
使用 VS Code 语言 API 在 TypeScript 中构建代码图
你通常得从搜索文件开始。你可能会使用编辑器的“查找引用”功能,在定义之间跳转,或者搜索导入、导出和函数名。 但我们可以换个角度思考这个问题。不要将代码库视为一组文件的集合,而是将其建模为一个图(graph)。 函数变成节点(node),调用关系变成边(edge)。“谁调用了这个函数?”
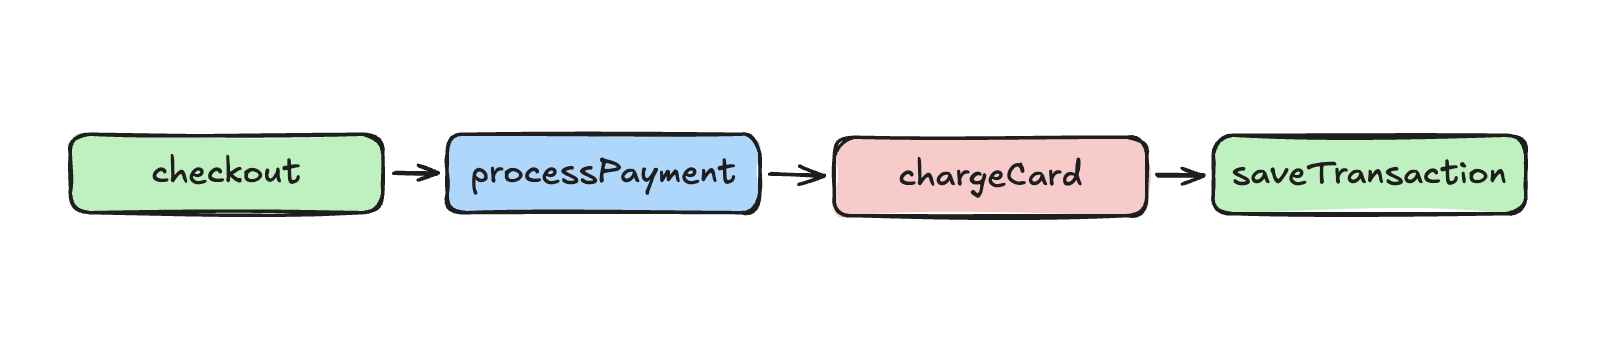 一旦代码被表示为图,“谁调用了这个函数?”或“这个函数最终调用了什么?”这类问题就转化为了图的遍历问题。
在本教程中,我们将使用 TypeScript 和 VS Code 内置的语言 API 来构建代码图的核心。我们不会自己编写 TypeScript 解析器,而是利用 VS Code 和已安装的语言扩展已经提供的语义信息。最终结果是一个包含文件、函数、方法及调用关系的图,并可以在 VS Code 的 Webview 中展示。
目录
我们要构建什么
我们将构建一个小型代码图引擎,利用 VS Code 的 Call Hierarchy API 来发现函数和方法之间的关系,然后跨多跳遍历这些关系。过程中我们会处理并发、失效的语言工具引用、缓存以及重复遍历等问题,确保图结构可靠且高效。
前置要求
在跟随本文操作之前,你需要熟悉以下内容:
TypeScript 以及基于
async/await的基本异步编程兼容 VS Code 的任意代码、VS Code 扩展 API,以及
vscode.commands.executeCommand图的基本概念,例如节点、边和广度优先搜索(BFS)
TypeScript 中对 Map、数组和泛型函数的使用
开始吧!
假设我们有以下代码:
function checkout() {
  processPayment();
}

function processPayment() {
  chargeCard();
}

function chargeCard() {
  saveTransaction();
}

function saveTransaction() {
  // persist transaction
}
我们需要将这段源代码转换为一张图。在一个真实的代码库中,这张图可能跨越多个文件:
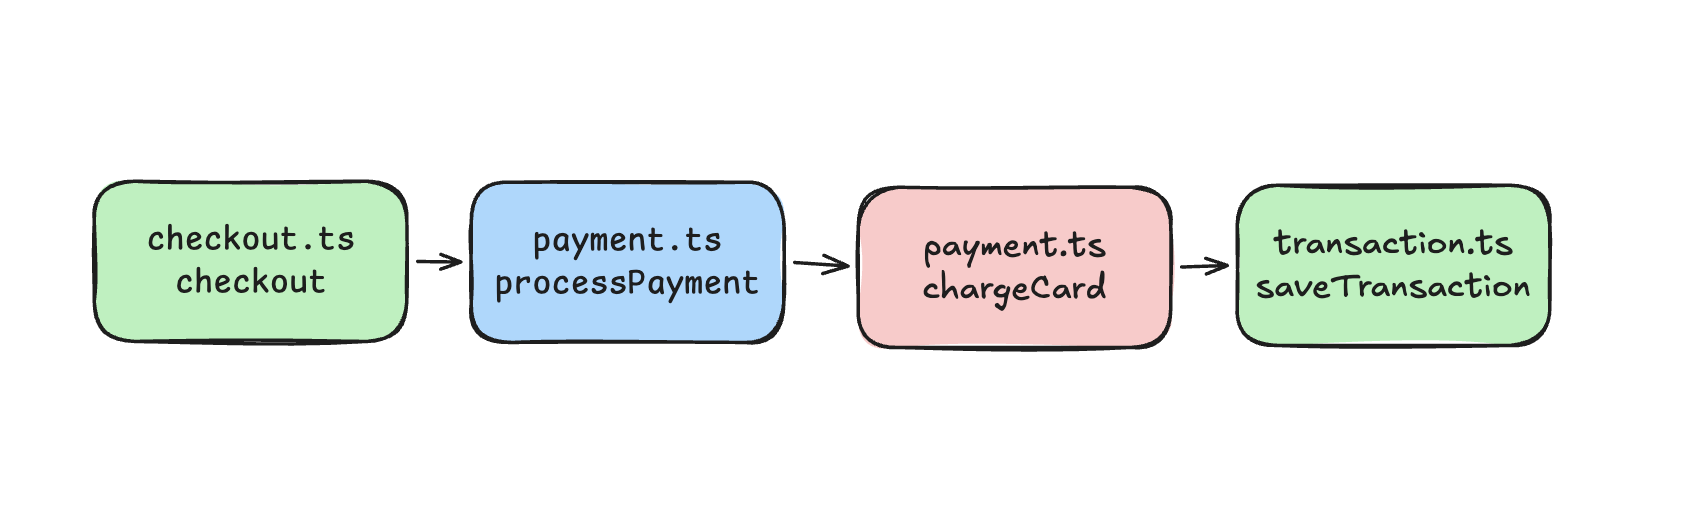
该实现主要分两部分:扩展宿主使用 VS Code 的语言 API 来发现图结构,Webview 则负责展示生成的图。整个架构中比较有意思的部分是图的构建器。
1. 理解 VS Code 语言 API
VS Code 已经暴露了若干命令,扩展可以利用它们来查询语言智能。在本项目中,其中四个命令格外有用:
| 命令 | 用途 |
|---|---|
vscode.executeDocumentSymbolProvider |
查找文档中的符号 |
vscode.prepareCallHierarchy |
将某个位置解析为调用层次结构项 |
vscode.provideIncomingCalls |
查找调用者 |
vscode.provideOutgoingCalls |
查找被调用者 |
这些 API 位于特定语言实现的上方。对于 TypeScript 和 JavaScript,TypeScript 语言服务提供底层信息;其他语言则通过各自的语言扩展和语言服务器暴露类似能力,例如 Go 的 gopls、Rust 的 rust-analyzer、Python 的 Pyright 或 Pylance。
这一点尤其重要,因为这意味着我们不需要为每种语言单独构建解析器和调用图引擎。只要某个语言扩展通过 VS Code 提供了文档符号和调用层次结构支持,同一套图构建架构就可以直接利用这些信息。
AST 能告诉你某个函数内部包含调用表达式,但它无法自动解析该调用跨越 import、文件、模块、类、别名等语言结构后,具体指向哪个函数。
语言服务器已经完成了大部分语义解析工作。因此,我们无需从头构建解析器和符号解析器,可以直接向 VS Code 查询它已掌握的信息。
2. 扩展初始化
在 package.json 中,我们声明了一个命令:
{
  "main": "./out/extension.js",
  "engines": {
    "vscode": "^1.85.0"
  },
  "activationEvents": [],
  "contributes": {
    "commands": [
      {
        "command": "codeGraphView.open",
        "title": "Code Graph: Open Graph for Active File",
        "icon": "$(type-hierarchy)"
      }
    ],
    "menus": {
      "editor/title": [
        {
          "command": "codeGraphView.open",
          "group": "navigation",
          "when": "resourceLangId == typescript"
        }
      ]
    }
  },
  "dependencies": {
    "elkjs": "^0.9.3"
  }
}
由于扩展宿主(Extension Host)和 Webview 运行在不同的环境中,需要分别打包。简化的 esbuild 配置如下:
const extensionConfig = {
  entryPoints: ['src/extension.ts'],
  bundle: true,
  outfile: 'out/extension.js',
  external: ['vscode'],
  format: 'cjs',
  platform: 'node',
};

const webviewConfig = {
  entryPoints: ['webview/main.ts'],
  bundle: true,
  outfile: 'out/webview/main.js',
  format: 'iife',
  platform: 'browser',
};
扩展代码运行在 Node 环境中,而 Webview 代码运行在浏览器环境中。
3. 设计图数据模型
在调用语言 API 之前,需要先确定图的结构。一个实用的模型如下:
export interface SymbolRow {
  id: string;
  name: string;
  kind: 'function' | 'method';
  line: number;
  character: number;
}

export interface FileNode {
  id: string;
  label: string;
  file: string;
  symbols: SymbolRow[];
}

export interface CallEdge {
  id: string;
  source: string;
  target: string;
}

export interface GraphData {
  rootFileId: string;
  rootSymbolId?: string;
  roots: string[];
  files: FileNode[];
  edges: CallEdge[];
  truncated: boolean;
}
这里有两个关键概念。
FileNode包含属于该文件的函数或方法。CallEdge表示两个符号之间的关系。
我们保持边的方向一致:
caller → callee
也就是说,如果 checkout() 调用了 processPayment(),图中始终是:
checkout → processPayment
即使这个关系是在查询“谁调用了我”时发现的,方向也不会变。
稳定的符号 ID
函数名并不唯一,一个项目里很容易出现:
// users.ts
function save() {}
和:
// payments.ts
function save() {}
因此,我们需要一个基于符号位置的标识符。
function idOf(
  uri: vscode.Uri,
  pos: vscode.Position
): string {
  return `${uri.toString()}#${pos.line}:${pos.character}`;
}
对于调用层级项,我们使用它的 selectionRange:
function itemId(
  item: vscode.CallHierarchyItem
): string {
  return idOf(
    item.uri,
    item.selectionRange.start
  );
}
用 selectionRange 的好处是,它定位的是符号的名称,而不是整个函数体或声明范围。这个稳定的 ID 是去重的基础:当同一个函数从图中多条路径被发现时,我们能识别出这些发现指向的是同一个节点。
4. 查找函数和方法
构建图的第一步,是发现当前文件中的符号。VS Code 通过以下 API 暴露文档符号:
vscode.executeDocumentSymbolProvider
调用方式如下:
/*
 * 借助 VS Code 内置的语言服务获取文档中的所有符号,
 * 而不是自己解析代码。这样就能拿到文档里的方法、函数和变量。
 */
async function getDocumentSymbols(
  uri: vscode.Uri
): Promise<vscode.DocumentSymbol[]> {

  /*
   * `vscode.executeDocumentSymbolProvider` 会把分析工作
   * 委托给为该文档语言注册的语言提供方。
   */

  const result =
    await vscode.commands.executeCommand<
      vscode.DocumentSymbol[] | undefined
    >(
      'vscode.executeDocumentSymbolProvider',
      uri
    );

  // 如果没找到符号,返回空列表。
  return result ?? [];
}
返回的符号是层级结构,比如:
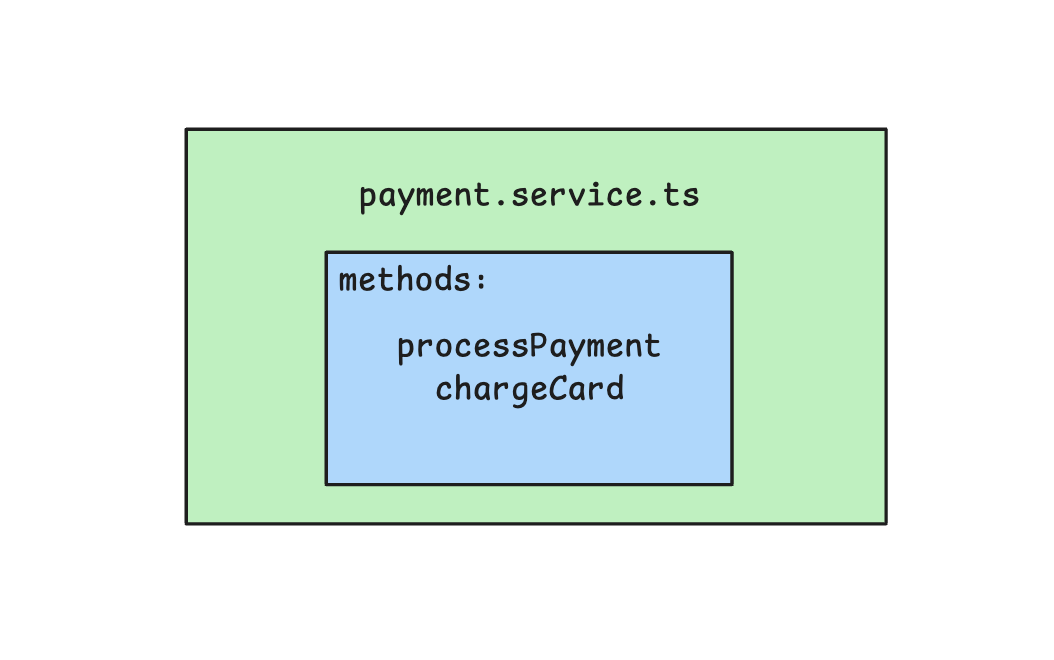
我们需要遍历这个层级结构,并收集那些能够代表可调用代码的符号。
// 检查符号是否可被视为可调用节点。
const isCallableKind = (
  kind: vscode.SymbolKind,
  includeConstructors: boolean
) =>
  kind === vscode.SymbolKind.Function ||
  kind === vscode.SymbolKind.Method ||
  (
    includeConstructors &&
    kind === vscode.SymbolKind.Constructor
  );
我们可以递归检查符号树:
  // 从符号树中递归收集函数、方法和变量
function collectCandidates(
  symbols: vscode.DocumentSymbol[],
  isCallable: (
    kind: vscode.SymbolKind
  ) => boolean,
  out: vscode.DocumentSymbol[] = []
) {
  for (const symbol of symbols) {
    if (
      isCallable(symbol.kind) ||
      symbol.kind === vscode.SymbolKind.Variable
    ) {
      out.push(symbol);
    } else if (
      symbol.children.length
    ) {
      collectCandidates(
        symbol.children,
        isCallable,
        out
      );
    }
  }
  return out;
}
变量也值得纳入考量,因为赋值给变量的函数在语言工具中可能会有不同的报告方式。例如:
const handler = () => {
  // ...
};
即使某个符号参与调用层级,它也可能被报告为变量。
5. 定位指定位置的符号
当用户打开某个特定方法的图时,我们需要确定包含光标的符号是哪个。由于文档符号具有层级结构,我们可以递归查找包含该位置的最深层符号。
// 查找包含给定位置的最具体符号。
function symbolAt(
  symbols: vscode.DocumentSymbol[],
  position: vscode.Position
) {
  for (const symbol of symbols) {
    if (symbol.range.contains(position)) {
      return (
        symbolAt(
          symbol.children,
          position
        ) ?? symbol
      );
    }
  }
  return undefined;
}
这就建立起了编辑器与图之间的桥梁。用户在源文件中选择一个位置,我们将该位置解析为符号,然后将该符号解析为调用层级项。
6. 解析调用层级
调用层级(Call Hierarchy)API 的工作分为两个阶段。首先:
position → CallHierarchyItem
然后:
CallHierarchyItem → 传入/传出调用
我们可以这样准备 CallHierarchyItem:
async function prepare(
  uri: vscode.Uri,
  position: vscode.Position
) {
  // VS Code 的语言工具本身就知道如何解析源文件中的符号。
  // 因此我们可以利用它为当前位置的符号准备调用层级。
  const items =
    await vscode.commands.executeCommand<
      vscode.CallHierarchyItem[] | undefined
    >(
      'vscode.prepareCallHierarchy',
      uri,
      position
    );

  // 该命令返回一个层级项数组。在我们的场景中,
  // 我们只关心光标直接下方的符号,所以取第一个结果即可。
  // 使用可选链(Optional chaining)还能处理在指定位置
  // 无法解析出任何符号的情况。
  return items?.[0];
}
拿到 item 之后,我们就可以查询调用者:
async function callers(
  item: vscode.CallHierarchyItem
) {
  // 向 VS Code 请求所有调用该 item 的符号。
  const calls =
    await vscode.commands.executeCommand<
      vscode.CallHierarchyIncomingCall[] | undefined
    >(
      'vscode.provideIncomingCalls',
      item
    );

  // 返回调用方符号;如果没找到,则默认为空列表。
  return (
    calls ?? []
  ).map(call => call.from);
}
或者查询被调用者:
async function callees(
  item: vscode.CallHierarchyItem
) {
  // 向 VS Code 请求该 item 调用的所有符号。
  const calls =
    await vscode.commands.executeCommand<
      vscode.CallHierarchyOutgoingCall[] | undefined
    >(
      'vscode.provideOutgoingCalls',
      item
    );

  // 返回被调用的符号;如果没找到,则默认为空列表。
  return (
    calls ?? []
  ).map(call => call.to);
}
假设存在这样的调用关系:
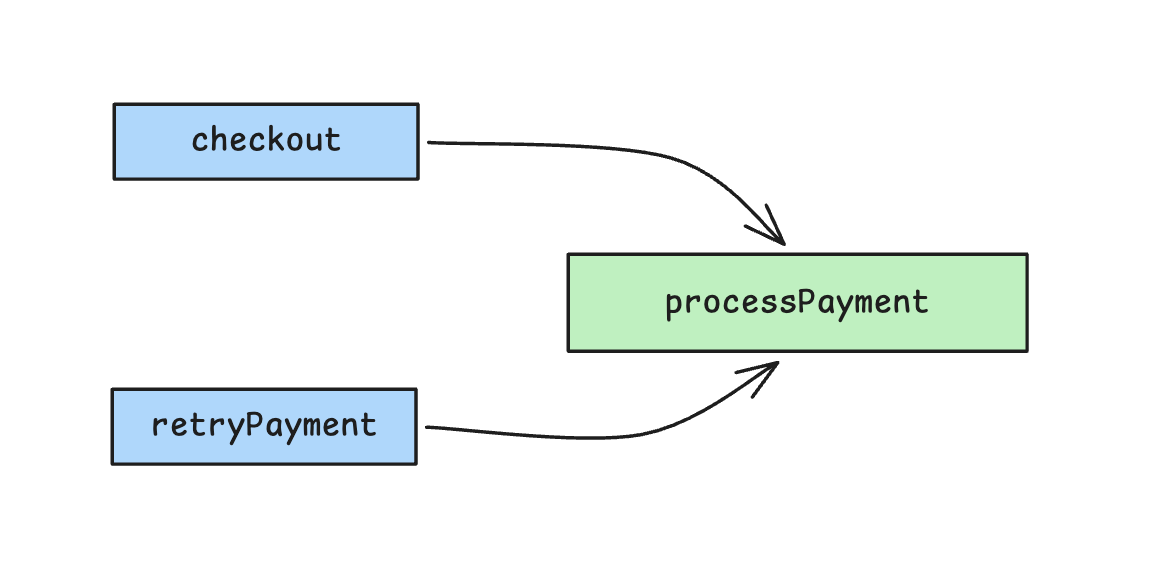
当请求 processPayment 的传入调用时,语言 API 返回的结果是:
checkout
retryPayment
接着我们将这些结果规范化为:
checkout → processPayment
retryPayment → processPayment
因此,同一套图结构既能表示入边遍历,也能表示出边遍历。
7. 构建符号注册表
遍历图时,同一个符号会反复出现。比如:
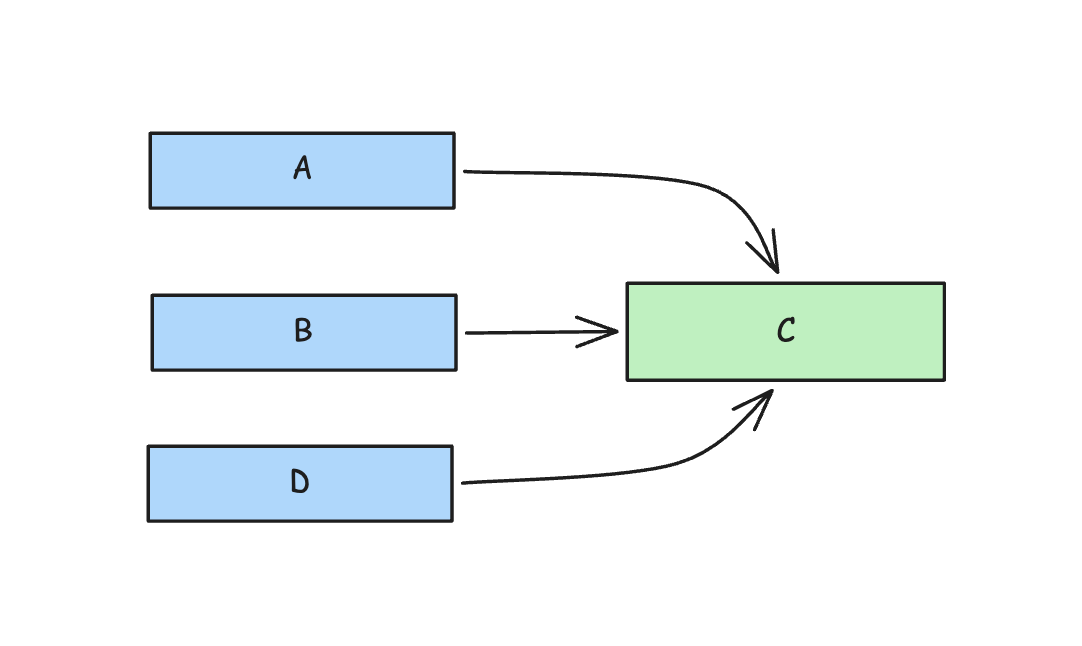
我们应该为 C 只创建一个节点,而不是三个。注册表就是用来做这层去重的。
class Registry {
  // Keep files and their symbols separately so they can be reused across the graph.
  private readonly files =
    new Map<string, FileNode>();

  // Store symbols by ID for fast lookup and duplicate detection.
  private readonly rows =
    new Map<string, SymbolRow>();

  get size() {
    return this.rows.size;
  }

  has(id: string) {
    return this.rows.has(id);
  }

  register(
    uri: vscode.Uri,
    name: string,
    kind: vscode.SymbolKind,
    position: vscode.Position
  ): string {
    // Generate a stable ID from the file and symbol position.
    const id =
      idOf(uri, position);

    // Avoid registering the same symbol more than once.
    if (this.rows.has(id)) {
      return id;
    }

    const fileId =
      uri.toString();

    let file =
      this.files.get(fileId);

    // Create the file entry the first time we encounter it.
    if (!file) {
      file = {
        id: fileId,
        label:
          vscode.workspace
            .asRelativePath(uri),
        file: uri.fsPath,
        symbols: [],
      };

      this.files.set(
        fileId,
        file
      );
    }

    // Normalize VS Code's symbol kind into the graph's simpler representation.
    const row: SymbolRow = {
      id,
      name,
      kind:
        kind ===
        vscode.SymbolKind.Method
          ? 'method'
          : 'function',
      line: position.line,
      character:
        position.character,
    };

    // Store the symbol globally and under its containing file.
    this.rows.set(id, row);
    file.symbols.push(row);

    return id;
  }
}Now the graph builder can repeatedly register symbols without worrying about duplicates.
8. 用 BFS 遍历图
一次调用层级查询只能获取一跳的信息。要构建有用的代码图,需要多跳查询。从 A() 出发的查询可能告诉我们它调用了 B(),但无法揭示 B() 下一步会调用什么。
为了构建实用的图,我们需要反复追踪这些关系:A → B → C → D。每次查询都会将图的层级向外扩展一层,因此我们需要一种遍历策略(如 BFS)来高效地探索多跳路径。
例如:
// 假设一个具有 4 跳的图
A --> B --> C --> D --> E
如果从 A 开始并请求深度为 3(即 3 跳),我们希望得到:
Depth 0: A
Depth 1: B
Depth 2: C
Depth 3: D
广度优先搜索(BFS)是自然的选择,因为该图是明确围绕跳数深度组织的。遍历过程维护一个前沿:
current frontier
      ↓
discover neighbors
      ↓
next frontier
      ↓
discover neighbors
基础实现如下:
const walk = async (
  start: Handle,
  direction: 'incoming' | 'outgoing',
  limit: number
) => {
  // 从给定的符号开始,逐层遍历调用图。
  let frontier: Handle[] = [start];

  for (
    let depth = 0;
    depth < limit &&
    frontier.length > 0;
    depth++
  ) {
    // 并行解析下一层,将并发请求数限制为六次。
    const results =
      await mapLimit(
        frontier,
        6,
        handle =>
          oneHop(
            handle,
            direction
          )
      );

    const next: Handle[] = [];

    frontier.forEach(
      (handle, index) => {
        for (
          const other
            of results[index]
        ) {
          // 在添加关系之前,先注册新发现的符号。
          if (
            !registry.has(
              other.node.id
            )
          ) {
            registry.register(
              other.node.uri,
              other.node.name,
              other.node.kind,
              other.node.pos
            );
          }

          // 在图中保留调用关系的方向。
          if (
            direction === 'outgoing'
          ) {
            addEdge(
              handle.node.id,
              other.node.id
            );
          } else {
            addEdge(
              other.node.id,
              handle.node.id
            );
          }

          next.push(other);
        }
      }
    );

    // 从当前深度发现的符号继续遍历。
    frontier = next;
  }
};
mapLimit 辅助函数用于控制并发语言服务器请求的数量:
async function mapLimit<T, R>(
  items: T[],
  limit: number,
  fn: (item: T) => Promise<R>
): Promise<R[]> {
  // 最多同时运行 `limit` 个异步操作。
  const results =
    new Array<R>(items.length);

  let next = 0;

  // 创建多个 worker,共享获取下一个待处理项。
  const workers =
    Array.from(
      {
        length:
          Math.min(
            limit,
            items.length
          ),
      },
      async () => {
        while (
          next < items.length
        ) {
          const index = next++;

          results[index] =
            await fn(
              items[index]
            );
        }
      }
    );
  await Promise.all(workers);
  return results;
}
关键区别在于:BFS 只是本地计算,而解析符号往往需要让 VS Code 的语言工具真正干活。
Code Graph View 在遍历每个符号时,可能需要向语言服务查询它的入边或出边调用。这些查询可能涉及解析源文件、解析符号,以及与语言服务器通信。图越大,请求数量也会随之增长。
所以虽然遍历本身很简单,但如果串行执行这些查询,整个过程会慢很多。mapLimit 通过让多个独立的语言工具请求并发执行来解决这个问题,同时限制并发数,避免压垮语言服务。
9. 处理循环引用
真实的代码不是树,而是图。这意味着循环引用是常态。
举个例子:
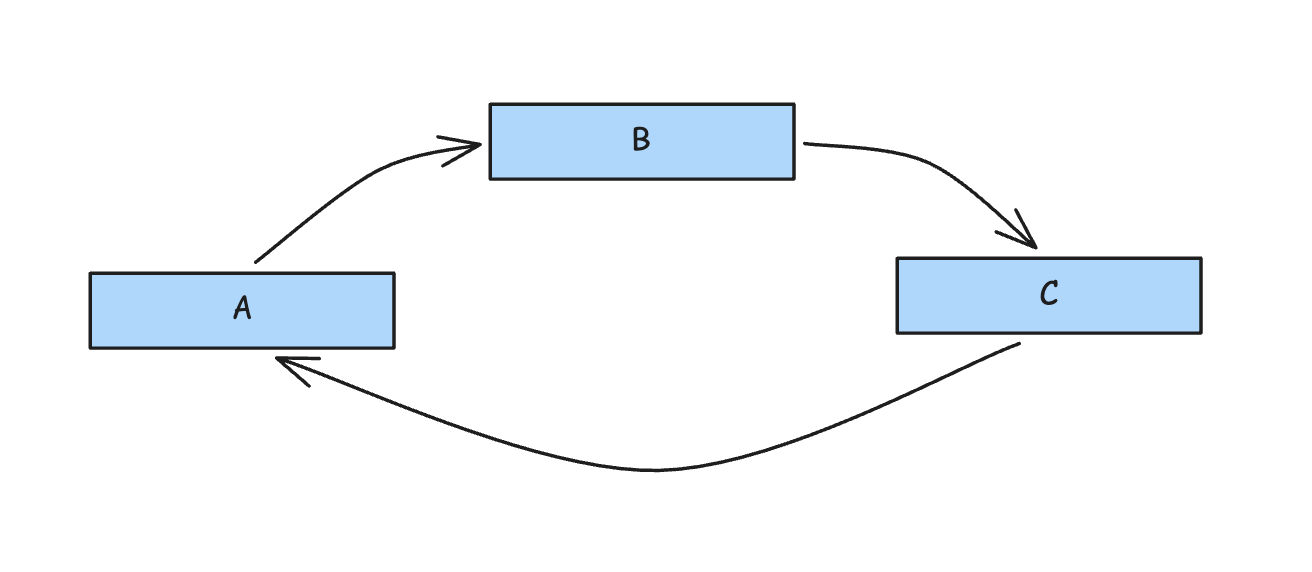
朴素的递归遍历可能会无限进行下去。因此我们需要记录已经探索过的节点。但这里有个微妙的细节:如果同一个节点会在不同深度被访问到,简单用一个
Set<string>
并不总是够用。更好的做法是,在探索节点时记录剩余的遍历深度。
const explored =
  new Map<string, number>();
然后:
// 追踪该节点已执行过的最深剩余遍历深度。
const key =
  `${direction}:${node.id}`;
if (
  (explored.get(key) ?? -1)
  < remainingDepth
) {
  // 只有当本次遍历能探索得更深时,才重新访问。
  explored.set(
    key,
    remainingDepth
  );
  next.push(node);
}
这意味着,如果我们之前到达某节点时剩余一跳,后来发现它还有三跳剩余,就可以再次探索该节点。这比简单地将其标记为“已访问”更精准。
10. 限定图的规模
图的规模可能迅速膨胀。一个高连通度的函数可能有数十个调用方,而这些调用方本身又各有数十个调用方。因此,图构建器必须设有明确的上限。
例如:
const MAX_SYMBOLS = 400;
const MAX_CALLS_PER_SYMBOL = 50;
const HOP_CONCURRENCY = 6;
当图触及上限时,我们不应假装图是完整的。而是:
let truncated = false;
并且:
if (
  registry.size >=
  MAX_SYMBOLS
) {
  truncated = true;
  continue;
}
生成的 GraphData 可以告知 UI:
此图已被截断。
这比让意外庞大的代码库导致扩展程序看似卡死要好得多。
11. 过滤文件
语言服务器可能返回指向不属于当前应用的文件关系。这些可能是构建文件,或由依赖安装或特定语言的构建/运行时操作生成的输出。例如,TypeScript 项目可能涉及:
node_modules
Python 项目可能涉及:
site-packages
我们可以在将这些路径加入图之前进行过滤。
const DEPENDENCY_DIRS =
  /\/(node_modules|vendor|target|\.venv|venv|site-packages|__pycache__|build|obj|\.dart_tool)\//;

function isWorkspaceFile(
  uri: vscode.Uri
): boolean {
  if (
    uri.scheme !== 'file' ||
    DEPENDENCY_DIRS.test(uri.path)
  ) {
    return false;
  }
  return !!vscode.workspace
    .getWorkspaceFolder(uri);
}
这样能让图谱始终聚焦于用户的工作区。它也清晰地体现了语言智能与应用行为之间的关键区别:语言服务器告诉我们哪些内容可以被解析,而我们的图谱构建器则决定哪些内容应当纳入图谱。
12. 为什么有些边会悄无声息地消失
在大型图谱中,有些函数明明互相调用,最终却可能没有任何连接,而且系统也不会报告任何错误。问题在于 CallHierarchyItem 依赖于语言服务的状态。一旦该状态过期,查询其调用者或被调用者时就可能返回空数组。从图谱构建器的视角看,这与一个没有任何调用者的函数完全一样。
在 VS Code 的实现中,调用层次会话仅保留最近有限数量的请求。我们的爬虫还可能同时有多个查询在进行,因此在遍历图谱的过程中,较早的项目可能会变得不可用。图谱构建器通过三种方式处理这一问题。
1. 存储纯数据,而非实时项目
每个函数由 NodeRef 表示,其中包含其 ID、URI、名称、类型和位置。单跳查询结果也以 NodeRef 形式缓存。这些信息足以在需要时重建一个调用层次项目。
interface NodeRef {
  id: string;
  uri: vscode.Uri;
  name: string;
  kind: vscode.SymbolKind;
  pos: vscode.Position;
}
2. 追踪每个已准备项目的“年龄”
一个全局 epoch 计数器会在每次准备新的调用层次项目时递增。每个句柄都记录其项目创建时的 epoch 值。如果某个项目变得足够陈旧,爬虫就会根据存储的 NodeRef 准备一个全新的项目。
3. 重试可疑的空结果
下面是 oneHop 的简化版本:
const SESSION_WINDOW = 7;

// 刷新过期的语言工具引用,必要时重试一次。
for (let attempt = 0; attempt < 2; attempt++) {
  const stale =
    !current.item ||
    epoch - current.epoch > SESSION_WINDOW;

  if (stale) {
    // 使用已过期的 CallHierarchyItem 之前,先重新解析符号。
    const fresh = await prepareFresh(
      current.node.uri,
      current.node.pos
    );

    if (!fresh) {
      return [];
    }

    current = fresh;
  }

  const items =
    await lookup(
      current.item!,
      direction
    );

  // 过期的引用可能查不到任何结果,因此将其置为无效并重试一次。
  if (
    items.length === 0 &&
    attempt === 0 &&
    epoch - current.epoch > SESSION_WINDOW
  ) {
    current = {
      node: current.node,
      epoch: -1,
    };

    continue;
  }

  // 缓存已解析的关系,避免重复查询语言工具。
  hopCache.set(key, {
    nodes: items.map(refOf),
    at: Date.now(),
  });

  return items.map(child => ({
    node: refOf(child),
    item: child,
    epoch: current.epoch,
  }));
}
这里的 lookup 是前文提到的 vscode.provideIncomingCalls 或 vscode.provideOutgoingCalls 命令的简写。具体的会话时长上限属于 VS Code 的内部实现细节,扩展不应依赖它。因此爬虫不会假设某个具体的上限一定存在,SESSION_WINDOW 只是给我们提供了一个保守的阈值,用于刷新旧的句柄。
这样做能减少丢失的边,但无法保证图是完整的。语言工具仍可能返回不完整的信息,或者无法解析某些关系。
这个经验同样适用于调用层次之外的其他语言服务 API:保存的是重建对象所需的信息,而不是对象本身。当基于过期状态得到空结果时,应把它当作"可能未知",而不是直接判定为"没有"。
13. 将图接入 Webview
图构建完成后,扩展还需要一个地方来展示它,VS Code Webview 正好派上用场。
扩展宿主负责创建面板:
const panel =
  vscode.window.createWebviewPanel(
    'codeGraphView',
    'Code Graph',
    vscode.ViewColumn.Beside,
    {
      enableScripts: true,
      retainContextWhenHidden: true,
    }
  );
图数据以可序列化对象的形式发送到 Webview:
panel.webview.postMessage({
  command: 'graphData',
  data: graphData,
});
Webview 随后可以接收该数据:
window.addEventListener(
  'message',
  event => {
    const message =
      event.data;

    if (
      message.command !==
      'graphData'
    ) {
      return;
    }

    renderGraph(
      message.data
    );
  }
);
至此,语言服务器侧的问题已经解决完毕。
我们完成了如下转换:
source code
变为:
symbols + relationships
再进一步转化为:
GraphData
现在,可视化层可以使用这些数据来渲染图形。
可以使用 ELK 等库来计算图形节点的布局位置,且不影响图构建的核心逻辑。
14. 测试图构建器
如果每个测试都依赖运行中的 VS Code 实例和真实语言服务器,那么测试这类扩展会很困难。更好的做法是将图构建逻辑与 VS Code 本身隔离开来。爬虫实际只需要依赖少数几个操作:
prepareCallHierarchy
provideIncomingCalls
provideOutgoingCalls
我们可以为这些命令创建一个伪实现。例如:
const sessions = new Map();

let sessionCounter = 0;

async function executeCommand(
  command,
  ...args
) {
  // 模拟 VS Code 在解析符号时创建会话。
  if (
    command ===
    'vscode.prepareCallHierarchy'
  ) {
    const id =
      'session-' +
      ++sessionCounter;

    sessions.set(id, true);

    return [
      createFakeItem(
        args,
        id
      ),
    ];
  }

  // 模拟依赖于有效会话的调用查询。
  if (
    command ===
      'vscode.provideIncomingCalls' ||
    command ===
      'vscode.provideOutgoingCalls'
  ) {
    const item = args[0];

    // 当 CallHierarchyItem 属于过期会话时返回空。
    if (
      !sessions.has(
        item.sessionId
      )
    ) {
      return [];
    }

    return getFakeCalls(
      item
    );
  }
}
这个模拟实现可以建模诸如调用层级状态过期等边界情况。需要注意的是,如果伪实现中使用了特定的会话限制,应将其视为测试模型,而不是自动视为 VS Code 官方 API 的保证。
这样,我们就可以生成一个确定性的图,并将爬虫的输出与一个简单的参考 BFS(广度优先搜索)结果进行对比。
例如:
flowchart LR
    A[A] --> B[B]
    A --> C[C]
    B --> D[D]
    C --> D
    D --> E[E]
参考实现已知预期边的情况。生产环境中的爬虫则针对模拟的语言服务运行。如果两者结果不一致,测试即失败。这种方法让我们能够在不完全依赖编辑器运行时的情况下,测试复杂的图逻辑。
15. 代码图的局限性
基于语言服务器的调用图很有用,但它并非程序执行的完整表征。静态调用层级分析在解析某些关系时可能非常困难,甚至无法实现。
例如:
动态分派
反射
依赖注入
事件发射器
回调
运行时生成的代码
框架特有行为
考虑如下代码:
eventEmitter.on(
  'payment.completed',
  handlePayment
);
开发者可能明白这会在事件与 handlePayment 之间建立一种运行时关系。但静态调用图未必将其表示为普通的函数调用。因此,图的质量部分取决于语言服务器以及它能解析的关系类型。
因此,应将此图理解为一种语义近似,而非完美的运行时模型。此外,还有一个语言特定的维度。
图构建器本身可以保持大部分语言无关性,但不同的语言扩展可能对文档符号和调用层级提供不同级别的支持。
结语
构建代码图并不要求编写编译器或从零实现解析器。VS Code 已通过其语言 API 暴露了大量语义信息。
核心流程如下:
Document -> Document Symbols -> Call Hierarchy -> Graph Nodes + Edges -> BFS Traversal -> GraphData -> Visualization
工程上最重要的决策其实不在于如何画图,而在于:选一个实用的图模型、构建稳定的符号标识、正确解析传入和传出的调用、控制遍历的深度与并发、处理循环引用,并把 language server 的状态视为随时可能变化的东西。
这些基础打好之后,可视化就只是一个独立的问题。正是这种解耦,让这套架构的价值超越了单一的 VS Code 扩展。
同一套图模型未来还可以支撑依赖探索、变更影响分析、架构视图、AI 上下文选择,以及其他 navigate 日益复杂代码库的方式。
我基于这套思路做了一个可运行的版本,代码在这里:https://github.com/otobongfp/code-graph-view。
期待看到大家用代码图做出各种有趣的东西,为软件工程流程添砖加瓦。