
使用 Next.js、Supabase 和 TypeSafe Jev 构建 AI 简历筛选工具
发布一个工程职位,一周内就能收到 300 到 400 份简历。认真读完一份大约要两分钟,光是一个职位,在面试还没开始之前就要花掉十一个小时。
但实际上没人会逐份细读。HR 做的是快速分拣:扫一眼职位头衔、工作年限和用过的框架,十几秒就把简历归入“细看”或“基本不考虑”两堆。分到第四十份时,投入的注意力远不如第四份。
我们要替换的正是这个分拣环节,而不是阅读本身。只要值得花时间,人读简历读得很好;但面对海量简历的快速分拣,人类就力不从心了——经验表述方式恰好不在扫读重点上的优秀候选人,往往就此被漏掉。
如果你已经熟悉 LLM,只想看实现过程,可以直接跳到如何搭建简历筛选应用。
目录
前置要求
跟着本文动手做之前,请确保你已经熟悉:
Next.js App Router:清楚什么是 Server Component,大致了解 Server Action 的触发时机。本文的构建依赖这两者。
足够的 SQL 知识,能读懂 migration 即可。无需手写,所有 migration 都已放在仓库里。
无需了解 Jev 或机器学习。接下来的两个部分会覆盖开发所需的全部背景知识。
开始之前,你还需要准备:
Node v24.21.0 和 npm。
Docker 且已运行。Supabase CLI 会调用它在本地机器上启动 Postgres、Auth 和 Storage。
Supabase CLI。所有操作都在本地进行,直到最后的部署步骤才需要云项目。
Claude Code。构建过程涉及九次提示词,每次都在新的 Claude Code 会话中运行。这些提示词经过微调后可在其他代码代理中使用,但构建环节中安装 TypeSafe skill 的操作仅支持 Claude Code。
来自 console.typesafe.ai 的 TypeSafe API key。Jev 按输入 token 计费,构建和测试的成本只需几美分。
Vercel AI Gateway key。可选。它仅在用于从简历文本中提取候选人姓名和邮箱的一次操作中调用。如果跳过,可以手动输入这些信息。
如果最后需要部署,则需准备一个 Vercel 账号。
为什么不用现有的工具?
筛选工具主要分三类,在自行开发之前,我们已使用或尝试过所有这三类。
关键词和布尔值过滤器 是大多数候选人追踪系统(ATS)的默认选项。你指定关键词,系统负责统计数量。候选人对此心知肚明,这就是为什么投递 React 岗位的简历里,“React”一词通常会出现六次。
这种过滤器衡量的是候选人撰写“讨好过滤器”文字的能力。它几乎无法说明候选人是否具备实际开发能力,并且会悄无声息地淘汰那些用不同措辞描述相同工作的优秀候选人。
匹配分数 是大多数 ATS 供应商现在推出的升级功能:模型将简历与职位描述进行对比,并返回一个百分比。这个数字是真实存在的,也可以据此排序。但筛选标准并非由你制定,你既看不见也无法修改它们。
当招聘负责人问起为什么某位候选人得分为 81 分而另一位为 64 分时,答案往往是“模型决定的”。对于一个优秀候选人的定义随每个职位空缺而变化的工程岗位而言,这不是一个可执行的有效答案。此外,这些产品大多面向拥有数十人招聘团队的机构,而非仅两名 HR 员工的公司。
LLM 评估 是最新的选项,也是我们最先尝试的。只需将简历和职位描述发送给模型,即可返回一段文本。后续章节将解释该方法为何失效,这里仅简述一句:返回的段落虽然质量尚可,但你无法对一列文本段落进行排序。
我们想要的比上面这些都更具体:由招聘经理用大白话、针对每个岗位写下评估标准;给出一个分数,HR 能拆开看它对应哪些标准、还能提出质疑;而且评分要足够便宜,这样哪怕经理改了主意,所有候选人也能在几秒内重新打分,而不是重新读一遍简历。
最后一个原因我也直说:这东西花几天 Claude Code 会话就能搭出来,而且刚好有一款新模型就是为这类问题设计的,我们想验证它到底行不行。本手册接下来讲的就是验证结果。
我们要做什么
我们要做一个内部招聘门户。HR 创建职位并设定重要标准,比如什么才算扎实的技术经验、带教经历重不重要、需要什么样的资历。然后逐份上传简历,系统按这些标准给每份简历打分,结果以行的形式呈现在一个可排序、可筛选的表格里。
每一行显示总分、各标准的分项得分、模型的置信度,以及一个标记——当置信度低到需要人工复核时会出现。这个工具绝不会自动淘汰简历,它只是帮你把简历堆排个序,最终决定权始终在人手里。
打分由 TypeSafe AI 在 2026 年 9 月发布的模型 Jev 完成。与 GPT 或 Claude 不同,Jev 不生成任何文本:你把简历和一组带类型的问题发给它,它返回带校准概率的数字。不用写 prompt,不用解析 JSON,也不用读大段文字,直接拿到代码可以用的答案。
我们会用到这些技术:
Next.js(App Router)
Supabase,负责认证、Postgres 和文件存储
Tailwind CSS 和 shadcn/ui
TanStack Table,用于求职申请列表
unpdf,从 PDF 中提取文本
Vercel AI SDK 加 AI Gateway,用于一个小型的信息抽取任务
TypeSafe Jev,负责打分
Zod,所有有输入的地方都用它
背景是这样的:我经营着一家软件代理商 MTechZilla(网址),这篇文章介绍的正是我们内部 HR 团队最初启动的版本。文末引用的数据来自实际运行结果,并非预测值。TypeSafe 对我要写这篇文章毫不知情。
简历筛选本质上是个决策问题
想想 HR 在筛选简历时会做什么。他们对结果进行排序和过滤,与其他候选人对比,然后仔细精读排名靠前的几份简历。
这些步骤中的每一个,都需要数字或标签,而不是一段段落。
我是踩了坑才明白的。工具的第一版会把每份简历和职位描述发给 LLM,要求它输出一段简短的书面评估。这些回复很有见地且具体,通常比我自己写的还要好。但它们没用,因为你无法对由段落组成的列进行排序。HR 看了前几份,点点头,然后又开始重新打开 PDF。
要想明白为什么解决办法不是“只要让它输出数字就行”,你得先了解 LLM 实际上是如何生成答案的。
语言模型如何生成答案
大语言模型是一种自回归模型。这个技术术语指的其实是个简单的概念:它逐块生成输出,而每一块新内容都是基于之前所有内容选择出来的。
这些“块”叫做Token。Token 大致对应一个单词或单词的一部分:“screening”可能是一个 Token,“unpdf”可能是三个。当你向 LLM 提问时,它并不是先计算出完整答案再打印出来,而是计算下一个Token的概率分布,选出一个,追加到文本中,然后再运行一次流程以选择后续的 Token。一个包含 200 个 Token 的回答,意味着要串行地经过那个巨大的神经网络 200 次。
这就是为什么使用 LLM 时会感觉慢。延迟不仅仅是开销,而是其工作机制固有的。每个 Token 都需要完整遍历一次模型,而且由于当前步骤依赖前一步,这些遍历无法同时进行。这也是为什么输出 Token 的比输入 Token 更贵:输入是一次性处理的,而输出是逐步生成的。
受限解码解决的是错误问题
现代大语言模型提供了结构化输出模式。你只需向模型传入一份 JSON Schema,它便会保证返回一个符合该模式校验的对象。其底层机制是约束解码:在生成的每一步,模型会在选择词元之前,屏蔽掉那些会导致无效输出的词元。如果模式规定下一个字符必须是数字,模型就只能选择数字。
这套方案确实有效,我想明确这一点。我们不再需要依靠正则表达式来解析模型输出,也不用在 JSON 损坏时不断重试。
但请思考约束解码真正改变的是什么。模型仍然逐词元生成字符串,延迟和成本不变。当你看到类似 "score": 7 的内容时,模型并未真正“计算”出一个分数。它只是根据简历、提示词以及它学过的大量评估案例,预测 7 是此处最可能的词元。这个数字仅仅是一个看起来像数字的文本。
为什么生成的数字并非概率
这里有一个关键区别。假设模型告诉你某位候选人评分为 10 分中的 7 分,或者他有 70% 的可能性是理想人选。
一个经过校准的模型赋予这个数字以特定含义。如果你检查所有被评 70% 的候选人,其中大约 70% 最终确实会是理想人选。这个数字是一种测量结果,你可以据此采取行动。你可以设定 60% 为阈值,并大致清楚自己接受和拒绝了哪些候选人。
但语言模型输出的 70% 并不具备这种含义。其训练数据中没有任何机制将字符串 "70%" 与真实的 70% 概率关联起来。模型输出 "70%",仅仅是因为在训练语料中,类似的评估常使用这类数字。它只是在模仿一种自信的判断风格。
在实际应用中,有两点使这一问题更为严峻。
采样机制是个问题。大多数 LLM 的温度设置高于零,因此模型并不总是选择概率最高的词元,而是进行采样。同一份简历运行两次,你可能一次得到 7 分,下次得到 8 分,尽管输入完全没变。将温度设为零有帮助,但无法根本解决问题,因为那个数字本身从未是一种真实的测量结果。
还有一个问题:评分之间没有统一的标尺。当你给候选人 A 打分后再看候选人 B,模型并不记得 A 的分数,每个 7 都是独立生成的,取决于模型当下参照的东西。表格里两个 7 看起来一样,实际上并不是。更糟的是,一列看似可比、实则不可比的数字,比没有数字还要糟,因为人们天然倾向于相信表格里的数字。
这才是第一版失败的真正原因,而不是解析或延迟。每一行的分数含义都不一致,按分数排序,实际上是在按随机噪声排序。
生成式 vs 判别式
机器学习里有一个经典的概念区分,恰好能解释这个问题。生成式模型学习产出与训练集相似的数据;判别式模型学习把输入归入一组固定类别,并为每个类别输出一个概率。
LLM 是生成式模型,它的输出空间是所有可能的字符串。这带来了灵活性,但也正是它会幻觉的原因:没有任何机制约束它只能输出真实内容,或对应真实选项的内容。它可以编造一条引用、一个函数,或一项候选人资质——因为任何字符串都是合法输出。
而基于固定选项集的判别式模型在结构上就不可能这样做。如果允许的答案只有 junior、mid、senior 和 staff_plus,它就答不出 principal,也无法输出一句话。它只会返回这四个选项各自的概率,仅此而已。格式上的幻觉从根源上就不存在——不是模型更谨慎,而是它无处可去。
这并不意味着它总是正确。它可能给一个明显是 mid 水平的人打 80% 的 senior 概率。但在固定集合内犯错,和在开放空间里犯错是两种不同的问题:前者可以度量、校准、设阈值,并据此做路由。
System 1 与 System 2 思维
Daniel Kahneman 把人类思维分为两种模式。System 1 快速、直觉、靠模式匹配:你看到一张脸,立刻知道对方在生气。System 2 缓慢而审慎:比如你逐项填写报税表。
简历筛选是一项系统 1 任务。资深招聘者扫一眼简历,十秒钟内就能大致判断是否值得花两分钟细读。他们并未进行深度推理,只是在识别一种已见过千百次的模式。
若将推理型 LLM 应用于此任务,无异于用系统 2 的机械装置去解决系统 1 的问题。它会输出思考过程,权衡各项因素,最后生成一段细致入微的段落。这些操作既慢又贵,且并非任务所需。任务真正需要的,是将招聘者那十秒钟的直觉变得可复制、标准化,并重复 350 次而不疲倦。
TypeSafe 正是据此命名其模型类别。系统 1 模型专为执行快速、校准过的识别步骤而设计,别无其他。
95% 准确率困境
再补充一点,这决定了自动化是否真正可行。
假设筛选模型 95% 的情况判断正确,听起来不错。但若无法指出错在哪 5%,你就不得不逐行核查,毫无省力可言。价值不在于准确率本身,而在于清楚准确率在何处失效。
经过校准的模型能提供这一点。当模型在一个通常给出 90% 或 10% 置信度的问题上输出 55% 时,这是一个信号:该案例存在歧义,应转交人工处理。
这正是让人机协作(human-in-the-loop)审查成为可执行设计,而非“反正每件事都要人工检查”委婉说法的机制。基于置信度路由:低置信度由人工介入,高置信度则采用工具结果,除非有人主动推翻。
契合的形状
输入非结构化文本,输出类型化、经过校准的决策。中间没有多余环节。
不是那种先生成文本答案再由你解析成决策的模型,而是其唯一可能的输出就是决策本身。允许的答案集合在调用前已固定;返回的数值经过训练,确保其含义与实际相符,且每次一致。
这是一类不同的模型,并于九月发布。
TypeSafe Jev 是什么,不是什么
Jev 是一个接受文本和一组类型化问题、并为每个问题返回数值答案的模型。这就是全部接口。要理解其行为,需了解其训练方式,因为这正是其独特之处所在。
来源
所有现代语言模型都从同一个起点开始:训练大型神经网络预测下一个 token,训练数据覆盖了大部分互联网文本。这便形成了一个预训练模型。尽管它掌握了大量知识,但初期实用性有限,因为它只是在做文本续写。你问它一个问题,它可能会作答,也可能继续生成更多问题,甚至蹦出多年前某个论坛的随机帖子。
要让模型真正有用,需要进行第二个阶段:后训练。目前,后训练主要有三种方法。
RLHF(基于人类反馈的强化学习) 是 ChatGPT 背后的技术。人类评估者对比成对的两组模型输出,并选择偏好的那一个。奖励模型学习如何预测这些偏好,语言模型则被训练以生成能在这奖励模型上得分较高的输出。简而言之,模型学习的是说出人们想听的话。
这种方法推动了聊天机器人的兴起,但也带来了一些权衡。优化“人们喜欢什么”并不等于优化“什么是对的”。RLHF 可能鼓励模型说奉承话,或自信地犯错。
还有一种更微妙的影响,TypeSafe 的入门指南称之为“模式缺失”:模型专注于评估者喜欢的风格,而生成其他类型响应的概率降低。结果是,模型变得更顺从,也更不倾向于表达自身的不确定性。
RLVR(基于可验证奖励的强化学习) 用于训练推理模型。这里的奖励来源于将答案与可验证的基准(如正确的数学结果)进行比对。这种方法在数学和代码任务上效果很好,但速度较慢、成本更高,因为模型在给出答案前必须展示推理过程。
RLCD(基于校准决策的强化学习) 是 TypeSafe 用于 Jev 的方法。模型不生成文本,而是返回一个来自固定集合的决策,并附带一个概率值。目标是让概率与决策实际正确的频率相匹配。例如,如果模型给出 0.8,那么在这些回答中,大约 80% 应该是正确的;如果给出 0.2,那么大约 20% 应该是正确的。
这个特性叫做校准(calibration),也是我们的主要目标。重点在于校准,而不只是准确率。一个错了 30% 但能告诉你错在哪 30% 的校准模型,比一个只错 10% 却不知道什么时候出错的未校准模型更有用。 Diogo Almeida 是 RLHF 的共同发明人之一,也是 TypeSafe 的联合创始人。在做过专注于讨好用户的聊天机器人之后,他现在认为软件决策需要的是对不确定性保持诚实的模型。请求的结构
一次 Jev 调用包含两个部分。 状态(State)就是决策所针对的内容,可以是一个字符串、一个 JSON 对象,也可以是一段文本数组。在我们的场景里,它就是职位描述和提取出来的简历文本。状态只是数据,Jev 会读取它,但不会执行其中包含的任何指令。 问题(Questions)是一组针对状态、有名称且有类型的提问。每个问题并行、独立地评估,互不影响,因此增加更多问题几乎不会增加延迟。比如,你可以在一次请求中发送一份简历并附带八个问题。 下面是我们的门户针对单个候选人发送的请求,筛选标准由 HR 团队撰写:{
"state": {
"job_title": "资深产品工程师",
"job_description": "端到端负责面向客户的功能。全栈 TypeScript、Postgres、值班响应、指导两到三名工程师……",
"resume_text": "ANJALI MEHTA\n高级后端工程师\nanjali.mehta@example.com | +91 98200 41122 | 印度浦那\n概述\n拥有九年 Go 和 TypeScript 支付及账本系统开发经验的工程师。主导了一个处理 400 万笔交易的双式记账系统的迁移工作……"
},
"model": "jev-1.13.0",
"questions": {
"technical_depth": {
"type": "score",
"instructions": "根据经历和项目描述,评估候选人的实际工程深度:考察其亲手构建的内容、复杂度以及负责程度。忽略技能关键词列表、头衔和公司名称。评分依据是展示出的深度,而非工作年限。若在两个层级之间犹豫,选择较低的一档。",
"criteria": [
"未承担过编写代码的角色或项目。技术接触仅限于周边领域:手动 QA、IT 支持、产品经理、售前工程师。",
"编程经历仅见于课程、训练营或教程项目(如待办事项应用、复刻项目)。没有面向真实用户发布的内容。",
"在他人架构下进行小范围工作:修复 bug、开发次要功能、CRUD 界面。局限于一种语言、一个层级。项目描述罗列的是任务而非解决的问题。若无法判断其实际构建了什么,也按此档评分。",
"在生产系统中端到端负责功能:独立设计、构建、测试并上线,仅需少量监督。跨两个层级工作(如 API 加前端)。提及代码审查、测试、部署或值班响应。",
"负责整个系统并做出架构权衡。在两个领域具备深度(如后端加基础设施)。解决附带量化指标的高难度问题:性能、扩展性、迁移、事故响应。通常领导项目或指导他人。",
"具备真正广度的深度专家:维护被广泛使用的开源项目、系统底层技术(编译器、内核、分布式系统、数据库引擎),或在大规模环境下负责全组织架构。"
]
},
"jd_alignment": {
"type": "score",
"instructions": "候选人展示出的经验与 `job_description` 中的要求匹配程度如何?依据职位描述的实际要求进行评估,而非基于“优秀工程师”的泛化概念。忽略技能列表中的关键词重合,侧重已展示的工作成果。",
"criteria": [
"与要求无重叠。属于完全不同的学科。",
"相邻领域。具备一些可迁移技能,但未展示核心要求。",
"部分匹配。满足部分核心要求,明显缺失其他要求,或证据薄弱。",
"强匹配。通过实际工作满足几乎所有核心要求。",
"超出要求。包括明确的加分项,且有可直接比对的既往工作经历。"
]
},
"mentorship_demonstrated": {
"type": "noul",
"instructions": "简历是否展示了指导他人的经验?"
},
"llm_experience": {
"type": "noul",
"instructions": "候选人是否有开发 LLM 产品的经验?",
"criteria": {
"true": "候选人构建过由 AI 或大型语言模型驱动的产品或功能。",
"false": "候选人未展示构建 AI 产品的经验。"
}
},
"open_source_contribution": {
"type": "noul",
"instructions": "候选人是否有开源贡献经验?"
},
"career_progression": {
"type": "choice",
"instructions": "展示了哪种职业晋升轨迹?",
"criteria": {
"steady_growth": "清晰的晋升路径,职级逐步提升。",
"lateral_moves": "在不同公司担任类似职位。",
"job_hopping": "频繁换工作,任期较短。",
"unclear": "晋升模式不明确。"
}
},
"primary_talent_profile": {
"type": "choice",
"instructions": "选择最符合候选人人才画像的选项。从整体经历判断,而非仅看头衔或技能列表。最新职位权重最高。",
"criteria": {
"frontend_engineer": "构建面向用户的界面:涉及 React、Vue 或 Angular,设计系统,浏览器性能,无障碍支持。消费 API 但不负责维护 API。",
"backend_engineer": "构建服务端服务、API 和数据模型。负责业务逻辑、数据库、队列和服务性能。几乎没有 UI 相关工作。",
"full_stack_engineer": "在同一项目中同时交付 UI 和服务,且两者并无主次之分。不属于“偶尔编辑模板的后端工程师”。",
"mobile_engineer": "构建 iOS、Android 或跨平台应用(Swift、Kotlin、React Native、Flutter):应用商店发布、设备性能、原生 SDK。",
"devops_infrastructure": "负责代码的运行和发布方式:CI/CD、Kubernetes、Terraform、云基础设施、监控、可靠性及值班响应。涵盖 DevOps、SRE 和平台工程。",
"data_engineer": "构建数据管道和数据平台:ETL、数据仓库、Spark、Airflow、dbt、流处理。服务对象是分析师和模型,而非终端用户。",
"ml_ai_engineer": "训练、微调、评估或提供服务模型。包括应用 ML、LLM 和研究工程。",
"security_engineer": "应用、云或产品安全:威胁建模、渗透测试、检测工程、身份认证、漏洞修复。",
"embedded_systems": "底层工作:固件、驱动程序、内核、编译器、机器人技术,或资源受限环境下的 C、C++、Rust。",
"other": "符合实际工程特征但不属于上述分类的,如 QA 自动化、游戏开发、前置部署或解决方案工程。"
}
},
"is_resume": {
"type": "noul",
"instructions": "该文档是求职候选人的简历或履历。"
},
"earliest_role_start_year": {
"type": "choice",
"instructions": "在候选人的工作经历中,其第一份全职职业角色始于下列哪一年?仅从列出的年份中选择。忽略教育日期和认证日期。若简历未说明第一份工作的起始时间,选择 'none'。",
"criteria": {
"2016": null,
"2017": null,
"2021": null,
"none": "简历未说明第一份职业角色的起始时间。"
}
},
"earliest_role_start_month": {
"type": "choice",
"instructions": "在候选人的工作经历中,其第一份全职职业角色始于哪个月份?若仅说明了年份或未说明起始日期,选择 'none'。",
"criteria": {
"january": null,
"february": null,
"march": null,
"april": null,
"may": null,
"june": null,
"july": null,
"august": null,
"september": null,
"october": null,
"november": null,
"december": null,
"none": "仅说明年份,或未说明起始日期。"
}
}
}
}
以下是响应示例(具体数值为示意,源自一份模拟简历,方便你了解返回结构):
{
  "model": "jev-1.13.0",
  "answers": {
    "technical_depth": {
      "type": "score",
      "score": 3.32,
      "confidence": 0.71,
      "legend": {
        "0": "没有任何实际写过代码的工作或项目经历。技术相关经验仅限于周边岗位:手工测试 QA、IT 支持、产品经理、售前工程师等。",
        "1": "编程仅停留在课程作业、培训班或教程项目层面(待办应用、克隆项目)。没有面向真实用户上线过的东西。",
        "2": "只在别人的设计框架内做小范围工作:修 bug、小功能、CRUD 页面。只用过一种语言、只接触一层技术。简历条目罗列的是任务,而不是解决的问题。如果看不出对方到底做过什么,也归为这一档。",
        "3": "在真实运行的系统中独立负责完整功能:设计、开发、测试、上线,几乎不需要指导。能跨两层技术工作(比如 API 加前端)。简历中会提到 code review、测试、部署或值班。",
        "4": "负责整个系统并做架构权衡。在两个领域有深度(比如后端加基础设施)。能解决有量化数据支撑的难题:性能、扩展性、数据迁移、线上事故。常常主导项目或带新人。",
        "5": "深度专精且具备广度:广泛使用的开源项目维护者,深入系统底层(编译器、内核、分布式系统、数据库引擎),或在相当规模下负责全公司的架构。"
      },
      "probabilities": { "0": 0.00, "1": 0.01, "2": 0.12, "3": 0.46, "4": 0.36, "5": 0.05 }
    },
    "jd_alignment": {
      "type": "score",
      "score": 2.87,
      "confidence": 0.68,
      "legend": {
        "0": "与职位要求毫无重叠,完全是另一个领域。",
        "1": "相邻领域。有一些可迁移的技能,但没有任何核心要求的体现。",
        "2": "部分匹配。满足部分核心要求,明显缺少其他要求,或者证据不够充分。",
        "3": "高度匹配。有实际工作成果,基本满足所有核心要求。",
        "4": "超出要求,包括加分项,并且有直接对口的过往工作经历。"
      },
      "probabilities": { "0": 0.01, "1": 0.04, "2": 0.21, "3": 0.55, "4": 0.19 }
    },
    "mentorship_demonstrated": {
      "type": "noul",
      "noul": 0.93
    },
    "llm_experience": {
      "type": "noul",
      "noul": 0.08
    },
    "open_source_contribution": {
      "type": "noul",
      "noul": 0.11
    },
    "career_progression": {
      "type": "choice",
      "choice": "steady_growth",
      "confidence": 0.82,
      "probabilities": { "steady_growth": 0.88, "lateral_moves": 0.08, "job_hopping": 0.02, "unclear": 0.02 }
    },
    "primary_talent_profile": {
      "type": "choice",
      "choice": "backend_engineer",
      "confidence": 0.79,
      "probabilities": {
        "frontend_engineer": 0.01, "backend_engineer": 0.86, "full_stack_engineer": 0.09,
        "mobile_engineer": 0.00, "devops_infrastructure": 0.03, "data_engineer": 0.01,
        "ml_ai_engineer": 0.00, "security_engineer": 0.00, "embedded_systems": 0.00,
        "other": 0.00
      }
    },
    "is_resume": {
      "type": "noul",
      "noul": 0.99
    },
    "earliest_role_start_year": {
      "type": "choice",
      "choice": "2016",
      "confidence": 0.94,
      "probabilities": { "2016": 0.96, "2017": 0.03, "2021": 0.01, "none": 0.00 }
    },
    "earliest_role_start_month": {
      "type": "choice",
      "choice": "august",
      "confidence": 0.88,
      "probabilities": {
        "january": 0.00, "february": 0.00, "march": 0.00, "april": 0.00, "may": 0.00,
        "june": 0.02, "july": 0.03, "august": 0.92, "september": 0.02, "october": 0.00,
        "november": 0.00, "december": 0.00, "none": 0.01
      }
    }
  },
  "usage": {
    "input_tokens": 4611,
    "output_tokens": 512
  }
}
注意缺了什么:没有文本、解释或“推理”字段。每个值要么是数字,要么是你定义集合中的标签,因此代码可以直接使用,无需额外解析。
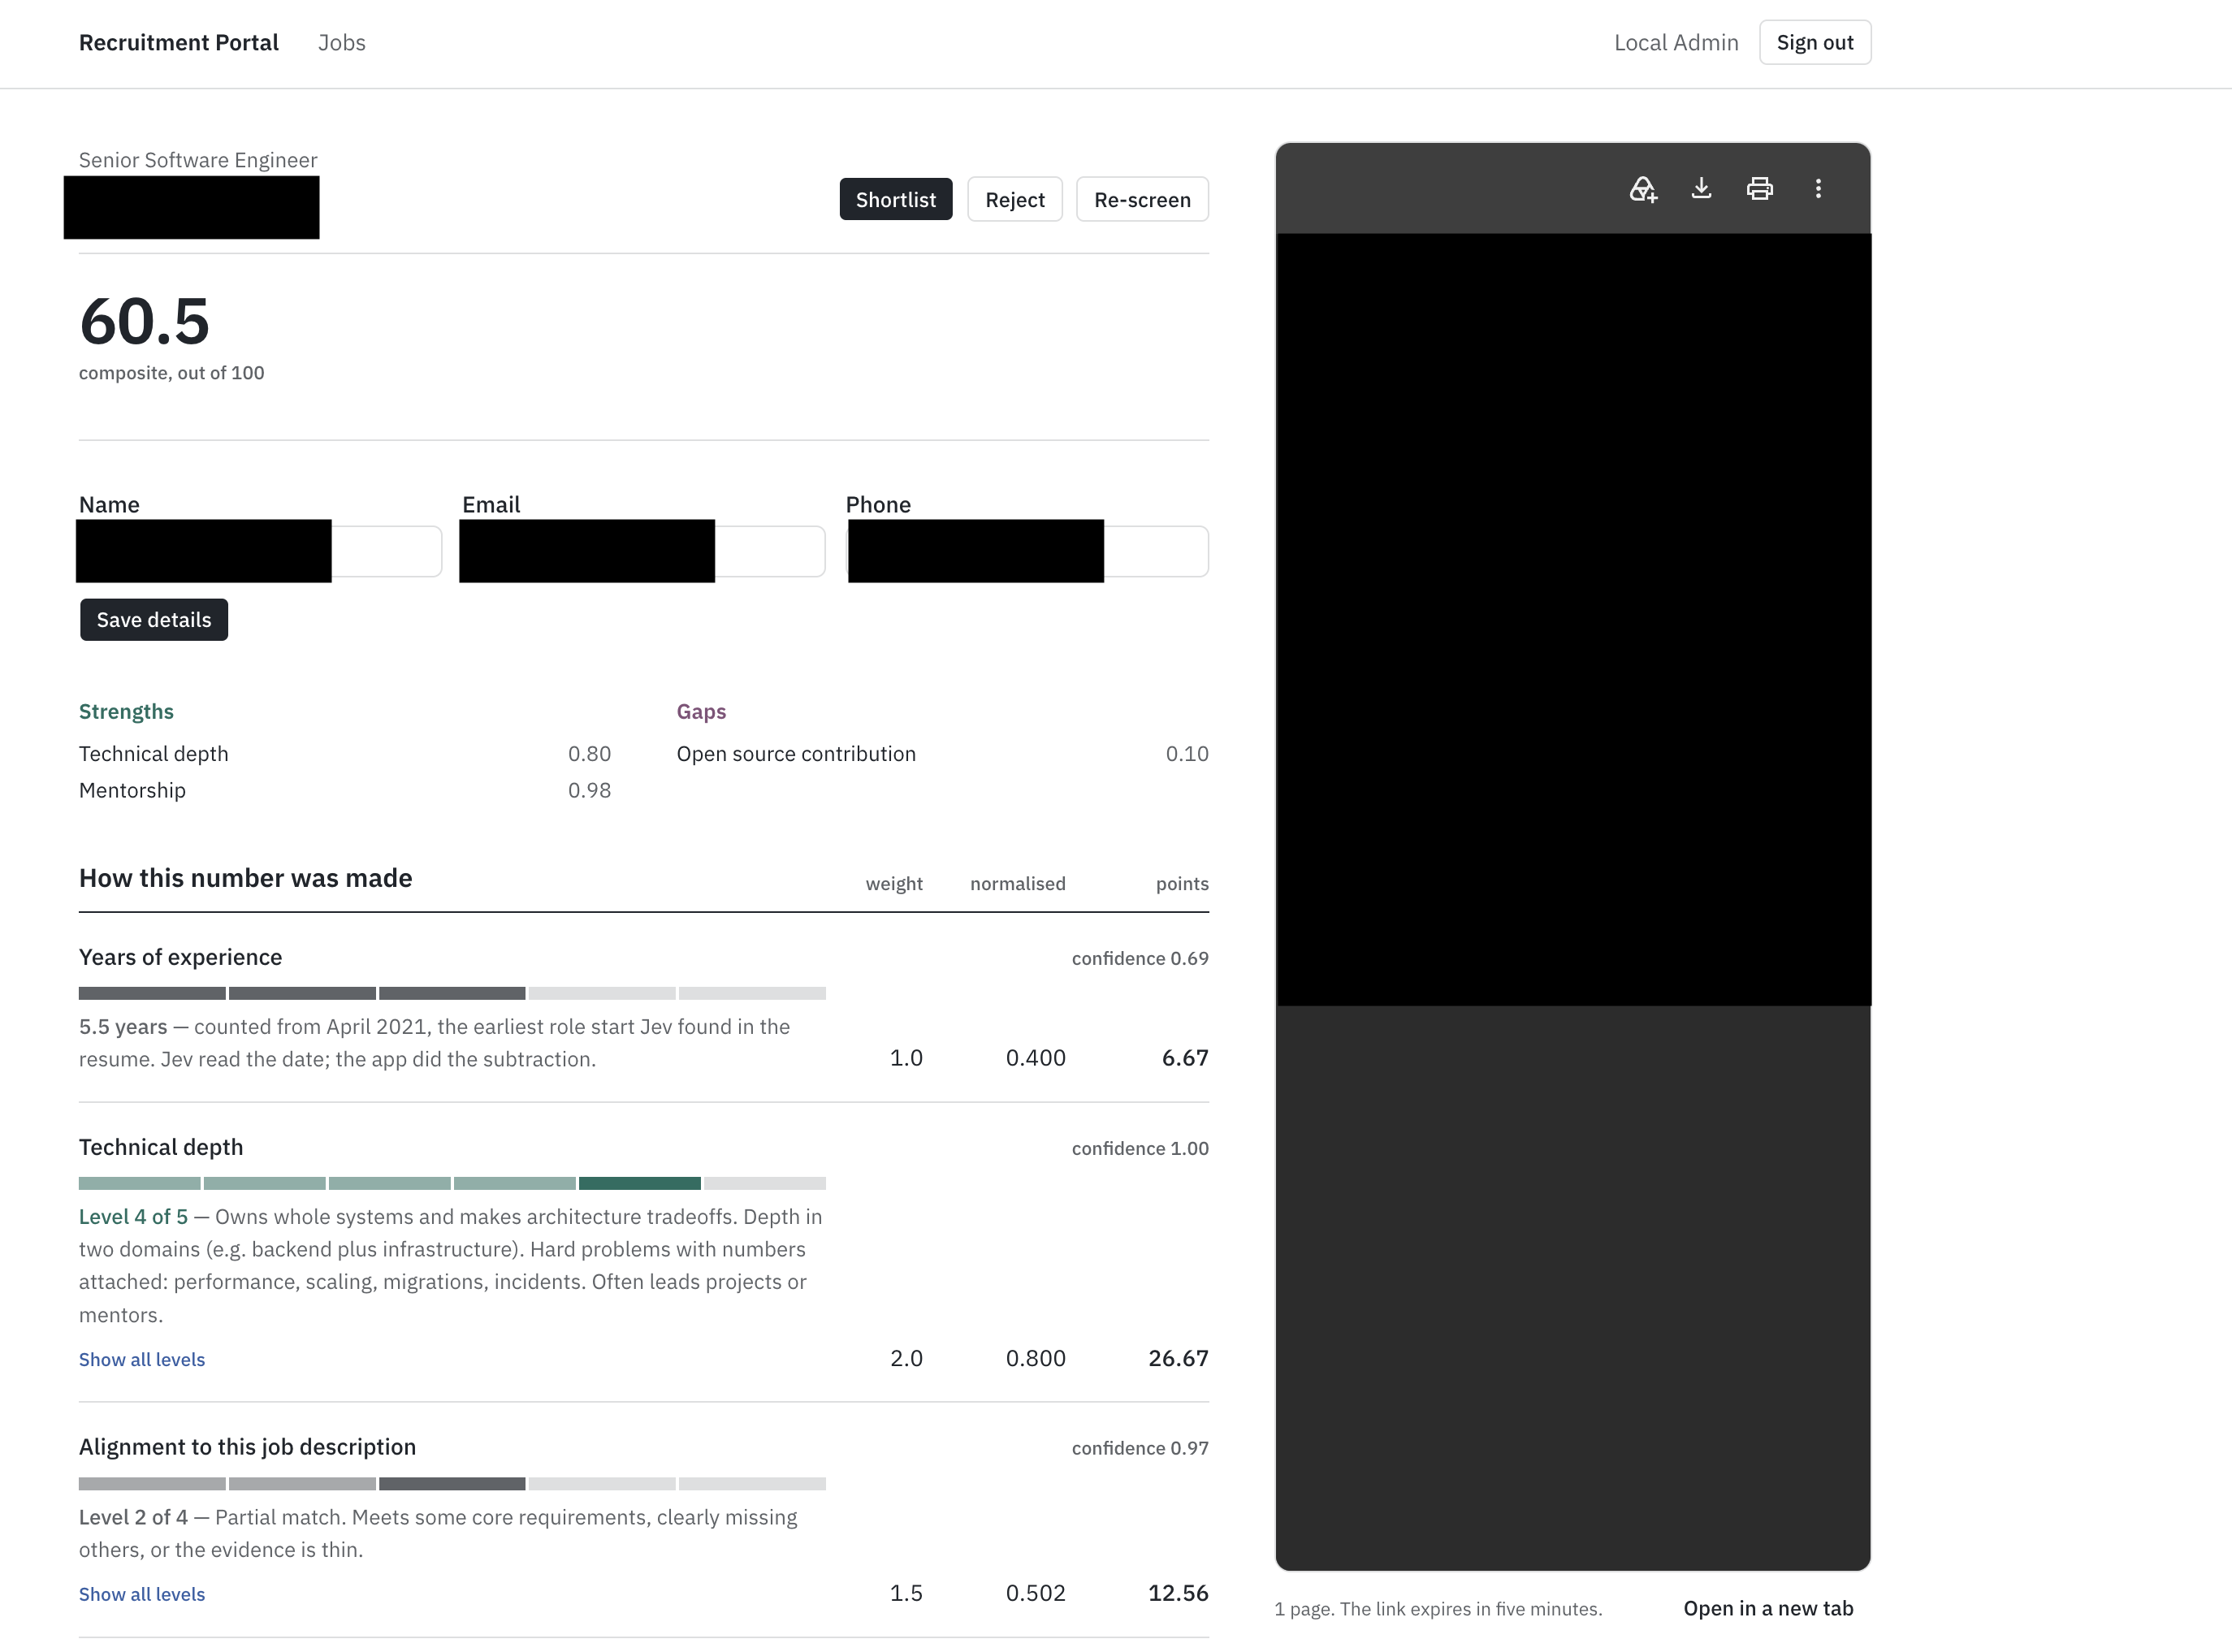
而且没有 years_of_experience 问题。它是推导指标,在代码中根据底部可见的两个最早角色起始时间计算得出。这种缺失正是设计的核心所在。
三种问题类型
Score 针对你定义的有序层级评估状态。这些层级充当契约:Jev 读取每一级并返回跨层级的概率分布,以及该分布的期望值,即分数。
重要的是,层级描述的是行为,而非数字。例如,“在实时系统中端到端负责特性”是 Jev 能在简历中识别的内容,但“6 年”是它无法计算的数字。我们稍后会重新讨论这一点。
Noul 是是非题,答案即为答案为是的概率。这就是整个响应:一个数字。没有单独的置信度字段,因为不确定性已体现在数值中。例如,0.95 表示高置信度,而 0.52 表示模型不确定。你还可以在标准中描述真和假的含义,这有助于处理边缘情况。
Choice 从集合中选择一个选项。它返回选定的键、每个选项的概率以及置信度分数。关键点在于 Choice 是相对的:它选出最匹配的选项,而不是判断是否有选项匹配良好。
相比之下,Noul 是绝对的,对所有选项都可能很低。这种区别在选择使用哪种类型时很重要。例如,“这位工程师属于哪种类型”是 Choice,而“此人是否进行导师指导”是 Noul。
置信度
Score 和 Choice 的答案包含 0 到 1 之间的置信度值。这不是单独的判断,而是基于概率分布的统计量。如果所有概率都集中在一个选项上,置信度为 1.0。如果均匀分布,置信度为 0。对于 Score,平坦的分布意味着层级不清晰或简历信息不足。对于 Choice,这意味着没有选项脱颖而出成为赢家。
概率决定了选择哪个答案,而置信度则决定是否可以据此采取行动。TypeSafe 的文档建议划分三个等级:高置信度表示可自动处理,中等表示需人工复核,低置信度则应移交给人工处理。
这些边界的设定取决于风险等级。例如,资历标签填错了可以修正,但错误地拒绝候选人则无法挽回,因此在得分较低时应更加谨慎。
在我们的门户中,阈值为 0.5,低于该值的都会被标记为需人工复核。筛选引擎的代码展示了这个参数的位置。
速度与成本
对于此类请求,Jev 的响应时间在 70 到 500 毫秒之间。这个速度足以在用户等待时直接通过 Server Action 处理,因此门户无需背景任务队列。
定价为每百万输入 token 0.042 美元,输出 token 免费。一份两页简历加上职位描述大约包含 1,500 个 token。问题本身也会计费且并不少:8 个默认标准加上 3 个系统问题,每次筛选会增加大约 3,000 个 token。因此,单次运行消耗约 4,500 个输入 token,成本约为 0.02 美分。每周处理 350 份简历的成本大约为 7 美分。
每个请求的上下文限制为 64,000 个 token,其中 32,000 个用于状态和最长的单个问题。典型简历不会触及此限制,但附带附录的 15 页 CV 可能会,因此筛选引擎代码中增加了相应的防护。
Jev 不是什么
大多数文章都会跳过这部分,但它解释了下一节中的设计决策,因此很重要。
Jev 不生成文本。 没有摘要、没有理由说明,也没有“候选人得分较高是因为……”这样的句子。招聘者看到的唯一解释是各标准的得分明细,因此标准本身必须写得能自解释结果。这是一个设计约束,也决定了标准编辑器的运作方式。
Jev 不是计算器。 数数、加减运算或日期比较都不可靠。例如,Jev 会将“2022 年 1 月 - 至今”视为文本而非时间段。任何算术运算都应在你的代码中处理。
Jev 只能读取文本。如果简历是扫描图片,就没有可供 Jev 评分的文本。门户会直接拒绝这类文件,而不是假装处理。
Jev 是字面化的。它只回答你写下的确切问题,而不是你以为的意思。"not" 这类词、隐含条件和范围限定,都会被按字面理解。
"从不产生幻觉"的实际含义比听起来更有限。Jev 不会返回你定义范围之外的值,既不会凭空发明新的职级,也不会用一句话来回答 Noul。这是真实的保证,因此不需要额外的解析层。
但这不代表 Jev 永远正确。比如,它可能给一个明显只是中级的人打出 0.85 的"senior"分数。类型系统是可靠的,但判断本身仍可能出错。校准(calibration)告诉你这种错误发生的频率。
这些限制都会在下一节体现为具体的设计决策,其中几项还会在文末的首次运行数据中有所体现。
应用的整体结构
在动手构建之前,先了解整体结构和每个部分的取舍原因会很有帮助。这里的多数选择都源于 Jev 的能力与限制。搞清楚每个部分为什么存在,你才能知道该为自己的需求做哪些调整。
 ┌─────────────────────┐
 │  使用笔记本电脑的HR  │
 │  (浏览器)            │
 └──────┬──────┬───────┘
        │      │  ① PDF 通过签名 URL 直接上传至 Storage ——
        │      │     不经过服务端 Action 请求体
        │      └──────────────────────────────────────────────┐
        │ 页面、服务端 Actions                                 │
        ▼                                                     ▼
 ┌────────────────────────────────────────────┐   ┌────────────────────────────┐
 │  Vercel 上的 Next.js                       │   │  Supabase                │
 │                                            │   │                            │
 │  proxy.ts        刷新会话、重定向          │◀─▶│  Auth      每次渲染时调用  │
 │  服务端 Actions  所有入口使用 Zod 验证     │   │            getUser()      │
 │  scoring.ts      纯函数——唯一的数值生成点  │◀─▶│  Postgres  6 张表,全部启用│
 │                  ⑤                          │   │            RLS,仅追加写入│
 │                                            │   │            筛选记录        │
 │                                            │◀─▶│  Storage   私有桶,使用    │
 └───────┬───────────────┬───────────────┬────┘   │            签名 URL        │
         │ ②             │ ③             │ ④      └────────────────────────────┘
         ▼               ▼               ▼
 ┌──────────────┐ ┌───────────────┐ ┌──────────────────┐
 │ unpdf        │ │ AI Gateway    │ │ TypeSafe Jev     │
 │ 解析文本,随后│ │ → 小型 LLM    │ │ 一次调用 systemOne│
 │ 从几何结构提取│ │ 提取姓名、邮箱、│ │ 并发处理所有问题  │
 │ 阅读顺序     │ │ 电话——别无其他 │ │                  │
 │ (进程内处理)  │ │               │ │ jev-1.13.0       │
 └──────────────┘ └───────────────┘ └──────────────────┘

 ① 上传   ② 提取   ③ 联系方式字段   ④ 评分   ⑤ 计算 + 持久化
一份简历的旅程
以下是从 HR 上传简历到分数出现在表格中的全过程。
浏览器使用服务端生成的签名 URL 直接将 PDF 上传至 Supabase Storage。上传过程完全不经过我们的服务器。
服务端动作从 Storage 下载 PDF,并利用 unpdf 提取纯文本。若文本长度远少于预期页数对应的水平,简历会被标记为失败,并提示“疑似扫描件”。若无有效输入,流程随即终止。
文本经由 Vercel AI Gateway 发送给小型 LLM,以提取候选人姓名、邮箱及电话号码。这是系统中唯一的生成式步骤,且为可选项。
职位描述、录用标准及简历文本合并为单个 Jev 请求。所有问题在一次调用中处理完毕。
代码根据 Jev 的回答计算综合得分,将各项标准标记为优势或缺失,检查置信度,并保存至 Postgres。
数据表格随之更新。耗时主要集中在 PDF 解析和信息提取,而非 Jev 的处理。
数据模型
六张表格支撑应用的全部数据。
jobs ─────────┬── job_criteria        (该职位对应的 Jev 问题)
              │
              └── applications ────── screenings ────── screening_answers
                  (每个简历一行)     (每次运行一行)     (每个问题一行)

profiles      (每个 HR 用户一行,镜像 auth.users)
jobs 表存储职位名称及粘贴的职位描述。由于每次调用 Jev 时,职位描述都包含在其状态中,因此直接存为文本,而非指向另一文档的链接。
job_criteria 是关键所在。每行即一道 Jev 问题,包含类型、指令、等级或选项、权重,以及是否计入综合得分的标志位。HR 创建职位时,系统会将默认标准集克隆至此表,供其编辑。HR 编写的问题 就是 筛选逻辑。系统中不存在任何提示词(prompt)。
applications 每个上传的简历对应一行。它缓存提取出的文本,使得 HR 修改标准后重新筛选时无需重新解析 PDF。
screenings 每次筛选运行对应一行,而非每个申请。每当简历被评分,便新增一行。旧记录保留不动。
screening_answers 将每个 Jev 回答展平为独立行:原始值、归一化值、置信度及区间带。这是表格排序和过滤的依据。
profiles 表对应 Supabase 的 auth.users 表,额外增加了一个显示名称字段,由数据库触发器在管理员创建用户时自动填充。
几个值得说明的设计决策
1. 筛选标准存在数据库里,按职位区分,而不是写死在代码中。
另一种做法是在配置文件里写一套固定的评分标准,我们最初就是这么做的。结果一位招聘负责人提出:“这个岗位我不在乎有没有带教经验,但开源贡献非常重要”,这套方案就行不通了。
把标准存成数据库行之后,改个权重只需在表单里操作;如果标准写死在代码里,每次调整都得重新部署。由于每个新职位都会复制一份默认标准,新建职位时自动带上合理的基础配置,只在负责人有特殊要求的地方做修改。
2. 综合得分始终由我们自己的代码计算,而不是交给 Jev。
原因有三点。
第一,Jev 的文档明确说明其评分输出不适合当作精确数值使用。这些等级更适合做阈值判断,而不是精确打分。
第二,代码里的加权求和易于审计,模型的判断则不然。如果有人问某位候选人为什么得了 71 分,你可以直接展示公式和输入。
第三,如果负责人想调整权重,只需改一个系数,然后在几毫秒内重新计算所有候选人的得分。如果综合得分由模型内部生成,这就做不到了。
3. Choice 类型问题用作标签维度,不参与计分。
Choice 是从一组无序选项中给出一个标签。比如 backend_engineer 并不比 mobile_engineer 更"值钱"。如果让 Choice 参与综合得分计算,就得给这些类别随意赋数字,得出的分数会有误导性。因此 schema 强制所有 Choice 的 include_in_composite 关闭,UI 中则把它们展示为筛选列。你可以先筛选出 full_stack_engineer,再按得分排序——两个操作互不干扰。
4. 筛选采用同步方式。
不引入队列、worker 或轮询。Jev 的响应远低于一秒,较慢的环节(如 PDF 解析和抽取 LLM 调用)也能在普通 server action 的超时时间内完成。
"调用 AI 模型就得上任务队列"是常规架构思路,但那只会平白多出一个活动部件,没有实际收益。将来如果需要一次性批量导入数百份简历,筛选函数本身已经独立成模块,可以直接挪到队列后面,其他部分完全不用动。
5. 两次模型调用分别处理不同任务。
姓名和邮箱的提取使用 LLM,因为需要从简历中提取自由文本,而 Jev 不擅长此任务。评分由 Jev 负责,它是基于固定标准集进行判断的,正如前文所述,LLM 并不适合这类工作。若用一个模型同时处理两项任务,反而会导致性能妥协。
6. 筛选历史仅支持追加。
应用程序永不删除任何筛选记录。当评分标准变更并重新评分时,旧分数与新分数并存。这种方式存储开销极低,且带来两大好处:为“该候选人为何 9 月被拒”等问题提供审计轨迹,以及观察标准变更对整体候选人池的影响。
7. 文件直接上传至存储。
Vercel Serverless 函数对请求体大小限制为 4.5MB。多数简历 PDF 小于 1MB,但部分(如设计师作品集)体积可能大得多。使用签名 URL 直接上传至 Supabase Storage 可规避此限制,且对用户更快,因为文件只需传输到一个目标位置。
安全模型
所有 HR 用户权限相同,因此这是一个单角色应用,安全模型简洁明了。所有表都启用了 行级安全(Row-level security)。已认证用户拥有完全访问权限,匿名角色则无任何权限。由于没有公开的申请表单,任何未认证请求都不应触碰数据。
存储是私有的。简历通过会在数分钟内过期的签名 URL 发送至浏览器。Supabase 的 service-role 密钥仅在服务器端代码中使用,绝不下发到客户端。
管理员在 Supabase 仪表盘中创建用户。系统没有注册页、邀请流程或密码重置表单。这是有意为之。对于一个只有少数用户的内部工具,增加这些功能只会增加安全风险而无实际收益。
我们刻意不构建的功能
系统不包含测试、后台任务、公开候选人门户、邮件通知或 ATS 集成。这些功能虽合理但超出本文范围,因为这本手册专注于筛选逻辑。添加它们会分散对核心主题的注意力。
如何构建简历筛选应用
到目前为止,我们重点讨论了数据模型。接下来将讨论应用程序本身。这部分的结构与传统教程有所不同,让我解释一下原因。
代码仓库:https://github.com/MTechZilla/recruitment-portal
为什么用提示词而非代码?
如果是在 2020 年,我会在开发应用时分享每一个文件:我写代码,你照着复制。但这并不是本应用的制作方式。仓库中的每一行代码都是由 Claude Code 根据书面简报,一次任务接一次任务生成的。如果直接复制输出并谎称是自己写的,那是不诚实的,且过程才最重要。
下面每个章节都会分享我使用的提示词,并解释其要求及原因。每个提示词生成的代码都在仓库中。
在开始运行任何内容之前,有三件事需要理解。
CLAUDE.md 是“宪法”。它位于仓库根目录,承载着所有必须跨会话保留的约束:技术栈、Jev 合约、安全规则以及复合公式。
每个任务提示词都以“读取 CLAUDE.md”开头。这能防止第六个任务悄悄撤销第二个任务中做出的决定。你可以在仓库中阅读完整文件。Jev 部分本质上是“什么是 TypeSafe Jev,什么是 TypeSafe Jev 不是”压缩而成的规则。
# 招聘门户 — 项目章程

内部 HR 门户。HR 创建职位、逐个上传简历 PDF,应用使用 TypeSafe AI 的 Jev 模型对简历进行筛选。单一角色,仅支持登录。

本文件是唯一事实来源。每次会话开始时都重新阅读。当任务提示与本文件冲突时,以本文件为准 —— 要标记冲突,不要悄悄自行取舍。

---

## 技术栈 — 不得偏离

- Node v24.21.0、npm
- Next.js App Router、TypeScript strict,所有应用代码放在 `src/` 下
- Supabase(Auth + Postgres + Storage),通过 `@supabase/ssr` 使用;本地开发使用 Supabase CLI
- Tailwind CSS + shadcn/ui
- 列表使用 TanStack Table
- `@typesafe-ai/sdk` — 打分。开发环境使用 `jev-latest`,生产环境固定为带版本号的 id(当前为 `jev-1.13.0`),见 DEPLOY.md
- `unpdf` — PDF 文本提取
- Vercel AI SDK + Vercel AI Gateway — 仅用于候选人字段提取,绝不用于打分
- Zod — 所有输入、所有环境变量
- CI/CD 用 GitHub Actions,托管用 Vercel
- **不引入测试框架。** 不要添加 Vitest 或 Playwright。
- **新增此处未列出的任何依赖前必须先询问。**

---

## Jev 不是 LLM — 动筛选代码前必读

Jev 只返回带校准概率的类型化值。它不输出字符串,不会幻觉出你定义的 schema 之外的值,也不会产生类型错误。一次请求中的所有问题都基于同一个 `state` 并行、相互独立地求值。增加问题几乎不影响延迟,所以一次性发出所有问题。

### 三种原语及其确切的响应结构

`POST https://api.typesafe.ai/v1/systemone`,请求体为 `{ state, model, questions }`。
响应:`{ model, answers, usage: { input_tokens, output_tokens } }`。每个 answer 都带 `type` 字段,且位于你在 `questions` 中使用的同名 key 下。

| type | criteria | answer |
|---|---|---|
| `score` | 2–10 个有序等级描述的数组,从低到高 | `{ type, score: float, legend: {"0": desc, ...}, probabilities: {"0": p, ...}, confidence }` |
| `noul` | 可选 `{ true: desc, false: desc }` | `{ type, noul: 0..1 }` — **没有 confidence 字段** |
| `choice` | 选项 → 描述(或 null)的映射,最多 255 个选项 | `{ type, choice, probabilities: {opt: p, ...}, confidence }` |

`probabilities` 和 `legend` 是**以字符串为 key 的 map**,绝不是数组。`score` 是跨等级的概率加权期望值,可能落在两个等级之间。

`instructions` 接受字符串、对象或数组。对象可以把问题放一个字段、数据放其他字段;在反引号中用名称引用数据字段。

编写读取 answer 的代码前,先阅读 `/sdk/javascript.md` 了解 SDK 的响应访问器。不要仅凭这些表格假设数据结构。

### 由此推导的规则

- 绝不问一个笼统的"给这份简历打个分"的问题。拆解为原子化的问题。
- **综合分由我们自己的代码计算。** 绝不让 Jev 给出最终数字。
- **没有 AI 生成的总结。** 优势和短板由代码根据各维度分数的区间划分得出。不要添加 LLM 调用来为候选人撰写描述性文字。
- **`choice` 类型的问题是切面,不是打分输入。** 它们的选项没有顺序 —— `backend_engineer` 不比 `mobile_engineer` 值更多分。它们只作为展示和筛选用列。绝不用索引把 choice 编码成数字。
- **`noul` 不返回 confidence。** `min_confidence` 只在 `score`、`choice` 和 `derived` 的 answer 上聚合。noul 的不确定性表现为接近 0.5;当 `|noul - 0.5| < 0.15` 时,标记该 noul 供人工审核。
- **Jev 不是计算器。** 它把日期当文本读取,不能计数、相加或比较日期。所有算术步骤都在 `src/features/screening/lib/scoring.ts` 中完成。Jev 的职责是*识别*文本中哪个值是我们要的,其余交给代码。
- **State 是数据。** Jev 不会执行 state 中的指令,但简历中的对抗性文本仍可能影响答案。criteria 必须精确。
- Confidence 是路由信号,不是质量信号。低置信度意味着"需要人工查看",绝不是"候选人不行"。UI 文案必须体现这一点。

### 问题分类

**职位标准** — `job_criteria` 表中的行,由 HR 编写,创建职位时从 `screening-criteria.default.json` 克隆。类型:`score`、`noul`、`choice`、`derived`。

**系统问题** — 固定、始终发送、不放入 `job_criteria`、不作为切面展示。定义在 `screening-criteria.default.json` 的 `system_questions` 下:
- `is_resume`(noul)— 守门问题。低于 0.5 时,申请直接标记为失败,不打分。
- `earliest_role_start_year`(choice)— 选项是用正则从简历文本中提取的四位年份,外加 `none`。请求时构建。
- `earliest_role_start_month`(choice)— 十二个月外加 `none`。

**派生标准** — 类型为 `derived`。不发给 Jev。在 `scoring.ts` 中由系统问题的答案加上当天日期计算得出。`criteria` 存放把计算值映射到等级的数值阈值;`instructions` 存放 `{ "source": "<name>" }`。派生值的 confidence 取其用到的系统问题答案中的最小 confidence。默认配置中唯一的派生标准是 `years_of_experience`。

### 综合分公式

```
score question:   normalized = score / (levels.length - 1)
noul question:    normalized = noul                          // already 0..1
derived question: normalized = level_index / (thresholds.length - 1)
choice question:  excluded from the composite entirely

composite = 100 * Σ(weight_i * normalized_i) / Σ(weight_i)
            over questions where include_in_composite = true

band: normalized >= 0.70 → 'strength'
      normalized <= 0.35 → 'gap'
      otherwise          → 'neutral'
```

这些逻辑放在一个纯函数模块 `src/features/screening/lib/scoring.ts` 中,无任何 I/O。`today` 是它的参数,绝不在模块内部读取系统时钟。

### 请求预算

每请求上下文 64k tokens,其中 `state` 加最长的问题占 32k。调用前先估算 tokens(字符数 ÷ 4 即可)。如果 state 会超过 28k tokens,将该申请标记为失败,并提示简历过长无法筛选。不要静默截断。

### 模型版本管理

响应的 `model` 字段会报告实际作答的带版本号的 id。每次筛选都要把它存入对应行。`jev-latest` 会随 TypeSafe 发布新版本而变化,针对某个版本调优的阈值在下一个版本上可能不成立。开发环境用 `jev-latest`;生产环境固定为带版本号的 id。

---

## 架构规则

- `src/app/` 只放路由 — 保持薄,零业务逻辑。
- Feature 自包含:`src/features/<name>/{components,hooks,lib,server,types}`。
  `server/` 存放 server actions 和 route handlers。
- `src/components/ui/` 只放 shadcn 生成的代码。不要手动编辑生成文件。
- `src/lib/` 存放客户端实例和 `env.ts`。`src/utils/` 只放纯函数。
- 没有第二个使用方之前不做抽象。
- 优先使用 server components。仅在确需交互时才用 client components。

---

## 安全 — 不可妥协

- **每张**表都启用 RLS。`authenticated` 拥有完整 CRUD,`anon` 什么都不给。任何地方都不允许对 anon 使用 `USING (true)`。
- `resumes` bucket 为私有。只用短期签名 URL。绝不用公开 URL。
- `service_role` key 仅限服务端使用。绝不放进 `NEXT_PUBLIC_`,绝不出现在 client component 中。
- 每个 server action 在操作数据库前都要用 Zod 校验输入。
- 环境变量在 `src/lib/env.ts` 中用 Zod 解析并校验;缺少变量时大声报错。
- `TYPESAFE_API_KEY` 和 AI Gateway key 仅限服务端使用。

---

## 认证模型

单一角色 — 每个已认证用户都是权限完全相同的 HR 用户。仅支持登录:**没有注册路由、没有注册 UI、没有自助密码重置、没有邀请流程。** 管理员在 Supabase dashboard 中创建用户。路由保护需要 middleware **和** 受保护 layout 中的服务端 session 检查双保险;仅靠 middleware 不够。

---

## 工作约定

- 实现前先给出简短计划。涉及结构性变更时暂停等待批准。
- 未经明确批准,不部署到 Vercel,不触碰云端 Supabase 项目。
- 每个会话只做一个任务。任务之间提交代码。
- 如果某事无法按规范完成,停下来明说。不要悄悄绕过。
每个任务都在独立的 Claude Code 会话中执行。乍看之下,这可能显得效率低下,但你会发现在经历漫长的会话后,模型开始受到前期任务的干扰,产生噪点。到了第八个任务,它往往会混淆概念并出现错误。从零开始,配合清晰的提示词和指导原则,产出的代码质量会远好于试图回忆之前所有内容的做法。
务必在不同任务之间提交代码,这样一旦出现意外情况,就可以轻松回滚。
screening-criteria.default.json 文件是核心评分标准。它位于仓库根目录。其中包含了一组默认问题:既包括 HR 在创建职位时会使用的各项筛选条件,也包括始终生效的系统性提问。
任务 2 利用该文件初始化数据库;任务 4 会为每个新职位复制该文件;任务 6 则从中读取内容以构建所有 Jev 请求。这是定义“优秀候选人”标准的唯一数据源。由于它属于数据而非代码,你可以随时更新筛选标准,而无需改动任何 TypeScript 代码。