
《AIAgent入门》第 04 篇
《AI Agent 入门》第 04 篇 · 共 21 篇
LLM:Agent 的大脑,与“模型即 Agent”新范式
第 1 章 · 决策核心与 Harness 之辩
手脚讲完,轮到大脑。大语言模型(Large Language Model,LLM,就是那个读得懂也写得出人话的超大神经网络)是 Agent 的决策核心:收到请求,它先解析真实意图——用户嘴上说的,往往不是他真正想要的——再把模糊又复杂的任务拆成能执行的步骤。
干活途中它还得不停做判断:下一步做什么、要不要调用工具、调哪个、传什么参数。这种"理解—规划—执行"的本事来自预训练,工作流和自主 Agent 都得靠它。
一、大脑的两层本事:预训练攒知识,后训练定策略
LLM Agent 有一个独门能力:内部思考——真正动手之前,先在脑子里规划推演一遍。这一步不改变外部环境,却能显著提升后续行动的质量。它推得动,靠的是预训练(Pre-training,在海量互联网文本上做初始训练,让模型学会语言规律和世界知识)沉淀下来的逻辑规则:数学定律、因果关系、问题分解策略。
所以它跟传统的强化学习 Agent 不一样:今天基于 LLM 的 Agent 不是瞎蒙乱试,而是站在结构化的知识体系上干活。再打个比方:预训练像一个人读了万卷书,后训练(Post-training)像上岗培训,把"碰到什么事该怎么反应"固化成习惯。
【大白话】
预训练攒下"知道什么",后训练攒下"习惯怎么干"。前者决定它懂不懂,后者决定它稳不稳。两层叠起来,才是 Agent 的大脑。
二、"模型即 Agent":工具调用被吃进了肚子里
"模型即 Agent"(Model as Agent)是目前最新的范式:先进模型通过后训练(尤其是强化学习)把工具调用内化为原生能力——什么时候调、调哪个、传什么参数,模型自己说了算,不再靠人工在外面编排。
但这不代表框架层不重要,恰恰相反:模型越强大,围绕它构建的 Harness 就越关键。Harness 这词原指马具,是套在马身上的缰绳与挽具——它不是为了限制马跑,而是把这股力量引到正确的方向上。放到 Agent 里,模型是那匹强大但不可预测的马,Harness 是把它的本事引导成可靠任务执行的工程外壳。
| 比喻里的角色 | Agent 里是谁 | 管什么 |
| 马 | 模型 Model | 做决策,决定能力上限 |
| 缰绳与挽具 | Harness | 上下文管理、工具接口、安全约束、验证与纠正 |
| 把马拉到正道 | 可靠的任务执行 | 让再强的马也按路线跑,不翻车 |
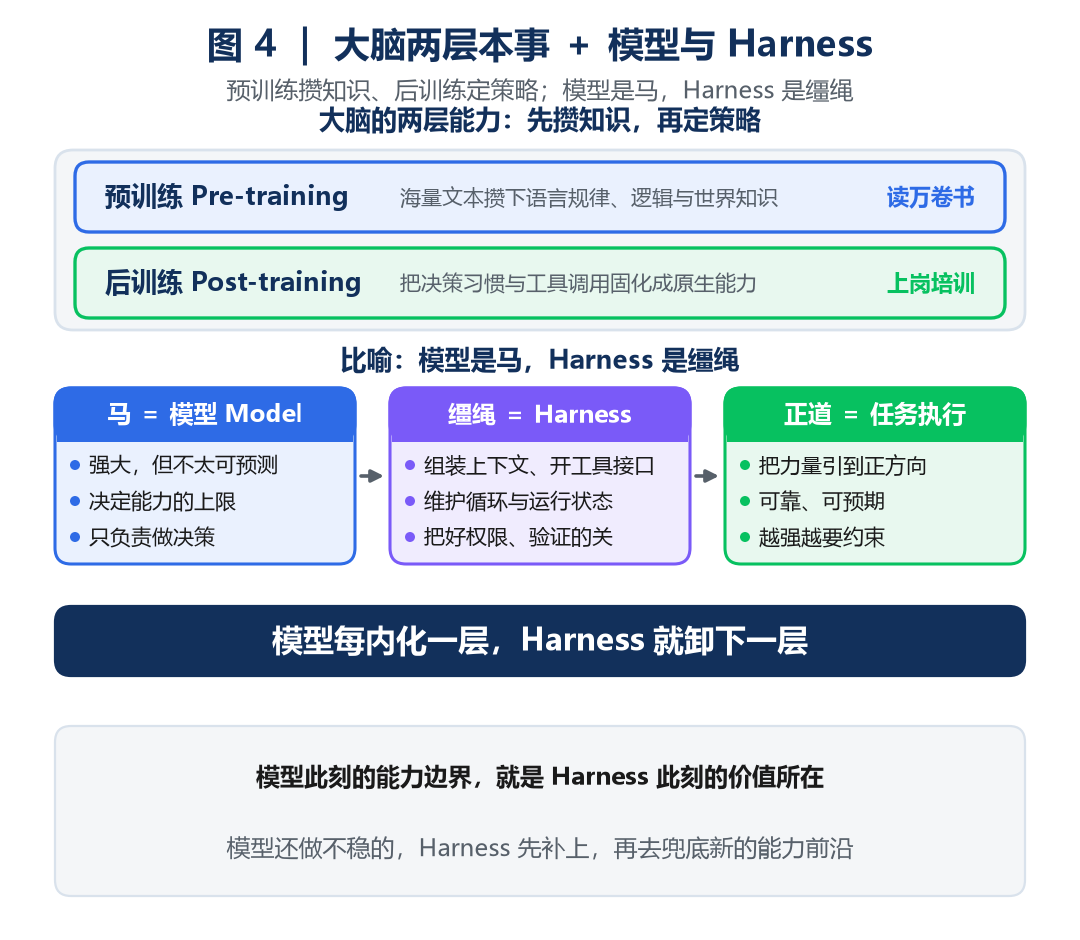
图 4:上为大脑两层能力,下为"模型是马、Harness 是缰绳"的比喻
三、Harness 早晚被模型"吃掉"吗?
模型自主决策的空间越大,出错时的影响面也越大,越需要更精细的约束、验证和纠正。往深了想还有一问:如果模型一直变强,今天这些 Harness 是不是迟早被它"吃掉"?Rich Sutton 在《苦涩的教训》里回顾了 AI 研究七十年反复上演的一幕——研究者一次次把对领域的理解写死进系统,短期见效,长期却总输给能随算力和数据规模持续扩展的通用方法:搜索与学习。
照这个标准,Harness 里的约束、验证与纠正,有多少属于注定会被模型内化掉的"人类先验"?本书的立场一句话:方向认同,节奏务实。方向上,不怀疑模型会持续吃掉 Harness——工具调用、长程规划都曾靠外部编排,如今已是模型的原生能力;节奏上,这个"吃"比想象中慢得多:训练以月计,模型也没法一次性吃下真实业务里所有的约束与偏好。
记住这句
模型此刻的能力边界,就是 Harness 此刻的价值所在。模型还做不稳的,Harness 先补上;模型每内化一层,Harness 就卸下一层,转而去兜底新的能力前沿。
大脑有了,可它每一步只能看见"上下文"里那点东西。下一篇:Agent 怎么越用越强?先搞懂它的"眼睛":上下文。
你猜这层"缰绳"多久会被模型拆掉?评论区聊聊。
本文为《AI Agent 入门》第 1 章通俗解读,共 21 篇,配图为原创示意。