
Gemini 4 Argon:谷歌应对竞品新动向,首创1M输出Token
GDM 上一次推出比 Flash 更大规格的大模型还是二月的 3.1 Pro。在经历了连续的 3.x Flash 小版本迭代,以及上月 GDM 高层大规模换血之后,GDM 最大的悬念在于:当竞争对手相继推出 Fable 和 Astra 级别模型时,他们何时能跟上步伐?
现在,Argon 来了,跑分相当漂亮(在 19 个可信基准测试中有 13 项达到 SOTA 水平)…… 但目前仅限网络安全领域小范围预览,官方承诺“尽快”开放:
Google DeepMind@GoogleDeepMindIntroducing Gemini 4 Argon – our new frontier model. It’s built for complex workflows across coding, enterprise knowledge work, and cybersecurity defense – rolling out today to a set of trusted testers through our Fairwind Program.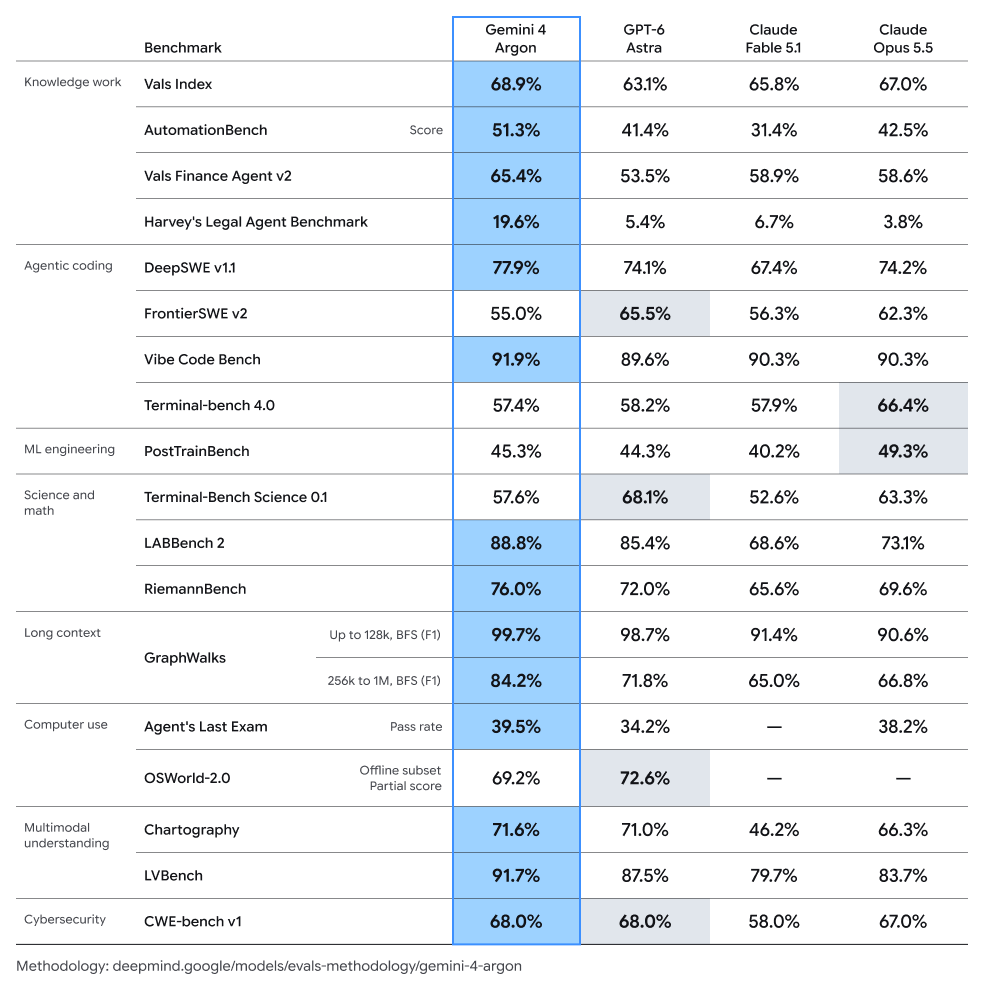 8:03 PM · Sep 30, 2026 · 3.42M Views
1.18K Replies · 2.81K Reposts · 26.4K Likes
我们比较看好那个实验性的 Long Decode Continuation,它是业内首创,将 输出 token 上限提升至 1M。
9/29/2026-9/30/2026 的 AI 新闻。我们巡查了 12 个 subreddit、544 个 Twitter 账号,未检查 Discord。在 AINews 网站 可以搜索过往所有期数。提醒一下,AINews 现已成为 Latent Space 的一个板块。你可以选择 订阅或退订 邮件推送频率!
AI 推特回顾
Gemini 4 Argon:Google 重返前沿
发布:Google DeepMind 推出 Gemini 4 Argon,面向编程、企业知识工作和网络防御场景(@GoogleDeepMind、@sundarpichai)。
开放范围:初期仅向 Fairwind Program 中的政府用户和可信网络安全防御者开放。Google 表示会先完善安全护栏,再逐步向开发者、企业和消费者开放(@Google、@demishassabis)。
输出上限:Google 称其输出上限达 1M token,远超此前 64K,属行业领先水平(@GoogleAI、@TheRundownAI)。
测量说明:Vals 列出的最大输出为 262K。Artificial Analysis 则借助 Long Decode Continuation 这一新的 API 功能实现了 1M 输出——该功能可暂停长响应,并在后续调用中继续生成(@ValsAI、@ArtificialAnlys)。
定价:标准定价为每 1M 输入/输出 token 4/20 美元,目前有 50% 限时优惠,降至 2/10 美元,截止日期未公布。缓存输入享 95% 折扣(@_philschmid、@ArtificialAnlys)。
Google 宣称的成绩:在公布的 19 项基准测试中,Argon 有 13 项击败 GPT-6 Astra 和 Claude Opus 5.5 排名第一。在 DeepSWE 上得分 77.9%,高于 Opus 5.5 的 74.2% 和 Astra 的 74.1%(@TheRundownAI)。
内部应用:Google 称 Argon agent 已释放超过 300 TiB 数据中心内存,并正在将超过 80 万行 C/C++ 内核代码迁移到 Rust(@kimmonismus)。
## [AINews] Gemini 4 Argon: GDM 对 Astra/Fable 的回应,配备 1M 输出 - 视频解码器:Agents 用安全的 Rust 替换了 32K 行 SIMD 代码,使现有的 Rust 移植版本在输出相同的情况下速度提升了 2.7 倍。 - 研究用途:团队表示,基于 Argon 构建的内部 agent 循环帮助完成了 CK 猜想(@mirrokni)。 - Artificial Analysis 评估:Argon 在 Intelligence Index 上得分为 53,与 GPT-6 Astra(53 分)持平,并略高于 GPT-6.1 Sol(52 分)(@ArtificialAnlys)。 - 单任务成本:按折扣价计算,Argon 单任务成本为 1.99 美元,而 Astra 为 3.26 美元;按标准价格计算,Argon 成本将升至 3.98 美元。 - Token 用量:成本优势源于价格而非效率。Argon 每任务平均使用 6.2 万输出 token,而 Astra 为 2.7 万。 - Agentic 工作:在 AutomationBench-AA 上以 77.5% 排名第一,在 Terminal Bench 4 上得分为 57%,落后于 Sonnet 5.5、Opus 5.5 和 Astra。 - 幻觉:在 AA-Omniscience 上,其幻觉率为 15%,而 Astra 为 51%。其代价是准确率较低:Argon 为 50%,而 Astra 为 63%(@aipulseda1ly)。 - Vals 评估:Argon 以 68.9% 位居 Vals Index 榜首,平均单任务成本为 15.68 美元(@ValsAI, @ValsAI)。 - 编码:它完美构建了 Vibe Code Bench 上的 30 个应用,而 Opus 5 为 25 个,Astra 为 24 个(@ValsAI)。 - 终端与安全:在 Terminal-Bench 4.0 上,成绩从 19.0% 提升至 57.6%。在 CyberBench 概念验证任务中得分为 70%,在 IOI 2024–2026 上得分为 100%(@ValsAI)。 - 效率:在 Vals Index 任务中,其输出 token 用量约为 Sonnet 5.5 的四分之一(@ValsAI)。 - Arena 及其他评估:Argon 在 Text Arena 中以 1525 分位居第一,在 Code Arena WebDev 中以 1679 分位列第八(@arena)。Agent Arena:综合排名第 8,在 3K 次初步会话的可操控性指标上位列第 1(@arena)。
PostTrainBench:得分 45.3%,较 Gemini 3.1 Pro 的 21.99% 有明显提升(@karinanguyen)。
质疑声音:部分观察者对公布的数字持怀疑态度。
法律基准测试:Argon 在 Harvey 法律基准测试中报告的得分为 19.6%,低于 Muse Spark 1.2 列出的 25.42%(@BlackHC)。
其他批评:评论者指出可能存在针对偏好数据的基准测试“刷分”行为,并对包括 DeepSWE 在内的部分数据提出异议(@teortaxesTex,@teortaxesTex)。
GPT-6.1 Sol 与 OpenAI DevDay 代理栈
独立评测:GPT-6.1 Sol 成为 MathArena 的新任第一(@j_dekoninck)。
Code Arena:在 WebDev 类别中以 1759 分排名第 3,比同价位($2/$10)的 GPT-6 Sol 高出 70 分(@arena)。
单任务成本:Artificial Analysis 测算,最大努力模式下单任务成本为 $0.72,而 Astra 为 $3.26,GPT-6 Sol 为 $1.04(@ArtificialAnlys)。
节省来源:Sol 使用的轮次更少,且缓存读取价格更低(@ArtificialAnlys)。
Luna 缺陷修复:OpenAI 修复了一个图像编码 bug,使 GPT-6 Luna 的智力指数增加了 1 点。
极速推理:OpenAI 宣称速度最高可达 300 tok/s。SemiAnalysis 报道其运行在 NVIDIA GPU 上,且处于低批处理大小状态,并非使用 Cerebras 硬件(@kimmonismus)。
实测报告:生成速度约快 8 倍,但端到端 agent 任务只快 2–4 倍,瓶颈在工具延迟(@sayashk)。
Computer use:提升最大,因为 UI 操作只需毫秒级响应。
成本:测试者约 2 小时就用光了每周限额。
产品层:DevDay 推出了 dots(带独立云端电脑的持久化 agent)、Decisions API 和 computer use(@latentspacepod)。
Sites:ChatGPT Sites 现在可以托管 MCP server,并将其变成可安装的插件(@mxstbr)。
用量额度:有用户获得了约 2500 美元的一次性额度,也有人抱怨用量限制被下调(@kimmonismus, @kimmonismus)。
其他发布:Embedding、图像/视频与开源模型
Perplexity 上下文 embedding:pplx-embed-v2-context-9b-preview 已在 Hugging Face 开放(@perplexity_ai)。
方法:模型对整个文档只编码一次,之后再对 chunk 向量做池化。训练时从上下文压缩模型蒸馏相关性,而非使用单一 gold-chunk 标签(@denisyarats)。
结果:在 ConTEB 上刷新了 SOTA。在 turbopuffer 的私有 context-bench 上,answer recall@10 比 voyage-context-4 高出 14.4 分,且用 1 KB 的 int8 向量替代了 8 KB(@turbopuffer)。
Cohere Embed 5:该系列包含 Pro 和 Fast 两个变体,共享同一 embedding 空间,因此可以用一个建索引、用另一个做检索(@cohere)。
Fast 层级:Cohere 表示,在成本比 Pro 低三分之一的情况下,其性能至少领先其他 Fast 层级模型 6 分。评估基于其新提出的 RCP-nDCG@10 指标 (@cohere)。
Ideogram 4.5:该编辑模型专注于无伪影的多轮编辑,并承诺开放权重 (@ideogram_ai)。
视频基准测试:Artificial Analysis 推出了 AA-Video-T2V v2.0,基于 1080p 分辨率及超过 68,000 次人工投票 (@ArtificialAnlys)。
领先者:Wan 3.0 以 $12/分钟 位列第一;Seedance 2.5 以 $34.12/分钟 位列第二;MiniMax H3 以 $4.80/分钟 与其统计持平。
Utopai X:基于 MiniMax H3 的后训练版本 Utopai X 首发即排名第三 (@ArtificialAnlys)。
开源与小模型:
Ling-3.1-flash:这款 500B 模型表现接近 GPT-5.6 Sol 和 Opus 5 (@kimmonismus)。在 Mobile App Arena 的开源权重模型中排名第二 (@DesignArena)。
Praxis-1:Runway 发布了一款开源权重的世界动作模型,并指出机器人策略性能可随第三人称视频数据增加而可预测地提升 (@agermanidis)。
Solar Mini 4:Upstage 报告该模型总参数量为 35B,激活参数为 3B。其 Intelligence Index 得分为 24,价格为 $0.10/$0.40 (@ArtificialAnlys)。
缓存惩罚:其任务成本仍约为 Luna 的 5 倍,因为其重复上下文的缓存命中率仅为 48%,而 Luna 高达 99%(@ArtificialAnlys)。
智能体研究、推理与系统
上下文语言模型(Meta):CLM 将上下文视为可编辑文件而非仅追加日志,其上下文管理策略通过权重学习实现,无需外部框架(@RulinShao)。
结果:在 24 小时多仓库智能体集群任务中,相同算力下得分高出 65%(@arankomatsuzaki,@natolambert)。
自适应推理算力:
TaH2:前视深度监督教会模型哪些难处理的 token 值得进行另一轮循环(@ZhihuFrontier)。
收益:在匹配的测试时算力下准确率提升 3.4pp,且扩展斜率陡峭 53%。
服务部署:MiniSGL 集成将不同循环深度的请求一起进行批处理。
AutoBenchmark(Meta):该项目实现了基准测试创建的自动化。在构思阶段,人类反馈优于单独工作的智能体,且难度可迁移至保留的求解者(@jaseweston)。
Stratego(国际军棋):一篇 Nature 论文介绍了首个超越人类的 Stratego AI,基于不完全信息下的 RL 和测试时计算构建(@ssokota)。
Prefill/Decode 分离:稳态分析表明,在相同的批大小和吞吐量下,分离架构可将平均交互性提高约 1/(decode-time fraction)(@ekzhang1,@cHHillee)。
影响:有助于 prefill 密集型工作负载,而非 decode 受限的低延迟服务。
编译器与硬件:
DeepSeek 上华为:DeepSeek 发布了开源 Ascend 工具包,其中的 TileLang 针对 Ascend 950 做了优化(@kimmonismus)。
AI 充当编译器:用模型把 Triton 直接编译为 PTX,再由验证器检查正确性、竞态和死锁问题。在 B200 上,FlashAttention 获得了最高 1.37 倍的加速(@Azaliamirh)。
Vera Rubin:Cognition 成为通过 CoreWeave 使用 Vera Rubin 的首家客户,称在相同解码速度下 token 吞吐量约为 GB200 的 4.8 倍(@cognition)。
DFlash 草稿模型:为 Ornith-1.5 推出的新草稿模型可实现最高 2.54 倍的无损加速(@ornith_)。
Agent 沙箱:Cloudflare 面向 agent 重建了 Containers,p50 可交互时间仅 648 ms(快 6 倍),快照功能已进入 beta(@mgamache)。
AutoRouter:Cloudflare 的模型路由器在内部测试中降低了约 30% 的成本(@ashleypeacock)。
安全、防护与评估可信度
推理链提取攻击:OpenAI 将一起隐藏推理链提取攻击活动的核心部分归因于与 Moonshot AI 有关联的个人(@kimmonismus)。
规模:OpenAI 在两天内记录到来自 4000 多名用户的 16000 次尝试,相关活动涉及的用户超过 15000 名。
外部研究者:他们对 Astra 的攻击在本周之前一直有效。补丁很难在产品各版本和第三方托管环境之间同步推送(@JSchaeff3r,@jonasgeiping)。
批评:Nathan Lambert 认为该漏洞的责任在 API 提供方(@natolambert)。
蒸馏防御:在未经后期强化学习验证的情况下评估防御措施,会制造虚假的安全感。强化学习能令简单攻击变得有效(@shidan_javaheri)。
嵌入式评估:Apollo Research 发布了针对前沿实验室外部评估者的原则,该评估者将获得类似员工的访问权限(@ApolloResearch)。
网络安全评估:在 CyberGym-E2E-AA 基准中,某些前沿模型在超过 85% 的任务上被安全机制拦截(@ArtificialAnlys)。
成本:GPT-6 Luna 或 MiMo-V2.6-Pro 在 100 万行代码库中执行约 100 次漏洞挖掘的成本约为 20 美元。
溯源与透明度:
SynthID Bio:AI 生成蛋白质的水印技术已在《自然》杂志发表,相关工具已开源(@demishassabis)。
AI 检测器规避:Opus 5.5 和 Astra 可以改写文档中超过 50% 的内容而不被 Pangram 标记(@ValsAI)。
智能体报告:一篇新的预印本探讨了 LLM 编写的关于智能体工作的报告实际透明程度(@jennyihuang)。
行业与政策
Factory 与 Cognition 争端:Factory 解除了 Chris Degnan 的顾问职务,指控他在参加 Cognition 董事会会议期间向其泄露信息(@matanSF)。
任命:Cognition 于同日宣布 Degnan 出任其首席营收官(@cognition)。
否认:Cognition 的 CEO 表示未分享任何 Factory 的信息,并称 Degnan 周一已辞去顾问职务(@ScottWu46)。
政治支出:Greg Brockman 承诺的第二笔捐给“Leading the Future”超级政治行动委员会(super PAC)的 2500 万美元已落空(@teddyschleifer)。
后续质疑:Alex Bores 询问这笔资金是否也覆盖了那些不公开捐款人身份的反监管组织(@AlexBores)。
OpenAI 财务状况:据《纽约时报》报道,OpenAI 年化收入接近 700 亿美元,正洽谈以 1.4 万亿美元估值融资 300 亿美元,IPO 推迟至明年(@srimuppidi)。
融资动态:专注于硬件工程 AI 工具开发的 Flow 完成 5000 万美元 B 轮融资,估值 7.5 亿美元(@parisingh)。
热门推文(按互动量排序)
Google:Argon 支持 100 万 token 输出 — 3.65 万
Cognition CEO 驳斥 Factory 的指控 — 3800
Ideogram 4.5 支持精准多轮编辑 — 3200
Arena:Argon 位列文本竞技场榜首 — 3000
AI Reddit 综述
/r/LocalLlama 和 /r/localLLM 综述
1. GLM-5.3 网络安全风险及本地推理支持
GLM-5.3 与高级网络攻击能力的扩散 \ Anthropic(热度:785):Anthropic 发布报告称,智谱/Z.ai 的开源权重模型 GLM-5.3 在自主网络攻击能力上跨过了一个重要门槛:在 ExploitBench 上端到端完成
50/410个 V8 漏洞利用,接近 Claude Mythos Preview 的56/410;此外在 Anthropic 内部的二进制漏洞利用任务中有4%实现了完整的控制流劫持,而此前模型接近于零。Anthropic 将风险归结为 能力 + 可获取性:GLM-5.3 可以广泛下载、价格相对便宜、拒绝微调较弱——据报道简单越狱成功率高达64–100%,而“ abliteration”技术可将拒绝率压到个位数低段,且几乎不损失能力。热门评论大多对 Anthropic 的说法持反对态度,认为这篇报告像是想打压一个接近 Anthropic 前沿水平的、更便宜的开源中国模型。也有评论者强调其合法防御用途,称 GLM-5.3 是他们做安全测试、改进自己软件的唯一实用工具。评论者普遍把 GLM-5.3 视为成本低、限制少且能力接近前沿的模型,有用户认为它适合用于“对自己软件做安全测试和改进”,本身并非恶意。讨论中提到的技术顾虑是:像 Anthropic 这类厂商的严格限制,可能妨碍防御性安全工作流——这类工作恰恰需要模型愿意分析敏感的漏洞利用或漏洞模式。
有评论者提到之前的 GLM-5.2 曾帮助应对过一次 Hugging Face 攻击,与之对比的是 Claude 据称拒绝提供帮助。核心观点在于:拒绝策略会削弱模型在应急响应或漏洞修复场景中的实用性,而限制更宽松的模型在防御性安全任务上反而更有实际价值。
添加 GLM-5.3-Flash (GLM5-Next) 支持 · 拉取请求 #27773 · ggml-org/llama.cpp (活跃度: 348): 已合并的
ggml-org/llama.cpp#27773为llama.cpp增加了对 GLM-5.3-Flash / GLM5-Next 的支持,使得这款 320B 的混合文本+视觉模型可以本地推理。该实现添加了 GLM 特定的 DSA 索引/池化、混合索引内存,以及新的glm5v视觉预处理/塔路径,同时复用了 Kimi-K3 KDA 层、DeepSeek 风格的 MoE/mHC 辅助工具、仅 MLA 注意力机制以及 DSV4 风格的 SwigLU 钳制;验证报告显示,随机模型的 logits 在 prefill/ubatching/decode 阶段与 Transformers 匹配,视觉嵌入一致性约为1e-5,部分对精度敏感的张量则保持非量化状态。 评论者担忧llama.cpp的模型支持正落后于新实验架构的发布速度,有人指出维护者的人力不足似乎是当前的实际瓶颈。还提出了一个技术兼容性问题:现有的 Unsloth 量化 reportedly 使用glm5next,而主线预期为glm5-next,因此当前主线可能无法加载这些量化模型。评论者指出 Unsloth 量化 PR 与主线
llama.cppPR 之间存在兼容性问题:一个将架构/模型类型标识为glm5next,另一个则使用glm5-next,这意味着如果不进行转换或元数据修复,主线llama.cpp可能无法加载现有的 Unsloth GLM-5.3-Flash 量化模型。有观点担忧
llama.cpp的支持进度落后于新模型的发布速度,尤其是新模型越来越多地采用需要特定加载器/运行时更改才能进行推理和优化的实验架构。有评论者认为,GLM-5.3-Flash 的支持在模型发布后又花了大约 “一个月” 时间,且进展很大程度上依赖于少数维护者。