
反驳Dwarkesh关于Computer Use的观点:OpenAI如何一周内上线其Jev竞品
三个月前,Dwarkesh 发布了他关于 RL 的精彩博客和播客节目,并 发布了一个引发众多 Computer Use 领域从业者不满的问题框架,用于他的 RLVR 视频文章:
Dwarkesh Patel@dwarkesh_sp这里有一个让我感到困惑且有趣的问题,它实际上揭示了很多关于当前 AI 进展本质的信息: 为什么 Computer Use 的进展如此缓慢?Computer Use 的验证是如此明确的。 我认为答案是,仅仅拥有一个领域……Dwarkesh Patel @dwarkesh_sp下一个训练范式是什么样的? 0:00:00 – 实验室正在做出的重大研究押注 0:02:12 – Grindability 与可验证性同样重要 0:06:10 – 仅靠 RLVR 能实现泛化吗? 0:08:41 – 将学习回归到权重中 0:15:22 – 梦境 0:17:23 –12:54 AM · Jun 27, 2026 · 604K Views143 条回复 · 70 次转发 · 1.02K 点赞
我们并不陌生于 公开学习 这种工作方式,也深知在大平台上犯错的压力。但我们有幸亲历了 Anthropic 发布 Computer Use 的时刻,见证了 Claude Cowork 的诞生,并参与了其首个大型播客访谈,还组织并呈现了AIE 上首个 Computer Use 专场,分享了最新进展。我们同样密切关注 OpenAI 收购 Sky Software 的动向,正是这一举措成就了 Codex 如今在 Computer Use 领域的全面主导地位。正因如此,我们非常兴奋地向大家介绍今天的重磅嘉宾——Sky 的联合创始人、如今正引领 CUA 各项惊艳进展的 Ari Weinstein,这些突破往往被普通用户忽略:
Ari Weinstein@AriX 我们收到了许多关于 Computer History 隐私影响的精彩提问。 以下是我们在构建这一强大功能的同时确保隐私安全所采取的一些措施。 首先,你可以在时间线视图中查看所有 Computer History 记录: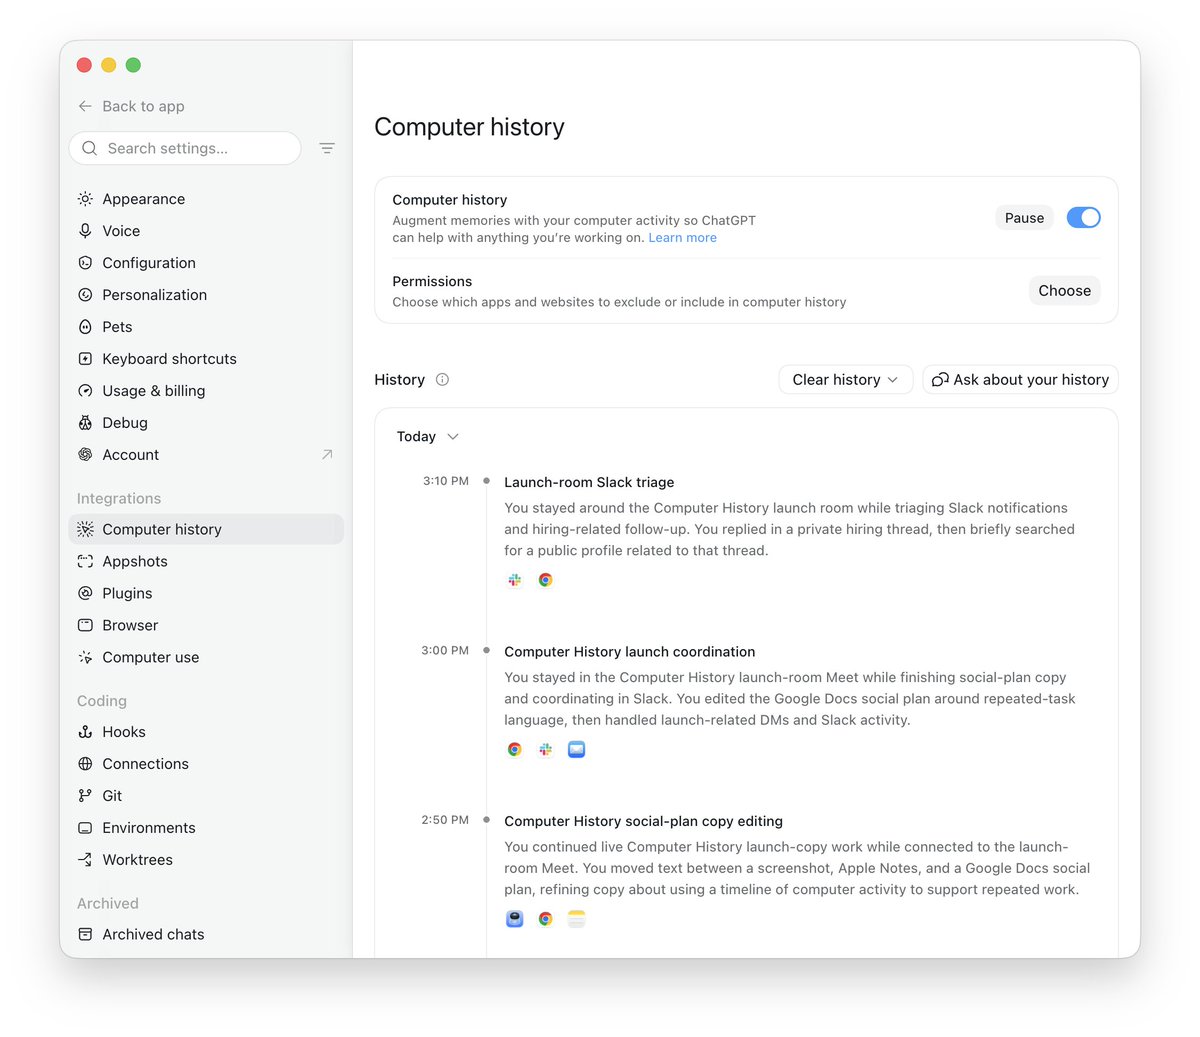 Ari Weinstein @AriX 今天,我们正式在 ChatGPT 中上线 Computer History。
它能学习你在电脑上的所有操作,从而更好地理解你的工作习惯,协助完成你正在进行中的任务,并根据你的电脑使用模式推荐技能和自动化流程。下午 8:39 · 2026 年 8 月 14 日 · 10.7 万次浏览
39 条回复 · 29 次转发 · 512 个赞
Ari 解释了为什么 Computer Use 现在和几个月前相比“发生了 180 度的转变”,Agent 是如何学会调试并从失败中恢复的,为什么把截图与无障碍数据、DOM、Playwright 和生成的代码结合起来能彻底改变速度方程式,以及为什么下一个前沿方向是让 Agent 在使用软件这件事上真正做到超越人类。
OpenAI 复刻 Jev
在下半场,来自 OpenAI API 团队的 Nikunj Handa 详细介绍了全新的开发者技术栈:异步工具调用、回合中途转向、WebSockets、UltraFast 推理、Decisions API、提示词缓存、预热、压缩,以及 Agents API。鉴于我们是第一个做 Jev 播客的节目,我们特别聚焦于 Decisions API 那次异常迅速的冲刺:
OpenAI Developers@OpenAIDevsGive your app real-time decision-making with Decisions API, powered by GPT-6 Luna. Define questions and possible answers to classify content, route requests, or choose an agent’s next action. Available in limited preview. 6:34 PM · 2026年9月29日 · 68.4 万次浏览
222 条回复 · 401 次转发 · 5710 个赞
以及为什么它目前只是 Luna 的一层封装——但团队有足够强的动力、也不端着架子,愿意复刻他们认为优秀的模式。
我们聊到了:
为什么 OpenAI 认为Computer Use 在最近几个月发生了翻天覆地的变化
Dots,以及当每个 Agent 都拥有自己的 Linux 电脑时会发生什么改变
为什么 Computer Use 现在完成某些任务的速度能超过普通人
从人类水平到“真正超人级”计算机使用的路径
为什么现代 Agent 在调试和从失败中恢复方面强得多
截图、可访问性树、DOM、Playwright 以及生成的 JavaScript如何协同工作
应用快照为何能提供比普通截图更丰富的上下文
Computer Use 如何闭合软件编写与测试之间的循环
当智能体能够进行支付和操作网站时,信任、权限与安全考量
异步函数调用以及模型为何不再需要在工具运行期间停止推理
中途转向、WebSockets 以及响应更敏捷的智能体背后的架构
UltraFast 推理以及 OpenAI 如何推动前沿模型实现极低延迟
Decisions API背后的快速内部故事
为何 Decisions API 在低延迟下超越了结构化输出
GPT Live、快速工具调用以及实时计算机控制
OpenAI 如何已利用 Decisions API 进行支持分类和内部工作流
更长的提示缓存、缓存预热以及感知缓存的应用
针对长时运行的智能体线程,服务端压缩与手动压缩的对比
Agents API与开发者自有框架中应包含哪些内容
OpenAI 作为“AI 云”及超越原生模型 API 的高阶原语探索
Ari Weinstein
OpenAI Computer Use 产品与工程团队
Nikunj Handa
OpenAI API 产品团队
LinkedIn: https://www.linkedin.com/in/nikunjhanda/
时间戳
00:00:00 OpenAI DevDay:Dots、GPT-6.1、Agents API 与 Decisions API
00:02:52 Dots 与个人云电脑
00:04:59 为什么 Computer Use 是“180度不同”
00:06:04 从云端到自我调试的 Computer Use Agent
00:09:24 Computer Use 如何感知和操作软件
00:12:09 从快过人类到超越人类的 Computer Use
00:16:03 Agents API:信任、权限与安全
00:17:31 用于编码、测试和 QA 的 Computer Use
00:19:14 GPT-6 API、异步工具调用与超快推理
00:23:21 Decisions API 背后的快速决策故事
00:25:32 Decisions API 是什么以及它如何工作
00:30:24 OpenAI 基于新 API 正在构建什么
00:32:23 Prompt 缓存、预加载与 API 性能
00:35:20 面向长时运行 Agent 的上下文压缩
00:37:13 记忆、高阶 API 与 AI 云
Transcript
引言:OpenAI DevDay 与新的 Agent 技术栈
Vibhu [00:00:00]: 好的。我们非常兴奋能在这里。今天是 OpenAI DevDay。一个特别的播客
Swyx [00:00:08]: 我们是你的直播结束后第一个访谈的播客。
Vibhu [00:00:10]: 第一个播客。这里还有 Ari,他负责 Computer Use Agent 的产品和工程团队。在我们开始深入探讨 Computer Use 之前,你想快速回顾一下吗?今天宣布了哪些内容?你们今天发布了一连串什么公告?
Ari Weinstein [00:00:24]: 是的。是的,那是一个超级令人兴奋的日子。我们刚结束主题演讲。真的很酷。有一系列 Computer Use 的公告,我认为值得深入思考。我们有 Dots,这是一款新的个人助理产品,带有一些非常令人兴奋的 Computer Use 功能。还有 GPT-6.1 Sol,这是一个很棒的新模型,我认为它对 Computer Use 特别有用,因为它的成本和速度优势。我想,我想我们提到,其成本是 Astra 的五分之一,如果专门看 Computer Use,成本则是七分之一,这真的非常出色。抱歉,东西太多了。我在努力梳理一下。
Swyx [00:01:02]: 还有 API。
Ari Weinstein [00:01:03]: 是 Agents API,现在里面加入了 Computer Use,这真的很酷——开发者可以在 Agent API 上构建,用的就是 Codex 和 ChatGPT 里同一套 Computer Use 能力。发布会上还演示了我们已有的 Computer Use 功能,比如 app shots,你可以把电脑上正在操作的上下文快速带到 Codex 和 ChatGPT 里。还有 Mac 上的原生 Computer Use:Roman 演示了它自动给应用截图,同时他还能在电脑上干别的事。总之是一场非常精彩的发布会。
Swyx [00:01:35]: 更别提还有 Decisions API。
Ari Weinstein [00:01:37]: 对,Decisions API。
Swyx [00:01:38]: 先问一下,这些是同一个模型吗?还是同一批数据蒸馏出不同的模型?
Swyx [00:01:44]: 也就是说,Computer Use 是基于 Decisions API 的,还是两者基本各自独立?
Ari Weinstein [00:01:49]: Decisions API 的亮点在于它有一些新能力:支持并行推理,没有推理链(reasoning),模型也比我们用于 Computer Use 的小,这些特性让它速度非常快。
Dots 与把工作交给云端电脑
Swyx [00:02:07]: 嗯。
Ari Weinstein [00:02:07]: 不过这也让它在长程、复杂任务上稍微弱一些。怎么把这些方法结合起来,我认为目前还是开放的研究课题。但无论如何,我很期待看到大家用 Decisions API 构建出什么。
Vibhu [00:02:24]: 有个有意思的地方是,Dots 现在挂载了个人电脑。
Ari Weinstein [00:02:28]: 是的。
Vibhu [00:02:28]: 感觉它们的持久性大大增强了。你已经用了一段时间了,大家该怎么突破边界?应该瞄准什么方向、尝试什么?就我自己来说,现在主要用它处理客服类的事情。比如:
Ari Weinstein [00:02:41]: 不错。
Vibhu [00:02:41]: “这里搞错了”“我不想登录、不想做身份验证”之类的情况,就让它自己去查清楚、直接解决掉。
Ari Weinstein [00:02:45]: 没错。
Vibhu [00:02:46]: 我们应该如何进一步推动?大家该尝试些什么?
Ari Weinstein [00:02:50]: Dots 是一款很棒的产品,因为每个 Dot 都能访问云端专属的 Linux 虚拟计算机。这与我们其他产品不同。通常,我们访问的是云端浏览器,或者你本地的电脑,但现在你拥有了整台云端的 Linux 电脑。因此,它可以运行完整的桌面应用程序,也可以使用 Web 浏览器。所以,我认为 Computer Use 强大且令人兴奋的原因在于,它让智能体能够执行人类能做的任何事情。因为世界上所有的软件都是为人类设计的,现在智能体也能使用这些软件,你可以将任务委派给它们。所以,你在电脑上做的任何事,都可以要求 Dot 来完成。我认为具体什么任务特别有用,很大程度上取决于最终用户是谁,以及什么对他们有价值。但我建议先从思考那些你花费大量时间的事情开始,看看如何将这些工作委派给智能体。
Swyx [00:03:47]: 是的,比如预订航班、购物,甚至玩游戏,对吧?
Ari Weinstein [00:03:52]: 完全正确。
Swyx [00:03:52]: 对。
Ari Weinstein [00:03:53]: 是的,我不知道。对我来说,我最近做的一件事是订阅了一个备餐服务,因为我想吃得更健康。我非常喜欢我找到的这个备餐服务,因为它允许我以非常细的粒度定制订购的餐食。我可以说:“我想要这么多克鸡肉,这么多克米饭。”但这太复杂了。我花两个小时才下完一单,我发现我可以要求 Computer Use 替我操作,它只用 15 分钟就完成了。所以我实际节省了两小时。它不仅比我自己做快了八倍,还在 GPT-6.1 Sol 上为我节省了两小时。
Swyx [00:04:32]: 是的。
Ari Weinstein [00:04:32]: 我认为这类任务真的非常强大。
Swyx [00:04:36]: 作为内容创作者,我可以立刻告诉你,我最主要的用例就是自动化 YouTube 操作。
Ari Weinstein [00:04:40]: 不错。
Swyx [00:04:40]: 因为 YouTube 并没有通过 API 开放很多功能。
Ari Weinstein [00:04:43]: 是的。
Swyx [00:04:43]: 你得把它扔进虚拟机里直接运行,比如做 AB 测试或者发布社区动态。这些功能都无法通过 API 访问,因为他们对开发者很不友好。
Swyx [00:04:53]: 总之,
Ari Weinstein [00:04:55]: 我们的开发者体验团队也说过类似的话。他们经常用它来处理 YouTube 任务。确实,这非常棒。
Swyx [00:04:59]: 我想打个比方……让我们说得更尖锐一点。我们那期著名的 AI 播客朋友(指 Dwarkesh 的节目)经常说 Computer Use 在过去两年没有进步。
Computer Use 在过去一年的变化
Ari Weinstein [00:05:12]: 是的。
Swyx [00:05:13]: 这是一个很有意思的观点。我觉得你是世界上最适合谈论这个话题的人之一,比如事情是如何进展的,对吧?
Ari Weinstein [00:05:20]: 是的。我记得他们几个月前是这样说的,我希望他们现在的看法有所不同,因为现在的 Computer Use 和以前完全不一样了。
Swyx [00:05:26]: 他是个很难取悦的人。
Ari Weinstein [00:05:27]: 是的,好吧,我们努力改变这一点。
Swyx [00:05:30]: 你知道,你……你基本上职业生涯一直都在做某种计算机自动化,对吧?
Ari Weinstein [00:05:34]: 是的。
Swyx [00:05:34]: 比如在 Apple 做 Shortcuts,
Ari Weinstein [00:05:35]: 是的
Swyx [00:05:35]: 然后 Sky,接着加入 OpenAI。你能梳理一下这条主线吗?是什么在驱动你?当时哪些事情还做不到?
Ari Weinstein [00:05:47]: 是的。
Swyx [00:05:48]: 以及你经历的关键里程碑有哪些。
Vibhu [00:05:49]: 那我顺着这个追问一下:从上周的 Codex Computer Use 到今天,最大的变化是什么?是模型?是那些细节?还是 harness?把历史脉络加上今天发布里真正变化的东西都讲讲。
Ari Weinstein [00:05:57]: 好。
Vibhu [00:05:57]: 从上周到今天?
Ari Weinstein [00:06:04]: 说到贯穿始终的主线,我一直对自动化这件事很着迷,就是帮人们把任务自动化,这样就能省下时间,把精力放在比精细操作电脑更重要的事情上。所以我们做了那些产品。我之前在 Apple 工作过,后来创办了 Sky 这家公司,最后加入了 OpenAI,这真的很让人兴奋。而且我觉得有一件事……
Swyx [00:06:27]: 差不多就是你们在 Apple 周围各种“曲线救国”,直到 Apple 说“算了,干脆把你们招进来,在内部直接做吧”,对吧?
Ari Weinstein [00:06:35]: 那里确实是个让人兴奋的工作场所。回顾 Sky 时期的经历,最有意思的一点是,我们当时也在做 Computer Use,但那时的模型能力远不如现在。过去这一年里,模型在 Computer Use 上的能力变得极其强大。我认为最显著的变化在于:以前模型能可靠地启动任务,但一遇到问题就卡壳;而现在它们非常擅长调试,也擅长重试和内省,能判断哪些操作有效、哪些无效。此外,Computer Use 领域本身也在前进。现在 Computer Use 经常涉及编写代码。如果你去看 Codex 并手动展开工具调用,你会发现它并不只是逐个执行动作,而是实际在编写 JavaScript 代码,由计算机执行这些代码来一次性完成许多操作,这就带来了巨大的速度和能力上的提升。我们还更多地使用了多模态的无障碍接口。也就是说,模型可能会使用截图、无障碍功能,或者 Playwright,并根据具体任务采用多种不同的机制。另外,模型推理速度的提升也令人惊叹。那么,今天有什么不同呢?我觉得我们一直在让计算机变得更优秀,所以过去一天的差别可能比过去一个月甚至两个月的变化要小得多。总之,我认为 Dot 中的 Computer Use 以及我们新发布的模型都令人非常兴奋。
衡量 Computer Use 与改进运行框架
Vibhu [00:08:03]: 在主旨演讲中,Tejal 提到 Computer Use 的速度提升了 7 倍,在一些基准测试上也表现更好。你们是如何思考衡量标准的?正如你所说,Computer Use 是一个随时间不断演进的东西。
Ari Weinstein [00:08:20]: 是的。
Vibhu [00:08:20]: 是运行框架(harness)的问题?模型的问题?还是后训练的问题?
Ari Weinstein [00:08:22]: 没错。
Vibhu [00:08:22]: 你们内部是如何评估其好坏的?新模型带来了哪些改变?
Ari Weinstein [00:08:29]: 我们实际上有多种不同的方式来衡量它,其中一些是基于 Harness 的不同排列和配置。这是一个稍微复杂的故事,因为,你知道,我们的生产产品有,你知道,更多安全检查,并且你知道,根据手头任务的需求进行不同配置。因此,有很多方式来衡量它,但我认为无论我们如何衡量,我们都发现了一致的提升。这些提升有时来自 Harness,有时来自模型。而且是的,我对 GPT-6.1 的结果感到非常兴奋,它在 Computer Use 方面比与 Astra 相比的基准成本改进更具成本效益。看到这一点真的很酷。
Swyx [00:09:10]: 是的。我的意思是,我从直播中很喜欢的一张可视化图表是,你正在改善你的,曲线,帕累托前沿,并且有很多关于你如何与 Harness 一起改善它的讨论。
Ari Weinstein [00:09:24]: 是的。
Swyx [00:09:24]: 你能举一些“顿悟时刻”的例子吗?无论是模型驱动 Harness 还是 Harness 驱动模型,什么都可以。
Ari Weinstein [00:09:32]: 我不想重复自己,但我认为,引入更多模态是非常强大的。
Swyx [00:09:36]: 好的。
Ari Weinstein [00:09:36]: 一个更具体的例子是,在过去,我认为我们看到很多 Computer Use 产品不得不花大量时间,比如,滚动,你知道?所以它会,比如,截图。它会尝试做一些事情。它会说:“哦,我必须,比如,滚动到下一页结果”,然后它会截图,然后它会尝试做一些事情。它会再次向下滚动。所以我认为,随着可访问性和其他。以及直接访问 DOM 和其他类似的东西,现在语言模型实际上可以看到,比如,整个页面或整个应用程序。它可以编写代码,一次执行多个步骤。所以我认为这些可能是最大的单一“顿悟时刻”。有一些更小的,相比之下不那么令人兴奋的小“顿悟”,但实际上我们也发现,许多速度提升是由许多小的割伤驱动的,我们必须深入反思。
App Shot、无障碍技术与更好的计算机上下文
Swyx [00:10:21]: 对,背后是大量高难度的工程工作。
Ari Weinstein [00:10:23]: 是的。
Swyx [00:10:23]: 我是说,整个 app shot 这个东西,对吧?Codex 里展示效果挺好看,但我觉得大家没真正理解它的区别——
Ari Weinstein [00:10:30]: 是
Swyx [00:10:30]: ——就是当你截一个 app shot 时,你不只是得到一张图,而是真的能驱动每一个按钮,而且每段文本都以最优的表示形式存在。
Ari Weinstein [00:10:40]: 没错。其实还挺有意思的。如果你想深究一下,可以在 Codex 里按两下 Command 键截一个 app shot,把当前应用的内容抓进来,送到 Codex 或 ChatGPT 的对话里。然后点开那个附件,再点右上角的一个小按钮,就能看到原始文本和原始的无障碍表示。我们在这方面下了很多功夫——
Swyx [00:11:04]: 就是把所有东西都导出来,对吧。
Ari Weinstein [00:11:05]: 对,全部导出来,而且要做到 token 高效、处理高效,这里面还挺有门道的。有意思的是,这项最初为残障人士发明的技术——比如屏幕阅读器——本来是帮助他们使用计算机的,结果同样非常适合让 LLM 使用计算机。能参与这方面的工作真的很开心。
Vibhu [00:11:27]: 补充一下背景,很多人其实不了解 app shot,甚至不知道这是个功能。
Ari Weinstein [00:11:30]: 对。
Vibhu [00:11:31]: 就是连按两下 Command,它会抓进来一个看起来像截图的东西——
Ari Weinstein [00:11:34]: 对
Vibhu [00:11:34]: 你可能会想:“我怎么就截了个图扔进去了?”不,它实际上抓取了所有元数据、所有代码,所有东西。
Ari Weinstein [00:11:40]:没错。举个例子,如果你截一张网页的图,截图里只有链接本身,但不包含它的目标地址。再比如截一张日历的图,事件标题经常被截断。但如果你获取的是应用级的完整信息,模型能拿到所有要素的全量上下文,能力边界就大不一样了。
Swyx [00:12:02]:是的。想了解更多细节的话,我邀请了 Jason Liu 在 AI Engineer 大会上开了一场专门讲这个主题的工作坊。
Ari Weinstein [00:12:07]:太棒了。
Swyx [00:12:08]:他讲得非常好。
Vibhu [00:12:09]:我想从一个更宏观的视角问个问题。
迈向超人类水平的计算机使用
Ari Weinstein [00:12:11]:请讲。
Vibhu [00:12:11]:关于 Computer Use 智能体。你刚才提到的“截图、滚动页面、再截图”就是现状。现在它们能自动化很多任务,那瓶颈在哪里?是模型本身,还是执行框架?你觉得两年后会发展到什么程度?能让智能体连续运行数小时吗?我们该怎么做才能达成?你对 Computer Use 的未来有什么预判?
Ari Weinstein [00:12:32]: 没错。我觉得过去几个月团队最惊人的成就,是现在 Computer Use 在大多数情况下完成普通任务的速度比一般人类还快。我认为下一个前沿是让 Computer Use 在性能上变得真正“超人”,也就是说,在使用软件时它的速度能赶上甚至超越像我们这样的高级用户。当那一天到来时,我认为会非常关键且令人兴奋,因为我们将突然能够构建提供极致实时体验的产品。我认为降低使用 Computer Use 的门槛——或者说启动能量——会让我们开始默认让 agent 去做那些我们原本习惯手动操作的事,这也令人兴奋,因为它能省下大量时间。我觉得有不少琐碎的痛点和瓶颈阻碍着这一进程。模型端、推理端、harness 端以及表示层都有问题。我们发现,随着 Computer Use 变快,瓶颈逐渐转移到了操作本身的速度上。比如在 Computer Use 任务的基准测试中,非微不足道的时间消耗其实就在于此。举个例子,假设你要在 doordash.com 上自动化某个任务,大量时间实际上都花在了等待 doordash.com 加载完成,你明白吗?
Swyx [00:14:04]: 是的,那你就写一个 wait,然后执行它。
Ari Weinstein [00:14:07]: 对,完全正确。而且你希望……是的,减少加载完成到触发下一步操作之间的延迟非常重要,你希望这个间隔尽可能短。
Swyx [00:14:16]: 没错。
Ari Weinstein [00:14:16]: 触发 LLM 执行下一个动作,这本身——其实是一门统计科学。
Swyx [00:14:20]: 也许可以用事件驱动的方式来处理。
Ari Weinstein [00:14:22]: 在可行的情况下,最好就是事件驱动。
Swyx [00:14:24]: JavaScript 有一些 load 事件。
Ari Weinstein [00:14:25]: JavaScript 或浏览器本身有针对网页导航的加载事件,但有些场景其实没法用事件驱动,所以会带来很多复杂性
Vibhu [00:14:34]: 比如跟客服聊天就是典型例子。
Ari Weinstein [00:14:37]: 没错。
Vibhu [00:14:37]: 对方回复可能要 30 秒,也可能要三分钟。
Ari Weinstein [00:14:39]: 哦,对。
Swyx [00:14:41]: 我用 Codex 跟机器人客服打过很多交道。挺好用的,不过我很好奇对面知不知道自己在跟机器人聊——因为我回的都是完整句子,大小写都规范得很。
Ari Weinstein [00:14:50]: 太搞笑了。
Swyx [00:14:51]: 连完整的产品编号都给对方。好得过分了,简直不像真人。不过我无所谓,我的目标就是把工单解决掉。
Vibhu [00:14:58]: 我还会给它加提示词,比如“别装成机器人,演一个很不耐烦的真人。”
Vibhu [00:15:02]: 回复就用简短的短句之类的。
Swyx [00:15:04]: 是
Vibhu [00:15:04]: 用各种方式逼它。我还会跟它说:“等回复的时候,用 subagent 去研究一下还有什么更好的办法能搞清楚我们的需求。”
Ari Weinstein [00:15:12]: 不错。
Vibhu [00:15:12]: 这样人只需要偶尔介入一下。
Ari Weinstein [00:15:14]: 太妙了。而且我感觉对面有一半的概率本来就是机器人,所以现在就变成
Vibhu [00:15:17]: 是啊
Ari Weinstein [00:15:17]: 机器人跟机器人互聊了。
Swyx [00:15:18]: 对。我还想说,Computer Use 现在已经跨过了一个里程碑:三四年前,我们连把 LLM 接到互联网上都害怕,更别说
Ari Weinstein [00:15:31]: 是啊
Swyx [00:15:31]: 接到我们自己的设备上了。现在我都让它帮我配置 DNS 了。
Ari Weinstein [00:15:35]: 哇。
Swyx [00:15:36]: 我让它帮我付账单。真的是几万美元的各种事项,我直接扔给 Computer Use 去处理,就这么 YOLO(孤注一掷)一把。你想想,最坏的结果会是什么?
Swyx [00:15:48]: 所以——就这样,这些都挺好。
在 Agents API 中安全地构建 Computer Use
Ari Weinstein [00:15:50]: 是的。
Swyx [00:15:50]: 我现在觉得,显然,你也得用自己的产品来喂自己(dogfood)。既然已经通过 API 发布了,你有没有什么需要告诉开发者的陷阱或建议?因为我猜他们即将亲手体验到这一切。
Ari Weinstein [00:16:03]: 首先,将 Computer Use 引入 Agents API 让我们非常兴奋。我认为这是一件很棒的事,因为显然许多开发者都在构建需要与第三方网站和服务交互的应用程序。Computer Use 具有普遍性,它能处理任何任务。现在,开发者可以直接基于我们正在使用的同一套 Computer Use 实现进行开发。如果你想构建自己的 Computer Use 框架,虽然仍有很大空间,但难度较高。此外,我们在该框架上训练模型,因此使用模型分布内的框架在速度、成本和准确率方面可能具有优势。我认为,允许人们在它之上进行构建是非常有益的。关于你刚才提到的点,我认为我们所有人其实仍处于适应阶段。不过,在这个领域中,我们在接受这项技术并建立信任方面可能比世界上大多数人走得更靠前。因此,我们认为我们有责任通过以下方式随着时间的推移建立信任:确保构建可靠的东西,建立适当的安全检查机制,在执行如支付等具有重大后果的操作前征得用户同意,以及根据具体应用,确保只允许其访问任务真正需要的网站或应用程序。我认为这是非常重要的一点。总之,我强烈建议大家尝试新的 Agents API,在上面构建各种酷炫的东西。如果方便的话,我们也非常乐意收到大家的反馈。
Vibhu [00:17:31]: 你有没有注意到它对开发工作流程产生了哪些变化?比如关于 Dots(推测为特定产品或功能名),你就能看到它在 Slack 中的使用情况。
Ari Weinstein [00:17:38]: 是的。
Vibhu [00:17:38]: 你可以看到人们使用语音构建。Roman 展示了一个例子:修改这个应用,并在过程中发送截图给我等。
用于测试的 Computer Use 及软件闭环
Ari Weinstein [00:17:46]: 是的。
Vibhu [00:17:46]: 在用户采用层面,你们有没有观察到大家怎么把 Computer Use 用到编码工作流里?有什么值得借鉴的经验吗?
Ari Weinstein [00:17:55]: 我个人最喜欢、也是我们在真实用户中见到最多的用法之一,就是让 agent 用 Computer Use 来测试它自己写的软件。这一点听上去平常,实际意义大得多。传统上,你让 Codex 帮你写好代码,然后测试就落到你头上,你成了 agent 的 QA,对吧?有了 Computer Use,就能打通整个软件开发生命周期:agent 负责开发,也负责测试。我自己就经常这么玩——让 agent 写东西,再让它自己测,等交到我手上时已经能跑了。还有个额外的乐趣:有时我在开发 Computer Use 本身,于是就有了一个 Computer Use agent 在驱动我的 Computer Use agent,后者又在操作别的东西。所以我觉得这类用例真的非常强大。
Swyx [00:18:44]: 我自己开发了一个“可视化试玩”技能,能揪出很多设计上的问题。
Ari Weinstein [00:18:49]: 不错。
Swyx [00:18:50]: 那些问题光看代码是发现不了的。这个方法拿来克隆应用也特别好使。如果你在用一个烂 SaaS,想干掉它,就一屏一屏地克隆下来。Computer Use 显然能全程操作:截屏、记录,然后用 Codex 把整个应用复刻出来。
Ari Weinstein [00:19:06]: 太酷了。
Swyx [00:19:06]: 好,感谢你带来的进展。我想——
Ari Weinstein [00:19:08]: 没问题。
Swyx [00:19:09]: 时间到了。
Nikunj Handa: OpenAI API 的新动态
Ari Weinstein [00:19:10]: 好。
Swyx [00:19:10]: 以后我们还会再聊的。
Ari Weinstein [00:19:12]: 嗯,很愉快。谢谢你们邀请我。
Swyx [00:19:14]: 好。
Vibhu [00:19:14]: 好了,时间卡得死死的。我们直接切入正题。
Nikunj Handa [00:19:17]: 没问题,开始吧。
Vibhu [00:19:19]: 好的,Nikunj,非常高兴邀请到你。你在 API 方面推出了大量功能,正如我们刚才和 Ari 讨论的那样,现在你可以使用 Computer Use 代理进行开发了。有没有什么关于 API 侧变更的重点想强调一下?顺便简单介绍一下你自己和你负责的工作?
Nikunj Handa [00:19:25]: 当然可以。
Vibhu [00:19:25]: 好的。
Nikunj Handa [00:19:34]: 我姓 Nikunj,负责 API 团队的产品工作。我在 OpenAI 大概待了三年,一直专注于模型发布工作。这似乎是我在此期间的常态。每当有新模型,我们都会与后期训练团队和研究团队紧密合作,挖掘其新功能,然后在 API 中开放这些能力。简单来说就是这样。如果你只看 GPT-6 的所有新特性,我们首先发布的是异步函数调用。就像你在 Codex、Dots 等产品中看到的那样,工具调用耗时较长,因此模型执行时不再需要暂停等待工具运行。你可以发起工具调用,让模型继续运行、继续推理,之后再回来检查结果。我们还推出了中途转向功能,现在你可以在模型推理过程中注入消息。也就是说,当工具调用完成时,你可以插入指令。
异步工具调用、中途转向与 WebSocket
Swyx [00:20:43]: 这在一定程度上也是模型对齐能力,对吗?
Nikunj Handa [00:20:46]: 是的。
Swyx [00:20:46]: 比如,他们必须训练模型具备这种能力。
Nikunj Handa [00:20:48]: 没错,确实如此。而且
Vibhu [00:20:49]: 我感觉应用里一直有这功能。在模型推理时,你其实可以引导它。
Nikunj Handa [00:20:54]: 对。
Vibhu [00:20:54]: 以前效果不太好,现在好多了。
Nikunj Handa [00:20:57]: 是的。
Vibhu [00:20:57]: 很想看看新版本的表现如何。
Nikunj Handa [00:20:58]: 对,而且我也很喜欢我们主要的……
Vibhu [00:20:59]: 而现在……
Nikunj Handa [00:21:00]: 我们在 API 里的主要目标就是,一旦某项功能在测试框架(harness)中训练稳定了,就立刻将其放入 API。所以我们会等待那个“足够好”的时刻。很多功能实际上都是由 WebSockets 驱动的,我们在几个月前就发布了它。WebSockets 开启了与模型之间真正的双向通信。这不是 GPT Life 那套东西,我指的就是 GPT-6。你可以进行异步工具调用、异步推理、注入消息。这是一个非常有趣的 API,开发体验很棒,我个人也很享受这个过程。
Swyx [00:21:33]: 没错。这也是为什么我们是工程技术类播客,因为我们可以聊 WebSockets。
UltraFast 与推理栈
Nikunj Handa [00:21:36]: 是的。
Swyx [00:21:37]: 这跟 UltraFast 也很搭配,对吧?
Nikunj Handa [00:21:39]: 噢,确实。
Swyx [00:21:39]: 就像现在,我认为 UltraFast 是首次通过 API 提供。
Nikunj Handa [00:21:43]: 是的。
Swyx [00:21:43]: 基本上就是理论上能达到的最快速度,智能前沿(Frontier of Intelligence)。
Nikunj Handa [00:21:49]: 对,做这个项目特别带劲。在聊 API 之前,先说 UltraFast 最好玩的部分,就是看着推理团队用 Astra 大展身手。他们一直跑着 Codex agent,不停压榨性能。我记得有几个月的重点是效率优化、降成本,所以才能把 Luna 的价格砍掉 80% 左右,很大程度上靠的就是推理团队落地的那些改进。现在他们换了方向,琢磨怎么让它跑得尽可能快。在 Astra 这种模型上看到 UltraFast 的表现真的很震撼,能跑那么快确实酷。至于 WebSockets,其实我们第一次上线它是为了 GPT 5.3 Codex Spark——不敢相信我们给模型起了这么个名字,反正就是为它上的线。它的好处显而易见:你总得调用工具,WebSockets 大大降低了工具来回交互的开销,这一点上它是真香。
Swyx [00:22:57]: 对。挺有意思的,我有个常规用量上限,还有一个从来没动过的 Spark 用量上限。
Nikunj Handa [00:23:03]: 嗯。
Swyx [00:23:04]: 想用就用得上。
Nikunj Handa [00:23:05]: 应该终于下线了。
Swyx [00:23:06]: 下线了,是啊。
Nikunj Handa [00:23:07]: 我知道,已经没了。
Swyx [00:23:08]: 对,你们在慢慢淘汰那些,
Nikunj Handa [00:23:11]: 老模型,对。
Swyx [00:23:11]: 老家伙们。
Vibhu [00:23:11]: 这一周真是精彩。这是我们第一次实现极致速度下的前沿智能。
Nikunj Handa [00:23:17]: 是。
Vibhu [00:23:18]: 用户非常喜欢。
Nikunj Handa [00:23:19]: 嗯。
Vibhu [00:23:19]: 所以
Swyx [00:23:20]: 对
Vibhu [00:23:20]: 这是第一次。
Swyx [00:23:21]: 是的。5.3 Spark 明确归功于 Cerebras。你们既没有承认也没有否认 UltraFast 与 Cerebras 有关,但人们很在意这件事,大家都在猜测。而且你们也有自己的芯片,这是个显而易见的大问题,即决策模型。
Decisions API:OpenAI 的快速决策模型
Nikunj Handa [00:23:38]: 哦,是的。
Swyx [00:23:38]: Decisions API。我们是第一个做 Jev 深度解析的播客,邀请了 Diogo 参与,我还在 AI Engineer 活动中采访过他。你看到 Jev 之后多快意识到……
Nikunj Handa [00:23:49]: 天哪。是的。
Nikunj Handa [00:23:50]: 是的。首先,真心佩服 Diogo 和 Jev 团队,他们真的激发了……
Swyx [00:23:55]: 没错
Nikunj Handa [00:23:55]: 整个市场细分领域。显然,Jev 一发布,大家就疯了。我们的用户纷纷联系我们。我们内部团队也说,“我们需要一个更快的分类系统”。我们可以做到。我不想提前透露一些即将推出的功能细节
Swyx [00:24:16]: 哇
Nikunj Handa [00:24:16]: 但你们将会看到一些基于 Decisions API 构建的非常酷炫、反应极快的功能。不过,是的,感谢 Jev 激发了这一切。显然,OpenAI 很多人因此受到启发,他们想,“我们怎样才能实现?我们不打算去……”
Swyx [00:24:33]: 好的。
Nikunj Handa [00:24:33]: 训练一个新模型。但是
Swyx [00:24:34]: 四周前,这根本不在研发雷达上,对吧?
Nikunj Handa [00:24:37]: 不,完全不是。没有。
Swyx [00:24:37]: 好的。
Nikunj Handa [00:24:37]: 这就是那种
Swyx [00:24:38]: 哇
Nikunj Handa [00:24:38]: 受 Jev 启发,并且
Swyx [00:24:40]: 我认为你官方上是你们实验室第一个克隆并采纳这种模式的人。
Nikunj Handa [00:24:44]: 没错。OpenAI 有着浓厚的黑客文化,大家对新事物总是充满热情。比如负责推理的一位同事,还有基础设施团队的一位大神,看到后都兴奋地说:“这太棒了,我们要立刻上手折腾。”他们迅速搭建了一个能跑的 prototype,现在我们就在针对延迟进行调优,力求把它做到最快。我们希望在几天内发布,一旦达到延迟目标,就会尽快上线。
Vibhu [00:25:13]: 这很有趣。在拥有黑客文化的同时,正如 Sam 所说,你们也是可靠性最高的 API 之一
Nikunj Handa [00:25:20]: 对
Vibhu [00:25:20]: 我相信使用量最大的其实直接来自你们团队内部。人们应该如何看待 Decision API?我觉得很多人听说过 Jev,感受到了热议,但还没实际用它来开发。你们正在让它变得非常主流。
决策模型擅长什么
Nikunj Handa [00:25:32]: 嗯。
Vibhu [00:25:33]: 人们应该把它看作什么?该如何使用它?
Nikunj Handa [00:25:36]: 主要用例是极快速的分类。所有的 Computer Use 演示都很惊艳。当然会有局限性,比如让 Astra 编写类似 JavaScript 脚本来控制电脑,与让 Luna 每次只选择一个动作相比,后者不会达到同等智能水平。但可能有一些 Computer Use 任务,这个方案已经足够好了。我很期待看到这种情况发生。内部另一个很酷的 prototype 是将它与 GPT Live 结合。GPT Live 是双向实时的
Swyx [00:26:14]: 语音
Nikunj Handa [00:26:14]: API,它基于前端模型和后端模型的架构。GPT Live 是这样的
Swyx [00:26:20]: 思考或说话者
Nikunj Handa [00:26:21]: 非常快。对,就是那个 talker 之类的。GPT Live 就是那个 talker,速度很快,擅长任务分发,后面还配了类似 Astra 的东西。但 GPT Live 的 tool calling 一直感觉很慢。所以有人做了 GPT Live 控制电脑的 tool calling 演示,感觉明显更流畅、更自然。所以我很期待大家能拿 Live 和 Luna 在 decisions API 上做出什么东西来。应该会挺有意思的。
Swyx [00:26:55]: 我想帮大家把这个概念理清楚,尤其是从产品角度看。因为最近很多人都在做 Jev 的克隆品,过去两周差不多有 100 个。
决策模型的独特之处
Nikunj Handa [00:27:01]: 哦,真的吗?太厉害了。
Vibhu [00:27:03]: 头几天就做出来了。
Swyx [00:27:04]: 但他们克隆的只是 Jev 的 API,说实话就是 structured outputs——
Nikunj Handa [00:27:09]: 对。
Swyx [00:27:09]: 而 structured outputs 是 OpenAI 率先推出的。
Nikunj Handa [00:27:10]: 是。
Swyx [00:27:11]: 所以我觉得有必要给大家讲清楚:决策模型到底是什么?
Nikunj Handa [00:27:16]: 好。
Swyx [00:27:17]: 关键在哪?不单纯是延迟,也不单纯是 structured output,对吧?因为我自己也可以拿 Luna——决策模型的价格和 Luna 是一样的,对吧?
Nikunj Handa [00:27:26]: 嗯。
Swyx [00:27:27]: 我把 reasoning 关掉,再加上 structured output,这算是一个 Jev 吗?显然不算,对吧?这才是真正的——
Nikunj Handa [00:27:33]: 对。
Swyx [00:27:33]: 真正的关键。
Vibhu [00:27:34]: 关键在于置信度。
Swyx [00:27:35]: 对。
Nikunj Handa [00:27:36]: 没错,完全同意。说一下我们的情况:我们没有专门为这个训练新模型。
Swyx [00:27:40]: 嗯。
Nikunj Handa [00:27:40]: 完全是基于现有的 Luna 权重搭建的。
Swyx [00:27:44]: 哦。
Nikunj Handa [00:27:44]: 对,本质上就是 Luna。此外,你还会施加约束,其中结构化输出占了很大比重。你会深度优化推理栈,让 TTFD(首 Token 延迟)尽可能快。由于可以生成多个问题,基本就是并行处理它们。
Swyx [00:28:05]: 作为批次运行。
Nikunj Handa [00:28:06]: 对,以批次形式运行。目前业界有各种旨在极致加速的推理技术。但我想说的是,至少在我们最初的实现和第一版中,我们直接在 Luna 上零样本尝试,看看效果如何。显然,你要把它发布出去。这是 OpenAI 典型的迭代部署策略:先上线,看看用户反馈,然后再根据需要做模型改进。好,这就是 Decisions API 的情况。
Swyx [00:28:38]: 对。而且显然有个好处,就是它具备视觉能力。他们(指 Jev)没有视觉能力,对吧?
Nikunj Handa [00:28:42]: 没错。
Swyx [00:28:42]: 显然,Jev 具备…
Nikunj Handa [00:28:43]: 对,用 Luna 我们就白送这个能力。
Swyx [00:28:45]: 嗯。我认为有些创新点,听起来似乎还没到来。如果还是使用相同的 Luna 权重,像置信度、校准这些方面我们之前在播客里聊过基准测试校准。因为基本上,RLHF 的问题在于它会向模型迎合你希望听到的答案方向坍缩。
校准、架构与开放研究问题
Nikunj Handa [00:29:03]: 对。
Swyx [00:29:03]: 但它实际上并没有准确反映真实的置信度水平。
Nikunj Handa [00:29:06]: 对,完全同意。我很期待看看后续发展。也许在下一个模型版本发布时,我们需要在这些关键领域进行爬山优化。
Swyx [00:29:15]: 对
Nikunj Handa [00:29:15]: 随着未来模型版本的发布。是的。
Swyx [00:29:18]: 在架构方面,另一个争论焦点也很明显。没人确切知道,因为 Jev 不透露细节,但目前主要有两种猜测:一是可能采用了扩散模型(diffusion model)而非自回归(autoregressive)架构,
Nikunj Handa [00:29:28]: 嗯。
Swyx [00:29:29]: 这样你就能以某种方式实现并行生成。另一种猜测是,它使用了某种机制可解释性(mechanistic interpretability)方法,
Nikunj Handa [00:29:37]: 嗯。
Swyx [00:29:37]: 即分析激活值,然后直接输出权重。
Nikunj Handa [00:29:40]: 那会很酷。
Swyx [00:29:41]: 也就是权重。
Nikunj Handa [00:29:42]: 对。
Swyx [00:29:42]: 你们团队在这方面的研究很多,外界也有很多猜测。
Vibhu [00:29:45]: 这两种方法都有过演示。
Swyx [00:29:46]: 是的。
Vibhu [00:29:46]: 这两种都有。我认为 Gemini 曾分享过类似 Jev 输出风格的 Gemini Diffusion 和 Gemma Diffusion。
Nikunj Handa [00:29:53]: 哦,太棒了。
Vibhu [00:29:53]: 另外,可解释性研究人员也从中层提取过信息,但这目前都只是推测。
Swyx [00:29:59]: 关键在于你想达到什么目标。实现 API 很简单,谁都能做到,这根本不算难点。真正的挑战在于速度、准确率以及其他校准功能。
Nikunj Handa [00:30:11]: 嗯。
Swyx [00:30:11]: 我一时想不到别的了。
Nikunj Handa [00:30:13]: 没错。完全同意。看到整个领域被激活起来,大家都在做很酷的事情,互相学习,这感觉太棒了。我也很期待未来。
开发者下一步该构建什么
Vibhu [00:30:24]: 作为平台团队成员,我觉得你的工作很大程度上是赋能开发者。
Nikunj Handa [00:30:27]: 嗯。
Vibhu [00:30:28]: 你觉得大家可以用 decisions API 和 Computer Use agents 来做些什么?你们内部有没有基于这次新变化构建的、你觉得能真正打开局面的东西?
Nikunj Handa [00:30:39]: 好,让我想想。decisions API 在内部的应用场景很明显,比如用户运营团队第一时间就冲上去了,说“我们得把所有支持工单都分类”。还有什么来着?对,还有那些很酷的 GPT Live 演示。我猜 Codex 应用团队可能也会拿它做点有趣的东西。毕竟这整个东西一周前才启动,还非常早期,
Swyx [00:31:06]: 哦,才一周。
Nikunj Handa [00:31:07]: 对,我们很兴奋,就是这么短的时间。
Vibhu [00:31:08]: 还有一个大方向是 evals,把 LLM as a judge 用起来,低延迟这点很关键。
Nikunj Handa [00:31:13]: 对,这个方向会很值得关注。至于 Agents API,OpenAI 内部已经有一批第一方产品完全构建在它之上。比如刚上线的 Codex 安全功能,就是完全基于 Agents API 构建的。还有,我们今天要发布一个类似会议记录的产品。
Agents API 与 OpenAI 的第一方产品
Swyx [00:31:40]: 嗯哼。
Nikunj Handa [00:31:40]: 应该有个演示,你还记得 Sam 展示插件扩展的时候吗?有个演示是你在日历里,可以直接把会议记录
Swyx [00:31:51]: 比如汇入到一个
Nikunj Handa [00:31:52]: 汇入你的工作空间
Swyx [00:31:52]: 类似 Google Docs 那种东西。
Nikunj Handa [00:31:53]: 对。
Swyx [00:31:54]: 没错吧?
Nikunj Handa [00:31:54]: 那些东西全都是构建在 Agents API 之上的。所以我很期待,我们才刚把它推出来,看看大家能在上面做出什么。
Vibhu [00:32:04]: 我觉得你展示得非常出色。包括编辑空间、页面、协作,还有接入你的 dot 点……功能这么多,
Nikunj Handa [00:32:12]: 对
Vibhu [00:32:12]: 确实有很多灵感供人们借鉴。
Nikunj Handa [00:32:14]: 没错。这一切用 Astra 都能实现,你懂的。现在事情发展得真快,
Swyx [00:32:19]: 对