
AI大模型实战-深入理解Seq2Seq:让我们看看语言翻译是怎么来的(我:多引言篇)
 (我:在本篇开始前,首先祝大家节日快乐,然后我想吐露下关于学习这件事的一些个人看法)(我:因为某些原因,我从原本的学习轨道上脱离了,后续才继续了学习的道路,什么是学习的道路,其实我也说不清楚,但是就是感觉自己又找到了自己应该有的道路)(我:编程在看了Ruby on Rails作者的那几分钟的视频后,发现有时候原来找个心理安慰的点,其实就是如此简单)(我:前一阵子看到同事看一些关于比较炫酷的页面,其实很多年前,我早就关注过,后来我翻开我记录这些内容的qzone,当时还没在cnblogs上记录东西,发现当时记录的内容,到现在为止,其实大部分没有深入那么多,反而记录在cnblogs上的,是工作中学习中很确定并且使用到的技术,现在回想这个是为什么,原因可能是:在qzone,当时感觉其实只是一个sns类似的东西,而且没有任何的自我监督,即这件事或者这篇日志见诸大众,会不会起到被监督的那种影响,后来发现效果比较差,而cnblogs不同,上面大部分,也可以说全部,都是做编程的,所以就算你将随笔写得再过花哨或咬文嚼字,没人说你矫情或者装,而是感觉你整理得不错,我当时也遇到了几个逛际于cnblogs的技术大牛,也交流,也获得了一些他们的'传道授业',包括聊职业,以及学习,当然还有技术)(我:从最早那会儿下定决心,到最终走上编程这条路,要做的心理建设,心理铺垫是比较烧心脏的,一是那些可能会在不久的未来就可以预见到的困难,无形之中在内心形成完全的一整栋的屏障;二是在当时认知的前提下,要为这个算是付出非常多时间以及耐心,还没有那么多引路人来做评估,自己没有百分比确信,这样的努力,是否会得到回报,而这两点,完全可以击溃任何心理哪怕有一丝孱弱状态的人,虽然现在AI编程已经完全大行其道,但我还是想对那些兢兢业业一个字符一个字符,用'古法编程'去做出伟大作品的前辈,致以崇高的敬意)(我:今天也遇到了一些有自学编程经历的年轻人,还好,他们可能没有经历过原来古法的那种'残酷',对比起来,就像是手工织毛衣和纺织机的区别,毕竟原来需要查阅文档,找对应博客,做测试做demo,才能确信这个不是太懂的技术中间件,是怎样的,而且要符合工期,就可能需要在下班时间里,去把这块技术内容补齐,虽然现在AI完全来写代码也几乎没有了那么大的不确定性,而且查资料或者收集资料也都可以通过它来完成,省去了诸多繁琐步骤,但可能要强的人可能还会想,如果让我拿几百块来投入编程或者对应这个行业的自我发展,可能更倾向于购买一些良好的课程,而不是去买大模型订阅)(我:到了一定阶段后,比如'古法'中级程序员向高级程序员发展,遇到的阻力几乎等同于一场高考,而这需要自己整理好考试的目的,以及考试的材料,以及大量的实践实操,说起这一点,我又有点其他心得体会,是关于一个程序员去找工作的故事,很多时候,如果当这个程序员将要做的方向和要实现的自我职业抱负规划得非常具体,再结合这程序员已经真正具备了一些技能的情况下,往往在自由市场中,会让双方都会产生错觉:即雇佣者会觉得这正是我要的符合技能的人,而被雇佣的程序员会感觉到:我以往的技能充分得到了发挥,并且又有合适的契机去学习实践我想掌握的技能,真好!但真实的解释是:这工作的薪水,通勤距离,以及部分技能是否双方满意)(我:上面讲得有点偏离主题,可能是我想要达到的目的,还是需要一部分铺垫,比如就学习AI而言,包括今天整理了部分真正符合我职业岗位再发展路线的路线图,最早这种路线,我都是去一些知名编程博主那里去获取,比如最早有一篇文章叫做'Java成神之路',我当时践行了这篇文章内讲述的学习路线比较久,不能称之为着魔,但有时候也感觉自己有点魔怔,比如当时调换了一份工作后,乘公交车坐了大概个把小时又去到当时上一份工作所在的租房地方旁边的图书馆去学习;还有时候,可能是你的坚持让你碰到那种事,比如我有次面试碰到一位做AI的面试官,我问他怎么学习的,他说他通勤坐地铁要2个多点小时,然后坚持了2年之久,而我那会儿也有过通勤2小时的经历,而且当时通勤时就是刷课程,这种5-6点起床,挤着上走3站公交车,2小时地铁通勤的日子,会让人明白或者说回想起,时间的重要性)(我:现在AI的相关自媒体内容层出不穷,似乎总感觉错过了就错失了很多知识,其实也不用焦虑,因为学习最好的状态就是找到自己的节奏,我这边最近因为更新这节自购课程分享得到了一些关注转发,但实际上我还是觉得每个人自己的规划是要放在第一位的)
深入理解 Seq2Seq:机器翻译背后的序列到序列模型
上一节课我们学了 Word2Vec,它的核心能力是把词汇放进一个多维空间里,让意思相近的词彼此挨得更近。这一节课我们更进一步,进入 Seq2Seq。这是一个复杂得多、也强大得多的模型:它不仅“认识”单词,还能把这些单词串起来,组成一句完整的话。
一、Seq2Seq 是什么
Seq2Seq 的全称是 Sequence-to-Sequence,字面意思就是“序列到序列”的转换。它既能捕捉词与词之间的关联,也能把整句话的含义“压缩”起来,再以另一种形式“释放”出来。打个比方:如果说 Word2Vec 让机器学会了“认字”,那么 Seq2Seq 就是让机器学会了“读懂句子并加以转化”。
在这个框架里有两个核心角色:编码器(Encoder)与解码器(Decoder)。编码器的职责是理解并压缩信息,好比把一封长信整理成一段摘要;解码器则负责把这则摘要重新展开,转成另一种语言或另一种表达形式。这里真正的难点,在于如何保证信息在“压缩—还原”的过程中不丢失精髓,而是换一副面貌依然精准地呈现出来。这正是我们接下来要深入的内容。
二、核心结构
Seq2Seq 本质上是一种神经网络架构,主体由编码器与解码器两个部分构成。
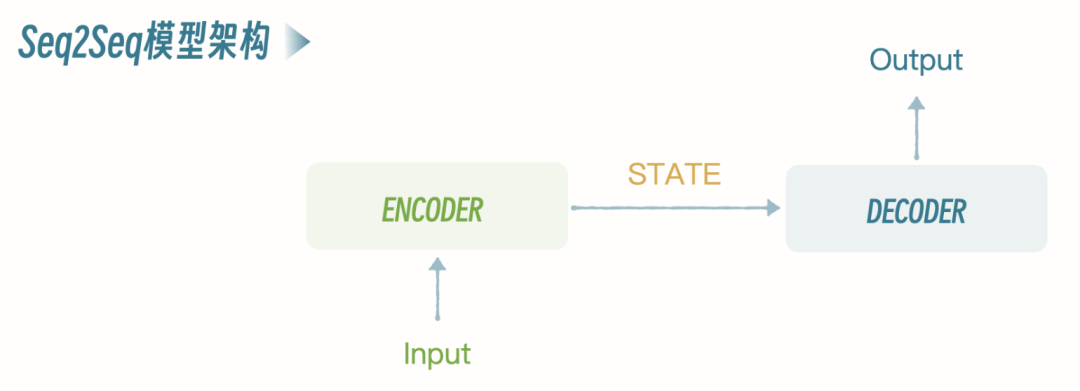
图 1 Seq2Seq 架构示意图(编码器—解码器)
1. 编码器(Encoder)
编码器的工作是读取并理解输入序列,把它转换成一个固定长度的上下文向量(context vector),也叫状态向量。这个向量是输入序列在模型内部的一种表示,浓缩了整句话的关键信息。实现上,编码器通常采用循环神经网络(RNN)或其变体——长短期记忆网络(LSTM)、门控循环单元(GRU),因为它们既能接纳长度不一的输入,也能记住序列里的长期依赖。
2. 解码器(Decoder)
解码器接收编码器产出的上下文向量,据此一步步生成目标序列。生成是“一步一个”进行的:每一步输出目标序列中的一个词或字符,直到吐出结束标记为止。解码器通常同样由 RNN/LSTM/GRU 构成,它在生成下一个元素时,既参考编码器给的上下文向量,也参考自己此前已经生成的输出。
3. 注意力机制(可选)
在编码器和解码器之间,还可以插入注意力机制(Attention Mechanism)。它的作用是让解码器在生成每一个输出元素时,能够“有侧重地”关注输入序列的不同位置,而不是只盯着一个固定的压缩向量,从而显著提升模型处理长句和复杂依赖的能力。
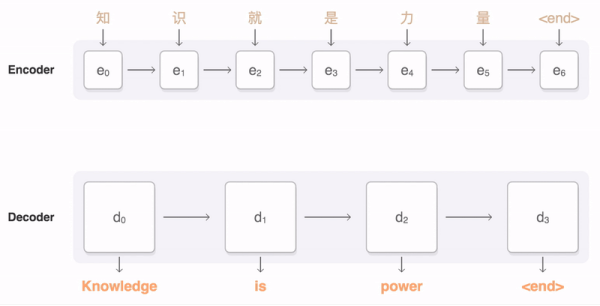
图 2 编码器、解码器与注意力机制的协作示意图
三、工作原理
下面通过一个中译英的例子来说明 Seq2Seq 的工作流程。我们先从训练讲起。Seq2Seq 的训练和 Word2Vec 差别不小:我们做的是翻译,所以训练数据是“中英对照”的句子对,整体也比 Word2Vec 更复杂。上一节课的 Word2Vec 直接调用了 gensim 现成模型,这一节课则完全从零写起,亲手训练一个 Seq2Seq。
四、模型训练
1. 准备数据
可以采用公开的平行语料,例如 AIchallenger 2017,它包含约 1000 万对中英句对。受机器算力所限,这里只从中文和英文两侧各抽取 1 万条用于训练。读取时逐行读入文件、去掉行尾换行符,分别存入中文列表与英文列表。
cn_sentences = []
zh_file_path = "train_1w.zh"
# 使用Python的文件操作逐行读取文件,并将每一行的内容添加到列表中
with open(zh_file_path, "r", encoding="utf-8") as file:
    for line in file:
        # 去除行末的换行符并添加到列表中
        cn_sentences.append(line.strip())
en_sentences = []
en_file_path = "train_1w.en"
# 使用Python的文件操作逐行读取文件,并将每一行的内容添加到列表中
with open(en_file_path, "r", encoding="utf-8") as file:
    for line in file:
        # 去除行末的换行符并添加到列表中
        en_sentences.append(line.strip())
2. 构建词表
遍历所有句子、逐句分词、统计词频,再把每个词映射为一个唯一的整数索引。要点有二:一是过滤掉频次低于 min_freq 的低频词;二是预留四个特殊标记。
·<unk>:未知词,标记训练集里没出现过的词;
·<pad>:填充符,把长短不一的序列补齐到同一长度,以便成批处理;
·<sos>:句首标记,放在目标句开头,提示解码器开始生成;
·<eos>:句尾标记,放在目标句末尾,提示解码器结束生成。
def build_vocab(sentences, tokenizer, max_size, min_freq):
    token_freqs = Counter()
    for sentence in sentences:
        tokens = tokenizer(sentence)
        token_freqs.update(tokens)
    vocab = {token: idx + 4 for idx, (token, freq) in enumerate(token_freqs.items()) if freq >= min_freq}
    vocab['<unk>'] = 0
    vocab['<pad>'] = 1
    vocab['<sos>'] = 2
    vocab['<eos>'] = 3
    return vocab
vocab = {
'<unk>': 0,
'<pad>': 1,
'<sos>': 2,
'<eos>': 3,
'i': 4,
'like': 5,
'learning': 6,
'machine': 7,
'is': 8,
'very': 9,
'interesting': 10,
...
}3. 组织数据集
把每个句子转换成整数索引序列(如 [1,2,3,4]),封装成 Dataset,再用 DataLoader 按 batch 加载。
dataset = TranslationDataset(cn_sentences, en_sentences, cn_vocab, en_vocab, tokenize_cn, tokenize_en)
train_loader = DataLoader(dataset, batch_size=32, collate_fn=collate_fn)
4. 检测设备
有 GPU 就用 GPU,没有则退回 CPU:
# 检查是否有可用的GPU,如果没有,则使用CPU
device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
print("训练设备为:", device)
5. 搭建模型
设定一组超参数:输入/输出词表大小、编码器与解码器的嵌入维度、隐藏维度、RNN 层数、dropout 比例;随后实例化 Encoder 与 Decoder,组合成 Seq2Seq,并定义优化器(Adam)与损失函数(交叉熵,忽略填充位)。
# 定义一些超参数
INPUT_DIM = 10000 # 输入语言的词汇量
OUTPUT_DIM = 10000 # 输出语言的词汇量
ENC_EMB_DIM = 256 # 编码器嵌入层大小,也就是编码器词向量维度
DEC_EMB_DIM = 256 # 解码器嵌入层大小,解码器词向量维度
HID_DIM = 512 # 隐藏层维度
N_LAYERS = 2 # RNN层的数量
ENC_DROPOUT = 0.5 # 编码器神经元输出的数据有50%会被随机丢掉
DEC_DROPOUT = 0.5 # 解码器同上

enc = Encoder(INPUT_DIM, ENC_EMB_DIM, HID_DIM, N_LAYERS, ENC_DROPOUT)
dec = Decoder(OUTPUT_DIM, DEC_EMB_DIM, HID_DIM, N_LAYERS, DEC_DROPOUT)

model = Seq2Seq(enc, dec, device).to(device)
# 假定模型已经被实例化并移到了正确的设备上
model.to(device)
# 定义优化器和损失函数
optimizer = optim.Adam(model.parameters())
criterion = nn.CrossEntropyLoss(ignore_index=en_vocab['<pad>']) # 忽略<pad>标记的损失
6. 训练循环
每个 epoch 遍历数据:前向、算损失、反向、更新参数。训练时喂给模型的是“去掉最后一个词的目标句”,损失则按“从第一个词开始的目标句”计算。
num_epochs = 10 # 训练轮数
for epoch in range(num_epochs):
    model.train()
    total_loss = 0
    for src, trg in train_loader:
        src, trg = src.to(device), trg.to(device)
        optimizer.zero_grad() # 清空梯度
        output = model(src, trg[:-1]) # 输入给模型的是除了最后一个词的目标句子
        # Reshape输出以匹配损失函数期望的输入
        output_dim = output.shape[-1]
        output = output.view(-1, output_dim)
        trg = trg[1:].view(-1) # 从第一个词开始的目标句子
        loss = criterion(output, trg) # 计算模型输出和实际目标序列之间的损失
        loss.backward() # 通过反向传播计算损失相对于模型参数的梯度
        optimizer.step() # 根据梯度更新模型参数,这是优化器的一个步骤
        total_loss += loss.item()
    avg_loss = total_loss / len(train_loader)
    print(f'Epoch {epoch + 1}/{num_epochs}, Average Loss: {avg_loss}')
7. 一个具体的例子
以“我 喜欢 学习 机器 学习 → I like studying machine learning”为例:训练前先把原文转成词表里的索引序列(例如“我 喜欢 学习 机器 学习”对应 1,2,3,4,5,即 [1,2,3,4,5]);编码器用 GRU 处理后输出上下文向量,作为解码器的初始状态;解码器每步计算目标词表的概率分布(比如第一步算出 “I”:0.3、“studying”:0.5……),取概率最高的词作为当前输出;再把这个输出与真实目标对比算损失、反向传播、更新参数。如此反复,直到收敛。可见训练轮数很关键,太少学不到位,太多又容易过拟合。
五、模型验证与推理
验证阶段用一个翻译函数把输入句子分词、加 <sos>/<eos>,转成索引和张量,交给编码器得到上下文向量;解码器从 <sos> 出发循环最多 max_len 步,每步用 argmax 取概率最高的词,遇到 <eos> 就停止,把生成的词拼成译文。
def translate_sentence(sentence, src_vocab, trg_vocab, model, device, max_len=50):
    # 将输入句子进行分词并转换为索引序列
    src_tokens = ['<sos>'] + tokenize_cn(sentence) + ['<eos>']
    src_indices = [src_vocab[token] if token in src_vocab else src_vocab['<unk>'] for token in src_tokens]
    # 将输入句子转换为张量并移动到设备上
    src_tensor = torch.LongTensor(src_indices).unsqueeze(1).to(device)
    # 将输入句子传递给编码器以获取上下文张量
    with torch.no_grad():
        encoder_hidden = model.encoder(src_tensor)
    # 初始化解码器输入为<sos>
    trg_token = '<sos>'
    trg_index = trg_vocab[trg_token]
    # 存储翻译结果
    translation = []
    # 解码过程
    for _ in range(max_len):
        # 将解码器输入传递给解码器,并获取输出和隐藏状态
        with torch.no_grad():
            trg_tensor = torch.LongTensor([trg_index]).to(device)
            output, encoder_hidden = model.decoder(trg_tensor, encoder_hidden)
        # 获取解码器输出中概率最高的单词的索引
        pred_token_index = output.argmax(dim=1).item()
        # 如果预测的单词是句子结束符,则停止解码
        if pred_token_index == trg_vocab['<eos>']:
            break
        # 否则,将预测的单词添加到翻译结果中
        pred_token = list(trg_vocab.keys())[list(trg_vocab.values()).index(pred_token_index)]
        translation.append(pred_token)
        # 更新解码器输入为当前预测的单词
        trg_index = pred_token_index
    # 将翻译结果转换为字符串并返回
    translation = ' '.join(translation)
    return translation

sentence = "我喜欢学习机器学习。"
translation = translate_sentence(sentence, cn_vocab, en_vocab, model, device)
print(f"Chinese: {sentence}")
print(f"Translation: {translation}")
文中示例的输出是“我喜欢学习机器学习。” → “I a a a . a . . . .”,基本只翻对了“我”一个字,其余都失败了,原因大概率是训练数据太少(只用了 1 万对)。
推理和训练很像,区别在于:训练时模型在“记忆”参数,推理时直接用这些参数逐词计算概率。
六、核心代码结构
下面是模型的核心类定义,整体代码即前面各块的组合。
import torch
from torch.utils.data import Dataset, DataLoader
import spacy
import jieba
from collections import Counter
from torch.nn.utils.rnn import pad_sequence
import torch.nn as nn
import random
import torch.optim as optim

# 加载英文的Spacy模型
spacy_en = spacy.load('en_core_web_sm')

def tokenize_en(text):
    """
    Tokenizes English text from a string into a list of strings (tokens)
    """
    return [tok.text for tok in spacy_en.tokenizer(text)]

def tokenize_cn(text):
    """
    Tokenizes Chinese text from a string into a list of strings (tokens)
    """
    return list(jieba.cut(text))

def build_vocab(sentences, tokenizer, max_size, min_freq):
    token_freqs = Counter()
    for sentence in sentences:
        tokens = tokenizer(sentence)
        token_freqs.update(tokens)
    vocab = {token: idx + 4 for idx, (token, freq) in enumerate(token_freqs.items()) if freq >= min_freq}
    vocab['<unk>'] = 0
    vocab['<pad>'] = 1
    vocab['<sos>'] = 2
    vocab['<eos>'] = 3
    return vocab

class TranslationDataset(Dataset):
    def __init__(self, src_sentences, trg_sentences, src_vocab, trg_vocab, tokenize_src, tokenize_trg):
        self.src_sentences = src_sentences
        self.trg_sentences = trg_sentences
        self.src_vocab = src_vocab
        self.trg_vocab = trg_vocab
        self.tokenize_src = tokenize_src
        self.tokenize_trg = tokenize_trg
    def __len__(self):
        return len(self.src_sentences)
    def __getitem__(self, idx):
        src_sentence = self.src_sentences[idx]
        trg_sentence = self.trg_sentences[idx]
        src_indices = [self.src_vocab[token] if token in self.src_vocab else self.src_vocab['<unk>']
                       for token in ['<sos>'] + self.tokenize_src(src_sentence) + ['<eos>']]
        trg_indices = [self.trg_vocab[token] if token in self.trg_vocab else self.trg_vocab['<unk>']
                       for token in ['<sos>'] + self.tokenize_trg(trg_sentence) + ['<eos>']]
        return torch.tensor(src_indices), torch.tensor(trg_indices)

def collate_fn(batch):
    src_batch, trg_batch = zip(*batch)
    src_batch = pad_sequence(src_batch, padding_value=1) # 1 is the index for <pad>
    trg_batch = pad_sequence(trg_batch, padding_value=1) # 1 is the index for <pad>
    return src_batch, trg_batch

class Encoder(nn.Module):
    def __init__(self, input_dim, emb_dim, hid_dim, n_layers, dropout):
        super().__init__()
        self.embedding = nn.Embedding(input_dim, emb_dim)
        self.rnn = nn.GRU(emb_dim, hid_dim, n_layers, dropout=dropout)
        self.dropout = nn.Dropout(dropout)
    def forward(self, src):
        # src: [src_len, batch_size]
        embedded = self.dropout(self.embedding(src))
        outputs, hidden = self.rnn(embedded)
        return hidden

class Decoder(nn.Module):
    def __init__(self, output_dim, emb_dim, hid_dim, n_layers, dropout):
        super().__init__()
        self.output_dim = output_dim
        self.embedding = nn.Embedding(output_dim, emb_dim)
        self.rnn = nn.GRU(emb_dim, hid_dim, n_layers, dropout=dropout)
        self.fc_out = nn.Linear(hid_dim, output_dim)
        self.dropout = nn.Dropout(dropout)
    def forward(self, input, hidden):
        input = input.unsqueeze(0) # input: [1, batch_size]
        embedded = self.dropout(self.embedding(input))
        output, hidden = self.rnn(embedded, hidden)
        prediction = self.fc_out(output.squeeze(0))
        return prediction, hidden

class Seq2Seq(nn.Module):
    def __init__(self, encoder, decoder, device):
        super().__init__()
        self.encoder = encoder
        self.decoder = decoder
        self.device = device
    def forward(self, src, trg, teacher_forcing_ratio=0.5):
        # src: [src_len, batch_size]
        # trg: [trg_len, batch_size]
        trg_len = trg.shape[0]
        batch_size = trg.shape[1]
        trg_vocab_size = self.decoder.output_dim
        outputs = torch.zeros(trg_len, batch_size, trg_vocab_size).to(self.device)
        hidden = self.encoder(src)
        input = trg[0, :]
        for t in range(1, trg_len):
            output, hidden = self.decoder(input, hidden)
            outputs[t] = output
            teacher_force = random.random() < teacher_forcing_ratio
            top1 = output.argmax(1)
            input = trg[t] if teacher_force else top1
        return outputs
七、小结
这节课我们亲手训练了一个 Seq2Seq。它已经算是比较高级的神经网络模型,除了机器翻译,还能做基础的问答。但它的短板也很明显:其一,固定长度的上下文向量限制了它对长距离依赖的建模能力;其二,训练和推理都要逐步串行处理序列,处理长序列受限;其三,参数量通常偏小,面对复杂场景时性能可能受限。
带着这些问题,下一节课我们将进入“终极大 boss”——Transformer。前面 ML → NLP → Word2Vec → Seq2Seq 一路铺垫,正是为了给 Transformer 做准备。
思考题
推理时,模型会使用训练阶段“记住”的参数来计算下一个词的概率。那么,模型的参数到底是什么?欢迎在评论区一起讨论。