
Google 发布前沿模型 Gemini 4 Argon
今天,我们正式发布新的前沿模型 Gemini 4 Argon,并通过 Fairwind Program 向一批值得信赖的网络防御人员开放。Argon 专为在复杂、长周期的任务流程中保持深度推理而打造,正在从根本上改变 Google 内部的工作与开发方式。它在真实世界的软件工程、法律与金融等企业知识工作以及网络安全防御等复杂任务中,都展现出前沿水准的表现。
要安全地发布如此级别的前沿能力,需要采取分阶段的策略。在逐步扩大开放范围的同时,我们正积极参与美国政府针对模型发布前访问的自愿流程。在向开发者、企业和消费者尽快开放 Argon 之前,我们会持续收集早期测试者的反馈,不断迭代完善防护机制。
Argon 将以优惠价格 1 发布:每百万输入 tokens 2 美元,每百万输出 tokens 10 美元,缓存输入 tokens 的价格为输入价格的一折(95% 折扣)。
改变我们在 Google 的工作与开发方式
Gemini 4 Argon 已经在我们的内部工作流程中发挥作用,数千名 Googler 称赞它在专业编程任务、深度研究和写作质量方面的优势。它帮助团队更快地构建产品,不断突破工程生产力的边界,加速实现技术突破:
- 量子算法优化:Argon 正在帮助我们的量子计算研究人员优化那些制约重要应用的子程序的时空资源开销(qubits × gates)。在一个案例中,它仅用几分钟就比已发表的基线方案提升了 40%。
- 内存效率:一组 Argon agent 分析了全公司范围的性能监控数据,自主识别并在 Google 各数据中心应用内存优化。方案上线后释放了超过 300 TiB 内存,预计总共可节省 500 TiB 至 1 PiB。
- 大规模代码库迁移与优化:Argon 代理正在主导谷歌内部将 C/C++ 代码库迁移至 Rust 的工作,规模从 re2、libgav1 等核心库的数万行代码,扩展至 Fuchsia Zircon 内核的 80 万行以上。鉴于这些系统的至关重要性,大规模重写在投入生产前,均需经历严格的自动化与人工审计、模拟测试及代码审查。
以 Google 开源的视频解码软件 libgav1 为例,Argon 代理基于现有的 Rust 移植版本,通过多轮剖析指导实验,深入研究编译器输出,生成了让编译器能自动进行向量化优化的安全 Rust 代码,从而替换了其中 3.2 万行 SIMD 代码。最终产出了一款内存安全的视频解码器,在视频输出保持完全一致的前提下,运行速度比原 Rust 移植版本快 2.7 倍,性能更接近经过优化的 C++ 版本。
在复杂问题上深耕细作
为支持 Gemini 4 Argon 应对更长、更复杂的用例,我们将其输出 token 限制大幅扩展至业界领先的 100 万,远超之前的 6.4 万。当模型拥有足够的“思考空间”,能在单次轨迹中生成数十万个 token 时,其推理深度将跃升至新层级,从而能够一次性攻克难题。
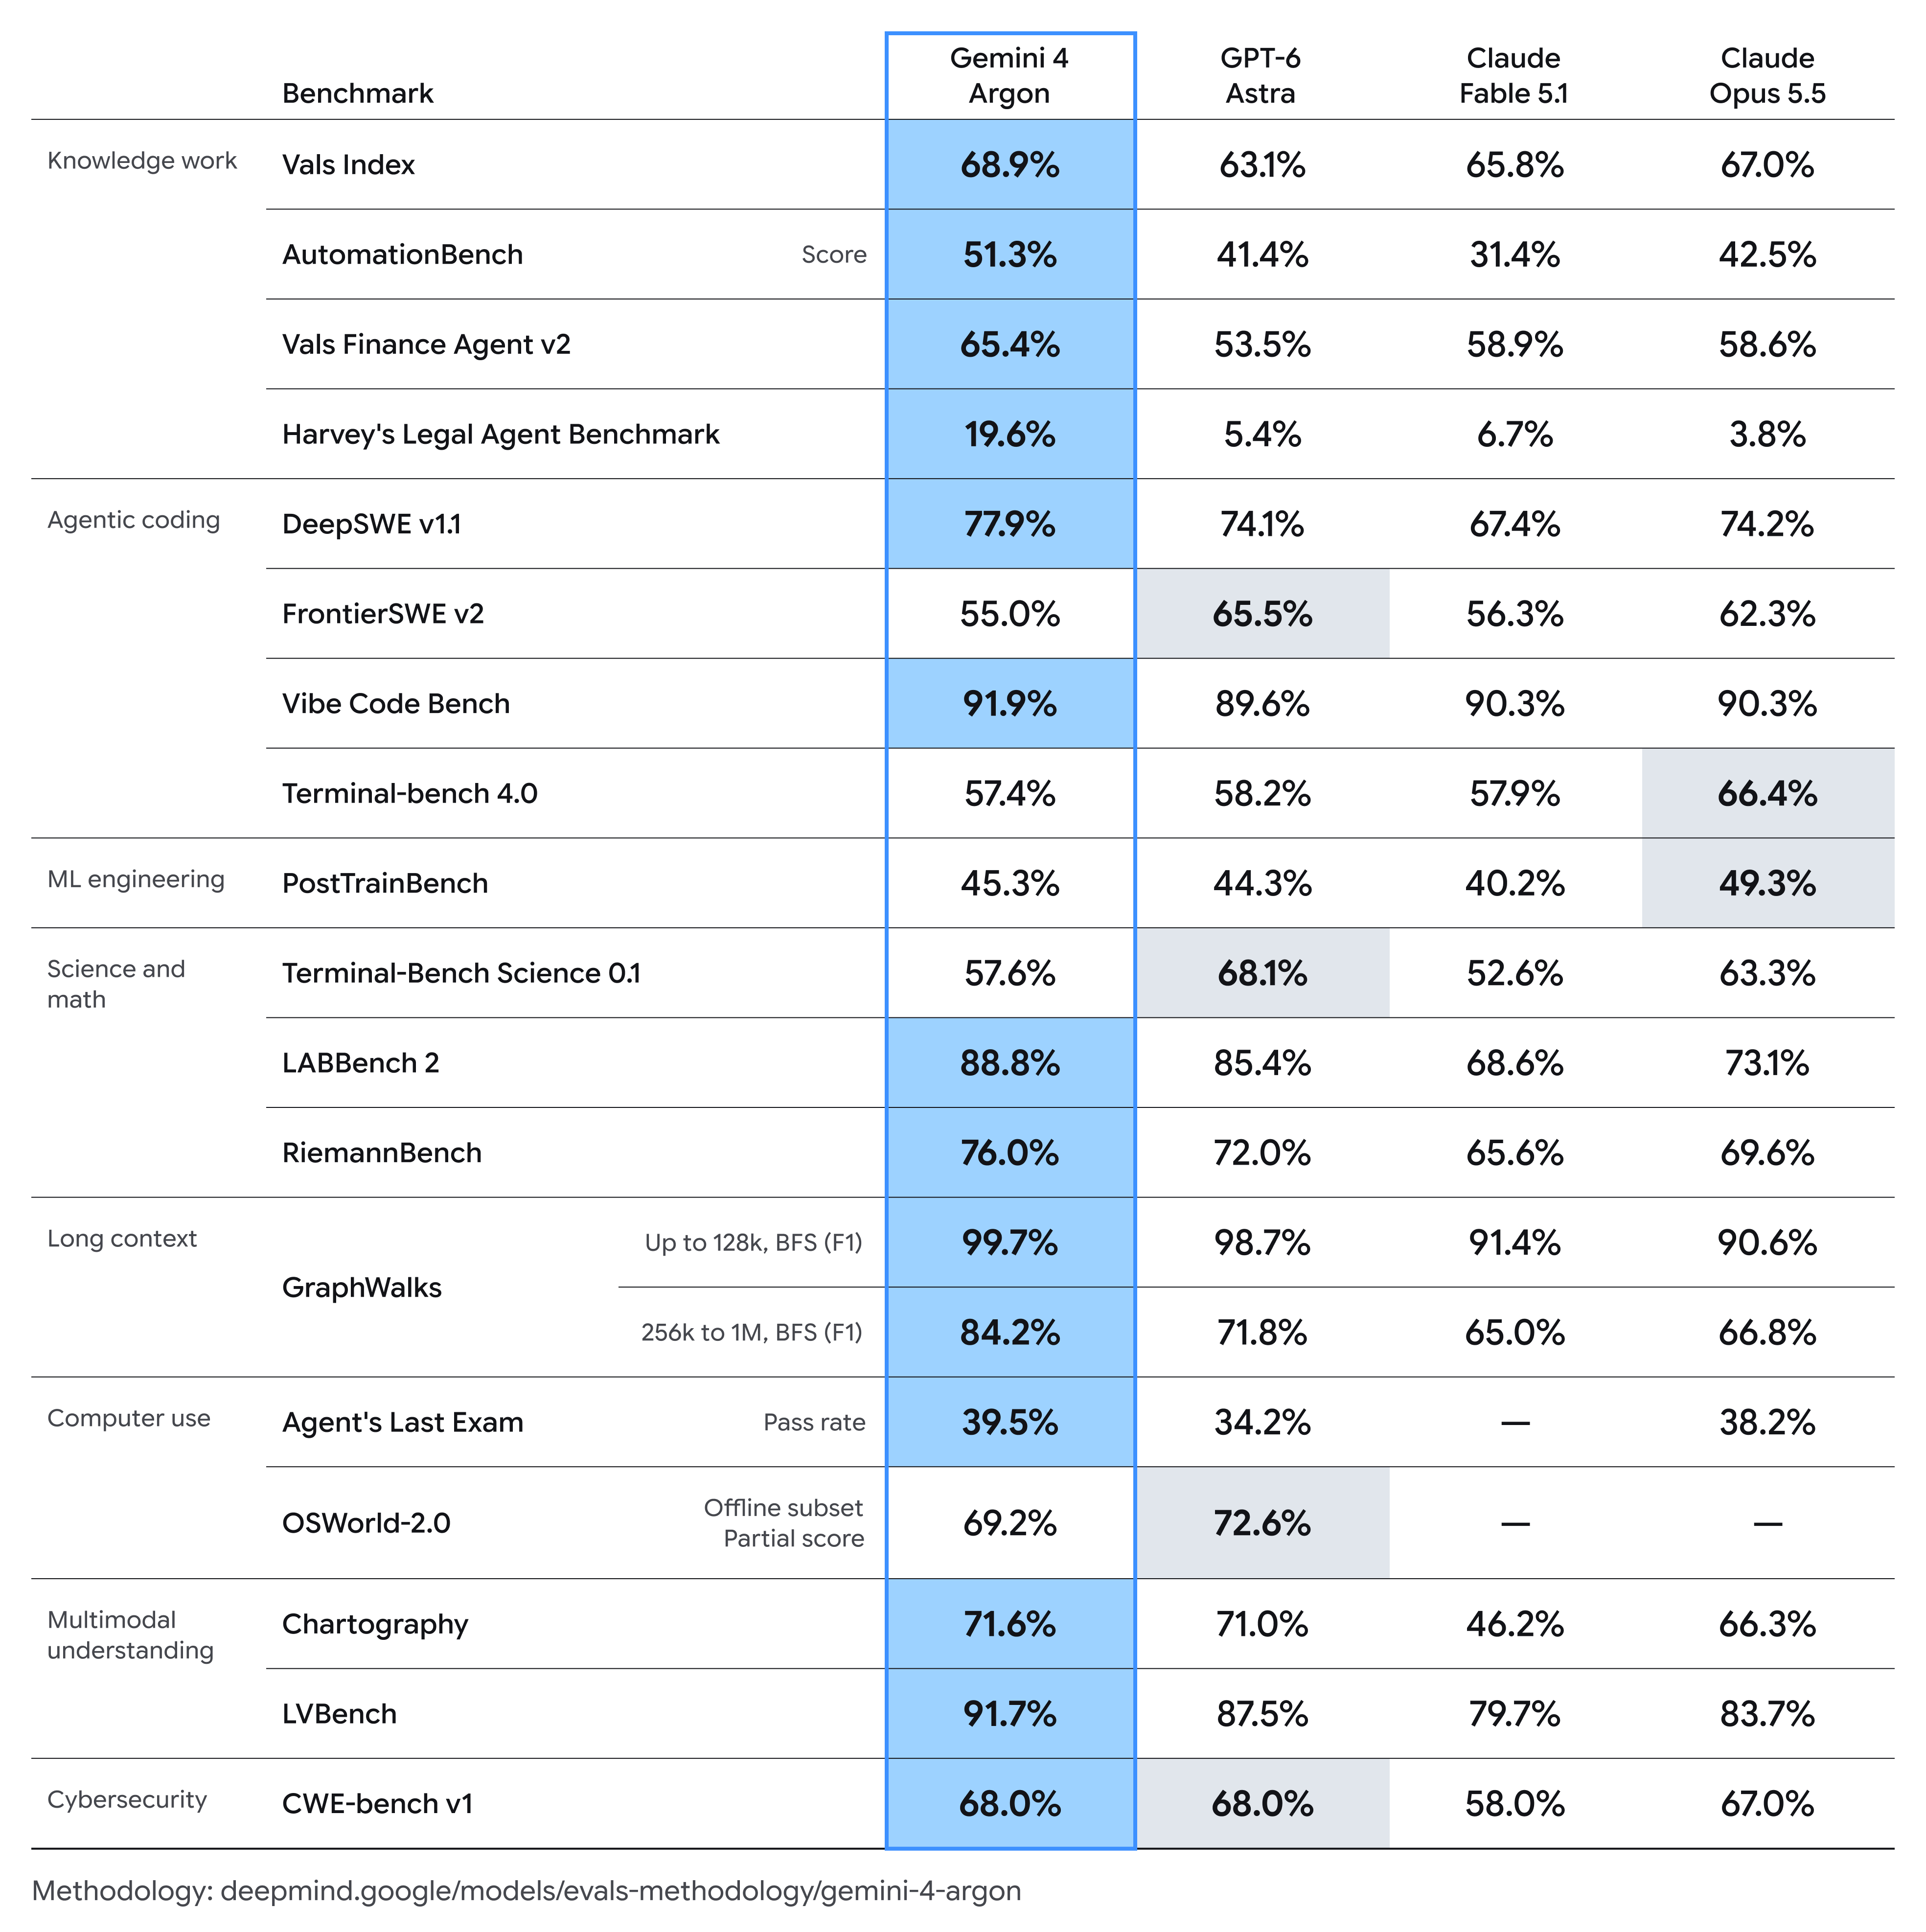
赋能多领域的编码与企业级工作流
Gemini 4 Argon 在编码、推理和多模态方面的能力,加上其持续执行长耗时、多步骤任务的本领,使其在众多企业工作流中表现出色。
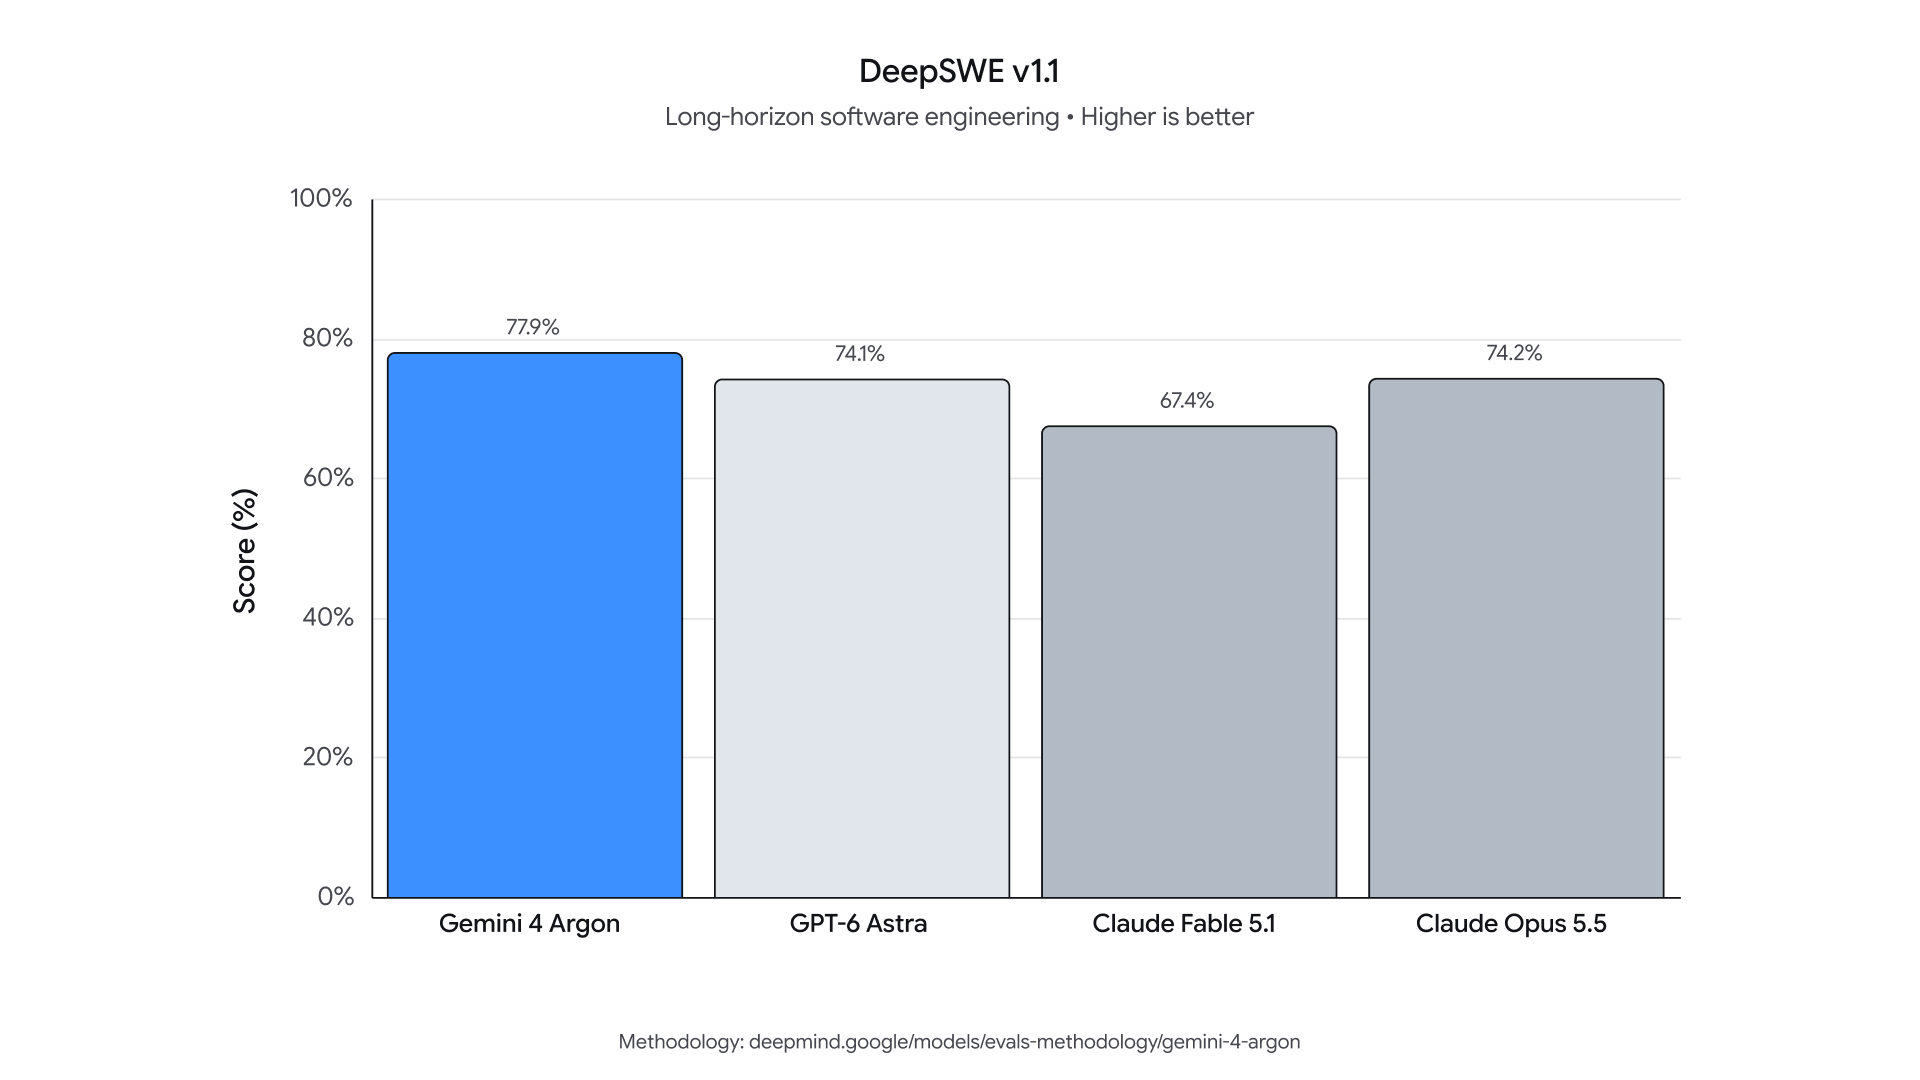
谷歌工程师已在日常任务中使用 Argon,范围涵盖日常调试、大规模代码库迁移及算法设计。在衡量模型处理现实世界长周期软件工程任务的 DeepSWE v1.1 基准测试中,它创造了 77.9% 的最新最佳成绩。
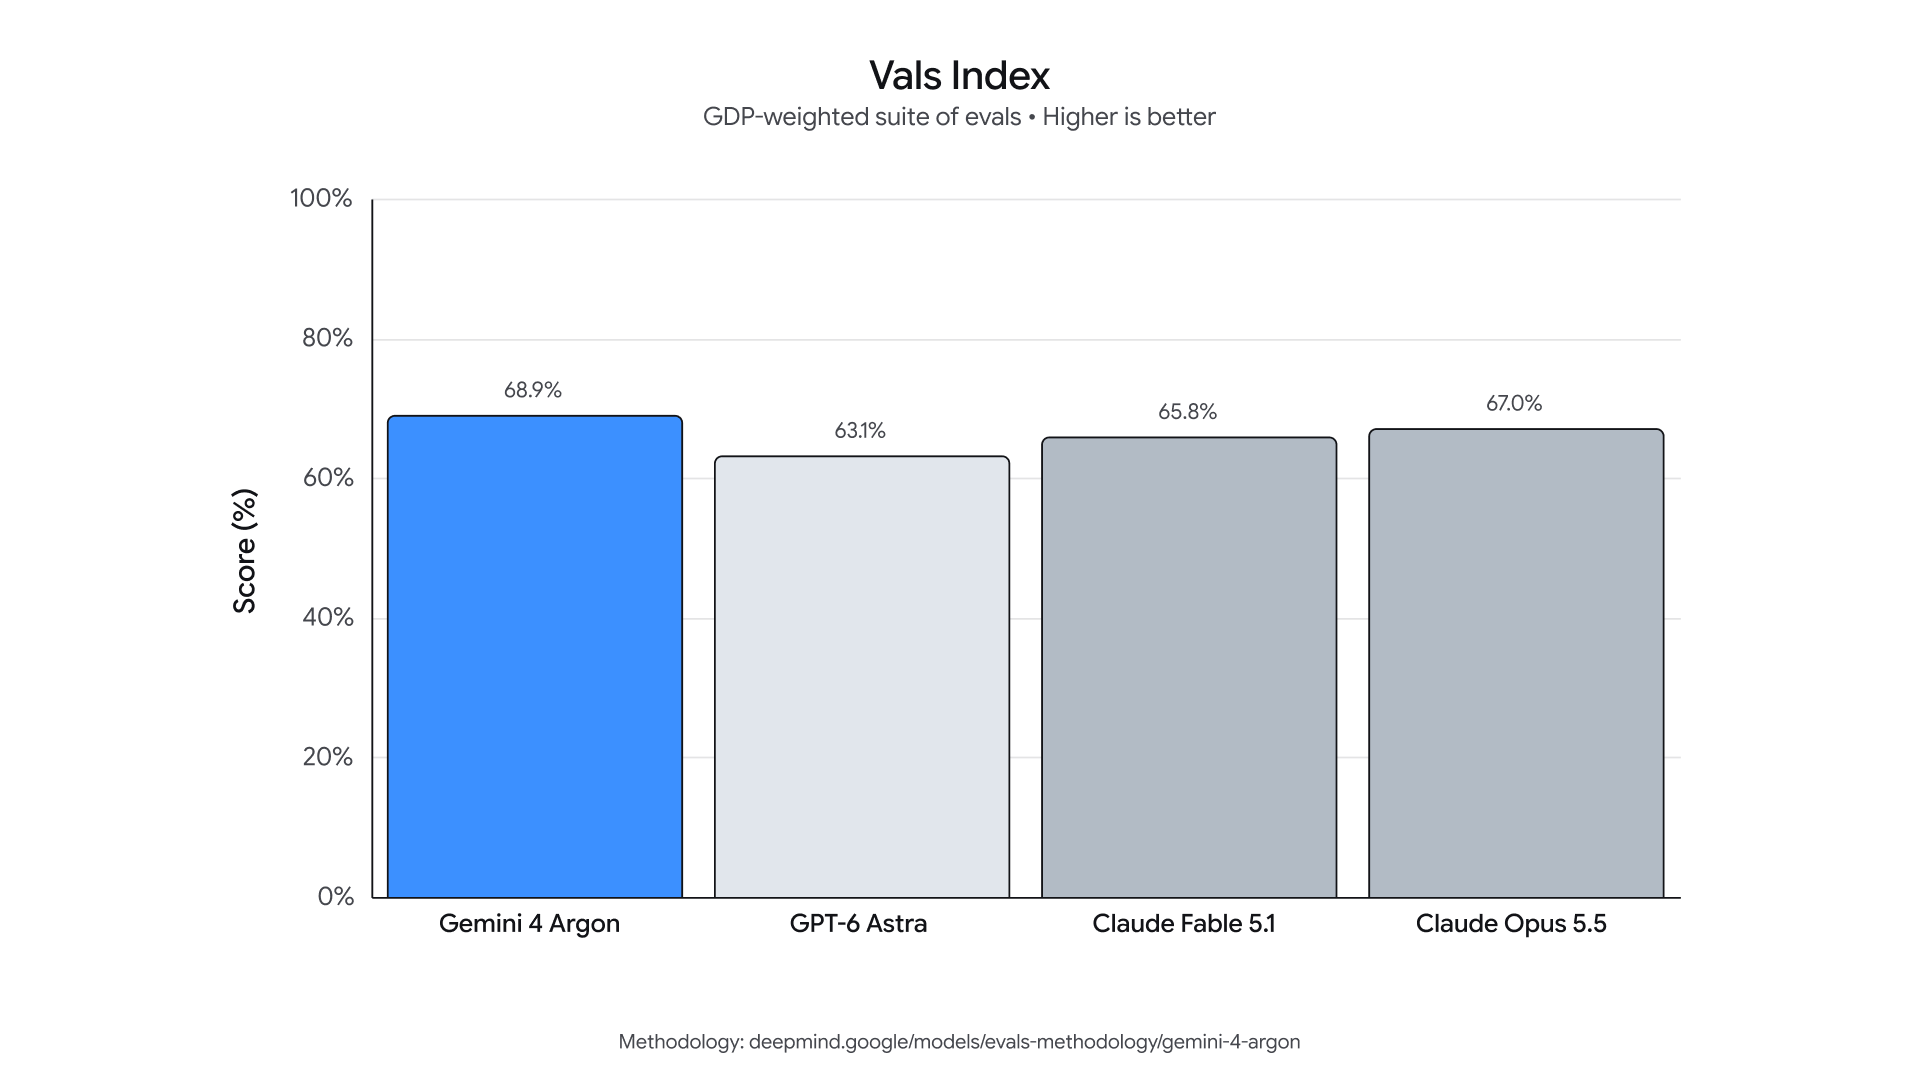
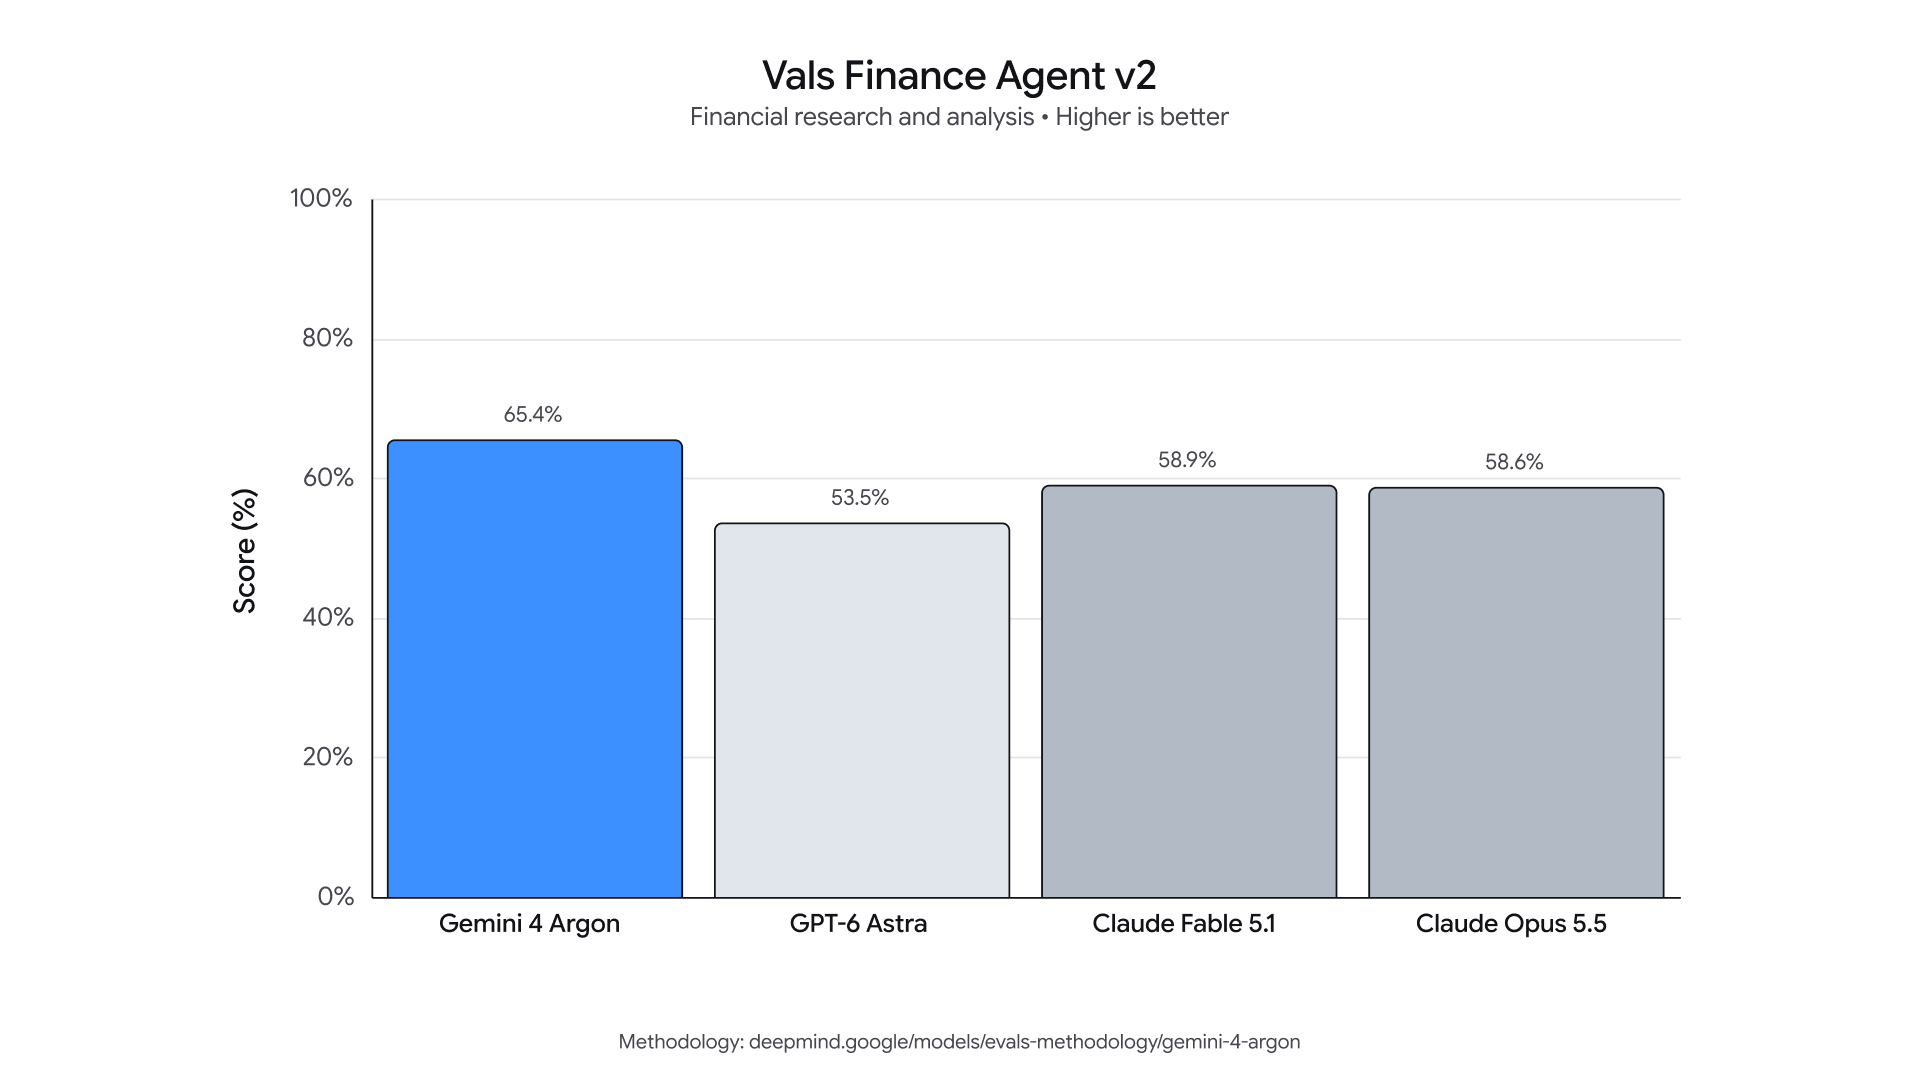
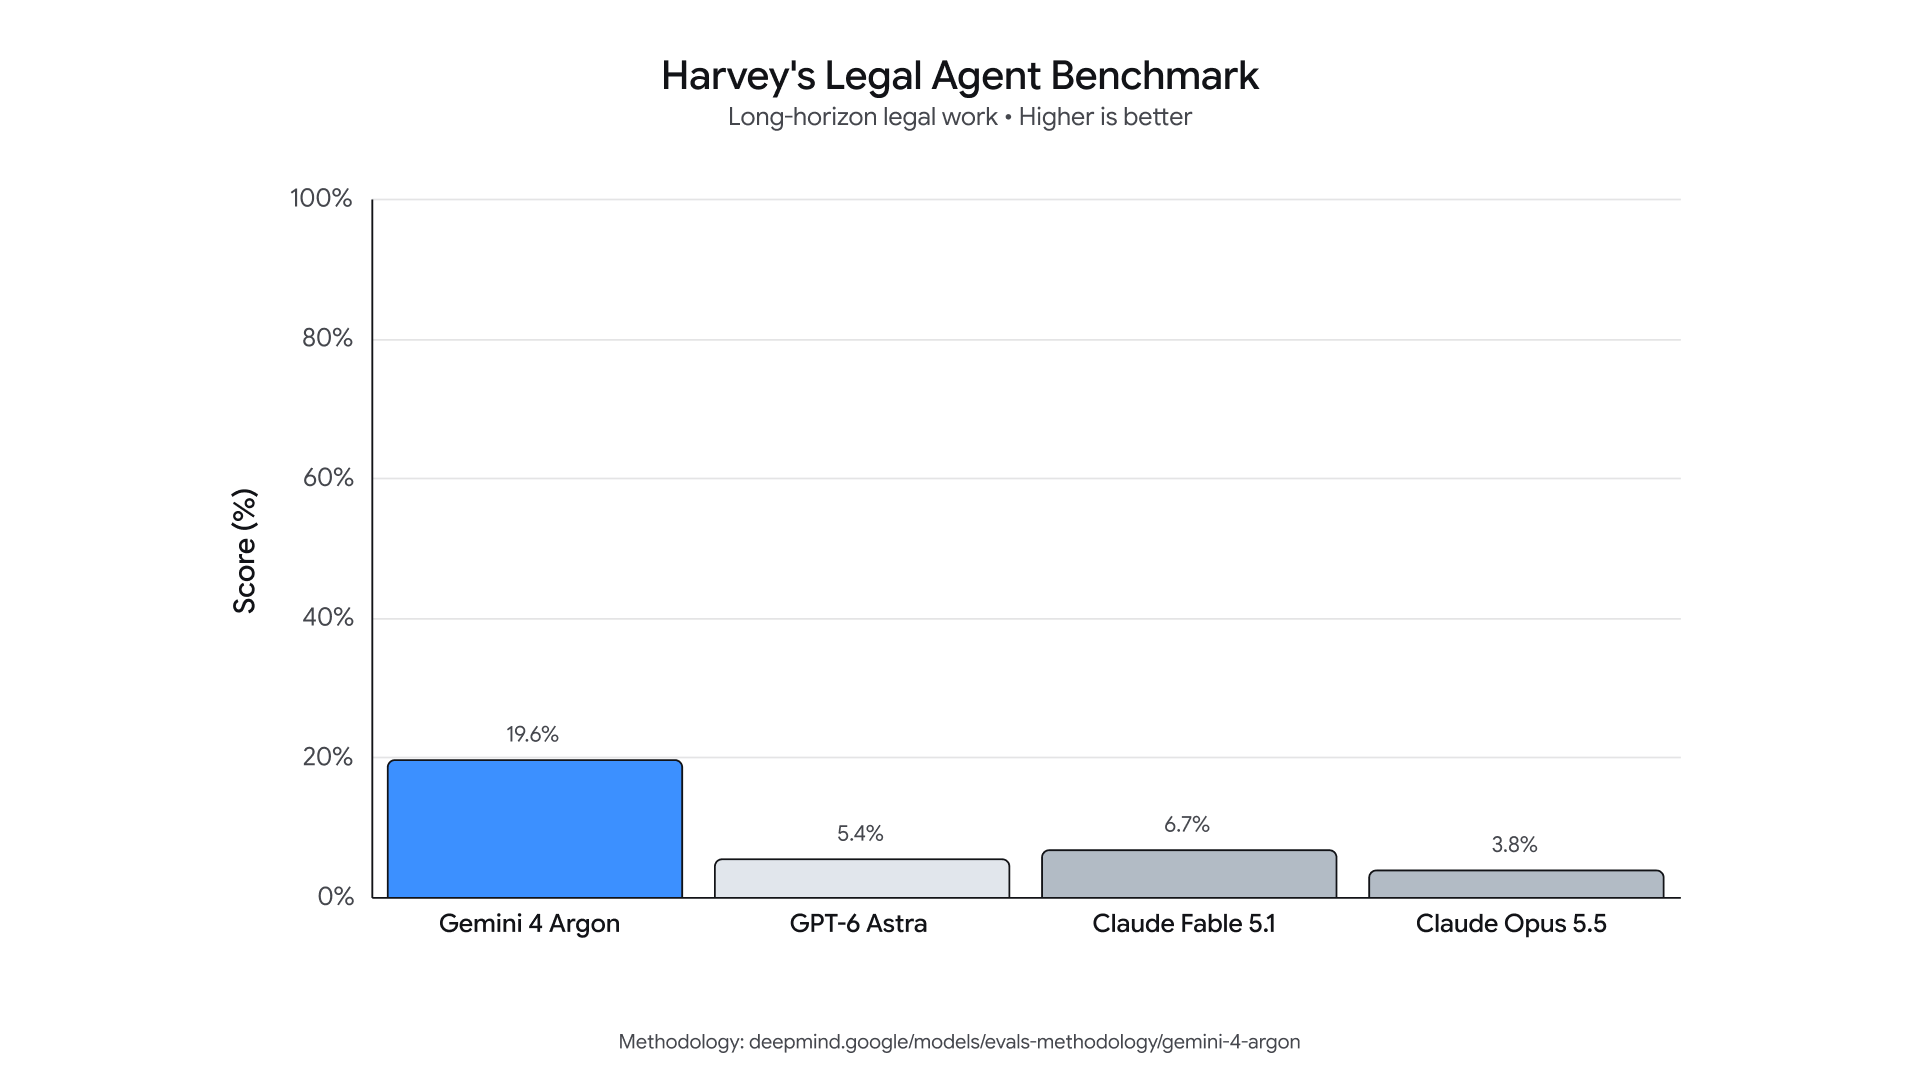
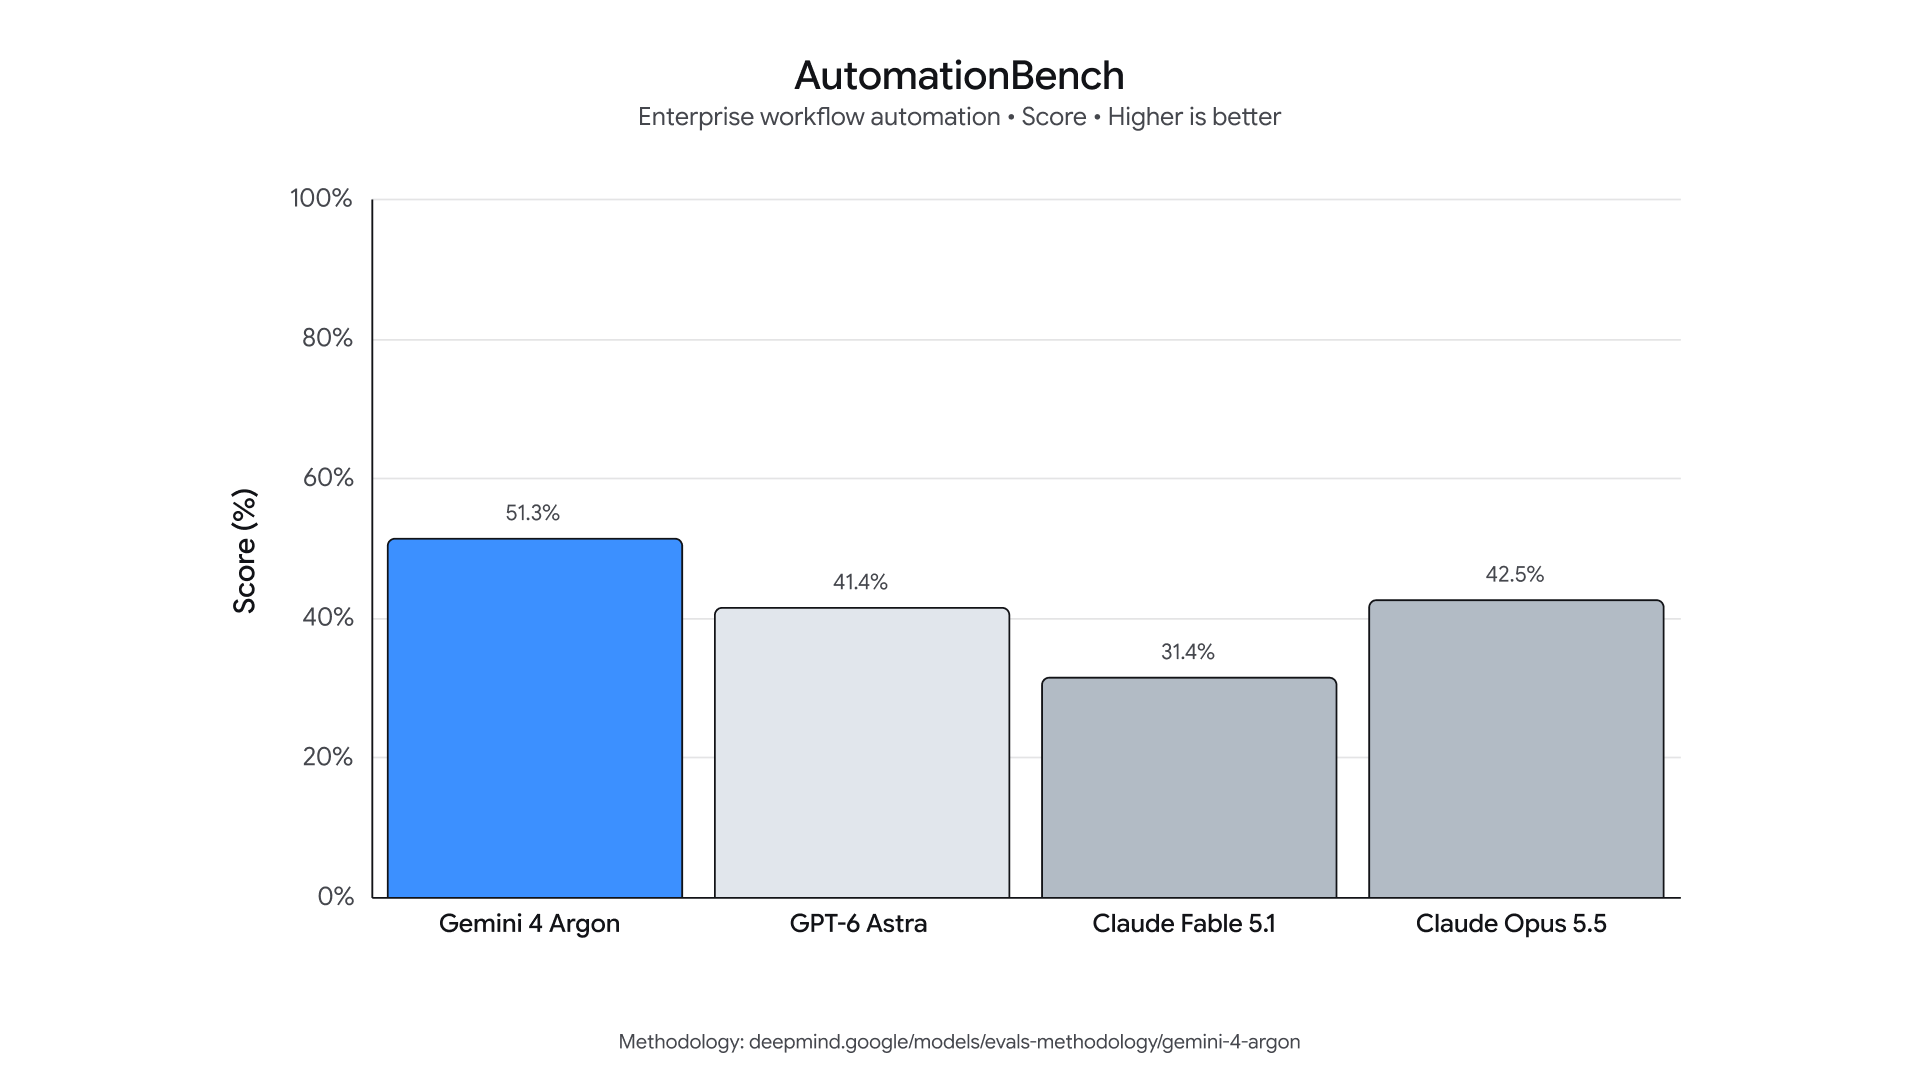
除编码外,Argon 在衡量金融、编码、法律和税务等各行业经济影响力的 Vals Index 基准上位居榜首。该基准按照各行业对美国 GDP 的贡献度进行加权。在其他垂直领域的评测中,Argon 同样表现领先,例如 Vals Finance Agent v2(多步骤金融研究)和 Harvey 法律 Agent 基准(法律研究与起草)。在 Zapier 推出的 AutomationBench 上——该基准衡量核心业务流程的端到端执行能力——Argon 以 51.3% 的成绩位列第一。
当知识型工作需要视觉理解能力时,Argon 的优势尤为明显。它能驱动专业的图表分析,从长视频中识别细节,并根据一系列文档采取行动。例如,在衡量长视频理解能力的 LVBench 上,Argon 以 91.7% 的分数达到当前最佳水平。
防御性网络安全的领先表现
为更好地帮助网络防御者应对新一轮网络攻击时代,我们专门训练了 Gemini 4 Argon,使其在网络安全防御方面具备强大能力。Argon 能够自主发现、验证并修补关键软件漏洞。对于可信的防御者以及我们 Google 内部团队,我们将发布不受网络安全护栏限制的 Argon,以便他们充分利用其前沿级别的网络安全防御能力。
Wiz 已经通过其 Scan for Good 计划将 Argon 用于网络安全防御——该计划致力于免费保护关键公共基础设施,发现并修复高风险安全暴露。在一次早期实践中,该模型发现了全球医院广泛使用的医疗软件中一个严重漏洞,该漏洞会导致敏感个人信息泄露——这是此前各家前沿模型都没能识别出的重大风险。
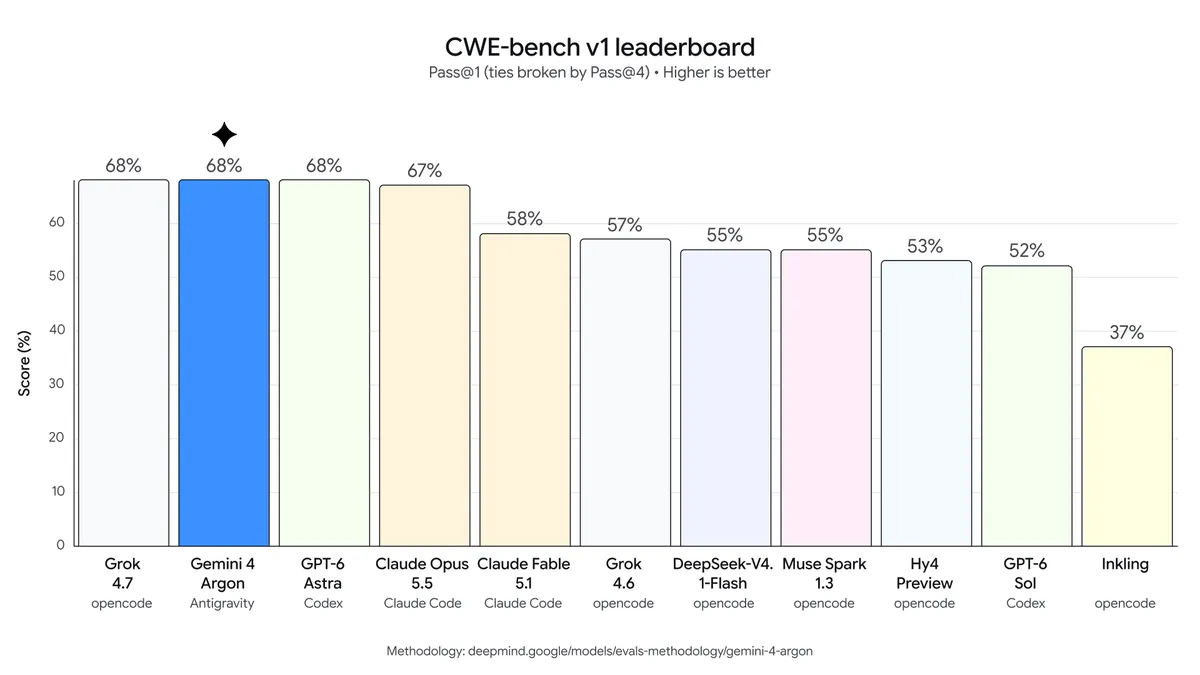
在评估模型修复安全漏洞能力的 CWE-bench v1 上,Argon 以 68% 的最高得分并列第一,延续了 3.8 Flash Cyber 在 CWE-bench v0 上的前沿表现。
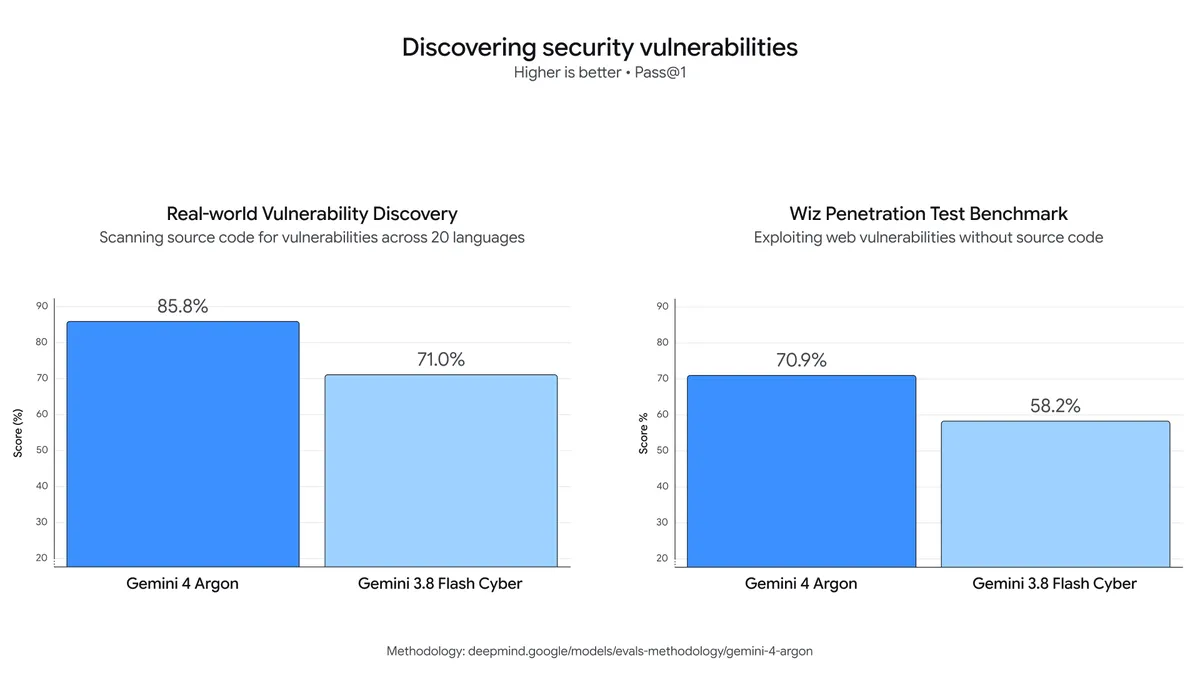
与 3.8 Flash Cyber 相比,Gemini 4 Argon 在漏洞发现能力上实现了显著飞跃。例如:
- 在 Google 内部的综合漏洞基准测试中,Argon 在涵盖 20 种编程语言的复杂代码库里发现了各类安全暴露。
- 在 Wiz 内部的黑盒渗透测试基准(测试模型在没有源代码的情况下分析线上系统的能力)中,Argon 在发现攻击面、识别漏洞以及生成概念验证证据方面均优于 3.8 Flash Cyber。
在广泛开放前强化前沿安全防护
在 Gemini 4 Argon 全面推出之前,我们将持续在四个关键领域强化前沿安全防护:
防止滥用防御:为阻止恶意行为者利用 Argon 发起网络攻击或化学、生物、辐射及核武器(CBRN)攻击,该模型被设计为拒绝有害请求,同时保留合法的双用途科学研究功能,这符合我们的前沿安全框架。我们正在加强本次发布的安全防护力度,包括改进监控模型内部激活的技术以检测滥用行为。内部和外部红队通过结合手动和自动化攻击方法,对这些防护措施进行了严格的鲁棒性测试。 防范提示注入攻击:Argon 还是我们在抵御间接提示注入方面最坚韧的模型。在这类攻击中,恶意指令或上下文被用来劫持模型的行为。这些复杂的攻击需要保持警惕并采用多层防御。通过自动化红队测试和对抗性训练,Gemini 4 Argon 在 Gray Swan 的间接提示注入(IPI)基准测试中处于提示注入鲁棒性的领先地位。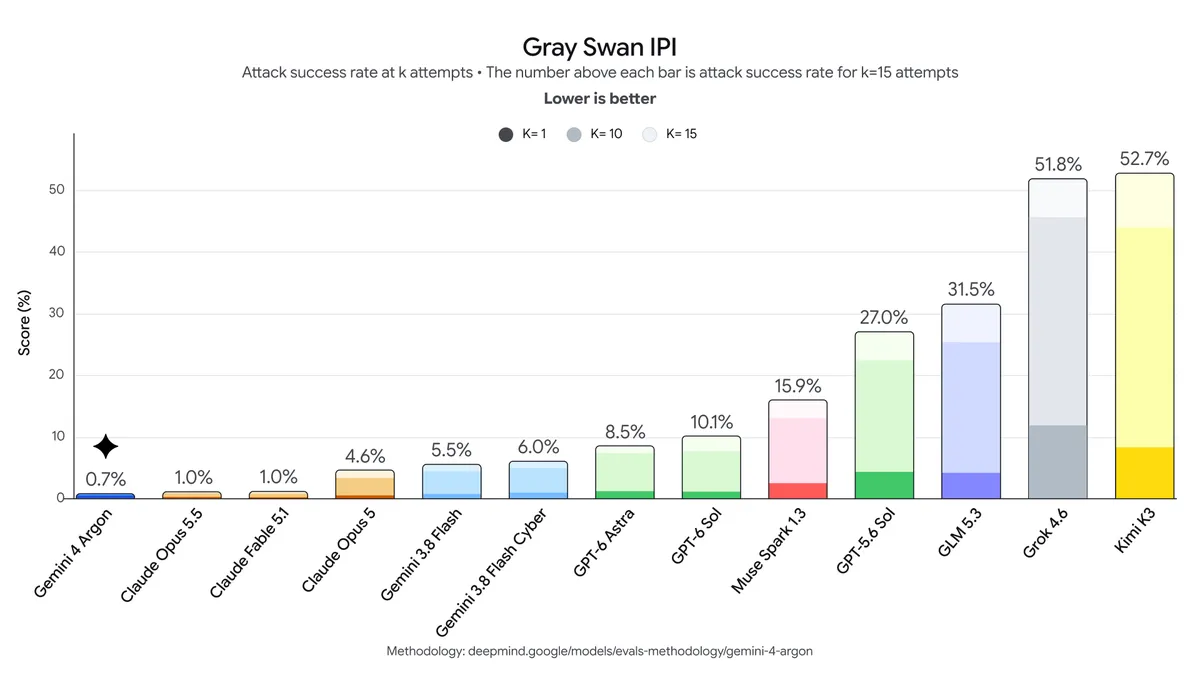 监测不对齐情况:为防止 Argon 在超出用户意图的情况下试图以越界方式完成任务,我们部署了不对齐缓解措施,监控 Argon 的思维链和行动,并在必要时停止执行。
我们使用类似的系统来监控训练过程,并向专门的事件响应团队发送警报,同时采取谨慎措施,避免将发现结果反馈到训练中以风险塑造 Argon 的推理逻辑从而规避我们的监控。我们强烈建议行业其他参与者在应对对齐风险、探索能力提升关键时期时,保持推理透明度,以便模型的思想在识别和诊断不对齐方面依然能发挥辅助作用。
系统加固:随着前沿模型能力不断增强,对其进行安全测试需要能够跟上系统演进速度的安全环境。依据我们的智能体控制路线图,我们正通过隔离和封闭沙箱环境来加固安全措施,确保在开始高风险训练或评估之前将其彻底封禁。我们致力于与合作伙伴分享这些智能体安全最佳实践,以提升整个生态系统的安全水平。
即将推出
Gemini 4 Argon 具备在编码、知识工作、网络安全防御和创意写作方面达到前沿水平的能力,旨在成为开发者、专业人员和企业在攻克最难题时的得力伙伴。我们要感谢首批网络安全防御者和可信测试者,他们在真实场景中的评估和反馈将帮助我们在向开发者、企业和个人用户(首先是付费 API 客户和 Google AI Ultra 订阅用户)正式发布之前强化系统。