
PageIndex Flash 发布:本地极速树状索引引擎,革新长文档 RAG 检索
我们正式发布 PageIndex Flash,一款专为长篇幅文本型 PDF设计的极速树状索引引擎。它完全在你的本地机器上运行,文档数据不出本机,且目前已集成至 PageIndex SDK 中可用。
PageIndex Flash 直接读取 PDF 自身的版面布局来构建层级树状索引,而非依赖视觉模型从零推断全文大纲。这一设计变革使得索引构建变得快速、低成本且可预测,足以应用于你持有的每一份文本型文档。
PageIndex Flash 已完全开源,并成为 SDK 本地模式的默认索引器,将完整的基于推理的 RAG 工作流带到你的本地机器上。你可以构建树状索引、存储文档、执行基于推理的检索,并借助你偏好的 LLM 和 API 密钥与长文档交互,支持页级引用且无需向量数据库。
GitHub 仓库Colab 笔记本快速上手一条命令即可安装:
pip install -U pageindex
PageIndex Flash 专为本地运行设计。它使用你自己的模型 API 密钥,所有索引保留在你的本地磁盘上,且无需向量数据库,非常适合处理私有及受监管的文档工作流。本地流水线直接读取 PDF 并跳过 OCR 步骤,因此仅支持文本型 PDF。对于扫描件或以图片为主的文档,我们建议使用 PageIndex Cloud,它会在构建树状索引前执行 OCR 和图像理解。
什么是 PageIndex?
大多数 RAG 系统会把文档切成固定大小的块,再通过向量相似度来检索。这种方式有用,但相似不等于相关。在长篇专业文档里,真正回答问题的段落,用词可能和问题完全不同;而语义上相近的段落,含义虽然接近,却未必与任务真正相关。财报、法规、技术手册和教科书这类文档,往往需要结合上下文、领域知识和多步推理,才能找准证据。
PageIndex 采用了另一条思路。它把每份文档组织成层级树形索引,然后让 LLM 在这棵树上推理——就像人类读者借助目录和章节结构翻到正确的页码。这样,检索就拆成了两个阶段:先建树,再搜树:
阶段一 —— 为文档构建树形索引输入 report.pdf —— 一份 120 页的纯文本 PDF,在本地完成索引一份 120 页的 PDF 进来了——有标题、章节、页码,但机器没法直接导航。 阶段二 —— 在树中搜索相关信息查询 2023 年的营业利润率是多少?在文档哪里写的?问题来了。不需要 embedding,也不需要分块索引——只需要文档树。2023 年营业利润率为 18.4%。<cite doc="report.pdf" page="43"/>
在 SDK 中使用 PageIndex Flash
我们开发了 PageIndex Flash,用来加速纯文本 PDF 的树形索引构建。它现在是 PageIndex SDK 本地模式的默认索引方式:
import os
from pageindex import PageIndexClient

os.environ["OPENAI_API_KEY"] = "your-openai-key"

client = PageIndexClient(
    index="gpt-5.6-luna",
    chat="gpt-5.6-sol",
)

doc_id = client.submit_document("report.pdf")["doc_id"]

messages = "What benchmarks are used?"

for chunk in client.chat(messages, doc_id=doc_id, stream=True):
    print(chunk, end="", flush=True)
索引构建和文档检索的需求不同,所以 SDK 允许分别配置。
- 索引模型负责生成节点摘要并协助优化树结构,用一款基础、高性价比的模型通常就够了。
- 对话模型负责搜索树、判断相关性、阅读证据并给出最终答案,建议在准确率和成本预算内选最强的模型。
这种分离设计既降低了一次性的索引成本,又不影响后续检索的质量。同时,它也允许在更换对话模型时无需重建文档索引。
PageIndex Flash 正是围绕这一分离机制构建的。由于 PDF 布局已提供结构化信息,索引模型无需重构大纲,只需总结那些已定位的章节。因此,一个低成本模型就足以生成一棵在检索中表现稳定的树,而在此阶段升级到更大的模型带来的收益微乎其微。
在基准测试中,我们采用了廉价模型 gpt-5.6-luna 作为索引模型——与上方代码片段所示一致。使用它进行索引的成本约为每页 $0.001。一本 1000 页的教科书首次索引成本略高于 1 美元,之后同一棵索引树即可服务于所有查询。
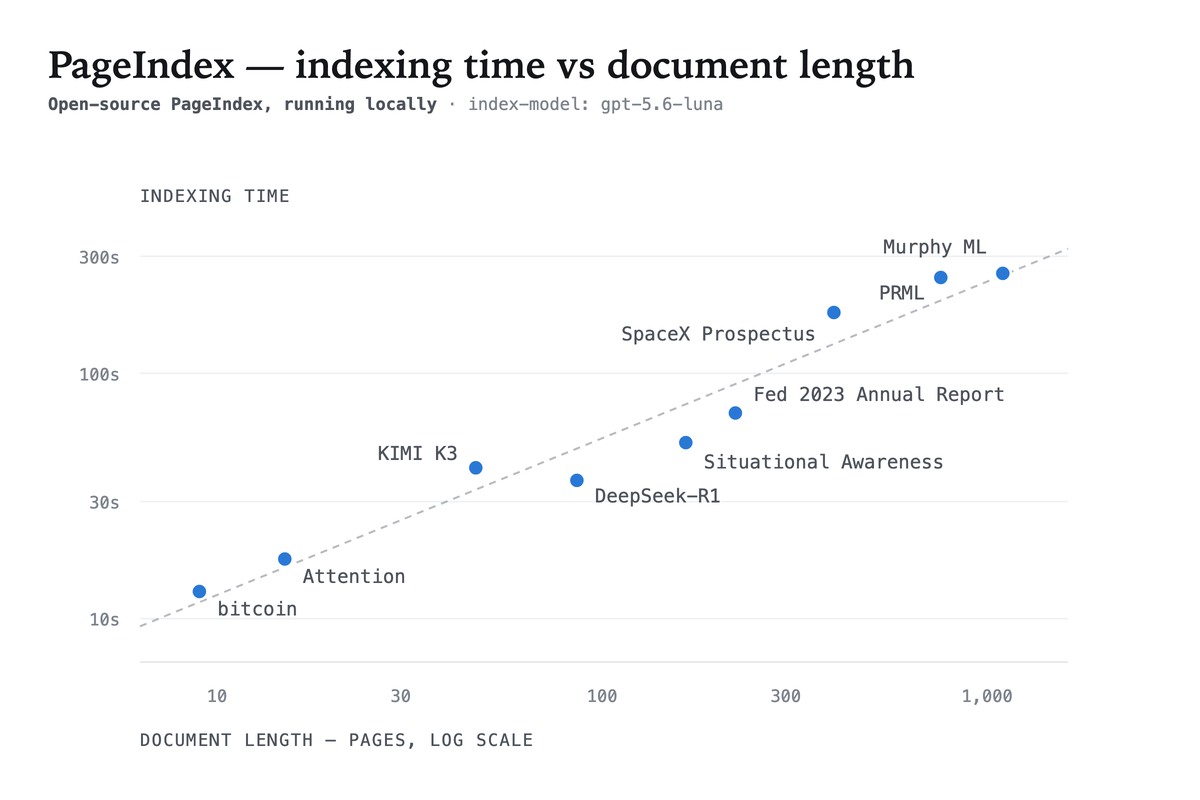
在涵盖 9 至 1098 页的基准文档中,索引耗时约13 秒至 4.5 分钟。
该索引树包含标题、页码范围、摘要及嵌套章节。它充当专为 LLM 搜索优化的目录,同时便于开发人员理解。
查询成本与准确性
PageIndex OSS 基准测试评估了上述相同的本地配置:使用 PageIndex Flash 索引的 PageIndexClient()。
该基准测试包含 34 份 PDF(共 1945 页)上的 62 个查找问题,数据源自 MMLongBench-Doc-V2。所有答案均为正文中陈述的事实,因此错误结果反映的是检索或阅读失败,而非开放式推理分歧。
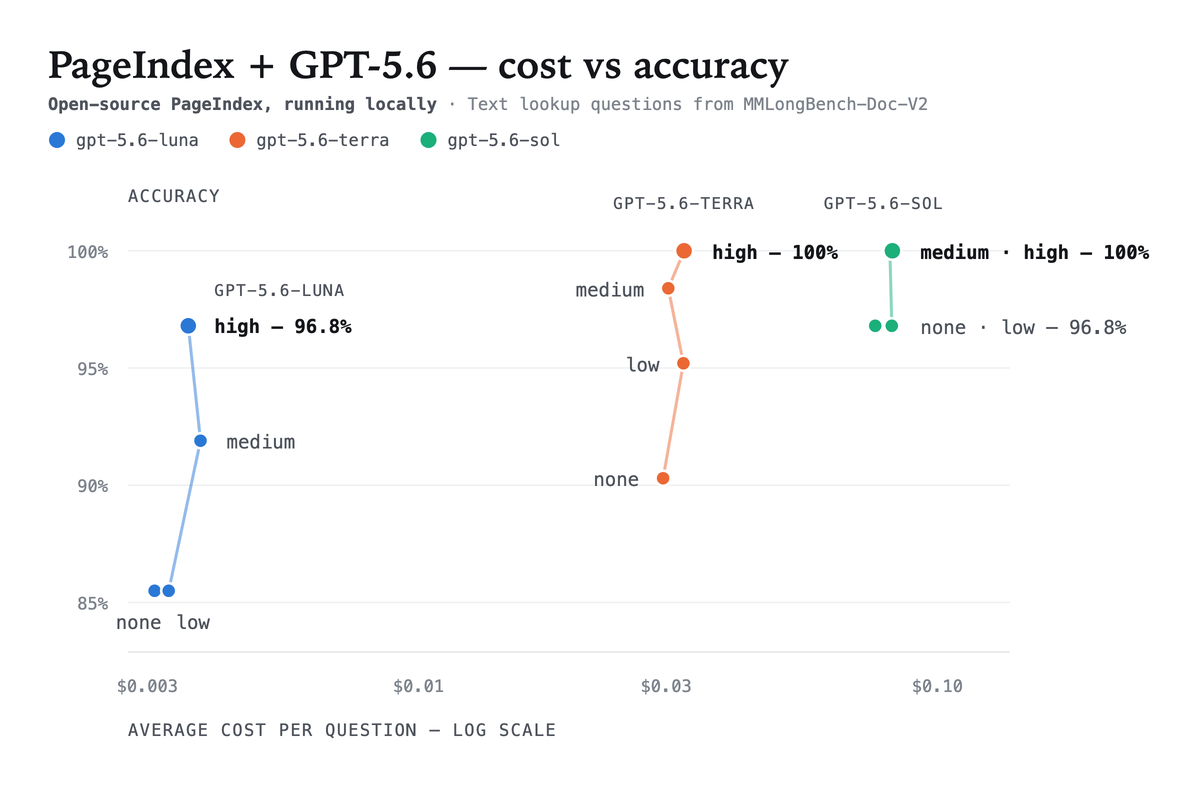
在同一模型内,增加推理努力程度会形成清晰的准确性阶梯,而成本水平保持相对一致。切换到更大的模型可进一步提升性能边界,但通常会使单问题成本增加一个数量级。这为团队提供了实用的部署调优方式:先根据目标预算选择模型家族,再根据所需准确性调整推理努力程度。
在树结构上进行检索,比直接把整份文档塞给模型要便宜得多。原生喂入同一份 PDF,52 页的文件成本高出 2.1 倍,420 页时则高出 16.6 倍;而一旦超过约 800 页,内容甚至无法再装进上下文窗口。

完整结果、源文档以及基准测试执行工具,都可以在 基准测试仓库 中找到。
扫描版及图片密集型 PDF:使用 PageIndex Cloud
直接从 PDF 中提取结构,是 PageIndex Flash 提速的关键,但也将其限制在了基于文本的文件上。扫描页没有文本层,也没有标题元数据——它只是一张文档图片,而非文档本身——因此 PageIndex Flash 无内容可解析。要在这一情况下恢复大纲,需要调用视觉模型来阅读页面并识别其布局,这正是构建索引树之前,PageIndex Cloud 所执行的操作。同理,若文档的含义主要承载在图表、表格和示意图而非正文中,也适用此方案。
针对这类文档,我们推荐使用 PageIndex Cloud,切换起来只需修改一行代码。将 index 指向 cloud,配置好 PageIndex API key,其余工作流完全保持不变:
import os
from pageindex import PageIndexClient

os.environ["PAGEINDEX_API_KEY"] = "your-pageindex-key"
os.environ["OPENAI_API_KEY"] = "your-openai-key"

client = PageIndexClient(
    index="cloud",
    chat="gpt-5.6-sol",
)

doc_id = client.submit_document("report.pdf", wait=True)["doc_id"]

messages = "What benchmarks are used?"

for chunk in client.chat(messages, doc_id=doc_id, stream=True):
    print(chunk, end="", flush=True)
这两种模式的区别,不仅在于索引运行在哪里:
| 能力 | 本地 | 云端 |
|---|---|---|
| 最佳适用场景 | 带有真实文本层的文本型 PDF | 扫描件、图片密集型及大型文档集合 |
| 索引 | 本地运行 | 由 PageIndex Cloud 管理 |
| 存储 | 本地存储 | 托管云存储 |
| 对话模型 | 你的模型 | 你的模型 |
| 引用 | 页级 | 行级 |
| OCR 和图像理解 | — | 支持 |
| 多文档规模 | 手动处理 | PageIndex File System |
| MCP server | — | 支持 |
将 PageIndex 集成到你的 Agent 工作流
PageIndex 可以轻松接入你已有的 agent,而无需接管其控制流程。本地模式和云端模式暴露相同的接口,因此无论索引是在你机器上由 PageIndex Flash 构建,还是由 PageIndex Cloud 构建,下面的集成代码都完全一样。
以 OpenAI Agents SDK 为例,客户端负责提供工具定义、配套的系统指引,以及作为对话开头的文档上下文,直接复用前面的 client 和 doc_id:
from agents import Agent, Runner

agent = Agent(
    name="PageIndex",
    instructions=client.agent_instructions(),
    tools=client.as_openai_tools(),
    model="gpt-5.6-sol",
)

messages = [
    {"role": "user", "content": client.document_context(doc_id)},
    {"role": "user", "content": "What benchmarks are used?"},
]

result = Runner.run_sync(agent, messages)
document_context(doc_id) 将所选文档的上下文作为单独的第一条用户消息传入。as_openai_tools() 以模型提供商自己的工具格式返回树搜索工具,agent_instructions() 则提供指导模型如何遍历树的提示词——这样 agent 就能基于文档结构进行推理,而你无需编写任何检索逻辑。
同一个客户端还支持 Anthropic SDK tool runner、Claude Agent SDK、LangChain 和 PydanticAI,并且可以将工具暴露为普通 Python 函数,用于不在上述列表中的其他框架。各变体的详情请参阅 agent 集成文档。
完全开源
PageIndex Flash 完全开源,本地模式的其他部分也是如此。PageIndex Flash 的索引构建、基于推理的树搜索、文档对话和页级引用都放在 GitHub 上的 PageIndex 仓库中,你可以逐行阅读检索逻辑、离线运行整个流水线,并将其适配到自己的 agent 中。
完整的 API 文档见官方文档。若希望在不安装任何软件的情况下体验基于推理的检索功能,可直接打开PageIndex Chat。如需将索引和存储迁移至托管服务,请申请PageIndex Cloud API 密钥。
GitHub 仓库Colab 演示 Notebook快速开始