
基于 NVIDIA Dynamo-Triton 部署 HSTU 生成式推荐系统
recsys-examples 仓库中。该工作流整合了 HSTU、PyTorch Ahead-of-Time Inductor(AOTI)编译、FlexKV 支持的 KV 缓存、原生 C++ 验证、NV 嵌入缓存 以及 Dynamo-Triton 部署。
最终实现了一条务实的路径,用于服务 HSTU 排序模型并保持优异的延迟表现。在 NVIDIA RTX PRO 6000 Blackwell Workstation Edition GPU 上,动态批处理大小为 8 时,配备 PyTorch AOTI 的 Dynamo-Triton 实现了显著的性能提升。在 100% GPU KV 缓存命中率下,相比未使用 KV 缓存的相同 AOTI 配置,三层 HSTU 模型的最佳加速比达 4.47 倍,八层模型则达 5.93 倍。
本文介绍如何借助 NVIDIA Dynamo-Triton、PyTorch AOTI 和 FlexKV,把 HSTU 生成式推荐模型从 PyTorch 开发阶段推进到生产级推理。你将学会如何导出并预先编译模型、在 Python 和原生 C++ 中验证部署产物,以及通过 Dynamo-Triton 提供服务——整个过程无需为其他运行时重写模型。
文章还探讨了 GPU 加持的 KV 缓存如何减少重复计算,并给出最高 5.93 倍延迟降低的基准测试结果,充分展现了这套部署流程的实际性能收益。
为什么在生成式推荐中使用 HSTU?
HSTU 最初是为处理高基数、非平稳事件流的生成式推荐(GR)工作负载而提出的。传统推荐系统中,召回和排序通常由一组专用模型和特征流水线拼装而成;而 GR 把推荐建模为序列预测问题,让模型在一个具备序列感知能力的架构中同时理解用户上下文、物品历史、行为历史和候选物品。
在 NVIDIA 的 HSTU 排序示例中,模型输入由类别 token 构成:上下文 token 表示用户侧信息,物品 token 表示物品,可选的行为 token 表示用户与物品的交互。
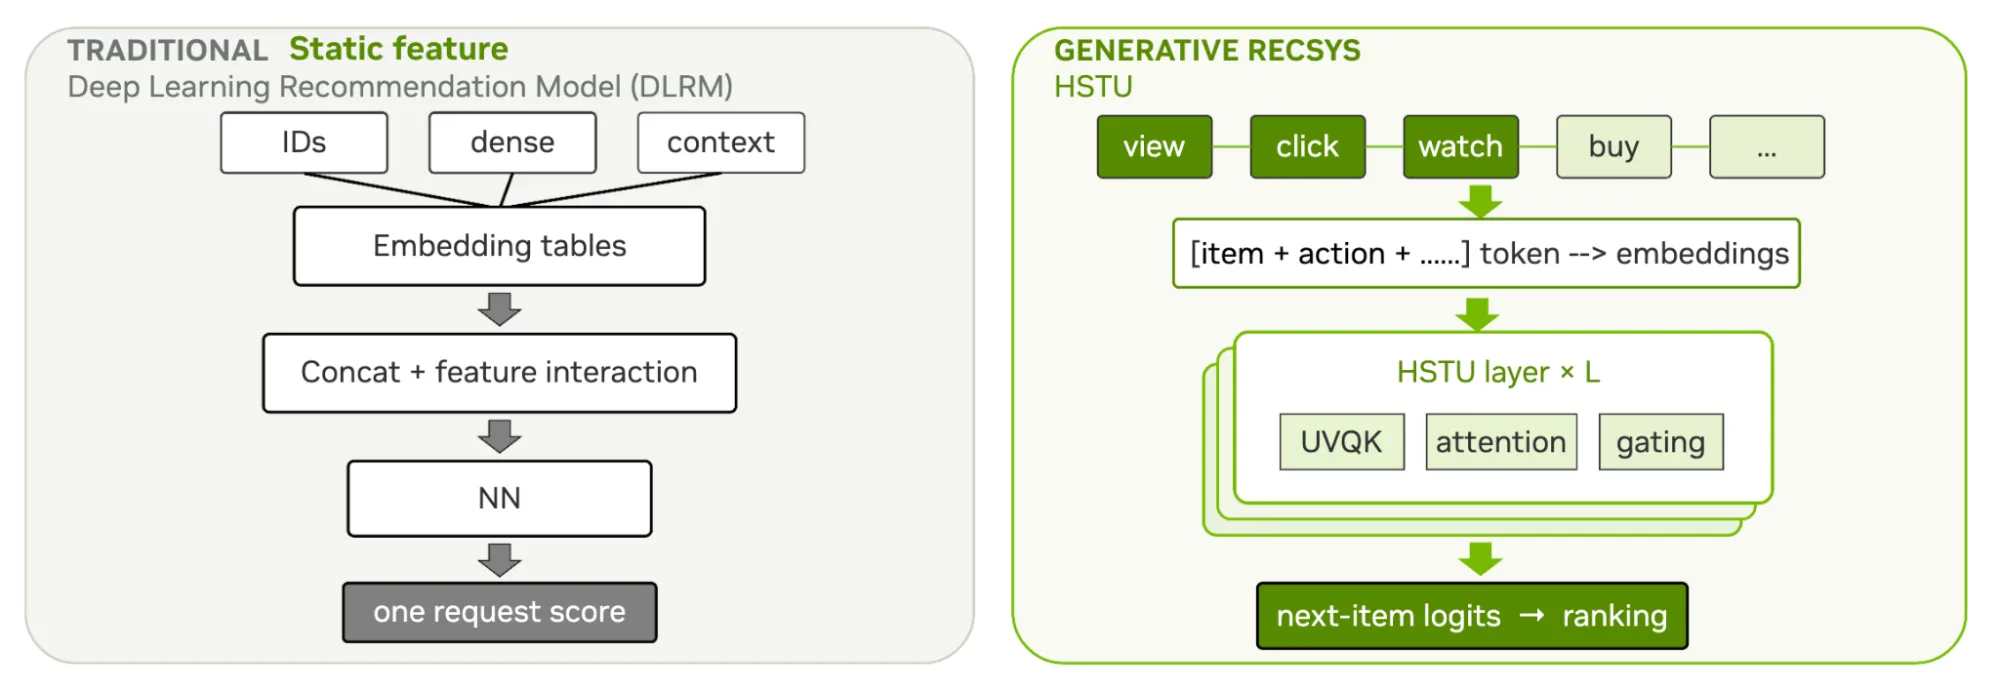
HSTU 的预处理流程会取出 embedding,在存在行为 token 时将物品与行为 embedding 交错排列,拼接上下文信息,并应用位置编码。随后由 HSTU 模块处理整个序列,最后由预测头输出多任务排序结果。
这种结构非常适合推荐系统,因为近期行为、交互顺序和重复模式在其中至关重要。但另一方面,这也意味着当每次请求都需要反复处理冗长的历史序列时,推理成本会变得很高。生产系统需要在保留 HSTU 建模优势的同时,减少服务期间的冗余计算。
为什么服务大型序列推荐器具有挑战性?
服务大型序列推荐器与服务小型稠密排序模型截然不同。服务栈必须能够处理锯齿状的序列输入、大型类别嵌入状态、长历史数据,以及同一用户带着少量新信息反复回来的请求模式。每次请求都重新计算完整用户历史的键值状态,不仅浪费计算资源,还会增加延迟。
这就是 KV 缓存发挥作用的地方。KV 缓存存储了先前序列计算中可复用的键值数据,使模型无需重新计算用户历史中已缓存的部分。在推荐推理中,当用户的长期历史大体稳定,而新的候选物品或最近的行为不断到来时,这种机制尤为有用。
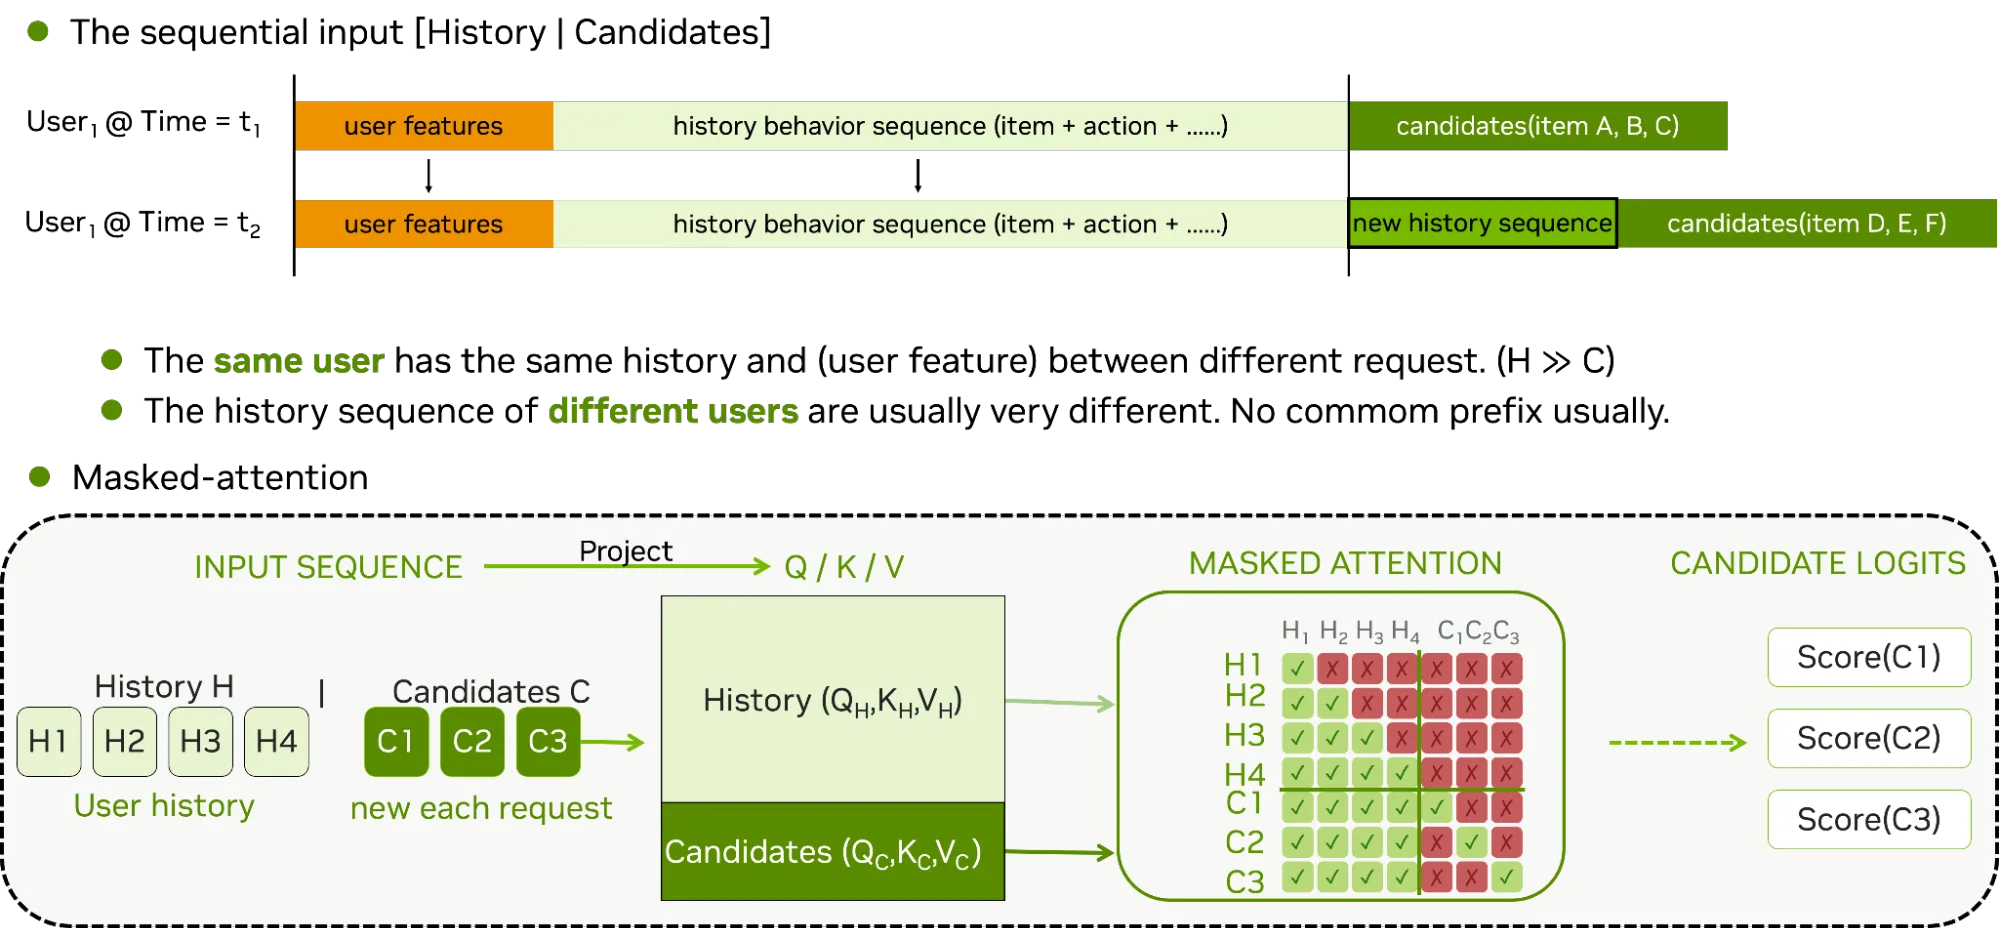
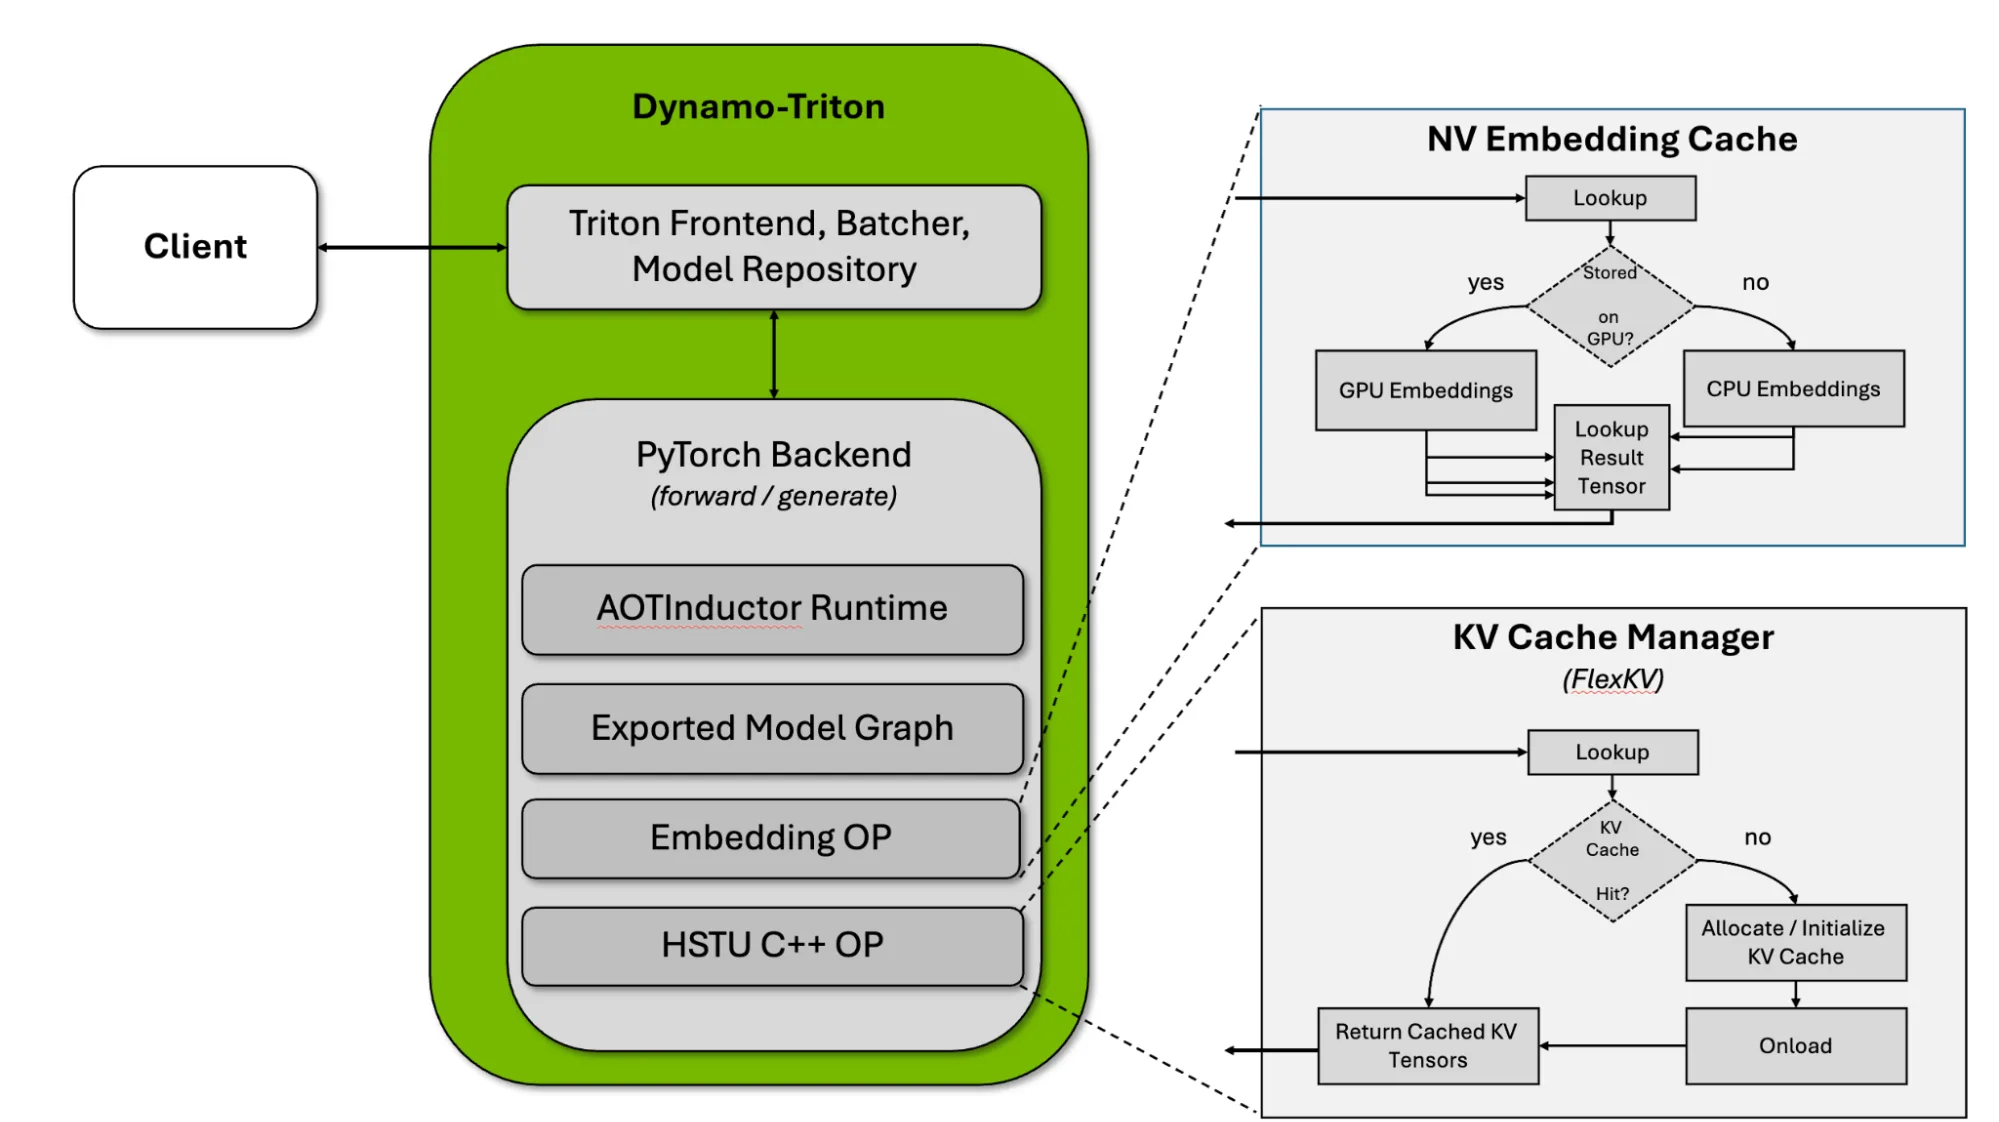
NVIDIA 的 HSTU 推理工作流包含一个 KVCacheManager,它利用 GPU 内存和主机存储来管理 KV 数据缓存。GPU 缓存组织为分页 KV 数据表,支持查找、分配、追加和逐出操作。当 GPU 缓存空间受限时,可以按照 LRU 策略逐出较久未访问的用户数据。主机端存储为缓存 KV 数据提供了另一层级,且该工作流包含一个由 FlexKV 支持的 KV 缓存运行时后端。
HSTU 注意力内核可以直接从分页缓存中读取 KV 数据,导出的推理路径包含针对查找、分配、加载、追加和卸载的缓存感知自定义算子。这种设计让服务层在保持模型序列语义的同时,减少了冗余计算。
PyTorch AOTI 原生推理
PyTorch AOTI(Ahead-of-Time Inductor,提前编译)工作流从 PyTorch 模型入手,使用 torch.export 和 PyTorch AOTI 将其导出。AOTI 在运行前将模型编译成一种可由原生 C++ 运行时加载的包,从而减少 Python 运行时开销,并为 Dynamo-Triton PyTorch AOTI 后端提供易于部署的产物。
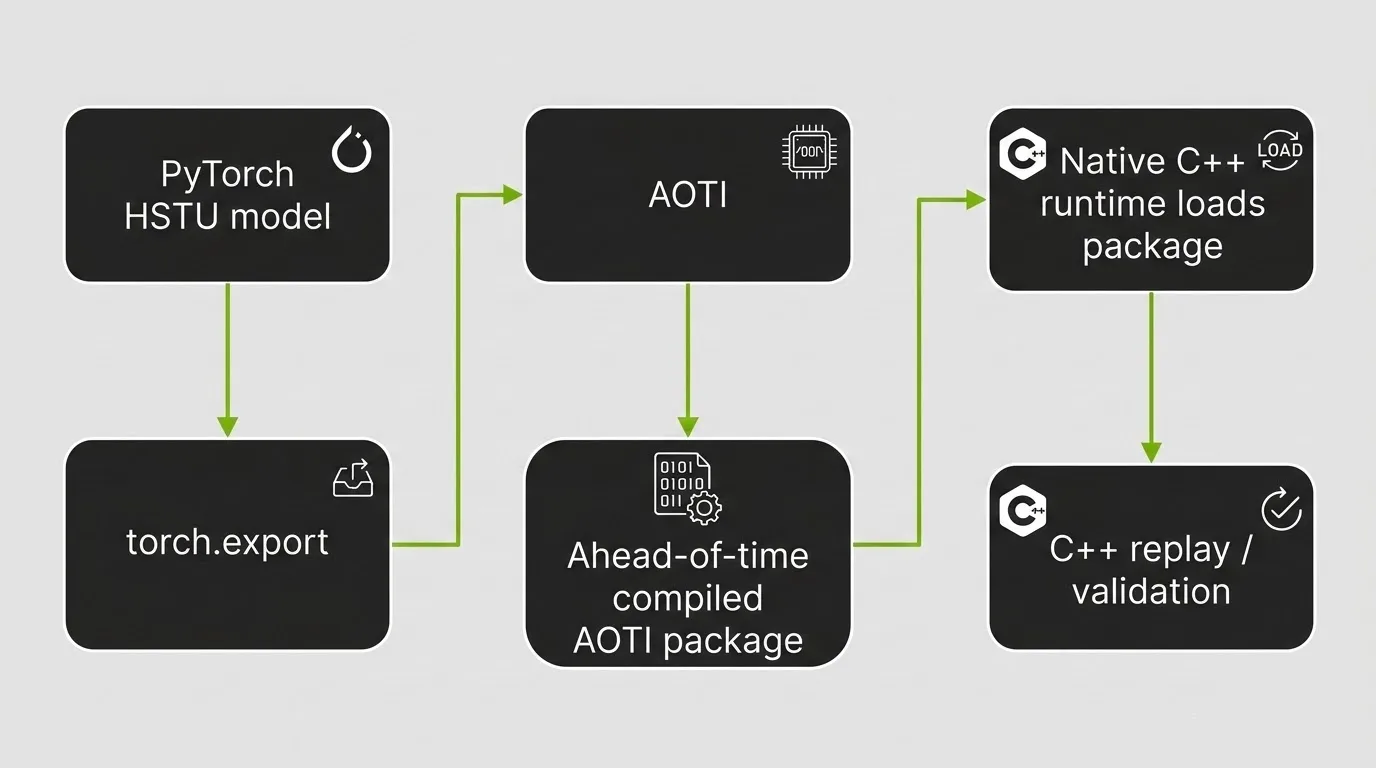
导出的模型包包含 AOTI 模型归档、元数据和嵌入表文件。在 NVIDIA 的示例中,嵌入层实现结合了 DynamicEmb 推理嵌入表和 NV Embedding Cache 。NV Embedding Cache 通过仅在 GPU 显存中存储热门嵌入项,而将完整嵌入表保留在 CPU 内存中,从而降低 GPU 显存占用。导出流程会将层元数据和嵌入表数据与编译好的 .pt2 归档一起写入,使模型加载时无需重复创建嵌入表副本。
工作流通过多种方式验证相同的导出产物。Python 导出脚本负责生成包并回放张量;原生 C++ 可执行文件则加载并回放导出的模型,以验证正确性和性能。Dynamo-Triton 部署也复用相同的 AOTI 包和回放路径,确保开发验证与生产服务保持一致。
Dynamo-Triton 部署路径
Dynamo-Triton 为导出的 HSTU 模型提供生产级推理服务层。AOTI 部署使用 Dynamo-Triton PyTorch backend,并配置 platform: "torch_aoti",使 Dynamo-Triton 能够加载并服务提前编译好的 PyTorch 模型包。
完整工作流包含以下五个阶段:
- 构建所需的自定义算子和运行时库
- 用 PyTorch AOTI 导出 HSTU 排序模型
- 启动基于 FlexKV 的 KV-cache 服务
- 用原生 C++ replay 验证导出的产物
- 用 Dynamo-Triton 部署导出的 KV-cache AOTI 模型
之所以采用这种方案,是因为推荐系统的推理服务不只需要一个高性能的模型 kernel:Dynamo-Triton 提供模型仓库管理、请求处理、后端集成、指标监控和部署结构;AOTI 提供开销更低的编译产物;NV Embedding Cache 通过只把 embedding 表的热点部分保留在 GPU 显存中来降低显存需求;FlexKV 则通过缓存 attention 块来减少长用户历史带来的重复计算。这些组件共同构成了一套面向真实生成式推荐推理的服务栈。
HSTU 推理延迟基准测试
这项基准测试对比了不同 Dynamo-Triton 后端、模型规模、batch size 和 KV-cache 状态下的 HSTU 推理延迟。
本环节旨在量化生产环境中 HSTU 服务栈的性能收益。我们将 Dynamo-Triton PyTorch AOTI 后端与 Python 后端进行对比,测量 GPU KV 缓存带来的额外延迟降低幅度,并评估这些收益随模型深度和批处理规模变化的趋势。最终目的是向开发者展示从基于 Python 的无缓存推理迁移到使用 Dynamo-Triton 的编译、缓存感知型 HSTU 部署方案时,可以预期的性能表现。
recsys-examples 中的基准测试结果基于单 GPU 环境,采用 KuaiRand-1K 排序配置。模型结构包含三层和八层两种 HSTU 变体,隐藏层大小 512,注意力头数 4,模型权重和 KV 缓存均为 BF16 格式。最大历史序列长度为 8,192(包含 4,096 个 item 与 action 对的历史流),最大候选序列长度为 100,另有 6 个上下文特征。对齐前的有效序列长度为 8,298 个 token,导出时的最大对齐序列长度为 8,320。
基准测试协议以每个逻辑请求的延迟作为报告指标。在 Dynamo-Triton AOTI 基准测试中,每次 Dynamo-Triton 调用包含一个逻辑批次,每个逻辑请求的延迟通过端到端耗时除以“Dynamo-Triton 调用次数乘以逻辑批大小”来计算。测试期间排除了数据集加载、验证、重新批处理、用户 ID 生成、服务器启动、预热及预热后的睡眠等待时间。
用于 Dynamo-Triton 后端对比及批大小结果测试的硬件为 NVIDIA RTX PRO 6000 Blackwell Workstation Edition GPU。
Dynamo-Triton 后端对比
在批大小为 2 时,即使没有 KV 缓存命中,PyTorch AOTI 的延迟也优于 Dynamo-Triton Python 后端。若启用 20 GB 的 GPU KV 缓存并产生命中,延迟改善幅度将显著更大。
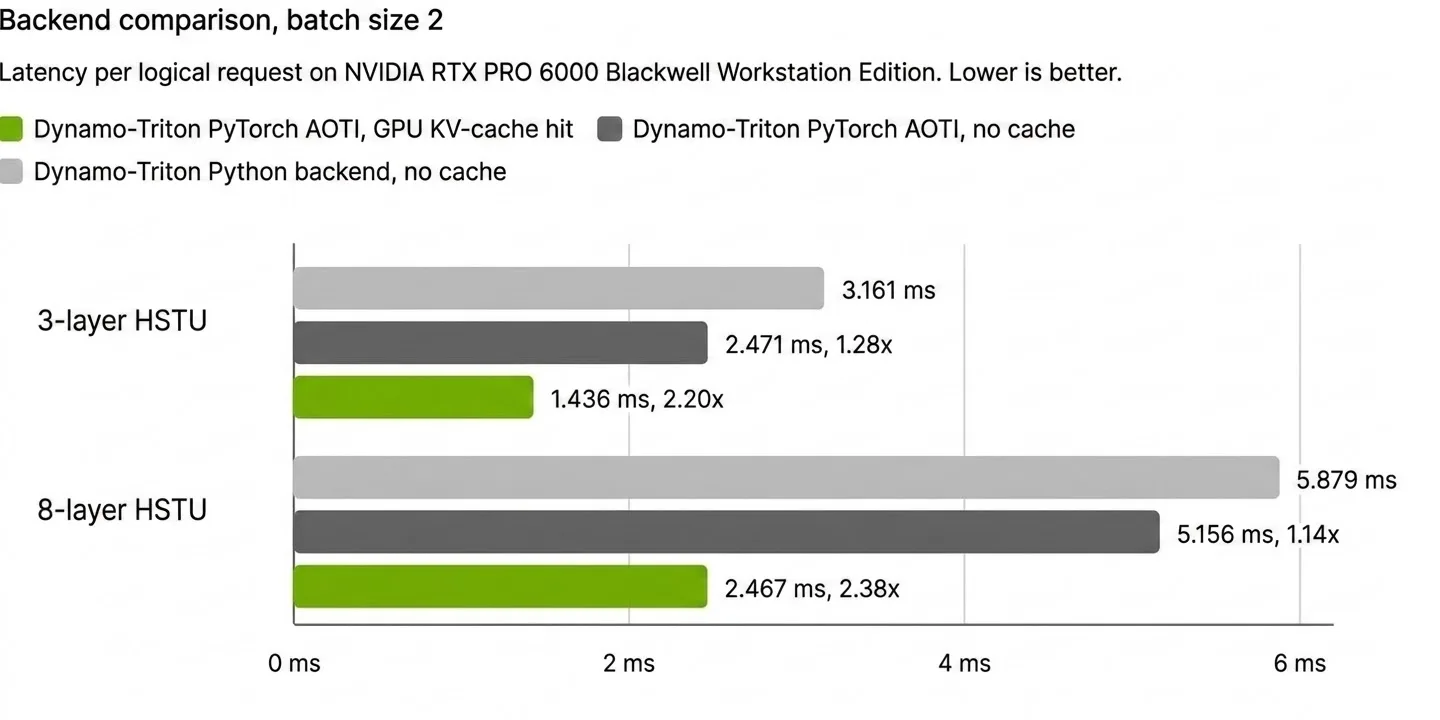
这些结果体现了两方面的收益。首先,与 Python 后端相比,AOTI 降低了服务开销;其次,KV 缓存命中通过复用缓存的序列状态来减少模型计算量。这种缓存收益在更深的 8 层模型上尤为明显,因为避免重复计算带来的影响更大。
AOTI 与 KV 缓存下的批大小扩展性
PyTorch AOTI 后端按批大小划分的结果表明,随着逻辑批大小的增加,KV 缓存的效率逐步提升。
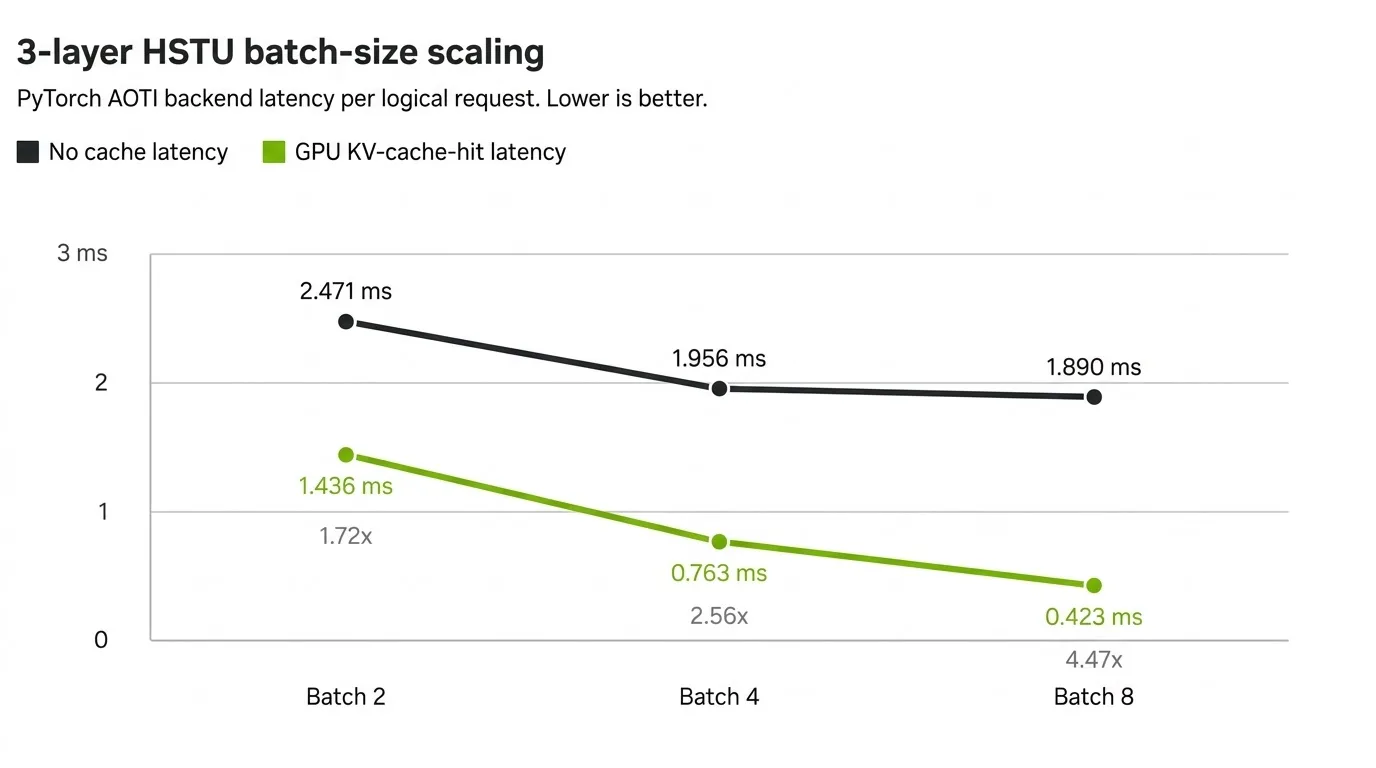
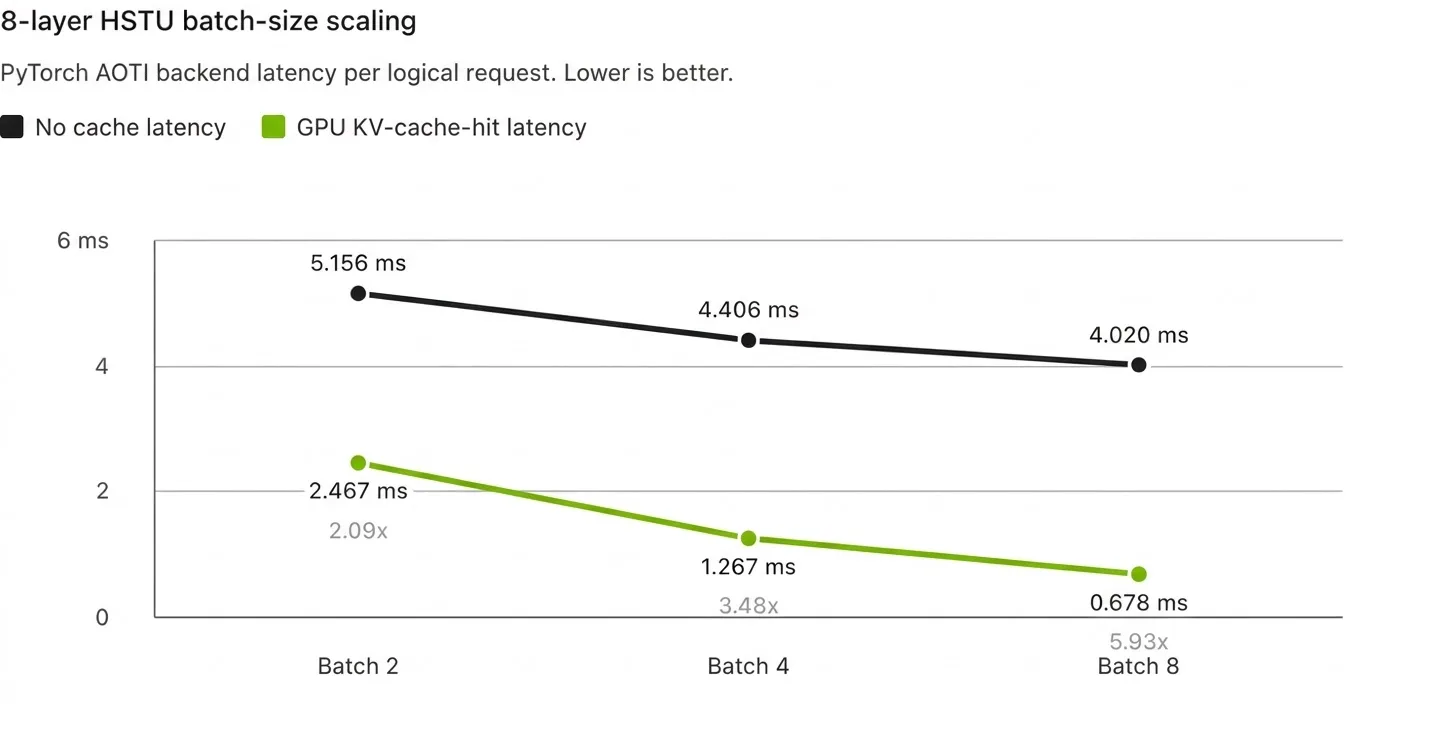
在批大小为 8 时,三层 HSTU 模型在 GPU KV-cache 命中的情况下,每个逻辑请求的延迟为 0.423 ms,八层模型为 0.678 ms。对于长序列排序推理来说,这是相当出色的成绩,也证明了将编译执行与缓存感知服务相结合的价值。
加速 HSTU GR 推理有哪些好处?
推荐系统对延迟的要求非常苛刻,额外的排序延迟会影响页面加载时间、信息流的响应速度以及广告投放的截止时间。与此同时,模型的序列感知和个性化程度越来越高,推理所需的算力也随之增加,尤其是用户历史数据不断增长的情况下。
HSTU 的服务化工作流将多种互补技术结合在一起来应对这一挑战:HSTU 提供生成式推荐架构,PyTorch AOTInductor 生成提前编译的部署产物,基于 FlexKV 的 KV 缓存支持复用已计算的注意力状态,NVIDIA Dynamo-Triton 则提供生产级的服务环境。
这种方案在连续请求共享用户交互历史中不变前缀时尤为实用。模型无需重新计算该部分序列的注意力机制,而是直接复用缓存的 Key-Value 状态,仅针对新追加的 Token 进行必要计算。随着序列变长和模型层数加深,潜在的性能收益愈发显著;否则,跨多个 HSTU 层级的重复计算将带来可观的延迟开销。
快速上手 HSTU 生成式推荐器推理加速
你可以基于 NVIDIA/recsys-examples GitHub 仓库复现并扩展这一工作流。HSTU 概览部分介绍了生成式推荐器(GR)的模型结构,包括上下文 Token、物品 Token、动作 Token、嵌入表、HSTU 模块以及预测头。
AOTI 推理指南详细演示了构建所需镜像和库、准备 KuaiRand-1K 数据、训练检查点、导出带 KV 缓存的 AOTI 模型、使用 C++ 重放进行验证、打包 Dynamo-Triton 运行时镜像,以及通过 Dynamo-Triton 服务器重放请求的完整流程。
如需深入了解,请参考以下相关资源: