
使用 NVIDIA NeMo Relay 追踪 Agent Harness 行为
一个 agent 即使任务完成,也可能走了低效的路径。一次失败的搜索可能触发再次搜索,一次被截断的文件读取可能导致又执行命令重新获取同样的内容。最终答案看起来正确,却掩盖了这些多余步骤——它们增加了延迟、消耗了 tokens,而低效本身还会带来更多失败的机会。
要改进 agent 的行为,开发者不仅要确认任务是否成功,还要了解它是怎么完成的。仅靠成功与否的检查,无法解释 agent 为什么能从工具报错中恢复、为什么提前停止、为什么需要额外的模型调用。
在本教程中,你将结合 NVIDIA NeMo Relay 运行两个 Hermes Agent 示例,利用生成的 trace 检查模型与工具调用、错误、重试、耗时和 token 用量,并将这些证据与各任务的验证结果进行对照。一个 Hermes ToolPerf 案例研究将展示如何用同样的方法,在多次重复运行中评估 harness 的改动。
本教程和视频将讲解如何:
- 搭建隔离的 Hermes Agent 运行环境,并使用其原生的 NeMo Relay 集成。
- 运行一个简单的终端工具任务,检查其事件流和执行轨迹。
- 运行一个涉及文件与网络的调研任务,在 Arize Phoenix 中查看其 OpenTelemetry trace。
- 结合任务验证与 trace 证据,评估对 agent harness 的一项改动。
前提条件
开始之前,请确保具备:
- macOS 或 Linux
- Git 和 curl
- 已安装并正在运行的 Docker Desktop 或 Docker Engine
- NVIDIA Nemotron 3.5 Lightning 的 NVIDIA Build API 密钥。打开模型页面并选择 Generate API Key。
下面简要介绍本教程用到的技术以及它们如何协同工作。
NeMo Relay 如何与 Hermes Agent harness 协作
NeMo Relay 为 agent 开发者提供了一种统一的方式来观察和控制模型与工具的执行。流行的 agent harness Hermes Agent 原生集成了 NeMo Relay,并将其 session、turn、模型调用和工具调用都表示在 NeMo Relay 的作用域层级中。NeMo Relay 会在工作开始和结束时记录生命周期事件,并保留时间信息和父子关系。
理解 trace 输出
NeMo Relay 用于 agent 可观测性。你会接触到 agent 执行的三种表示形式:
| 格式 | 包含内容 | 使用场景 |
|---|---|---|
| Agent Trajectory Observability Format(ATOF) | 一条 JSONL 日志,记录作用域的开始、结束和时间点标记,附带 ID 和时间戳,可用于重建 agent 的完整运行过程。 | 用于调试或审计单个事件、时间信息和父子关系。 |
| Agent Trajectory Interchange Format(ATIF) | 由生命周期事件组装而成的 JSON 记录,逐步呈现 agent 的交互、工具调用和观察结果。 | 用于逐步审查、分析或评估 agent 的执行路径。 |
| OpenTelemetry 结合 OpenInference | OpenTelemetry 以父子 span 的形式记录运行过程;OpenInference 则为 agent、LLM 和工具 span 打上标签并定义其属性。 | 用于 Phoenix 等 OTEL 兼容工具,检查模型与工具调用、耗时、token 用量和错误。 |
ATIF 中的工具请求记录了模型请求执行的操作,但无法确认执行结果。要核实实际发生了什么,需要查看 ATOF 中对应的工具 start 和 end 事件以及可能记录的错误信息。事件通过 uuid 成对关联,而 parent_uuid 则将工具调用连接到其父级。
分享追踪数据前请先检查内容。根据你的配置,其中可能包含提示词、模型响应、工具参数与结果、文件路径以及其他应用数据。
在 agent 安全治理方面,NeMo Relay 提供了证据层:企业和评估方、安全系统可以利用这些结构化的 traces 和 trajectories 来调查 agent 行为、评估策略、改进控制手段,或开发扩展 Relay 的专用安全插件。
接下来开始第一个 agent 任务。
实验 #1:用 Hermes Agent 运行一个简单的工具调用任务
第一个示例刻意做得很小,方便你在加入 web 搜索和 Phoenix 之前先验证整套环境。Hermes 使用其 terminal 工具,在一个隔离的 Docker 容器内运行自带的 Python 脚本。脚本会输出:VALUE=42.
这个固定输出让 runner 可以进行精确的成功校验。运行通过也意味着 Hermes 已成功连接模型、在沙箱中调用了 terminal 工具,并生成了两个 Relay 追踪文件。
容器无法访问网络、代码仓库或 NVIDIA API key,Hermes 也无法退回到在宿主机上执行终端命令。
按顺序执行以下命令。复制 keys.env 后,先在该文件中填入你的 NVIDIA API key 再继续。
# Clone the tutorial repository.
git clone https://github.com/NVIDIA/nemoclaw-community

# Enter the cloned repository.
cd nemoclaw-community/examples/tools/hermes-relay-tracing

# Create the isolated Hermes Agent and NeMo Relay runtime.
./scripts/setup_tutorial_runtime.sh

# Copy the API key template.
cp keys.env.example keys.env

# Add NVIDIA_API_KEY to keys.env before continuing.

# Verify that Docker is running.
docker version

# Build the Docker image for the terminal-tool task.
./scripts/build_tutorial_image.sh

# Run the task and generate the ATOF and ATIF traces.
./scripts/run_tutorial.sh
Hermes Agent 和 NeMo Relay 进程都在该仓库的本地环境中运行,Docker 则单独用于终端工具沙箱和本地 Phoenix 服务。
仓库中的安装脚本会在 .tutorial-runtime/ 目录下创建一个自包含的环境,包含所需的全部依赖,如 Python 3.11,以及搭载 NeMo Relay 0.8.3 的 Hermes 0.21.1。它不会改动你已有的 Python 或 Hermes 安装。
任务完成后,runner 会检查响应和两份 trace 文件。运行通过时会输出验证结果,随后是 ATOF 和 ATIF 的摘要。
查看 trace 摘要
Hermes 完成任务后,runner 会验证预期结果和生成的 trace,检查内容包括:终端命令是否成功、ATOF trace 是否包含已完成的 LLM 活动(含 token 用量且无工具错误),以及 ATIF 轨迹是否非空。以下输出来自一次验证通过的运行。token 数量、标识符和文件路径在不同运行之间可能有所差异。
ATOF 摘要
events: 74
completed llm scopes: 2
llm scopes with usage: 2
prompt tokens: 7239
completion tokens: 96
total tokens: 7335
tool calls: 1
tool errors: 0
correlated events: 74
ATIF 摘要
agent: Hermes Agent
model: nvidia/nemotron-3.5-lightning-30b-a3b
steps: 3
llm calls: 2
requested tool calls: 1

Task verified: VALUE=42
Artifacts: .../artifacts/runs/<run-id>
留意 Task verified: VALUE=42 这一行,它确认了预期结果。ATOF 摘要报告了已完成的模型 scope、token 用量、工具调用和工具错误;ATIF 摘要则以三步轨迹的形式呈现同一执行过程。
Artifacts: 后面的路径指向本次运行的目录,其中包含完整的 ATOF 事件流和 ATIF 轨迹。配套仓库说明了如何再次查看或汇总这两个文件。
实验 #2:运行一个多工具研究任务并探索其 trace
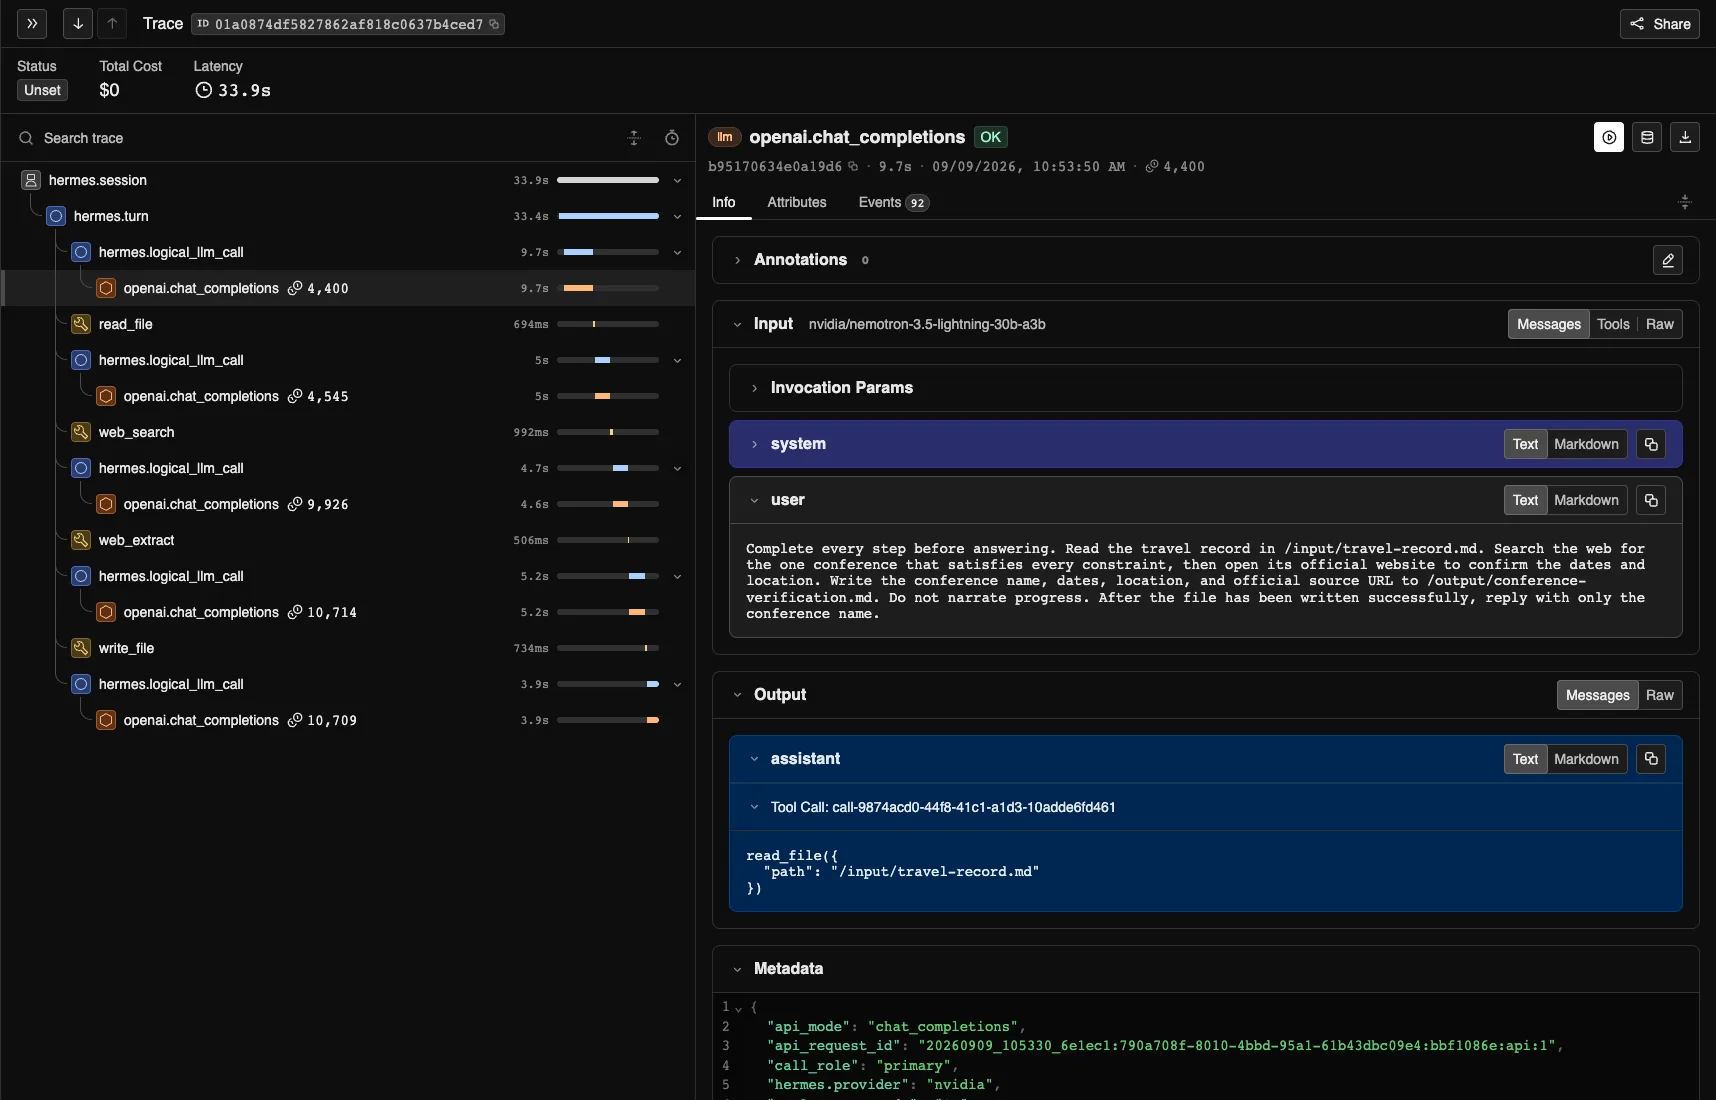
在完成基础环境验证后,第二个例子沿用相同的 Hermes 和 NeMo Relay 环境,执行一个需要多种工具的任务。Hermes 会收到一份旅行记录,其中包含关于某场未具名机器学习会议的线索。它需要阅读记录,根据主题、日期和地点找到匹配的会议,到官网确认答案,把核实过的信息保存成报告,最后返回会议名称。
使用 NeMo Relay 的 OpenInference exporter,通过 OTLP(OpenTelemetry Protocol)把 OpenTelemetry span 发送到 Arize Phoenix。Phoenix 会把这次运行展示为交互式 trace,你可以查看模型和工具调用、耗时、token 用量、错误信息以及可用的输入输出。
只需修改端点和认证配置,就能把同一份 OpenTelemetry trace 发送到其他兼容 OTLP 的后端,例如 LangSmith。NeMo Relay 可观测性指南介绍了其他可用的 exporter 和配置选项。
本例复用第一个例子中的 NVIDIA Nemotron 模型和 NVIDIA API key。Hermes 使用内置的免密钥网络搜索,runner 则在固定版本的本地容器中启动 Phoenix。运行会议检索示例:
./scripts/run_conference_research_with_phoenix.sh
运行过程中,NeMo Relay 会在本地保存 ATOF 事件流和 ATIF 轨迹。
在报告成功之前,runner 会检查 Hermes 是否:
- 识别出
COLT 2026作为会议名称 - 保存了包含预期会议详情和官方来源的报告
- 成功完成
read_file、web_search、web_extract和write_file调用 - 生成了非空的 ATIF 轨迹
- 向 Phoenix 发送了 token 用量大于零的模型和工具 span
各项检查通过后,终端输出会包含 Phoenix 项目的链接和本地运行目录。在 Phoenix 中打开该项目,就能追踪整个 agent 运行过程:从最初读取文件,到网页搜索、来源验证、报告撰写,最后生成回复。
换一个模型试试
想看看其他模型如何处理同一个会议查询,可以按照配套仓库中的模型配置说明操作。保持查询、可用工具、执行限制和验证器不变,这样便于对比执行路径的差异。
由于该任务依赖实时网页搜索,这些运行更适合用来探索模型行为,而非为模型排名。要做严谨的对比,需要固定搜索响应并多次重复运行。
用 trace 评估 agent harness 的改动
前面两个例子展示了如何验证结果和检查单次运行。而评估 harness 改动,则需要在受控、可重复的条件下执行同样的检查。
Agent harness 评估步骤
- 选定一个固定任务,配有精确、可自动化的成功判定标准。
- 定义一个基线,以及一个针对 prompt、工具、配置或 harness 的单一改动。
- 除该改动外,其他所有条件保持不变,包括模型版本、提供商、任务输入、执行预算和超时时间。
- 在启用 NeMo Relay 的情况下,对基线和候选方案运行相同次数的重复测试。
- 先比较经过验证的任务结果,再借助 trace 检查模型调用、工具调用、重试、错误、耗时、token 用量和成本。
- 在推广结论之前,先在该改动预期覆盖的其他模型或工作负载上重复评估。
只有当候选方案带来可复现的任务完成率提升,或者在保持完成率的同时改善了你要优化的可靠性、延迟或成本指标,才能称之为改进。单次更快的运行或更少的调用次数可以辅助解释结果,但单凭这些还不足以证明优化有效。
结果没有变化同样有价值,它可以说明所谓的改进其实依赖于特定的模型、环境或样本。评估 Hermes 工具层改动的基准测试案例
Hermes ToolPerf 基准测试由 Nous Research 开发,过程包括:分析生产环境中的会话、审计工具 schema,并从生产会话日志中挖掘失败类型。随后利用 NeMo Relay ATOF 追踪进行基准轮次统计。通过梳理九种失败模式,团队把结果转化为确定性的基准用例,进而用于评估一批 Hermes 工具层修复。
8 月 6 日的重跑在九个任务上对比了锁定的 Hermes 基线版本和修复版本。每个任务在每个模型、每个版本下各跑三次,共 108 次运行,全程使用相同的提示词、工具、执行限制和成功判定标准。任务校验器负责判定完成情况,NeMo Relay ATOF 追踪则记录模型调用、工具调用、错误、重试、工具返回数据和耗时。
| 模型 | 版本 | 任务成功数 | 平均 LLM 调用 | 平均工具调用 | 平均工具返回数据 | 平均耗时 |
|---|---|---|---|---|---|---|
| Claude Sonnet 4.5 | 基线 | 24/27 (89%) | 2.9 | 2.2 | 17 KB | 16 s |
| Claude Sonnet 4.5 | 修复版 | 23/27 (85%) | 2.8 | 2.1 | 17 KB | 22 s |
| Qwen3 Coder 30B | 基线 | 19/27 (70%) | 3.8 | 2.8 | 16 KB | 27 s |
| Qwen3 Coder 30B | 修复版 | 22/27 (81%) | 4.9 | 3.9 | 33 KB | 42 s |
在这轮测试中,Sonnet 没有实质变化:基线版完成 27 次中的 24 次,修复版完成 23 次,仅差一次,而且两个版本在轮次、工具调用和返回数据方面完全一致。
Qwen Coder 是修复真正见效的地方,但效果是双刃剑。成功完成的任务多了三个,从 27 个中的 19 个提升到 22 个。同时它也更“卖力”了:平均 LLM 调用次数从 3.8 升到 4.9,工具调用从 2.8 升到 3.9,工具返回数据从 16 KB 涨到 33 KB,耗时从 27 秒延长到 42 秒。修复让基线版本放弃的任务获得了成功,代价是一个更慢、更啰嗦的 agent。
任务层面的审计揭示了这些取舍的来源。
- 在阻断命令任务上,基线 Qwen 死在解析器阻断处,得分 33%,而恢复配方让修复版达到 100%。正是这种完成度推高了轮次数量:恢复要花轮次,而放弃则不用。
- 大小写不敏感搜索任务则走向反面。零匹配探测输出让 Qwen 在三次运行中的两次陷入额外的探索性搜索,轮次从 3.3 飙升到 9.3,这是一个值得单独审视的回退。
- 隐藏文件搜索在两个版本、两个模型上都停留在 0 到 33%,与原始运行发现的差距一致,在当前这些 SHA 下依然存在。
只看任务的成败与否,是得不出这个结论的。NeMo Relay 的追踪记录了全部 108 次运行中的每一次模型调用、工具调用、错误、重试、结果负载和时间数据。Qwen 多出来的轮次是有效恢复而非盲目挣扎,而那个任务的回退也能追溯到具体的探测输出。这些追踪记录已提交至结果目录,任何人都可以解包并从原始记录重新生成这些表格。
开始评估 agent 追踪
NeMo Relay 为你提供了一种一致的方式来采集证据,评估针对 agent harness 的优化改动。ATOF 保留有序的生命周期事件,ATIF 则把同样的工作呈现为可读的轨迹。将追踪与确定性验证器配合使用,就能比较 harness 的改动效果,而不会把“调用更少”误当成“结果更好”。
配套的仓库提供了示例产物,包括可运行的任务、验证器、NeMo Relay 配置以及本文使用的 Phoenix 环境。
了解更多:
- NeMo Relay 文档:安装、概念与配置说明。
- Hermes Agent 文档:Hermes 的安装与使用。
- 配套教程仓库:本文示例的可运行代码。
- ATOF 与 ATIF 文档:事件与轨迹格式说明。
- NeMo Relay 可观测性配置:配置 exporter 与遥测目标。
- 支持的集成:在其他 agent 框架和应用中使用 NeMo Relay。