用于文本分类的语言模型:从词袋模型到 Jev
最近发布的 Jev AI 模型在过去两周内在技术社区引起了不小的轰动。
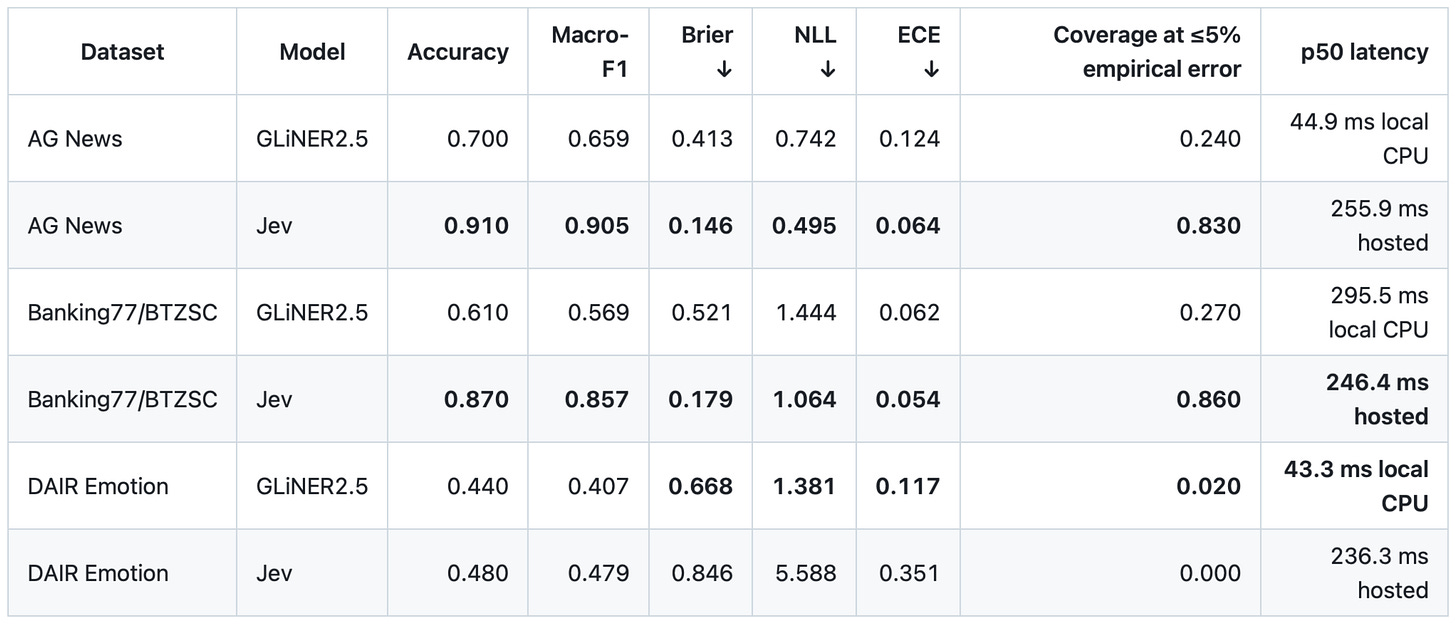
虽然 Jev 旨在进行分类,但人们很容易将其视为“仅仅是一个分类器”。在过去几天里,我对 Jev 的看法发生了很大变化。起初,我认为“分类器曾是我的看家本领,我自己也能轻松构建”(稍后会详细讨论这一点),但后来我意识到:“哇,它的表现确实比我想象的更好。”
当然,最新 SOTA 的 GPT 和开源权重 LLM 也能执行与 Jev 类似的分类任务,同时具备更通用的决策能力。但 Jev 的优势在于,它能以更快速度和更低成本处理这些分类任务。
在频谱的另一端,对于狭义且定义明确的问题,Jev 在分类的准确性、速度或成本上,可能并不比专用分类器更优。但它的卖点是,相比那些任务特定模型,它具有更广泛的通用性。
那么,Jev 背后的方法论是什么(基于合理推测),它能做什么,以及为何如此受欢迎?我打算在文章后续部分回答这些问题。不过,我觉得从用于决策的语言模型简史入手,是一个很好的开始。这也有助于消除部分炒作,并展示 Jev 在哪些方面表现出色(“Jev 本质上是一个文本分类器”,但“Jev 也不‘仅仅’是一个文本分类器”)。
附注:我与 Jev 没有任何利益关联。我也未获得 Jev 的免费访问权限,本文并非产品背书,只是一篇技术文章,旨在梳理文本分类的历史脉络,帮助你理解近期的热潮。
由于这篇文章比较长,我建议在浏览器中阅读,这样可以随时使用左侧的目录导航。
1. Transformer 之前的语言建模与分类
为了内容完整,在引入 Jev 之前(这可不是双关语),我觉得按时间顺序梳理一遍会更有意义。在这一节里,我想简要回顾一下基于 Transformer 的模型出现之前,朴素贝叶斯、逻辑回归以及更经典的(深度)神经网络在文本分类中的实际应用。
1.1 词袋模型:朴素贝叶斯、逻辑回归和 XGBoost
遥想 15 年前我读研究生的时候,虽然循环神经网络早已存在(后面会细说),但文本分类通常还是用词袋(bag-of-words)表示来做的,因为它简单直接,在中等规模的数据集上也能取得不错的效果。
简单来说,词袋表示可以看作是一种把不同长度的自由文本转换为经典分类器(如朴素贝叶斯、逻辑回归、SVM、随机森林、XGBoost 等)所能处理的固定长度输入向量的方法。
它在现实中的典型应用包括新闻文章分类、邮件垃圾过滤等等。没错,据说 Gmail 最早的垃圾邮件过滤器用的就是基于词袋表示的朴素贝叶斯模型。
顺便一提,我正好在 12 年前写过这方面的内容,那也是我最早分享到 arXiv 的文章之一。
那么,词袋表示到底是什么?它是一种将不同长度的自由文本(比如下面这样的文本)进行转换的方法:
训练样本 1:“Zentropa 是我多年来看过的最具原创性的电影。如果你喜欢受黑色电影影响的独特惊悚片,那么它正是治疗当下那些充斥影院的好莱坞暑期档爆款的绝佳良药。冯·提尔的后续作品如《破浪》获得了更多赞誉,但这确实是他的最佳作品。”
训练样本 2:“这部电影简直糟糕透顶。John Ritter 在那儿傻乎乎地摔跤,75% 的演员看起来像是在照台词本念稿,剪辑很烂,音效混音也很糟糕。”
训练样本 3:“Zentropa 与《第三人》有很多共同点,这也是另一部背景设定在战后欧洲废墟中的黑色风格电影。”
转为固定大小的表示形式,以供前述“经典”分类器使用。(上述例子摘自流行的 IMDb 电影评论分类数据集。)
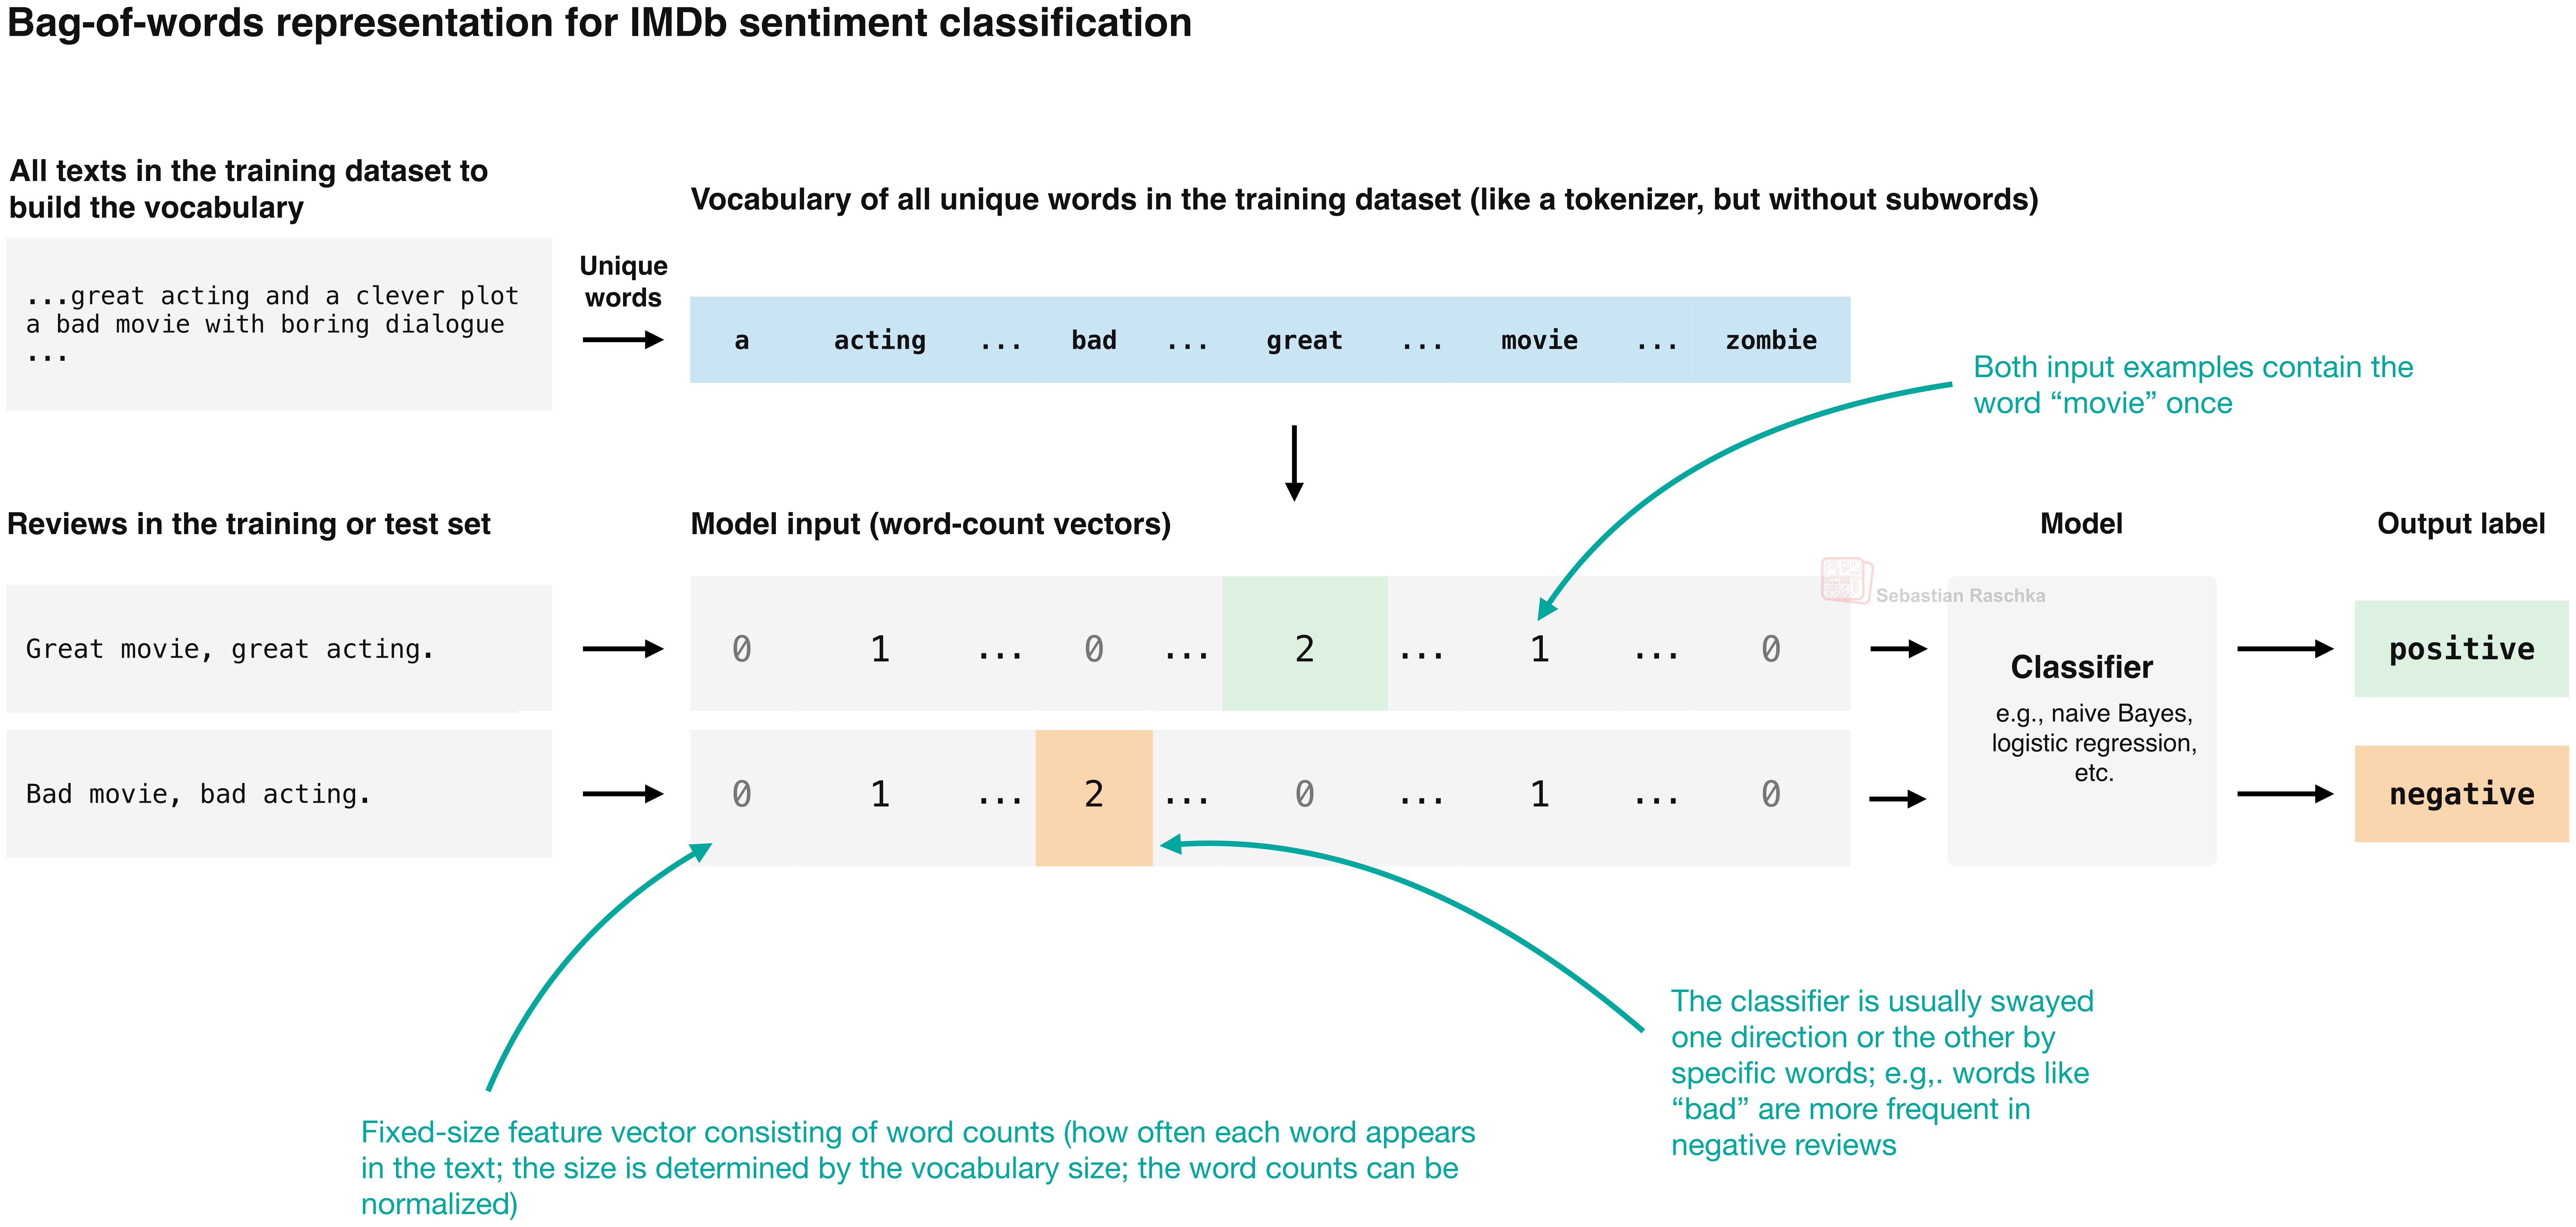
词袋模型首先建立词汇表,即包含训练集中所有不重复单词的集合(可选地,可以去除所谓停用词,如“a”和“the”,这些词在大多数语境中几乎没有语义信息)。
词袋表示通过为词汇表中的每个单词分配向量中的专属位置,从而生成固定大小的输入。然后统计每个单词在文档中出现的频率。例如,如果词汇表包含 50,000 个唯一单词,无论输入是只有十个词还是 30 万个词,都会生成一个包含 50,000 个条目的固定大小向量。请注意,大多数条目都是零,因为每篇文档只包含词汇表的一小部分。(除了表示原始计数外,还有 TF-IDF 等归一化方案。)
有了这些词频向量,我们便可以在带标签的训练集上训练分类器,例如将邮件标记为垃圾邮件或非垃圾邮件。举个例子,逻辑回归模型会学习特征权重,从而让特定的词(及其出现次数)与特定标签产生关联。也就是说,某些词可能会提高预测为垃圾邮件的概率,而另一些词则会降低该概率。
这种方法计算成本低,在特定单词能提供强标签线索时往往效果良好。对于垃圾邮件分类这类简单的分类任务,通常只需此法即可获得快速且较为准确的结果。
但该方法最大的缺点之一在于:受词袋表示的本质限制,它丢失了词的顺序。例如,“the dog bites the man” 和 “the man bites the dog” 描述的是完全不同的事件,却会生成相同的向量。
(有一些变通方法可以通过引入词对或更长的序列——即 n-gram——作为特征,来保留局部顺序,但这会增加词表的大小。)
尽管存在上述不足,我仍认为词袋模型在某些低风险应用中仍有其用武之地,因为它的成本极低。词袋表示加上逻辑回归,依然是我处理任何文本分类问题的首选基线方案,因为它非常容易实现。
1.2 用于文本分类的深度神经网络
前述的词袋模型也可以用于(简单的)深度神经网络,例如多层感知机。但缺点依然存在:我们会丢失句子结构和词的顺序。
不过,更复杂的神经网络架构可以绕开词袋这种变通方案:卷积神经网络(CNN)和循环神经网络(RNN)可以直接以词向量作为输入。
1.2.1 词向量
首先,在把文本输入模型之前,需要将其转换成合适的表示形式。词袋是一种表示方式,词向量则是另一种。两者的区别在于:词袋向量通过统计词表中每个词在整段文本中出现的次数来表示整段文本,而词向量把单个词表示成一个由学习得到的稠密数值向量。
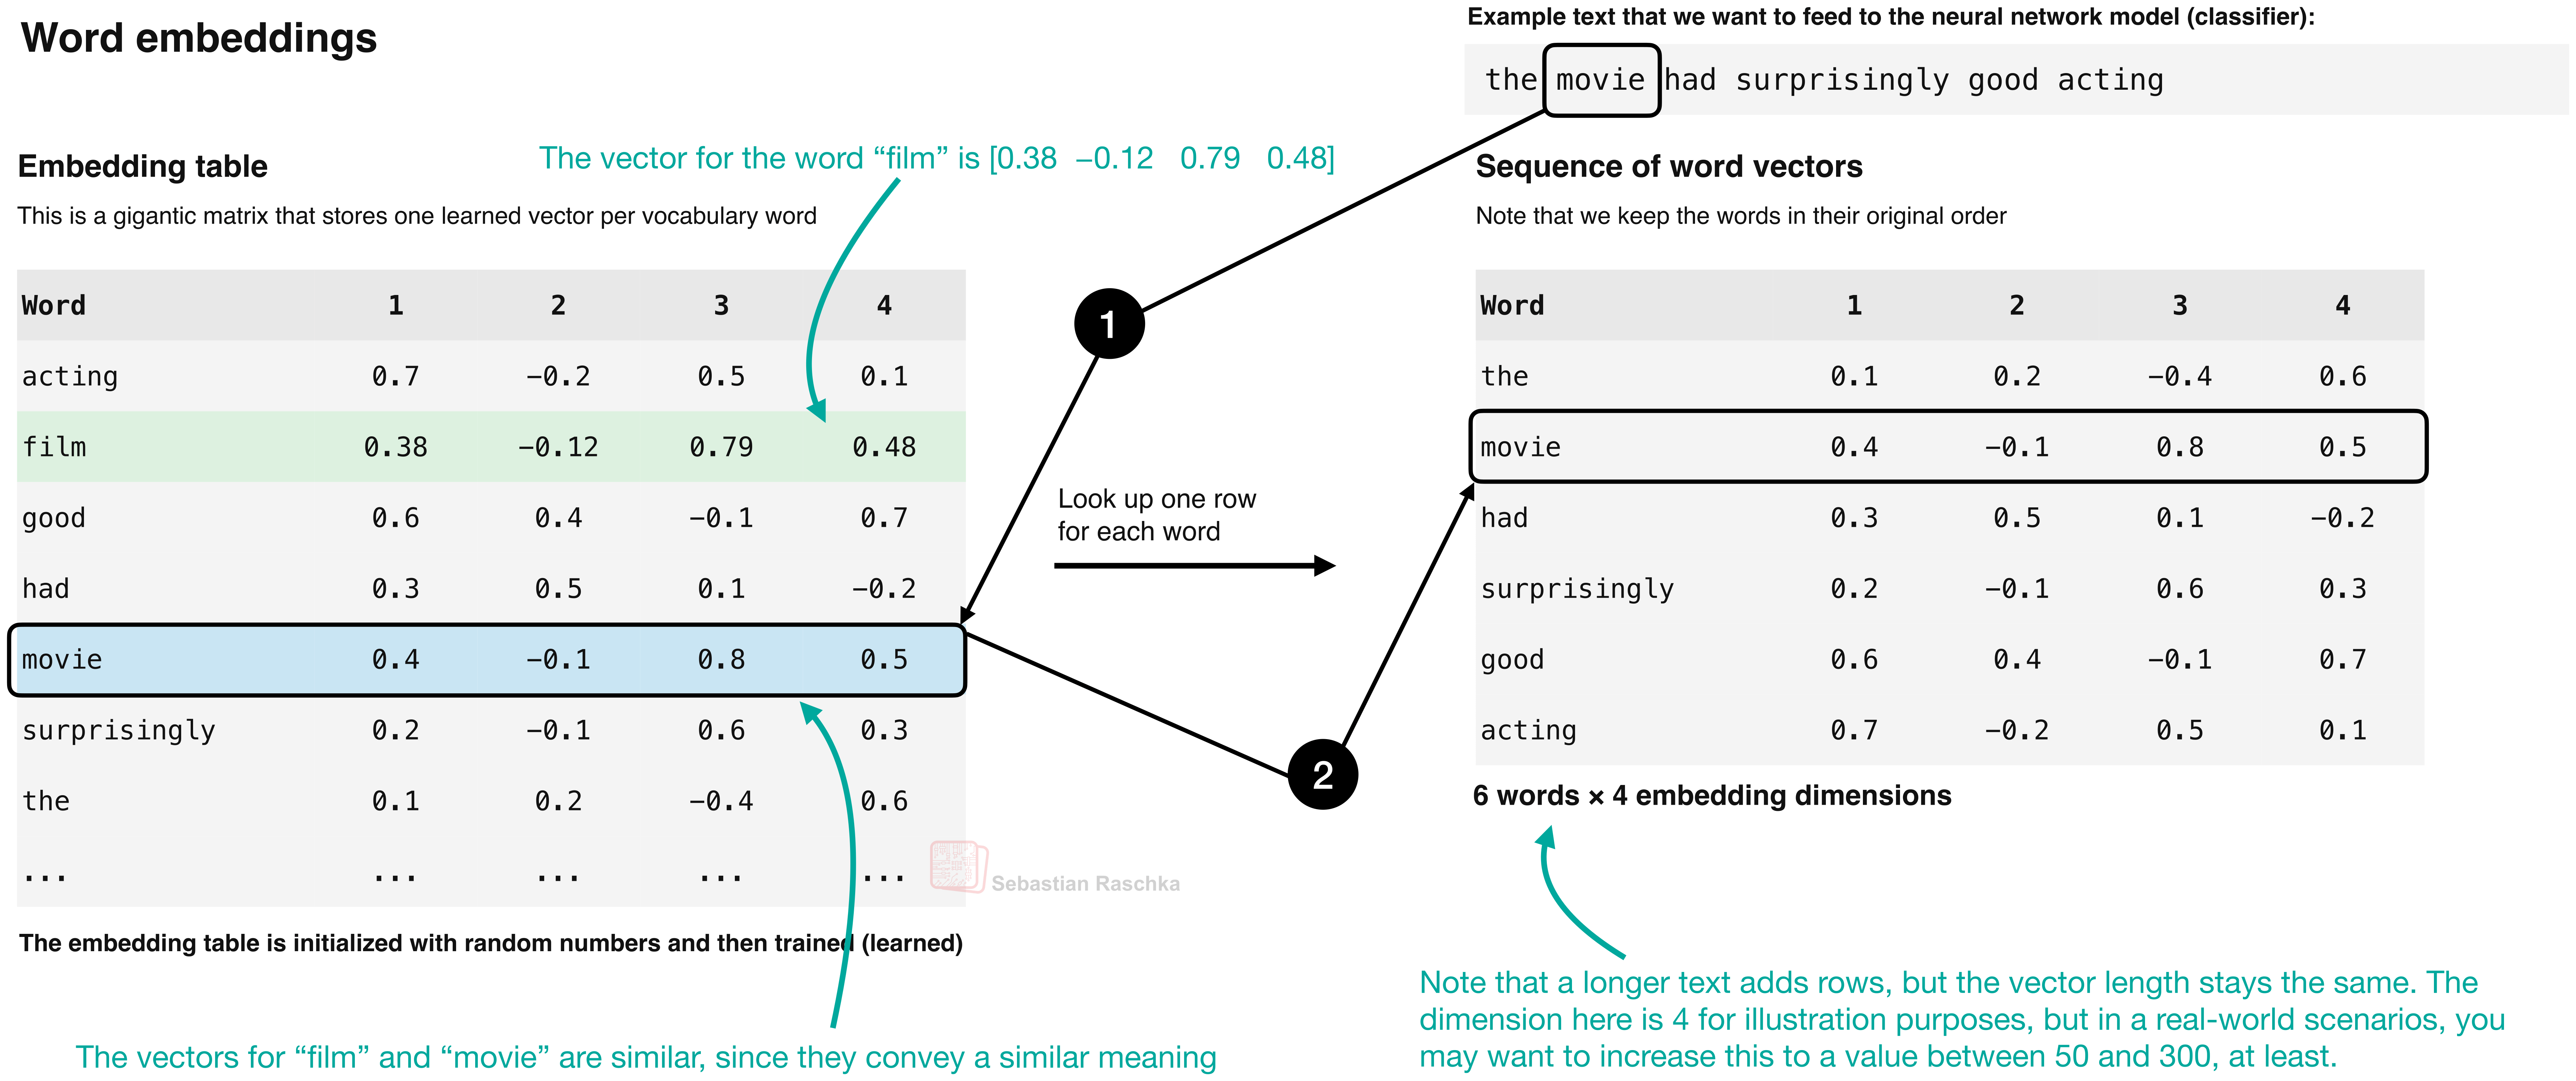
词向量的原理与 LLM 中的 embedding 层类似,都是把输入 token 转换成稠密向量。向量化既可以在模型外部完成(例如两个经典且流行的方法是 Word2Vec 和 GloVe),也可以把 embedding 层作为神经网络架构的一部分,在模型训练过程中学习和调整。
这些经典词向量在查询时与上下文无关。比如"bank"这个词,在"river bank"(河岸)和"bank account"(银行账户)中会得到相同的向量(如你所知,上下文可以通过 attention 这类机制来处理)。
关于词向量的更多资料,以下内容可能对你有帮助:
第 2 章:处理文本数据(这一章讲的是 LLM,但足以让你理解词或 token 的向量化要点;在 LLM 的 tokenizer 中,单词会被拆分成子词 token,而在 Word2Vec 中,通常一个词就是一个 token。)
理解 Embedding 层与 Linear 层的区别(本插图旨在展示 Embedding 向量在何时在数学上等价于 Linear 层和矩阵乘法。)
1.2.2 循环神经网络(RNN)
鉴于你们中的许多人可能已经熟悉循环神经网络(RNN),我将简要介绍这一部分。RNN 是自然语言处理中经典的默认神经网络架构,流行的变体可追溯至 20 世纪 80 年代至 90 年代初。随后,于 2017 年引入的 Transformer(采用了最早在 RNN 中提出的 attention 机制;简要的时间线参见我的文章 理解大型语言模型),在许多 NLP 应用中逐渐取代了 RNN。
RNN 逐词读取序列(如文本)。在每一步,它将当前单词的 embedding(前文已讨论)与上一步的隐藏状态相结合。我们可以将隐藏状态视为一个固定大小的向量,用于总结迄今为止处理的文本。正因如此,单词的顺序至关重要,因为改变单词顺序会改变状态更新的序列。
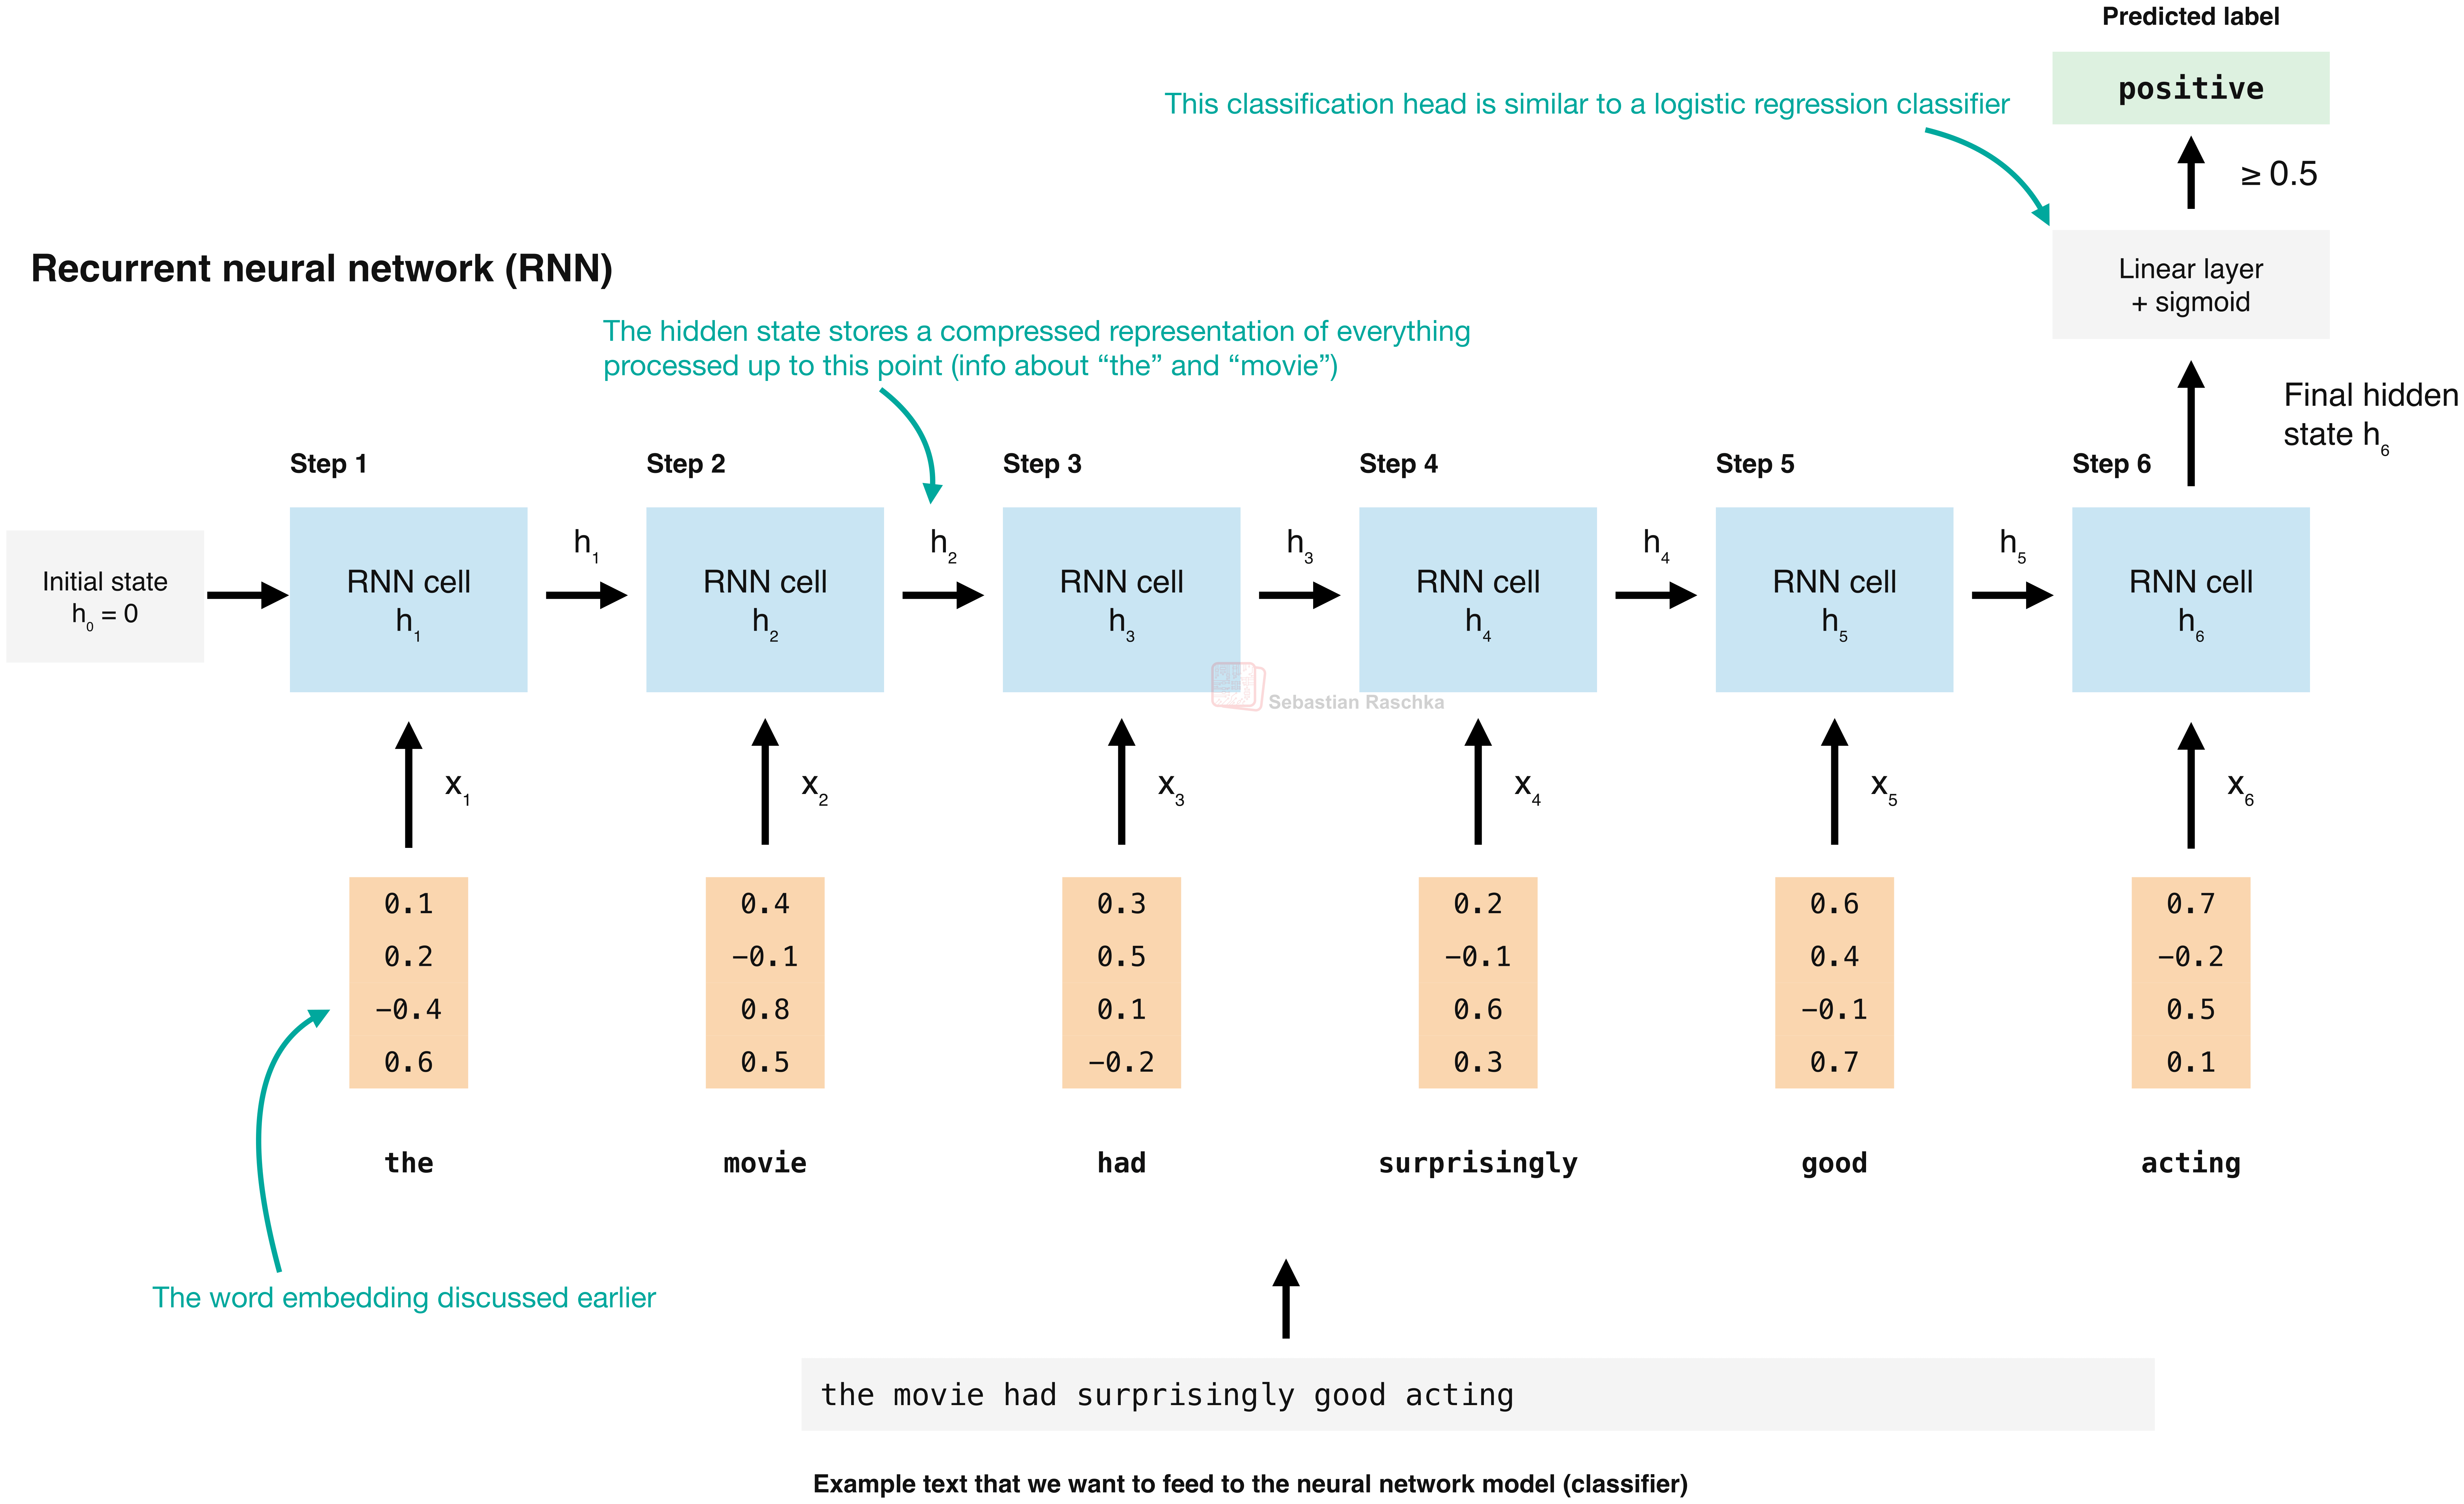
请注意,上图展示的是展开表示法下的 RNN。也就是说,RNN 对每个输入复用相同的层堆栈,因此被称为“循环”(recurrent)。由于是“循环”的,输入文本长度可以是任意的。下图将展开表示法与“循环”特性并排展示,以说明这一机制。请注意,两者展示的是完全相同的架构,只是可视化方式不同。
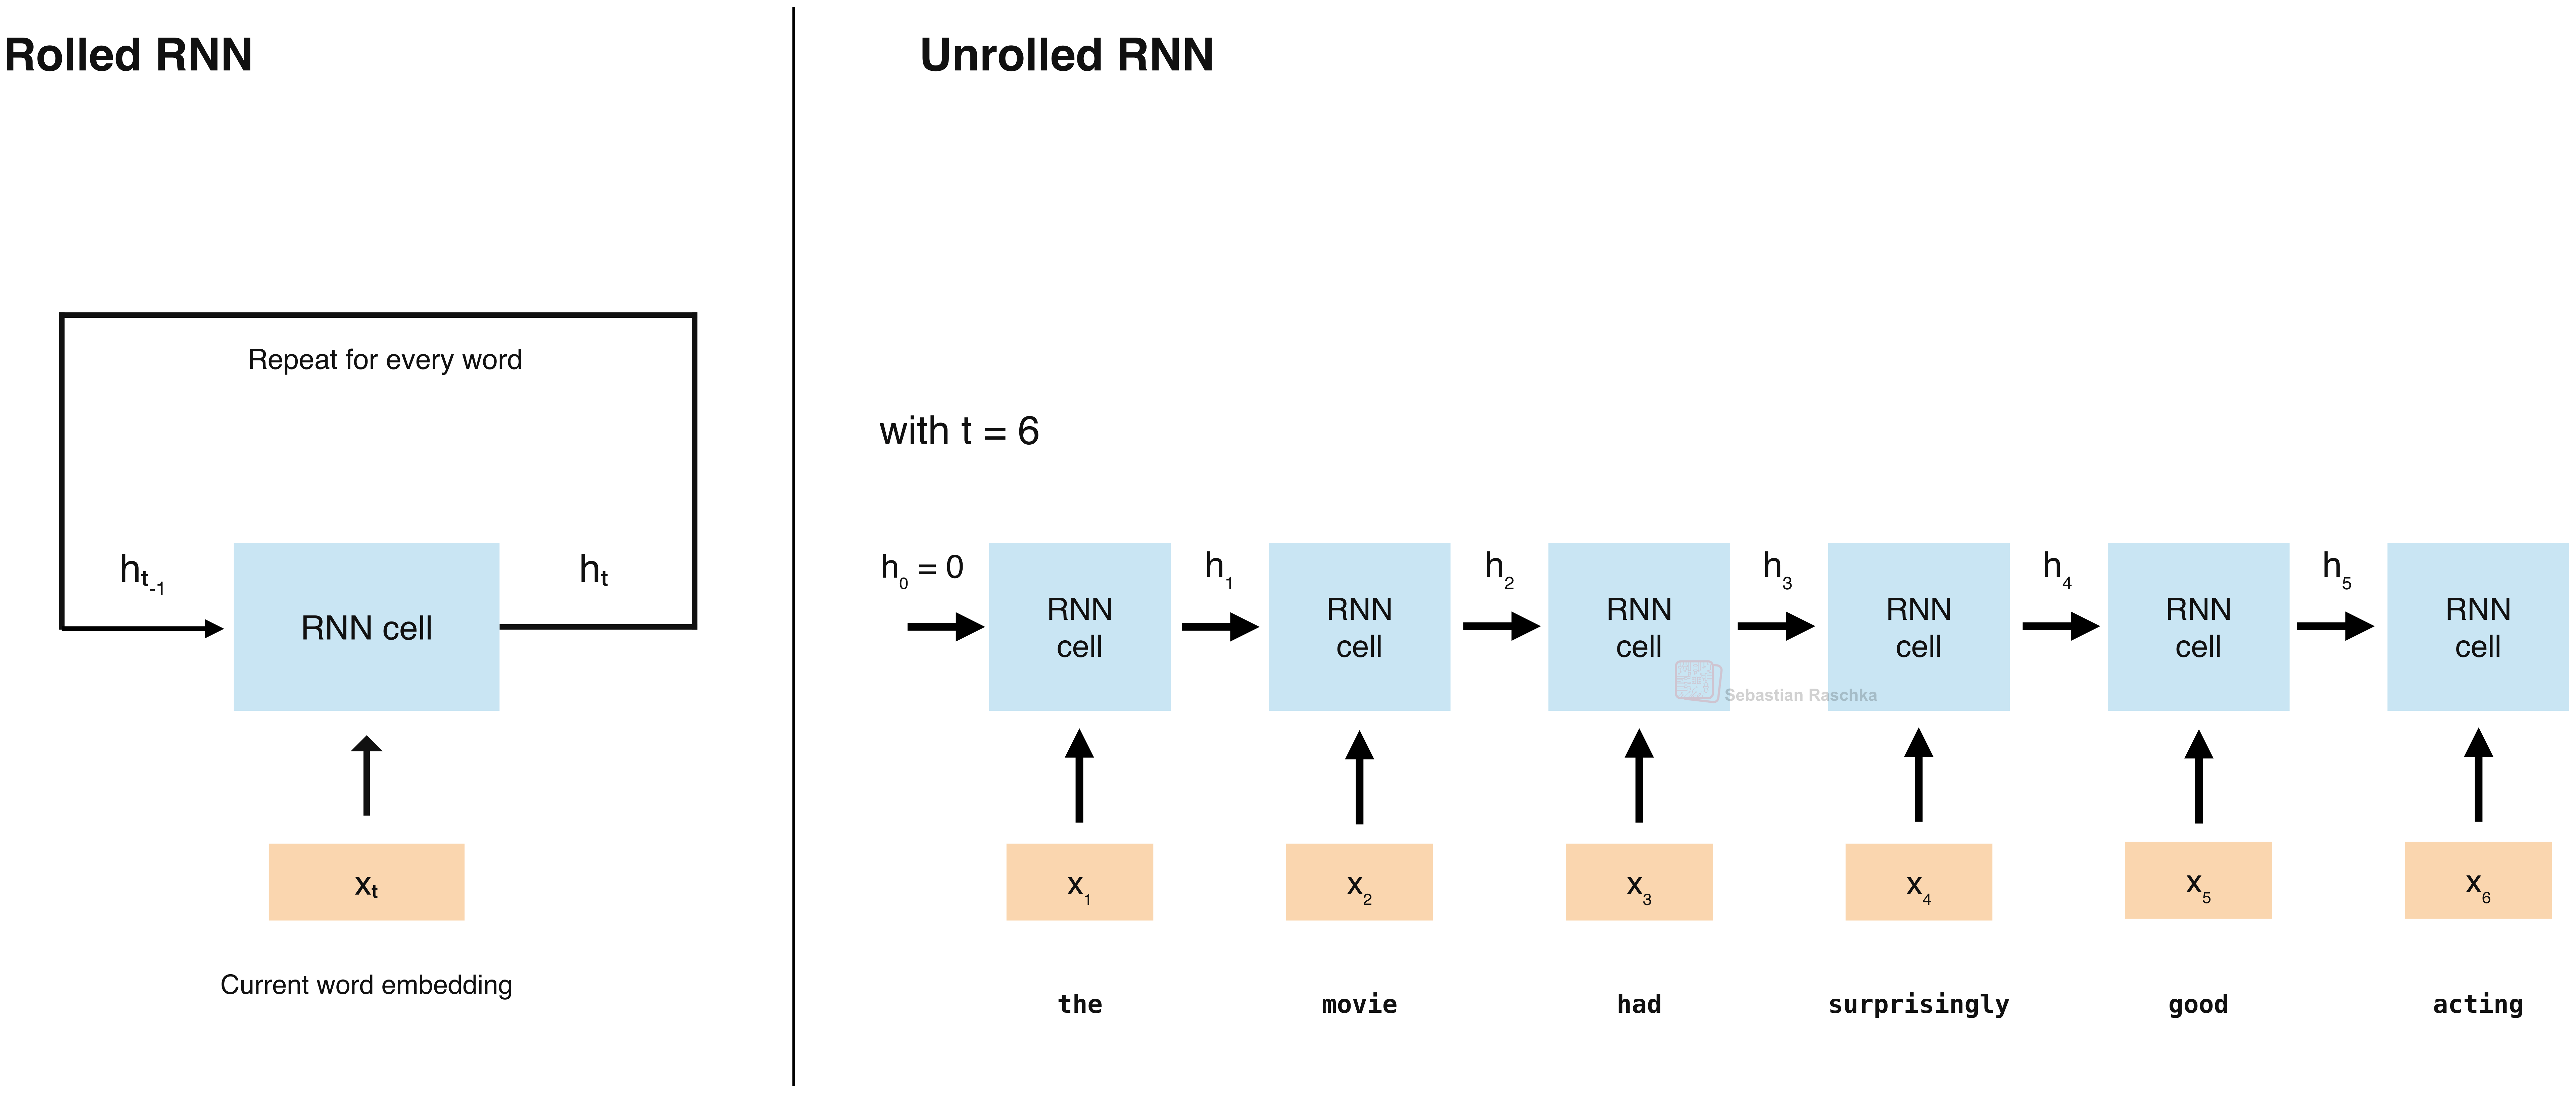
RNN 以难以训练而闻名。随后出现了一些针对 RNN 的重要改进,例如 1997 年引入的 长短期记忆(LSTM) 网络和 2014 年引入的 门控循环单元(GRU)。它们通过学习的门控机制来控制信息的保留与更新。(此外还有 2024 年推出的较新模型 xLSTM:扩展长短期记忆)。
状态空间模型也受此启发,它们依赖于按顺序更新的固定大小隐藏状态,这种机制比 Transformer 注意力机制成本更低。然而,瓶颈仍然在于隐藏状态能保留多少信息,且数据仍需顺序处理。(一个有趣的事实:注意力机制最初是为 RNN 开发的,早于 Transformer 架构,但这又是另一个故事了;我在我的 《理解大语言模型》 文章中对此有所著述。)
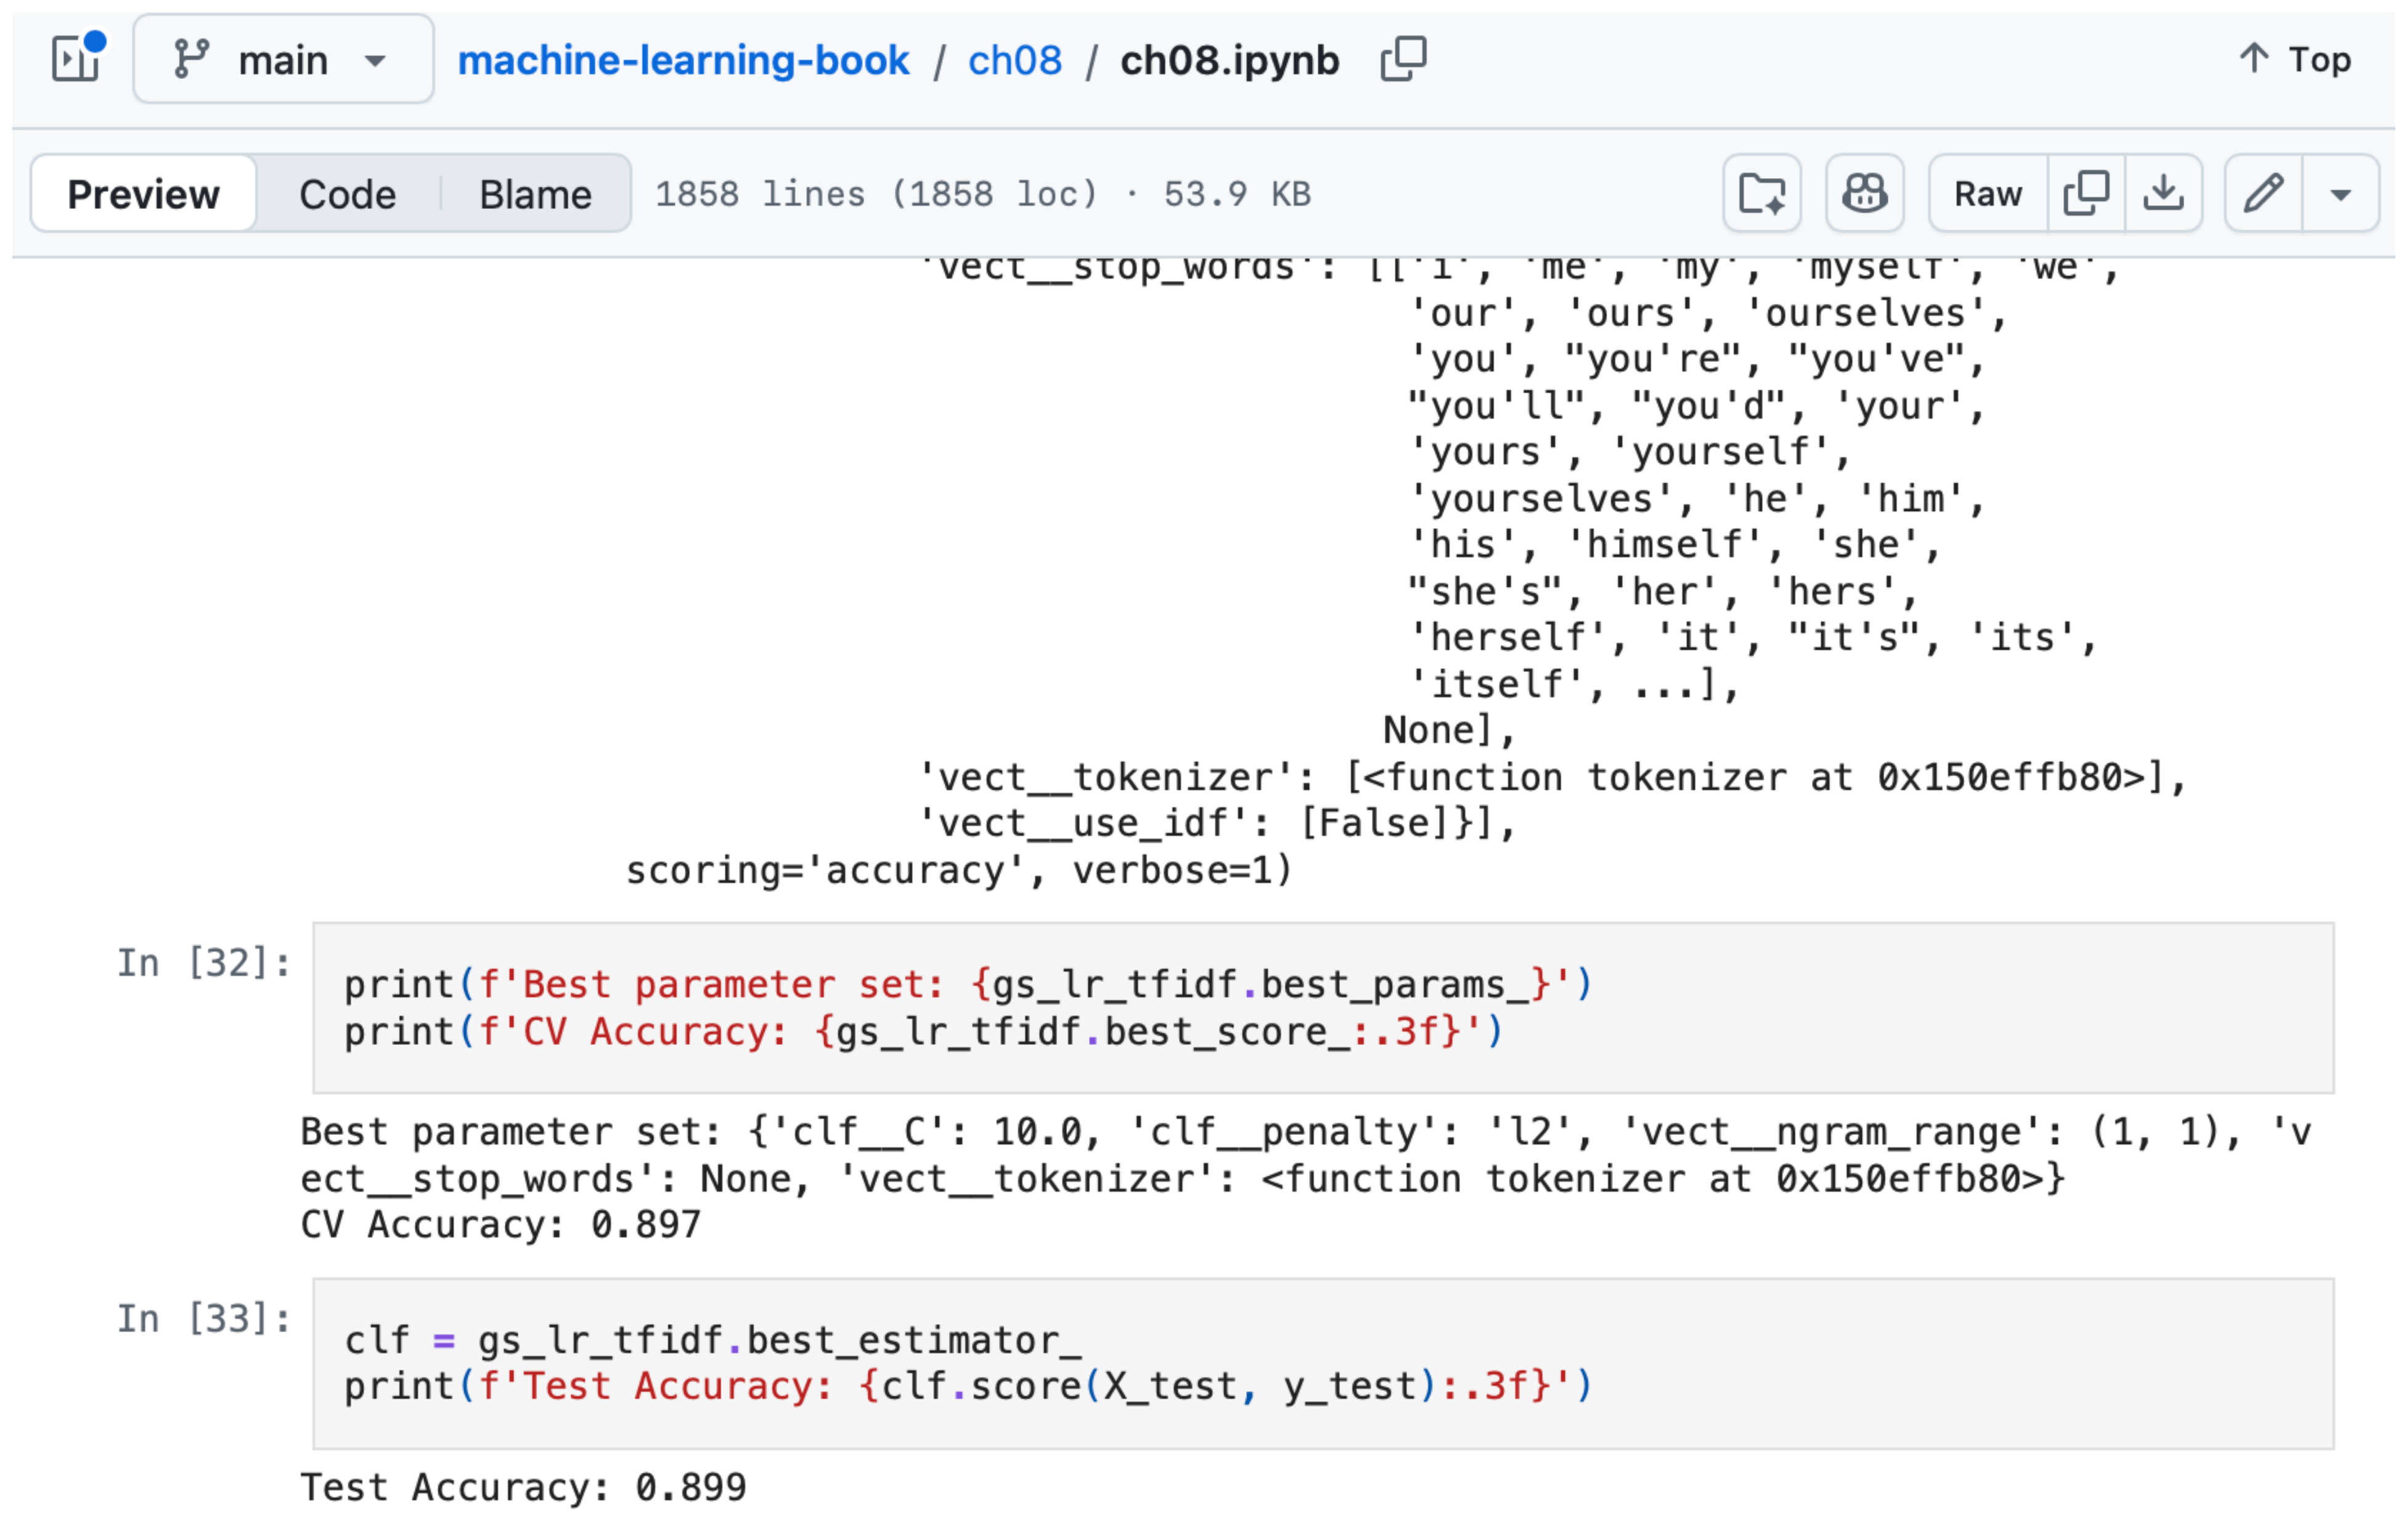
归根结底,RNN 可以用于训练文本分类器。回到 IMDb 电影评论数据集,使用逻辑回归的 bag-of-words 分类器在平衡数据集上达到了约 89.9% 的准确率,而 LSTM RNN 仅达到 85.66%。没错,RNN 确实更难训练(请留意下文提到的 ULMFiT 方法,它能以更高的准确率训练 RNN)。
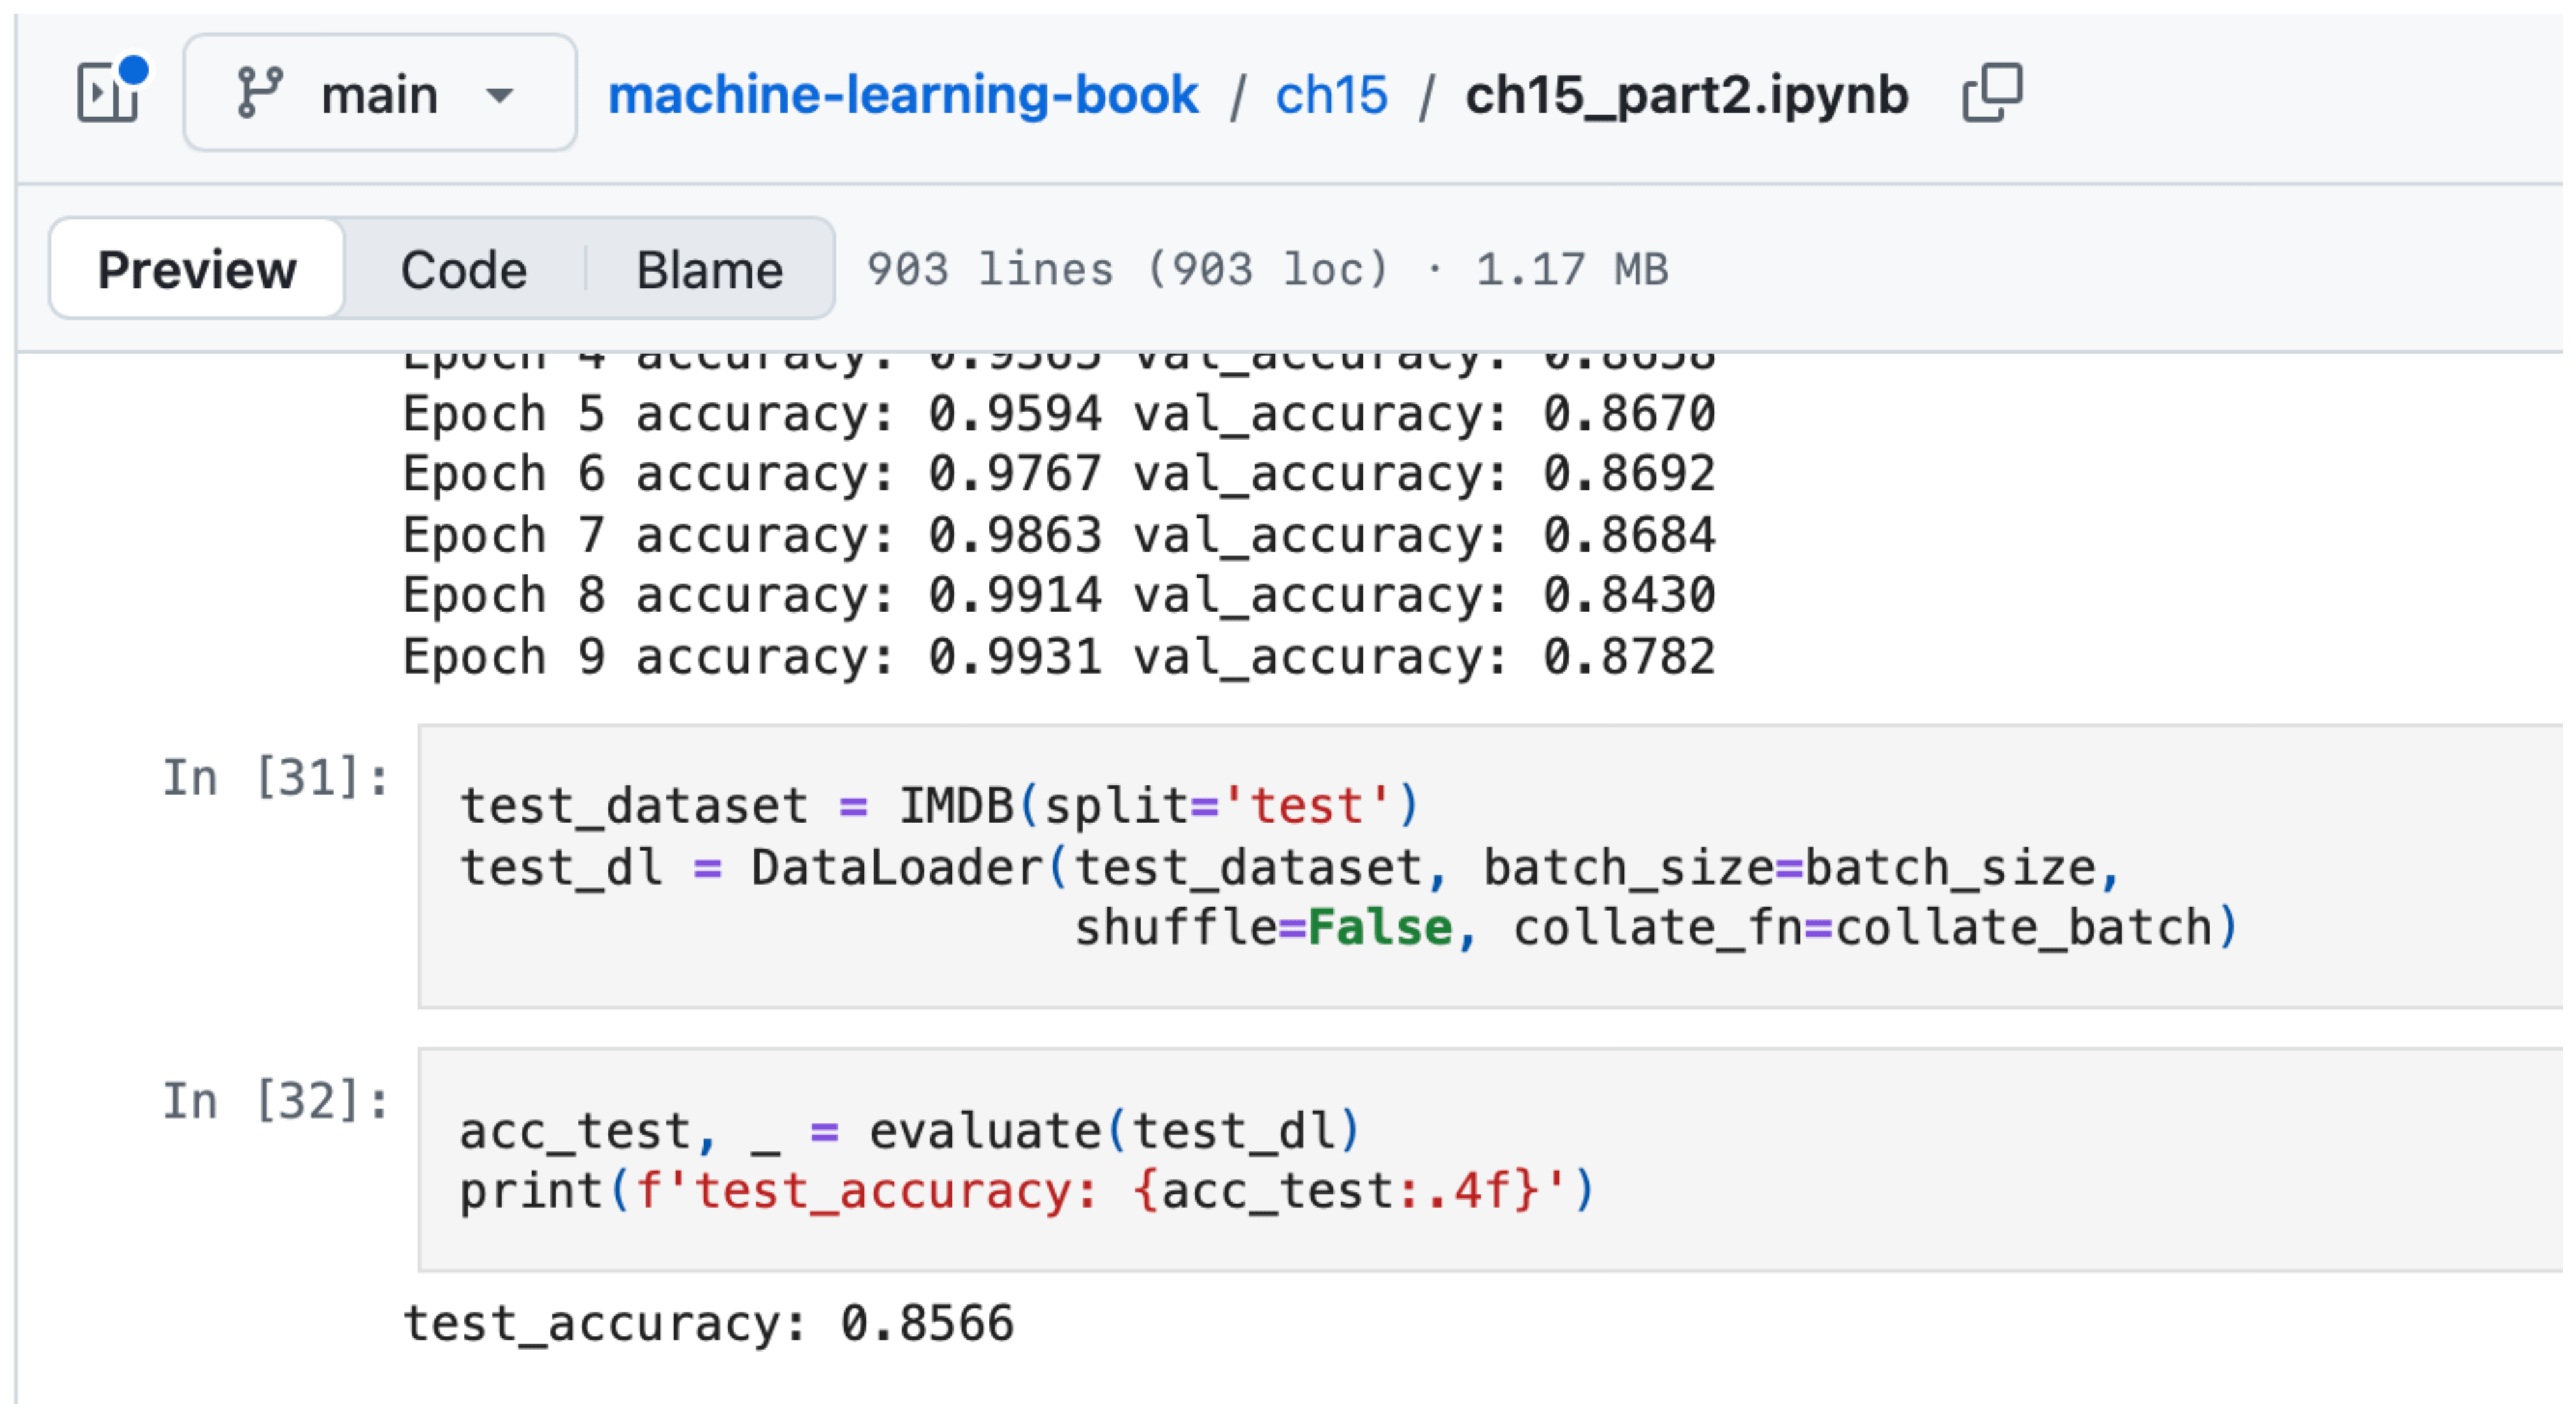
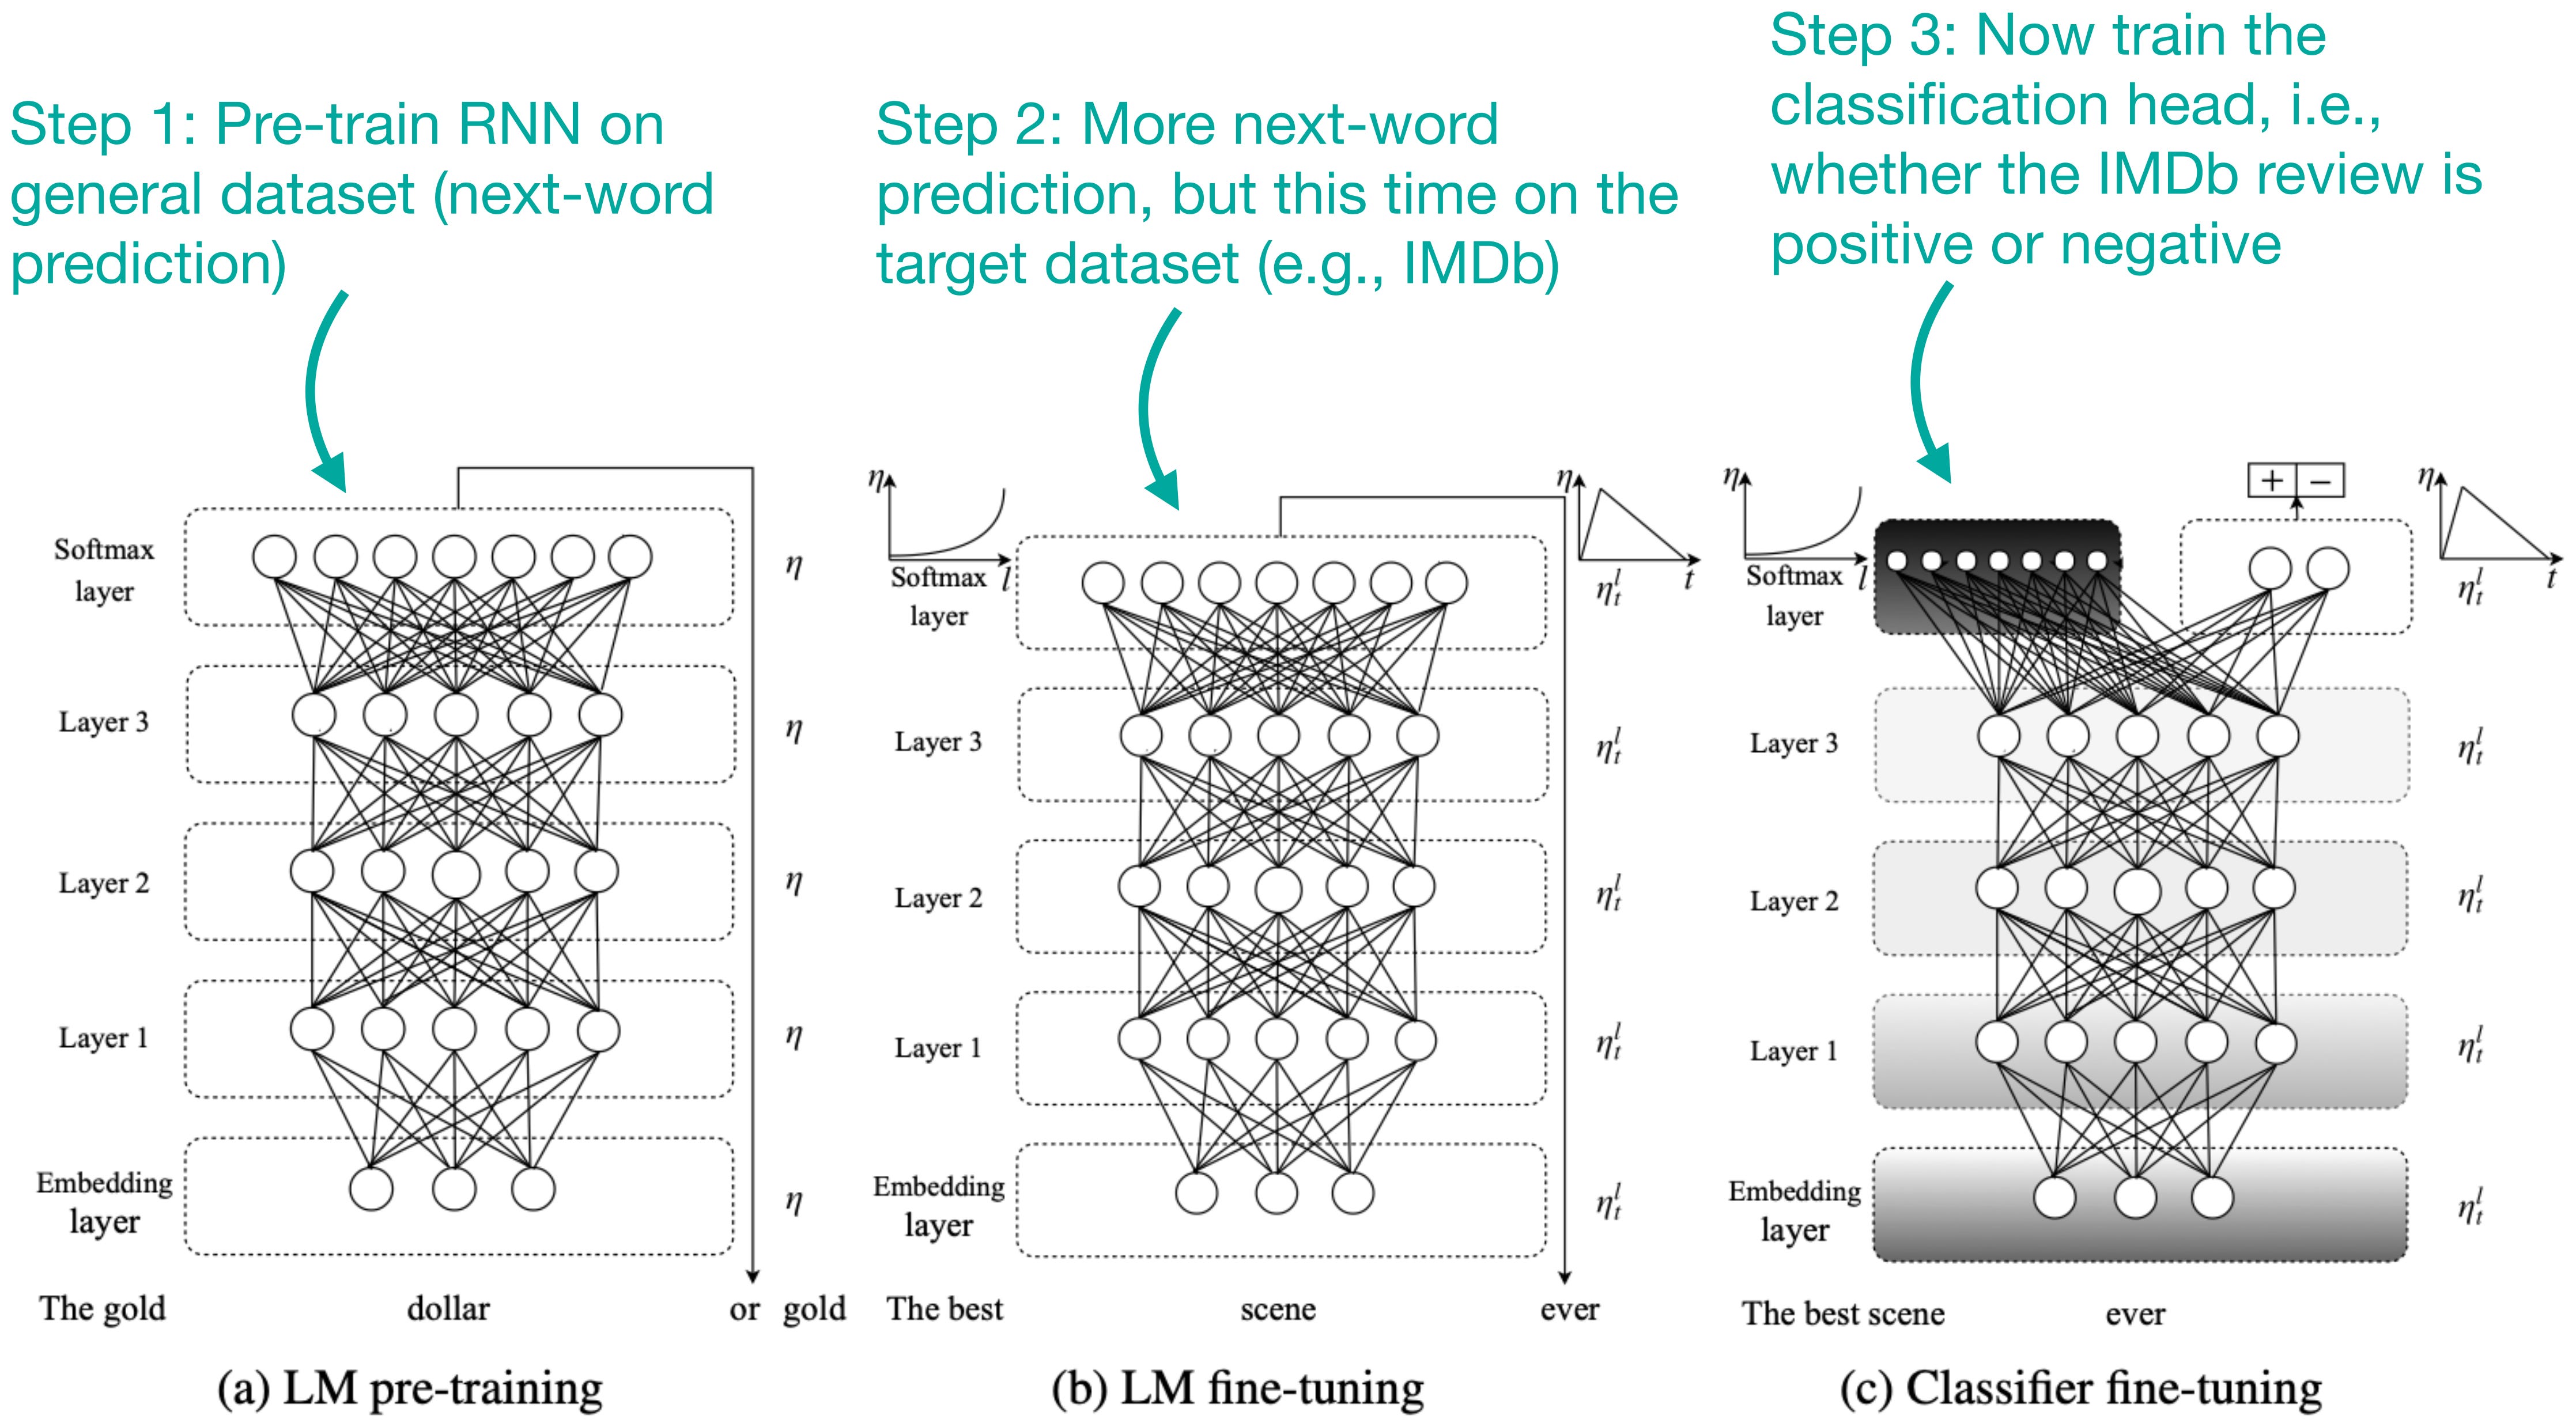
注意,这个 RNN 是从头训练的。更好的做法是先在大规模数据集上预训练模型,再在目标数据集上微调(传统上称之为“迁移学习”)。
在自然语言处理领域,提出这一思路最具影响力的论文之一是 ULMFiT(2018),它在 IMDb 上取得了 95.4% 的测试准确率,令人印象深刻。
1.2.3 卷积神经网络(CNN)
你可能是在计算机视觉中了解到卷积神经网络(CNN)的。不过,虽然历史上较少见,CNN 同样可以用于文本处理。
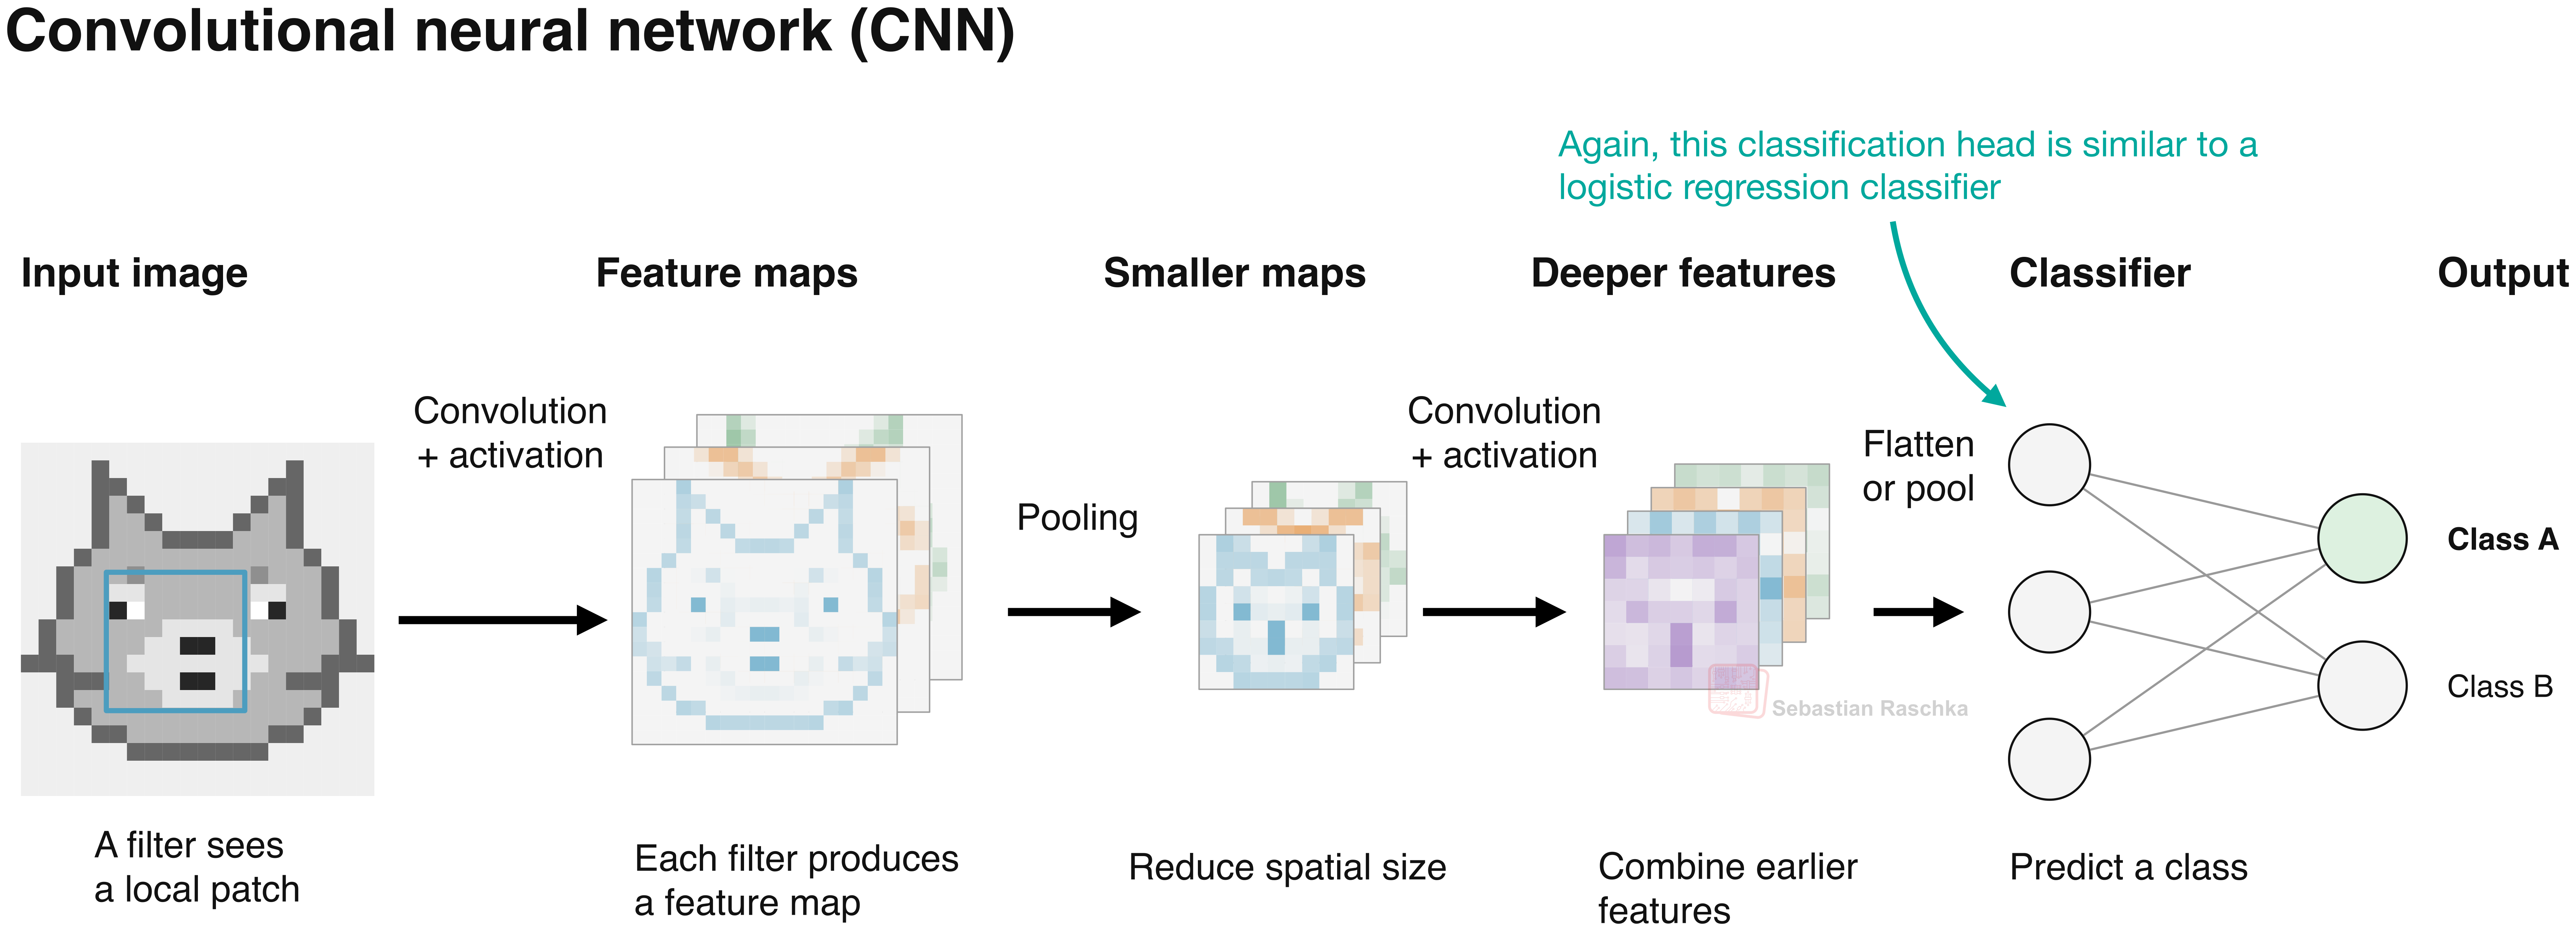
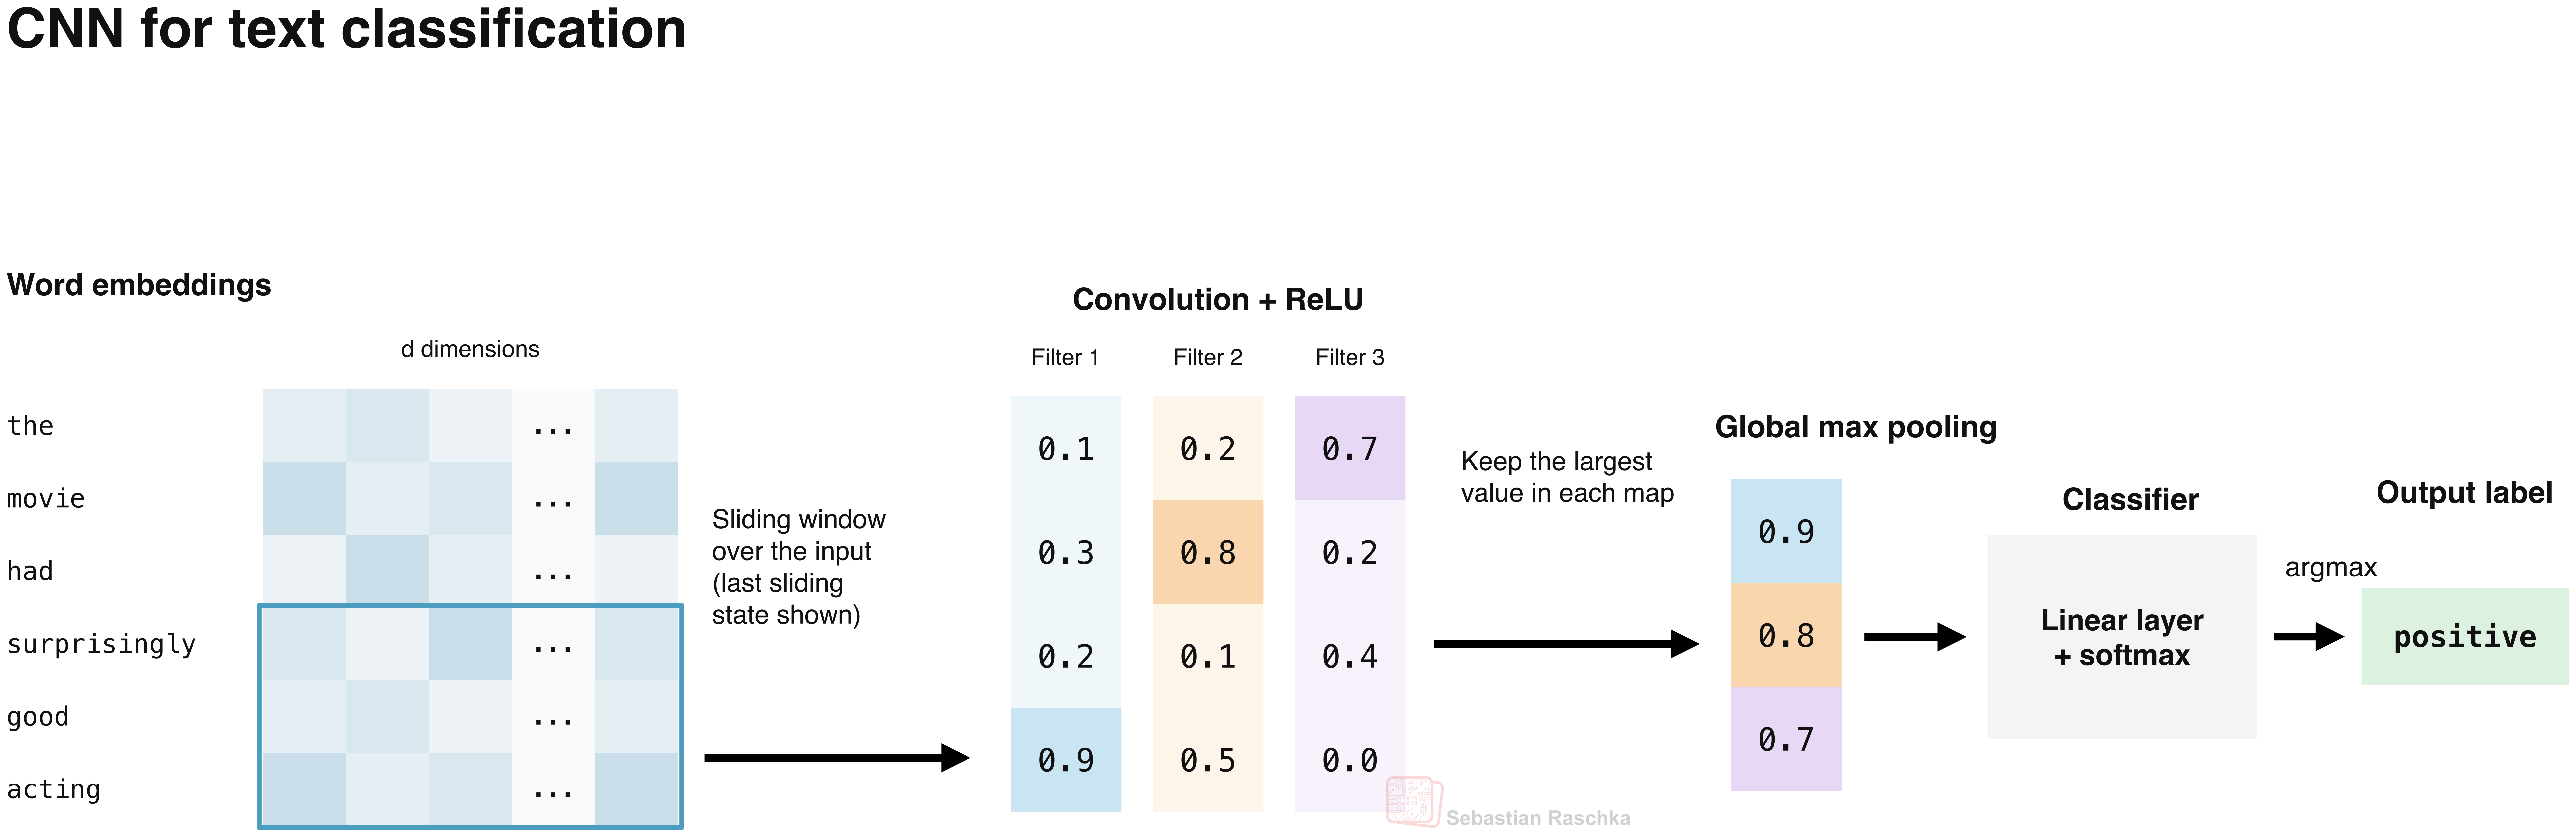
如上图中图像分类示例所示,CNN 将学习到的滤波器应用于图像局部窗口。同样,在自然语言领域,我们也可以将学习到的滤波器应用于相邻词嵌入构成的窗口。
如上一步骤所示,窗口大小为 3 的卷积滤波器对每一组相邻的 3 个词使用相同的权重。随后,它在输入上滑动,每次将滤波器向右移动一个词,作用于“the movie had surprisingly good acting”。因此,在忽略填充(padding)以保持简单的前提下,会得到 4 个窗口:
1:“the movie had”
2:“movie had surprisingly”
3:“had surprisingly good”
4:“surprisingly good acting”
因此,在最后一层,即分类头之前,我们可以将结果展平(flatten)或进行全局最大池化(global max pool),然后再连接到分类头。虽然展平操作能保留所有信息,但它会产生长度随输入文本长度变化的向量。(例如,如果“the movie had surprisingly good acting”更长,特征图也会更长。)所以,为了使其与输入长度无关,此处采用全局最大池化是更好的选择。
简而言之,我们可以如下可视化文本 CNN。
另外值得一提的是,滤波器在各位置上的计算可以并行进行,避免了 RNN 那种逐步依赖的处理方式。
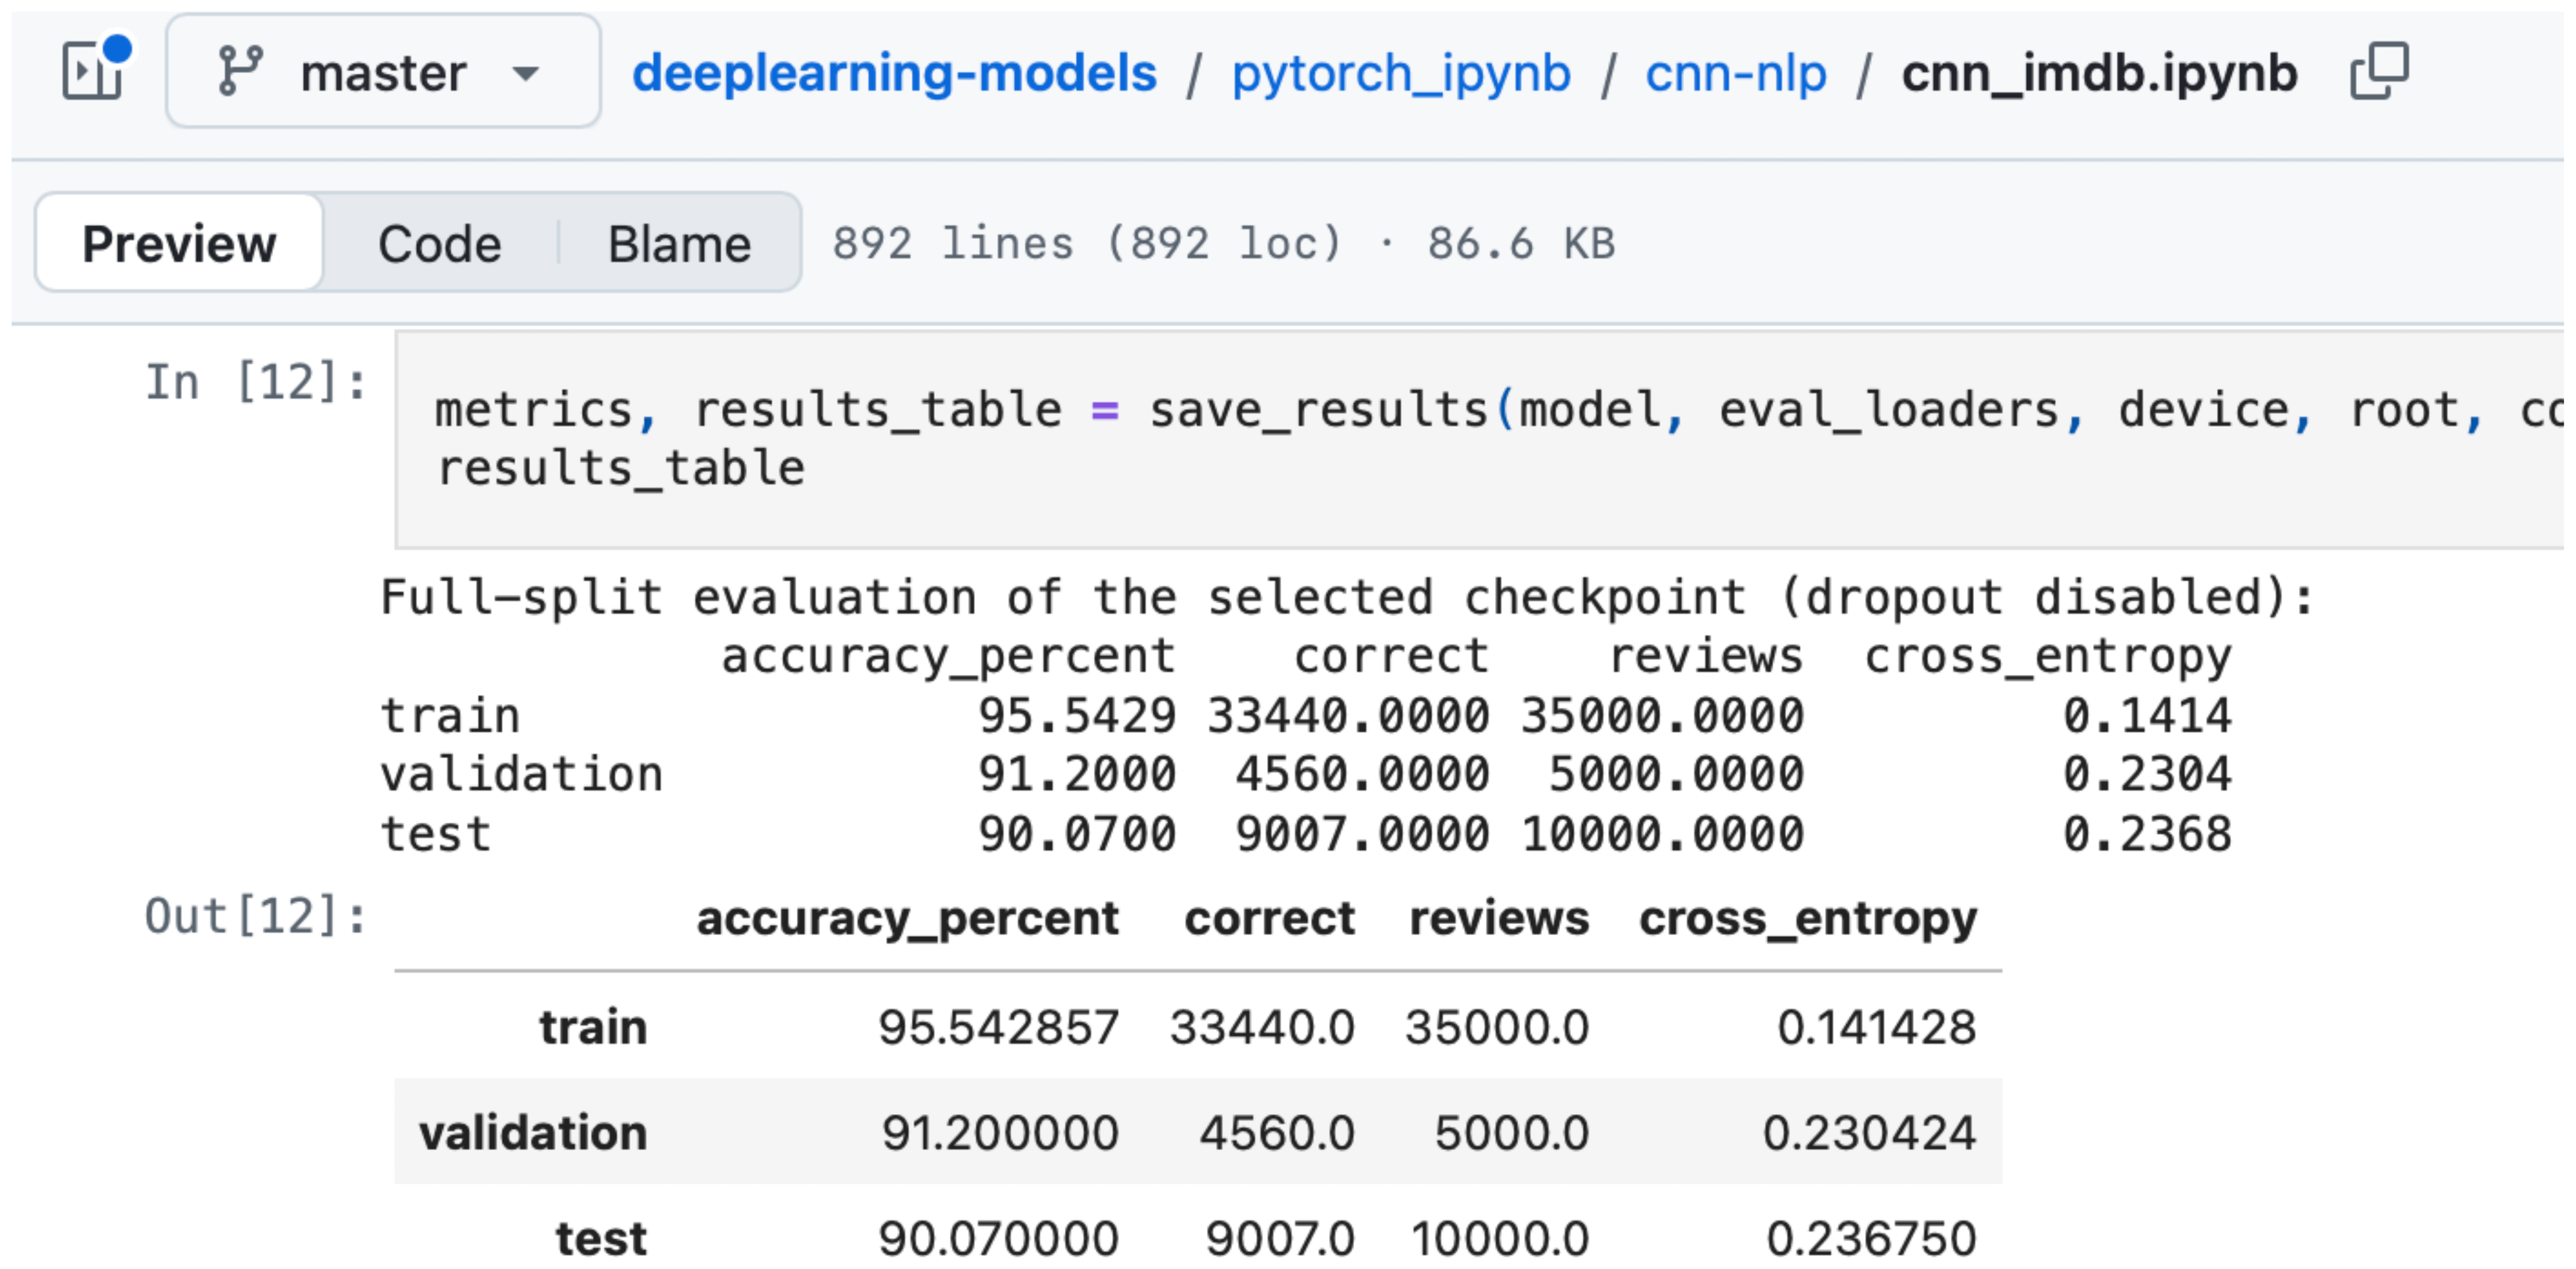
简单对比一下:在上面提到的 IMDb 数据集上,我的实验显示这种 CNN 能达到约 90.07% 的准确率(不过要注意,结果高度依赖具体架构;熟悉计算机视觉的朋友应该知道,准确率差异可以很大。比如老牌的 AlexNet 在 ImageNet 上的 top-1 准确率只有约 62.5%,而 ConvNeXt V2-H 能达到 88.9%)。
2. Transformers
2017 年,原始的 Transformer 架构在论文 Attention Is All You Need 中被提出。这个话题已经被我和许多人讲过很多次了,所以这里只聚焦与分类相关的内容。如果你对注意力机制和其他架构细节感兴趣,可以参考我的相关文章:
大型 LLM 架构全面对比
Sebastian Raschka, PhD · 2025年7月19日 阅读全文现代 LLM 中 Attention 变体视觉指南
Sebastian Raschka, PhD · 3月22日 阅读全文核心要点在于,原始 Transformer 架构采用编码器-解码器结构,主要用于语言翻译任务,但经过简单调整即可用于文本分类,我将在下文具体说明。
2.1 编码器型语言模型
原始 Transformer 架构发布后的头几年,我印象极其深刻,那段时间几乎完全由两种不同路线的争锋所定义:
以 BERT 为代表的编码器模型,主要由 Google 开发;
以 OpenAI 的 GPT 为代表的 Decoder 架构模型。
Encoder 架构模型天然适合做文本分类,GPT 模型则能以涌现能力实现零样本和少样本分类,但其强项仍在生成类任务。
不过,让我们先从 Encoder 架构模型入手,看看如何微调并用于文本分类。
无论是 Encoder 还是 Decoder 架构,使用 Transformer 的一个共性在于:我们基于在大规模文本语料上预训练的模型开展工作。除了直接用作零样本或少样本分类器,我们还可以针对目标数据集进行微调(这与前文 RNN 章节中提到的 ULMFiT 类似)。
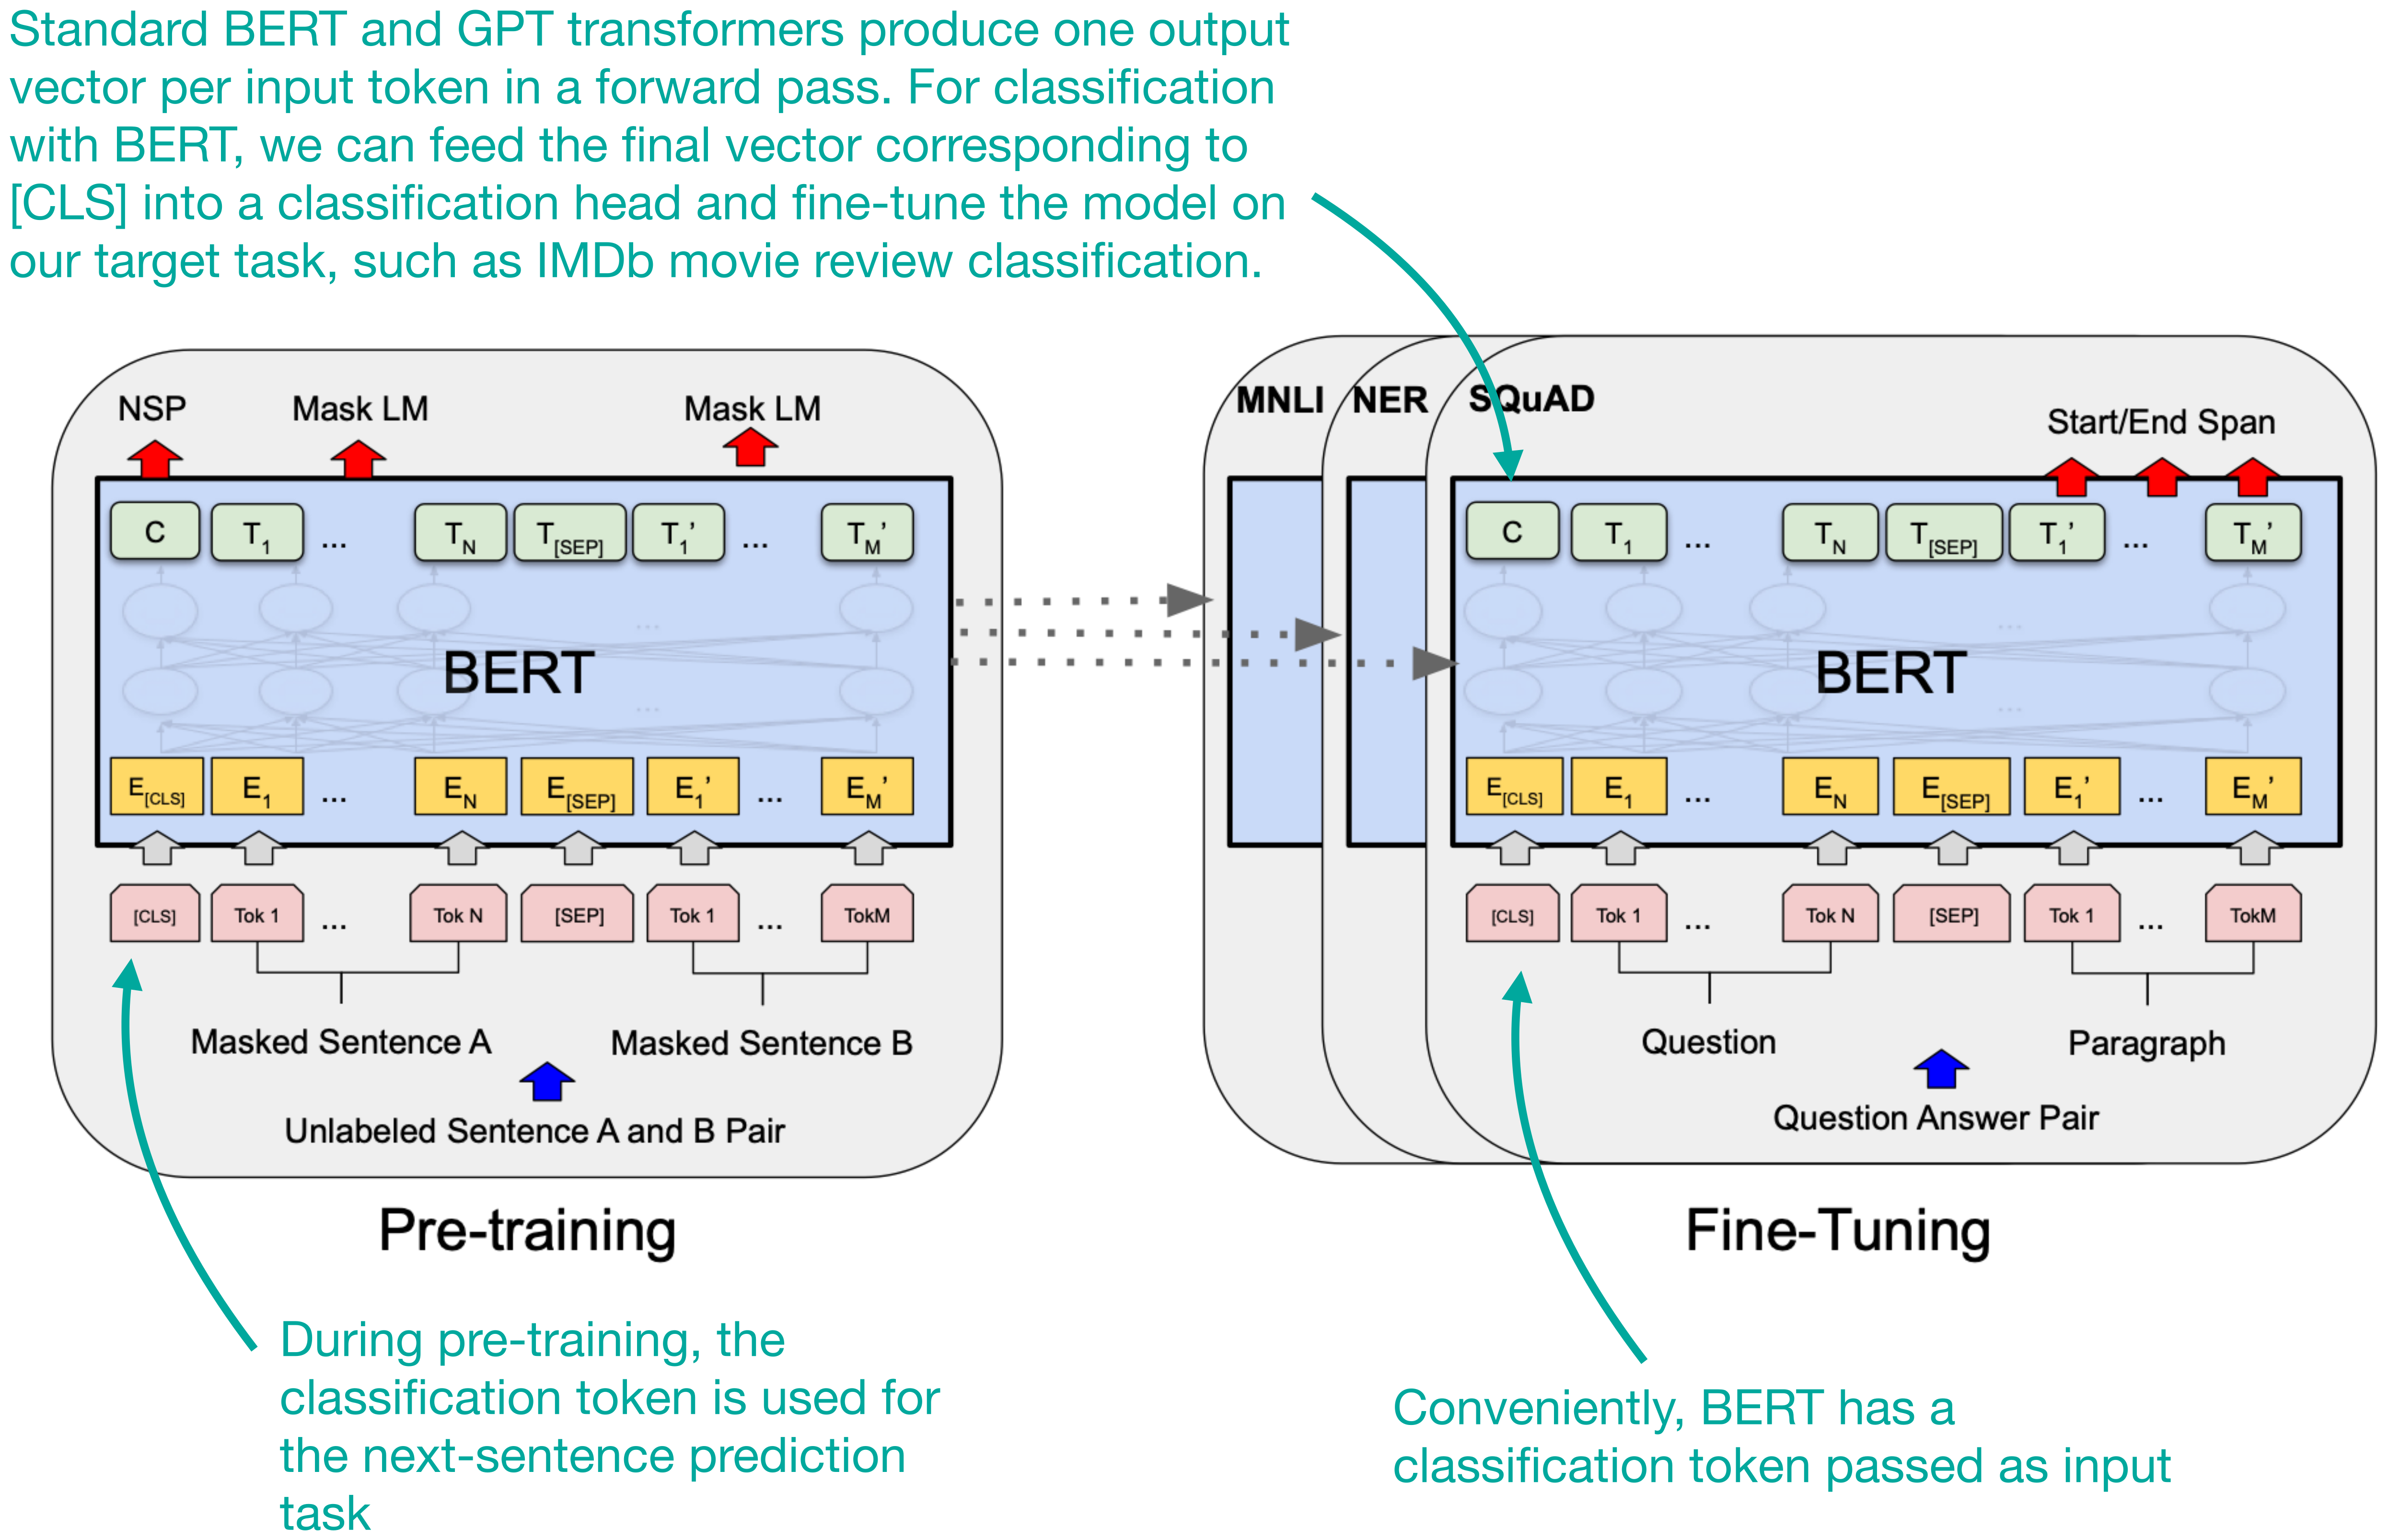
如下图所示(摘自BERT 论文,2018 年),BERT 等 Encoder 架构模型在首位有一个分类标记([CLS]),我们可以方便地微调它以用于分类任务。
虽然 BERT 模型不像自回归 GPT 架构的 Transformer 那样流行,但好在仍有人偶尔对其进行更新和现代化改造。我经常首选用于分类任务的现代模型是 2024 年发布的ModernBERT。
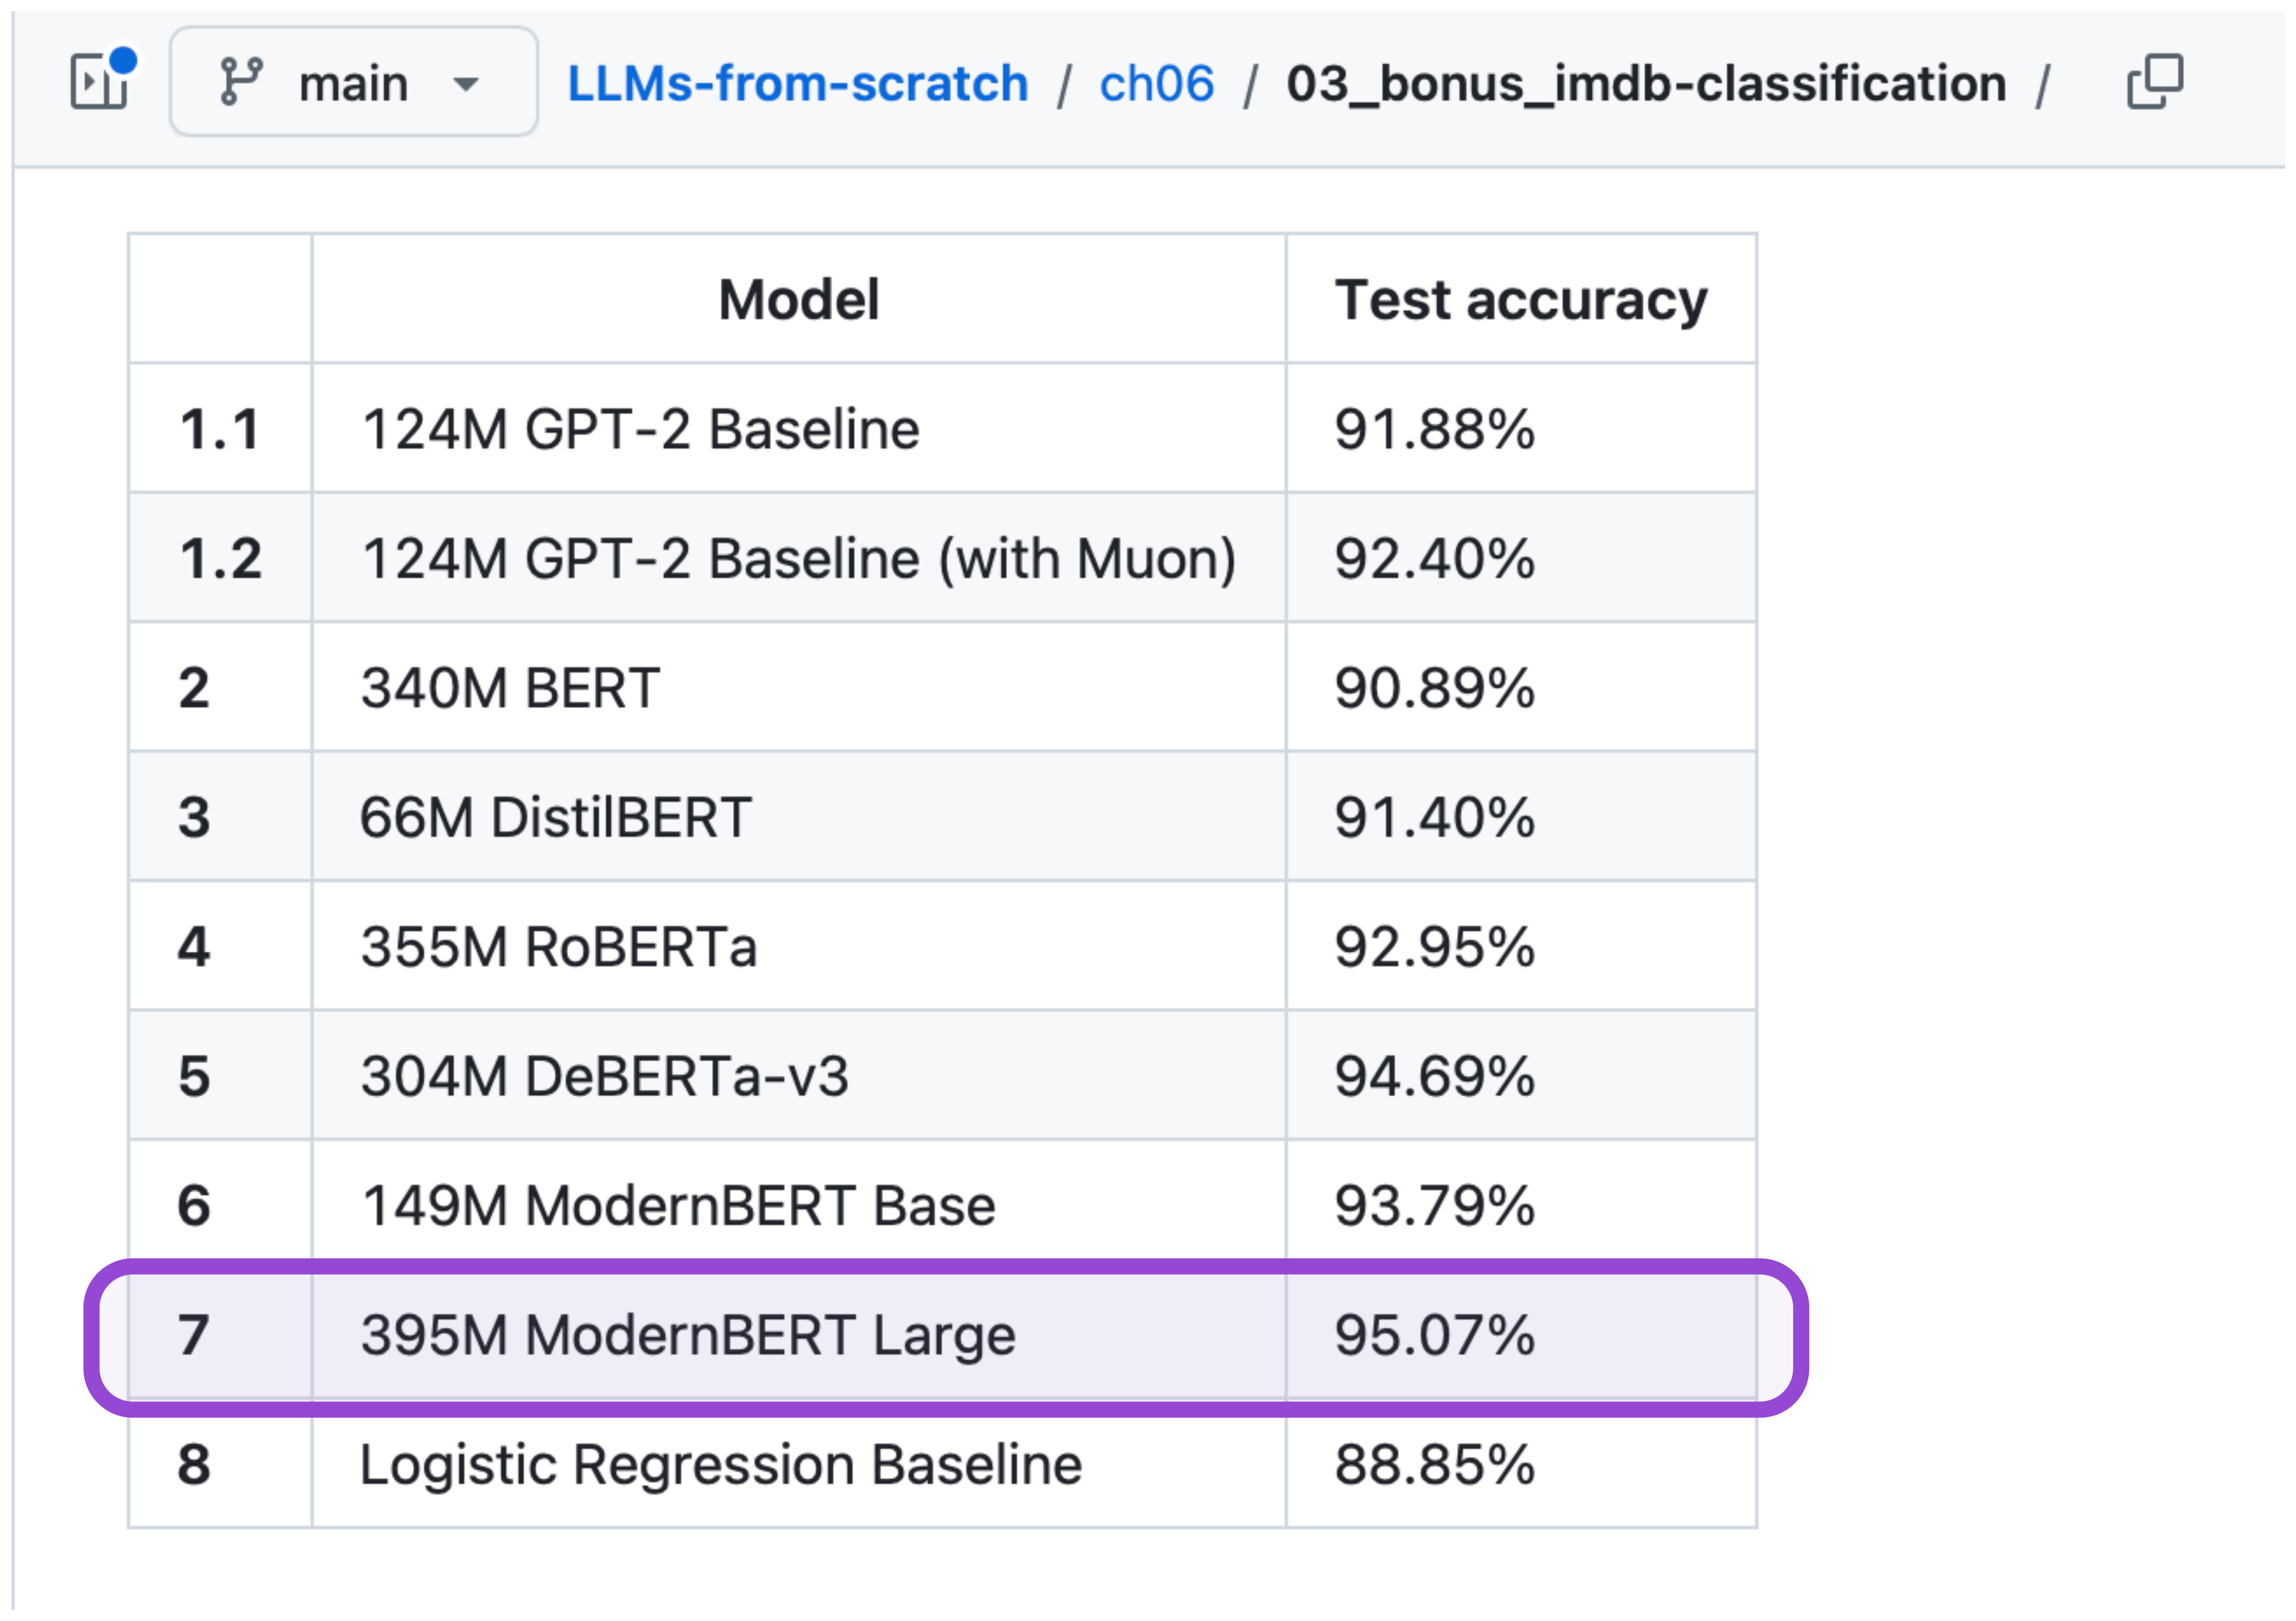
如下图所示,在 IMDb 电影评论数据集上,ModernBERT 仅需很少的微调努力,即可达到约 95% 的准确率。
2.2 Decoder 式 LLM
GPT 这类 LLM 属于 decoder 式自回归 Transformer,是文本和代码生成领域万众瞩目的焦点(绝非双关)。
不过,正如我在《Build A Large Language Model (From Scratch)》一书的第 6 章所讲的,作为微调的入门介绍(在讲指令微调之前),我们也可以把这些模型改造用于文本分类。
当然,我们也可以像下图截图那样,直接向 LLM 发 prompt。
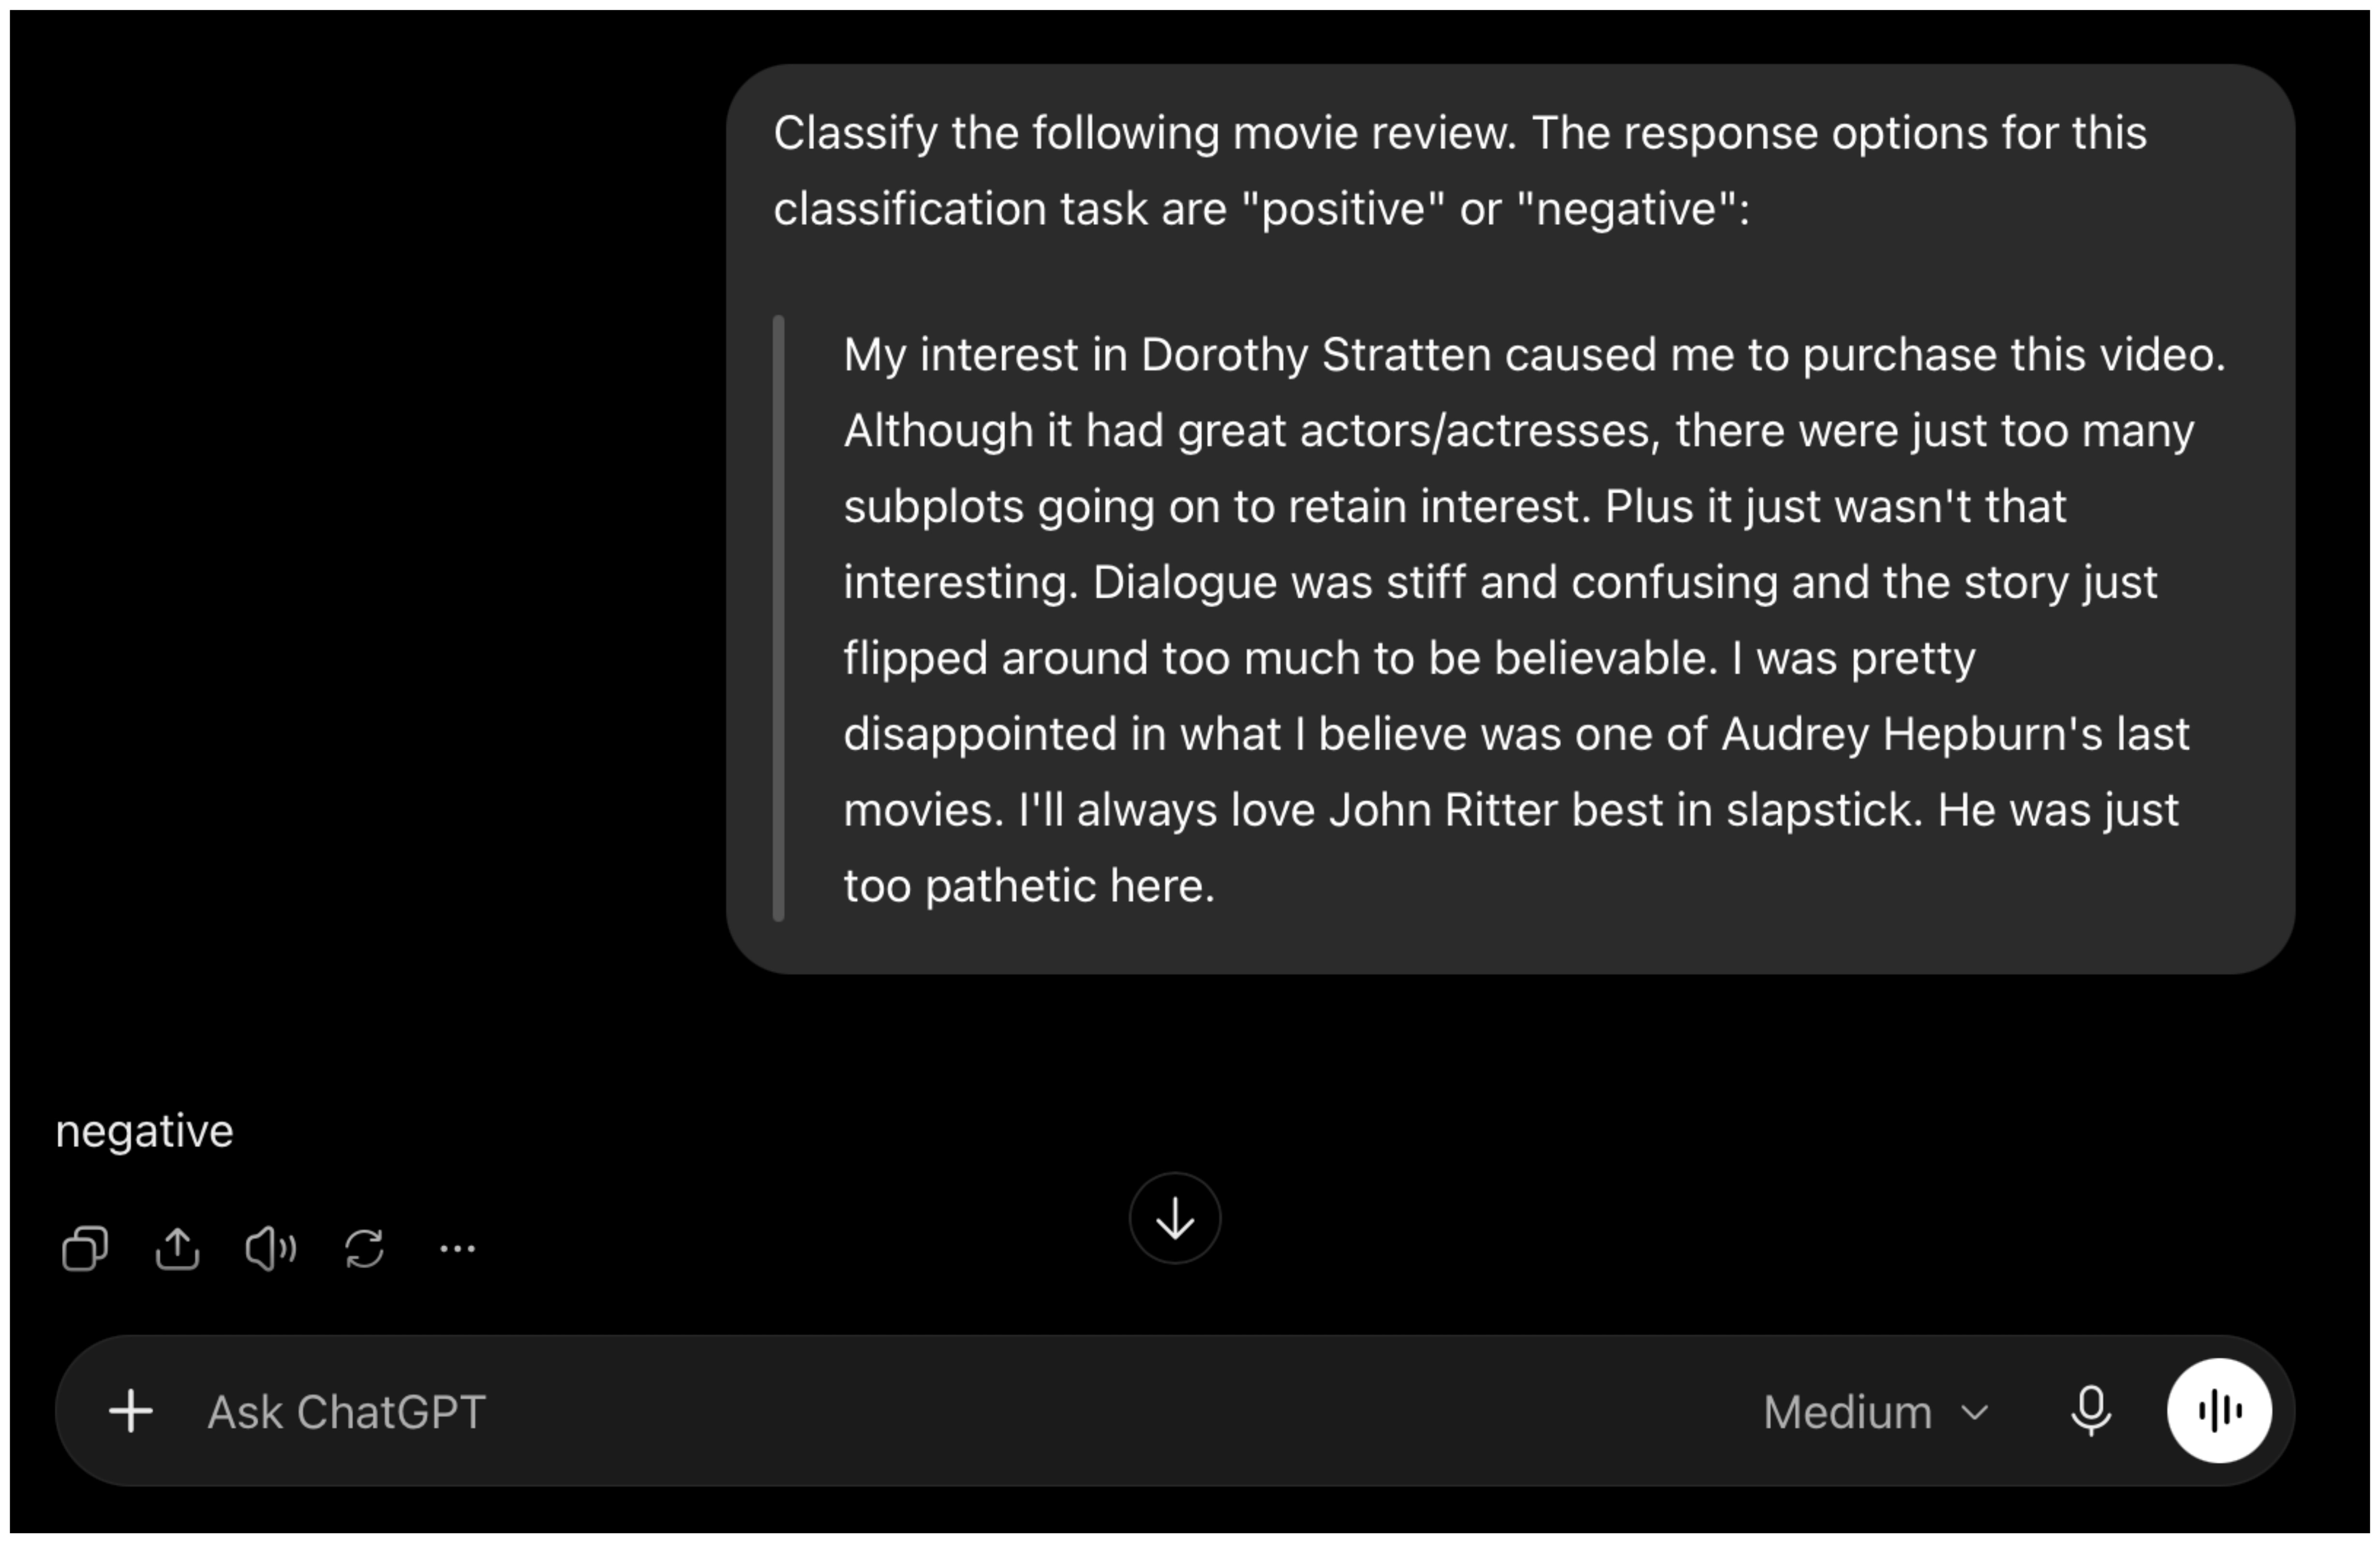
但如果我们需要结构化的输出,且目标领域已经明确,这种做法既脆弱又低效,实在没必要。
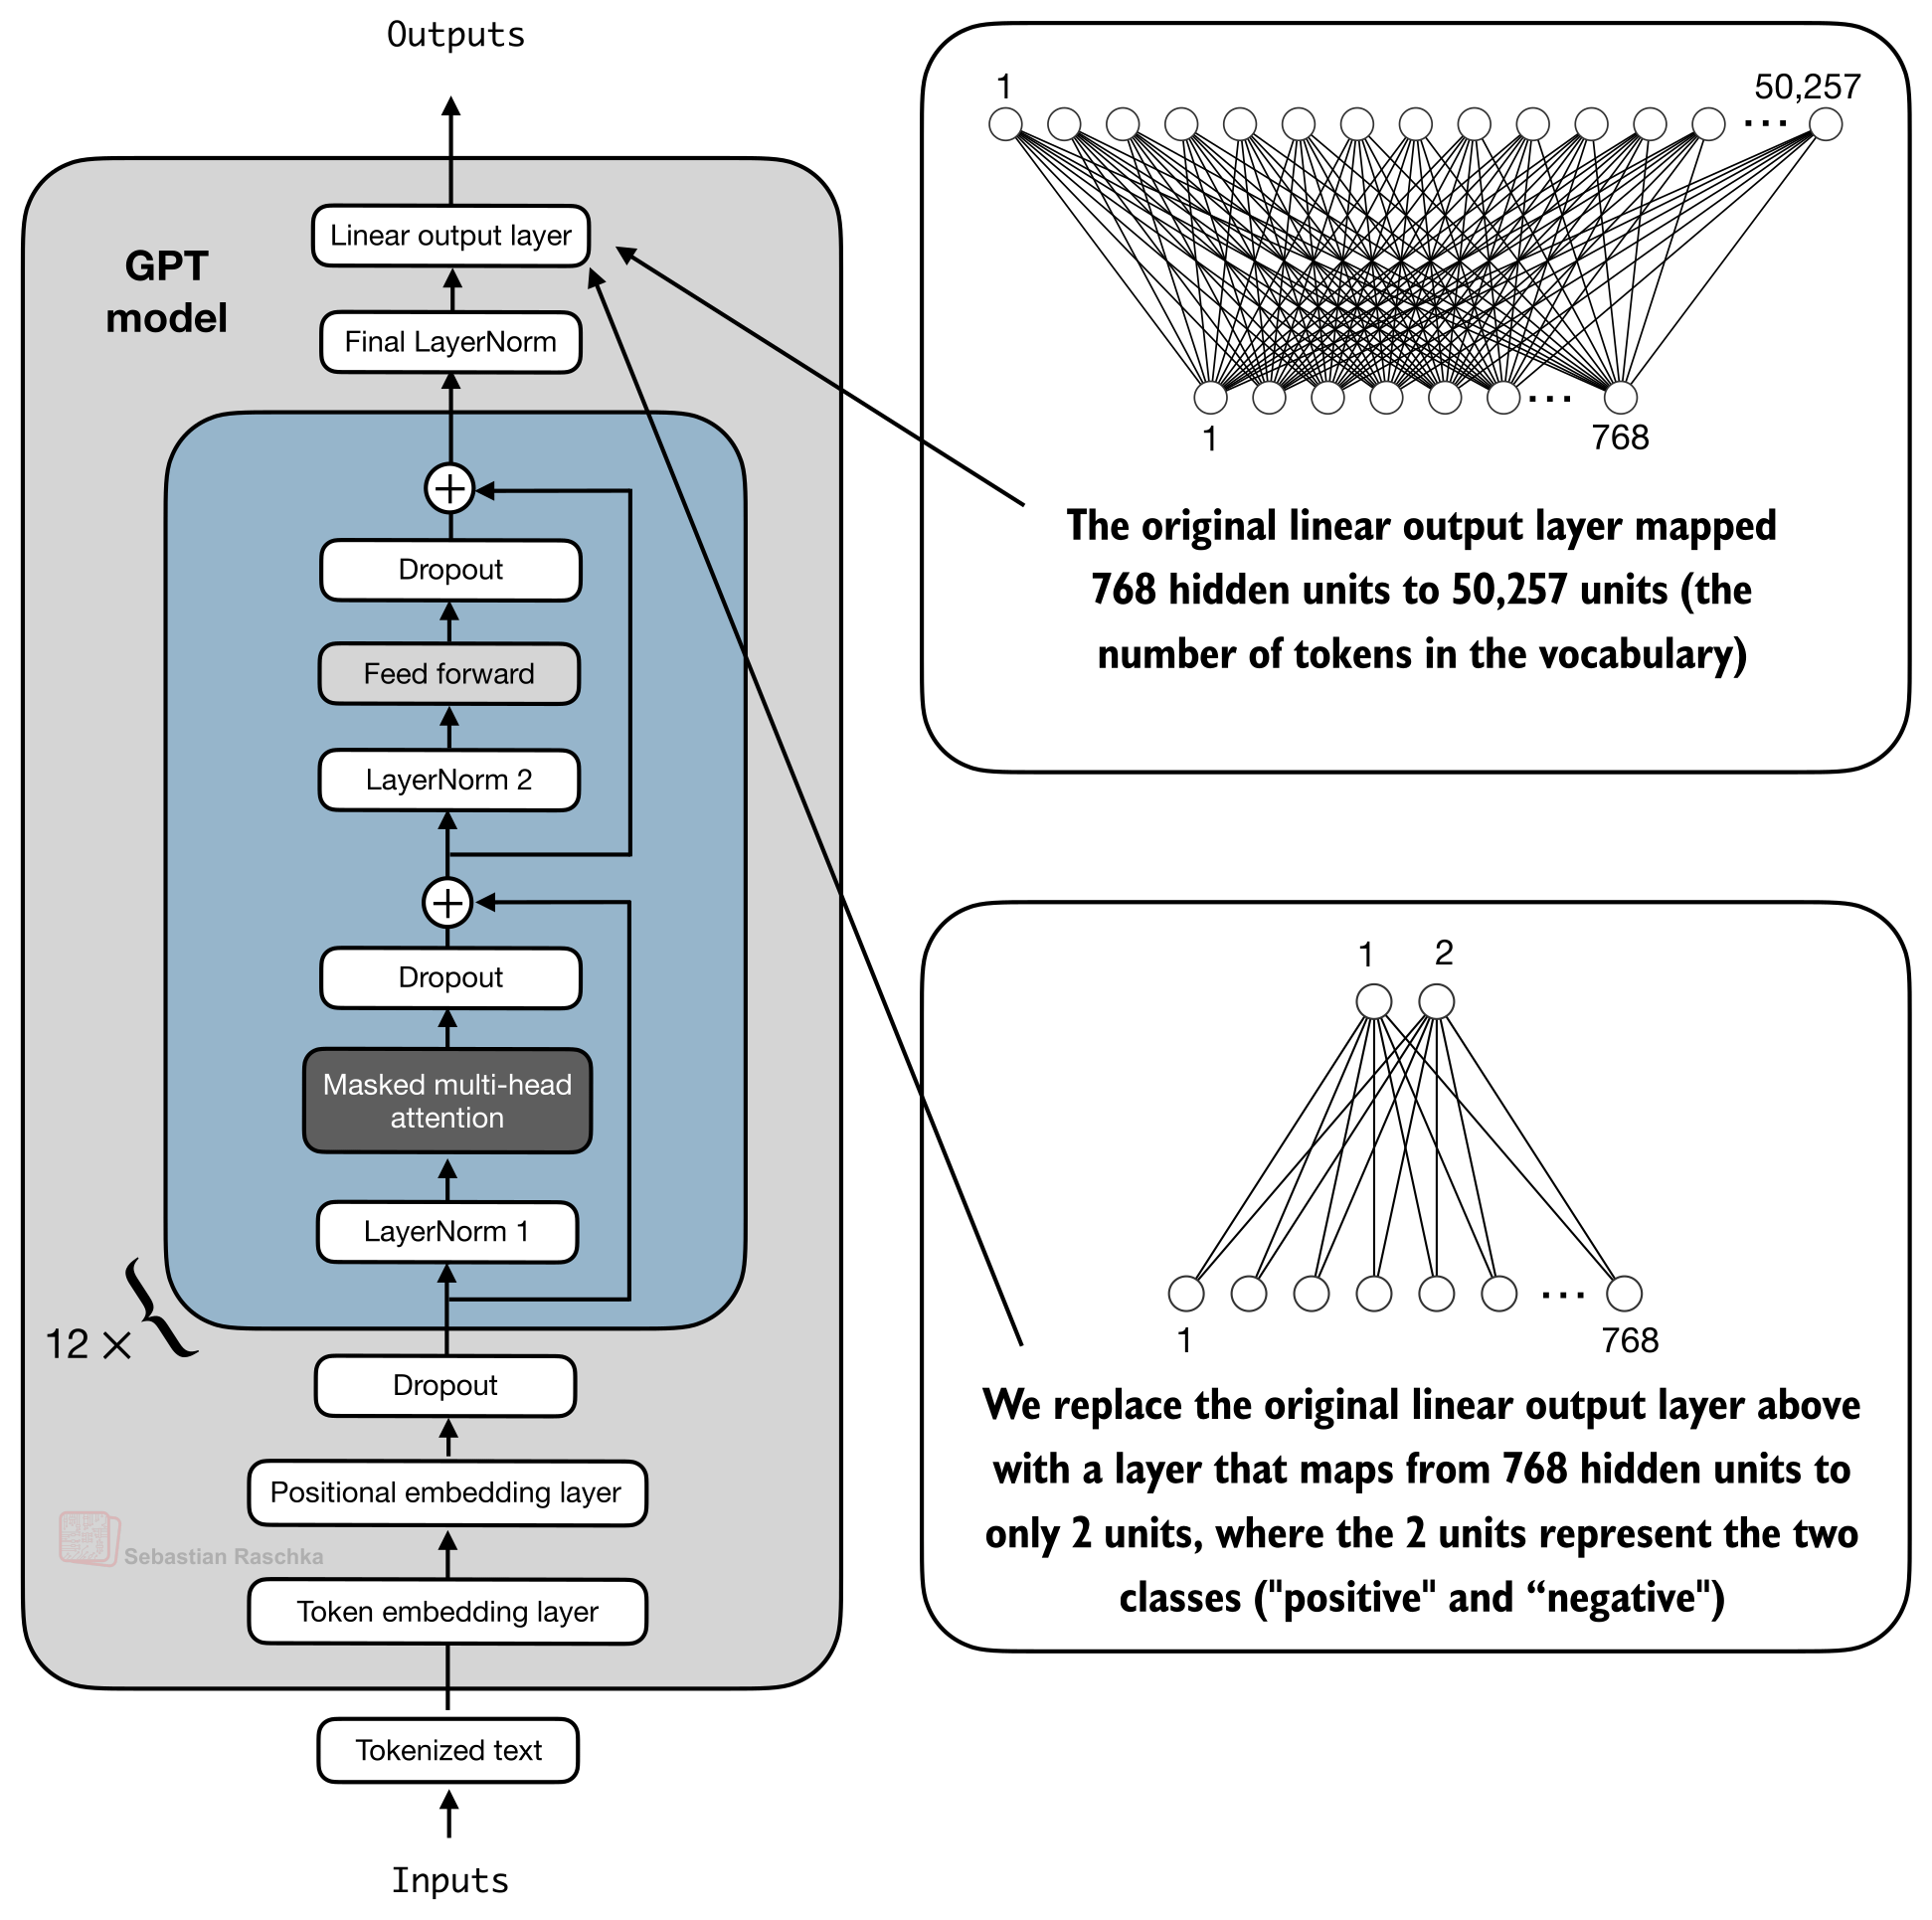
更好的做法是把输出层替换成一个更精简的分类头,如下图所示:
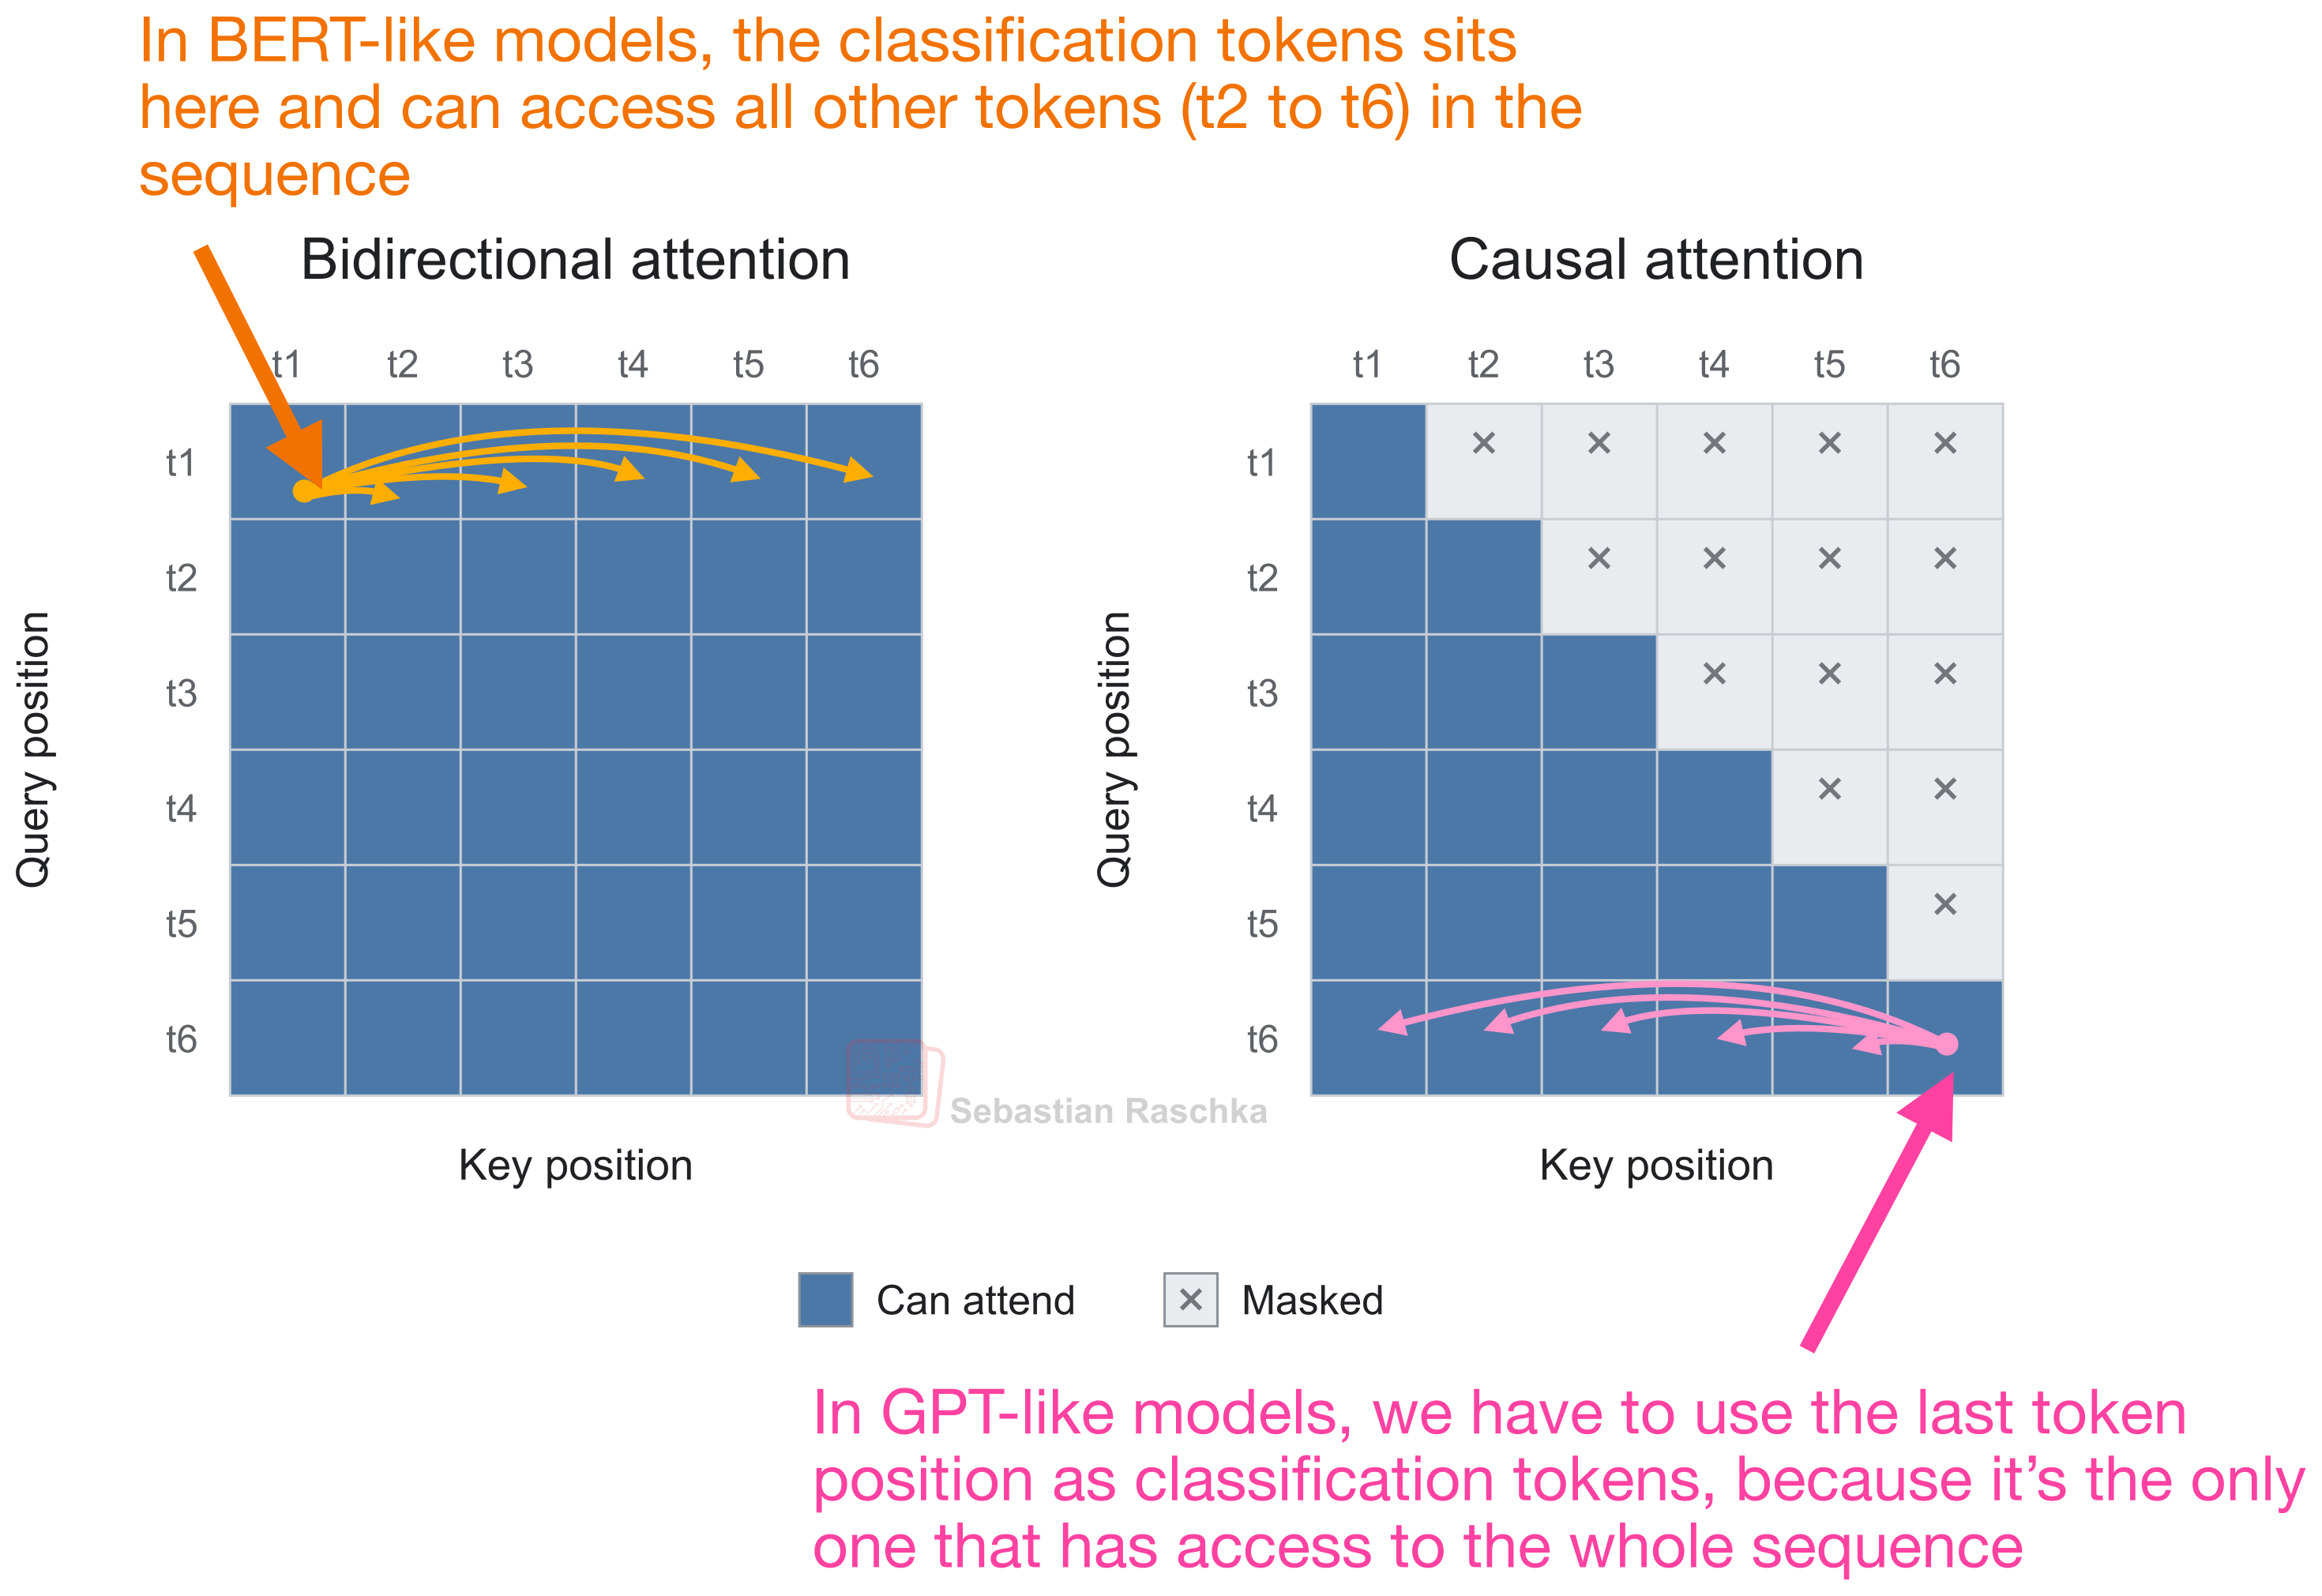
微调有一些需要注意的地方。例如,由于自回归 attention mask(注意力掩码)的限制,我们在设计微调过程时必须确保分类 token(词元)能获取序列中其他所有 token 的信息。
如果你对更多技术细节感兴趣,请查看我最近的一篇端到端文章《从零构建 AI 文本检测器》:
从零构建 AI 文本检测器
Sebastian Raschka, PhD·8 月 15 日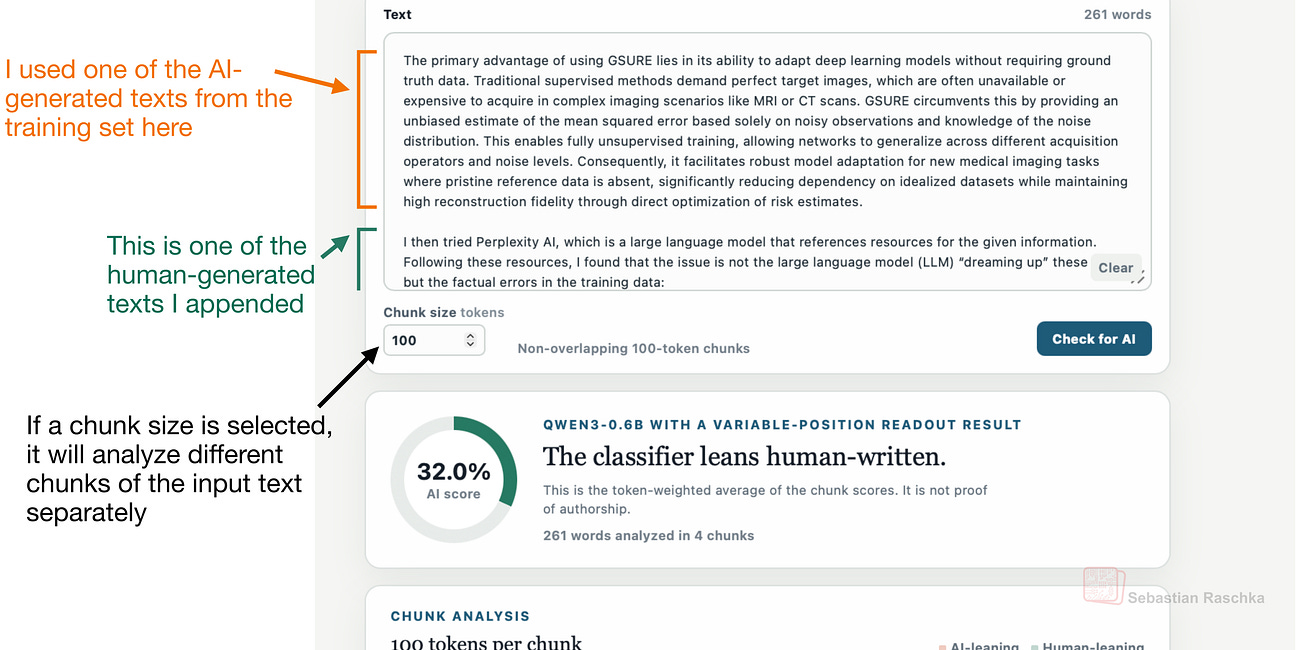
Substack 最近在用户界面中上线了其 AI 检测功能,这一点非常有趣。
阅读全文总体而言,GPT 类 LLM 相比 BERT 等变体的优势在于可选的现代开源权重架构众多。从较小的 Qwen 3 0.6B 到最新的 Kimi、GLM、DeepSeek 模型均可选择。(当然,从效率角度看,使用 >1B 参数模型进行分类可能有些过度,但这在技术上是可行的。)
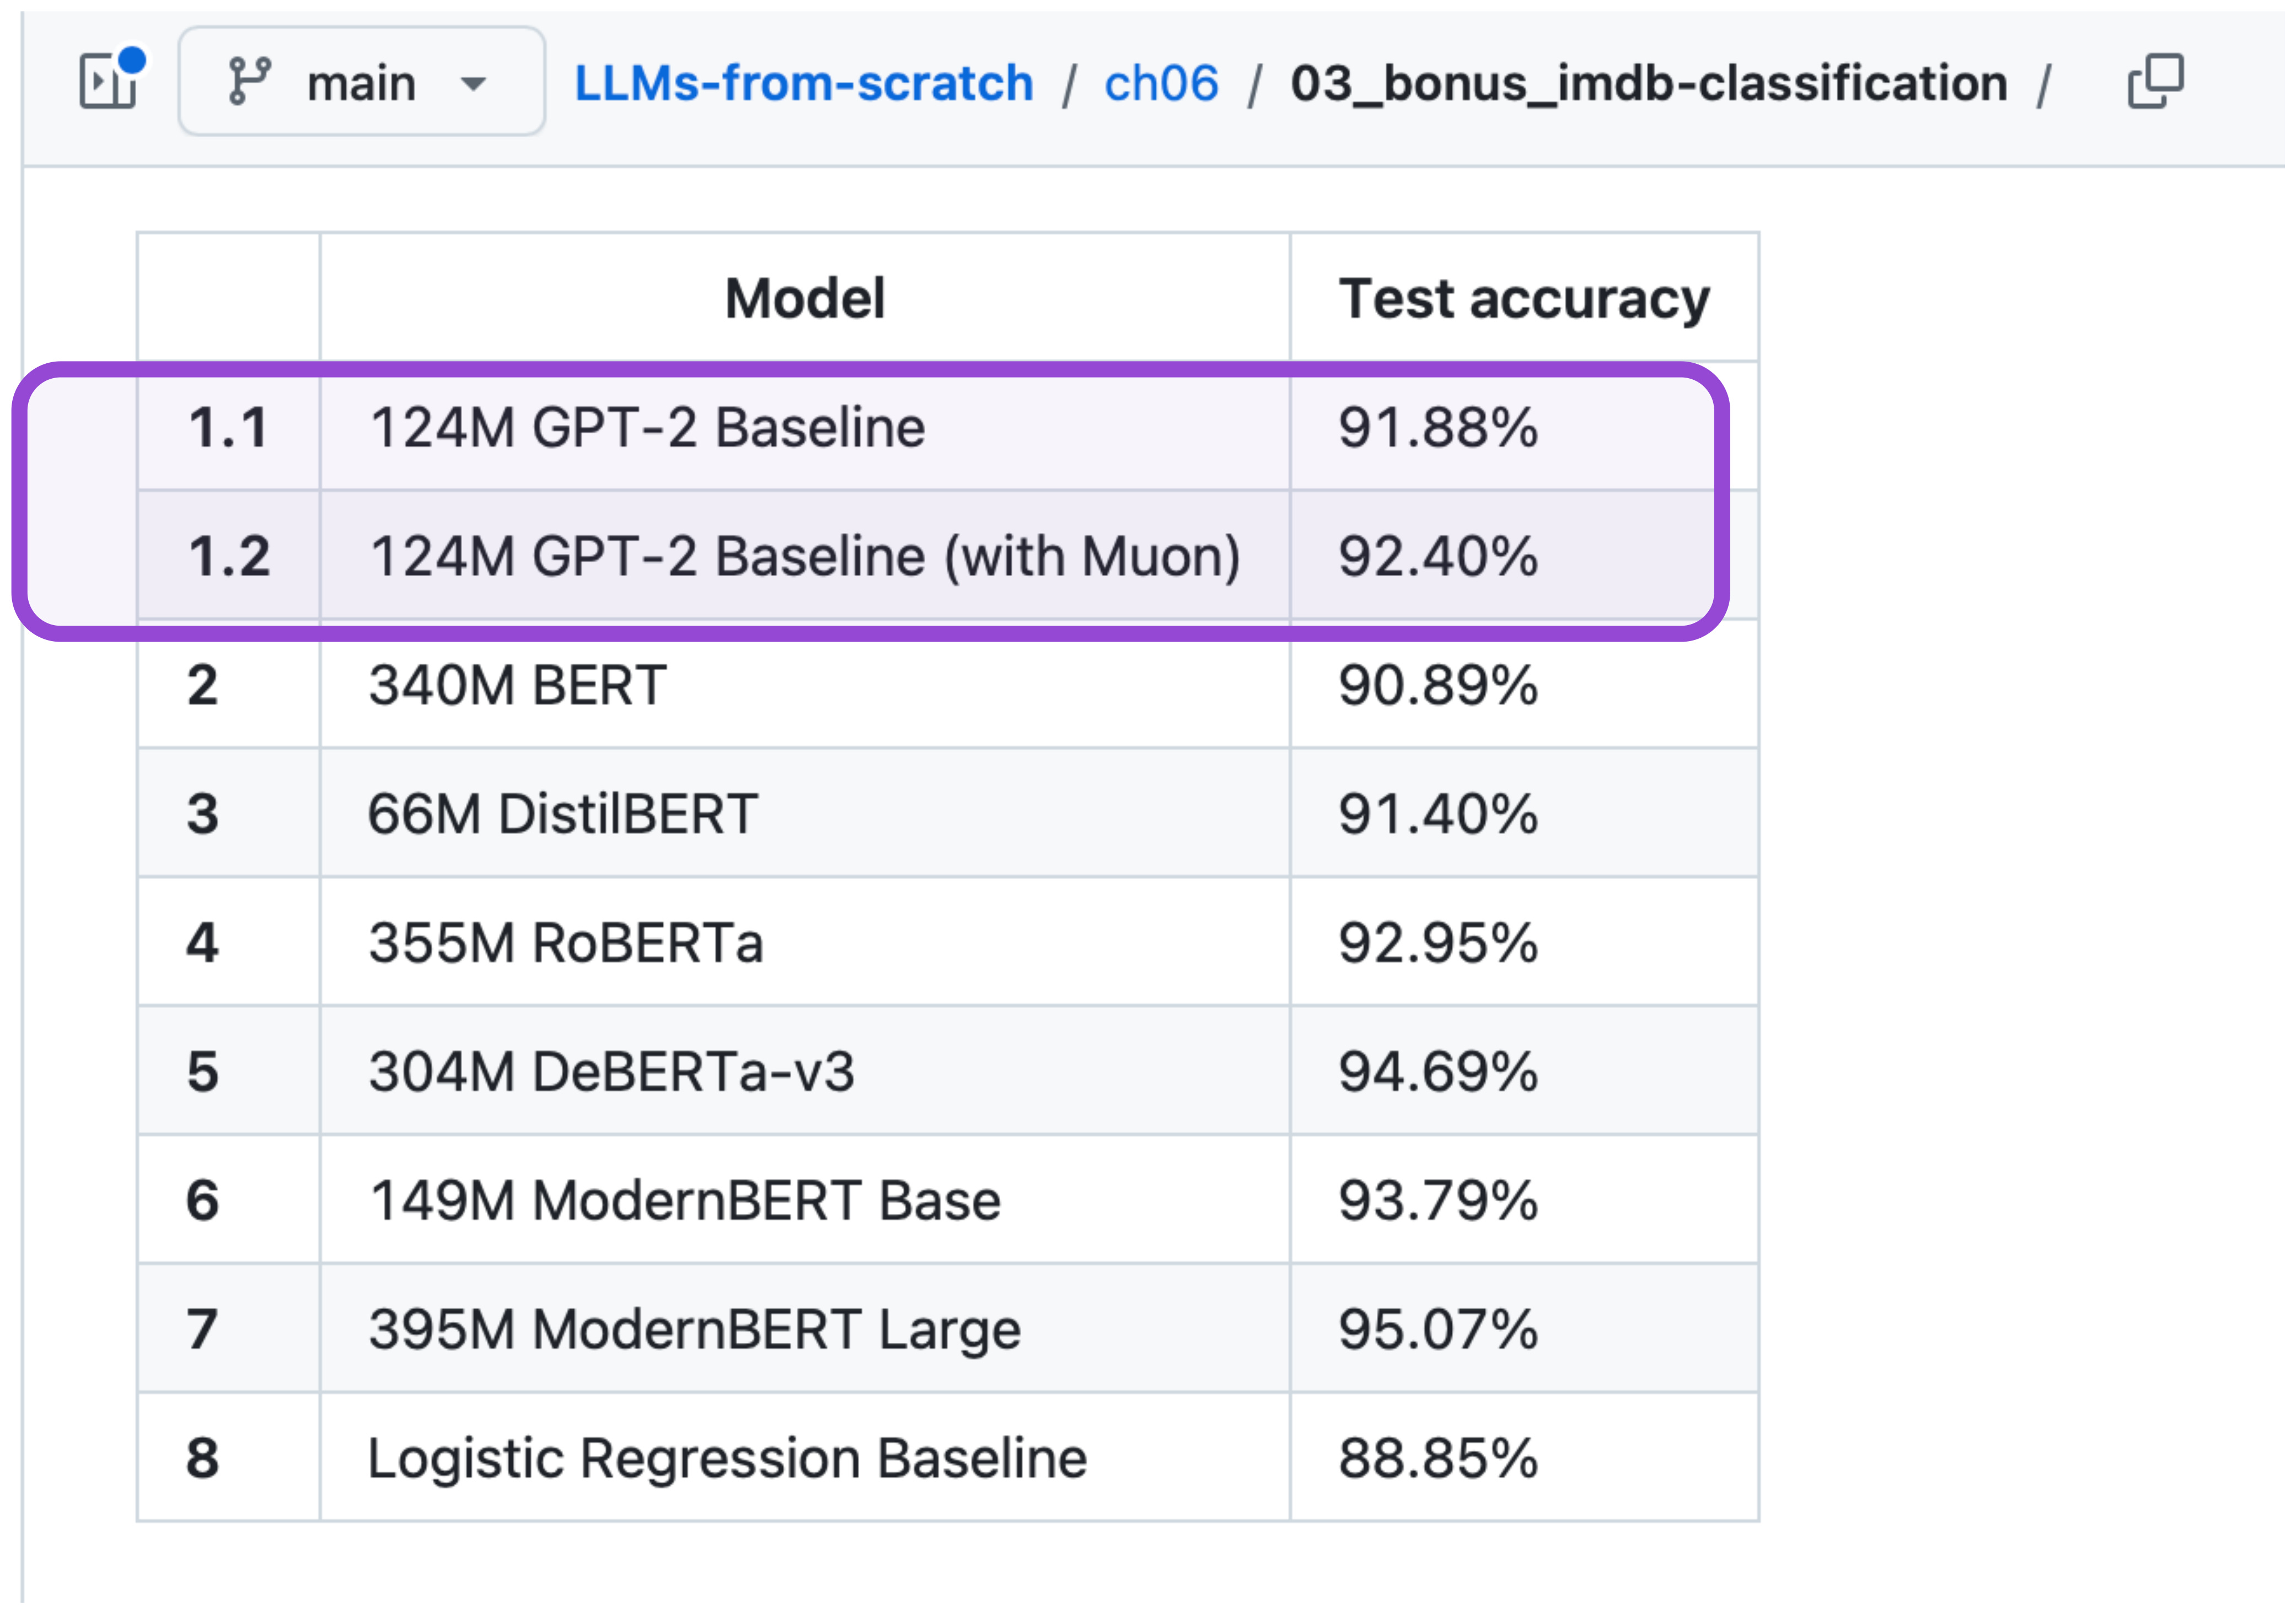
图 20:在前述 IMDb 电影评论数据集上,相对较小的 GPT-2 124M 模型准确率约为 92%;更大的新 LLM(如最近的 Qwen3 变体)表现会更好。
2.3 Encoder-decoder 架构
虽然原始 transformer 架构(encoder-decoder)被拆分为 encoder 类模型(如 BERT)和 decoder 类 LLM(如 GPT)两大范式,但也有工作致力于使用 encoder-decoder 变体,其中较新的一个(出人意料的是)是 DeepSeek V4.1 Flash。(不过在此例中,它采用的是 causal encoder,而非 T5 中的双向 encoder。)
聚焦于用于分类的 encoder-decoder 架构,最突出的候选者或许是 Google 2019 年的 T5(Text-to-Text Transfer Transformer)。
在架构上,T5 与原始 transformer 的区别包括架构更新(如下所述)以及训练方式的变化。原始 transformer 通过有监督方式训练进行语言翻译;T5 使用无标签文本进行预训练,采用 span corruption(跨度损坏):encoder 接收缺失跨度的文本,decoder 生成这些缺失部分。
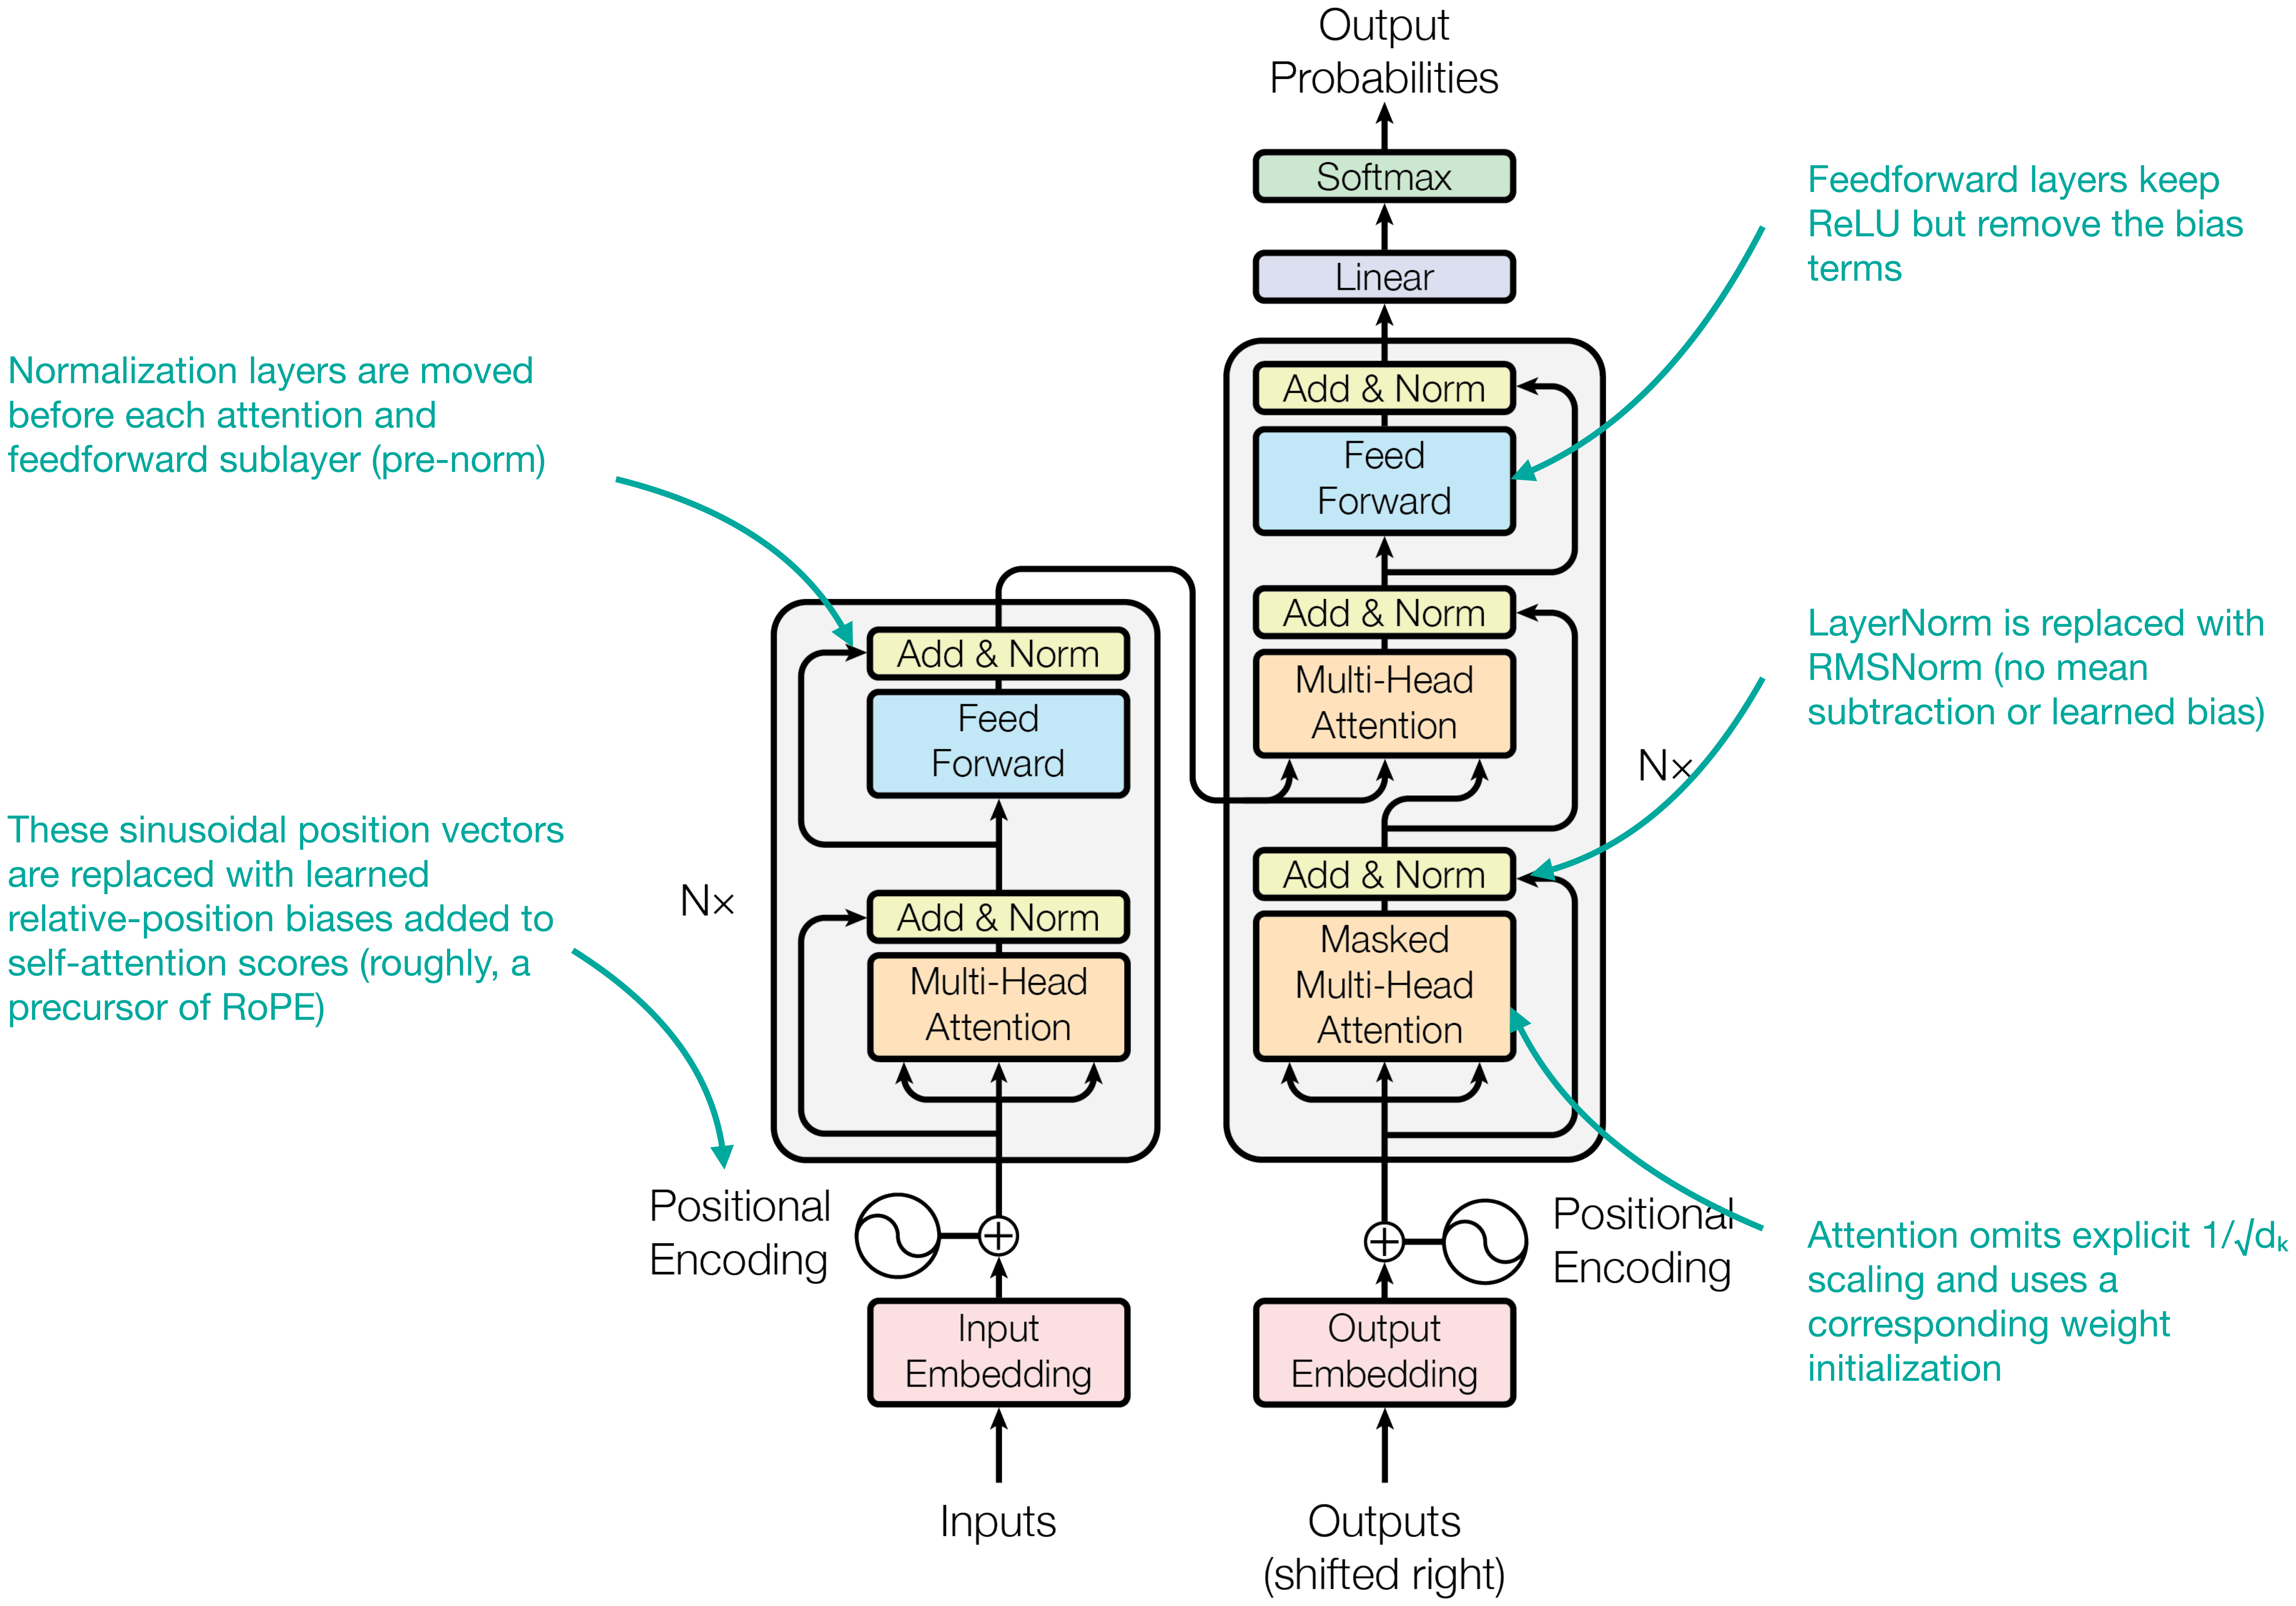
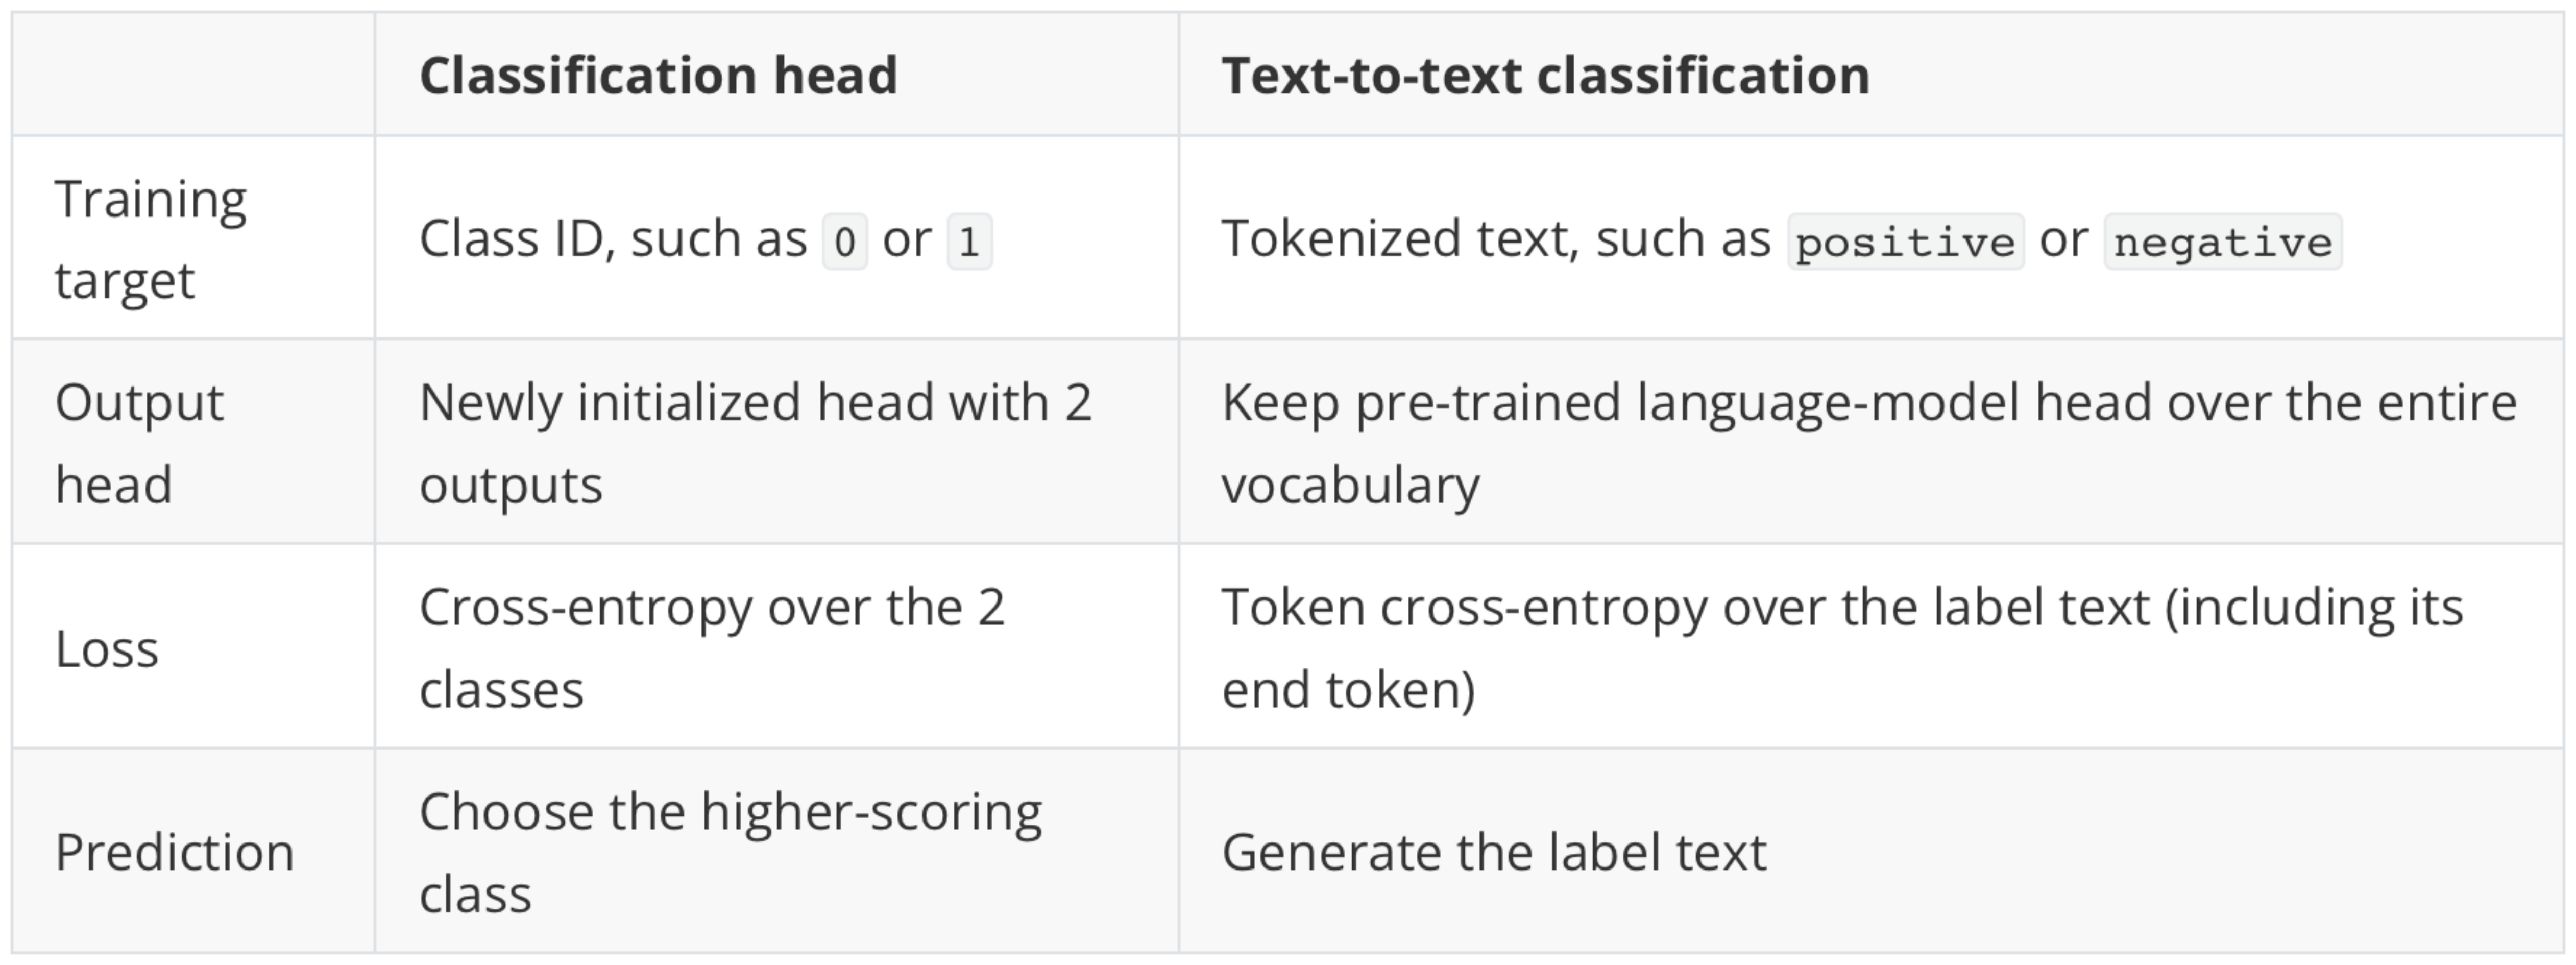
现在,我们可以像前面介绍的 RNN、CNN 和 Transformer 方法一样,为 T5 加上分类头(classification head)来使用它。
此外,我们也可以训练 decoder 直接输出类别标签预测(比如 IMDb 影评数据集中的"正面"或"负面"),就像普通 LLM 那样。我们不妨把这种方式称为 text-to-text 分类。
GPT 风格的 LLM 在海量文本上预训练,通常无需额外调整就能很好地完成 text-to-text 分类,前面已经展示过(为了方便,这里再次插入下图)。
而 T5 通常需要在目标领域上对 decoder 进一步微调,才能在这类任务上取得好效果。
对 T5 来说,两种方法都可行。总结如下:
3. Jev 简介
目前,文本分类的方法层出不穷。从基于词袋模型的传统方法(如逻辑回归、朴素贝叶斯),到对 GPT-6 等最新前沿 LLM 进行提示工程,再到为任意开源权重 LLM 添加分类头(或采用文本到文本分类),各种方案都有。
起初,我几乎将其视为“只是一个分类器”。这是我处理自然语言输入分类任务时经常构建的工具(近期公开示例可参见我的AI Detector 文章)。
3.1 Jev 与现有文本到文本分类
在深入之前,先简要介绍 Jev。Jev 是 TypeSafe AI 新发布的模型,几周前才结束隐身期,很快引起了广泛关注。最初它显得有点奇怪,因为它看起来只是一个普通的分类器。
Jev 是专有模型。尽管发布后迅速涌现了大量开源克隆版本(后文会详述),但 Jev 本身使用成本相对较低,并声称在决策能力上与 GPT-5.6 Luna 相当,速度却快几个数量级,成本也低得多:
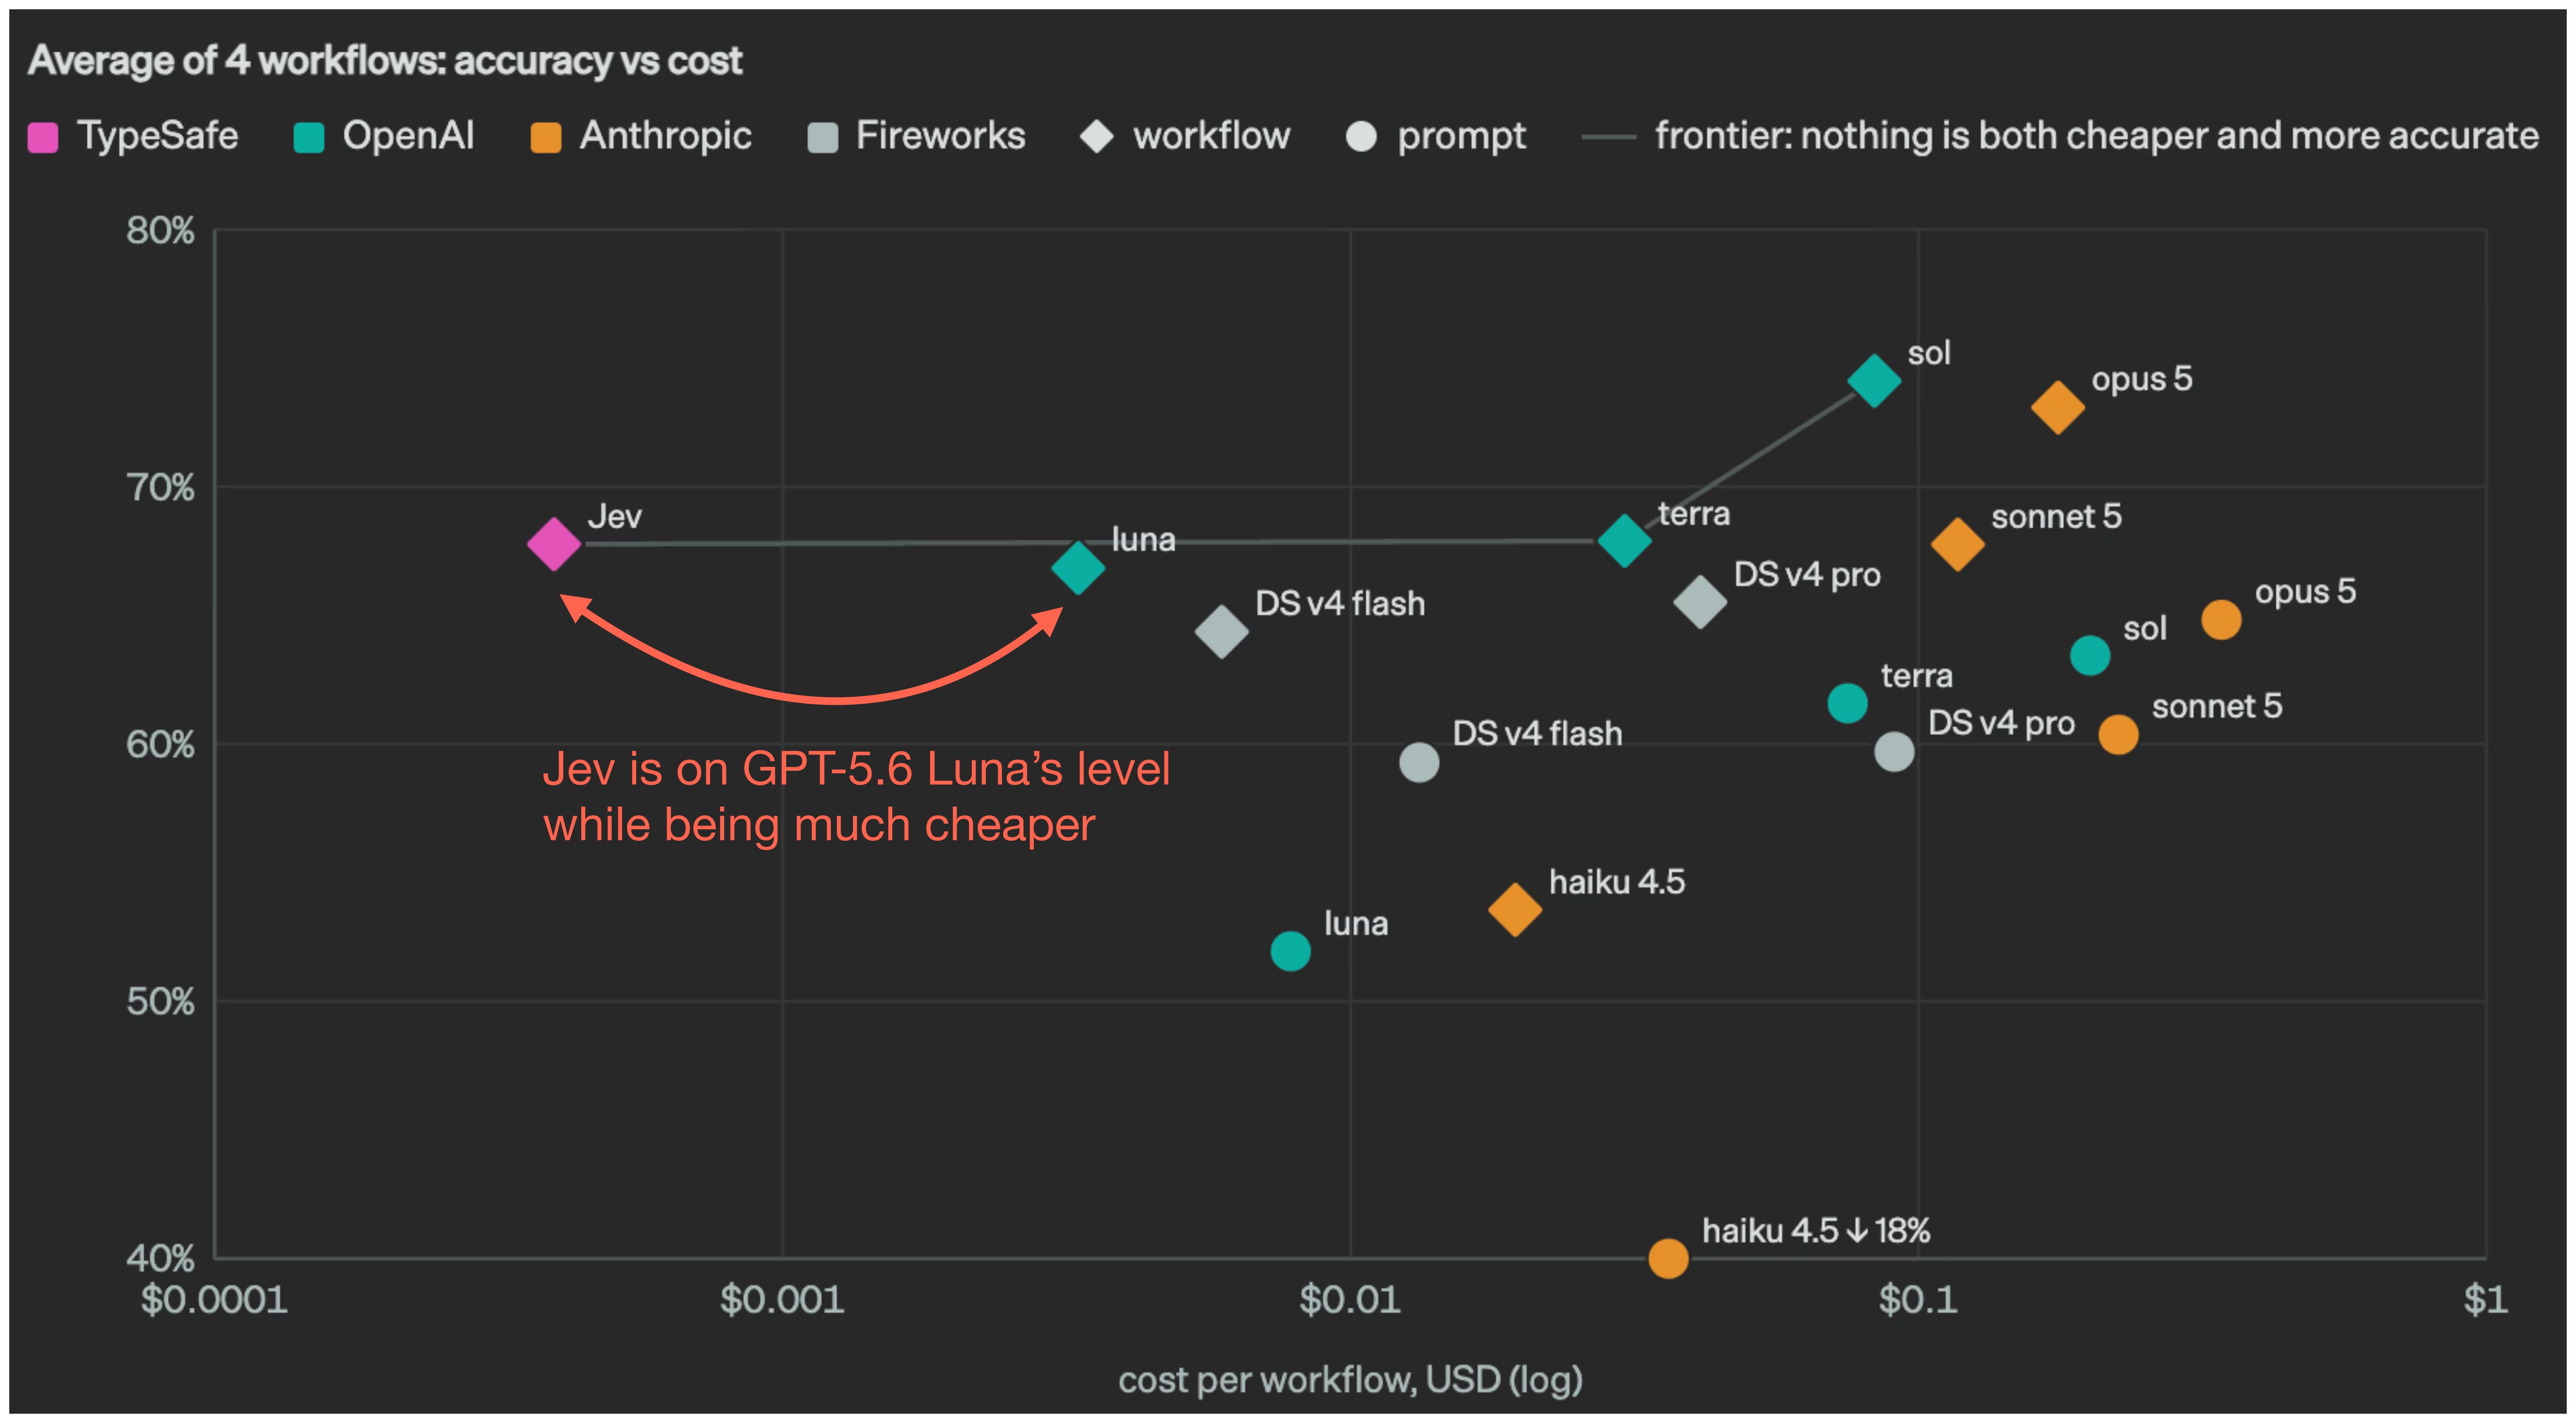
对于 GPT-Luna,可以将其理解为前文讨论过的文本到文本(text-to-text)分类方法。
那么,为何 Jev 如此备受追捧?我认为一部分原因是其接口友好,且在各类任务上表现优异,因此无需进行定制化微调。
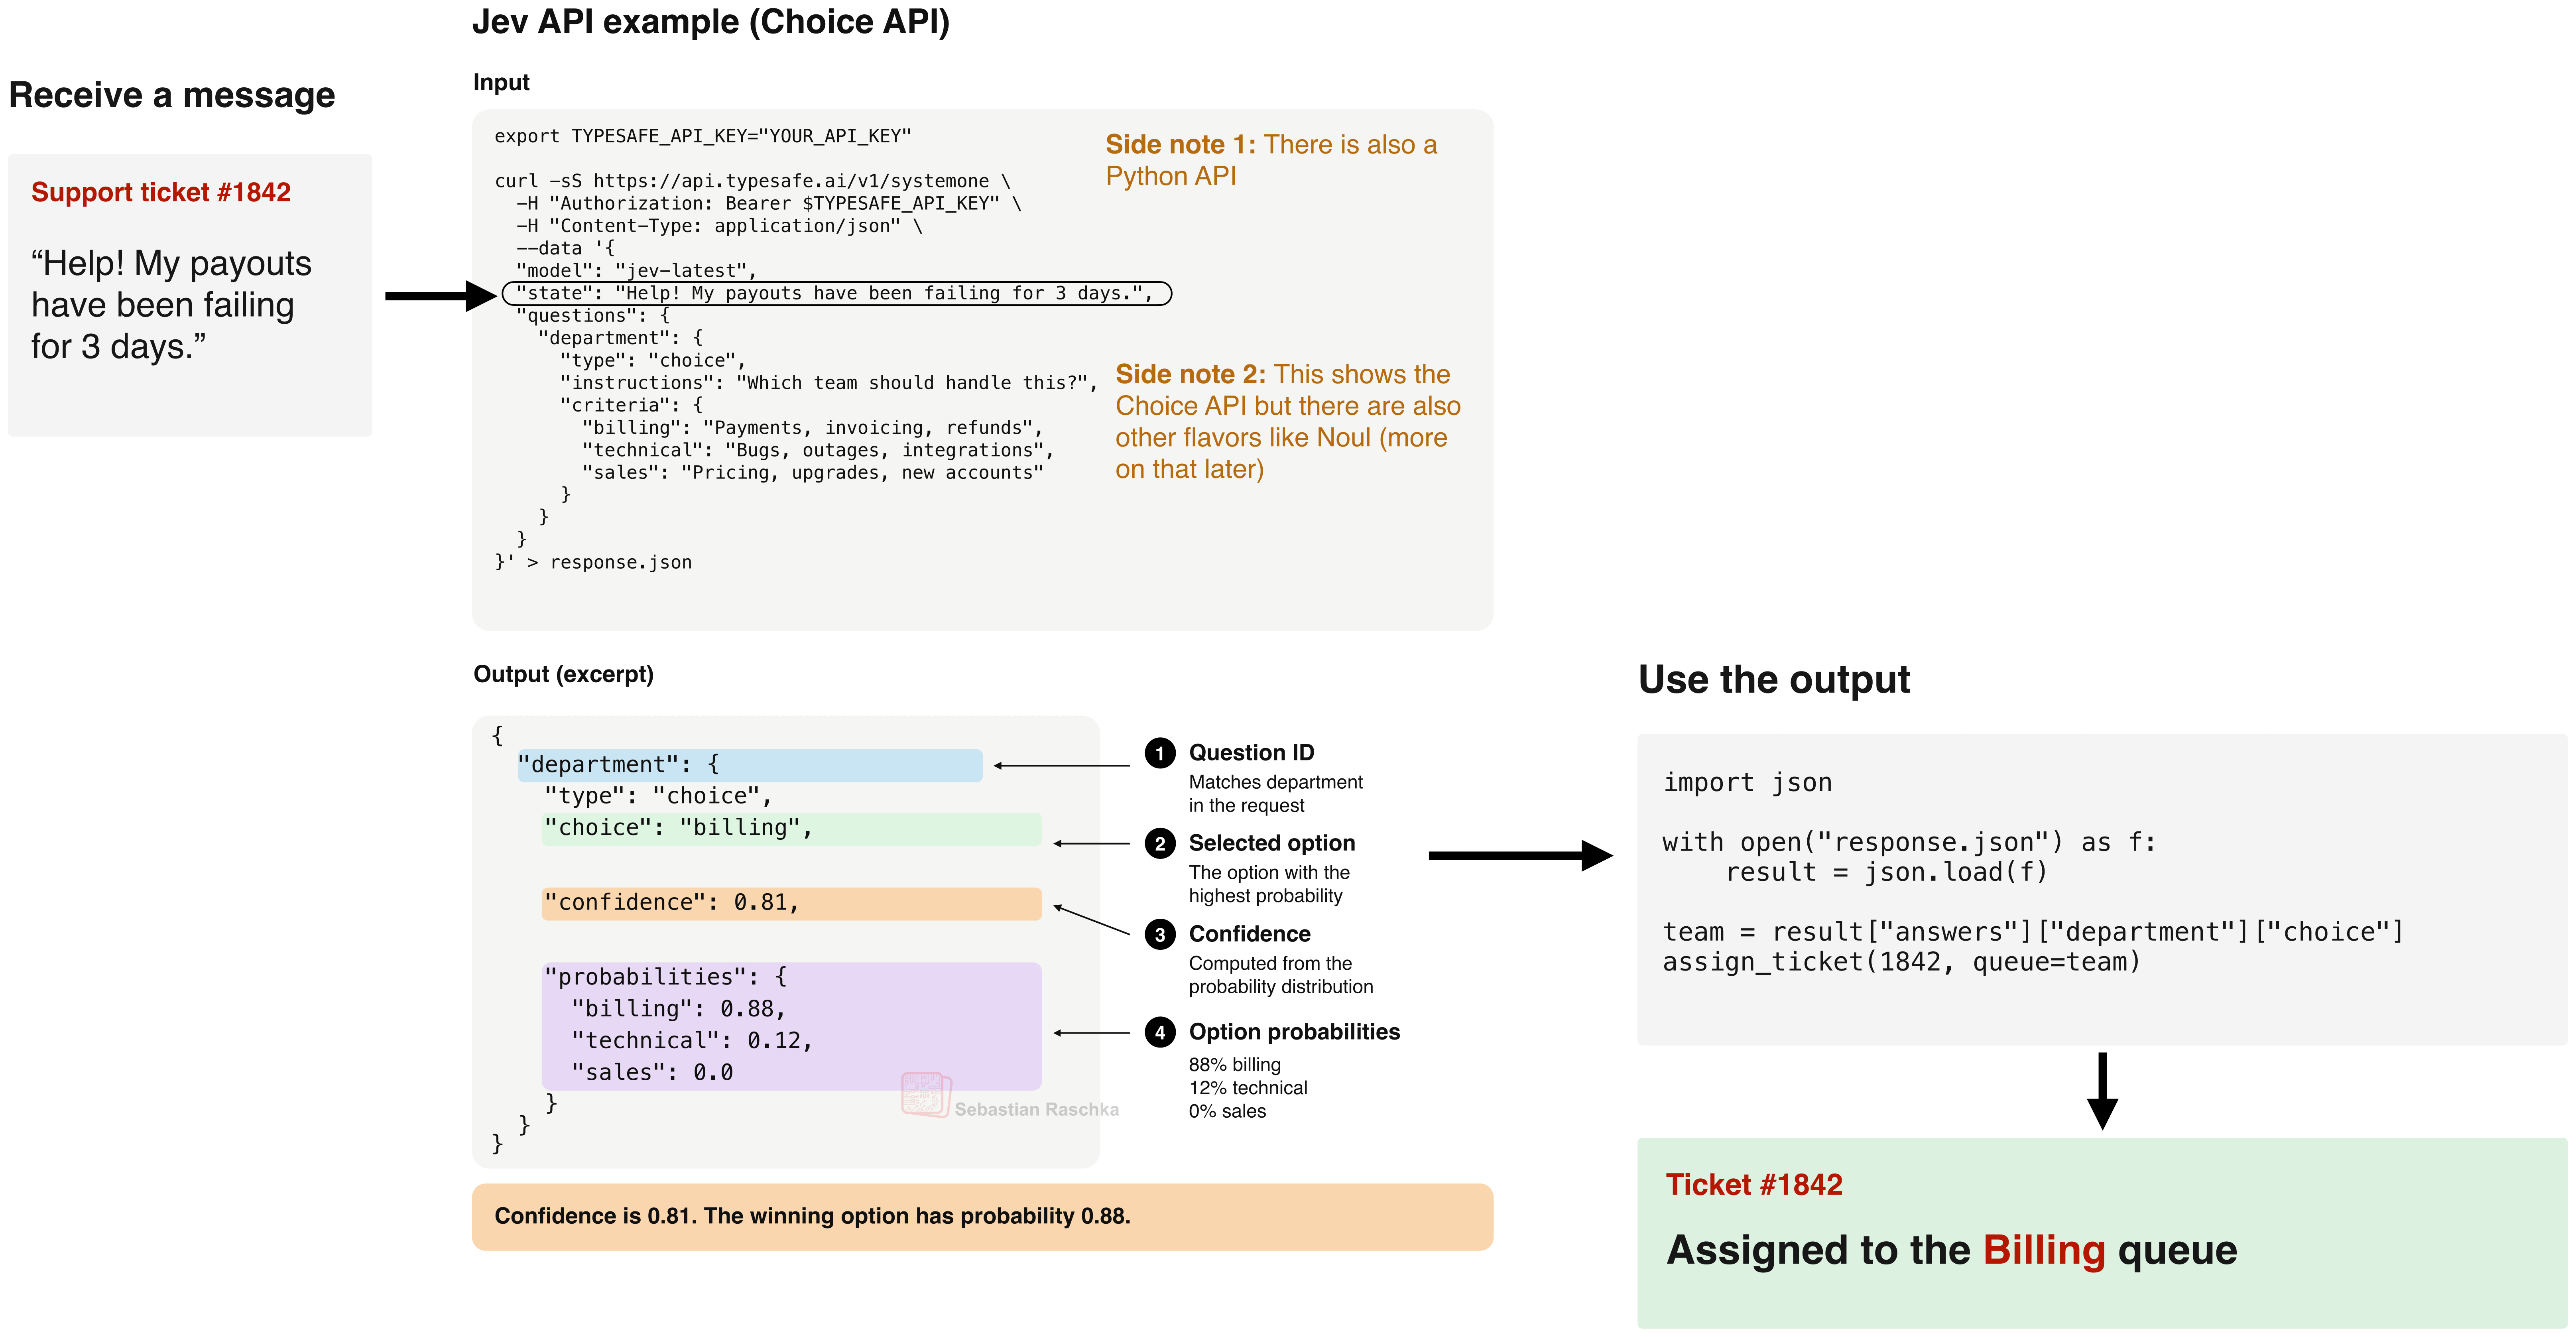
例如,我可以用它来自动分类客服工单或邮件(我特意录了视频来展示其响应速度):
或者,我可以让同一个模型实时玩俄罗斯方块(此处使用的是 Choice API):
如果要简明扼要地解释 Jev 为何令人兴奋(在深入技术细节之前),可以这样类比:正如 2022 年的 ChatGPT 因作为一个能生成各类文本的通用聊天模型而令人振奋,技术社区对 Jev 的兴趣也源于此——它是分类领域的 ChatGPT 时刻,无需为每个任务微调专用分类器,即可低成本地对各种文本输入进行分类。
(截至本文撰写,关于其架构和具体训练算法的信息尚不多见,仅有一位创始人提到其通过“面向校准决策的强化学习”(Reinforcement Learning for Calibrated Decisions)进行训练,稍后我会详细展开。)
3.2 Jev API
过去几年,我们习惯于使用更大、更强、更昂贵的 GPT 类 LLM 来解决各类问题。对于目标决策或分类任务而言,像 Jev 这样廉价且快速的方法或许会让大多数人耳目一新。特别是对于一次性任务,如果收集训练数据并微调定制的 ModernBERT 显得过于繁琐,我们可能只需调用一个类似 Luna 的模型即可。
除了因其通用性(即在各类目标领域上开箱即用,表现良好)而广受欢迎外,Jev 还提供了一个相对便捷的 API,我们可以使用终端中的 curl 命令或通过其 Python API 进行调用。
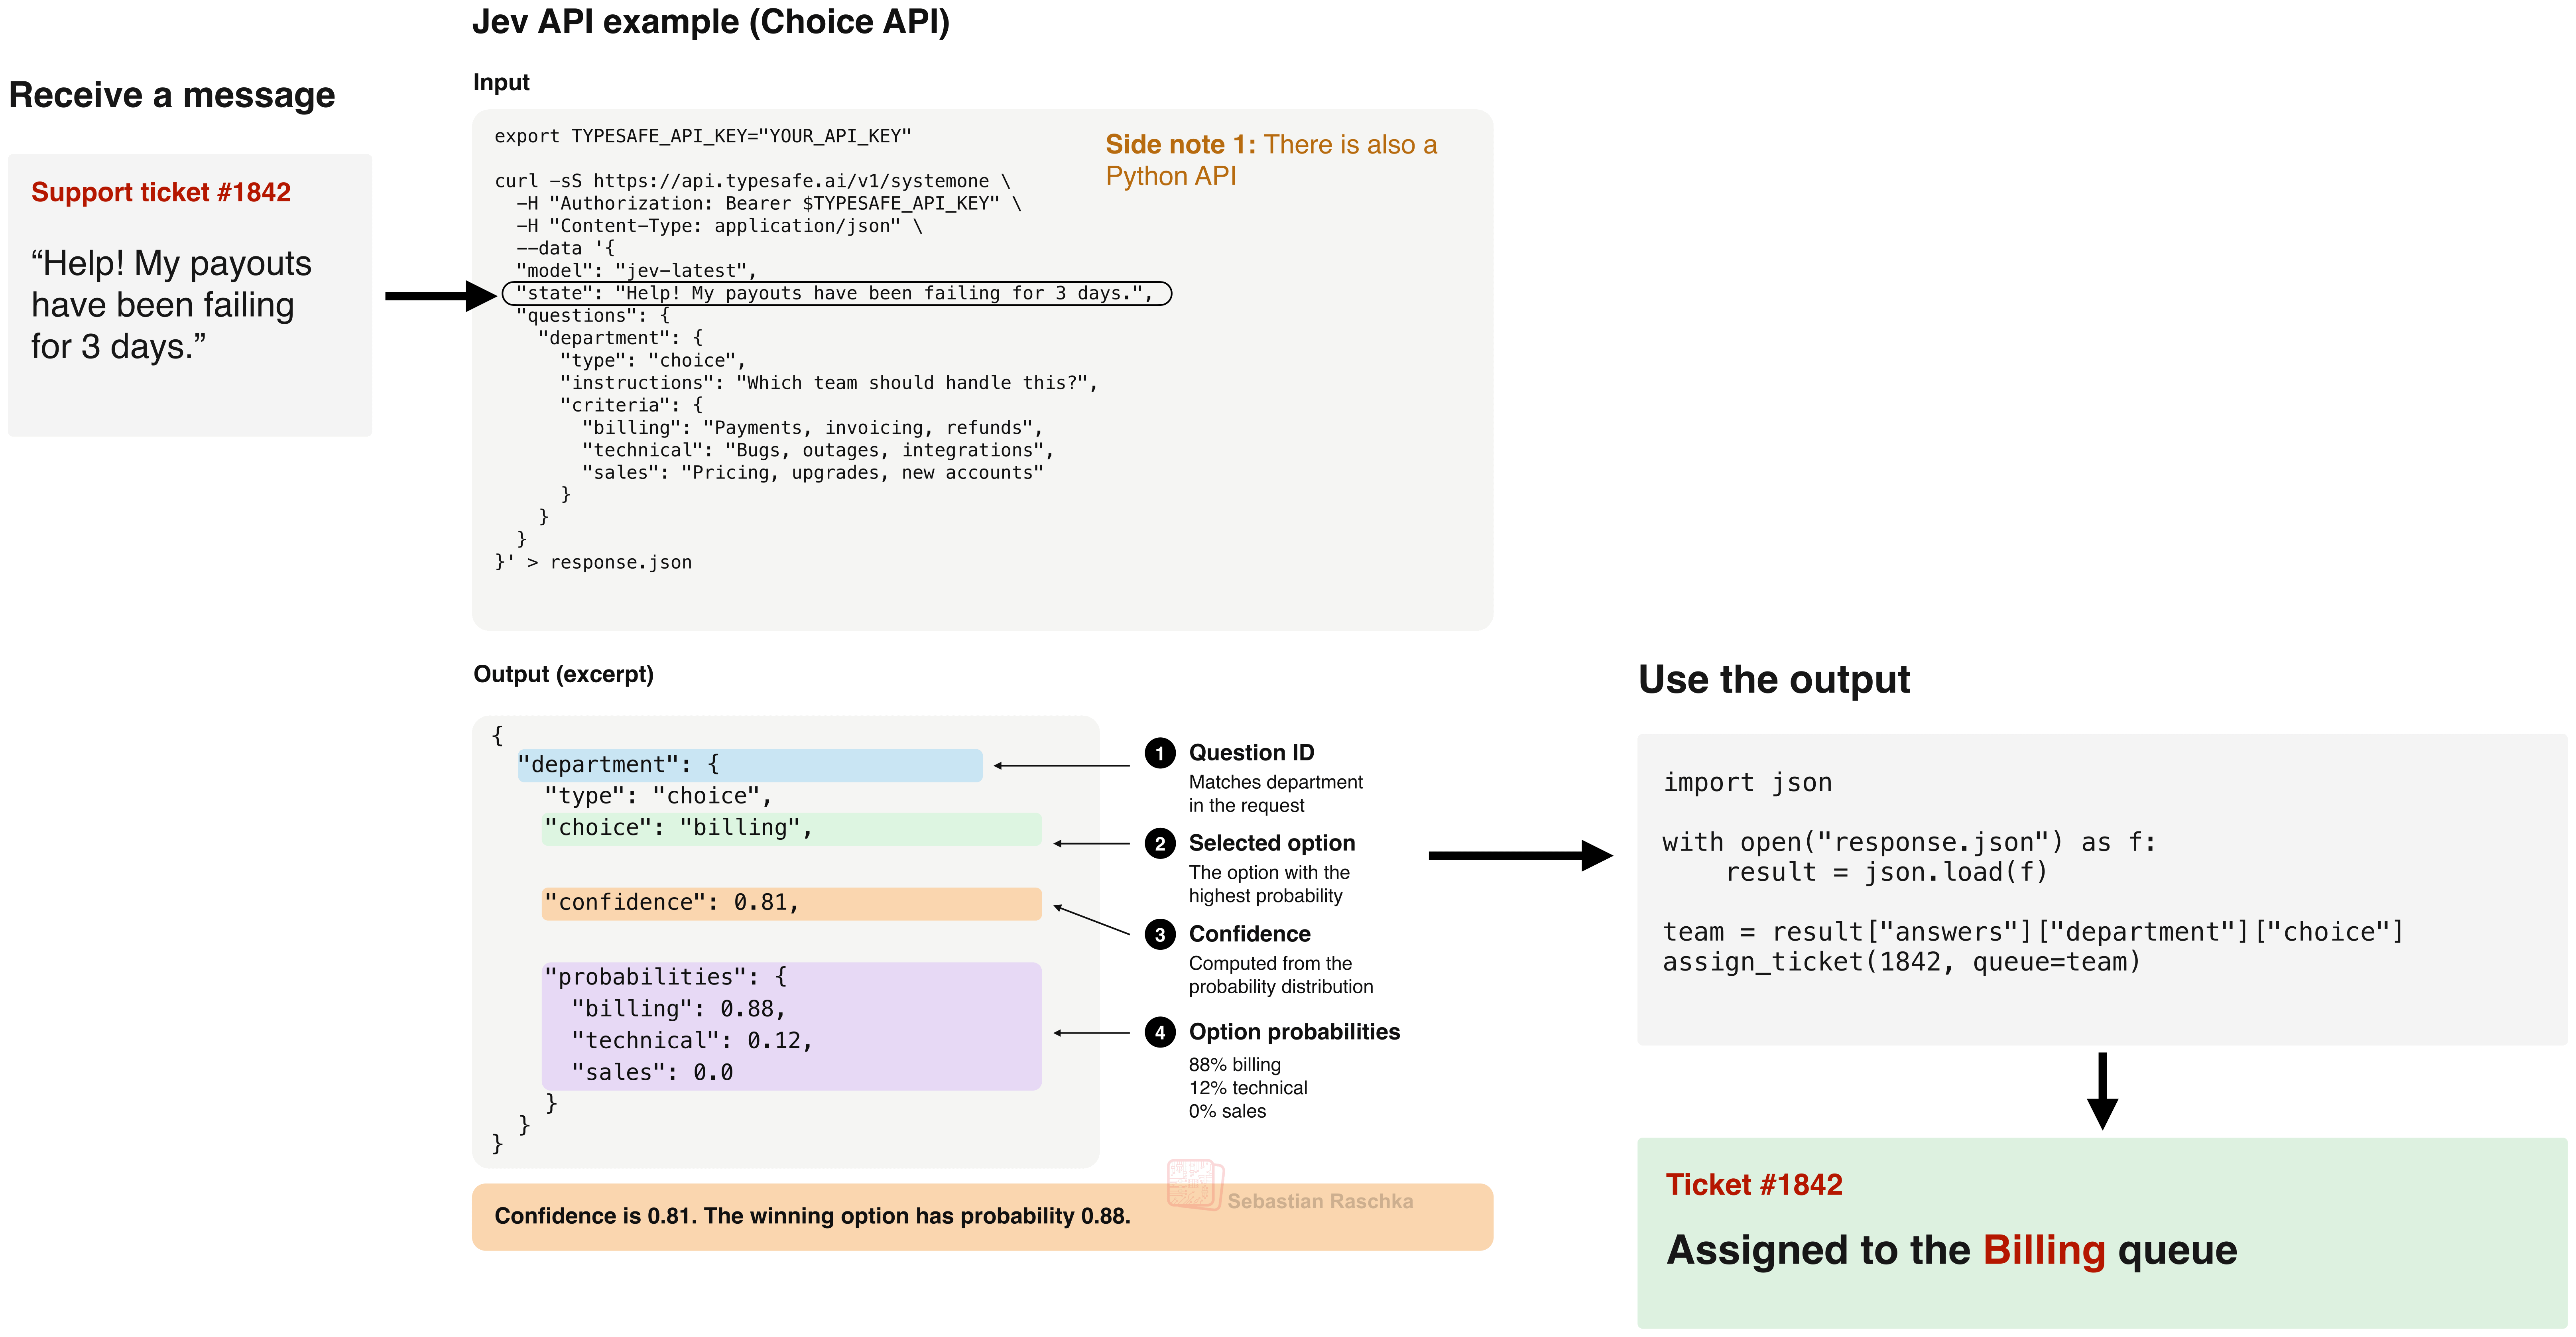
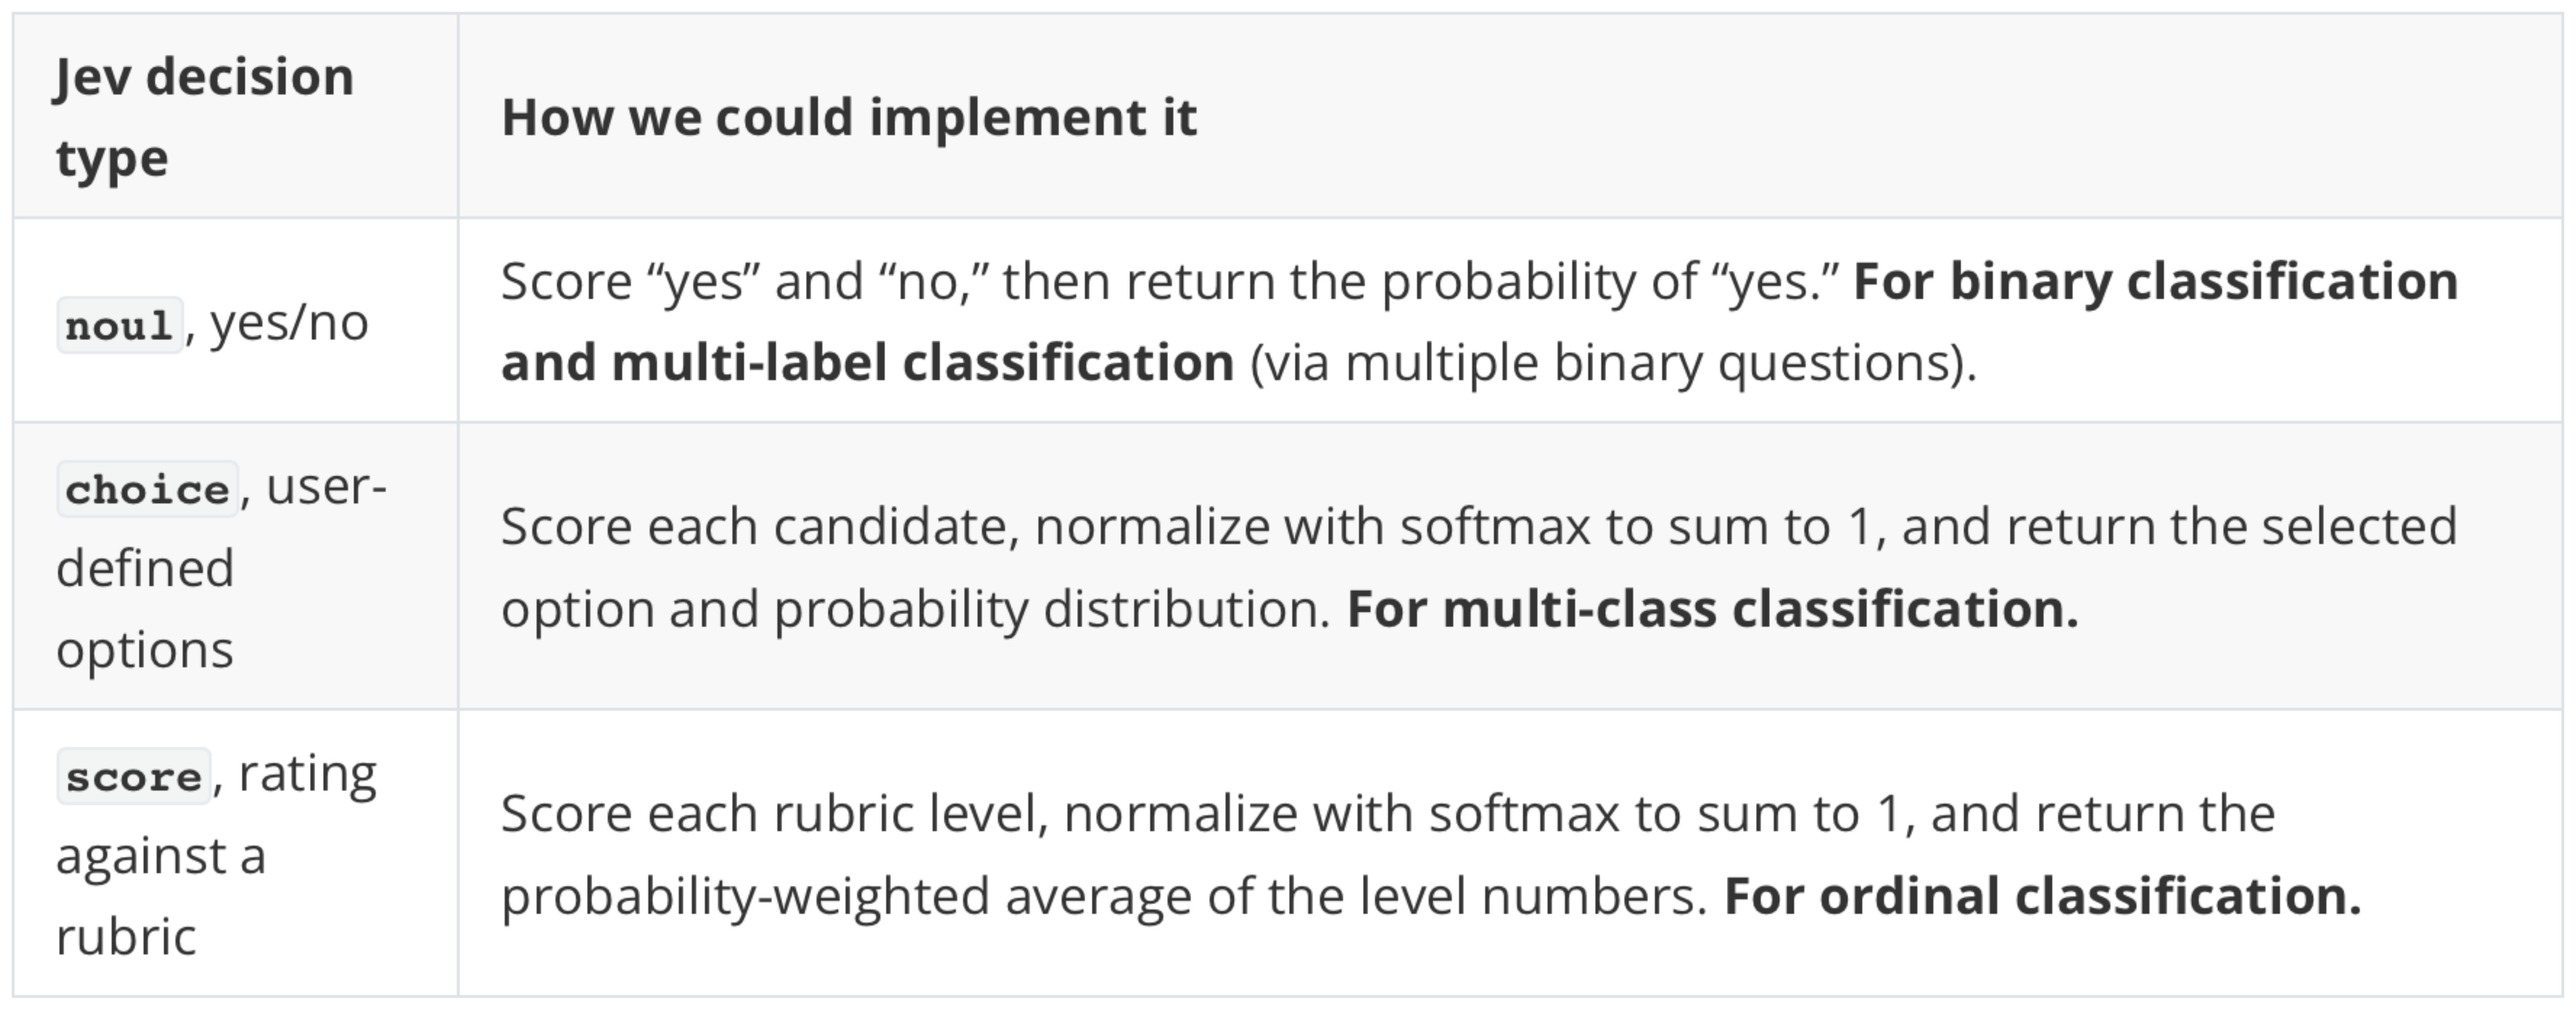
简单来说,主要有三种 API 类型,如下所示。先从 Choice API 讲起,它适合多分类任务。
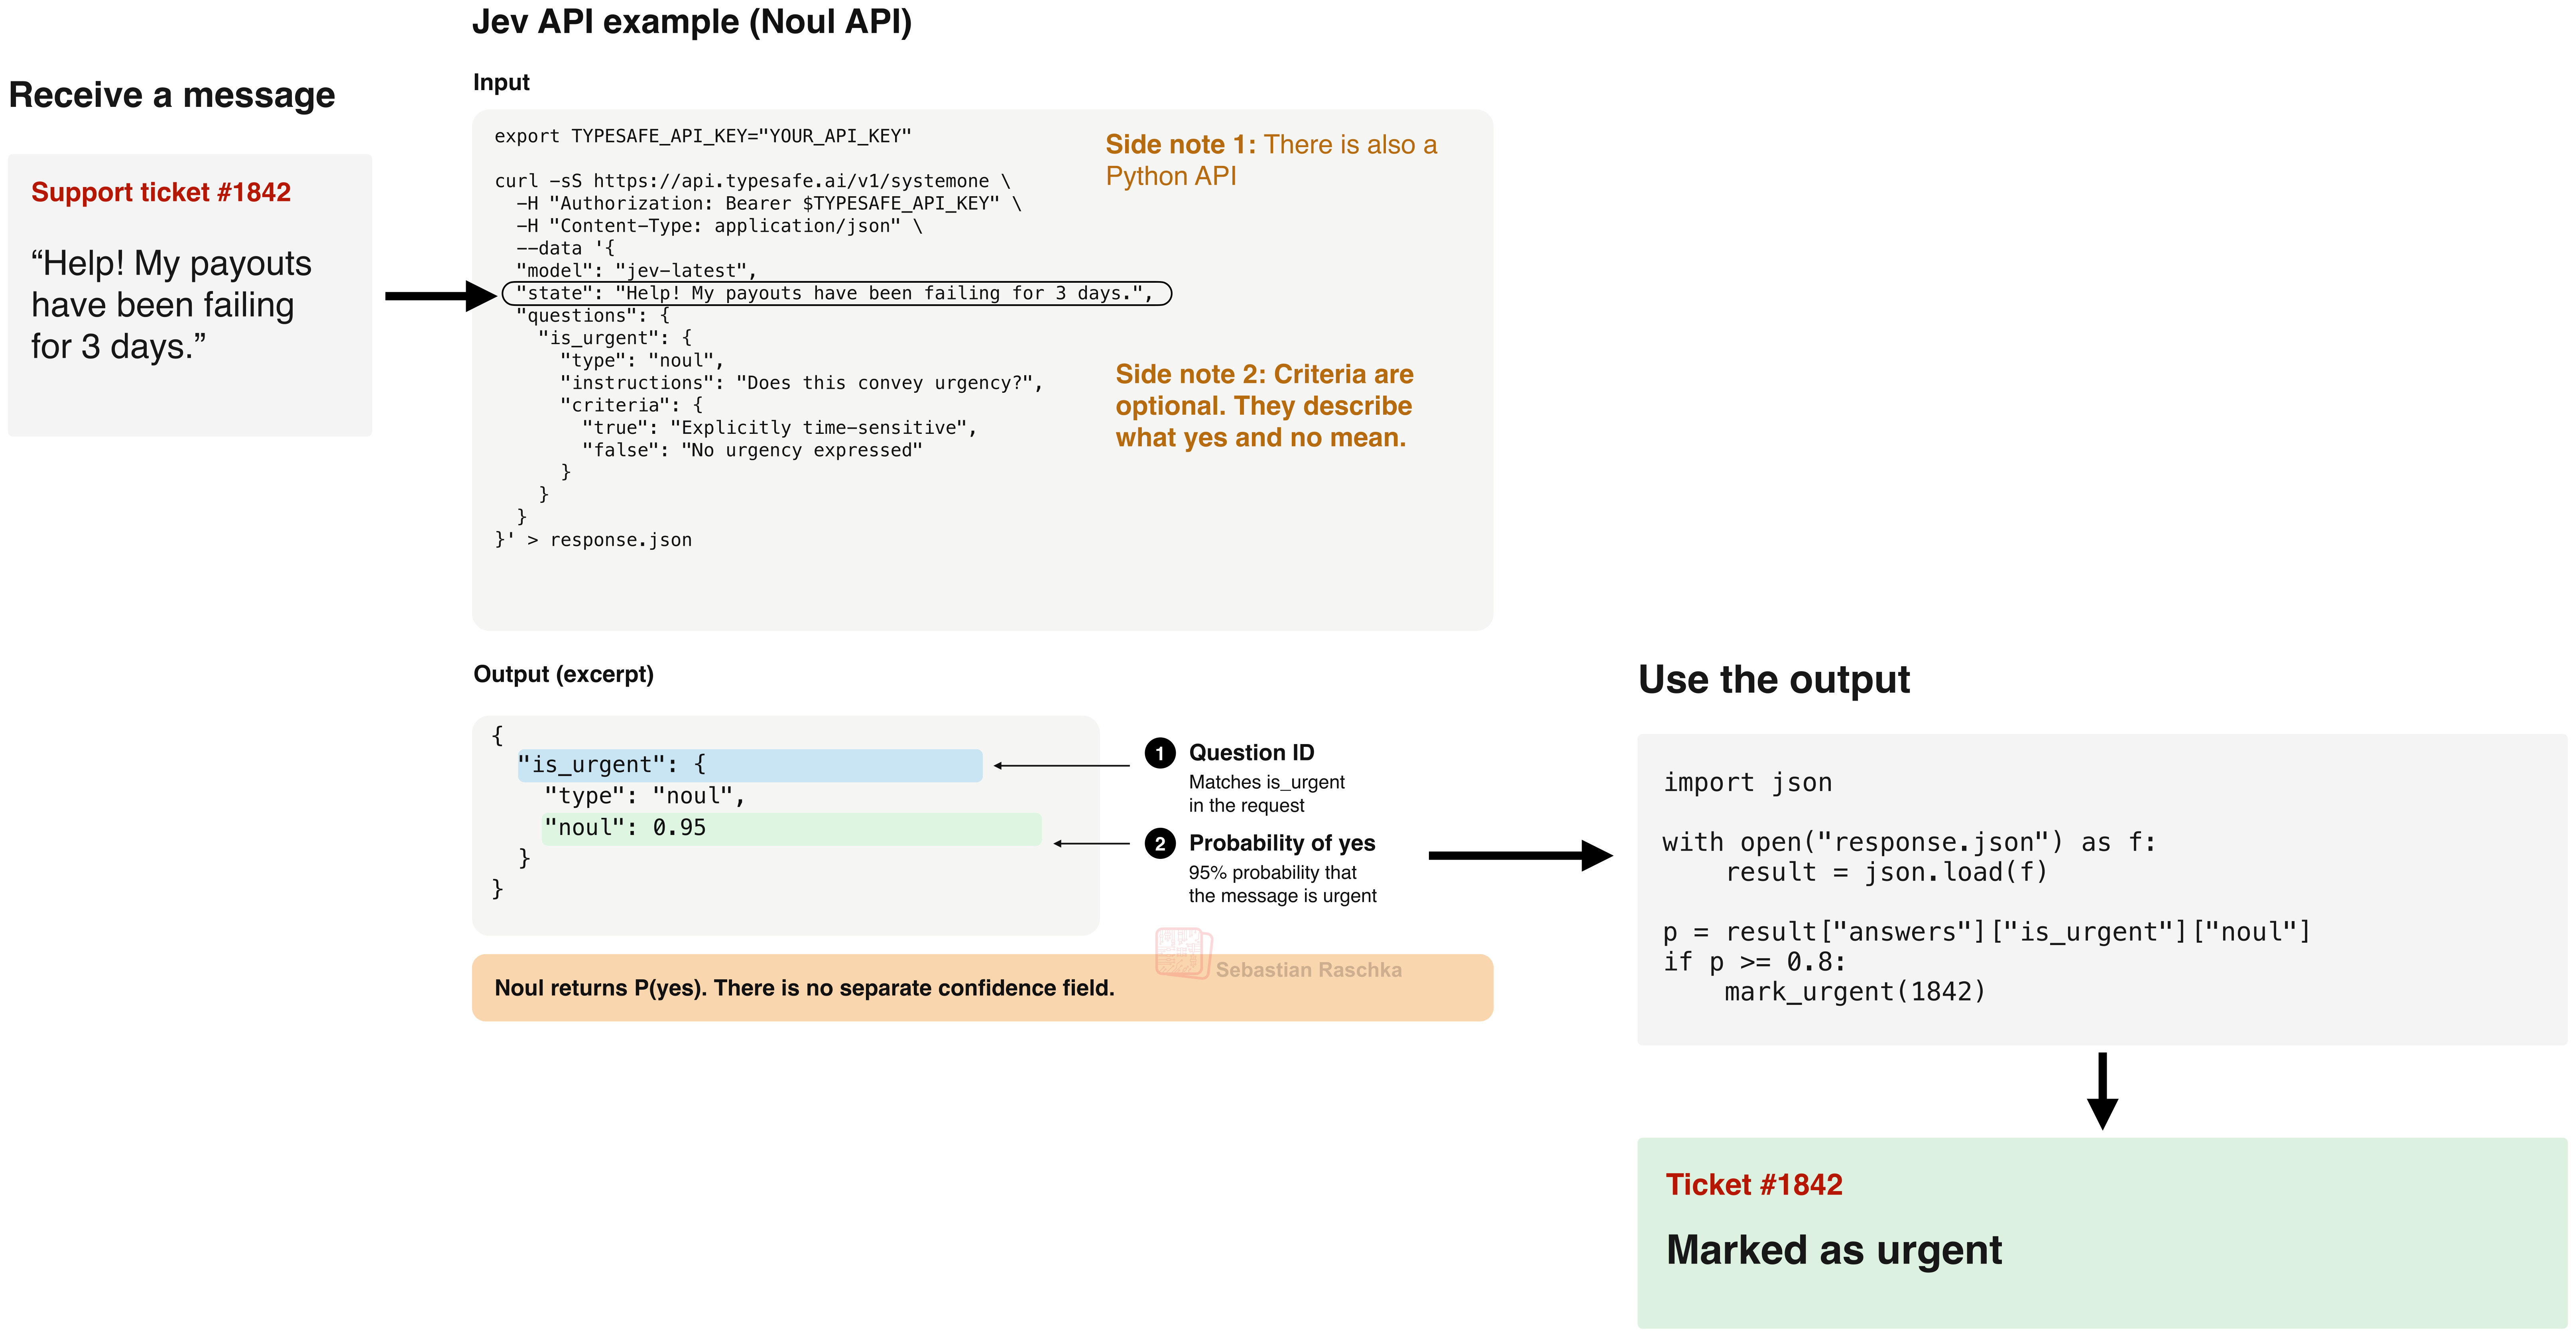
接下来是 Noul API,它更简单,只需为一个问题输出“是”的概率。
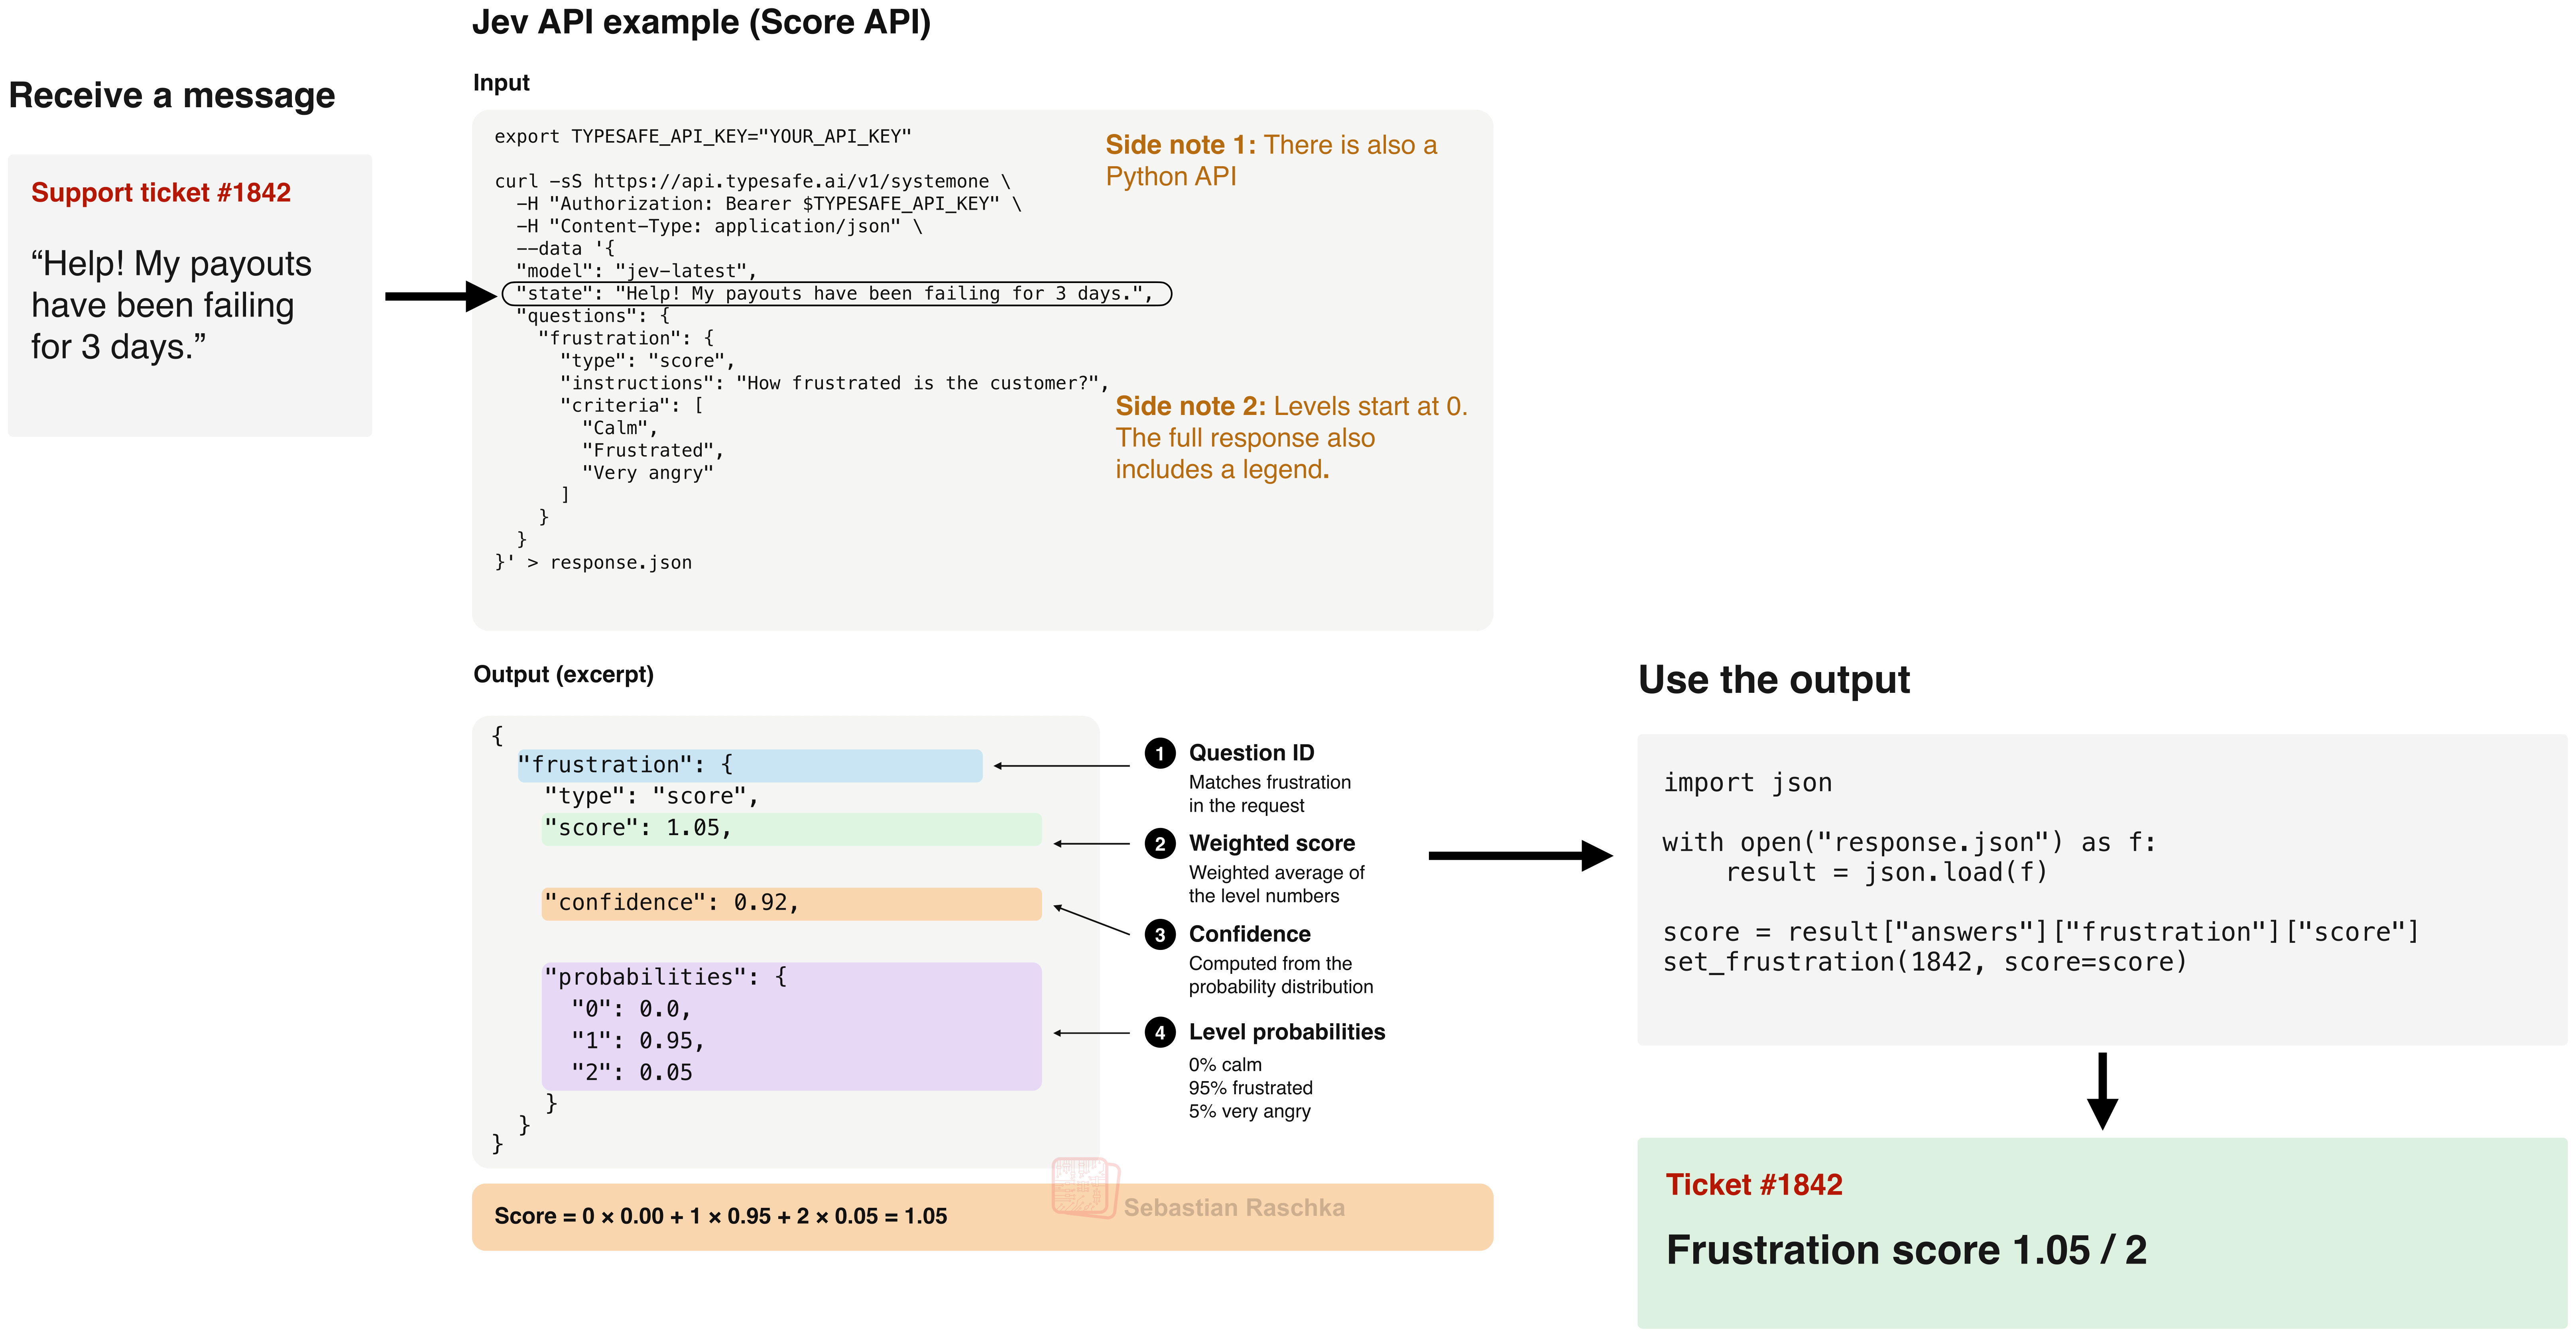
最后是 Score API,它按照评分等级(下例中为 0、1、2)打分。
总结一下,各种 API 及其适用场景如下。
3.3 使用 Jev 对 IMDb 进行分类
为了让这些 API 更具体,并解答 Jev 在 IMDb 数据集上的表现如何,我们可以使用 Choice 或 Noul API 进行运行。
首先来看 Choice API。每条评论会按如下格式组织:
export TYPESAFE_API_KEY="YOUR_API_KEY"

curl -sS https://api.typesafe.ai/v1/systemone \
  -H "Authorization: Bearer $TYPESAFE_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "jev-1.13.0",
    "state": "The acting was excellent and the story kept me engaged throughout. I would happily watch this movie again.",
    "questions": {
      "sentiment": {
        "type": "choice",
        "instructions": "What is the overall sentiment of this movie review?",
        "criteria": {
          "negative": "An overall unfavorable opinion of the movie",
          "positive": "An overall favorable opinion of the movie"
        }
      }
    }
  }'
当我们希望使用显式标签来处理二分类(此处)或多分类问题时,Choice API 非常便捷。
实际的响应可能如下所示:
{
  "model": "jev-1.13.0",
  "answers": {
    "sentiment": {
      "type": "choice",
      "choice": "positive",
      "confidence": 1.0,
      "probabilities": {
        "negative": 0.0,
        "positive": 1.0
      }
    }
  },
  "usage": {
    "input_tokens": 342,
    "output_tokens": 32
  }
}curl -sS https://api.typesafe.ai/v1/systemone \
-H "Authorization: Bearer $TYPESAFE_API_KEY" \
-H "Content-Type: application/json" \
-d '{
"model": "jev-1.13.0",
"state": "The acting was excellent and the story kept me engaged throughout. I would happily watch this movie again.",
"questions": {
"is_positive": {
"type": "noul",
"instructions": "Does this review express an overall positive opinion of the movie?",
"criteria": {
"true": "An overall favorable opinion of the movie",
"false": "An overall unfavorable opinion of the movie"
}
}
}
}'{
"model": "jev-1.13.0",
"answers": {
"is_positive": {
"type": "noul",
"noul": 0.98
}
},
"usage": {
"input_tokens": 328,
"output_tokens": 21
}
}“这篇文章是关于金融的吗?”
“这篇文章是关于政治的吗?”
“这篇文章是关于科技的吗?”
Choice:
准确率 96.47%(24,117 条正确)
总运行时间:22 分 24 秒
15,456,663 输入 tokens,总成本 $0.6492
Noul:
准确率 96.20%(24,050 条正确)
总运行时间:23 分 3 秒
15,106,663 输入 tokens,总成本 $0.6345
需要注意的是,Choice 和 Noul 之间在性能和运行时间上的微小差异可能只是随机波动,因为和其他 LLM 一样,这些运行结果并非完全确定性的。
比如,我把 Choice API 在同一个测试集上又跑了一遍,结果就略有不同,如下图所示。
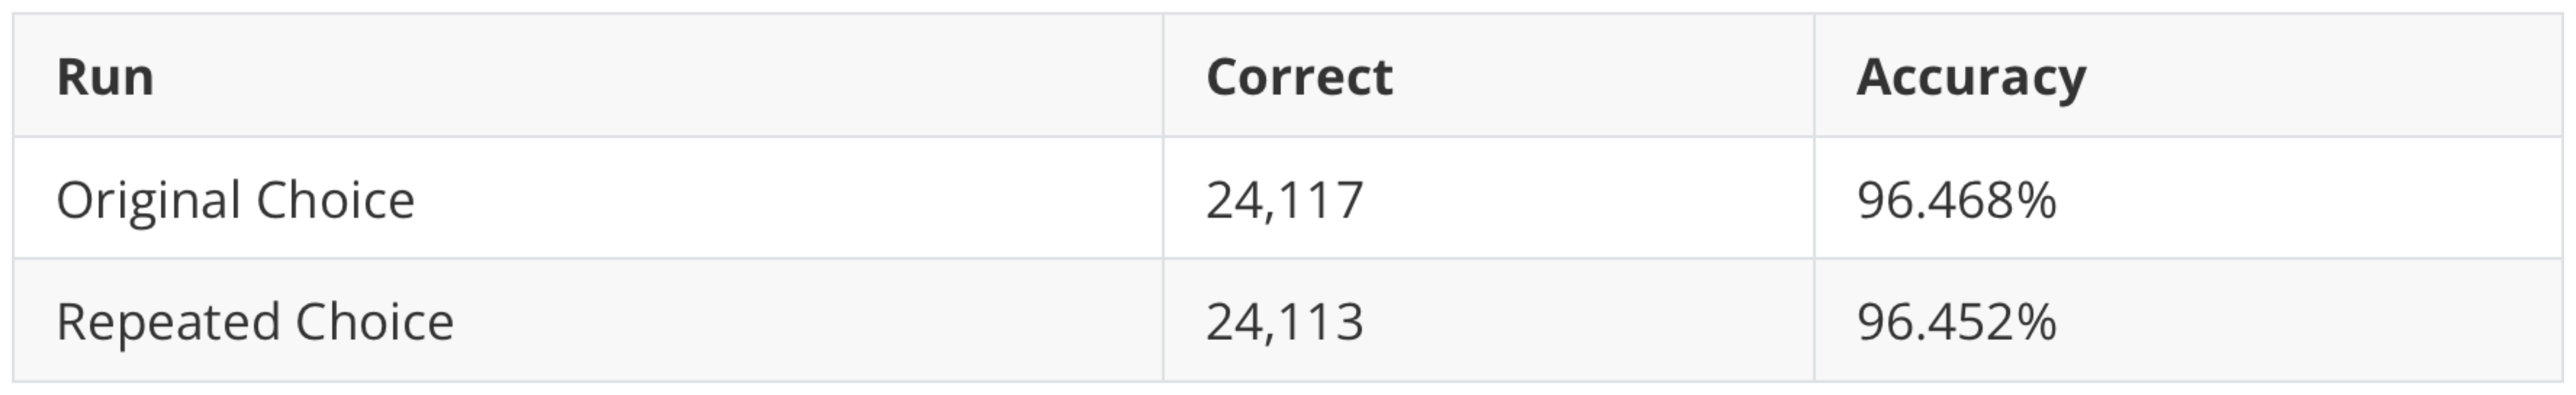
(在大规模部署 LLM 及其他模型时出现的这种非确定性,很可能是因为 GPU kernel 的执行依赖于 batch,导致浮点运算的顺序发生变化,Horace He 去年的一篇博客文章对此有很好的阐述。)
不管怎样,整体结果相当不错(提醒一下:我们并不知道 IMDb 测试集是否包含在训练集中)。
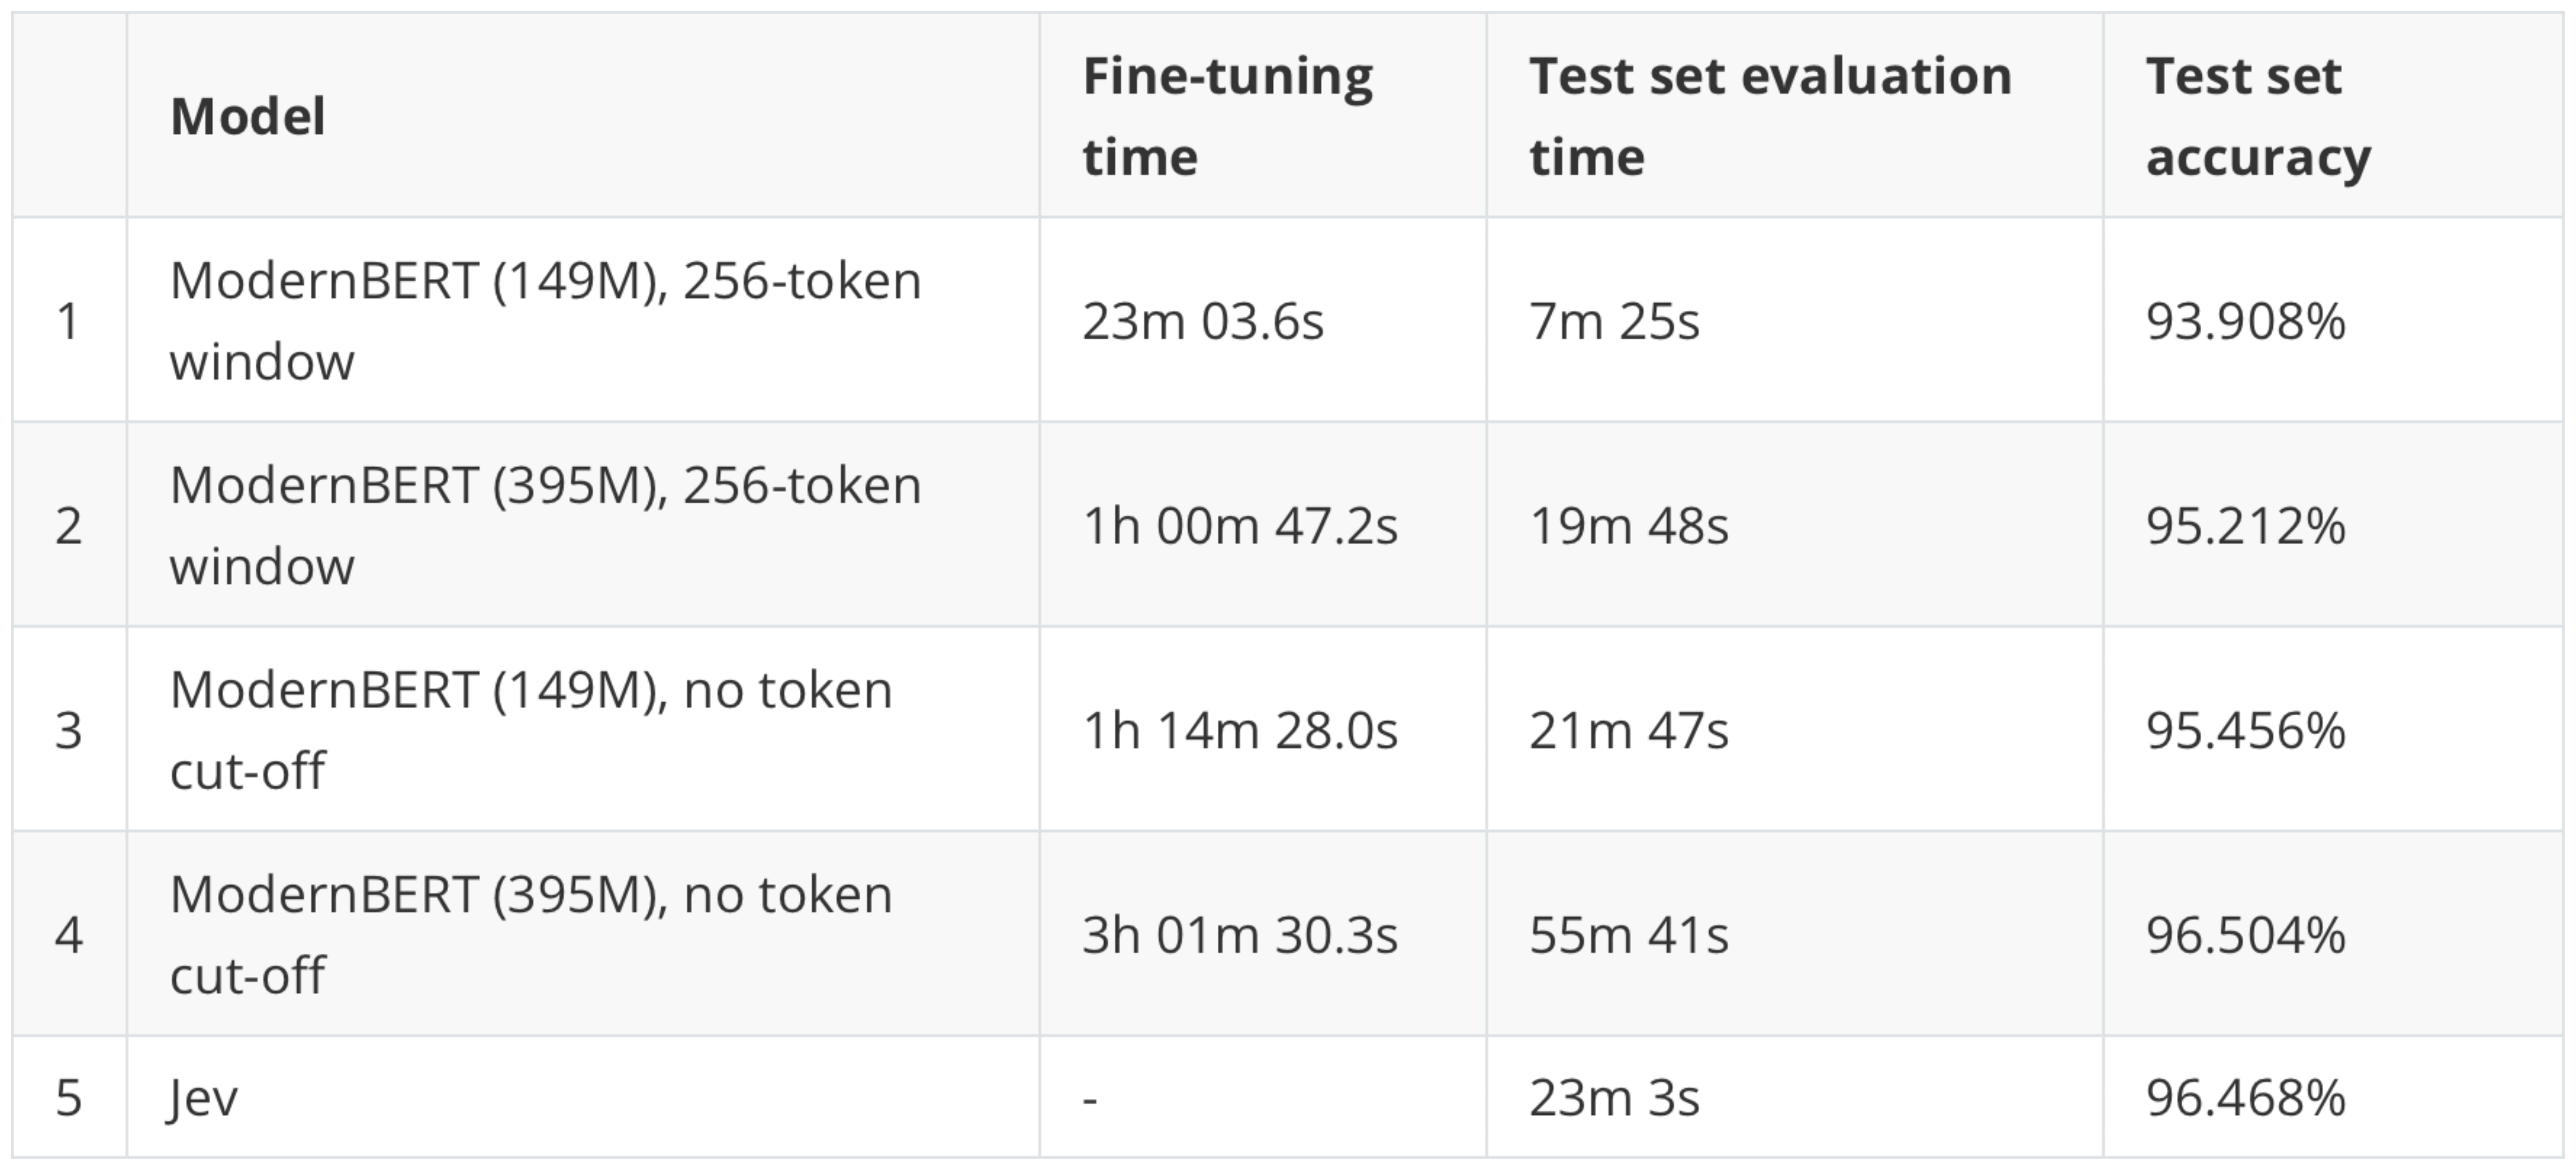
作为参考,一个 ModernBERT 模型需要:
23 分钟在训练集上微调;
7 分钟在测试集上评估。
对比来看,表现最好的 ModernBERT 模型准确率相近,如下图所示(我认为通过额外的超参数调优,还能再提升 1-2% 的准确率)。需要注意的是,这是在 DGX Spark 上跑的,通过量化和更快的硬件还有可能获得更快的推理速度。
例如,我们的 ModernBERT 模型不会玩俄罗斯方块,也做不了电影分类以外的事——除非我们为它在新任务上做微调。不过,我们可以直接丢一个 GPT-5.6 Luna 或 GPT-6 Luna 模型过去处理(这些模型稍慢一些,成本也更高)。
过去常有一条经验法则:
一次性决策任务,用便宜的大语言模型(比如 GPT-6 Luna);
需要反复执行的任务,微调一个专用分类器。
现在,像 Jev 这样的模型可以替代上述做法:a) 相比 Luna 能降低延迟、省钱;b) 省去微调自定义模型的工作。(当然,如果是高吞吐量、且对特定任务的速度和精度要求极高,微调仍然是合理选择。)
4. 带 Jev API 的 BERT 和 GPT 风格模型
当然,我们也可以给(Modern)BERT 或任意 GPT 风格模型加上 Jev 式的 API。这其实很直接。事实上,Jev 发布后,我就构建了一个 Jev 风格的 ModernBERT 模型,展示自建 Jev 模型有多简单。
最终我决定不发布我的 Jev 克隆,因为想法变了:给 ModernBERT 套一层 Jev 式 API 很容易,在若干分类任务上做微调也不难,但要让模型在各类不同任务(比如俄罗斯方块)上表现良好,却需要大量的训练与测试,并非易事。(另外,趁着热点蹭热度做的 Jev 克隆已经够多了;世界不需要再来一个快速克隆,但一个强大的开放权重版本当然更好。)
当然,如果你好奇这种改造具体如何实现,这里简要介绍一下。举例来说,我们可以在任意 BERT、GPT 或 T5 类模型上添加一个轻量级分类头,从而实现类似 Jev 的 Choice API,正如前文所示。与让分类头的输出节点数量与类别数一致不同,我们将该头简化为仅包含 1 个输出节点,如下图中修改后的 GPT 模型所示。
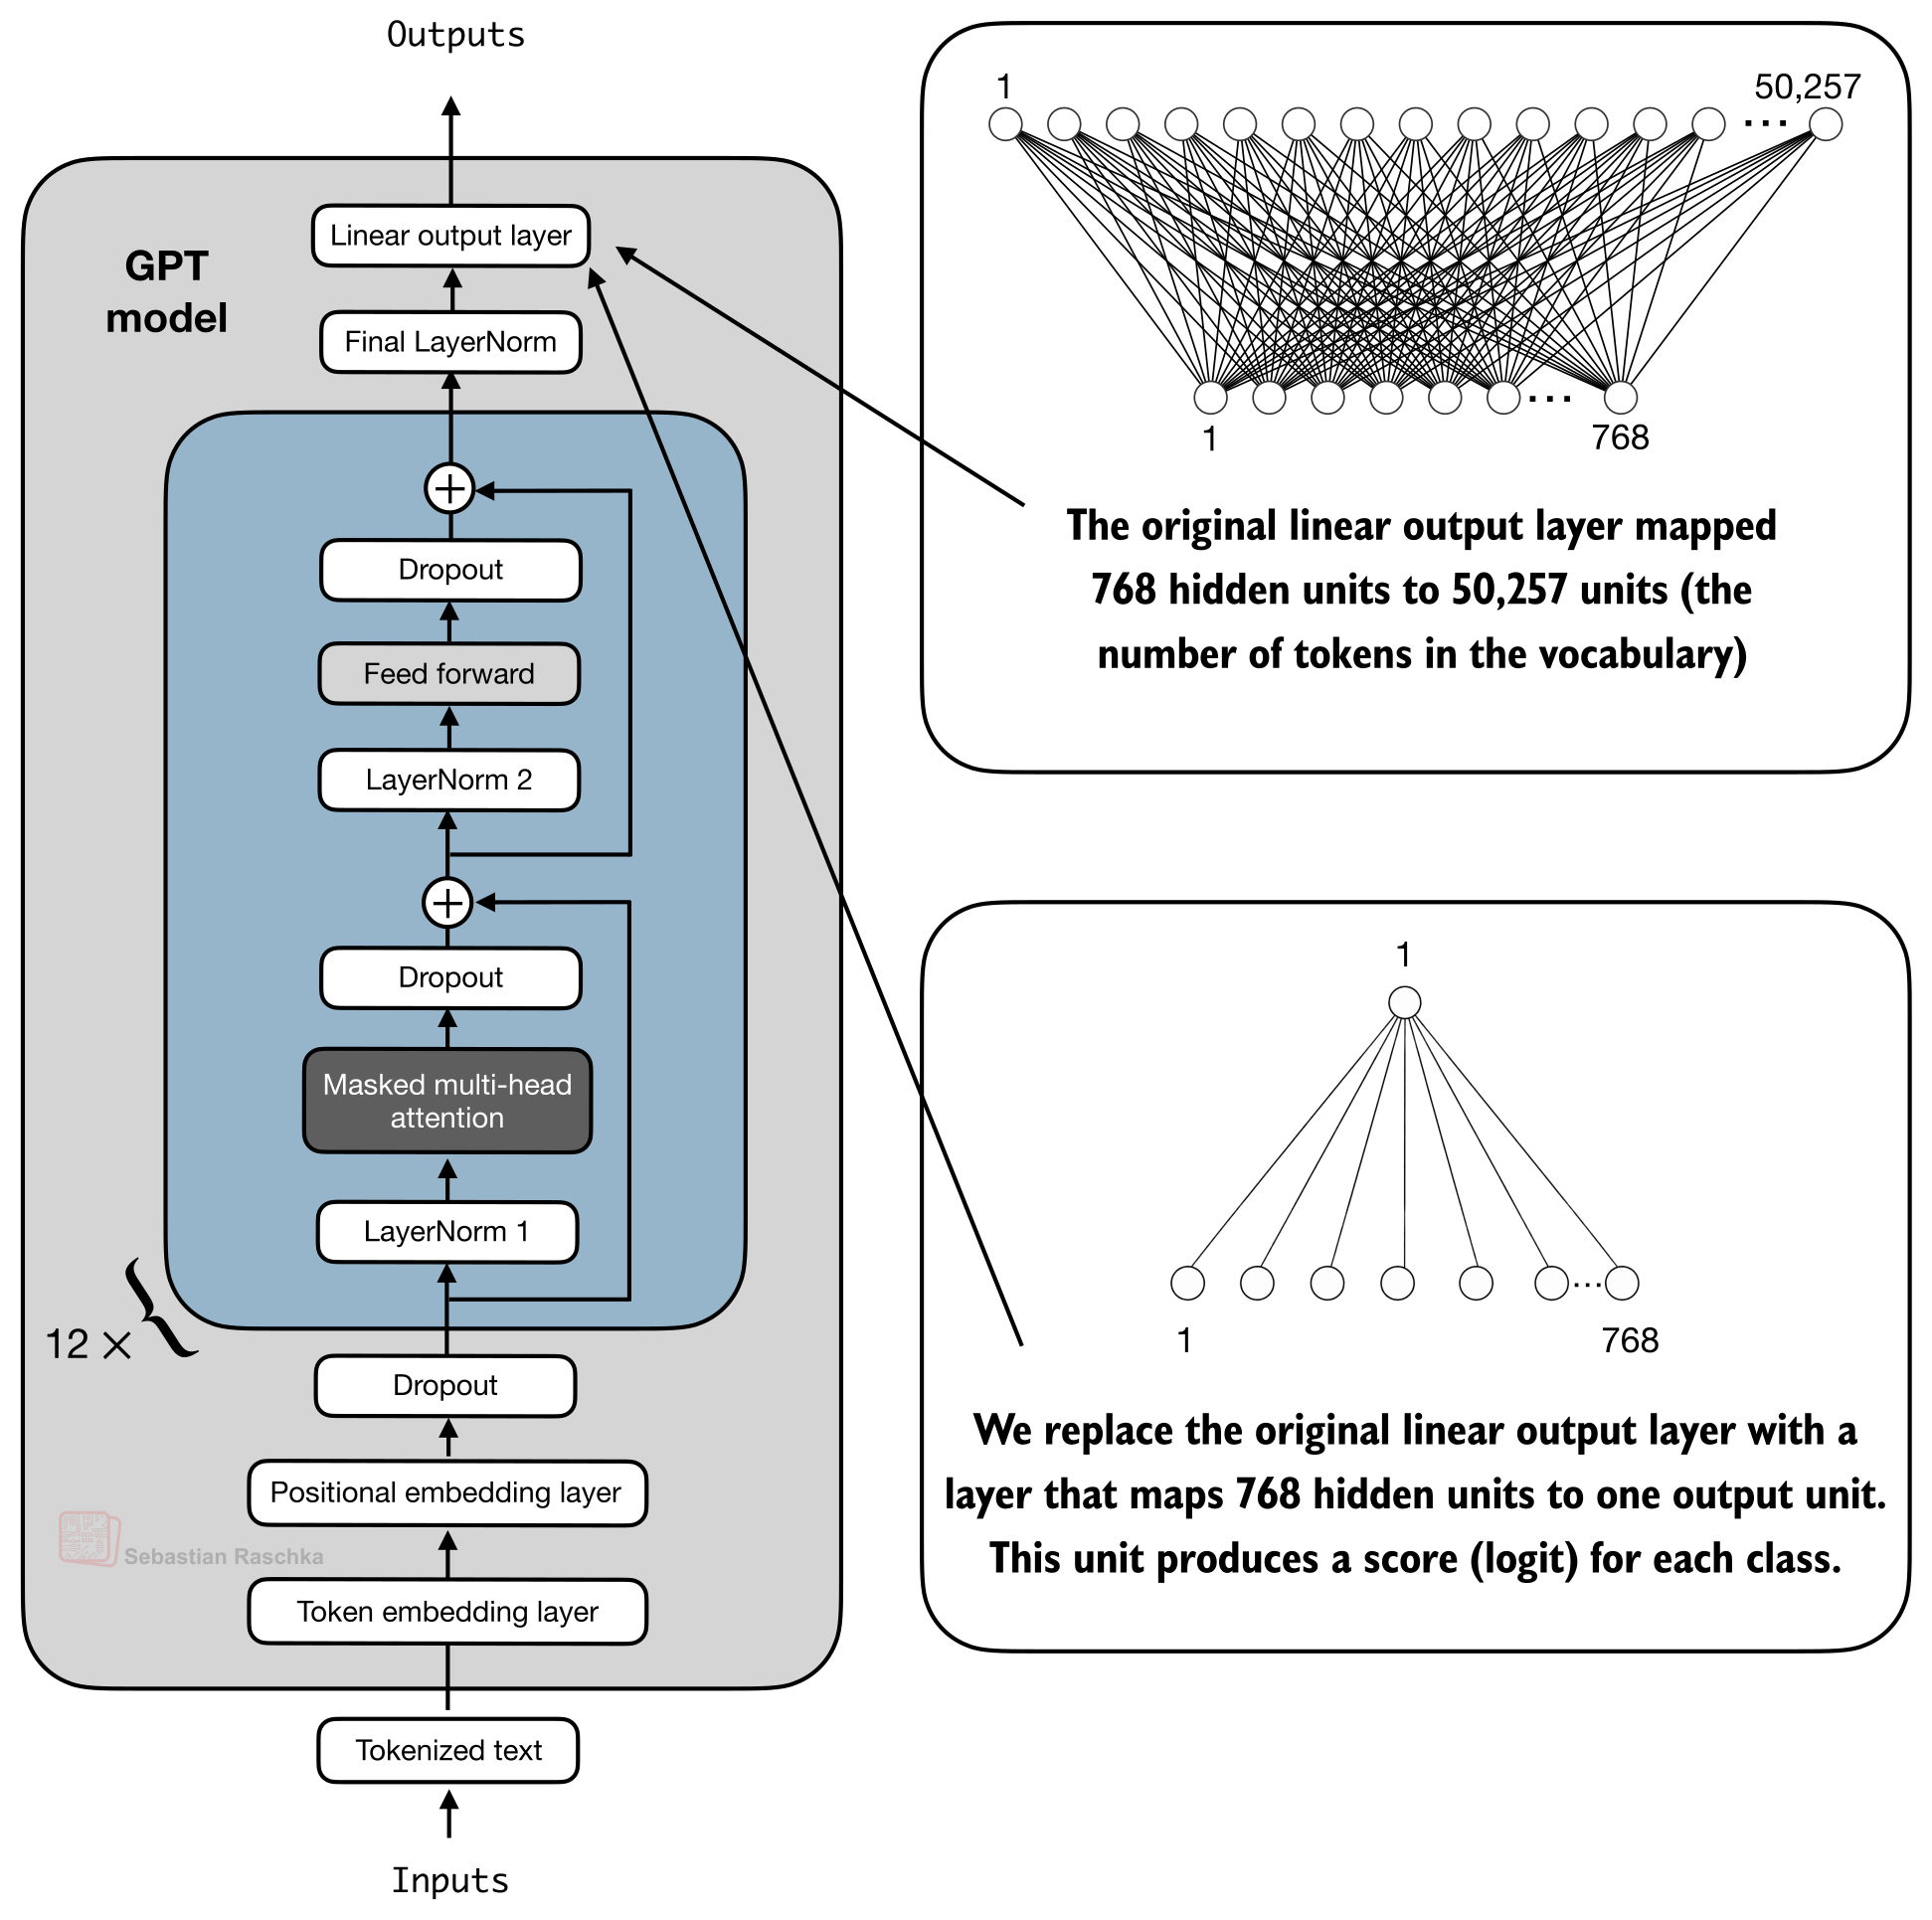
此前,我们讨论了如何针对特定任务(如使用预定义标签“正面”和“负面”的电影评论分类)对这些模型进行微调。而通过这种“单输出节点”架构,我们可以将其扩展至支持灵活且任意数量的类别。
要将其扩展至任意数量的类别(例如将客户工单归类为“账单”、“技术”、“账户”这三个类别的三分类场景),具体做法如下方图示。
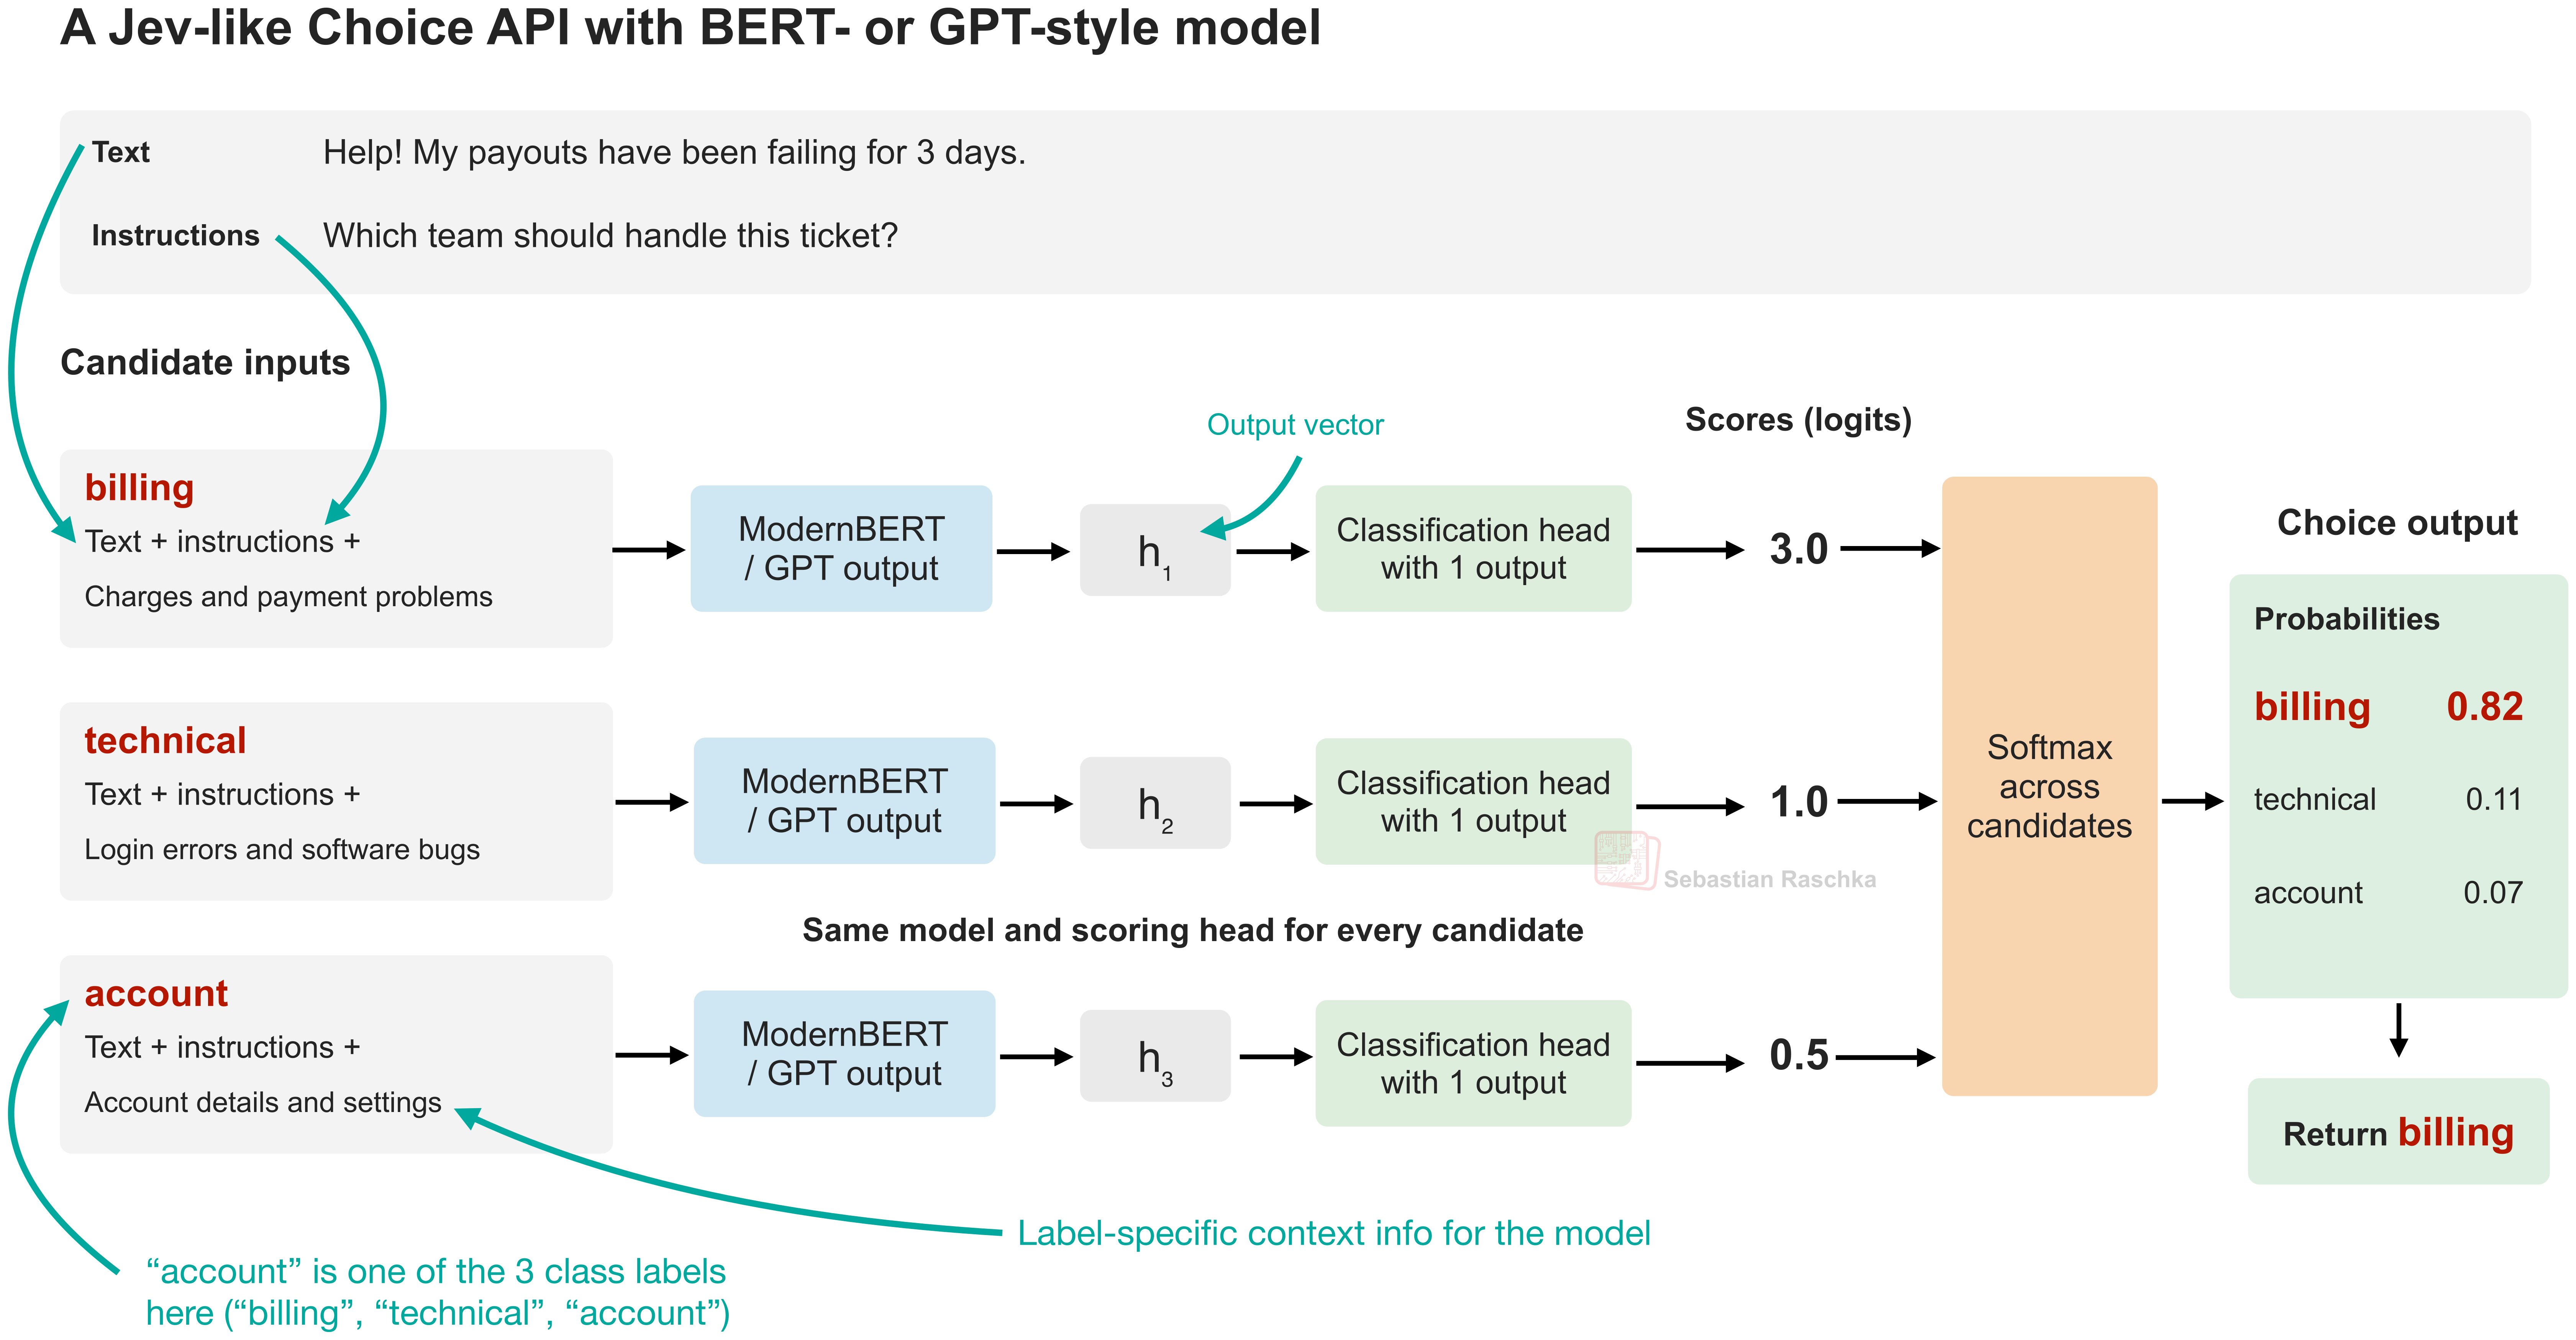
如图所示,对于每个候选项,我们把输入文本、任务说明和候选描述一起喂给模型。分类(打分)头将输出表示映射为一个标量分数。随后对所有候选分数做 softmax,得到概率分布,并返回概率最高的候选项。
这里的关键在于,该打分头对每个类别只有一个输出。每个类别描述会产生各自的表示,再由同一个打分头通过输出层(本质上就是一个 logistic 回归模型)进行打分:
其中
si 是类别标签 i 的标量分数;
w 是可学习的权重;
b 是可学习的偏置单元;
hi 是 transformer 在进入分类头之前的输出。
对于 N 个候选项,会得到 N 个分数,经 softmax 后返回 N 个概率。当 N 变化时,学到的参数保持不变。
关于 hi 需要注意:
BERT 风格的编码器模型使用
[CLS]token 的最终隐藏状态(可选地再经过一个池化层);GPT 风格的自回归模型通常使用最后一个非 padding token 的隐藏状态——这是由前面讨论过的自回归特性决定的(最后一个非 padding token 能够关注到前面的文本、任务说明和候选描述)。
然后,我们以正确选项为目标,用交叉熵损失对模型和打分头进行联合微调。由于所有候选项共享同一个打分头,我们可以在不改变架构的情况下调整选项的数量和描述。但同样地,它在陌生任务上的表现如何,仍取决于训练数据。
顺便一提,为什么不选文中提到的更简单的 RNN 或 CNN 架构,而要用 BERT 或 GPT 这类基于 Transformer 的模型呢?从技术角度看,上述方法对两者都适用。但基于 Transformer 的模型扩展性极佳,意味着它们能在更大的数据集上预训练,并从中获得更多收益。此外,得益于注意力机制,它们能更充分地利用上下文信息。因此,如果我们希望模型在不同目标任务上具有良好的泛化能力,且无需针对每个任务进行显式微调,那么在高质量数据集上预训练一个基于 Transformer 的模型,比使用基于 RNN 或 CNN 的模型更有希望接近我们的目标。
5. Jev 的架构与训练算法
那么,Jev 为何能在众多不同任务(从电影评论到像玩俄罗斯方块这样任意任务)上表现如此出色呢?不幸的是,关于其架构、算法和训练数据的细节并未公开。此外,请谨记,其背后是一支专业团队和一家市值数百万美元的公司,他们为此模型付出了巨大努力;我们并不能指望通过在一周内于开放数据集上训练一个 ModernBERT 类似的模型,就能达到那样的性能水平。
话虽如此,如果非要我做个有依据的猜测,就架构而言,我推测他们使用的可能是类似 ModernBERT 的小型模型,这也是其低延迟的来源。
至于训练数据,正如前文所述,TypeSafe AI 的首席执行官在这里这样说过:
我们 100% 使用合成数据(当然,不是那种 LLM 随意吐出来的垃圾数据)
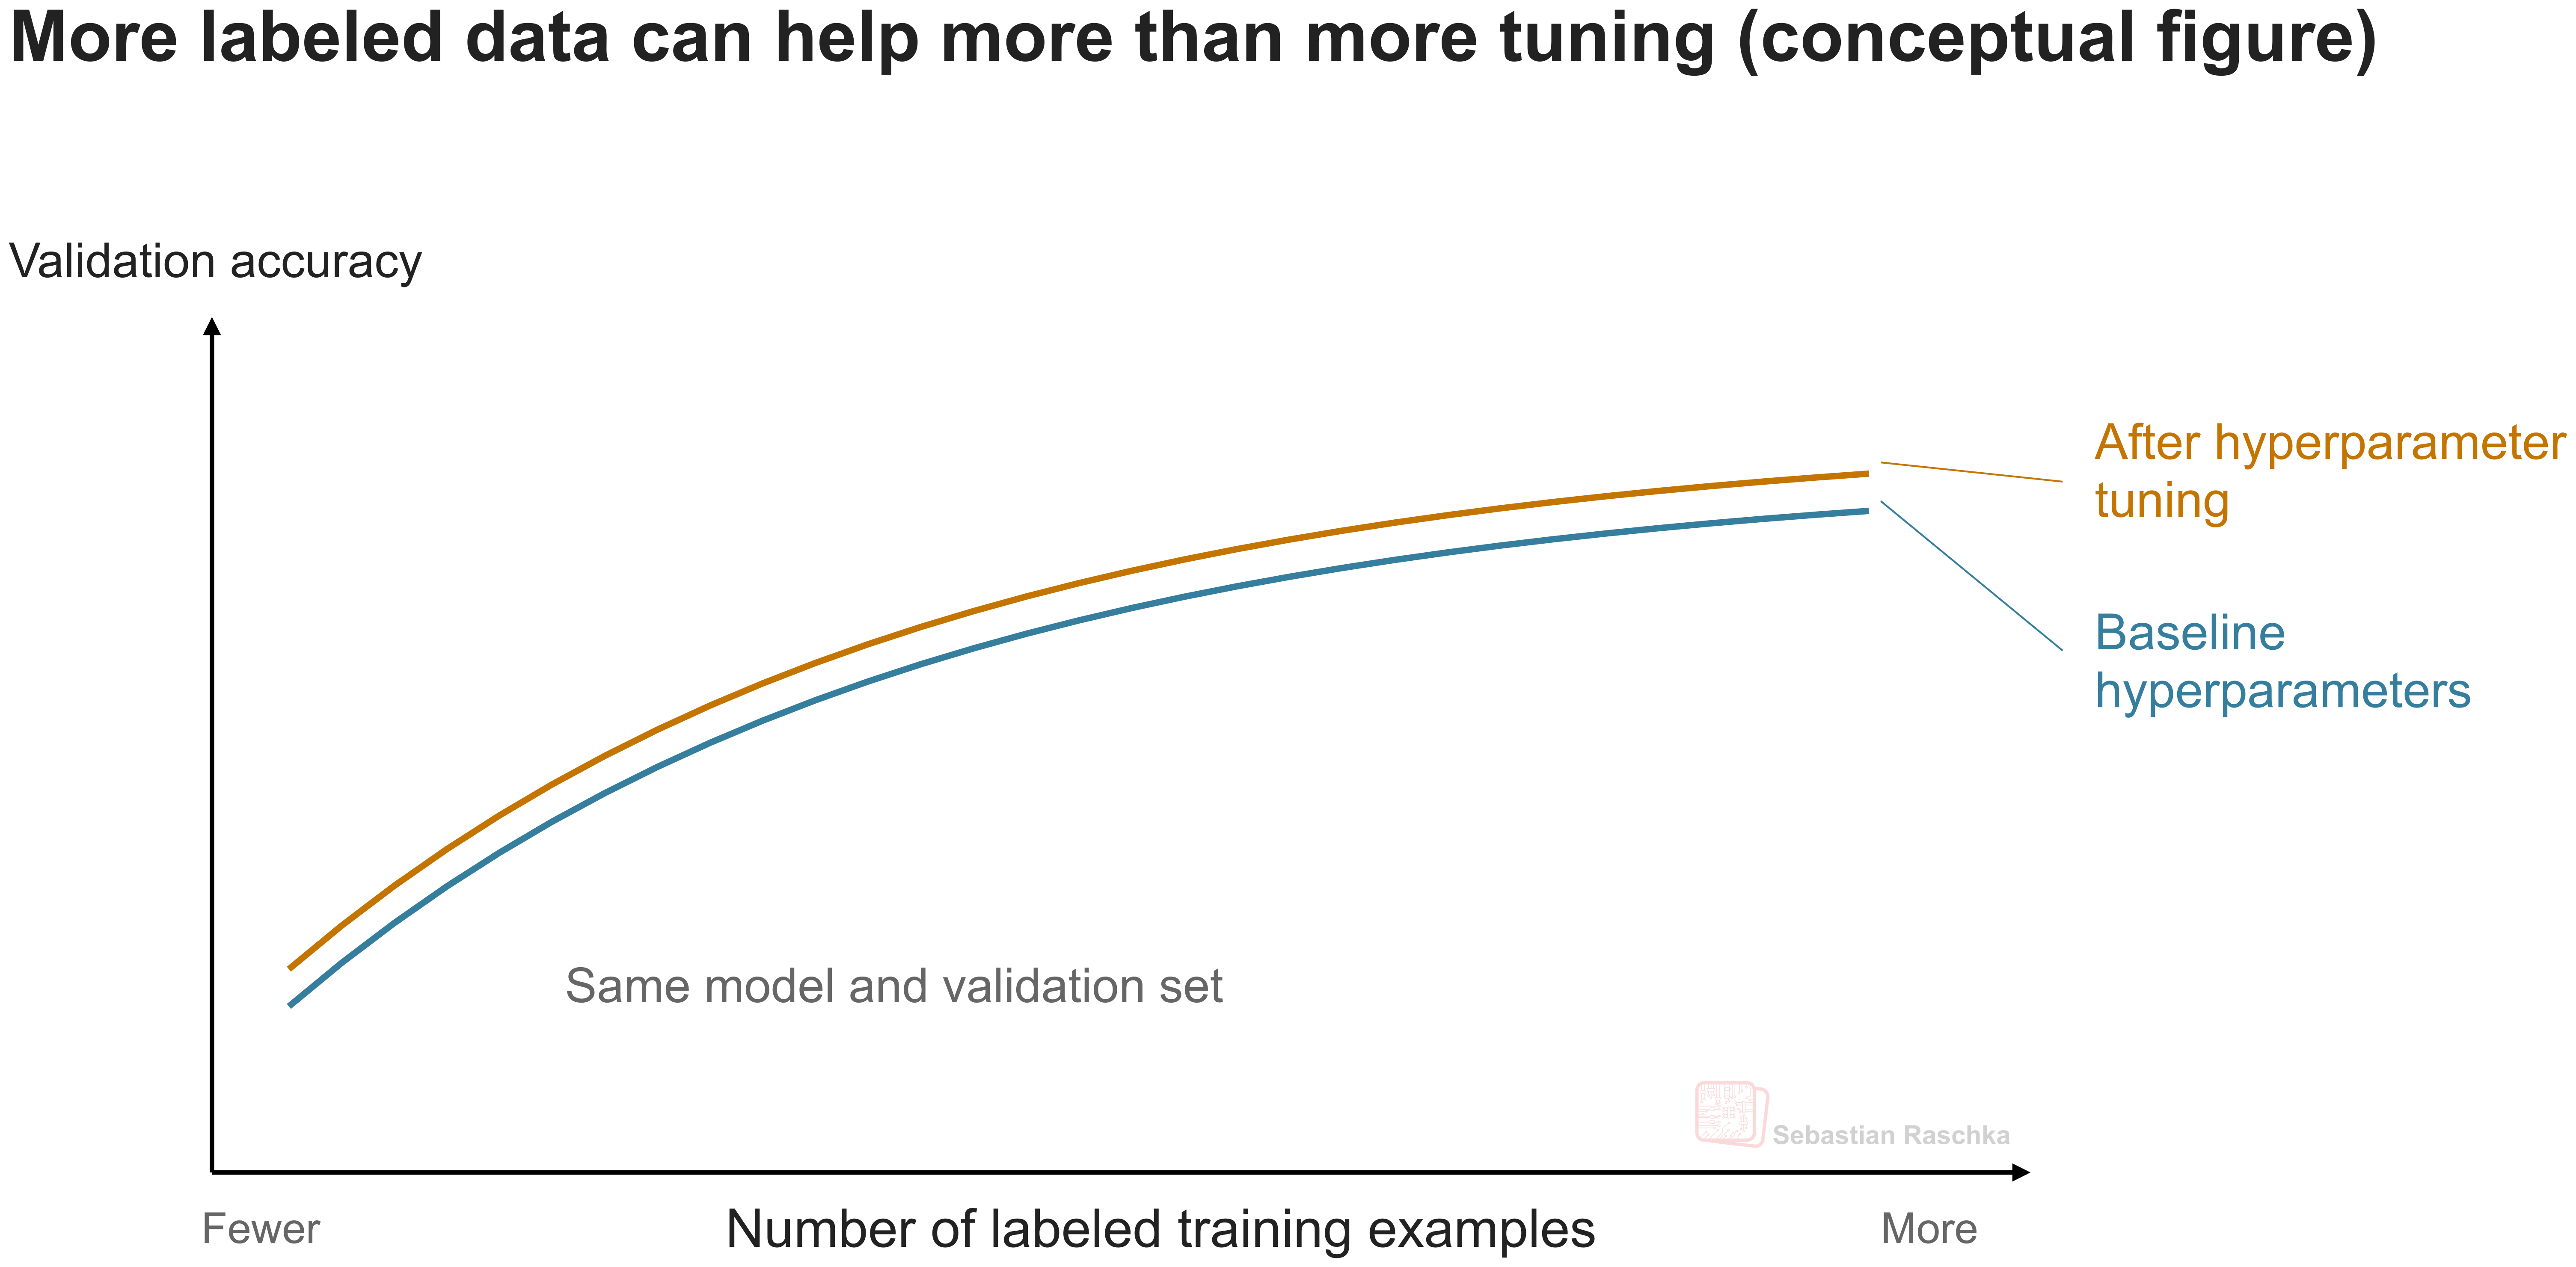
所以,没错,我认为大部分精力都花在了构建这个数据集上。这也是我多年来一直在向学生和合作者强调的观点。分享一件小事:大约 8 年前,我与社会科学系的一位教授合作,帮助设计了一个文本分类问题的实验方案。她的学生花了好几天时间调整 bag-of-words 基线和 BERT 模型的超参数,才勉强挤出约 2-5% 的准确率提升。随后,我建议我们各自花几天时间手动标记更多数据(我想我们原本的数据集只有 300 个样本左右,我们将其规模扩大了一倍),结果准确率提升了 10-20% 以上。是的,为了达到这个目的,绘制学习曲线确实很重要 :)。
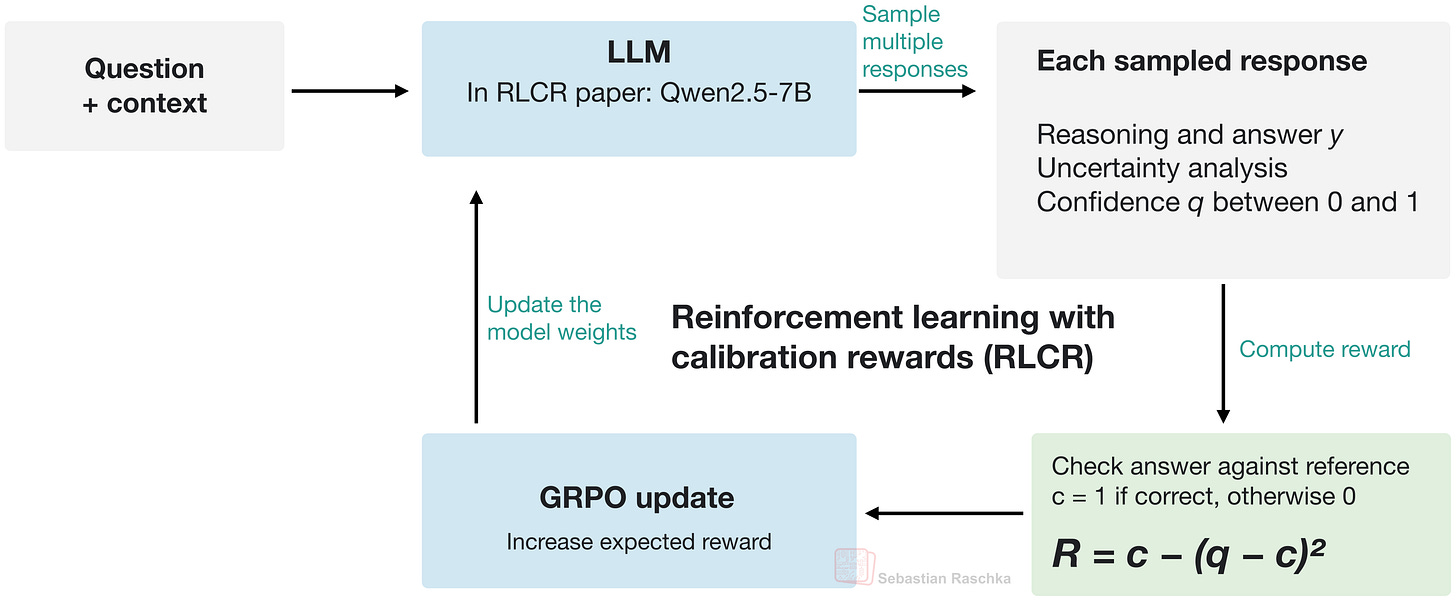
最后是训练算法。具体细节尚未公开,但 TypeSafe AI 的博客文章提到,他们采用了一种名为校准决策强化学习(Reinforcement Learning for Calibrated Decisions,简称 RLCD)的新算法:
“我们构建了一个完全专注于自动化的新技术栈:采用了新的模型架构、用于最大化效率的并行采样器,以及我们称之为校准决策强化学习(RLCD)的训练方法。”