为什么大语言模型会说谎?
你的 Agent 返回了异常结果。是 Prompt 的问题、工具调用超时,还是代码无法解析的响应?如果没有 Trace(链路追踪),你只能靠猜。
在这项动手实践中,Sentry 的 Serge 将使用 Sentry Agent Tracing 为三个 Agent 添加埋点:一个电商客服聊天机器人、一个自定义 Slack Agent,以及一个用于审查 PR 的 GitHub Action。你将学会如何捕获异常的工具调用和意外输出,同时跟踪每个 Agent 的 Token 消耗和性能表现。
一位客户询问公司新的 AI 客服助手,15 天前购买的订阅是否支持退款。假设助手立即回答:公司享有 30 天退款期,介绍了取消流程,并承诺款项将在 5 个工作日内到账。听起来既乐于助人、自信满满,又回答完整。
但问题只有一个。
实际上,该公司仅允许 14 天内退款。也没有关于 5 天处理时间的承诺。助手实际上只是拼凑了部分合理政策,凭空捏造了一个虚假的承诺。换言之,它撒谎了。客户现在期待的是一个公司从未提供的服务。
虽然这个例子听起来像是虚构的,但它揭示了基于 LLM 应用中最关键的问题之一。尽管 LLM 能生成优秀的语言,但它们可能完全搞错底层信息。
本文将探讨 LLM 产生幻觉的原因,以及可以帮助提高 LLM 回答可靠性的技术。内容涵盖:
LLM 中幻觉的实际含义
回答出错的三种方式
文本预测如何产生虚构事实
模型为何难以承认不确定性
使用 RAG 为模型提供证据
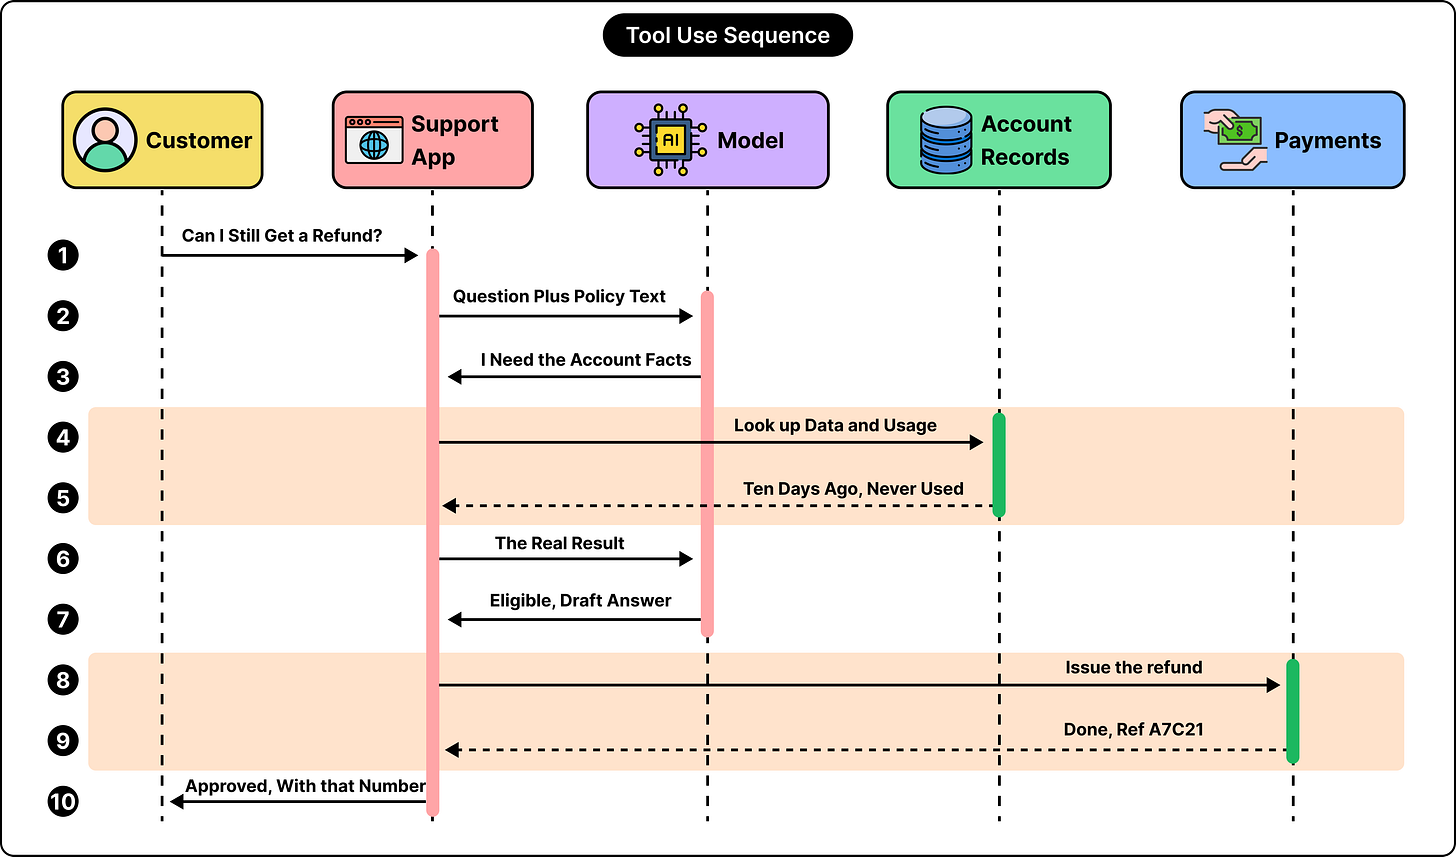
使用工具查询缺失事实
写出有用的答案
为什么解释不等于证明
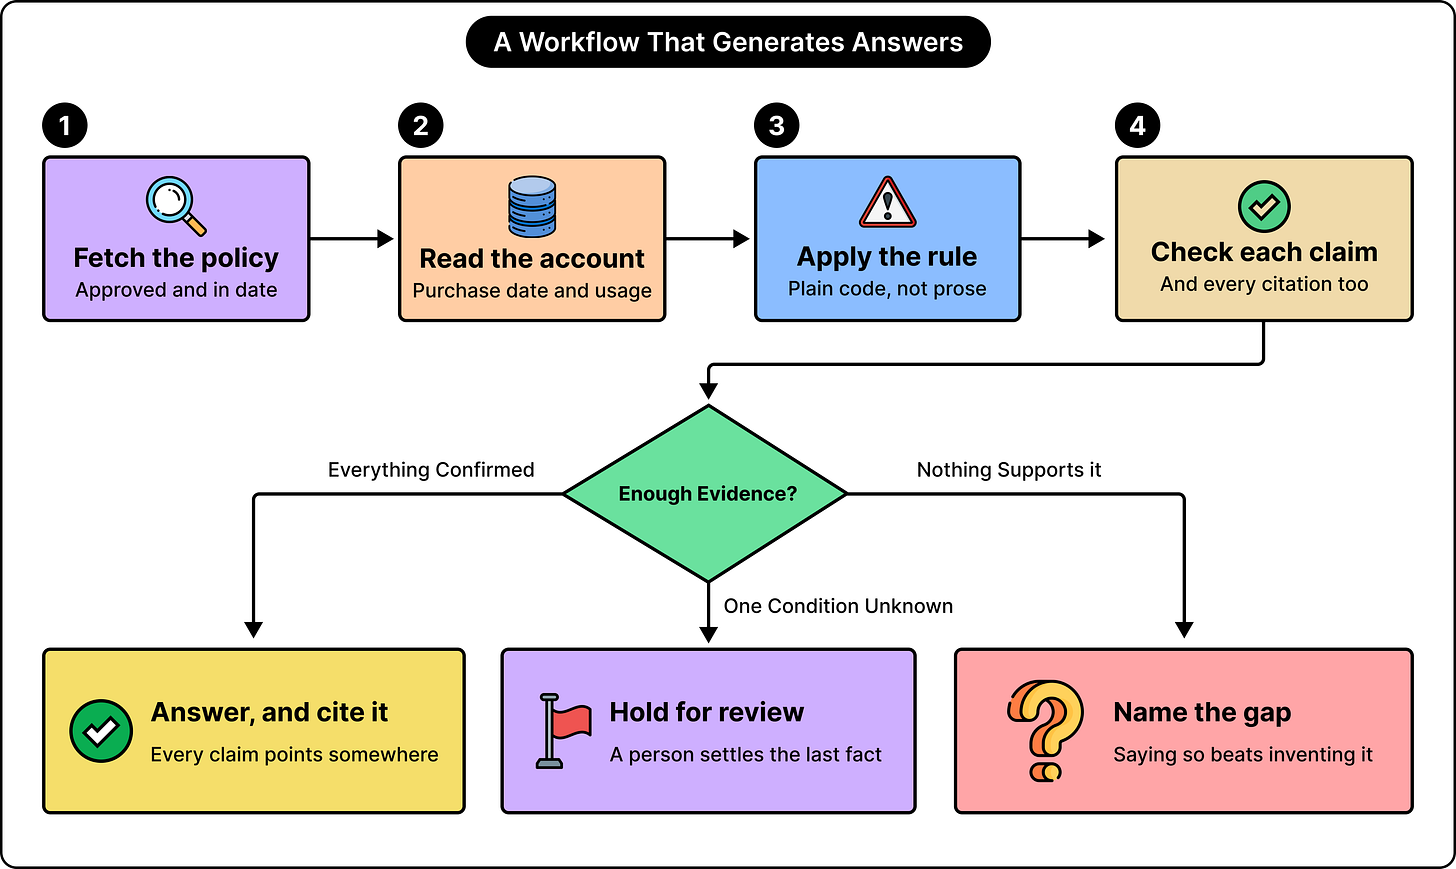
答案送达用户前先进行核查
幻觉到底是什么意思
在 LLM 语境下,幻觉指的是模型生成的信息在事实上有误、凭空编造,或与它本应依据的素材不符。幻觉的产生过程如下:
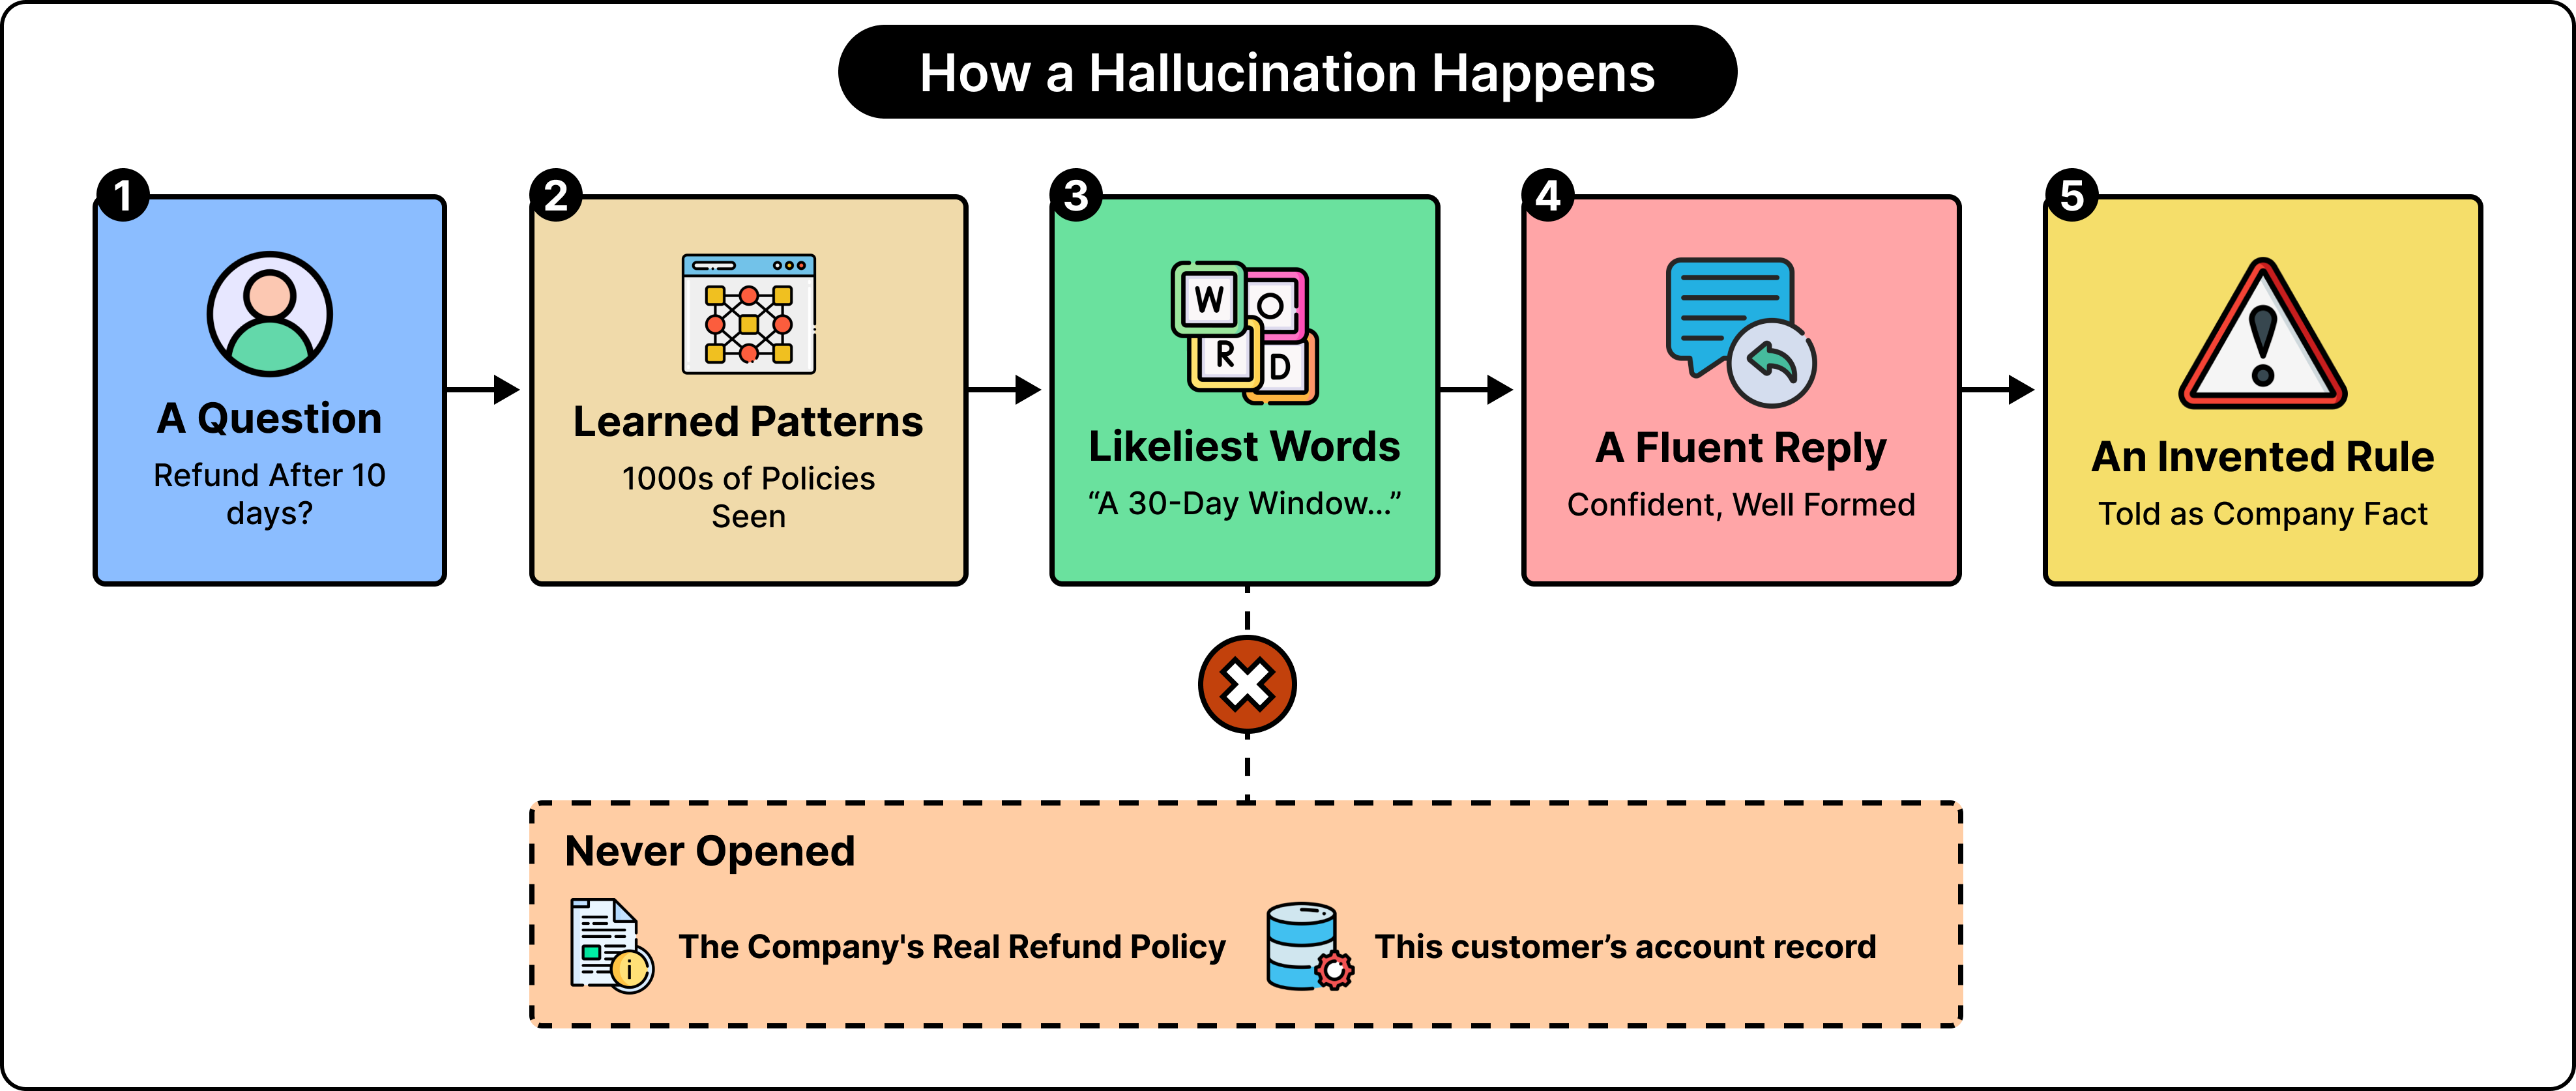
整段回答未必全错。事实上,一段本来很有用的解释里,可能混着一个编造的日期、一个没有依据的承诺,或一份根本不存在的文档引用。而读者恰恰可能就依赖那个小细节。
我们没法直接把这种行为称为撒谎,但它已经非常接近谎言了——回答就像一个自信满满的错误说法。不过,撒谎通常意味着有欺骗的意图,而幻觉无法证明存在这种意图。模型完全可能通过正常的生成过程就给出错误答案。回到前面客服的例子,最直接的问题在于:应用把一条凭空生成的退款政策当成了公司既定信息呈现给用户。
语境在这里非常关键。如果任务本身就是为一个虚构公司编写退款政策,那编造是合理的;但把同样的编造内容当作某家真实企业的政策来呈现,就是事实性错误了。归根结底,区别不在于内容本身,而在于答案声称自己代表什么。
答案出错的三种方式
把 AI 客服助手的错误分成三类,会更容易理解:
事实性幻觉:与客观现实相矛盾。比如说公司的退款期限是 30 天,而实际是 14 天,就属于这一类。公司确实存在,政策也是真实的,只是助手把它描述错了。
忠实性幻觉关注的是答案与所给证据之间的关系。例如,如果应用程序提供的政策要求账户必须处于未使用状态,但助手却表示使用情况无关紧要,这就与其来源产生了矛盾。
捏造则涉及无中生有,比如虚构某条政策条款、确认编号或研究论文。
这三类问题之间存在重叠。
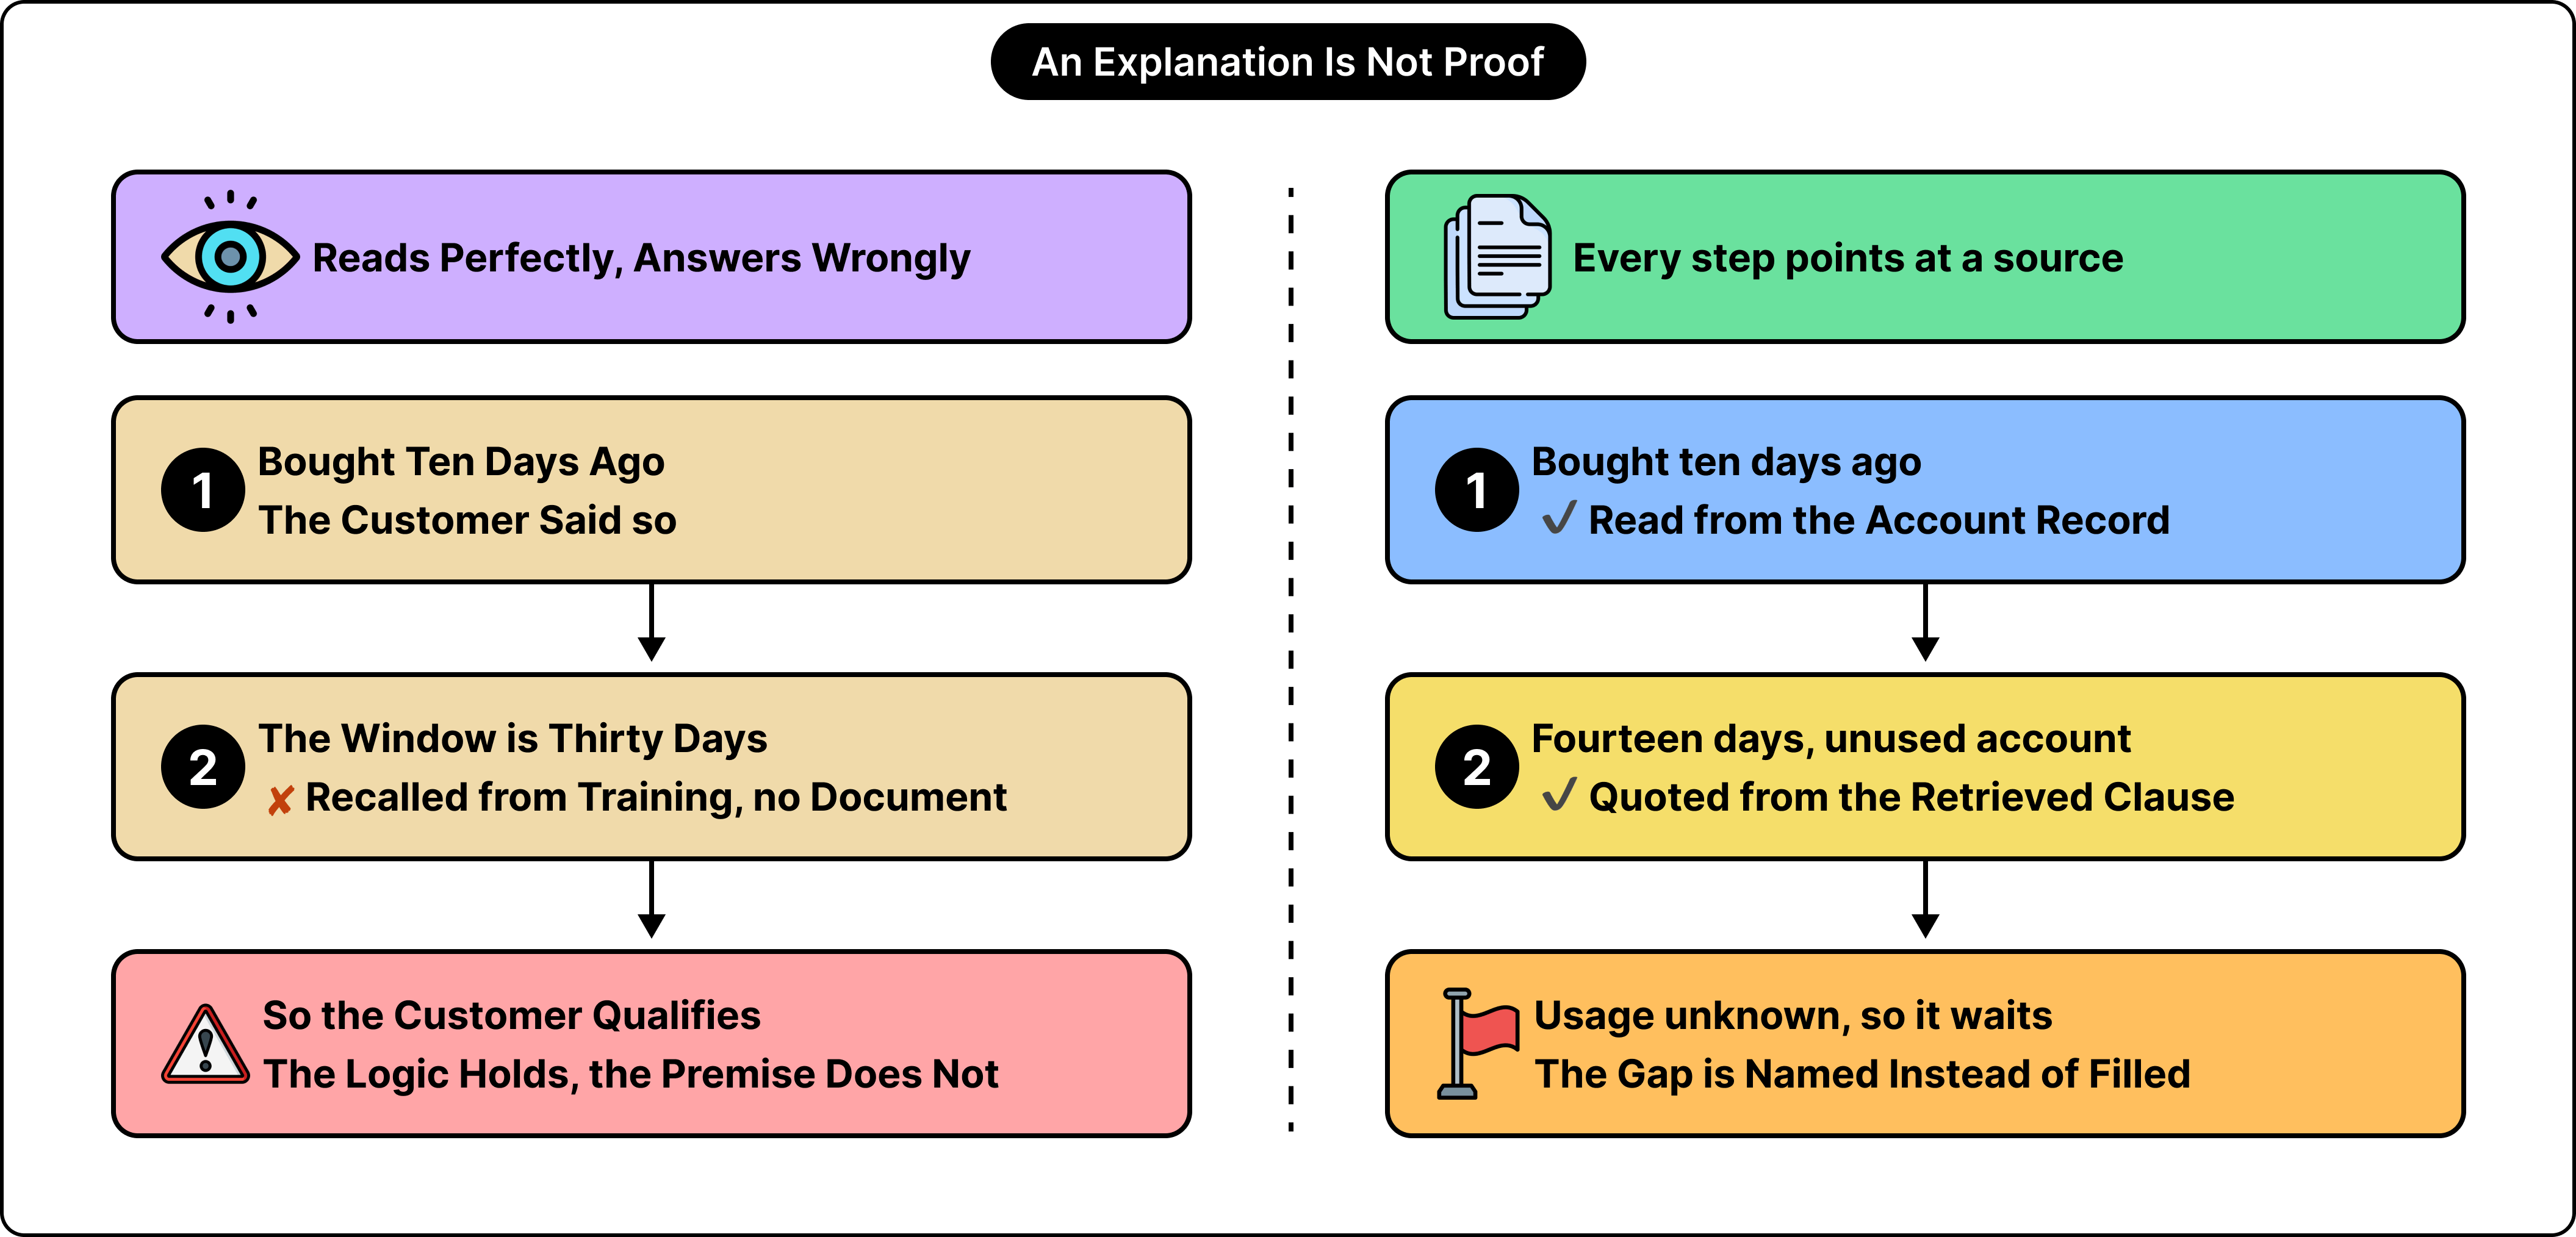
一个被捏造的政策章节,既可能在事实上是错误的,也可能缺乏所提供文档的支持。我们也可以将事实性和忠实性视为两个更广泛的类别,将捏造归入事实性失败之下。关键的区别在于:是核查答案是否符合现实,还是核查答案是否与提供的证据一致。
这一区分揭示了一种有趣的情形。AI 助手完全可能忠实地总结了一份过时的文档,却依然给出关于当前政策的错误答案。要修正这一回复,我们需要同时关注模型本身和作为信息来源的内容。
构建并规模化扩展制胜的 AI 智能体策略(赞助内容)
将智能体部署到生产环境只是第一步。让智能体保持稳定、可治理并持续改进,才是大多数企业 AI 项目停滞不前的症结所在。
顶尖团队是如何做到的?他们采用智能体运营模型(Agentic Operating Model, AOM),这是一套分步框架,旨在协调人员、流程与技术,确保企业级智能体在规模化过程中不断优化。
在 LangChain 的最新指南中,你将了解到:
为什么 AI 智能体的故障模式与传统软件不同
覆盖 Agent 完整生命周期的技术栈
从“构建并部署”转向“运营并持续改进”
文本预测如何产生幻觉
想清楚理解这个机制,我们来看看 LLM 是如何生成一条回复的。
你可能已经知道,LLM 以 token 为单位处理文本。token 可以是一个词、词的一部分,或者标点符号。对于给定的输入和已生成的回复,模型会为可能的下一个 token 计算概率。生成方法从中选出一个,追加到回复中,然后重复整个过程。根据具体设置,选择时可以挑概率最高的 token,也可以在候选延续中随机采样。
但“很可能的延续”并不等于“经过验证的陈述”。用来选择下一个 token 的概率只关乎文本生成,并不代表整个答案的可靠性。同样,像“肯定”“绝对”这类词也只是生成的语言,它们的出现并不能证明模型真的核查过相关政策或掌握了可靠的证据。
这些模式是模型在训练中学到的。
在最初被称为 pretraining(预训练)的阶段,模型会处理海量文本,学习预测后续内容。它的内部数值参数(weights,即权重)会逐渐捕捉到语法、概念、关系和事实等方面的模式,从而获得有用的知识以及处理各种语言任务的能力。
然而,对某个主题的熟悉并不等于掌握它的每一个具体事实。模型可能在训练中见过成千上万条退款政策:14 天、30 天、未使用账户、处理延迟等等。这些例子让它能用恰当的方式讨论退款,但并不能告诉它:在这家特定公司,哪些条款适用于这位特定客户。
编造引用也是类似的情形。模型学会了学术文献引用长什么样——作者姓名、发表年份、论文标题等等。即使手头没有真实的文献作支撑,它也能把这种格式复现出来。
为什么模型难以承认不确定性
LLM 主要被优化用于生成流畅且合理的文本。虽然它们经过额外训练以提升准确性、有用性以及对不确定性的处理能力,但一段流利的续写并不能证明模型发出的每个陈述都是真实的。
某些训练激励机制还会鼓励模型去猜。举个例子,假设一种评估方案:答对得一分,但答错和承认不确定也得到同样的分数。这样一来,猜测就存在得分的可能,而放弃猜测则意味着零分。这种激励机制会训练模型倾向于猜测,从而产生幻觉。
不过,说幻觉是架构固有的、因此不可避免,这种说法并不完全正确。模型能够识别某些不确定性,并检测部分错误。在特定条件下,模型具备有用的自我评估能力;但当这些能力需要泛化到不熟悉的任务时,其局限性就显现出来了。然而,目前不存在一个可靠的内部保证机制,能将每一个正确答案与每一次猜测明确区分开来。
要求模型给出置信度百分比,也无法自动解决这个问题。例如,如果模型声称自己有 95% 的置信度,我们需要证据来证明这种打分对当前任务是有意义的。校准(Calibration)用于衡量置信度估计是否与大量案例中观察到的准确率相匹配。如果没有这种评估,一个看似自信的百分比反而可能为一个本就不确定的答案增添更多模糊的细节。
通过 RAG 为模型提供证据
第一种主要防御措施直接针对信息缺失问题。
检索增强生成(RAG)会先查找相关资料,并将其添加到模型的输入中,然后再进行生成。检索负责找到信息,增强环节负责提供信息,生成环节则负责产出答案。
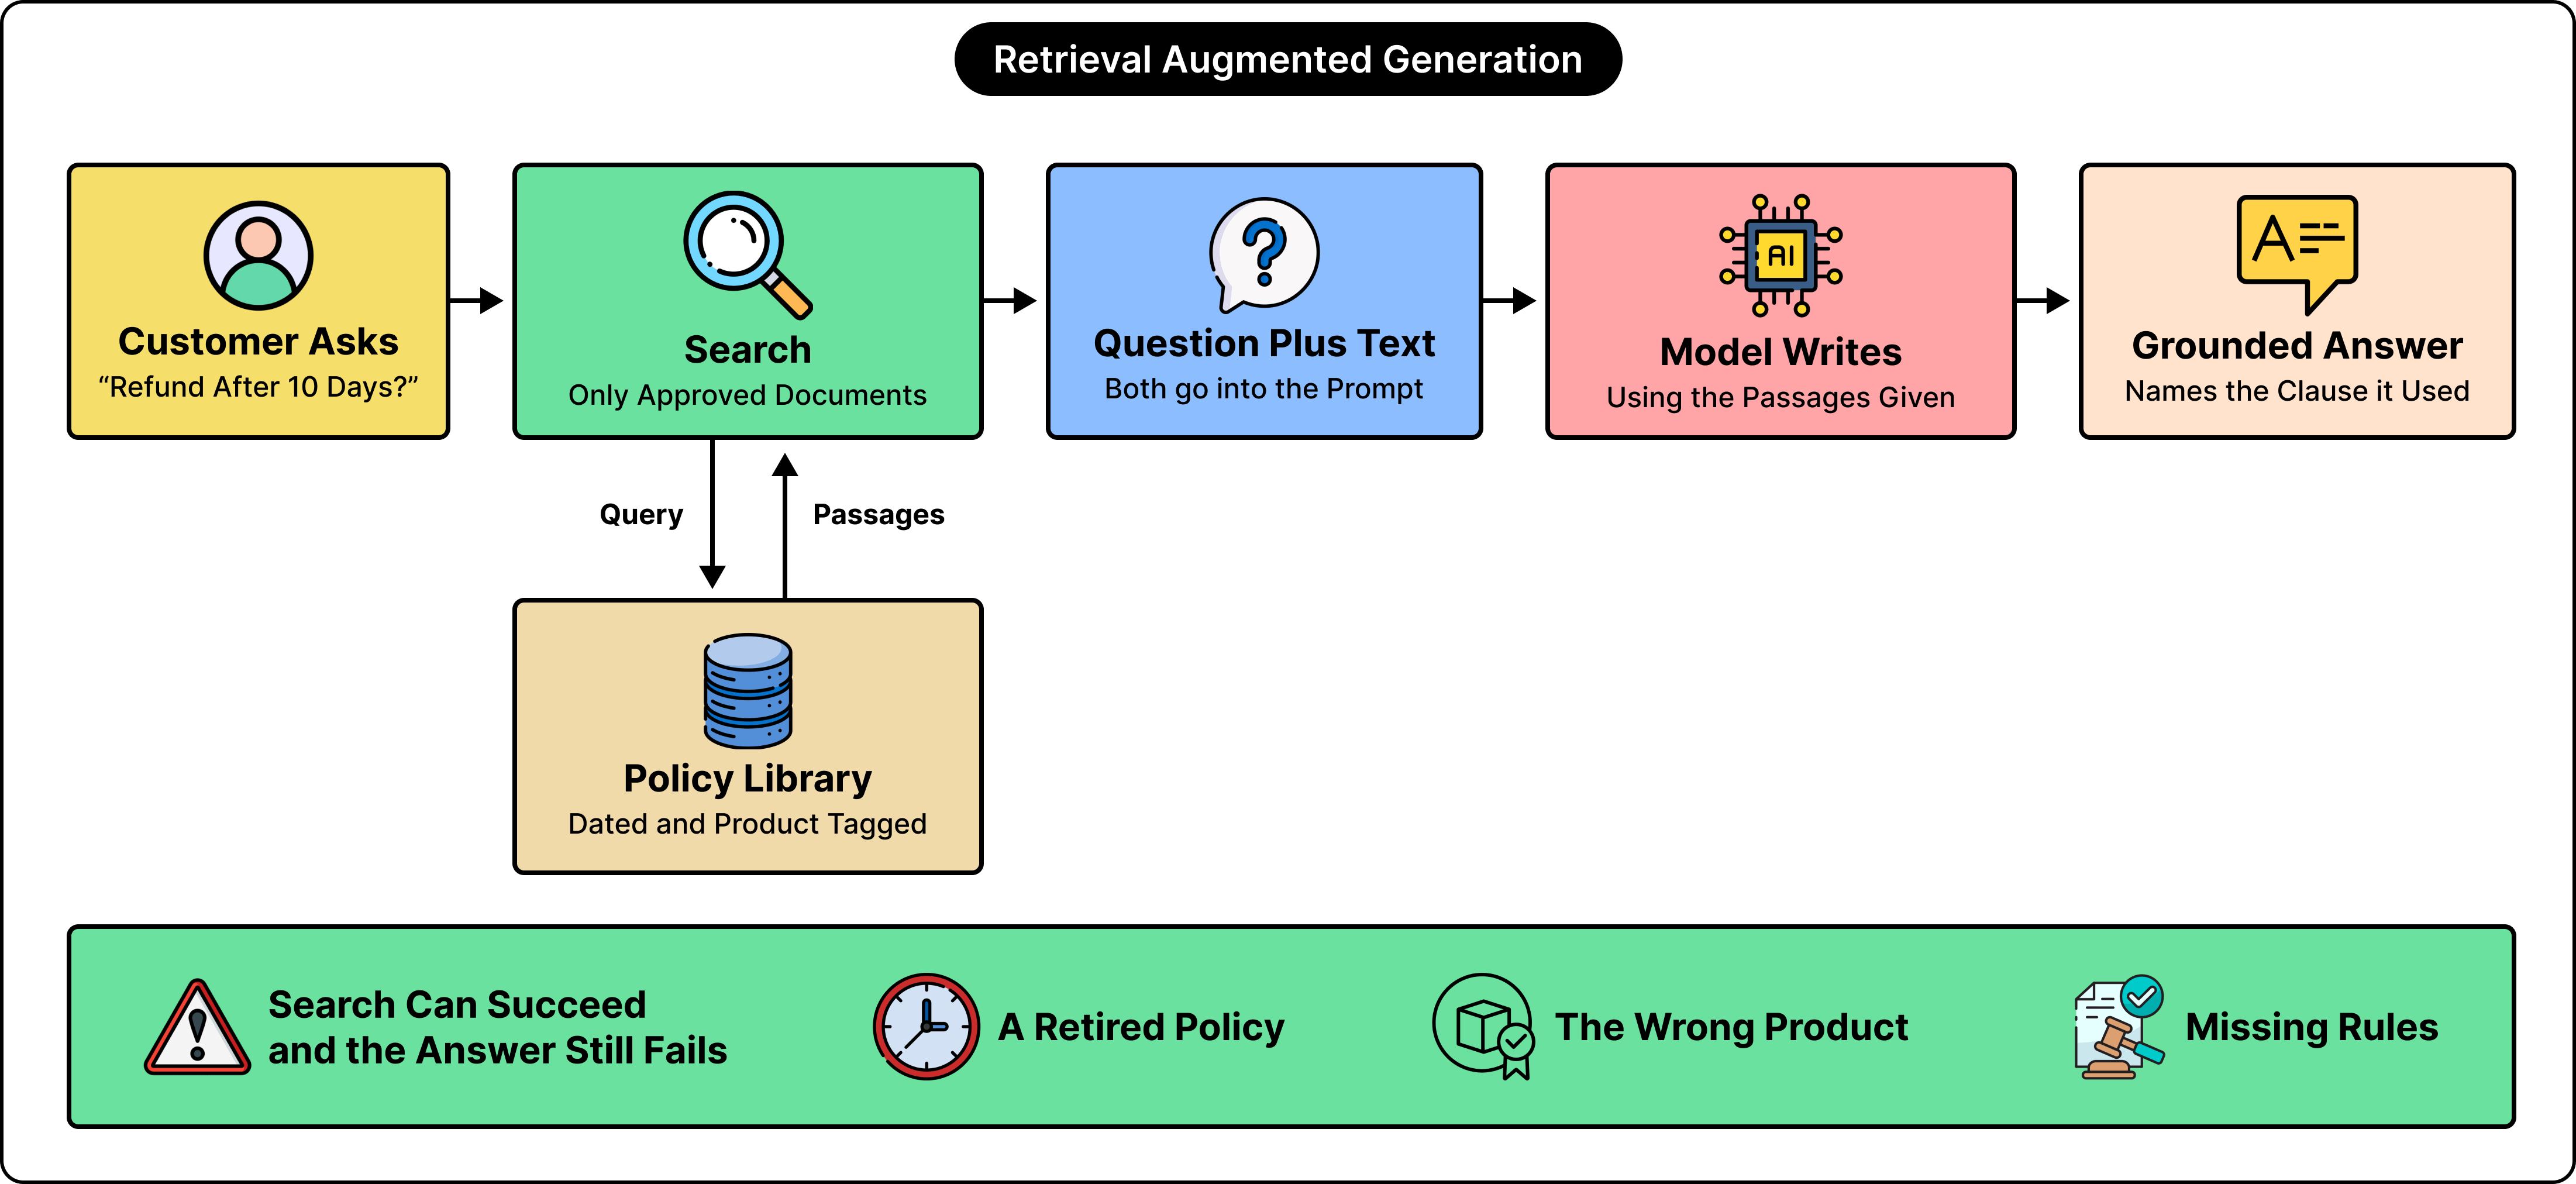
在我们举例的客服应用中,关于退款的问题会触发对公司批准文档的搜索。应用会检索到描述适用政策的段落