
AIAGENTHARNESS 拆解系列 · VOL.01 · 方法论
图 00 · 封面
第一节 · HARNESS 简史三年里,"智能"换了三个住址英文里 harness 本义是马具,指把牲口的蛮力变成犁地拉车这份有用功的那套缰绳。软件行业早把它借走过一次:test harness(测试夹具),指给被测代码搭的脚手架,负责喂输入、收输出、隔离爆炸。如今 LLM 工程师把它第三次借走,指代本系列的拆解对象:驮着模型跑的整套执行系统。一个词被借用三次,三次都指向同一件事,一个力气很大的主角,配一套把它管住的工程,这个巧合本身就在预告本文的主旨。
这个词真正站上舞台中央,大约用了三年。这三年也是一部"智能到底住在哪"的搬家史,值得每个产品经理了解,因为每次搬家都埋葬过一批产品。
2022–2023,智能住在提示词里。ReAct 论文(2022)给出智力原型:让模型交替地"想-做-看"。2023 年春,AutoGPT、BabyAGI 爆红又迅速退潮:给模型一个远大目标和一段"自主规划"提示词,它看起来就能自己干活了,然后死循环、幻觉自嗨、上下文爆掉、没有任何记忆。这一波留下一个行业级教训:光靠提示词撑不起自主性。同年 6 月,OpenAI 发布 function calling,模型第一次有了可靠调用工具的标准原语。散场与开工在同一年完成。
2023–2024,智能住在框架抽象里。LangChain 们把 agent 打包成库,即链、代理、记忆组件,降低了写 demo 的门槛,也收了一笔"抽象税":出了问题,你在调试的是框架的行为,不是模型的行为,于是越来越多的生产团队选择扔掉框架裸写循环。2024 年底,Anthropic 发布《Building Effective Agents》,主张从最简单的方案做起、能上工作流就别上自主 agent,等于官方给"为编排而编排"的框架时代画了句号。同年还有两个值得记下的信号:Devin 把"agent 即产品"的愿景演示给了全世界(成色不论,方向成立);SWE-bench 论文(2023 年底)让"agent 干活好坏"第一次变成可测量的事,评测意识在这一年萌芽。
2025,智能搬进执行系统,harness 即产品的元年。Claude Code 年初把完整的 agent 循环做成终端产品,并把 CLAUDE.md、hooks、子代理、权限模式这些机制公之于众,"harness"一词随之进入主流话语;紧接着 OpenAI Codex CLI、Gemini CLI、OpenCode 等密集登场。行业对瓶颈的表述也换了:2024 年是"模型还不会好好用工具",2025 年变成"执行系统喂不对、管不住、收不了尾"。年中,"上下文工程"(context engineering)一词流行起来,迅速取代"提示词工程"成为热词,词语的更替,标记了问题从模型侧搬到了工程侧。年末还有一个定调的信号:LangChain 2025 年 10 月的博客把 framework / runtime / harness 三层词汇定形。
2026,收敛与内卷。模型厂商亲自下场成为潮流:年中 DeepSeek 开源了 dsh,智谱 Z.ai 把 ZCode 与 GLM 做成一体化;开源 harness 批量涌现(Grok Build 转 Apache 2.0、TrueForge 开源);学术圈进场(OpenDev 论文)。交互式体验拉平之后,竞争焦点转向无人值守、失败恢复与验证,这个新战场,正是后文七维框架里"评测与验证"那一维要盯的空白。
回头看,"智能"的住址从提示词搬到抽象框架、再搬到执行系统,每次搬家都伴随一批产品死亡、一批产品崛起。现在可以回答那个 2026 年的常识现象了:同一个模型,换一个产品包装,体验能差出几倍。因为发动机是同一台,底盘不一样:方向盘的虚位、刹车的软硬,决定你敢把油门踩多深。用户敢把多少真实工作交给 agent,通常不取决于模型跑分,而取决于这层系统里一连串看不见的设计决策:上下文压缩时丢掉什么、权限冲突时听谁的、失败之后从哪一步恢复。
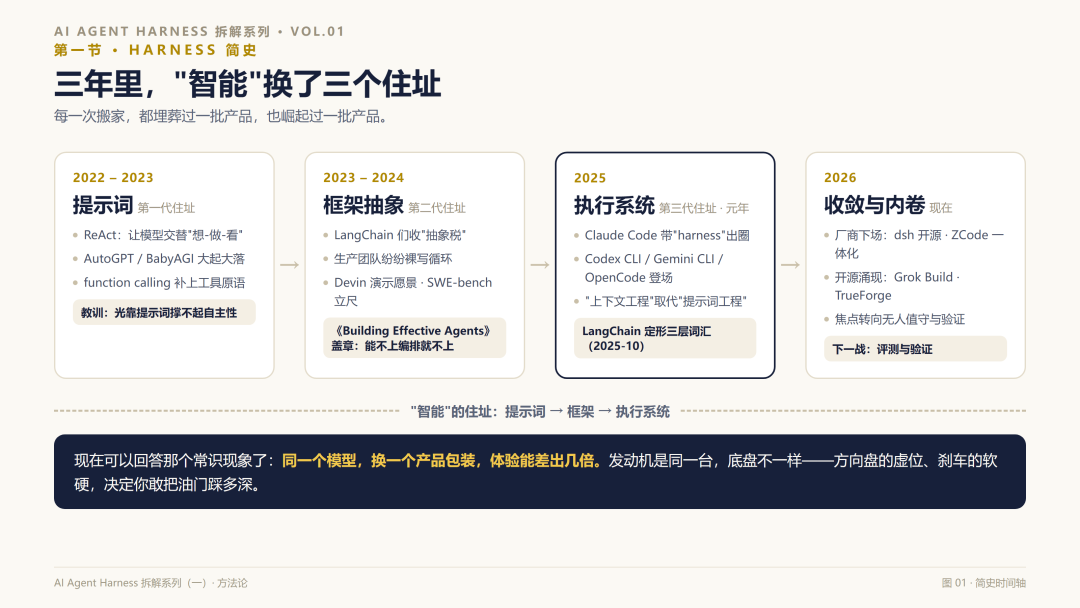
图 01 · harness 简史时间轴
第二节 · HARNESS 是什么模型外面包着的那层执行系统简史讲完,给这个词一个严格的定义。业界在 2025-2026 年收敛出一套三层词汇,LangChain 2025 年 10 月的博客给出了最清晰的划分:
框架 framework:你写 agent 的逻辑,是时代的遗产,如今公认负担多于价值。
运行时 runtime:执行与基础设施,即沙箱、队列、进程管理。
harness:完整的自主循环,即把一个 LLM 变成一个能干活的 agent 的那层运行系统。
本系列采用的工作定义:harness 是包裹模型的执行系统——上下文的装配与管理、工具的执行、权限的控制、记忆的存取、失败的恢复。模型负责思考;harness 决定思考的原料、手段、边界和退路。
也要说清 harness 不是什么:不是模型本身;不是聊天界面;也不是"编排"(orchestration)。编排解决多个 agent 的组织问题,harness 解决单个 agent 循环的工程问题,两者经常被混为一谈,第八节会看到一个厂商主动区分它们的活案例。
一个成熟 harness 里实际在运转的东西,至少包括:启动时的上下文装配(注入什么、各占多少预算)、窗口耗尽前的压缩(保留什么、丢弃什么)、工具调用与结果截断、防死循环、权限门与自主度档位、跨会话记忆的写入与唤起、失败后的中断与重放。注意:这些绝大多数不是模型自己能解决的,它们是纯粹的执行层工程,也正是本系列每一篇拆解要拆的对象。
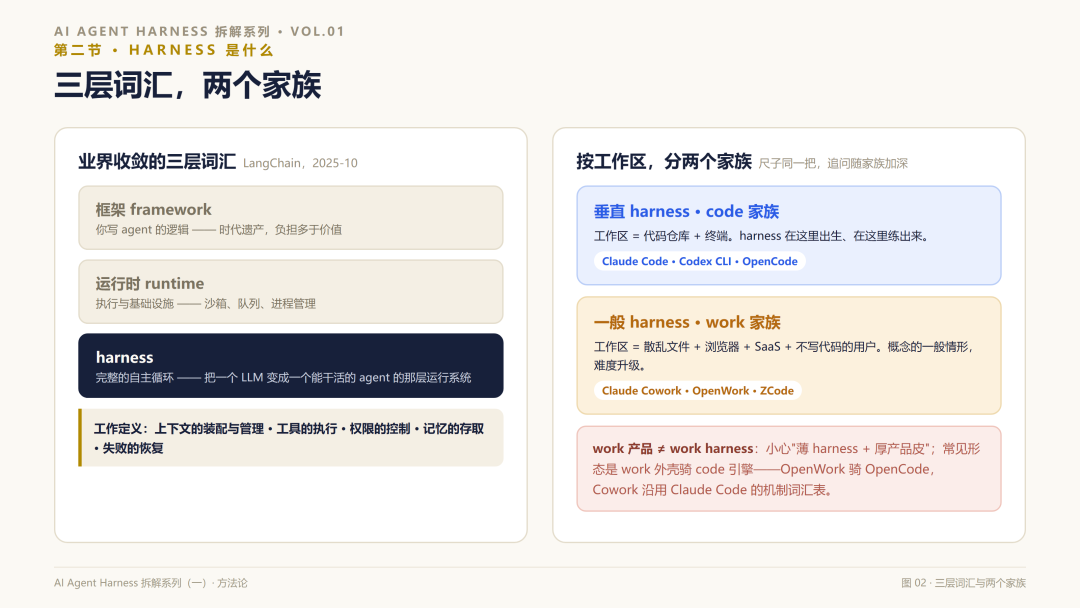
图 02 · 三层词汇与两个家族
还要给这个概念分个家。按工作区划分,harness 有两个家族:
垂直 harness · code 家族,其工作区是代码仓库加终端。Claude Code、Codex CLI、OpenCode 是代表,harness 一词也是在这里出生、在这里练出来的。
一般 harness · work 家族,其工作区是散乱的文件、浏览器、SaaS 和不写代码的用户。Claude Cowork、OpenWork、ZCode 是代表。
这次推广不是换皮,是难度升级。work 场景把 harness 的四个难题全部放大:
① 验证失去编译器:"PPT 做对了"没有单元测试,评测从附录变主战场;
② 动作外溢且不可逆:打向邮件、文档、账单,而不是 git 兜底的仓库;
③ 用户换成了非技术人:权限 UX 不能再是命令行的 y/n;
④ 工作区有状态且脏:仓库有结构,桌面是混沌。
Cowork 把"删除"设为必须审批、把 computer use 定位成 connector 之后的最后手段,都是这四个难题逼出来的产品决策(官方产品页,2026-09 核对)。两个家族的边界常被讨论是否会互相渗透,但 Codex CLI 目前仍是纯 code harness,并未跨入 work(work 层是另一款 OpenClaw)。
但要防另一个误区:work 产品 ≠ work harness。市面上大量 work 产品是薄 harness 加厚产品皮,机制工程未必比 Claude Code 深;更常见的形态是 work 外壳骑在 code 级引擎上,比如 OpenWork 骑 OpenCode,Cowork 沿用 Claude Code 的机制词汇表。
所以本系列两族都拆:用 code 家族立词汇,用 work 家族看泛化。尺子是同一把,追问随家族加深(第九节的路线图按这个两幕结构排布)。
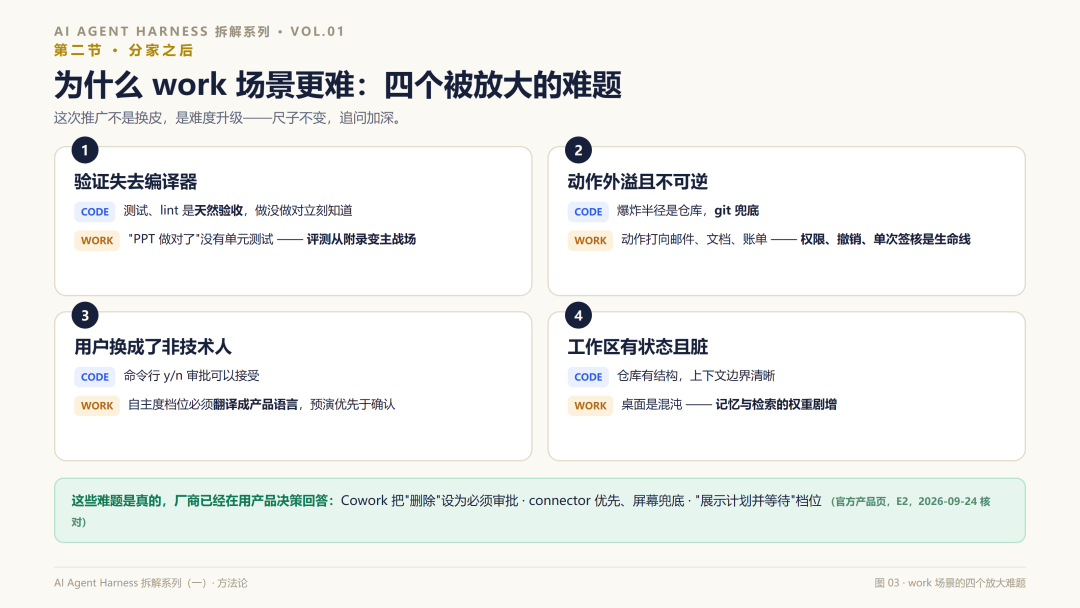
图 03 · work 场景的四个放大难题
第三节 · 为什么重要harness 对 AI 产品经理为什么重要第一,差异化主战场换了地方,而很多团队还守着旧地图。模型能力在加速同质化,产品体验的方差却越拉越大,这个方差现在主要住在 harness 里。用户嘴里的"这个 agent 越用越懂我",多半是记忆与压缩做得好;"那个跑着跑着就傻了",多半是上下文管理失守。看不懂这一层的 PM,会把病因记在模型头上,然后发现换了三个模型也没治好。还在"接模型、套壳、堆功能"层面竞争的产品,等于拿着上一场战争的地图打下一场仗。
第二,它是 AI PRD 的名词表。写不出可验收的 AI 需求,多数时候不是能力问题,是词汇问题。说不出"压缩存活集",长任务的验收标准就写不成句;不知道权限规则的命中顺序,就跟工程团队吵不清"为什么这个操作要弹审批";讲不出"恢复语义"(失败后从哪一步重跑、哪些已完成结果可复用),"失败自动重试"就只能是一句废话。harness 的机制词汇就是 AI 需求的最小词汇表。第五节的七维表,可以直接当需求模板骨架用。
第三,质量定义权落在这层,而这恰是 PM 能接管的真空地带。模型选型可以外包给算法团队,提示词可以交给工程师,但"这个 agent 功能的行为对不对、下个版本有没有退步"的验收标准,只有 PM 能定义,载体是评测集(evals)。功能列表说"支持记忆",但记忆召回对不对要靠评测回答;而全行业普遍把"观测"(tracing)做满了、把"评测"留成了空白(第八节 TrueForge 的拆解表里你能亲眼看到这半格)。谁先把"可信"产品化,谁拿走下一个心智。
第四,选型话语权。你的公司迟早要选 agent 底座,而乙方话术最擅长的就是混用"框架 / 运行时 / harness / 平台",2026 年连命名本身都成了竞争手段,TrueForge 专门发文教市场区分 harness 与 framework(第八节)。听得懂这套词的 PM,在选型会上问的是机制:压缩策略是什么?权限怎么组织覆盖?失败怎么恢复?听不懂的,只能问参数和报价。
一句市场注脚:2026 年的招聘市场上,"评测方向 AI 产品经理"已经是一个单独定价的岗位,价格带普遍高于同类非评测岗,说明市场正在为这层能力单独付钱。
出于这些判断,我动手开了这个系列:用接下来的八篇,把两族名单逐个深拆——code 侧 Claude Code、Codex CLI,work 侧 Claude Cowork、OpenWork、ZCode、DeepSeek Harness,外加一篇国内 work 产品合集。每个产品独立成篇,回答同一组问题,最后以一篇横向对比收官。至于为什么偏偏挑"逐个拆"这个最笨的办法,下一节交代。
第四节 · 方法辩护为什么要"逐个拆解""逐个拆"听上去就是最笨的选择,为什么不干脆写一篇综述,或者直接拉一张全产品对比表?因为现有材料回答不了产品决策的问题。对 harness 的公开讨论大多停在功能清单层,比如"支持 MCP""有 subagent""能跑命令";再往下往往就是营销话术,比如"最聪明""最便宜""最佳开源"。功能清单回答"它有什么",营销话术回答"它想让你相信什么",都没有回答"它是怎么想的":它的设计决策是什么、为什么这么定、代价是什么。而这恰恰是产品决策最需要的层面。
综述到不了这个层面,篇幅摊薄之后,每个产品只配得到两三行;没有逐个深拆垫底的横向对比,也只能停在参数和宣称上。所以这个系列选了最笨的一条路:逐个产品、按同一把尺子,把这些设计决策拆出来,并给每条论断标注证据等级。主要写给 AI 产品经理,但工程师和技术选型者也可以直接拿去用,每篇产出一张可复核的拆解表,系列收官时汇总成一张选型清单。
而要拆得统一、可比、可信,得先把尺子立起来。这把尺子分静态、动态两部分,接下来两节展开。
第五节 · 静态切面七维框架系列最初的草稿用六维。试拆两个产品后加了一维,评测与验证——因为它是各家营销最回避、而产品经理最该 own 的一层。七维如下,每一维对应产品经理的一个现实问题:
| 维度 | 回答的问题 | 典型机制 |
|---|---|---|
| 1 形态与架构 | 引擎和界面怎么分?谁能长在上面? | client-server、OpenAPI/SDK、多表面复用 |
| 2 上下文与记忆 | 什么进窗口、什么被记住、什么被忘掉? | 分层记忆、压缩存活集、大结果卸载、按需加载 |
| 3 工具与扩展 | 它能长出什么? | MCP、skills、hooks、子代理、自定义工具 |
| 4 权限与自主度 | 用户敢闭眼到什么程度?规则冲突听谁的? | allow/ask/deny、模式档位、沙箱、组织策略覆盖 |
| 5 并行与恢复 | 复杂工作怎么拆?失败了从哪一步重来? | 子代理隔离、session 树、journal 重放、断点续跑 |
| 6 评测与验证 ◆ | 它怎么知道自己做对了?坏了谁来发现? | 只读预演、验收标准、回归评测、遥测 |
| 7 开放与企业 | 谁能审计它、管控它、私有部署它? | 许可证、托管配置、自托管、RBAC、审计日志 |
第七维是试拆后新增的:它是各家营销最回避、而产品经理最该 own 的一层:全行业把"观测"做满了,"评测"留成空白。
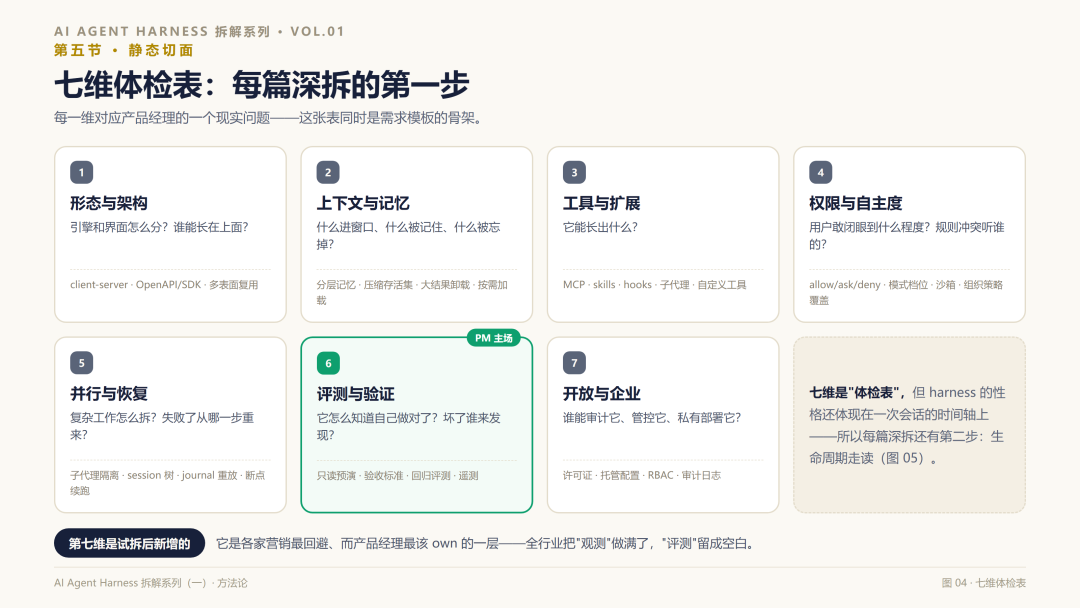
图 04 · 七维体检表
第六节 · 动态切面生命周期走读法七维是"体检表"。但一个 harness 的性格不只体现在静态指标上,更体现在一次会话的时间轴上。拆解的第二步是跟踪一次会话的完整生命周期,沿着"一个任务从进来到交付"的全程,在每个阶段问固定的问题:
第 1 站 · 冷启动
注入了什么(系统提示、记忆、规则、工具 schema)?预算怎么分配?
第 2 站 · 主循环
每一轮工具结果怎么回流、怎么截断?怎么防死循环?
第 3 站 · 压缩
什么时候触发?保留什么、丢弃什么?压缩后哪些从磁盘重新注入?
第 4 站 · 出口与交付
任务怎么算"完成"?谁在验证交付物?用户看到什么证据?
第 5 站 · 断点与复盘
中断后能恢复到哪一步?这次会话沉淀了什么记忆?
静态表 + 动态轴,交叉出每篇深拆的骨架。七维告诉你它"有什么",生命周期告诉你它"怎么想"。复盘的记忆写回存储,进入下一次冷启动:会话是循环,不是单行道。
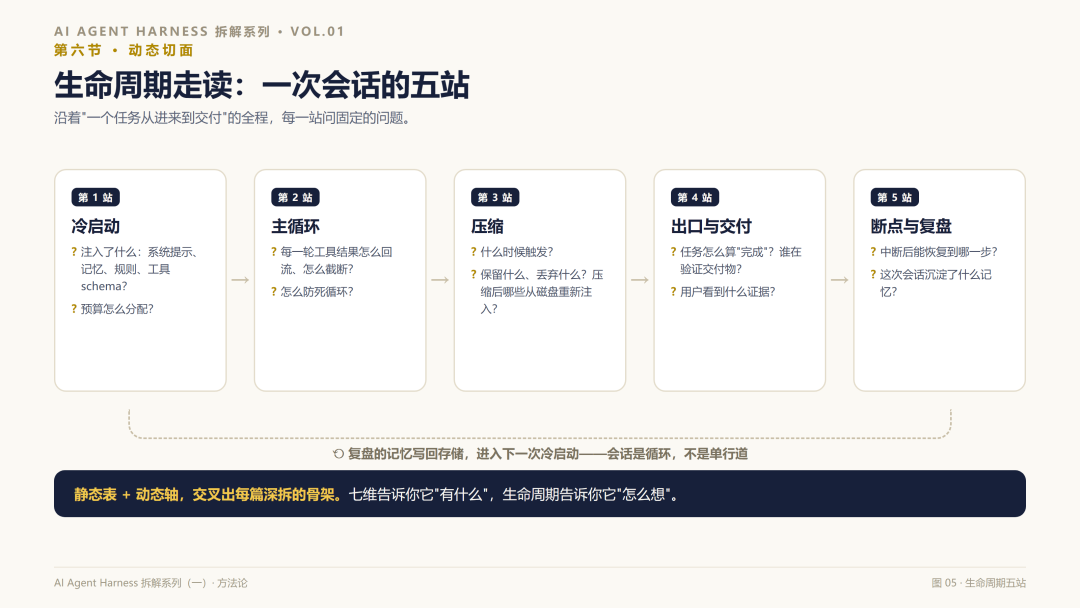
图 05 · 生命周期五站
第七节 · 凭什么信证据分级 E1–E4拆解类内容最常见的质量问题不是明着撒谎,是把营销话术当机制写。所以本系列每条论断都标注证据等级:
E1 · 营销与媒体
只能支撑"它想让你相信什么"的定位分析,不能支撑机制论断。如"便宜 X%""最快""最佳"。
E2 · 官方文档
机制论断的下限。必须标注核对日期:harness 迭代极快,无日期的文档论断三个月后即可疑。
E3 · 源码
开源产品的事实基准。声明读到的版本,文档会滞后、会美化。
E4 · 一手使用
闭源产品的行为验证。n=1,是证据不是结论,标注"一手观察"。用作线索,不用作结论。
硬规则一:查不到的格子写"证据不足",禁止用合理推测填空。空格子本身就是信息。
硬规则二:成本与性能宣称永远保持 E1,不复述为事实。分级不是为了否定厂商,是为了知道每句话能用到哪里。
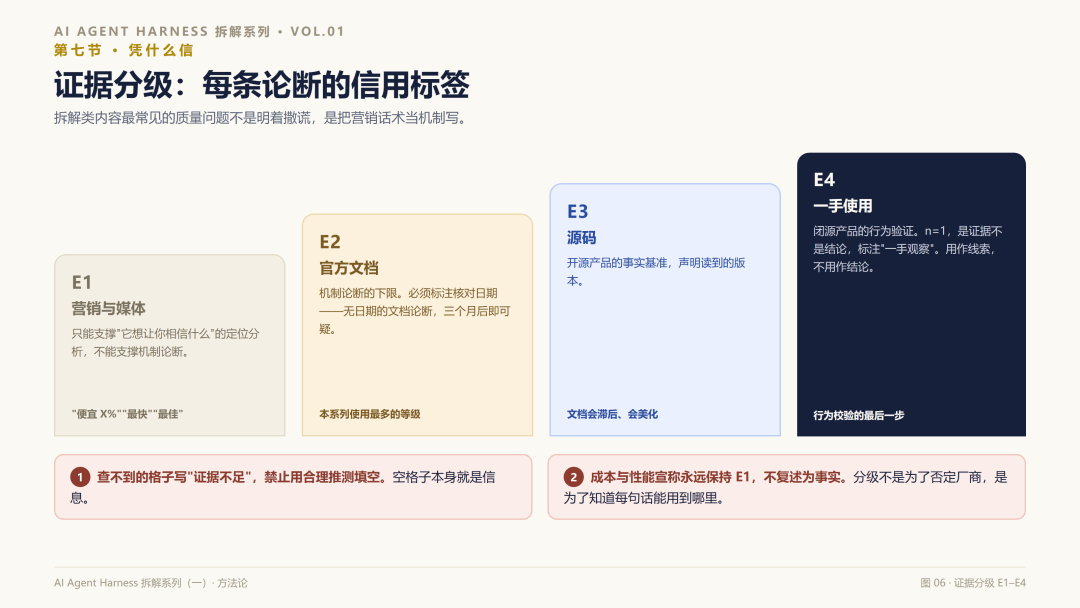
图 06 · 证据分级 E1–E4
第八节 · 工作示例不到一小时,拆一遍 TrueForge方法论说完了,现场演一遍。选 TrueForge,这是 TrueFoundry 2026 年 8 月才开源的新 harness,小、新、资料不算多,正好展示尺子怎么用,也展示尺子怎么诚实。
第一步,定位(E1)。2026 年 8 月 19 日开源,MIT 许可,宣言"The Agent Harness Should Be Open",官方说明它是 TrueFoundry 自家 AskTFY agent 背后的同一个运行时。媒体口径是"任务完成成本比 Claude Managed Agents 低 30-75%","最佳开源 harness"榜单也出自 TrueFoundry 自家内容。注意这一整套都是 E1,它们的正确用法不是判断产品好坏,而是读出市场叙事:TrueForge 押的是"成本 + 供应商中立"两个点,打的是托管 agent 平台的锁定与溢价。
第二步,机制(E2)。官方产品页给出了组件清单:沙箱执行(作用域凭据、自带算力)、人工审批(approvals)、上下文工程(子代理、预载工具、大结果卸载、自动压缩)、持久化状态、MCP/API 工具、版本化 skills 注册表(SKILL.md + RBAC)、步骤级 tracing(每个模型调用、工具调用、token 全程留痕)。
第三步,源码(E3)。写作时 GitHub 两次连不上,收尾前已用源码包补齐(main 分支,trueforge-core 0.3.0-rc.0 / SDK 0.2.1rc0,核对日 2026-09-27;npx 发布的 standalone 版号与此源码快照不同,下文 E3 基于 main 分支源码)。核心引擎在 packages/trueforge-core。把它拆开,E2 说的四条都对得上,但源码比宣传更老实,下面逐条坐实。
1. 工具 schema 默认延迟加载。agentSpec 里 preload 默认 false,注释原话"tools are discovered lazily, only preload_tools stay eager";convertMCPServers 直接跳过没有预载工具的 server,"to avoid unnecessary listTools() calls and OAuth triggers"。换句话说,不是每个 turn 都把所有工具定义塞进上下文,默认是 deferred,只有点名 preload 的才常驻。E2 那句"延迟加载工具 schema"于此坐实(E3 ✓)。
2. 子代理是模型现拉的。DynamicSubAgents 暴露一个 create_sub_agent 工具,子代理动态生成、与父代理共用工具与沙箱、文件系统互通,但拿不到父对话历史、必须收自包含指令,还能从 modelSet 里挑更便宜的模型跑子任务。长尾子任务不膨胀父上下文,坐实(E3 ✓)。
3. 大结果卸载到沙箱文件。LargeToolResponse 有硬阈值:单条 ≥6000 token、或累计 ≥10000 token 就拦截,把完整内容写进沙箱文件、只回路径加前后 100 字符预览,并提示"要么缩参数、要么 grep/sed、要么丢给子代理"。引用而非全文,坐实(E3 ✓)。
4. 50k token 自动压缩,且是确定性重写。ContextCompaction 默认阈值 50000 token(模型上下文已知时改取 0.8×长度);每次 LLM 调用前作为 PreLLM 处理器跑,超阈值就把整段上下文送模型做摘要,再用 AGENT_CONTEXT_OVERWRITE 把上下文整体替换成"摘要 + 续写提示"。注意它是整段覆盖、非增量,且压缩本身另花一次模型调用,成本叙事里"省下的上下文"有一部分要还给它。坐实,但带这个 caveat(E3 ✓)。
主循环在 AgentThread:preLLM 处理器(压缩)→ 流式 LLM → 工具调用 → 工具响应处理器(大结果卸载)→ 循环到 done。四件事里有两件分别嵌在管线前后两端,这就是它敢说"可审计"的底气。
第四步,一手(E4)。源码依赖已装(pnpm 整仓,875MB),并用 npx 起过 standalone 服务(server 监听 8990);但 agent 实际对话未跑(缺模型 key),仍标待验证(详见文末说明)。
| 维度 | 观察结论 | 证据 |
|---|---|---|
| 形态与架构 | UI/SDK 构建 agent 的运行时;sessions、governance、triggers 内建;generative UI streaming | E2 ✓ |
| 上下文与记忆 | 子代理分流、大结果卸载、自动压缩,官方称上下文工程是"token 数字背后最大的杠杆" | E2 ✓ |
| 工具与扩展 | 任意 MCP server / API;版本化 skills 注册表(SKILL.md + RBAC,按需挂载) | E2 ✓ |
| 权限与自主度 | approvals 中央化配置(敏感调用暂停等人签核);沙箱内作用域凭据 | E2 ✓ |
| 并行与恢复 | 持久化状态,长任务跨重启存活、可续跑(resume) | E2 ✓ |
| 评测与验证 | 有步骤级全链路 tracing(观测);另有仓库内 benchmark/ 可复现套件,即 DevRev Enterprise-Bench 14 个跨系统任务、盲评 LLM judge、对照 Claude Managed Agents 与 deepagents 的成本/准确率,E3 确认;但它是产品之外的评测脚本(需自备数据集与 API key),非 harness 内置的"做得对不对"自检 | E3 ✓ · 外评测非内置 |
| 开放与企业 | MIT · 自托管 · 模型级 RBAC · 集中式 OAuth · 深度绑自家 AI Gateway(1000+ 模型) | E1 + E2 |
从这张表里,产品经理能读出三件事:
1. 最满的格子和半空的格子同样有信息。最满的是"上下文与记忆",TrueForge 的成本叙事(E1)和技术叙事(E2)押注完全一致,这本身就是个行业信号:上下文管理被公认为 harness 里最值钱的杠杆。而最值得玩味的是那半格"评测与验证":tracing 把"每一步发生了什么"做得清清楚楚,却没有回答"做得对不对"。观测和评测是两件事,行业普遍只做了前者。对照 Claude Code 把只读预演做成一等公民、ZCode 用 journal 重放管理失败恢复,验证维度仍是新玩家的盲区;对 PM,这就是机会区:谁先把"可信"产品化,谁拿走下一个心智。补一句 E3:TrueForge 随仓带了一个可复现的 benchmark/ 套件(DevRev Enterprise-Bench、盲评、n=3),所以"只做观测"那句对它要修正,它有外部评测,只是没有内置验收;这半格的准确判读是"有外部基准、无内置自检"。
2. 成本宣称的证据处理示范。"同基准同模型便宜约 50%"背后其实有细节:14 个生产型任务、DevRev Enterprise-Bench、盲评。这比纯口号强,但仍是自建基准、自报告,按本系列规则记为 E1+,归入定位分析,不复述为事实。分级不是为了否定厂商,是为了知道每句话能用到哪里。
3. 对照阅读暴露它的真身。TrueForge 官方把 LangGraph/CrewAI 归为"你写你托管的代码库",把自己归为"带生产特性的 harness"。第二节那套三层词汇不是学究分类,是厂商自己在用的市场武器。读懂这层话语,你才能在选型会上一眼看穿"我们用的是框架还是 harness"这句销售话术。
【已补 E3】源码核实已补(见第三节,基于 main 分支,核对日 2026-09-27)。E4 运行:源码依赖已装(pnpm,hoisted + ignore-scripts);另用 npx standalone 起过服务(监听 8990),但 agent 实际对话未实跑(缺模型 key),仍标待验证。
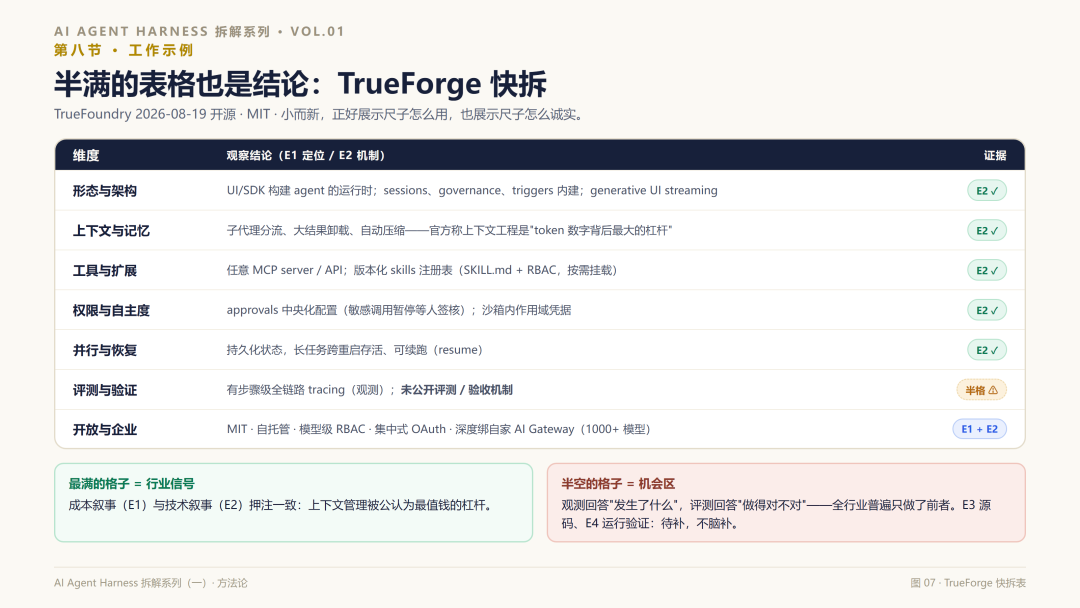
图 07 · TrueForge 快拆表
第九节 · 系列路线图两幕九篇:先立词汇,再看泛化本系列按 harness 的两族排布,两幕推进:先用 code 家族立词汇,再用 work 家族看泛化。Codex CLI 目前仍是纯 code harness,并未跨入 work,放在 code 代表位。产品比最初计划又多了几个,全深拆按 2-3 周一篇就是半年以上的工程,必然烂尾,所以分层控制深度:Tier A 全深拆(七维 + 生命周期走读 + 源码或一手证据)、Tier B 标准拆(七维 + 文档证据为主)、Tier C 收官横向对比(全产品同表)。
| 篇目 | 产品 | 为什么放这个位置 |
|---|---|---|
| 02 | Claude Code | 机制词汇表的出生地,文档体系最全;系列的流量入口 |
| 03 | Codex CLI | OpenAI 门面,开源 Rust 可做源码级;目前仍是纯 code harness,未跨入 work |
| 04 | Claude Cowork | 一般 harness 的参照系:官方机制文档最全的 work 产品 |
| 05 | OpenWork + OpenCode | "work 外壳骑 code 引擎"的分层标本;开源可源码级,且是我的一手材料 |
| 06 | ZCode | 国内 work 一体化的顶点;我的日常主力工具,一手材料最多 |
| 07 | DeepSeek Harness(dsh) | 模型厂商按 harness 理念开源的正牌样本(everything-is-a-plugin);与 ZCode 构成"厂商下场"的两种姿势对照 |
| 08 | 国内 work 产品合集 | WorkBuddy / 悟空 / 飞书 OpenClaw:巨头围剿一般 harness 的打法对比;证据以 E1/E2 为主,正好实测分级规则 |
| 09 | 收官对比篇 | 两族同表:垂直 vs 一般、开源 vs 闭源、引擎 vs 外壳;产出总表与选型清单 |
节奏:2-3 周一篇;每篇文首锚定"基于版本 X / 文档核对日期 Y"。Gemini CLI、Qwen Code、Grok Build、TrueForge 不设单篇,收官篇同表收录。
图 08 · 两幕九篇路线图
第十节 · 方法论的边界四条诚实声明1. 设计分析 ≠ 效果测量。本系列读设计,不做 benchmark。谁比谁强需要另一套实验,那是 eval 项目的领土,不是拆解文章的领土。
2. 文档会撒谎(滞后、美化)。开源产品以源码为准;闭源产品只能文档 + 一手,靠证据等级让读者自己加权。
3. 一手观察是 n=1。用作线索,不用作结论。
4. 七个维度相互纠缠(权限影响并行、上下文影响验证)。切面是分析工具,不是物理事实。
结语一套尺子(七维),一条时间轴(生命周期),四级证据(E1–E4),一个禁止项(不脑补)。剩下的是体力活:一个一个拆。
下一篇开始拆 Claude Code。如果你想优先看到哪个产品,或者对尺子本身有异议,尤其认为某个维度该拆、该并,欢迎留言。方法论是拿来用的,不是拿来供奉的。
参考资料
Agent Frameworks, Runtimes, and Harnesses — LangChain 博客(langchain.com)
Comparing Open-Source AI Agent Frameworks — Langfuse(langfuse.com,2026-07)
A Comparison of AI Agent Harnesses in 2026 — Winder.AI(winder.ai,2026-08)
truefoundry/trueforge — GitHub 仓库(github.com/truefoundry/trueforge)
TrueForge 产品页 — TrueFoundry 官网(truefoundry.com/trueforge)
Claude Cowork 产品页 — claude.com/product/cowork(2026-09-24 抓取)
Building Effective Agents — Anthropic Engineering(anthropic.com,2024-12)
ReAct: Synergizing Reasoning and Acting in Language Models — arXiv 2210.03629(2022)