
Holo4:驱动通用型计算机使用智能体
Holo4 是我们推出的新一代 Agentic 模型系列。该系列提供两种规格:27B 稠密模型和 35B-A3B 混合专家(Mixture of Experts, MoE)模型。两者均已通过 H Models API 开放使用。同时,我们还发布了 Holotron 3 的更新版本:Holotron4 Nano。
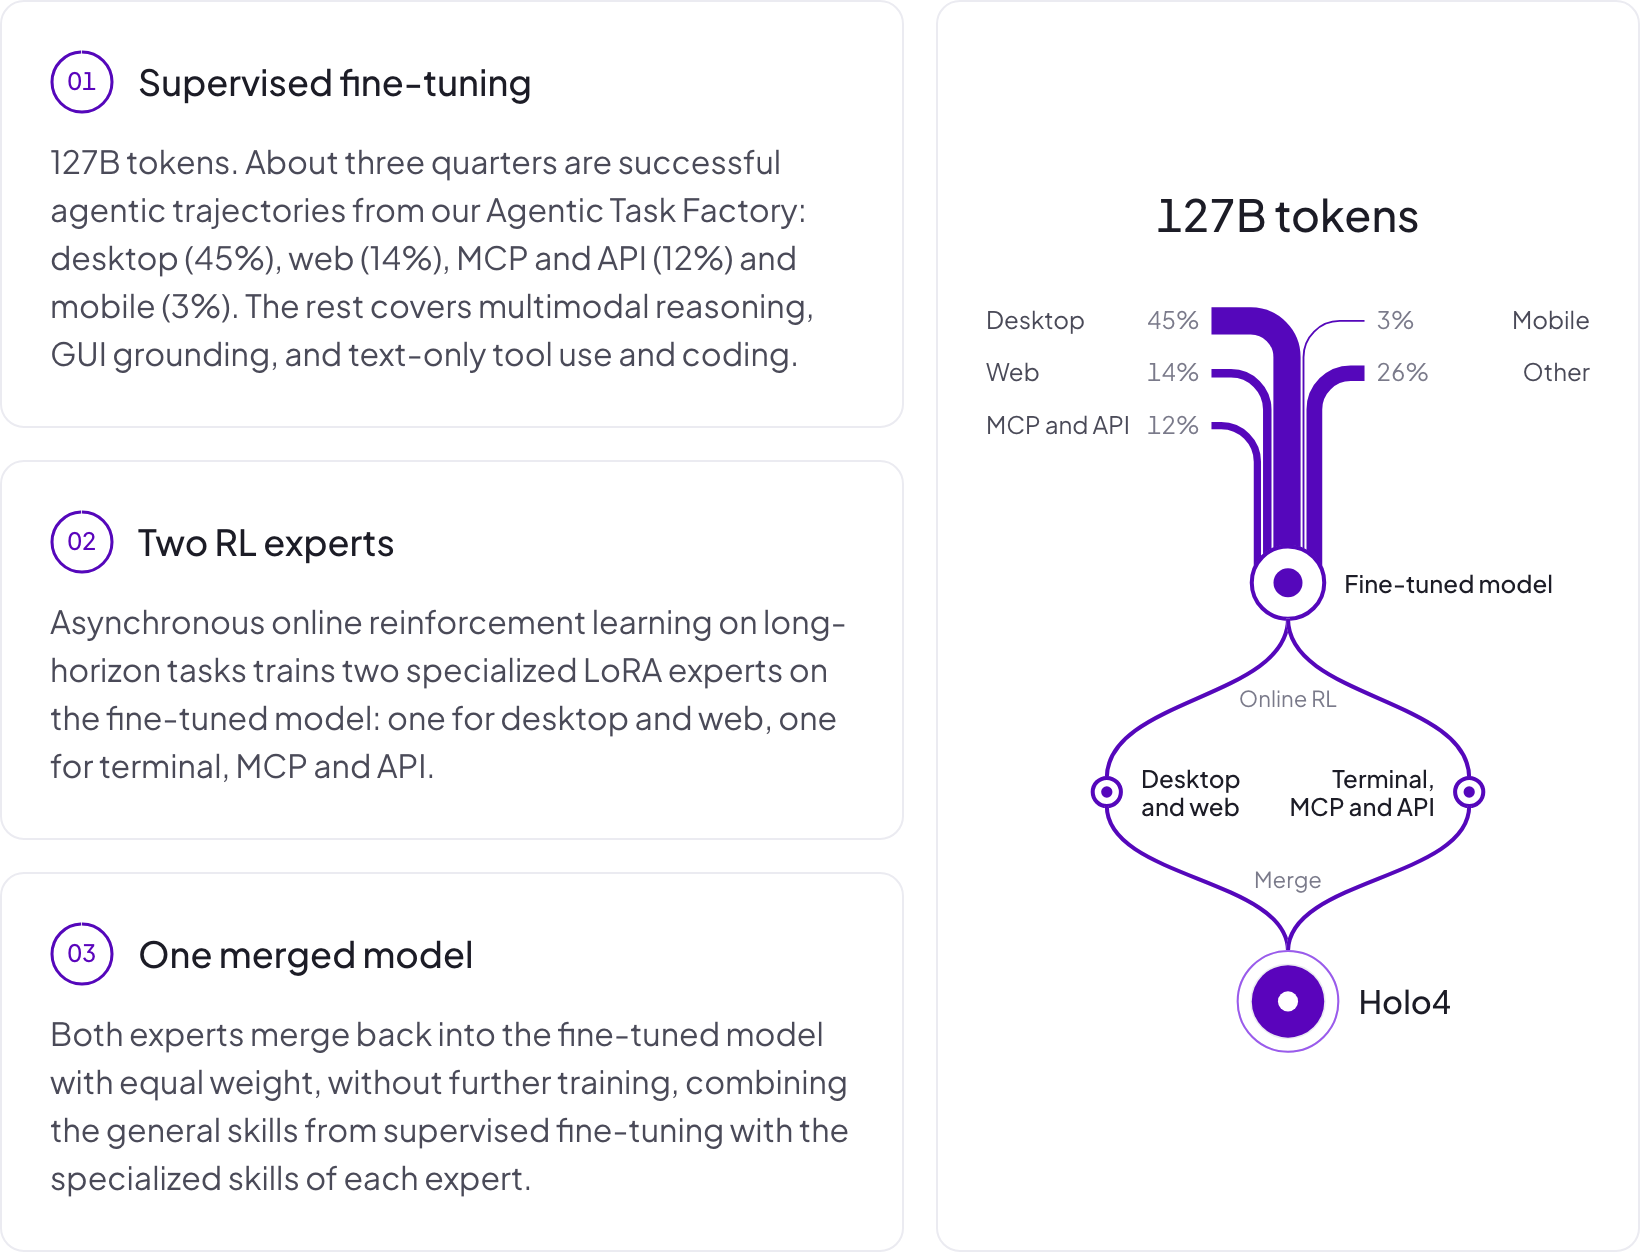
Holo4 在前代模型基础上进行了增强,能够通过各种可用接口与软件交互,包括 GUI、代码、MCP 和 API。虽然在学术基准测试中表现优异,但我们设计它的初衷是服务于真实的业务流程。该模型在包含 Agentic Task Factory 生成内容在内的大量环境和任务中,通过监督学习和强化学习进行训练。
立即上手:
- 🤖 模型: Holo4-27B | Holo4-35B-A3B | Holotron4 Nano
- 🗂️ 完整资源包(FP16、FP8、GGUF): Holo4
- 🎞️ 轨迹数据: 查看器 | 数据集
- ⚡ H Models API: 快速入门
- 📝 完整博客文章: hcompany.ai/newsroom/holo4
适配所有接口的模型
Holo4 既能模拟鼠标点击和键盘输入,也能编写并运行代码,还能调用 MCP 或 API 工具。它会针对任务自动选择最合适的接口。大多数 Agentic 模型仅针对单一接口进行训练:侧重 GUI 的模型在没有屏幕时如同盲盒,而偏好工具调用的模型在面对无 API 的应用程序时则束手无策。实际工作并非如此割裂,单个业务任务往往需要结合多种交互方式。
Holo4 支持桌面端、Web、Android、代码沙盒以及企业 API。无论在哪种场景下,它都是同一个模型,调用方式也保持一致。用户无需针对不同平台选择不同的模型。
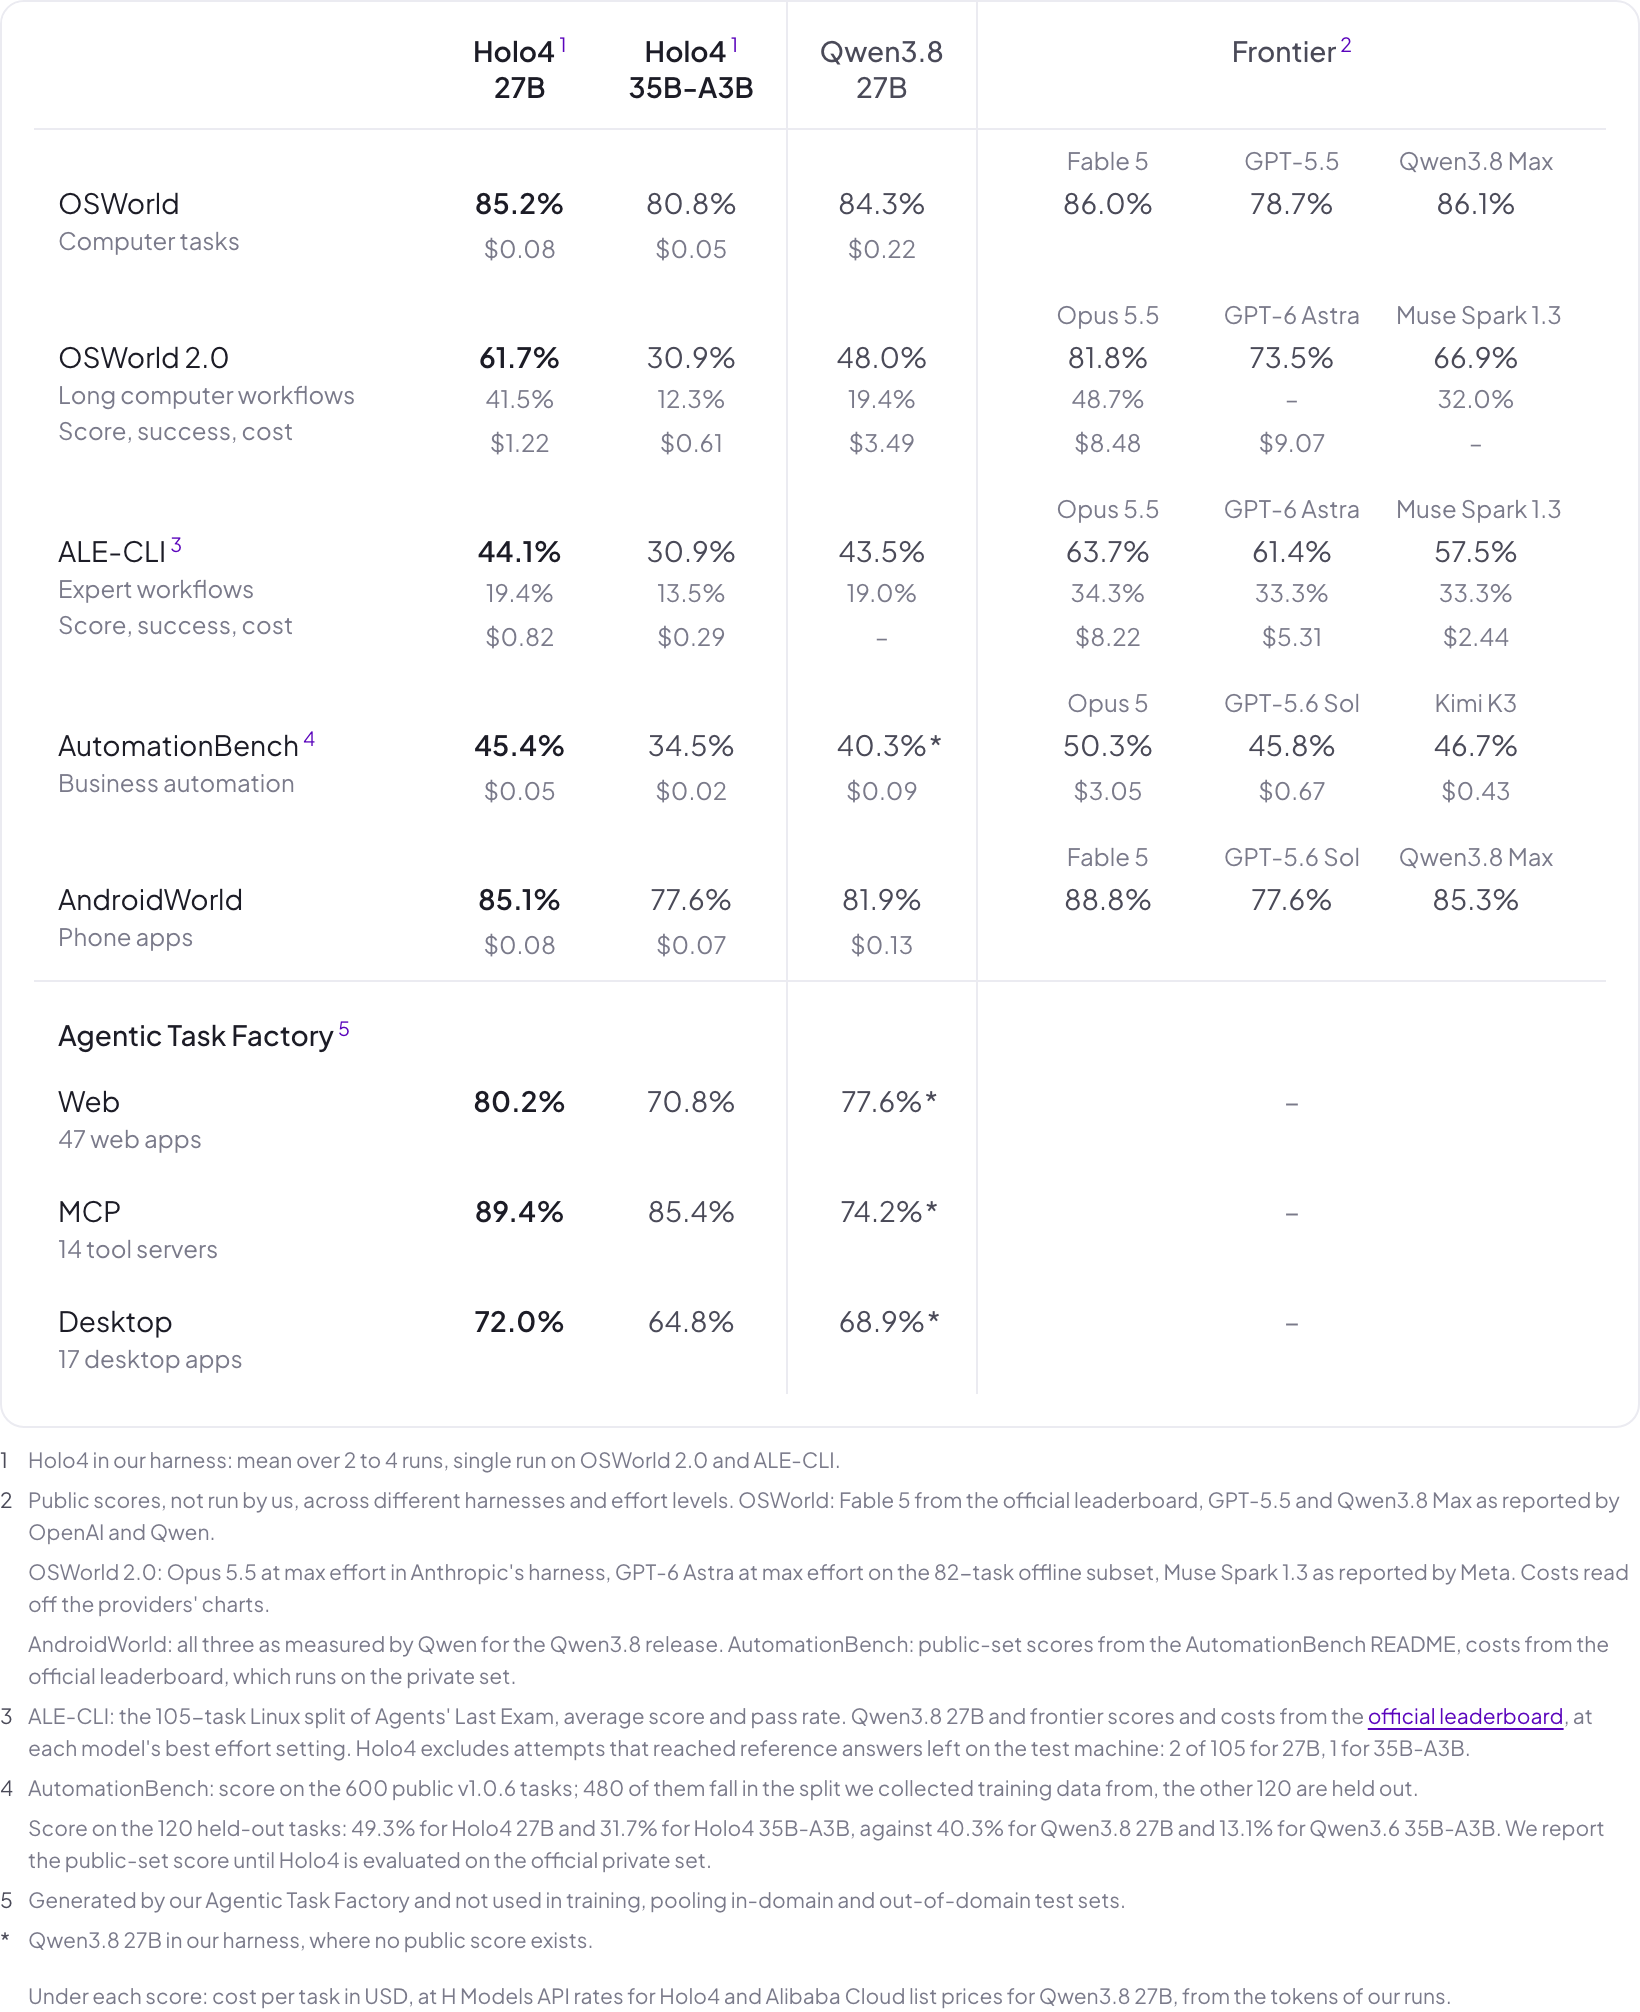
Holo4 模型在 Qwen 基座模型基础上实现了显著提升。在长流程任务中,Holo4 的表现仅略逊于最强的闭源模型:在 OSWorld 2.0 上,Holo4 27B 得分为 61.7%,而 Opus 5.5 为 81.8%;Holo4 35B-A3B 得分为 30.9%。然而,Holo4 实现这些性能所需的参数量要少几个数量级,且成本大幅降低。我们在公开基准测试中开放了所有评分轨迹数据:您可以在 trajectories.hcompany.ai 逐步回放,或从 Hugging Face 下载。
以低几分之一的成本媲美前沿模型
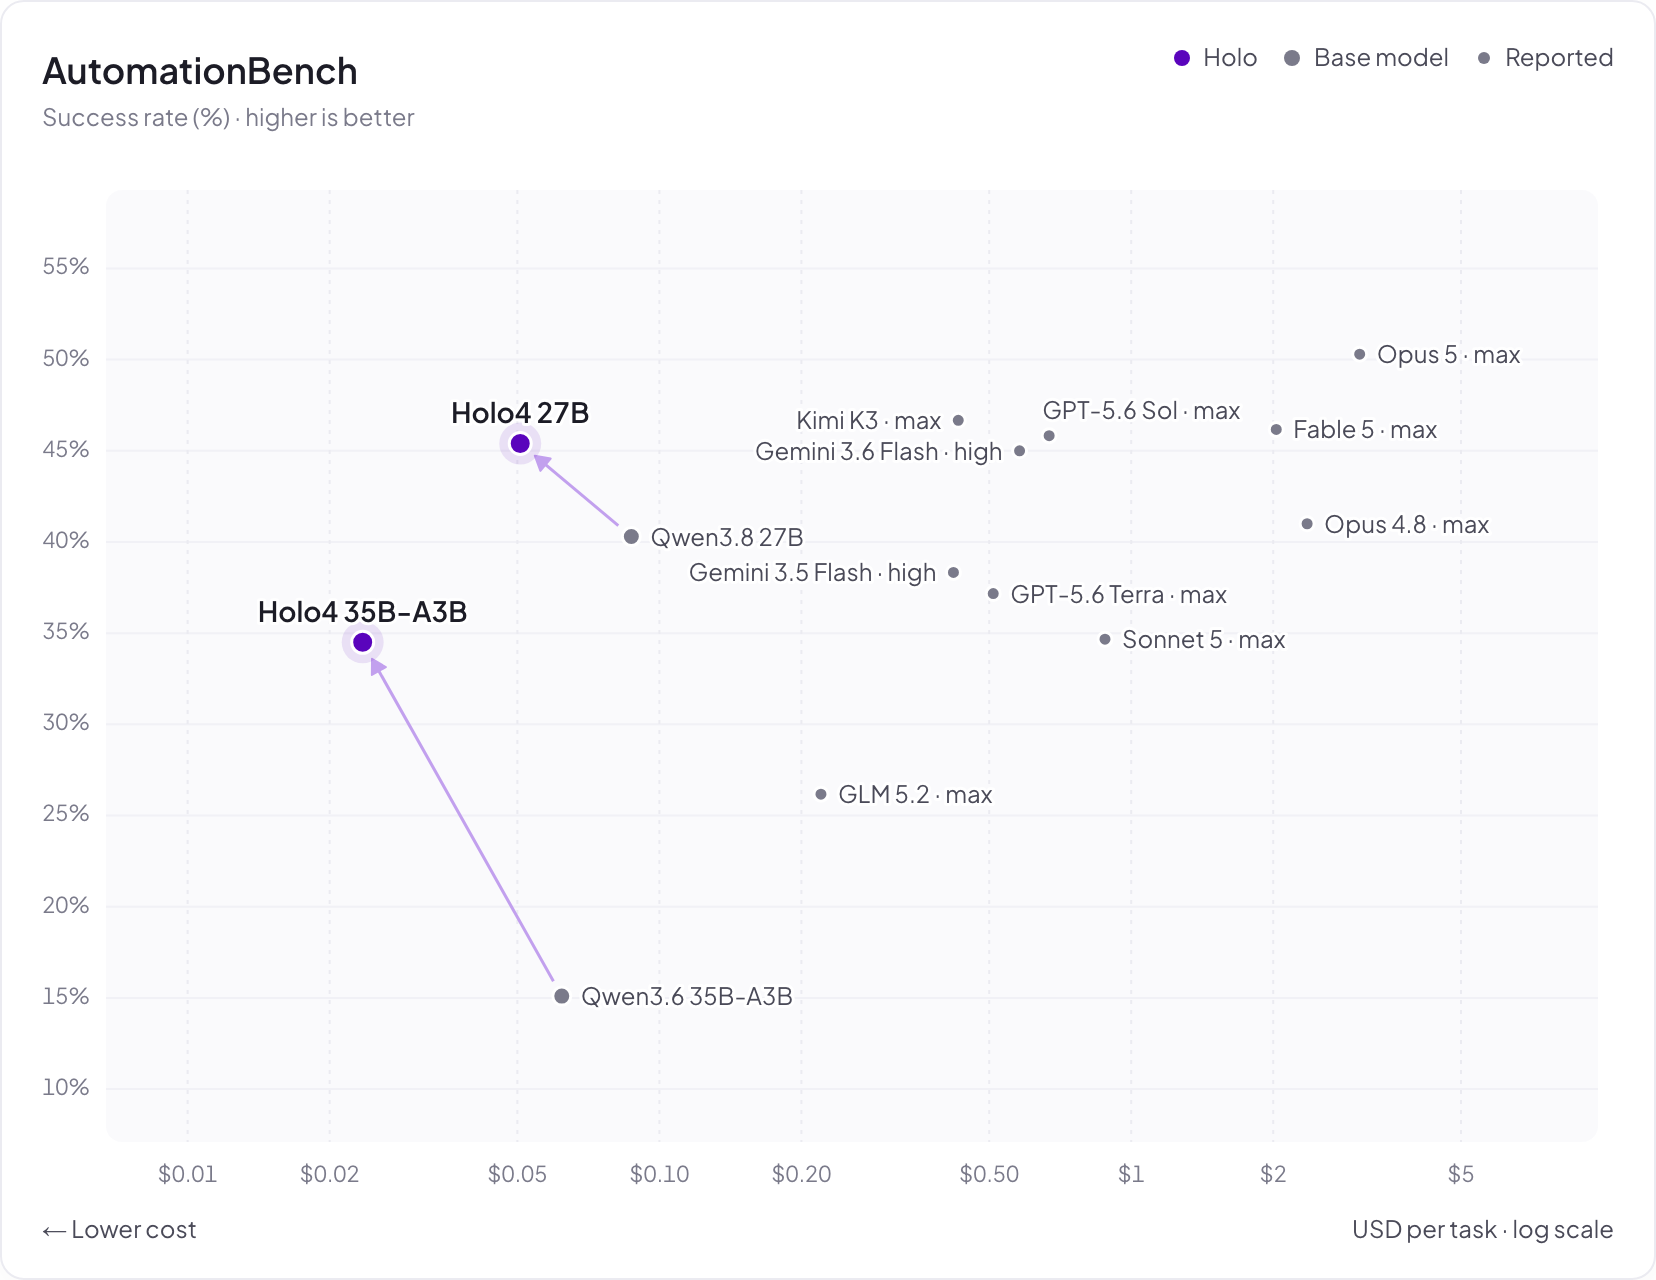
在最严苛的桌面控制学术基准(OSWorld 2.0)和 API 使用基准(AutomationBench)上,Holo4 以远低于前沿模型的单次任务成本实现了可比的性能。
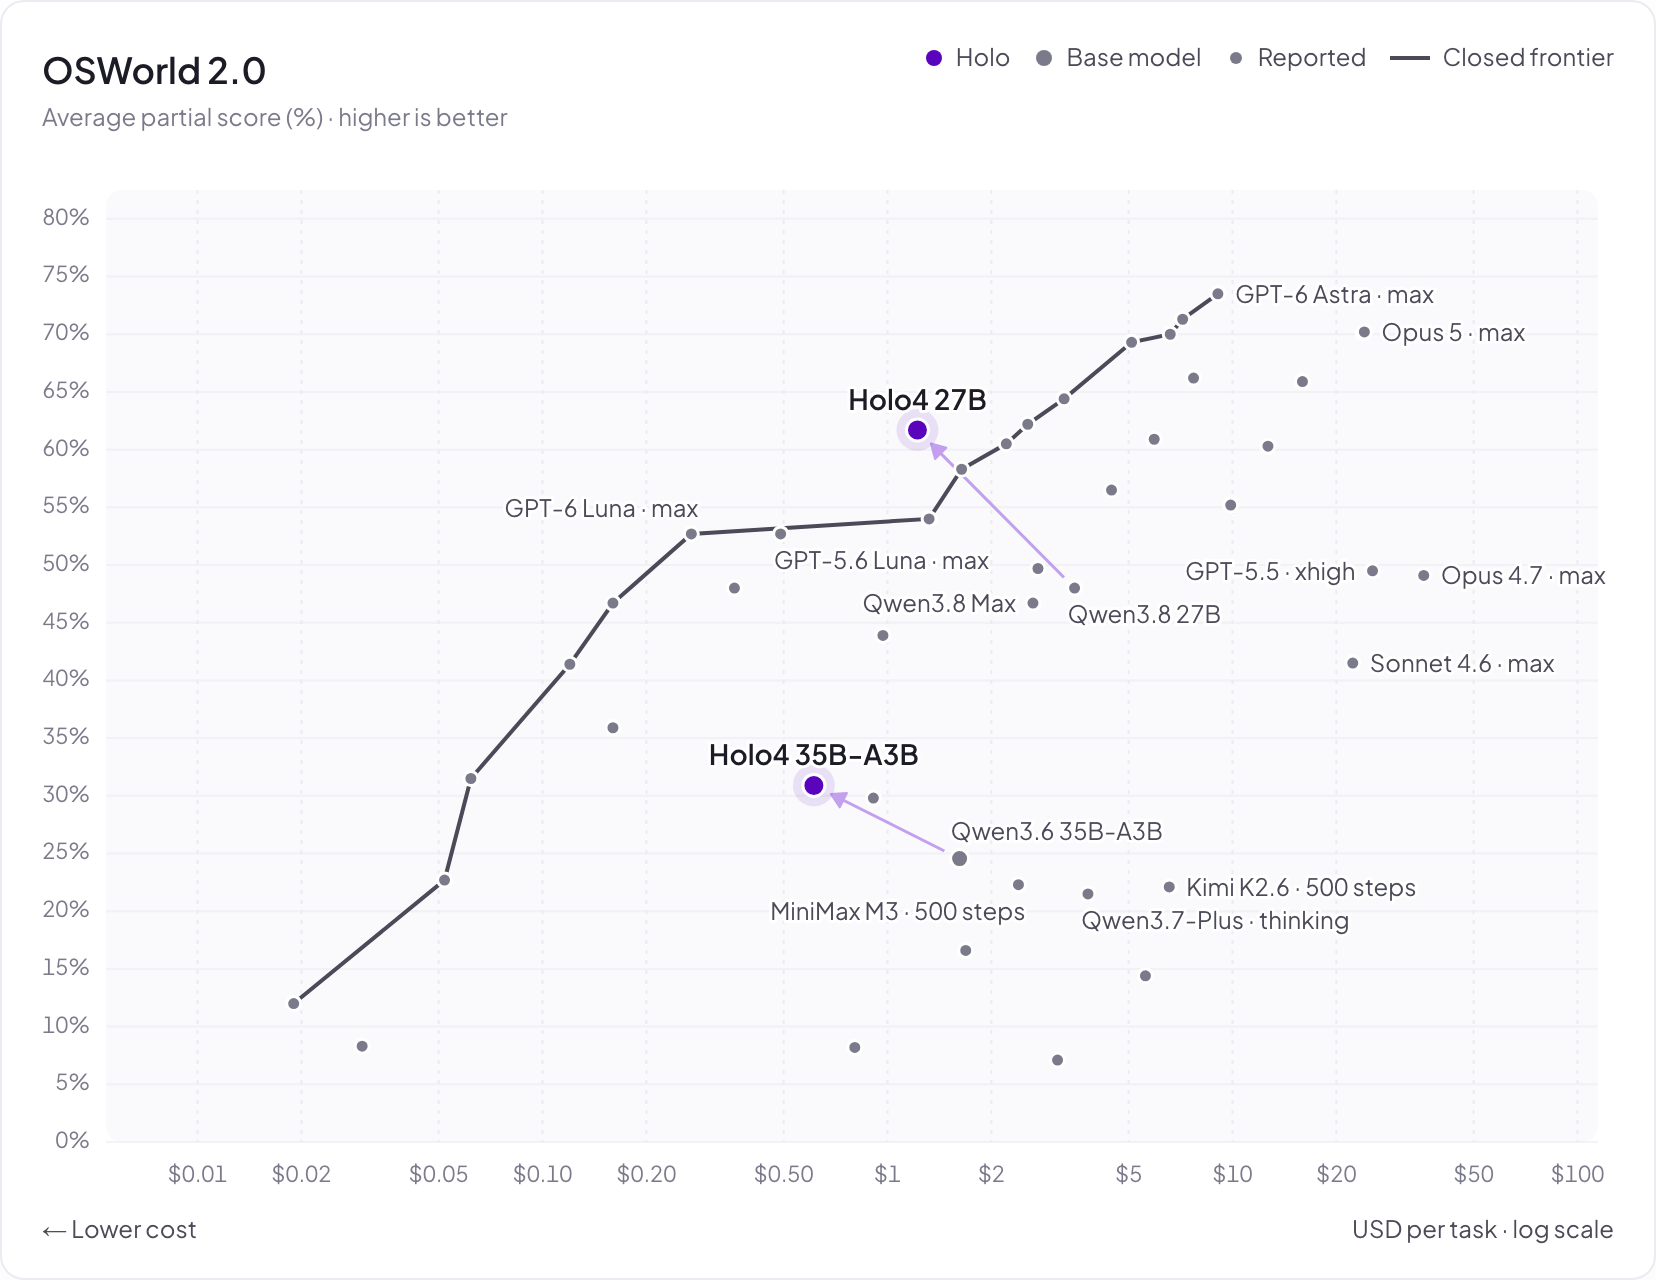
OSWorld 2.0。成本根据每次智能体运行的输入和输出 Token 数估算。Holo4 的价格按 H Models API 费率计算(单次运行)。Qwen3.8 27B:分数来自模型卡片,成本基于阿里云官方标价计算我们的运行 Token。Qwen3.6 35B-A3B:在我们的框架中单次运行,按阿里云官方标价计算,缓存命中部分的输入价格按 20% 计算。GPT 和 Opus 的算力消耗数据来自 OpenAI 的发布数据;其他闭源和开源权重点使用 官方 OSWorld 2.0 排行榜。不同模型发布的版本、运行框架及任务子集存在差异。图中的连线展示了闭源模型中非支配的得分-成本对;Holo4 未包含在内。
AutomationBench。Holo4、Qwen3.8 27B 和 Qwen3.6 35B-A3B 的成绩来自 AutomationBench v1.0.6,分数和成本均在我们内部测试环境中测量。其他模型的公开集分数来自 AutomationBench README,单任务成本来自官方排行榜(该榜使用私有集测评)。Holo4 在私有集上的成绩将在测评完成后公布。
能真正干活的 AI
Holo4 系列模型在我们 Agentic Task Factory 提供的环境和任务上训练,在专业软件操作方面表现出色。下面的示例将 Holo4 27B 与其基座模型 Qwen3.8 27B 进行对比,两者使用相同的提示词和测试环境。
3D 建模 · 埃菲尔铁塔
在 FreeCAD 中构建埃菲尔铁塔的 3D 模型,比例尺为 1 毫米比 1 米,以原点为中心,沿 X、Y 轴对齐。请按以下设计要求建模。
铁塔在每个高度的水平截面都是正方形,绝不是圆形。从中心轴到角点的半宽:地面处为 62.5 mm,高度 57 处为 32.5 mm,高度 115 处为 17.5 mm,高度 276 处为 9.35 mm。各高度之间的半宽沿平滑曲线过渡,靠近地面处收窄较快,越往上收窄越缓,绝不能是直线。
四条完全相同的塔腿,每个象限一条,每条都是一个方形柱体,其外侧角沿上述轮廓变化。每条塔腿在地面处宽 14 mm,到高度 276 处收窄至 4 mm。塔腿从地面起相互分离,向上逐渐收拢汇聚。塔腿之间没有任何填充物:整座塔是通透的,从任何一侧都能直接看穿。
三层平台,每层都是以上轴为中心的实心方形板:高度 57 处,宽 72 mm、厚 4 mm;高度 115 处,宽 40 mm、厚 3 mm;高度 276 处,宽 22 mm、厚 3 mm。
一根塔桅,从高度 276 延伸到 324,为方形,底部宽 8 mm,收窄至顶端 2 mm。
每个部件必须是体积非零的封闭实体,且任何部件都不得填充塔腿之间的空间。
Holo4 27B(84 次调用,1.3M tokens)
Qwen3.8 27B(60 次调用,1.0M tokens)
3D 建模 · H logo
在 FreeCAD 中创建 H 公司标志的 3D 模型:一个实心圆盘紧挨着一个方块无衬线大写字母 H。两者拉伸至相同厚度,高度大致相当,并排分布互不重叠,圆盘中心与 H 的中线齐平。将这两个形状均设为黑色。
Holo4 27B(94 次调用,150 万 token)
Qwen3.8 27B(118 次调用,190 万 token)
游戏设计 · 吃豆人
用 Godot 开发一款吃豆人风格的游戏,并让其保持运行状态。
在网格上布置矩形迷宫墙壁,所有开放通道中填满豆子。玩家标记沿通道连续移动,经过豆子时将其吃掉并计分。三个幽灵在同一通道中移动并追击玩家。若幽灵捕捉到玩家,玩家失去一条生命,所有元素重置回初始位置。得分和剩余生命显示在屏幕上。
没有人会实际游玩这款游戏。玩家由简单的启发式算法驱动:在每个路口,它向最近的豆子移动;除非附近有幽灵,此时它会远离幽灵。游戏必须无人值守、无限期运行,且不依赖任何键盘输入。
当功能正常时,启动游戏并让它持续运行。
Holo4 27B(68 次调用,240 万 token,268 行代码)
Qwen3.8 27B(197 次调用,1140 万 token,327 行代码)
Holo4 的构建过程
智能体任务工厂
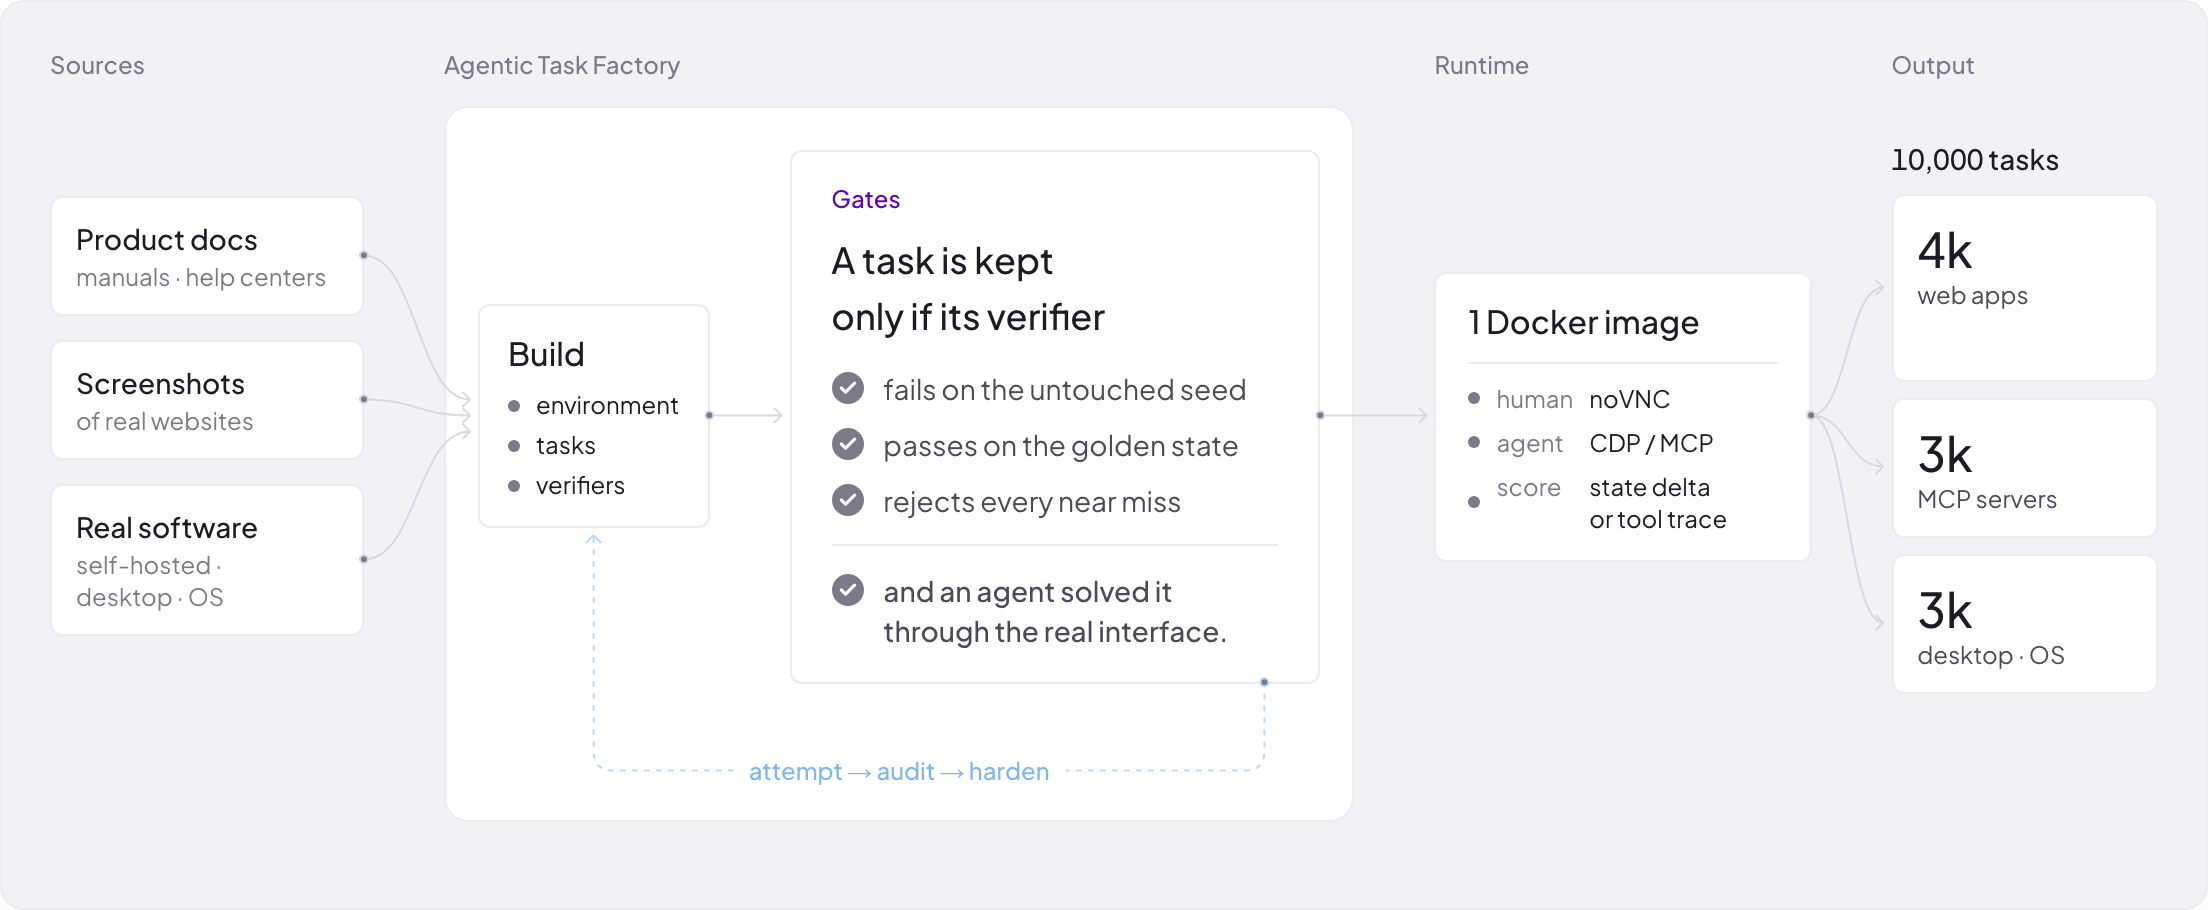
我们内部的智能体流水线仅基于文档(如真实网站截图或开源软件)即可构建交互式环境和可验证的任务。目前,它已生成约 10,000 个任务,涵盖 Web 应用、MCP 服务器及桌面环境,包括通过 GUI 和 MCP 暴露相同状态的混合环境。
训练
驾驭框架
除了模型训练,我们还重构了驾驭框架(harness),即执行模型动作并在数百步中管理上下文的循环。我们利用该智能体在 OSWorld 2.0 上的性能反馈进行优化:智能体会标注每项任务失败的原因,工程师则审查相应的修复方案。最大的两项改动是:为智能体配备可靠的记忆机制,使其能够追踪数百步的操作;以及在桌面机器本身提供 shell 终端。
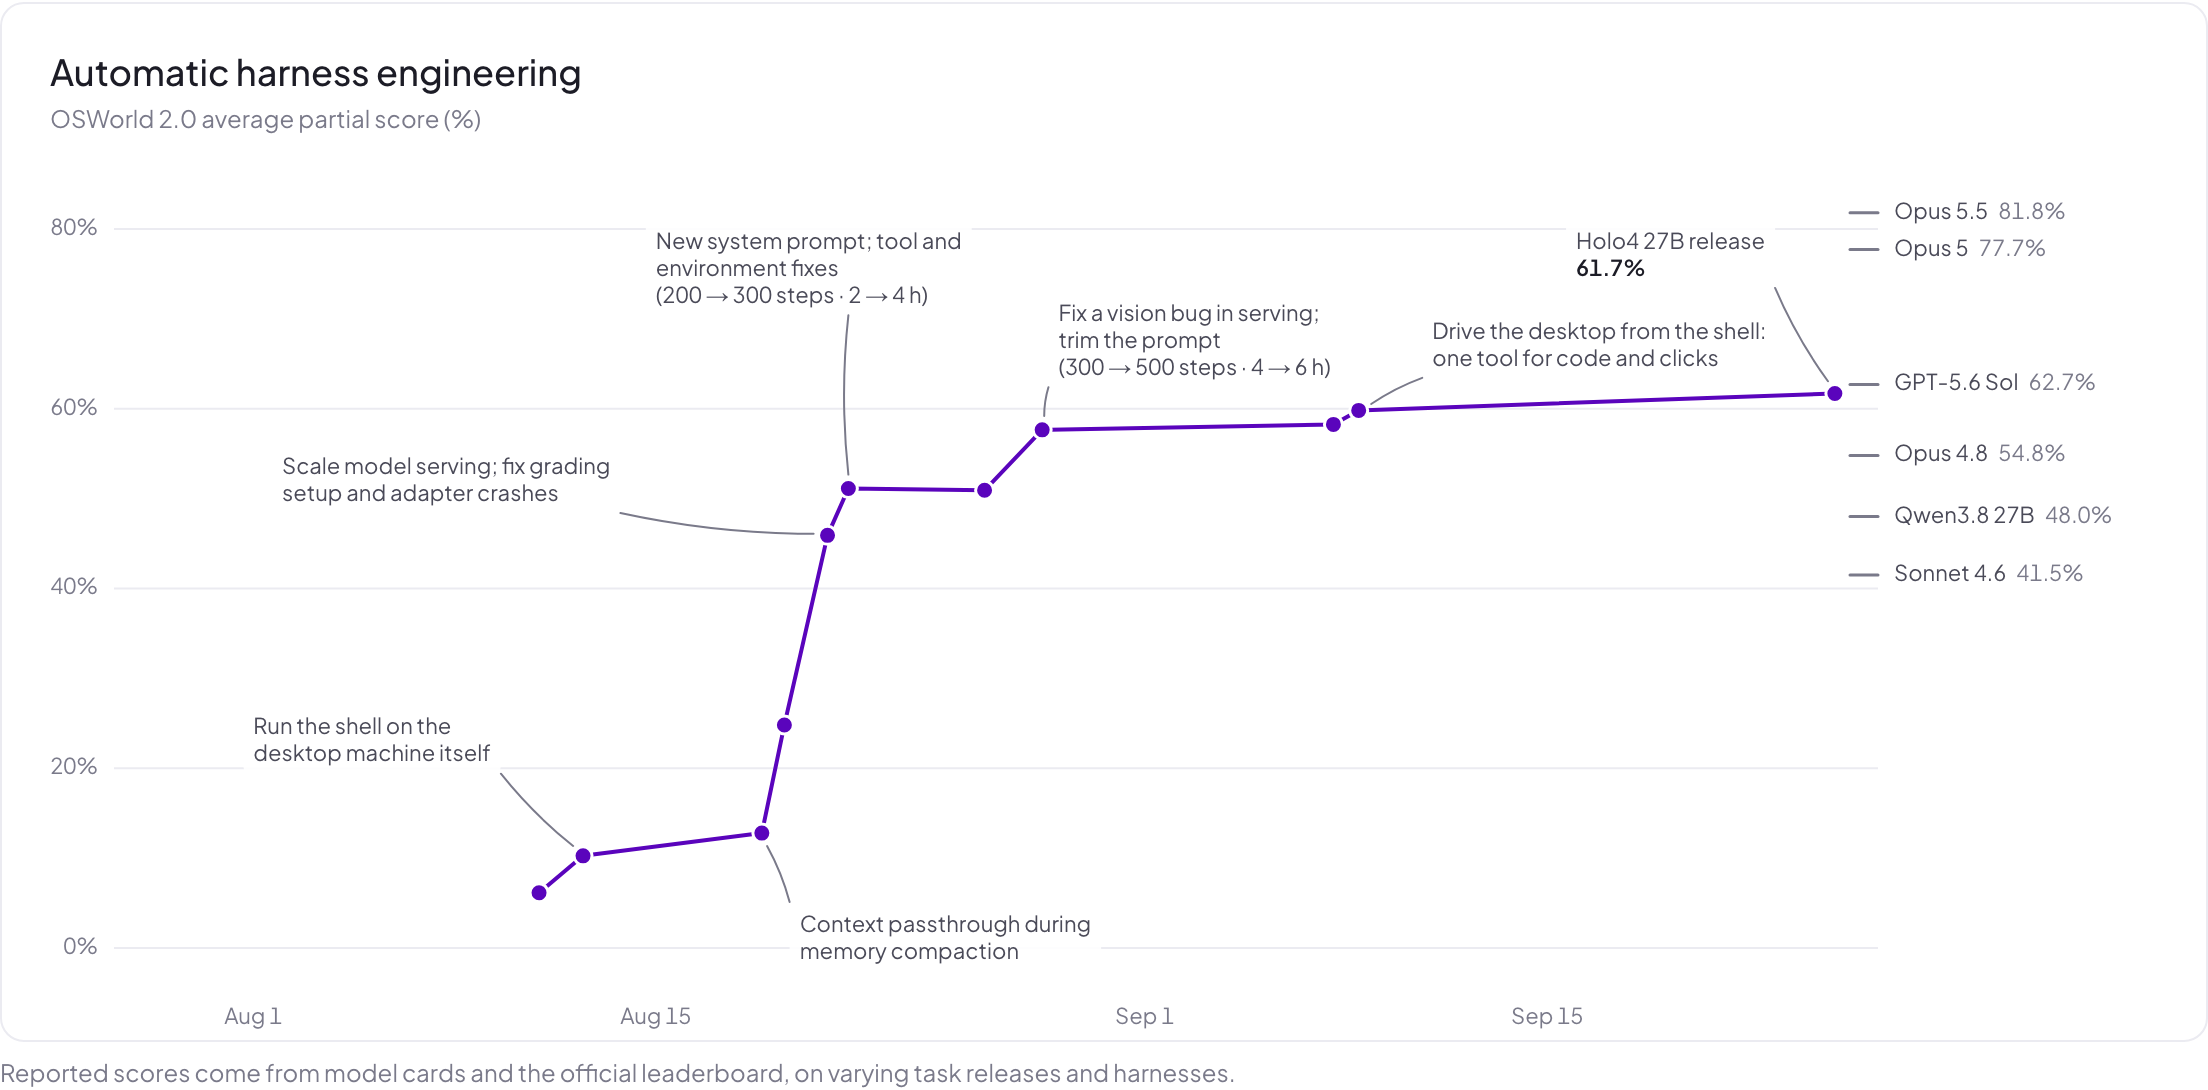
Opus 5(70.2%)和 GPT-5.6 Sol(66.2%)在 OpenAI 发布图中的 v2026.08.08 离线数据集上采用最大努力的局部奖励策略,与成本-性能图表中的结果一致。其他参考分数来自模型卡片和官方排行榜。请注意,任务发布时间、子集选择及驾驭框架存在差异。
Holotron4 Nano
我们的后训练堆栈旨在适应新的基础模型,并产出具备跨界面和环境泛化能力的智能体。作为 NVIDIA Nemotron 联盟 的成员,我们将最新的技术栈应用于 Nemotron 3 Nano Omni 模型,作为 Holotron 3 的后续工作。
同样的配方将 Nemotron 3 Nano Omni 转化为 Holotron4 Nano,这是一个通用型智能体模型,相比基础模型,在 GUI 工作流以及暴露了 MCP、API 或代码沙箱的环境中表现显著提升。
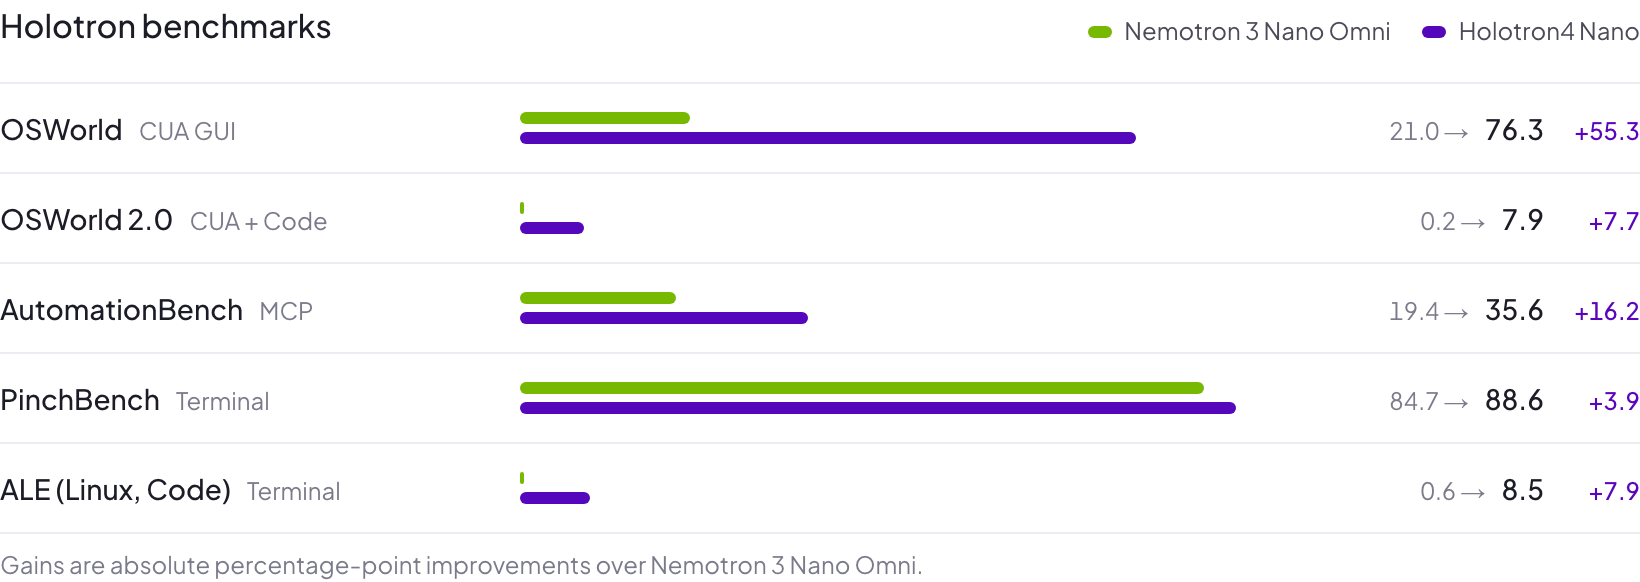
提升幅度为相对于 Nemotron 3 Nano Omni 的绝对百分点增长。
这些提升说明我们的方法具备良好的可迁移性,能把通用模型打造成智能体专家。而且这套方法对模型规模没有任何限制。
自己动手试试
两种规模现已在 H Models API 上线。权重已在 Hugging Face 发布,提供 BF16、FP8、NVFP4 和 4-bit GGUF 格式,同时发布的还有我们的小模型 Holotron4 Nano。
未来几天我们还将发布优化后的 DSpark drafter 检查点,进一步加速推理。