
AIAgent攻克建筑工程难题!AEC-Bench:首个多模态智能体基准,重新定义图纸理解
AI Agent攻克建筑工程难题!AEC-Bench:首个多模态智能体基准,重新定义图纸理解
本文深度解析arXiv 2026最新顶会论文《AEC-Bench: A Multimodal Benchmark for Agentic Systems in Architecture, Engineering, and Construction》,揭秘建筑工程(AEC)领域首个多模态智能体评测基准,直击AI图纸理解、跨文档推理的核心痛点,用实测数据告诉你主流大模型在真实工程场景中的真实水平。
建筑、工程与施工(AEC)是万亿级实体产业,施工图纸审核、跨文档协同、规范校验是决定项目工期与成本的核心工作。一套完整的工程图纸包含上百页PDF、密集标注、几何线条与跨页引用,纯人工审核效率极低,而现有AI Agent却屡屡翻车:文本提取丢失空间结构、视觉模型看不懂工程符号、跨文档推理频繁出错。
2026年3月,Nomic AI联合行业专家发布AEC-Bench,这是全球首个面向AEC领域的多模态智能体基准,覆盖单页图纸理解、跨页推理、项目级文档协同三大真实场景,系统性评测GPT、Claude等主流模型的工程能力。本文结合论文核心数据与图表,完整拆解这项填补行业空白的突破性研究。
一、行业痛点:AI为何搞不定工程图纸?
论文开篇直指AEC领域AI落地的三大核心壁垒,也是所有工程数字化的共性难题:
- 1. 多模态信息高度耦合:工程图纸是文本+几何+符号的混合体(图2),纯OCR会丢失空间关系,纯视觉模型无法理解专业标注;
- 2. 信息分散跨页跨文档:关键数据分布在单页、多图纸、规范文档中,需要长链路推理与精准检索;
- 3. 通用Agent水土不服:代码型智能体只会用命令行提取文本,彻底抛弃图纸的空间结构,视觉定位与专业判断能力近乎为零。
此前的AI评测基准要么聚焦纯文本推理,要么仅做简单文档VQA,完全脱离真实工程协同 workflow,而AEC-Bench的诞生,正是为了解决这一核心空白。
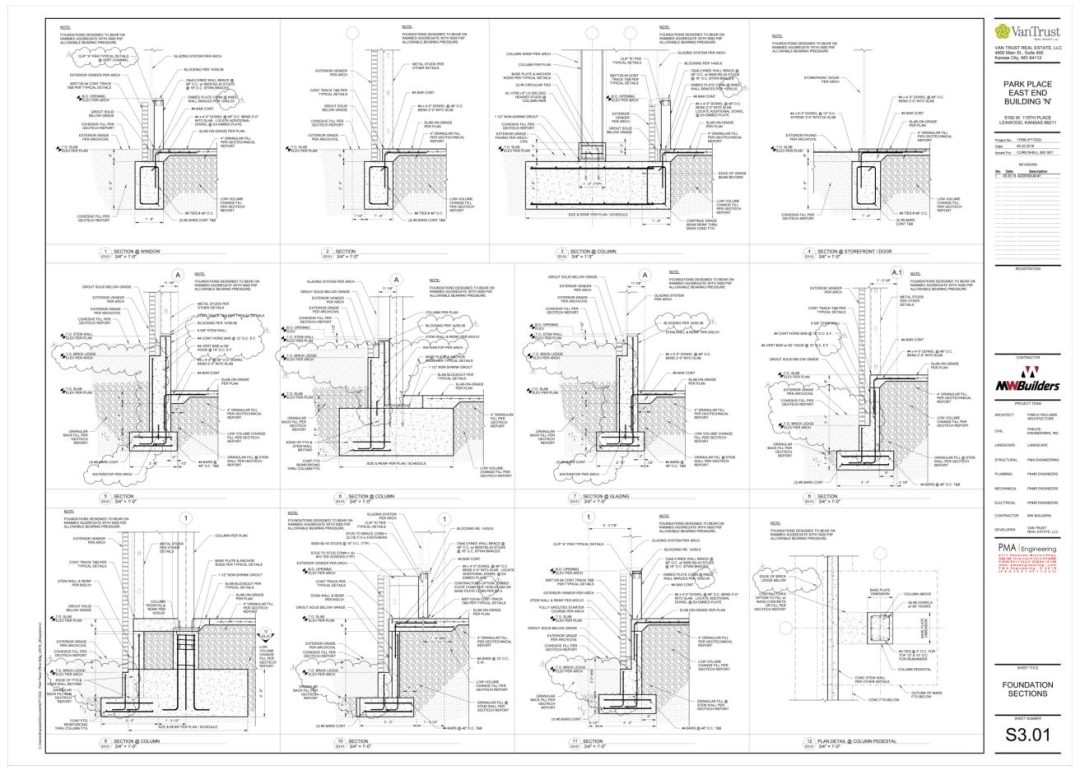
图2 真实复杂施工图纸样本:标注密集、线条交错、跨引用嵌套,是AEC领域的典型工作场景
二、AEC-Bench核心设计:三级任务,覆盖全工程场景
AEC-Bench由行业专家全程参与构建,基于真实公共工程项目图纸,人工注入合规缺陷,最终形成9大任务类型、196个评测实例,严格按照「上下文范围」划分三级难度,完美匹配工程审核工作流:
2.1 任务分类体系(核心创新)
- • Intra-Sheet(单页推理):仅需单页图纸即可完成,如标注校验、细节标题匹配;
- • Intra-Drawing(跨页推理):同一图纸集多页联动,如跨引用校验、索引一致性检查;
- • Intra-Project(项目级协同):跨图纸+规范+报审文件,如规范冲突检测、报审合规性审核。
2.2 数据集全景
论文表1完整统计了基准的任务分布,覆盖建筑、结构、机电全专业,是目前AEC领域最全面的智能体评测集:
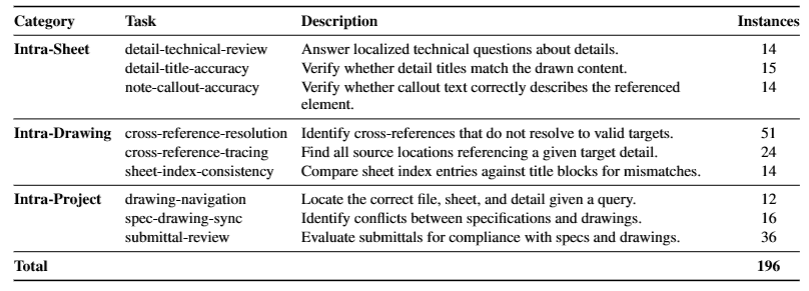
表1 AEC-Bench数据集统计:3大类别、9大任务、196个真实工程实例
同时,团队通过「原图-缺陷图」对照构建评测样本,图3展示了跨引用校验、标注匹配两大核心任务的前后对比,缺陷注入完全贴合真实工程错误:
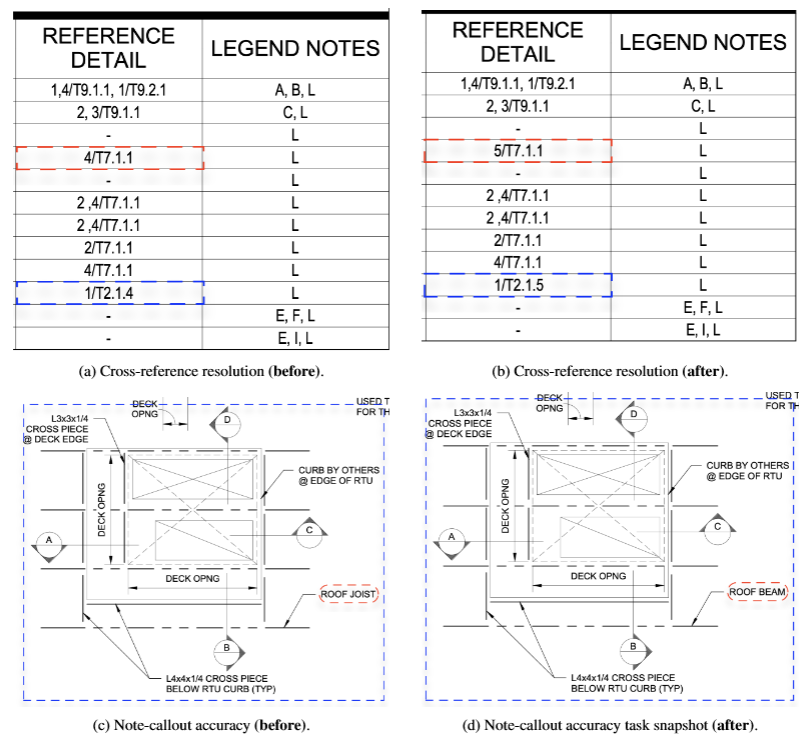
图3 任务样本前后对比:上为跨引用编号错误、下为标注文本不匹配,最小化视觉干扰保证场景真实性
三、硬核实测:主流大模型工程能力全曝光
团队选取GPT-5.4/5.2、Claude Opus 4.6/Sonnet 4.6四大主流模型,设置两组对照实验:
- • H(基础套件):仅提供命令行、PDF工具,模拟通用代码Agent;
- • H+(增强套件):新增Nomic结构化解析工具,强化图纸信息提取。
评测指标为平均奖励值(0-100,越高越好),核心结果分为可视化对比与精细化数据两部分:
3.1 整体性能对比
图1直观呈现了各模型在三级任务中的平均表现,增强套件显著提升检索类任务性能,但单页视觉任务提升有限:
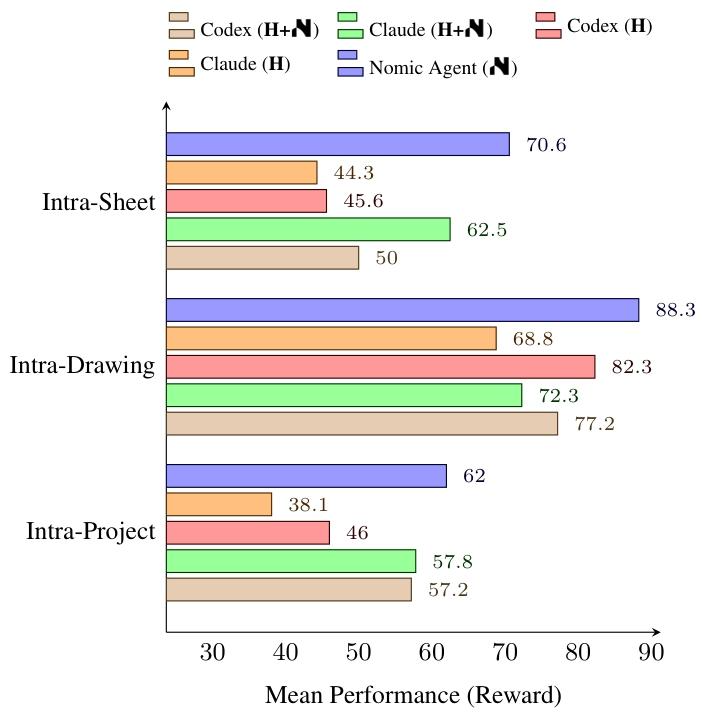
图1 各模型三级任务平均奖励对比:项目级任务是所有模型的共同短板
3.2 全任务精细化得分
论文表2给出了9大任务的逐模型得分,核心结论一目了然:
- 1. 检索类任务暴涨:图纸导航、规范同步任务,H+套件最高提升100%;
- 2. 视觉任务原地踏步:标注匹配、跨引用追踪任务,得分普遍低于40,增强工具无效;
- 3. 专业判断全军覆没:报审文件审核任务,所有模型最高仅23.1分,是行业最大卡点。
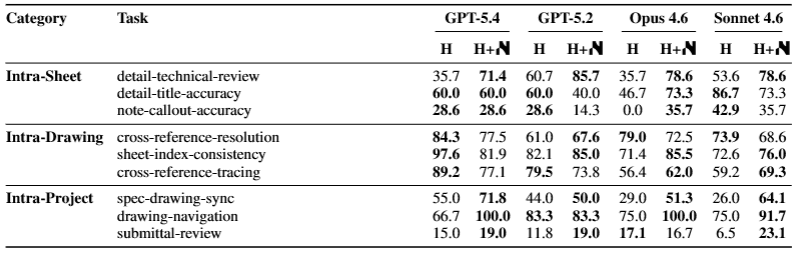
表2 全任务模型得分明细:加粗为最优成绩,结构化工具仅对检索类任务有效
四、核心发现:AI Agent的三大致命短板
基于上万次实验,论文总结出通用智能体在AEC领域的三大系统性缺陷,这也是所有行业落地的关键瓶颈:
- 1. 检索是第一瓶颈:80%的失败源于Agent找不到关键图纸/段落,而非推理能力不足;
- 2. 视觉空间定位能力缺失:需要追踪引线、匹配几何位置的任务,成功率仅5%,图像渲染≠空间理解;
- 3. 专业判断能力空白:报审审核等需要工程经验的任务,模型频繁误报,无法匹配行业标准。
更值得关注的是:所有模型都在「用写代码的方式看图纸」——77%的操作依赖文本提取工具,直接丢弃空间结构,这是通用Agent水土不服的核心原因。
五、总结与展望
AEC-Bench的价值,不仅是一套评测基准,更是为AEC领域AI Agent指明了落地方向:
核心贡献
- 1. 首个工程 workflow 级多模态智能体基准,脱离纯理论测试;
- 2. 量化证明:结构化解析可解决检索问题,但视觉定位+专业知识才是核心攻坚点;
- 3. 全量开源:数据集、评测代码、智能体套件均以Apache 2.0协议开源,支持行业复现。
未来方向
论文明确了下一代工程AI的进化路径:空间记忆建模+领域知识注入+多模态协同推理,而非单纯依赖文本提取或视觉识别。
结语
当AI Agent在代码、网页领域大放异彩时,AEC-Bench让我们看清:实体产业的AI落地,从来不是模型大小的比拼,而是行业场景的深度适配。
工程图纸的一根引线、一个标注、一条跨引用,背后是几十年的行业经验,这正是AI最需要补齐的短板。AEC-Bench的出现,标志着建筑工程AI正式从「玩具级演示」走向「工业级落地」,而这,才是大模型真正的价值所在。
https://arxiv.org/pdf/2603.29199
**开源地址**:https://github.com/nomicai/aec-bench