
Nginx 的AI限流:让大模型API 不再被刷爆
一、一分钟烧掉两千块
某团队大模型 API 上线第三天,账单显示单日消耗 4800 元。排查发现:一个爬虫脚本以每秒 40 次的速度调用接口。
二、传统限流为什么失效
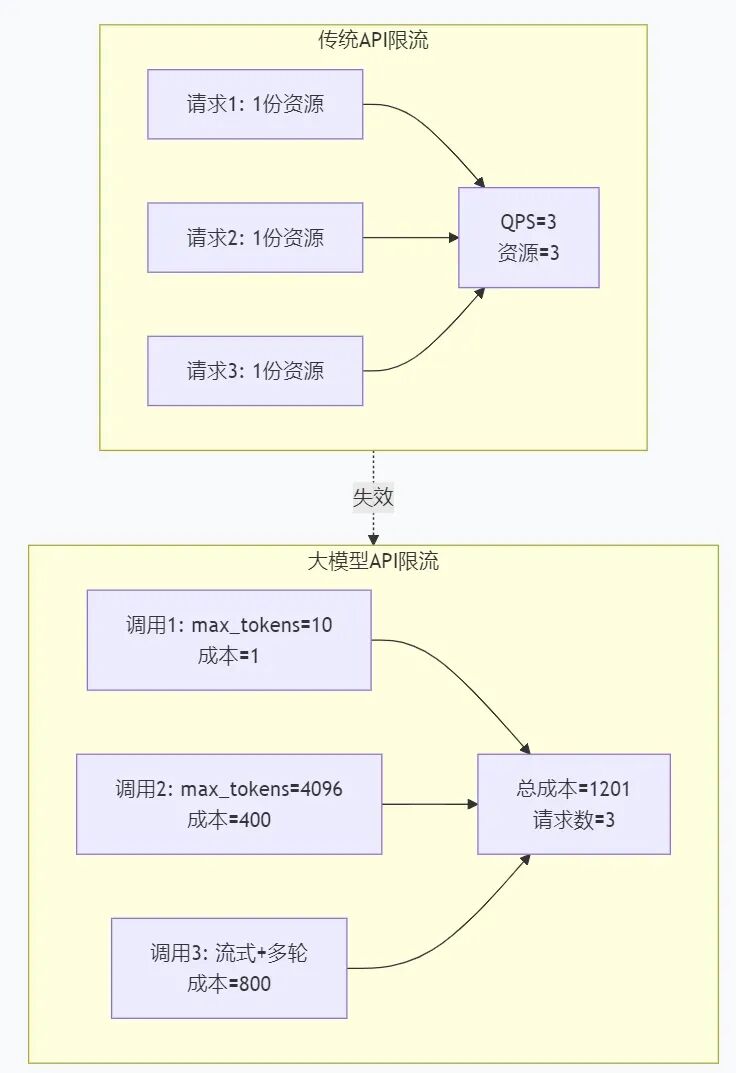
limit_req 按请求数限流。但大模型 API 的每一次调用,成本和耗时可能相差百倍。按次数限流,等于没限。
三、大模型 API 的限流困境:三个维度同时爆炸
3.1 请求数不是成本
传统 Web API 的限流逻辑很直接:一个请求消耗一份资源。限制每秒请求数(QPS),就限制了资源消耗。
大模型 API 打破了这个假设。一次 max_tokens=100 的调用,和一次 max_tokens=4096 的调用,消耗的算力相差 40 倍以上。一次简单的分类请求,和一次复杂的多轮推理,GPU 占用时间可能相差百倍。
如果只用 QPS 限流,攻击者可以用最少的请求数消耗最多的资源。40 次 max_tokens=4096 的请求,比 4000 次 max_tokens=10 的请求更贵,但在 QPS 限流下只占 40 个配额。
3.2 Token 消耗是更准确的成本单位
大模型 API 的成本模型与传统 API 截然不同。它的计费单位是 Token——输入 Token 和输出 Token 分别计价。一次调用的成本 = 输入 Token 数 × 输入单价 + 输出 Token 数 × 输出单价。
这意味着限流的基本单位应该是 Token,而不是请求数。但 Nginx 默认不理解 Token。它看到一个 HTTP 请求,不知道这个请求的 max_tokens 参数是多少,不知道输入文本有多长,更不知道模型实际会输出多少 Token。
3.3 流式响应让计时变得复杂
大模型 API 大量使用 SSE(Server-Sent Events)流式响应。一次调用可能持续 30 秒甚至几分钟,期间连接一直保持打开。传统 Nginx 的 limit_conn 按连接数限流,但一个流式连接消耗的资源远大于一个普通 HTTP 连接。
更麻烦的是,流式响应期间无法预知总 Token 消耗。模型边生成边返回,Nginx 只能看到已经传输的字节数,无法提前判断这次调用会消耗多少资源。
四、改造思路:在 Nginx 层做 Token 预估
4.1 为什么选择 Nginx 层
限流可以放在多个位置:应用层、网关层、Nginx 层。
应用层限流最精确,但需要修改业务代码,且限流逻辑分散在每个服务中。网关层限流(如 Kong、APISIX)功能丰富,但引入了额外的组件和运维成本。
Nginx 层的优势在于:它是流量的第一入口,所有请求都必须经过它。在这里限流,可以最大程度地拦截恶意流量,避免无效请求到达后端 GPU 资源。同时,Nginx 的 Lua 模块(OpenResty)提供了足够的灵活性来实现 Token 预估逻辑。
4.2 Token 预估的核心逻辑
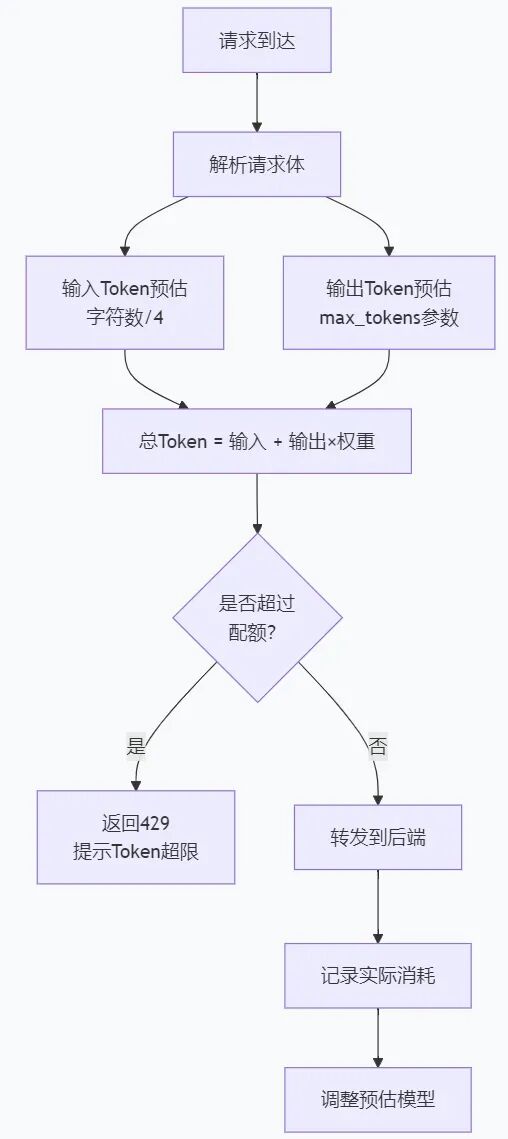
Token 预估的精度不要求 100%。目标是识别“明显异常”的调用——那些单次消耗数十倍于正常值的请求。
预估逻辑分两部分:
输入 Token 预估:对于文本输入,可以用字符数除以 4 作为粗略估算(英文约 4 字符/token,中文约 1.5 字符/token)。对于 JSON 请求体,先解析出 messages 字段的内容,再按上述规则估算。对于多模态输入(图片、音频),按预定义的换算表估算。
输出 Token 预估:从请求体中提取 max_tokens 参数。如果客户端没有指定,使用模型的默认值(通常 4096)。如果指定了,取实际值。
总预估 Token = 输入预估 + 输出预估 × 权重系数。权重系数用于反映输出 Token 的更高成本(输出 Token 通常比输入 Token 贵 2-4 倍)。
4.3 用 Lua 实现 Token 计数
OpenResty 的 lua-resty-limit-traffic 库提供了限流的基础设施,但它是按请求数限流的。我们需要自己实现 Token 计数的逻辑。
核心思路是:在 access_by_lua 阶段,读取请求体,解析 max_tokens 和输入文本,计算预估 Token。然后以 API Key 为维度,在共享内存字典中累加 Token 消耗。如果超过配额,返回 429。
共享内存字典使用 lua_shared_dict 配置,例如 lua_shared_dict token_quota 100m。每个 API Key 的配额可以按时间窗口设置:每秒、每分钟、每小时。
滑动窗口比固定窗口更精确。固定窗口在窗口边界处可能出现“双倍突发”——前一秒的最后一次请求和后一秒的第一次请求在极短时间内连续发生。滑动窗口通过记录每次请求的时间戳,精确计算窗口内的总量。
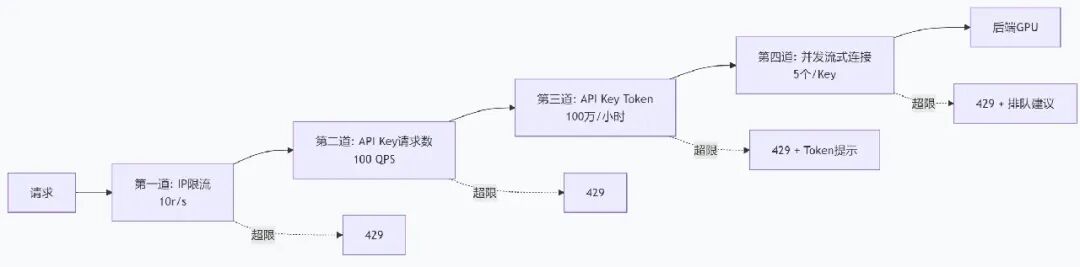
五、分层限流:从粗到细的四道闸门
5.1 第一道:IP 层限流
最粗粒度的限流。限制单个 IP 的请求频率,拦截明显的脚本攻击。用 limit_req_zone 配置,rate=10r/s 对大多数正常用户足够。突发流量用 burst 参数允许,但需要配合 nodelay 避免延迟累积。
5.2 第二道:API Key 层请求数限流
每个 API Key 有独立的请求数配额。免费用户 10 QPS,付费用户 100 QPS。这一层拦截的是“用大量小请求刷接口”的行为。
5.3 第三道:API Key 层 Token 限流
这是核心防线。每个 API Key 有 Token 配额,按小时或按天计算。Token 配额与请求数配额独立——用户可以用 1000 次小请求,也可以用 10 次大请求,只要总 Token 不超限。
Token 限流的实现需要维护两个计数器:请求数计数器和 Token 计数器。两个计数器分别检查,任一超限即拒绝。
5.4 第四道:并发流式连接限流
流式响应的连接是长连接。一个用户可能同时发起多个流式请求,每个请求占用一个连接和一份 GPU 资源。用 limit_conn 限制单个 API Key 的并发流式连接数,防止单个用户占满所有 GPU。
六、反馈闭环:从预估到实际
6.1 预估偏差的修正
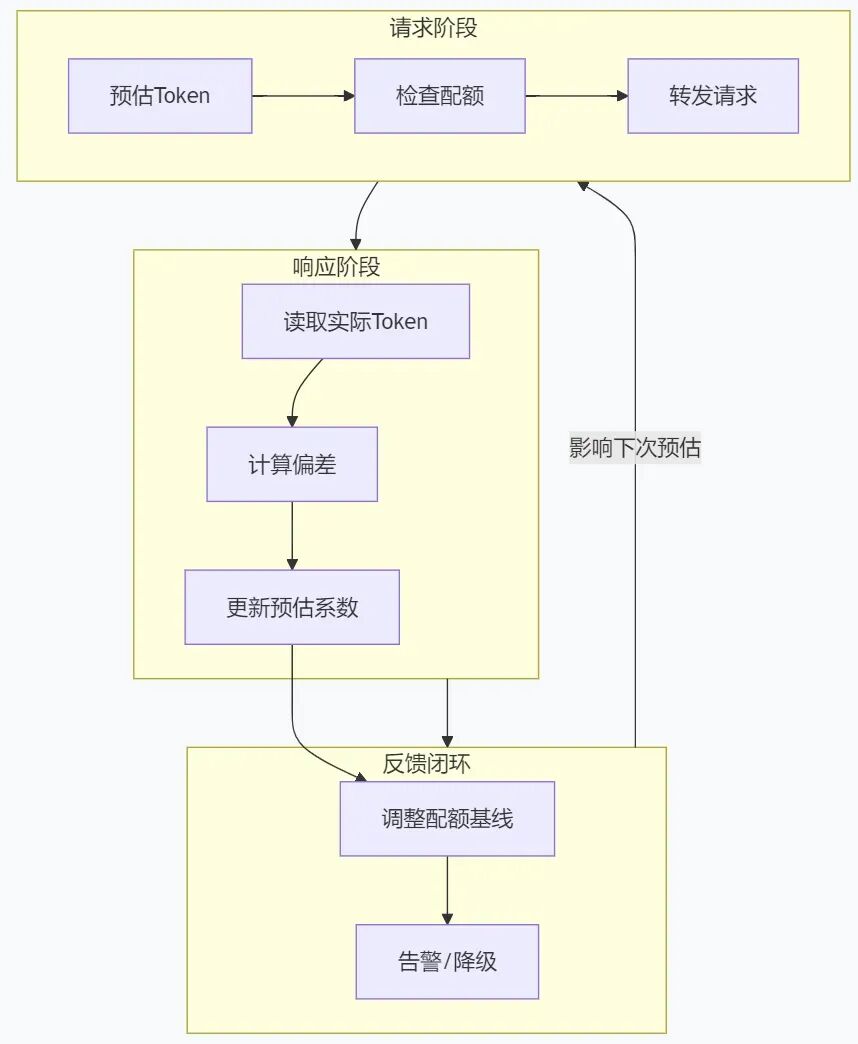
Token 预估不可能 100% 准确。输入文本的 Token 数取决于分词器,不同模型的分词器不同。输出 Token 数取决于模型的生成行为,无法提前精确预知。
解决方案是建立反馈闭环。后端在响应完成后,将实际 Token 消耗写入响应头(如 X-Actual-Tokens)。Nginx 在 log_by_lua 阶段读取这个头,与预估 Token 对比,计算偏差系数。
偏差系数用于调整后续请求的预估。如果某个 API Key 的预估持续偏低(实际消耗是预估的 2 倍),系统会自动调高该 Key 的预估系数,避免配额被低估。
6.2 动态配额调整
基于历史消耗数据,系统可以自动调整 API Key 的配额。一个持续接近配额上限的用户,可能意味着业务增长,需要提示升级套餐。一个突然消耗暴增的用户,可能意味着滥用,需要临时降级或人工审核。
动态调整的核心是“基线 + 偏离检测”。每个 API Key 有一个历史消耗基线(过去 7 天的中位数)。当某小时的消耗超过基线的 5 倍时,触发告警并临时降低配额,等待人工确认。
七、实战配置片段
7.1 共享内存字典
lua_shared_dict token_quota 100m;
lua_shared_dict request_count 50m;
7.2 限流逻辑入口
location /v1/chat/completions {
    access_by_lua_file /etc/nginx/lua/token_limit.lua;
    proxy_pass http://llm_backend;
}
7.3 Token 预估 Lua 核心逻辑
-- 读取请求体
local body = ngx.req.get_body_data()
local req = cjson.decode(body)

-- 输入Token预估
local input_text = ""
for _, msg in ipairs(req.messages or {}) do
    input_text = input_text .. (msg.content or "")
end
local input_tokens = math.ceil(#input_text / 4)

-- 输出Token预估
local max_tokens = req.max_tokens or 4096

-- 总Token(输出权重2.5)
local total_tokens = input_tokens + max_tokens * 2.5

-- 检查配额
local key = ngx.var.http_authorization
local quota = get_quota(key)
local used = shared_dict:get(key) or 0

if used + total_tokens > quota then
    ngx.status = 429
    ngx.say('{"error": "Token quota exceeded"}')
    return ngx.exit(429)
end

shared_dict:incr(key, total_tokens, 0)
八、总结
大模型 API 的限流,本质上是一个“成本控制”问题,而不是“流量控制”问题。
按请求数限流,控制的是流量。按 Token 限流,控制的是成本。两者的区别在于:前者假设每个请求成本相同,后者承认请求之间的成本差异。
在 Nginx 层做 Token 限流,是在不修改业务代码的前提下,用最小的改动实现最直接的成本控制。它不完美——Token 预估有偏差,流式响应的实际消耗无法提前预知——但它足够有效。
对于正在被大模型 API 账单困扰的团队,一个务实的路径是:先用 IP 层限流挡住明显的脚本攻击,再用 API Key 请求数限流控制基本频率,最后引入 Token 限流作为成本控制的核心防线。三层叠加,比任何单层限流都更有效。
模型很贵。让每一次调用都花在该花的地方,是每个 AI 应用团队的基本能力。
欢迎加w一起交流:19067272547