
Ember-1:Fireworks 专为高效推理打造的专用模型,token 节省 40%
Ember-1:一半的 token,同样的答案
Ember-1 是 Fireworks Research 推出的全新专用模型,在保持 Kimi K3 质量的同时,token 消耗减少 40%。它基于 Kimi K3 构建,学会了削减不必要的推理、只保留真正有价值的思考。我们在外部基准、客户实时 A/B 测试以及自家编码和 agent 工作负载上进行了验证,质量在所有场景下都保持稳定。Ember-1 现已上线,它是 Fireworks 系列专用模型的开山之作,后续模型将由开发者的需求驱动。Ember 只是 Fireworks Training 平台能力的一个开始。
Fireworks Research 如何打造 Ember-1
许多用户告诉我们,希望以更低成本获得 K3 的编码能力,因为它冗长的推理链路让大规模自动化编码成本高昂。而单纯调低 K3 的推理力度并不能解决问题——低力度的设置会损失太多质量。想要既保住质量又减少 token,模型必须学会更高效地推理,这就需要训练。
这背后是扎实的研发工作。团队进行了 50 多次训练实验和 200 多次评估,并在此过程中开发了新的训练算法,能在不损失精度的前提下缩短推理。全部工作都在 Fireworks Serverless Training 上完成。由于无需配置和管理 GPU,我们一有想法就能立即启动实验,只为实际运行付费,从研究到上线的周期和成本都大幅缩短。
我们在覆盖广泛任务的数据上训练,让 token 节省能推广到多种工作负载。训练只使用了我们自己的数据,未使用任何客户数据。随后我们在 Specialized Intelligence Index、公开基准和真实生产流量上评估了 Ember-1,确认它在减少 token 的同时质量没有下降。Ember-1 是 Fireworks 自研模型,也是 Fireworks Research 系列模型中的第一款。
问题所在:思考型模型想得太多
像 Kimi K3 这样的推理模型,会将生成的大部分 Token(有时甚至超过 90%)用于内部推理,而非直接给出答案。这种思维结构在单次请求中成本高昂,而在多轮智能体工作负载中问题更为严峻。每一轮交互都会将之前所有的推理内容重新回传给模型,导致上下文长度随轮数呈近似二次方增长。早期轮次产生的长篇推理轨迹,会在后续每次调用中被重复读取(并重复计费)。
这些推理真的都是必需的吗?我们的实验给出了否定答案。Kimi K3 输出的推理远长于任务实际需求,且这些冗余部分可以在不干扰最终答案的情况下被移除。基于此,我们创造了 Ember-1,这是一个由专属智能构建的 Kimi K3 经济版本。
从一个观察到高端模型
K3 的推理并非完全浪费。其中一部分属于自我反思:重新审视假设、响应反馈,或追溯结果源于先前的决策,这些都有助于模型从错误中恢复。关键在于,在保留这种能力的同时,削减不必要的推理,并摆脱无效率的循环。我们相信,通过学习任务和环境反馈,可以教会模型更高效地推理,同时保持其核心能力。
对于智能体任务,这种学习贯穿整个交互过程。模型探索可能的行动,融入新的观察,并随着进展不断精炼其推理。反馈将决策与其后果联系起来,鼓励在整个任务过程中进行有益的反思。
我们将这些洞察纳入训练数据集中,涵盖数学、编码、指令遵循、对话、搜索、工具使用及软件工程等领域,覆盖独立问题和扩展交互,以强制模型适应观察结果和最终成效。任务反馈引导在线策略规划与学习,重点在于在此类多样化场景下保持能力一致性。
公共基准测试和实时 A/B 测试的结果支持了这一方向:在七个基准测试和两家客户的生产流量中,Kimi K3 的推理长度可在不牺牲准确性的前提下缩短 35%–50%。这种内化行为还表现出对不成功尝试中 Token 使用的克制,减少了冗长且无效率的推理。
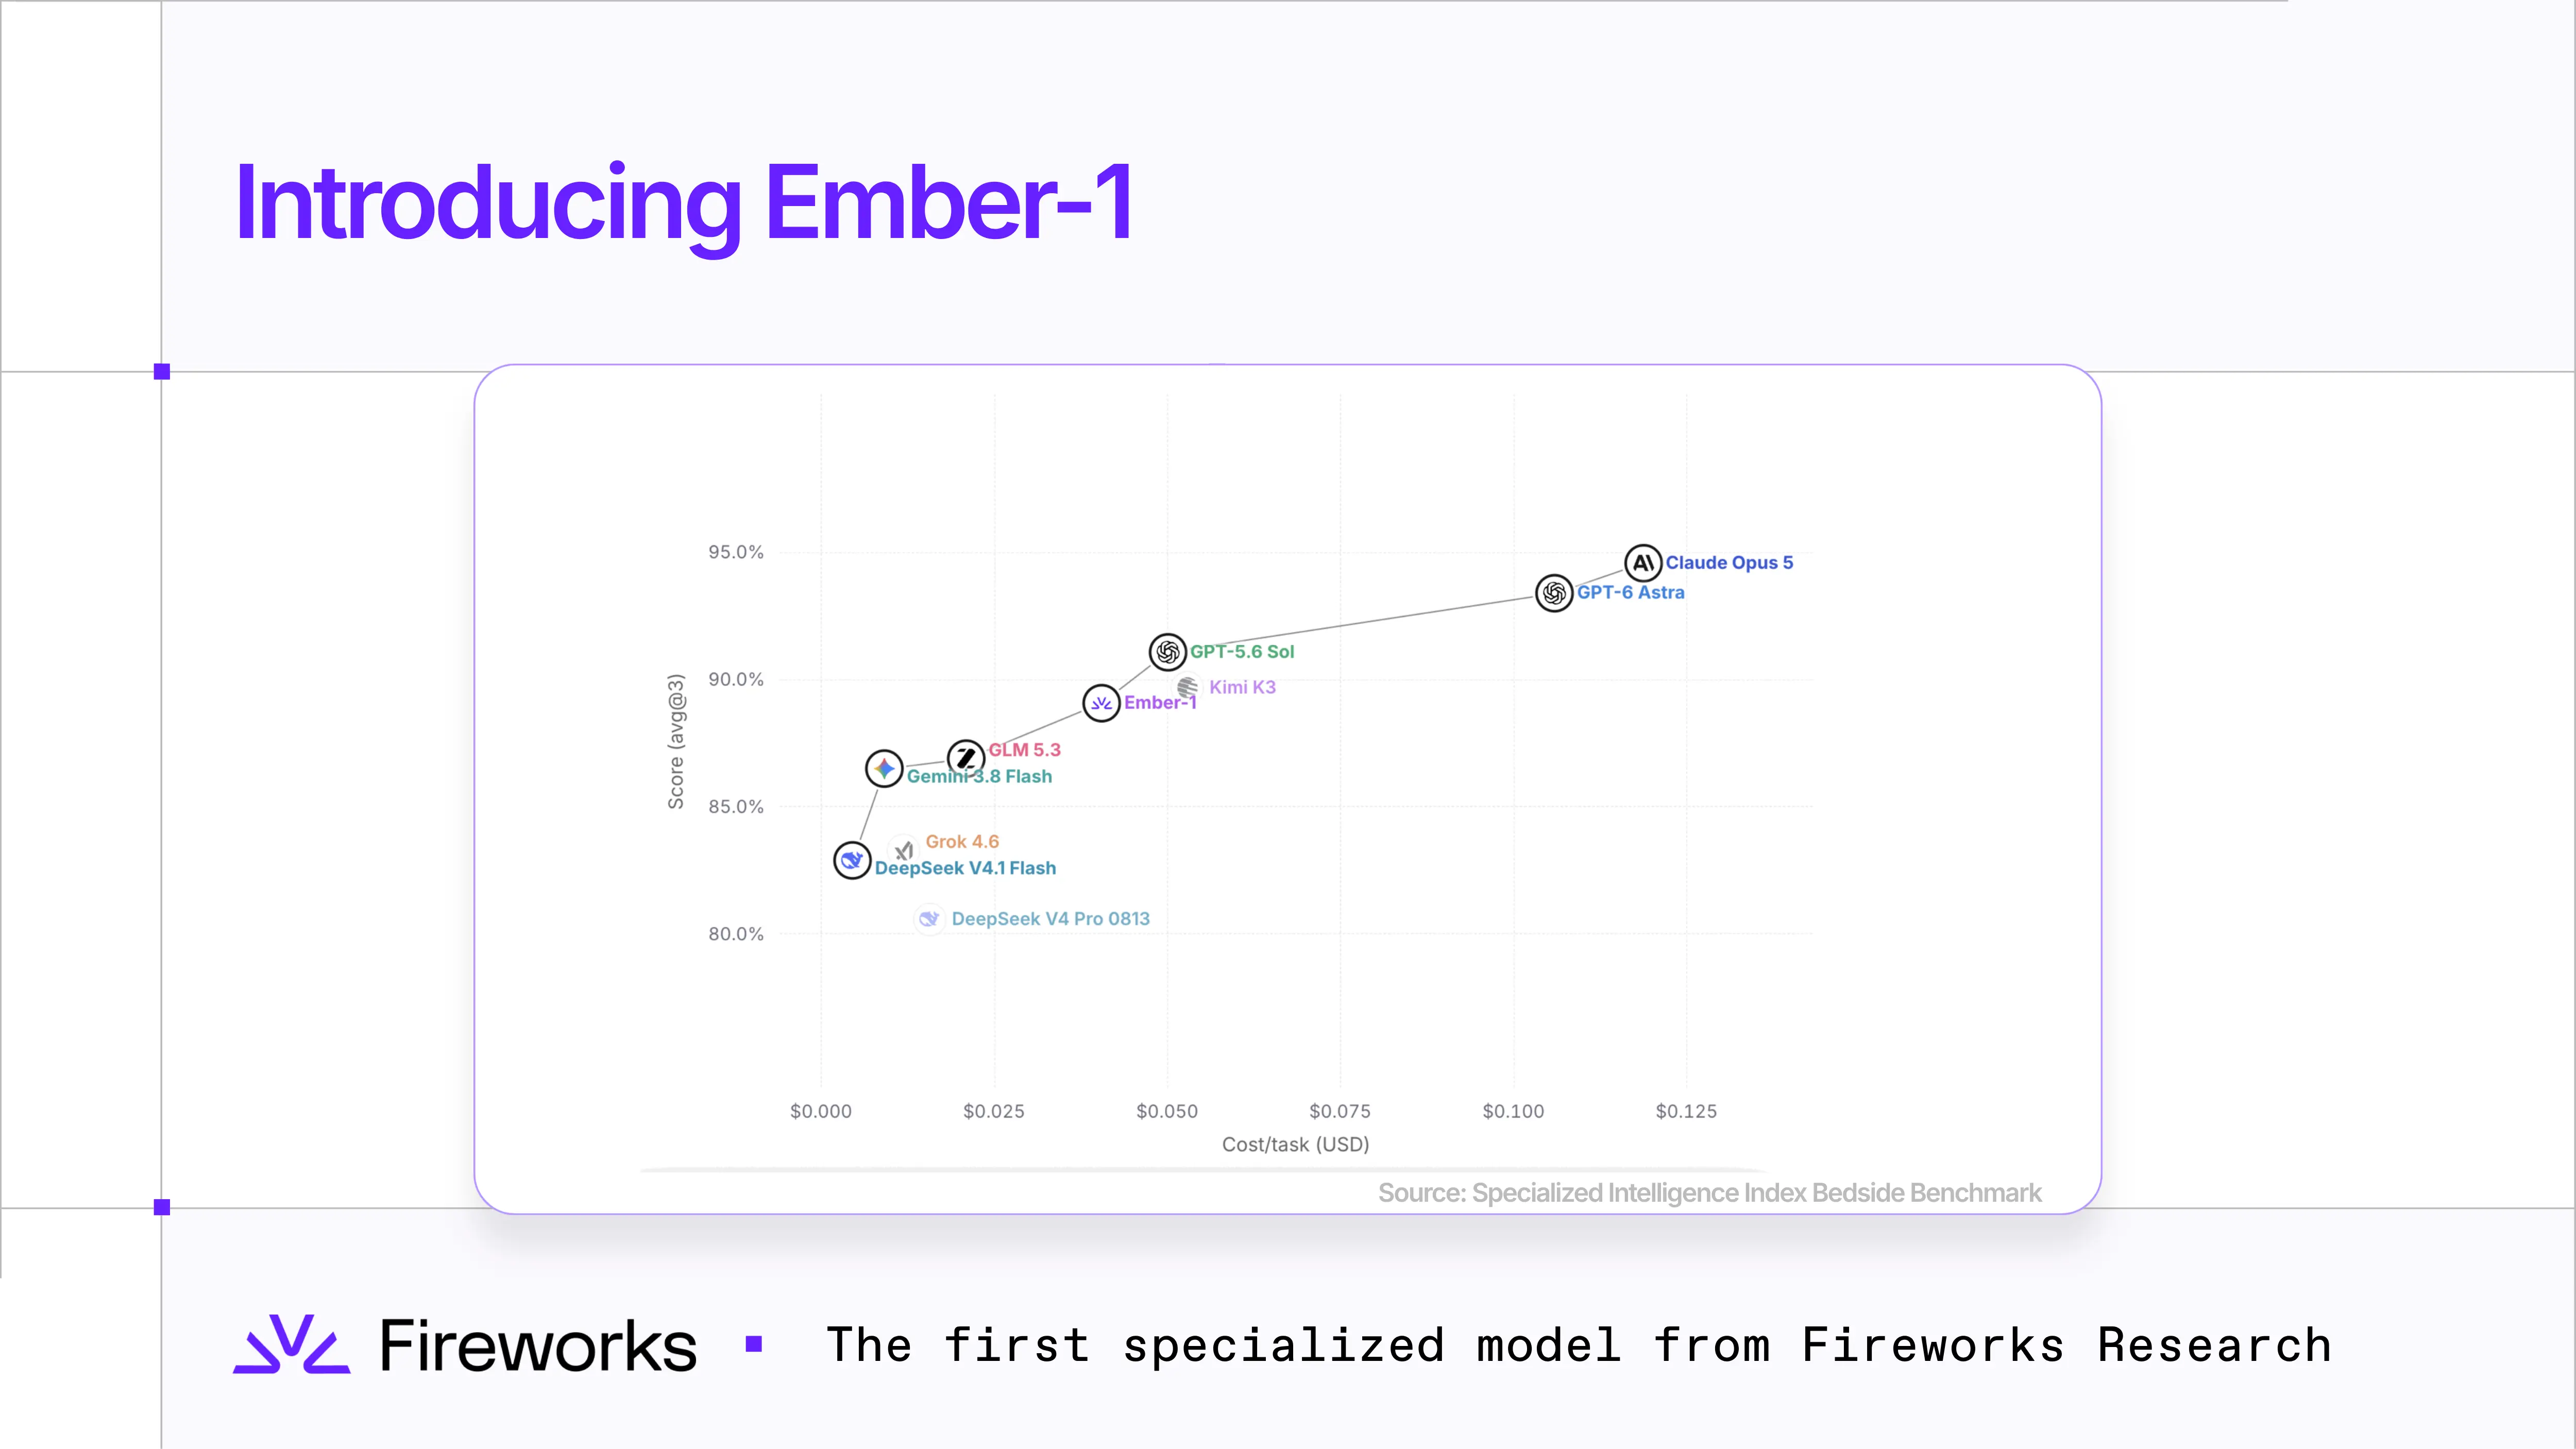
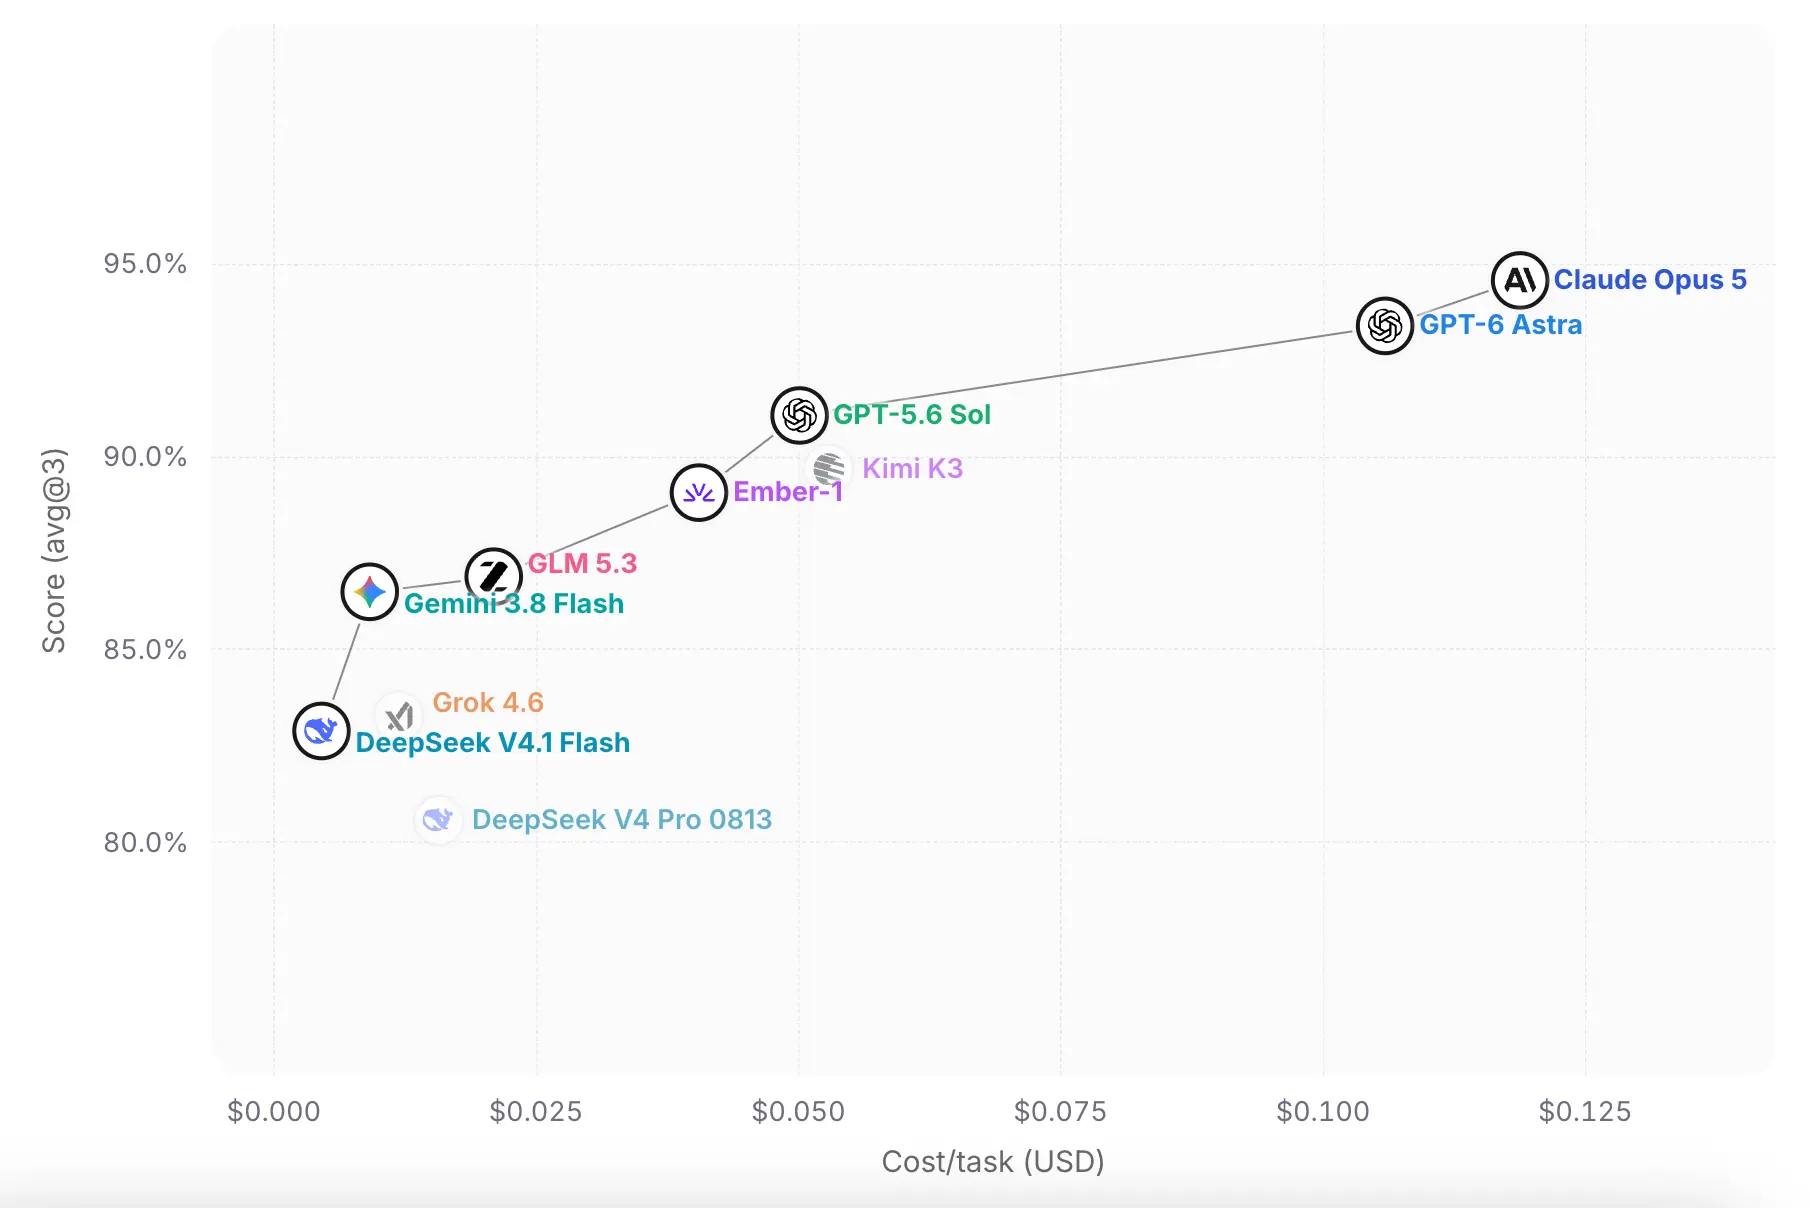
专属智能指数:Ember-1 在 Bedside Bench 上确立了帕累托前沿
本周早些时候,我们推出了专业化智能指数(SII),用于对标开放、封闭及专用模型在行业专家构建的真实世界任务上的表现。
我们在多密西蒂(Doximity)的 Bedside Bench 上评估了 Ember-1。该基准测试由医生验证,涵盖 10 个专科领域的 500 个临床案例。
结果如何?在每任务成本方面,Ember-1 在 Bedside Bench 上为开放和闭源模型(包括 GPT-5.6 Sol、GPT-6 Astra 和 Claude Opus 5)确立了新的帕累托前沿。
在更多行业基准测试中评估帕累托前沿
我们还在其他一些行业基准测试中评估了 Ember-1 的质量-成本前沿。我们使用 Kimi K3 公开 API 的定价(未缓存输入 $3/百万 token,缓存输入 $0.30/百万,输出 $15/百万)计算了每个基准测试的成本,并将其与三条路径的通过率进行绘制:K3 低推理强度、K3 高推理强度、K3 最大推理强度(默认)以及 Ember-1。在所有测试样本超过 50 个的基准测试中,Ember-1 位于或接近帕累托前沿,以 K3 最大推理强度的一小部分成本达到了同等质量,并严格优于 K3 低推理强度。我们还分析了 GPT-6 Astra、Claude Opus-5 和 GLM 5.3,发现 Ember-1 处于帕累托前沿的领先地位。
我们深入对比了 Ember-1 与原版 K3 的结果,得到如下数据:
| N | K3 最低 | K3 最高 | K3 最佳 | Ember-1 | Ember-1 vs. K3 最佳 | |
|---|---|---|---|---|---|---|
| Terminal Bench 2.1 | 89 | 76.4% | 77.6% | 80.9% | 82.0% | -51.9% / -23.1 美元 |
| SWE-bench Verified | 500 | 80.4% | 86.0% | 93.2% | 92.2% | -15.5% / -68.1 美元 |
| SWE-Interact | 75 | 6.7% | 13.3% | 21.3% | 20.0% | -32.5% / -60.8 美元 |
| DeepSWE 1.1 | 113 | 55.8% | 62.8% | 66.4% | 75.2% | -23.7% / -126.9 美元 |
| τ-2 Bench Airline | 50 | 64% | 64% | 64% | 66% | -5.9% / -0.3 美元 |
如今最省成本的选择,不再是让 K3 少思考,而是直接使用 Ember-1——一个学会了高效思考的模型。
客户验证:线上 A/B 测试
基准测试能说明的东西有限。正如我们在专业智能指数结果中的发现,我们希望在更真实的工作负载上测试模型,用生产流量来验证它。真正的考验往往是:模型能否在用户依赖的产品中扛住生产流量的检验。
我们邀请两位客户针对其生产环境的编程任务进行了实时 A/B 测试。在两个案例中,Ember-1 都展现了显著的 Token 节省效果,在保持同等质量的前提下,每个任务约减少 35% 的 Token 消耗。大部分下游产品指标持平或提升,包括任务完成率、成功率,失败率也朝正确方向移动,而 Token 成本大幅降低。A/B 测试后,一位客户现已在生产环境中运行 Ember-1,并计划逐步扩大规模以完全替换基础模型。
| 得分 | 步数 | 输出 Token | 推理 Token 降幅 | 总 Token 降幅 | |
|---|---|---|---|---|---|
| Kimi K3 | 0.751 |
23.8 |
49.3K |
- |
- |
| Ember-1 | 0.753 |
21.4 |
29.9K |
71.3% |
39% |
内部验证:开发者未察觉切换
Fireworks 内部大量的编程/协作流量由其自建推理服务提供支持。在客户接触该模型之前,我们先在内部部署了 Ember-1,让自家开发者将其用于日常编码工作,包括针对真实任务的大规模 vibe testing。
我们最自豪的结果是:毫无波澜。没有新闻就是好消息。开发者照常进行编码工作,未察觉底层模型已切换,同时 Token 消耗大幅减少。对于一个核心价值主张为“答案相同,Token 更少”的模型而言,在内部流量中实现无感平滑切换是最强的信心信号。
未来计划
Ember-1 将在 Serverless 上作为研究预览版本推出,与基础 Kimi K3 模型并行作为服务选项。为支持快速成长的开源生态,我们将推出研究发布通道,让开发者获得新研究模型两周的 Serverless 访问权限,并根据社区需求决定是否转为永久可用。对于智能体编程及其他由推理 Token 占据主要成本的工作负载,它能在 Token 成本约为原来一半的情况下提供同等质量。
Fireworks Research 将持续探索模型效率的边界,将专业化智能引入更多 Ember 模型,帮助你在部署最具性价比模型的同时降低 token 成本。提升 token 效率正逐渐成为 Fireworks 的核心主题。
希望将 Ember-1 推向更高水平,并针对你的具体场景进行优化?我们还同步推出了针对 Ember-1 的训练支持,让企业能够利用自有数据构建定制化、高 token 效率的模型。开放模型的未来,在于基于特定工作负载训练出的专业化模型。
正在你的工作负载中试用 Ember-1?我们很乐意了解你的使用体验,欢迎在 X(@FireworksAI_HQ)上联系我们,分享你正在构建什么。