
NVIDIA DSX MaxLPS 如何提升 AI 工厂的吞吐量与能效
每一瓦未被利用的电力,都是被搁置的算力潜力。AI 工厂通常会为所有 GPU 同时达到峰值功耗这种极端罕见情况预留缓冲,这导致在正常运行期间,大量基础设施处于闲置状态。NVIDIA DSX MaxLPS 采用策略驱动的动态电力共享机制,在参与资源间灵活分配电力,使客户能够在已批准的电力预算内多部署多达 40% 的 GPU。
本技术详解将探讨 NVIDIA 与 Nscale 联合评估的一项案例:在位于冰岛凯夫拉维克 Verne 园区的 Nscale 数据中心,使用纯可再生能源驱动的 NVIDIA GB300 NVL72 系统运行 Kimi K2.5 工作负载。内容涵盖电力与性能之间实测的权衡关系,解释用于维持电气限制的控制机制,并介绍一套可复用的验证方法,供运维人员在大规模部署前使用。
静态配置如何导致可用电力搁浅
AI 工厂运行在多层电气限制体系之下。从电力供应、变电站、配电设备、机架、节点到 GPU,每一层级都存在约束。运维人员必须在满足应用吞吐量和延迟目标的同时,确保每个管理边界都保持在获批的限制范围内。
传统的静态电力规划通常为每个节点预留达到其规格峰值所需的电力,假设所有节点会同时达峰。这种方法虽然简单保守,但 AI 负载极少保持恒定功耗。训练负载会在计算、通信、同步和检查点写入等阶段间切换;推理负载则在前缀处理(prefill)、解码、内存密集型操作、网络活动及空闲间隔之间交替。即便是同一模型的不同实例,随着请求形态和并发数的变化,其功耗也会有所不同。
这种波动造成了预留峰值功耗与实际消耗之间的缺口。在静态的单节点预留模式下,某节点内部未用的容量无法转移给其他节点。这导致整个机房的总功耗可能低于限制上限,而额外的 GPU 容量却被迫处于离线状态。
DSX MaxLPS 通过监测实际电力消耗,在保持运维人员设定的总体预算和策略边界的前提下,动态地在参与资源间重新分配可用电力。
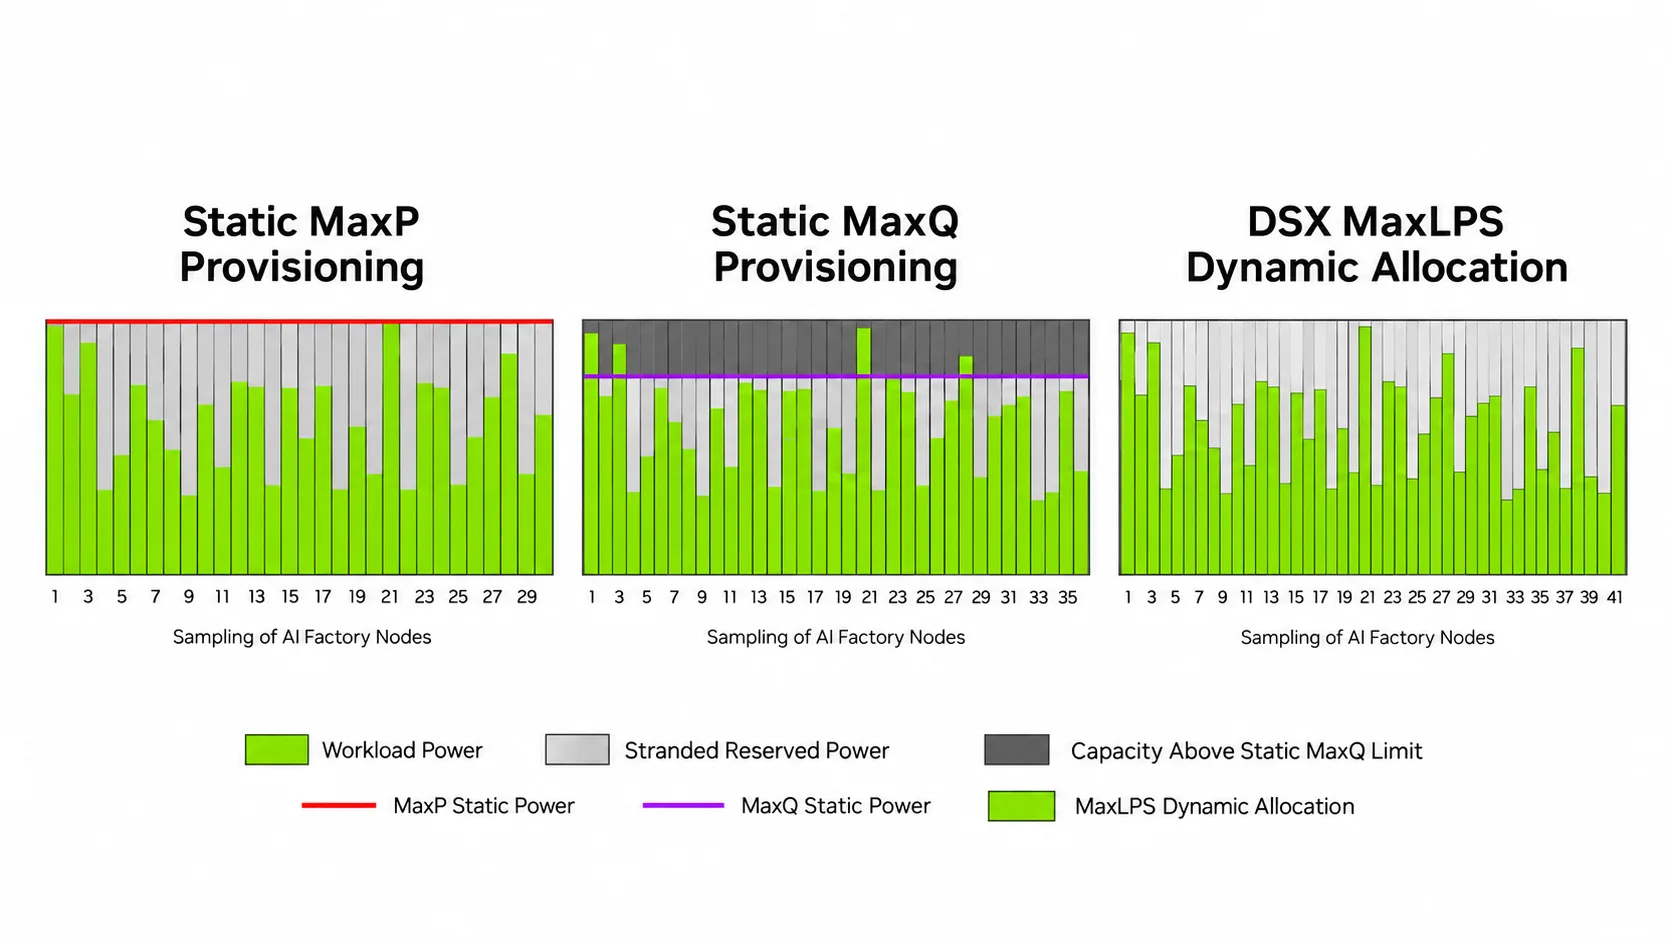
DSX MaxLPS 控制环路的内部机制
DSX MaxLPS 融合了芯片、系统、散热和软件技术,在土地、电力和机房空间(LPS)受限的条件下最大化 AI 工厂的产出。Dynamic Power Software 提供控制层,按策略执行电力分配。
控制过程包含五个技术要素:
- 拓扑与资源组。运维方映射参与的基础设施,并将节点组织成一个受管组,为其设定总电力预算。
- 遥测。系统以足够发现可用余量和电力事件的频率,采集 GPU、节点、机架和组级别的电力遥测数据。
- 策略。运维方定义的规则确定节点限额、组限额、分配优先级、预留要求,以及对维护或紧急事件的响应方式。
- 分配与控制。当部分资源的实际功耗低于分配额度时,软件会调整参与节点的 GPU 功率上限,让其他资源利用剩余容量。
- 验证与执行。系统将实测功耗与核准的组预算进行比对,并在接近限额时调整分配。
这是一种协调式的资源分配,并不是提升站点的供电能力。控制环路的目标,是在同样的受管电力预算下完成更多有效工作。
评估方法
评估中,Nscale 在其数据中心部署了 MaxLPS 软件,并在 NVIDIA 运行工作负载期间收集遥测数据。该评估旨在测量控制行为及工作负载间的权衡。
评估配置使用 NVIDIA Blackwell Ultra GPU,运行 FP4 精度下的 Kimi K2.5 模型,并采用 NVIDIA Dynamo 和 NVIDIA TensorRT LLM。序列长度设为 8K 输入和 1K 输出。工作负载组合混合了高吞吐量和低延迟推理实例,从而在托管组内形成了截然不同的电力和服务画像。
静态基线使用 35 个四 GPU 节点(共 140 块 GPU)。其中两个高吞吐量实例各占用 52 块 GPU,一个低延迟实例占用 36 块 GPU。DSX MaxLPS 配置则使用 48 个四 GPU 节点(共 192 块 GPU)。它在保留原有 36 块 GPU 低延迟实例的同时,新增了第三个 52 块 GPU 的高吞吐量实例。
任务分布在四个机架中运行,两种配置下的分布式工作负载均被限制在单一机架内。这一设计旨在排除机架间性能差异的影响。如果测试环境已验证各机架性能等效,则无需对分布式工作负载施加此限制。
团队测量了归一化的聚合吞吐量、单实例吞吐量、首词元生成时间(TTFT)、端到端延迟、交互性,以及 GPU、CPU 和机架的电力遥测数据。通过对比这些指标,可以防止吞吐量提升掩盖延迟、稳定性或电力合规性方面的性能退化。
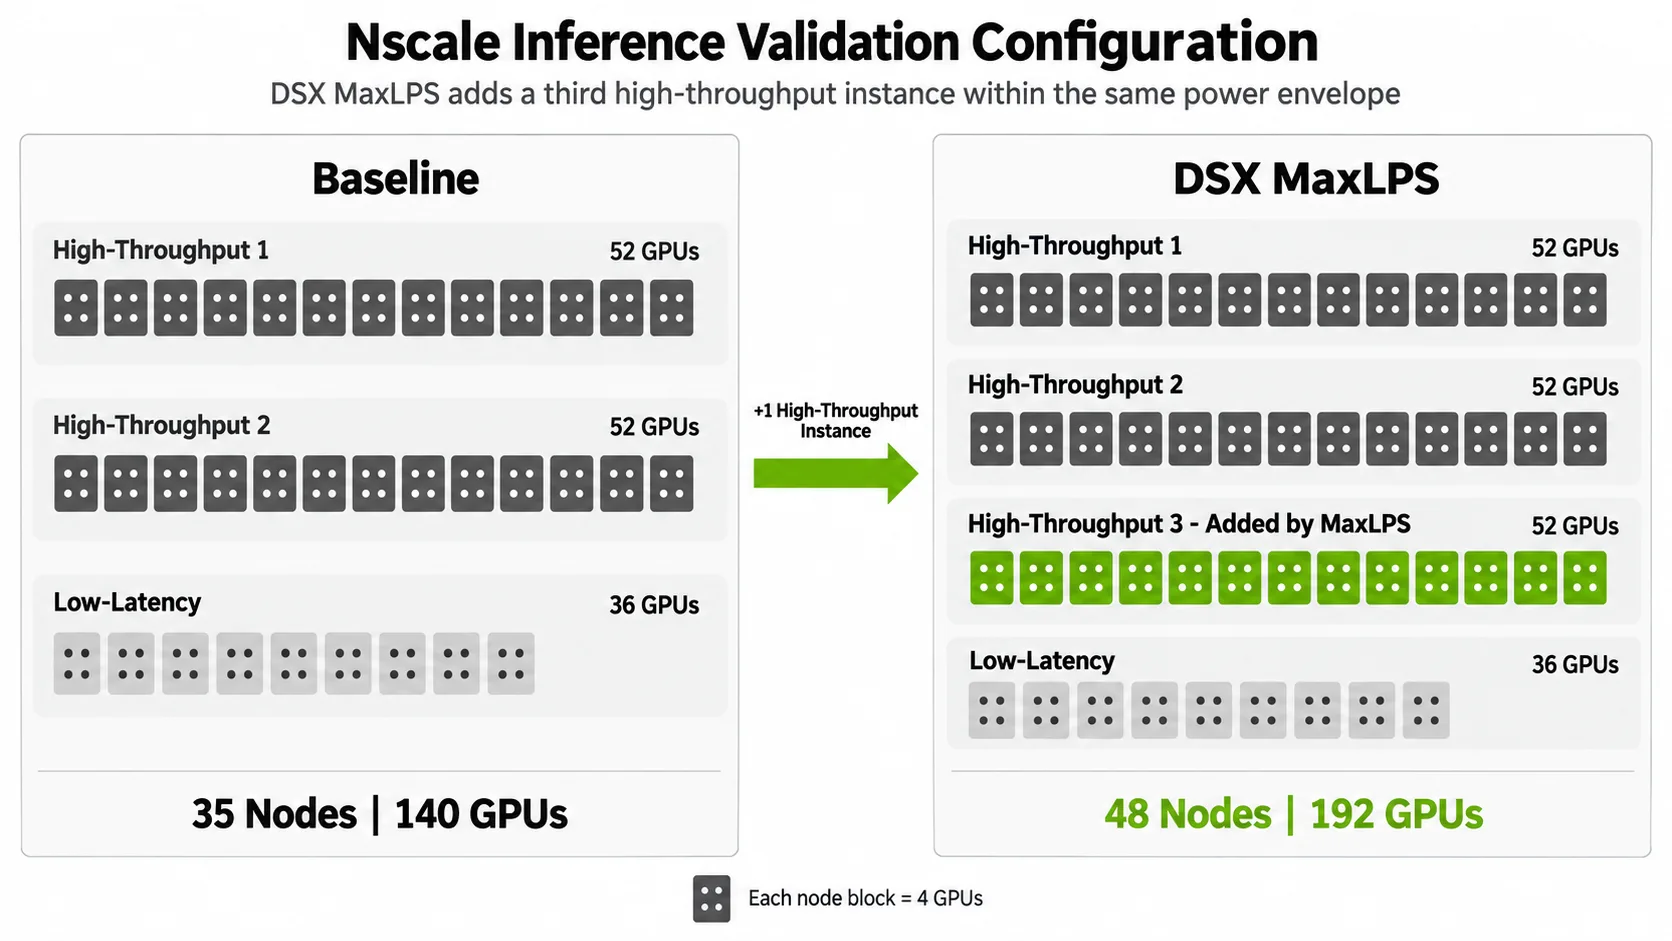
测量结果展示
1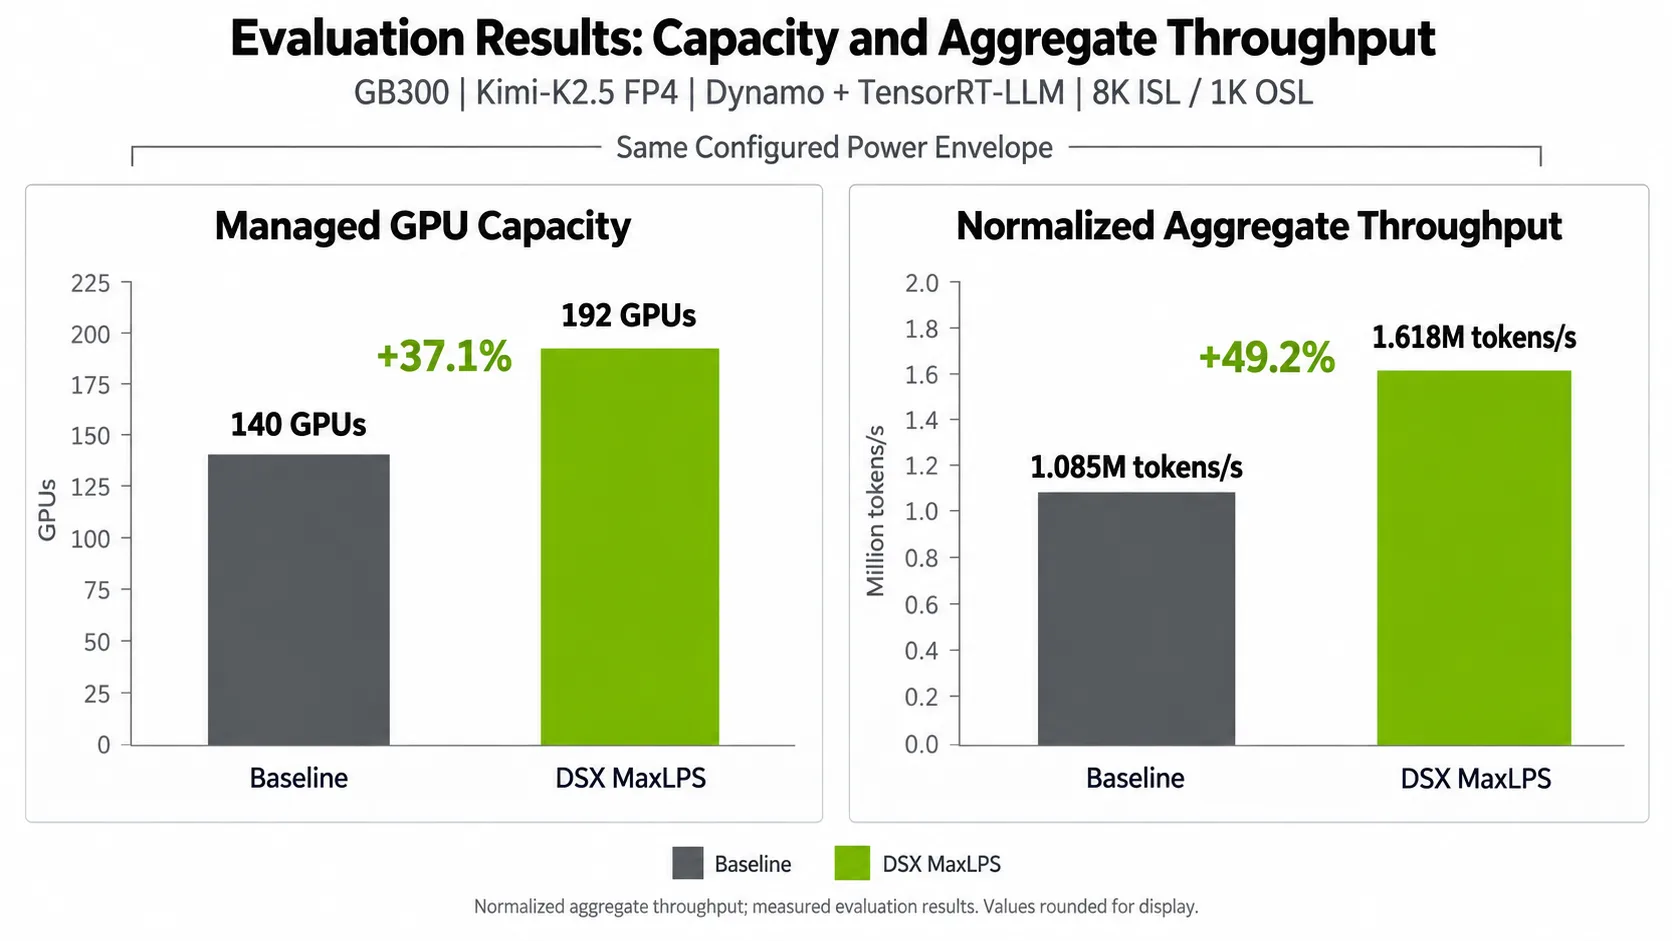
评测揭示的权衡
动态功率分配让工程上的权衡在集群层面变得可观察、可控制,但并不能消除这些权衡。
工作负载组合决定可用余量
DSX MaxLPS 利用的是原本闲置的功率余量,因此新增的容量仍会推高平均功率利用率。可用余量的大小也取决于工作负载组合:功率曲线互补的工作负载比同时达到峰值的工作负载能带来更多优化空间。因此,运维人员应当用具有代表性的生产工作负载,针对总功率上限进行测试。典型的 AI 工厂运行着功率曲线各异的多种异构工作负载,所以本研究使用的工作负载组合也专门反映了这种多样性。
长尾延迟揭示服务层面的权衡
稳定的中位数延迟可能掩盖长尾延迟的变化。在本次评测中,中位数和 P75 延迟与基线的偏差保持在 5% 以内,但 P99 首 token 时间增加了 17%。生产环境的验收标准应作为评测的一部分事先明确。
遥测数据支撑可靠控制
动态分配依赖可靠的遥测数据。测量数据缺失、延迟或映射错误,都可能影响集群层面的决策。本次评测使用了站点级遥测来校验机架级功率测量结果。在部署之前,运维人员应确认新增的吞吐量不会损害服务质量,也不会违反功率上限。
这些权衡共同界定了部署前运维人员需要验证的关键事项。
验证 DSX MaxLPS 的方法
采用分阶段验证流程,并明确各阶段的边界与验收标准。
- 界定管理边界。 绘制电力、配电、机架、节点及 GPU 的拓扑图。设定资源组预算、预留要求及升级策略,并确认哪项度量指标代表可执行的限额。
- 建立代表性基线。 在静态配置下运行具有代表性的 AI 工厂工作负载组合,应用预期的部署和放置规则。持续测量性能与功耗,以确保捕捉工作负载的波动并确认可重复性。
- 谨慎引入策略。 从接近已验证基线的限制值开始。在增加节点前,先确认遥测数据、拓扑结构、控制响应及预算合规性。
- 逐步扩容并测试每个阶段。 逐步增加受管实例数量,并在每一步对比聚合性能与单实例性能。在继续之前,需验证峰值负载、操作切换、遥测故障及电力供应受限等场景下的服务行为。
- 设定生产环境运行限额。 仅当配置满足吞吐量与延迟目标、处于受管预算范围内、保留了必要的预留资源,且在故障和切换期间表现可预测时,才予以批准。
该评估展示了 DSX MaxLPS 如何回收电力受限 AI 工厂中的闲置容量。这种基于策略治理的方法可在多种环境中提升有效算力。运维人员可根据硬件、工作负载组合、软件、冷却系统、网络拓扑及服务目标,为每个部署场景调优最佳运行点。
针对已验证的运行目标规划站点
动态分配是一项运营能力,但站点必须具备承载该能力所释放容量的基础设施。即使初期部署的机架较少,电气配电、冷却系统、网络架构、地面空间及机架位置也应按已验证的全生命周期目标进行规模规划。
面向未来 NVIDIA Vera Rubin NVL72 AI 工厂,DSX MaxLPS 将动态功耗管理与能效比技术相结合,并采用专为 45°C 液冷进水工况设计的架构。Vera Rubin 的产能预测应保持独立,不与本次 GB300 NVL72 的实测数据混同。
DSX MaxLPS 为运营方提供了一套将负载波动转化为可控容量的框架。工程侧的工作包括:界定边界、测量典型行为、根据服务目标调优策略,并在常规及极端条件下验证合规性。
参考 NVIDIA DSX MaxLPS 及 NVIDIA 动态功耗软件文档,利用上述验证流程为您的 AI 工厂确立生产级运行极限。