
AI Agent 在模型开发中承担更多工作,但决策权仍归人类
研究团队记录了人类与 AI Agent 协作开发新 AI 模型的过程,研究结果颠覆了人们对 Agent 独立工作能力的部分预期。
当 AI Agent 协助构建新的 AI 模型时,决策权在谁手里?一个包含复旦大学研究人员的团队研究了自己的项目以寻求答案。他们分析了 56 名参与者提交的 700 多份任务日志,以及所用 Agent 的运行日志。
该项目聚焦于开发名为 Atria Dawn Preview 的 Agentic 语言模型。该模型基于 7440 亿参数的混合专家架构(MoE),专为研究与工程任务设计。
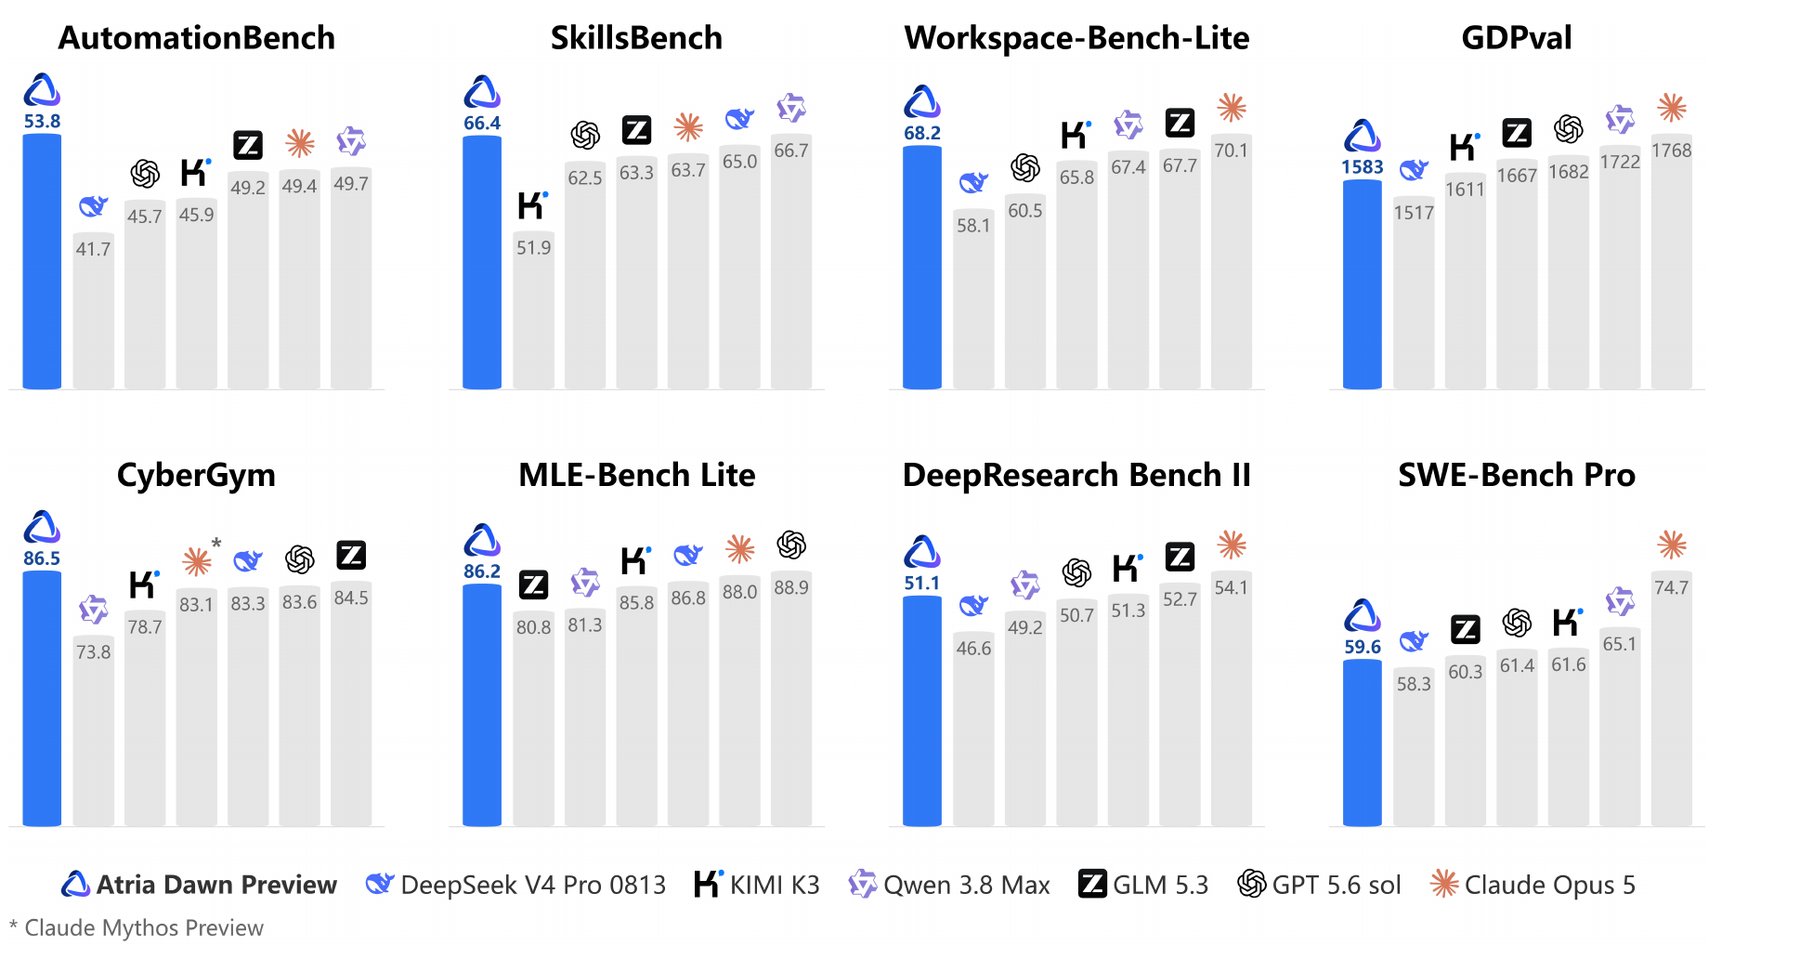
模型通过一种将每项任务与真实执行环境挂钩的流程进行训练。它会调用工具、生成中间结果,并对照测试、指标或源代码证据等外部信号进行检查。团队表示,该模型在 16 项基准测试中的 5 项上领先,涵盖网络搜索和网络安全等领域,但并未在整体性能上超越竞争对手。
三分之一的 AI 辅助任务若没有 AI 根本不会开展
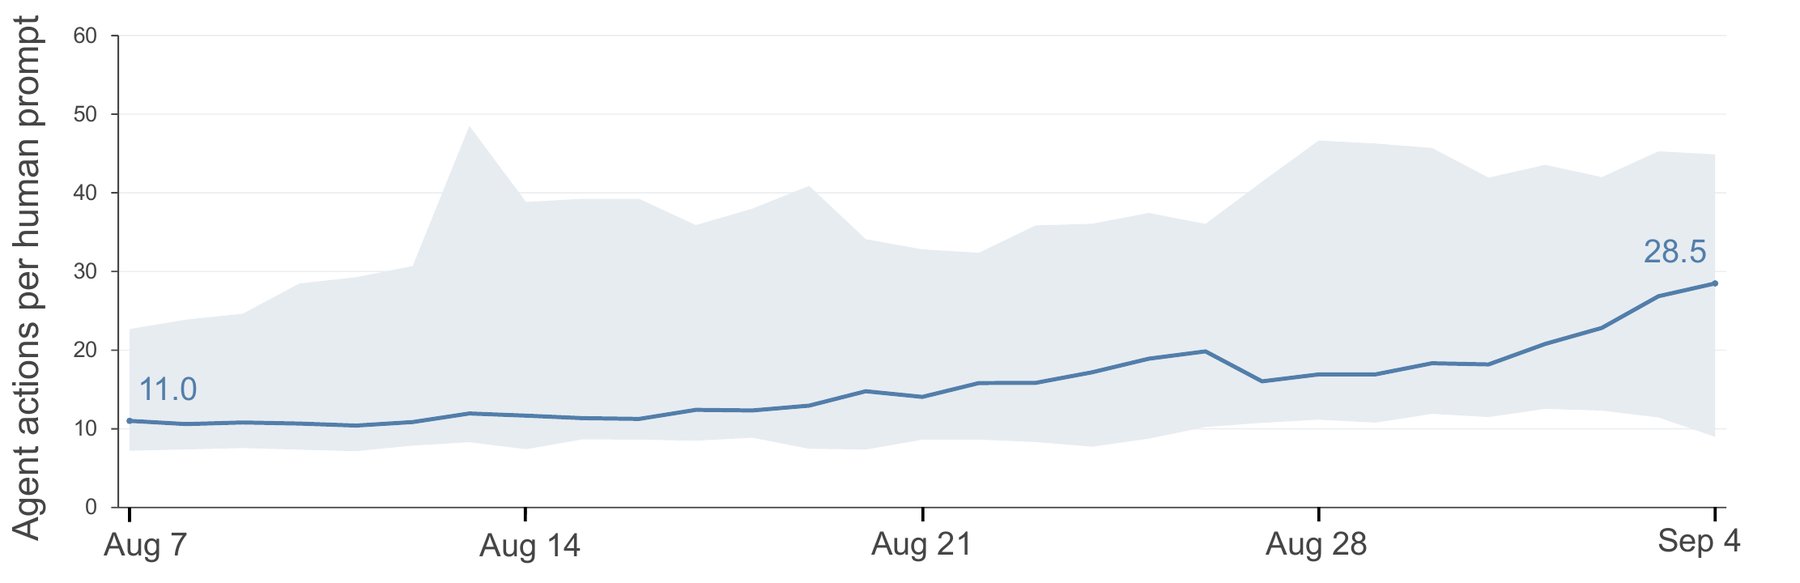
在审查的任务中,96.5% 使用了 AI。随着项目推进,参与者将越来越多的工作移交给 Agent。在四周内,Agent 操作与人类输入的比率中值从 11 升至 28.5。团队提醒,不要将此解读为 Agent 自主性的增强。每一个人类决策都导致更多的 Agent 步骤,但这并不意味着 Agent 本身做出了更多决策。
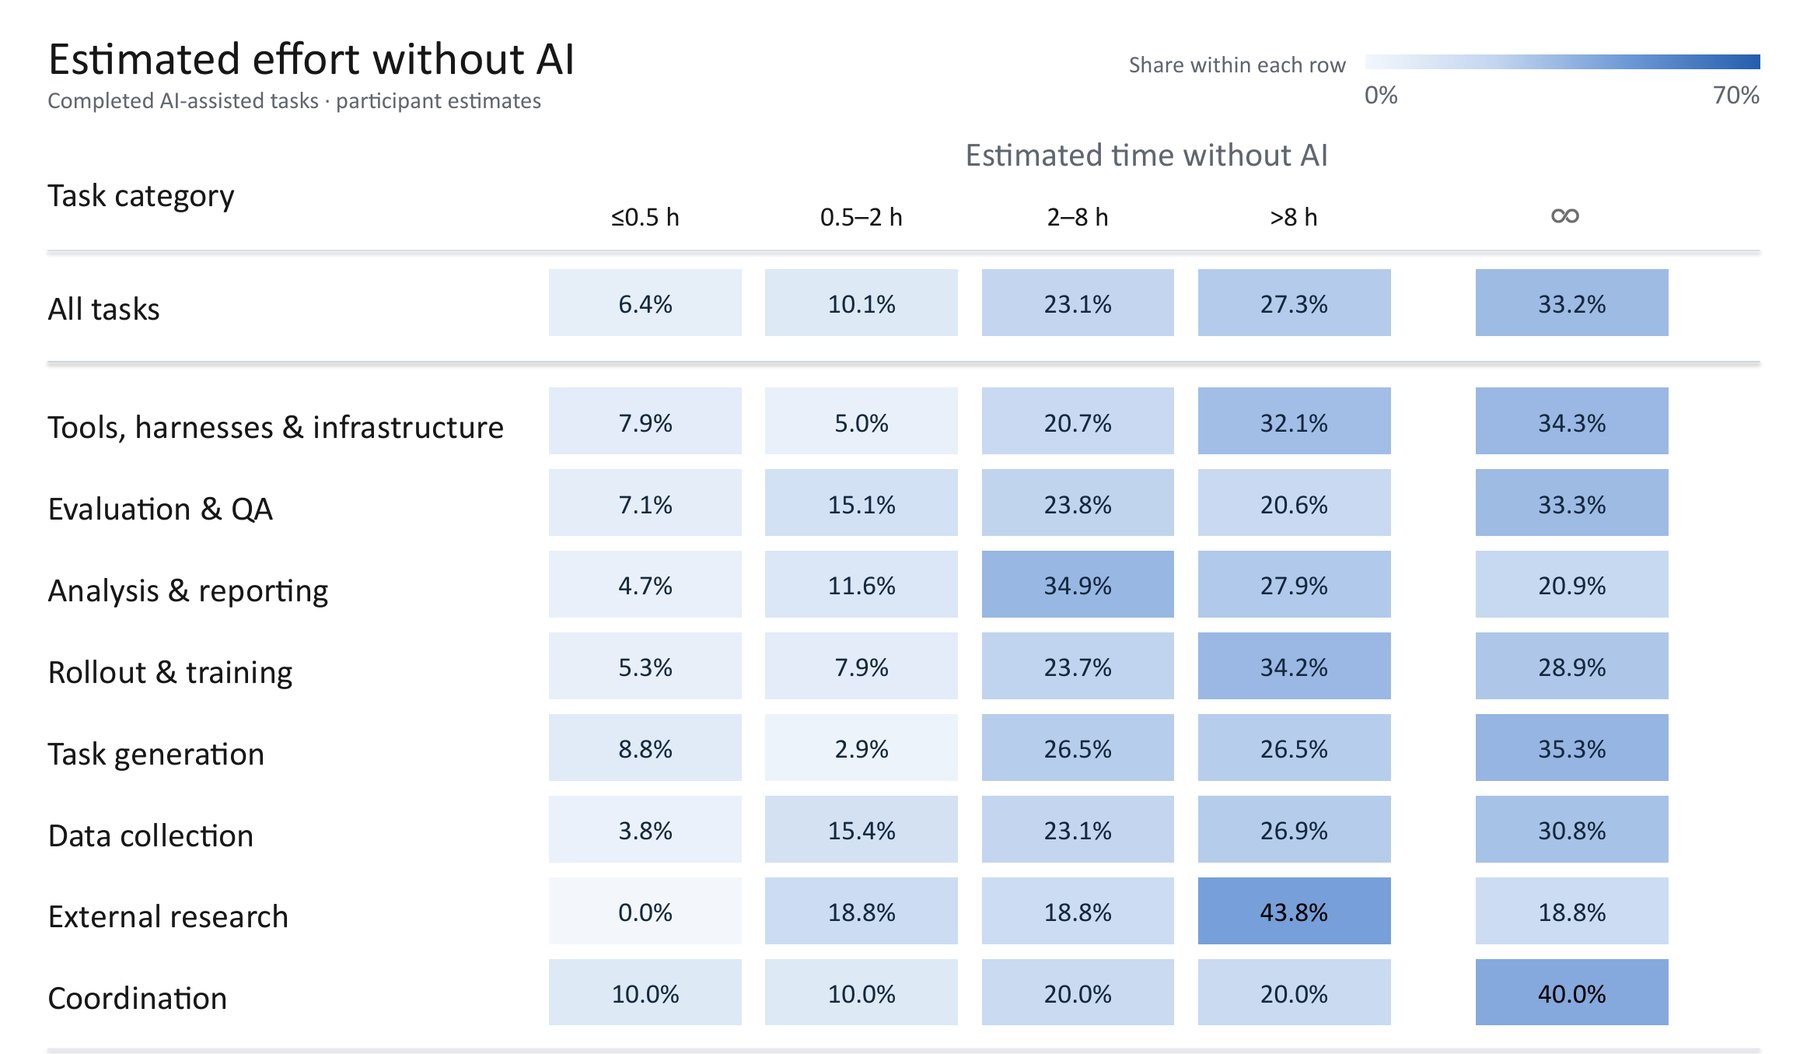
参与者还被问及:如果没有 AI,能否在相同范围和质量下完成自己负责的任务部分。在 455 个借助 AI 完成的任务中,有 151 个被认为离开 AI 根本无法完成,约占三分之一。这些任务分布在 56 名参与者中的 27 人身上,并非只集中在少数重度用户身上。在这类场景中,AI 并没有让已有工作变快,而是让原本根本不会启动的工作成为可能。
AI 提议,人类拍板
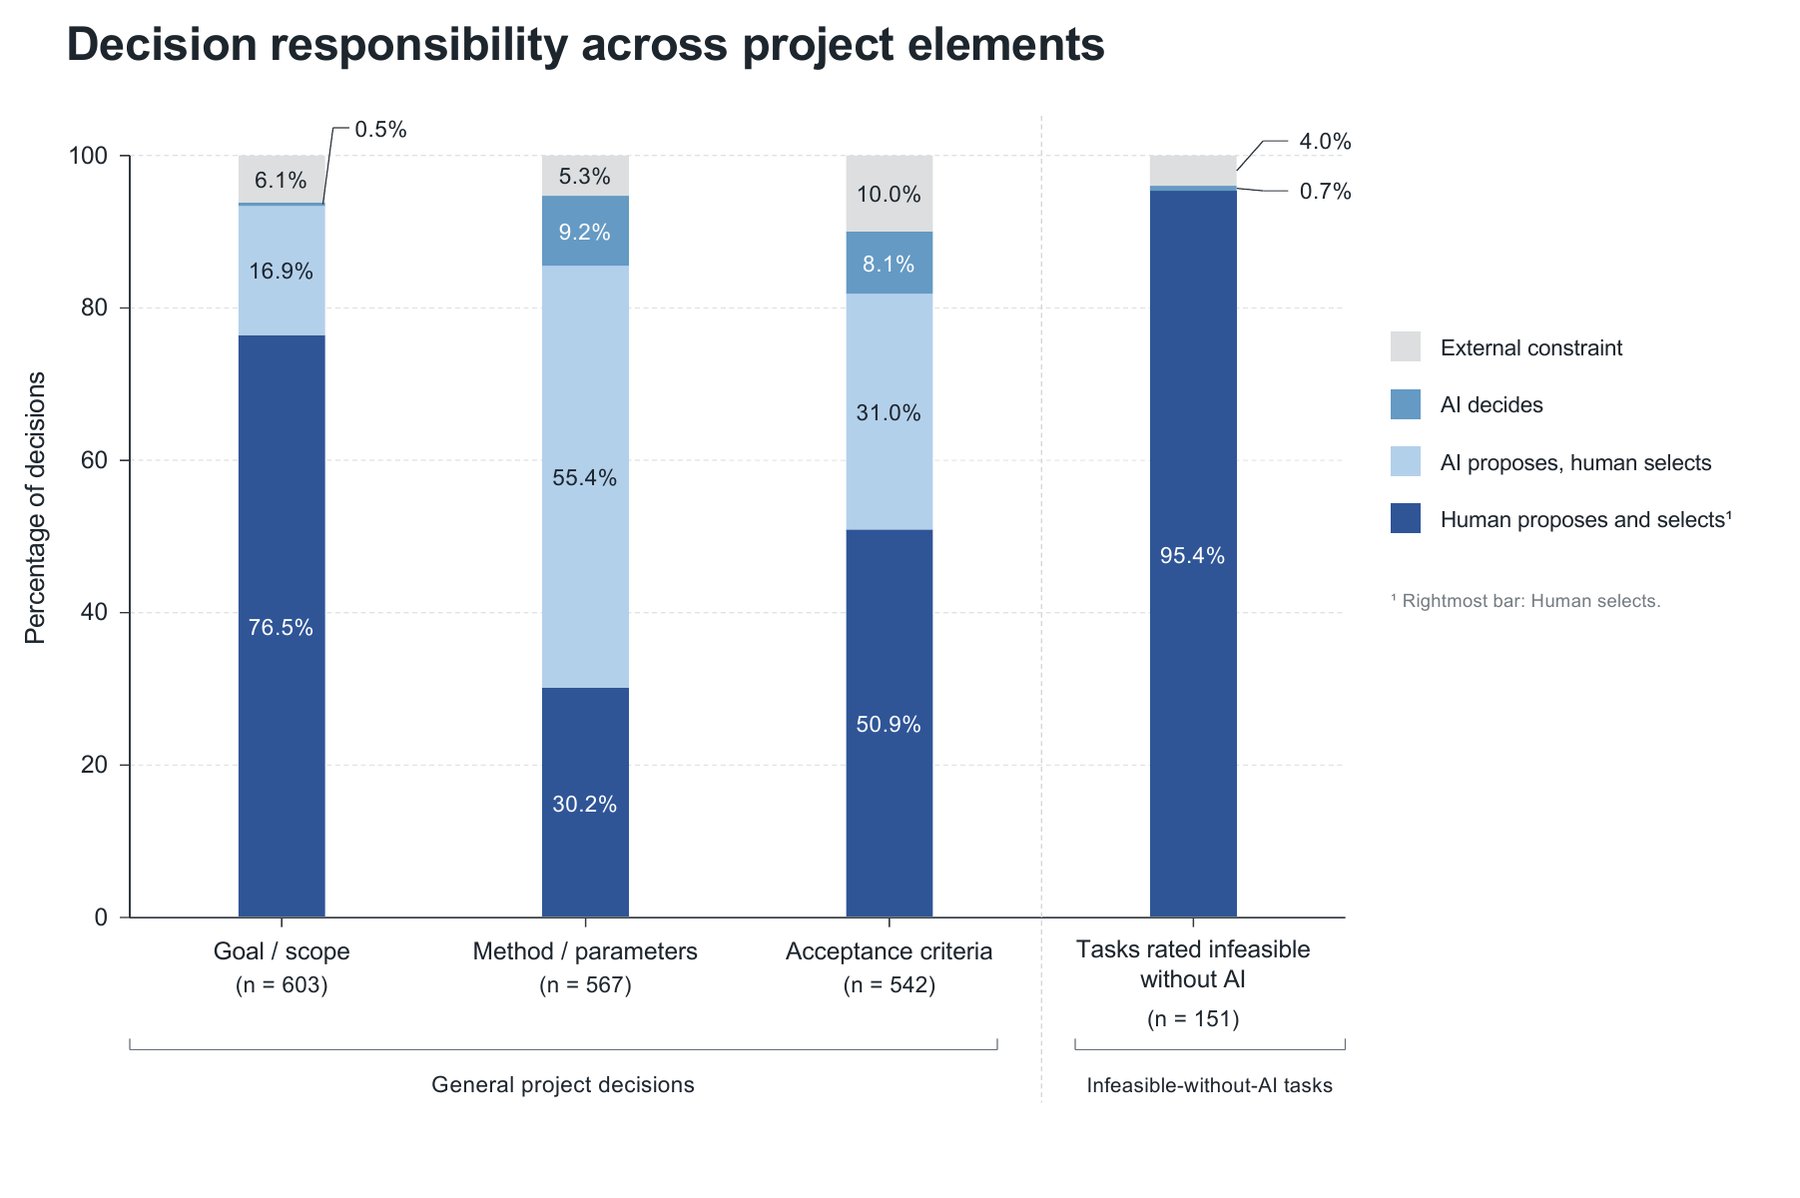
在方法和参数的选择上,最常见的模式是“AI 提议、人类选择”,占 55.4%。总体来看,关于方法和参数的决策中,人类做出 85.5%,AI 仅做出 9.2%。而在目标和范围的最终决定上,人类占 93.4%。
按决策类型不同,AI 参与提议的比例在 17% 到 55% 之间浮动,但它在最终决策中的占比始终是个位数。谁提出方案差异很大,但最终拍板的绝大多数始终是人类。即便在那 151 个被认为离开 AI 无法完成的任务中,目标由人类敲定的比例也高达 95.4%。
人类提供背景,而非体力劳动
当出现问题时,同样的模式也会出现。在 588 个有难度记录的任务中,76% 通过人类干预得以推进,而 23% 则由 Agent 自行解决。人类帮助几乎总是以信息形式出现,例如补充背景信息或澄清需求(35.2%),或者诊断问题并切换方法(34.7%)。人类很少亲自执行工作。部分编辑仅占 3.2%,完全接管则只有 0.7%。
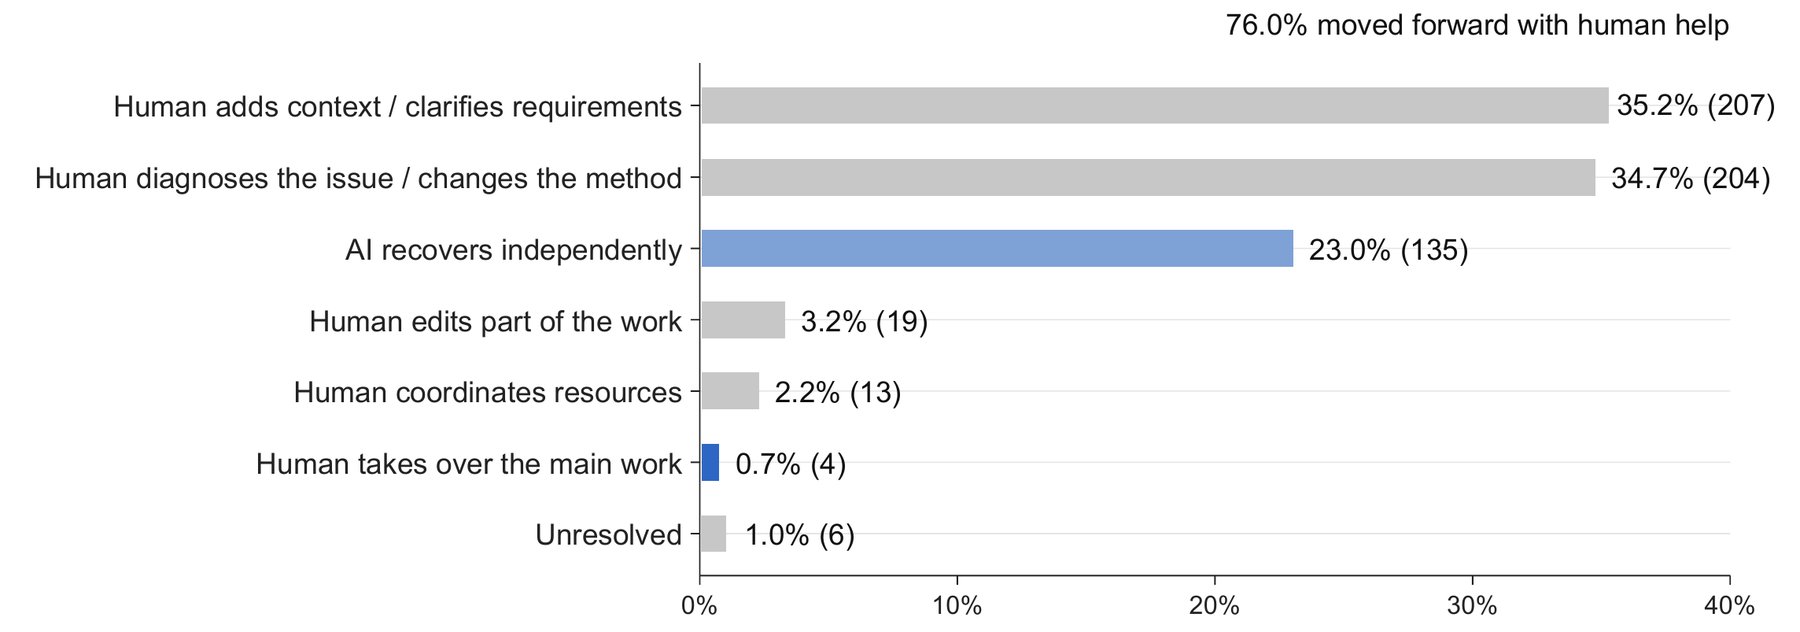
当 AI 输出需要修改时,在收到人类反馈后,AI 在 75.4% 的情况下自行完成了更改。瓶颈在于人类的判断,而非执行。
该团队描述了 AI 角色的三个阶段:从研究对象,到单任务工具,再到如今的项目伙伴。在当前角色中,AI 在人类设定的目标下起草和调整计划。一个推测性的第四阶段将涉及递归自我改进,即更强的模型产生更强的后继者。
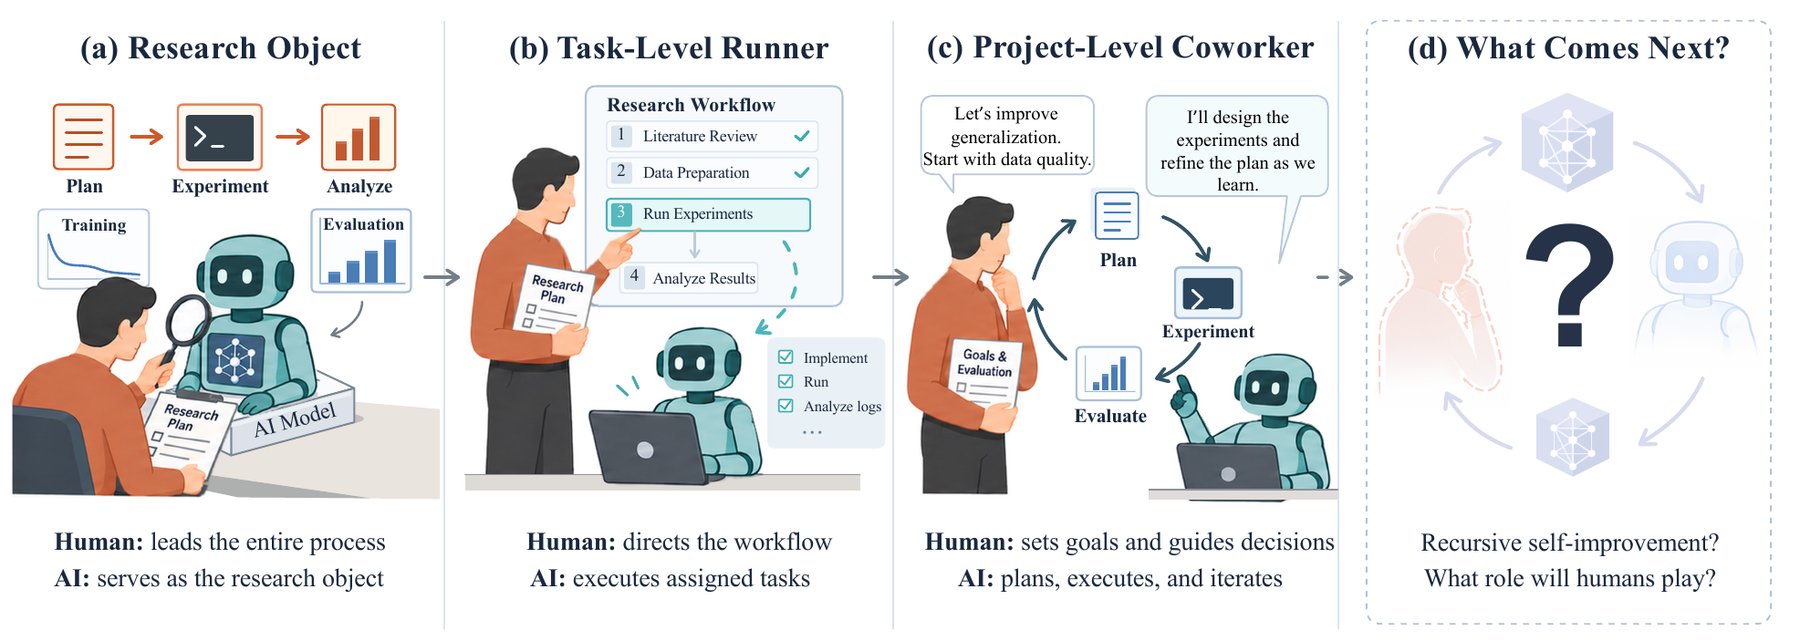
作者指出,模型可以在提升训练任务表现的同时,并不一定在开发其继任者方面变得更强。在结果尚未显现之前,AI 如何提出多样化的研究方向并评估其价值,仍是一个悬而未决的问题。
橡皮图章风险
当所有决策都依赖比任何人类都能审阅更长的 Agent 工作链条时,监督就变得困难。团队写道,最糟糕的情况是,人类沦为只能对所见内容进行“橡皮图章”式审批的审阅者。许多参与者在运行 Agent 时也采用了自主模式,以避免频繁的人工确认打断长时间的任务运行。这一边界的划定源于便利性,而非对 AI 应拥有多少权力的深思熟虑。
这篇论文发表于关于递归自我改进的激烈争论之中。Anthropic 认为,AI 开发自身继任者的时间可能比预期更早,其 CEO Dario Amodei 因此呼吁行业实行速度限制。据 Anthropic 称,目前关于该公司研究方向的决定中,人类仅做出个位数的比例。OpenAI 使用 GPT-5.6 Sol贯穿其整个开发周期,而 Google 和 DeepMind 则利用 Dream-RSI 让 AI Agent 通过记录在案的搜索轨迹探索替代策略,尽管它们仅改进了搜索策略,而非模型本身。
一千多名顶尖 AI 公司的员工最近警告称,他们所在的公司可能即将实现 AI 研究的自动化。另一项由 Princeton 和英国 AI Security Institute 开展的研究则得出了与 Atria 团队更为一致的结论:前沿模型能胜任研究工程类工作,但在真正关键的价值判断上却无能为力。