
DeepSeek mHC多流残差坍塌失效了?

核心结论:mHC 的四条残差流并未被均匀使用 —— 读写权重集中在约两条流上;深层(22–42 层)残差混合已接近单位矩阵。干预实验显示:去掉最弱读写路径六任务平均分最多下降 0.38 个百分点,深层残差混合矩阵替换为单位矩阵后六任务平均分基本不变(84.22 → 84.26),浅层固定为平均矩阵仅下降 0.25 个百分点。
论文题目:How Does mHC Use Its Residual Streams? Selective Routing and Near-Identity Mixing
论文链接:https://arxiv.org/html/2609.05309v1
DeepSeek-V4-Flash 采用 mHC 结构维护四条残差流,但在实际计算中,它们并没有被均匀使用。mHC 会为每个 token 单独生成读写权重,因此路由可以随输入变化。然而,在训练后的模型中,同一子层的主导流选择对 token 呈现出较强的一致性:对于同一个 Attention 或 FFN 子层,读写权重通常集中在约两条残差流上。残差混合矩阵也呈现出退化形态:虽然浅层仍然存在一定程度的跨流混合,但是到了第 22–42 层,残差混合矩阵已经接近单位矩阵。
我们进一步在推理阶段干预,分别去掉每个 token 读或写权重最小的路径后,PPL 最多上升 2.7%,六个任务的平均分最多下降 0.38 个百分点。将第 22–42 层的残差混合矩阵替换为单位矩阵后,PPL 上升 1.9%,任务平均分则基本保持不变。浅层虽然不能直接用单位矩阵取代(替换后 PPL 上升 41.4%),但是固定为其在 C4 校准集上的 token 平均矩阵(即保留本身的混合结构、去掉逐 token 的变化),PPL 仅上升 0.2%,六个任务的平均分下降 0.25 个百分点。
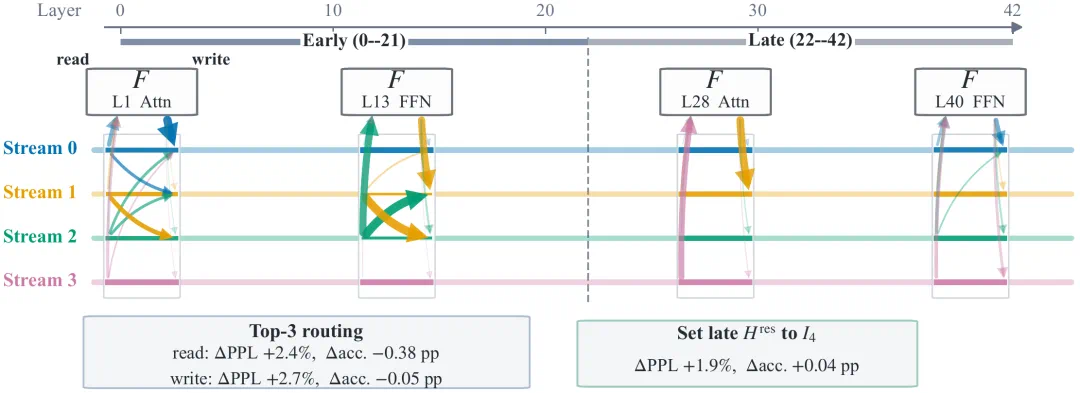
图 1|四流 mHC 的读写主要集中在少数残差流上,主导流随深度切换;浅层保留跨流混合,深层则接近各条流独立传递。
从单流残差到多流残差
在标准 Transformer 中,每个 Attention 或 FFN 子层都从同一条残差流读取隐藏状态,并将计算结果加回这条流。Hyper-Connections(HC) 及 Manifold-Constrained Hyper-Connections(mHC) 将单条残差流扩展为多条并行流。
在本文分析的 DeepSeek-V4-Flash 模型中,mHC 维护四条残差流。将第个 Attention 或 FFN 子层的输入残差流记为,该子层的更新为:
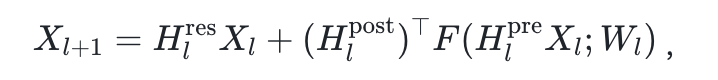
对单个 token,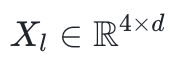 ,其中 d 为隐藏状态维度。读映射和写映射分别由行向量
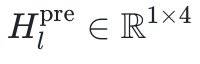 和
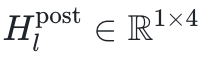 表示,残差混合映射由矩阵
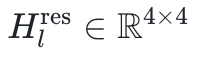 表示。这三个映射均采用依赖输入的参数化方式:模型根据当前 token 在该子层的隐藏状态,通过可学习参数生成读写权重和残差混合矩阵。F 表示 Attention 或 FFN 计算, 为其参数。
mHC 还使用 Sinkhorn–Knopp 迭代对 进行归一化,将其约束为双随机矩阵,即元素非负、每行和每列的元素之和均为 1,以改善训练稳定性。单位矩阵也满足该约束,当接近单位矩阵时,各条流主要沿残差通路独立传递。不过,mHC 并未将直接固定为单位矩阵,保留了动态混合的能力。
mHC 允许模型随输入调整四条残差流的读写和混合方式,但训练后的模型如何使用这些流,又在多大程度上依赖这种动态性,仍不清楚。因此,我们分析了 DeepSeek-V4-Flash 前向计算中的读写权重、残差混合矩阵和各条流的隐藏状态,并通过推理时干预,检验裁剪读写路径或替换残差混合矩阵对模型性能的影响。
分析对象与评测设置
我们使用公开的 DeepSeek-V4-Flash-0731 权重进行分析。我们从 C4 数据集中随机采样 512 个长度为 1,024 的序列,在前向计算中记录各子层为每个 token 生成的读写权重和残差混合矩阵,以观察这些映射随输入和网络深度的变化。另外,我们通过 C4 数据集困惑度(PPL)和六个零样本任务(ARC-Easy、ARC-Challenge、PIQA、HellaSwag、MMLU 和 GSM8K)评估干预后的模型性能。
读写路由的集中程度与主导流选择
读映射 和写映射 分别决定每个子层从哪些残差流读取、向哪些残差流写入。对于每个 token,我们将读或写权重最大的那条残差流称为「主导流」,然后定义以下指标考察不同 token 是否选择相同的主导流,以及读写权重集中在多少条残差流上:
主导流一致性:在同一个子层,选择最常见主导流的 token 占比。
有效流数量:将读或写权重归一化为 ,计算 ,衡量权重分布相当于使用多少条流。
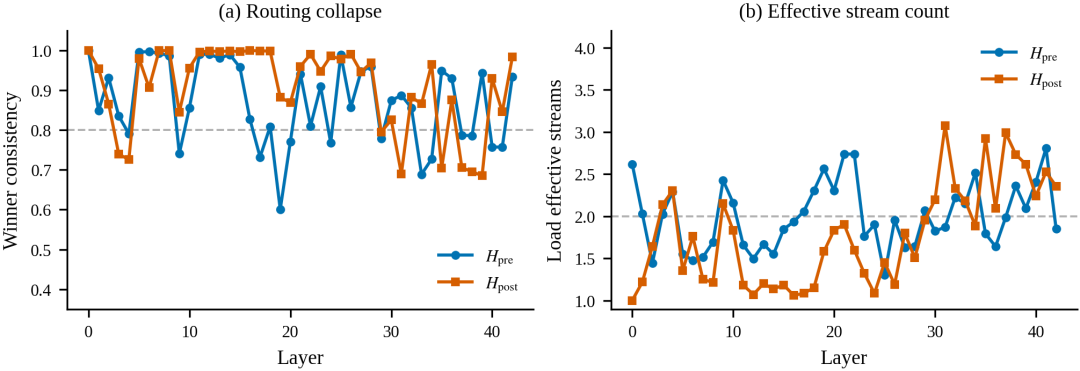
图 2|左:主导流一致性;右:有效流数量。每个点合并了同层 Attention 和 FFN 子层的统计结果。
图 2 中,读映射的主导流一致性平均为 0.871,写映射为 0.905。也就是说,在一个给定子层内,大多数 token 往往共享同一条主导流。
与此同时,读映射平均对应 1.998 条有效流,写映射为 1.775 条。这说明尽管架构提供了四条流,一次典型的 Attention 或 FFN 计算实际上只把主要权重放在约两条流上。
上述统计描述了单个子层内的路由模式。图 3 进一步展示各条流在不同子层中的平均读写权重。
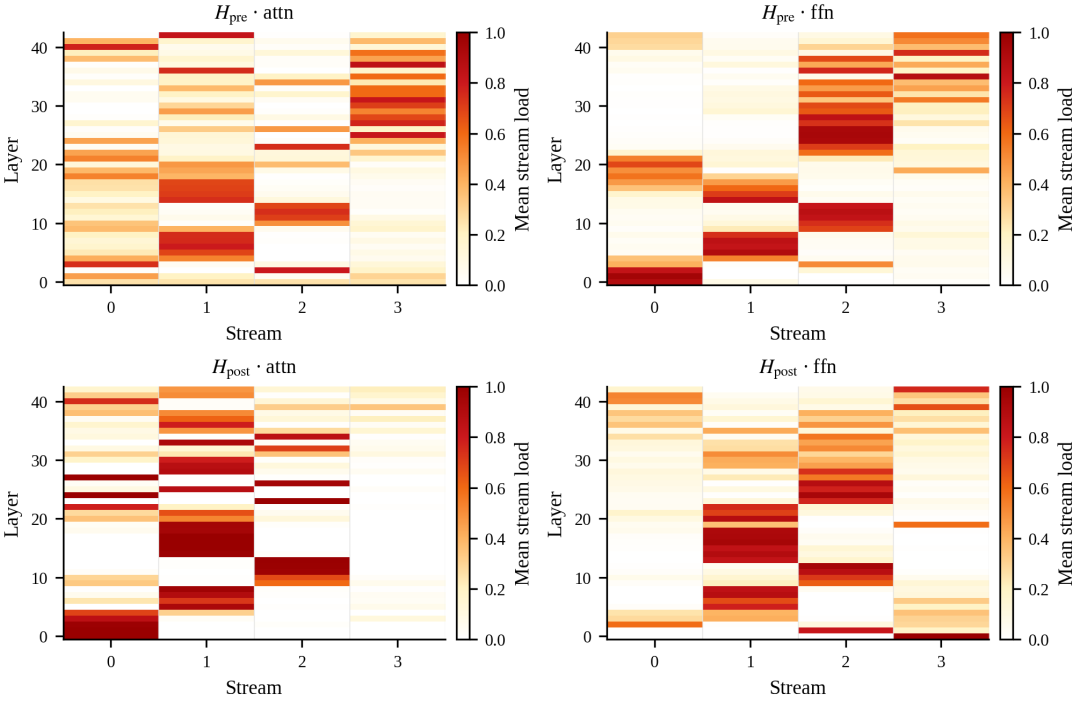
图 3|四类位置上的平均流负载。高负载区域形成连续的深度区间,但主导流会随层、子层类型以及读写映射发生切换。
残差流之间的表示相似度
一个需要进一步检查的问题是:四条流的表示是否已经趋于相似,从而使模型只需集中访问其中少数几条?我们在每个 Attention 或 FFN 子层计算四条流隐藏状态之间的余弦相似度,共得到六组两两比较,结果见图 4。
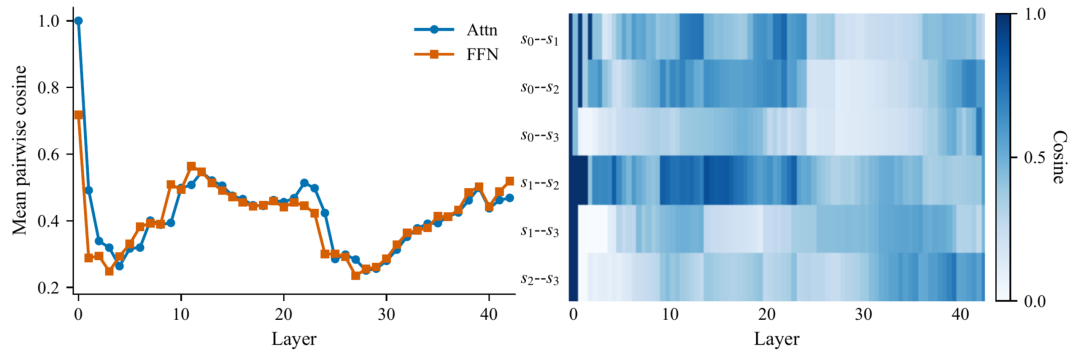
图 4|四条残差流两两之间的余弦相似度随深度的变化。左图为六组流对的平均值,右图分别展示各组流对,颜色越深表示余弦相似度越高。
图 4 左图中,四条残差流在模型入口处的余弦相似度为 1,因为它们由同一份输入表示复制而来。经过第一个 Transformer 层后,各条流的表示开始分化;在之后的网络中,六组流对的平均余弦相似度介于 0.235 和 0.564 之间,总体平均为 0.404。也就是说,各条流在前几层就形成了方向上不同的表示,此后也没有重新趋于一致。
右图将六组流对分开展示,每一行对应一组流对,颜色越深表示余弦相似度越高。从各行的颜色变化可以看出,不同流对随深度呈现出不同的变化,也没有哪一对残差流在整个网络中始终保持较高的相似度。
不过,表示方向是否相同,与具体读写路径是否必要,是两个不同的问题。即使某条流的表示方向与其他流不同,当分配给它较小的读写权重时,仍可能对模型输出影响有限。这些较弱的读写路径能否裁剪,需要通过后面的推理时干预检验。
残差混合映射随深度的变化
我们用残差混合矩阵与单位矩阵的平均绝对偏差衡量各子层的跨流混合强度:
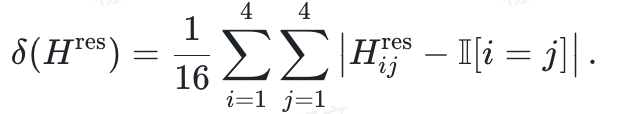
当为单位矩阵时,,四条流沿残差通路各自传递。图 5 给出了每个 Attention 和 FFN 子层在校准 token 上的平均值。
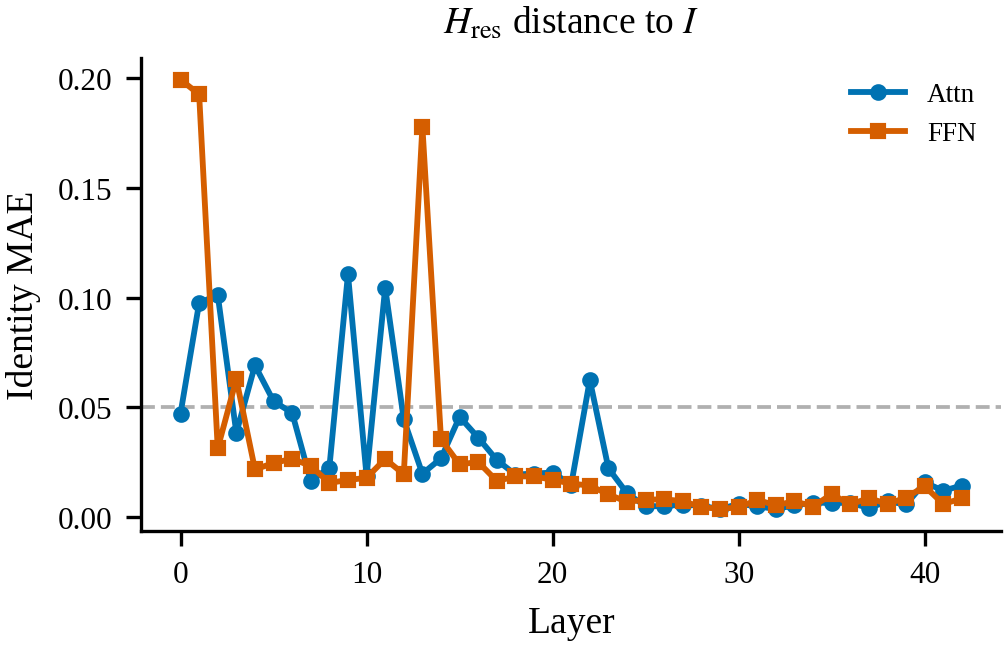
图 5|Attention 和 FFN 子层的单位矩阵偏离,每个点为校准 token 上的平均值。
图 5 显示,较大的偏离主要出现在模型前半部分。在第 22 层后,残差混合矩阵逐渐接近单位矩阵。在第 23–42 层的 40 个子层中,有 32 个子层的偏离低于 0.01。图 6 分别给出了第 0–21 层和第 22–42 层的平均残差混合矩阵:
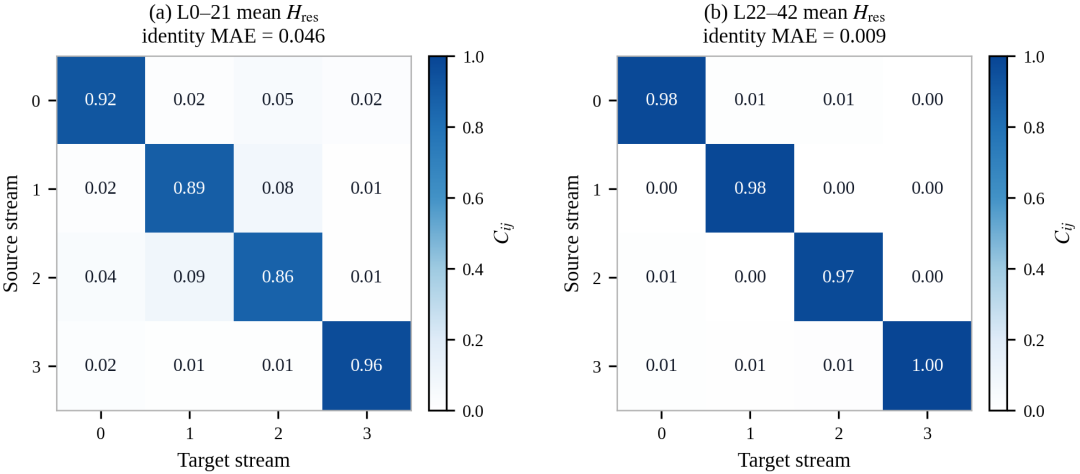
图 6|第 0–21 层和第 22–42 层的平均残差混合矩阵。
这更直观地呈现了这种深度差异:第 0–21 层的平均矩阵中仍能看到非对角权重;第 22–42 层的平均矩阵则已接近单位矩阵。
读写路径裁剪与残差混合映射替换
读写路径裁剪
对每个 token 和每个子层,我们分别在读映射和写映射中保留权重最大的
路径,再将保留的权重等比例缩放,使权重之和与裁剪前相同。
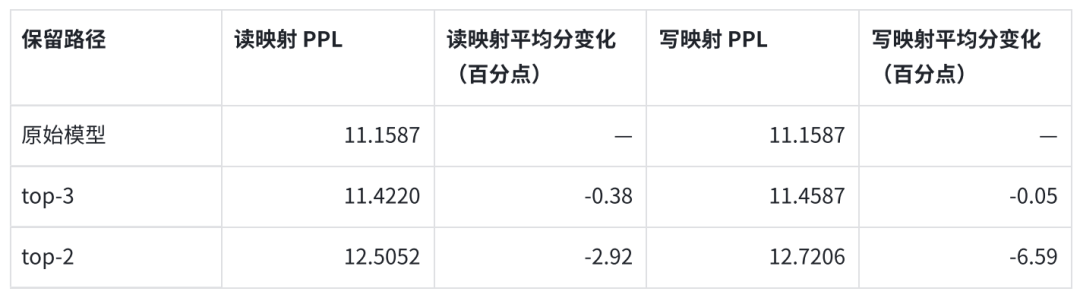
保留 top-3 时,读写路径裁剪对 PPL 和六个任务平均分的影响都较小。进一步裁剪到 top-2 后,两项指标的变化明显增大,其中写映射裁剪的影响更大。因此,权重最小的一条路径可以近似移除。
残差混合映射替换
我们将指定深度范围内的残差混合矩阵替换为。我们还用每个浅层子层在 C4 校准集 token 上的平均矩阵,替代该子层原本动态生成的矩阵,单独考察逐 token 变化的作用。
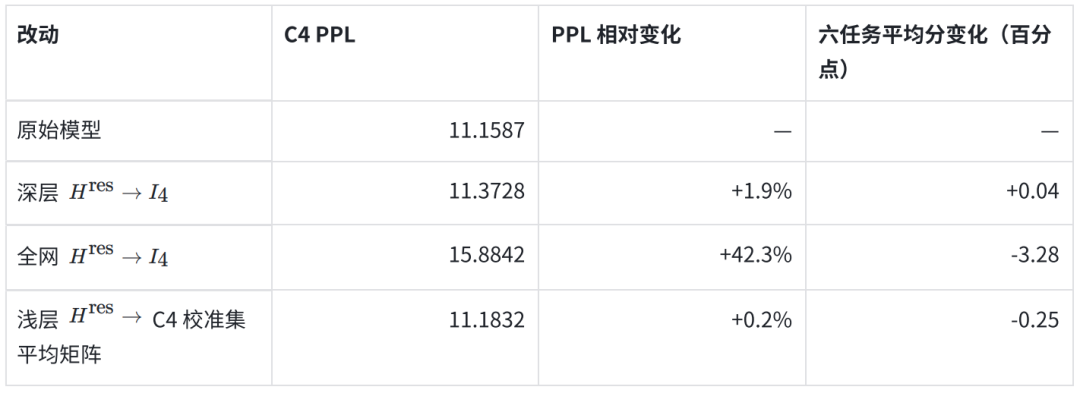
将深层残差混合矩阵替换为 后,PPL 上升 1.9%,六任务平均分变化 +0.04 个百分点;将全部残差混合矩阵替换为 后,PPL 上升 42.3%,六任务平均分下降 3.28 个百分点。这说明关闭深层的直接跨流混合影响较小,但全网都换成单位矩阵会带来明显的性能下降。
将浅层固定为各子层的 C4 平均矩阵后,PPL 上升 0.2%,六任务平均分下降 0.25 个百分点。这项干预固定了浅层的跨流混合方式,说明逐 token 变化带来的额外作用有限。
图 7 进一步列出每个任务的得分变化:
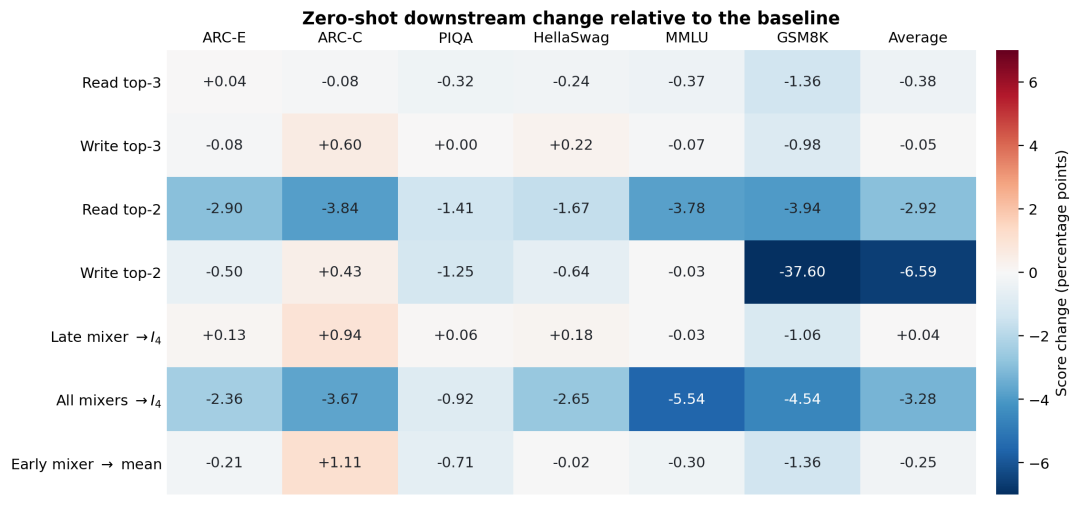
图 7|各项干预相对原始模型的零样本分数变化,单位为百分点。为突出常见变化范围,色阶在 ±7 处截断,格内数字保留真实变化值。
讨论:多流残差结构的简化方向
在读写路由上,部分低权重路径可以移除,但继续提高裁剪强度会带来性能下降。因此,可以探索在保留多流结构的同时,适当降低读写路由的密度。这样的设计能否兼顾模型性能与计算效率,需要在相应的架构中重新训练和评估。
残差混合映射则表现出明显的深度差异:深层替换为恒等映射后,模型性能变化较小;浅层仍需要跨流混合,但同一子层内的逐 token 变化作用有限。因此,可以探索让残差混合映射的动态性随深度变化,而不必在所有层采用相同的机制。近期的两个多流模型已经采用了更简单的残差通路:腾讯 Hy4-preview 的 identity Hyper-Connections(iHC)将 固定为单位矩阵,Qwen3.8-Flash-Next 的 Gated Residual 则直接去掉这一映射。按本文的记号,两者都相当于令 。