
从 Computer-Use 到 Robot-Use:一套接口让 VLM 直接「玩转」真实机器人
标题:Show-Harness: Just a VLM Agent Can Play Robots
作者:Yanzhe Chen*, Zechen Bai*, Zhijun Cao*, Wenzheng Zeng*, Kevin Qinghong Lin, Yiqi Lin, Guoqiang Liang, Kevin Yuchen Ma, Qiming Huang, Mike Zheng Shou†
单位:新加坡国立大学 Showlab
项目主页:https://showlab.github.io/Show-Harness/
论文链接:https://arxiv.org/abs/2609.10522
开源代码:https://github.com/showlab/Show-Harness
开源模型:https://huggingface.co/showlab/Show-Harness-VLMs
开源数据:https://huggingface.co/datasets/showlab/Show-Harness-Data
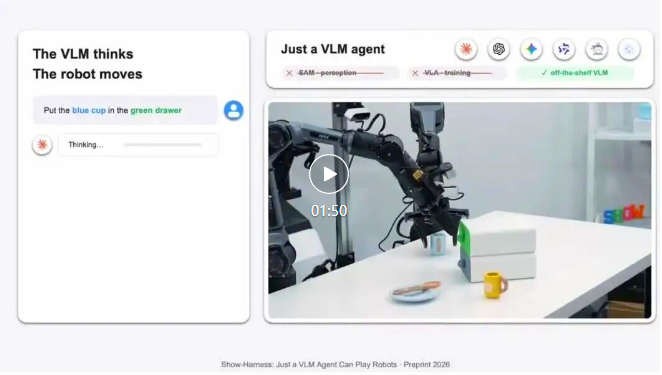 今天的 Agent 已经能看懂屏幕、理解任务,并通过 click、type、scroll 等鼠标键盘操作来完成数字世界的任务,那么它距离操控真实世界里的机器人,还差什么?
过去一段时间,越来越多工作开始尝试让 GPT、Claude、Gemini 等 frontier models 参与真实机器人控制。这背后有一个很直接的判断:当我们讨论具身智能时,常常强调 “具身”,但核心仍然是 “智能”。而今天最强的智能,包括视觉理解、空间推理和任务分解等能力,都逐渐集中到 frontier foundation models 中。
问题在于,这些能力并不会自然的变成机器人动作。过去的研究尝试了不同的路线去利用 foundation model。传统的 VLA 往往让模型基于图像和任务指令直接回归连续控制量;另一类系统则让大模型只负责规划,再由独立的控制器完成物理执行。前者需要为不同机器人和数据分布反复适配,后者又拉开了语义决策与实际动作之间的距离。
新加坡国立大学 Show Lab 的研究者提出 Show-Harness。这个工作的出发点不是再训练一个更大的机器人策略,而是追问:如果给 foundation model 一个它能够理解、组合并持续校正的物理接口,它已有的智能能否更直接地进入物理世界?
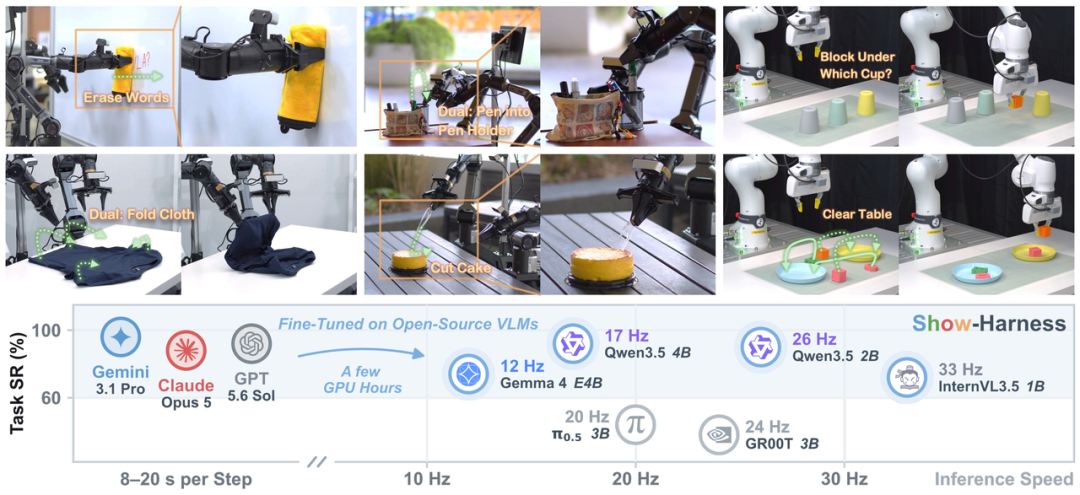
图 1:Show-Harness 在不同任务、环境、机器人形态和模型上的真实机器人演示
Robot-Use 也需要接口
Computer-Use 相关的研究给出了一个很直观的参照。在电脑上,Agent 并不需要输出底层驱动信号;它面对的是 click、type、scroll 等清晰、可组合、能从观察中验证结果的动作接口。模型据此形成 observe → reason → act 的闭环。
机器人控制也可以从类似的视角重新理解。真正难的并不只是 “让模型决定一个动作”,而是设计一层接口:它既要让 VLM 能够把视觉和空间理解映射到行动意图,又要足够细粒度,能在真实世界中完成接近、对齐、抓取、放置和修正。
Show-Harness 作为专门为具身智能设计的 Embodied Harness,其核心就是这样一套介于模型和机器人控制之间的语义动作接口:对于模型而言,动作是可读、可推理的语义单元;对于机器人而言,动作会由各自的解释器转成受安全边界约束的本地控制命令。
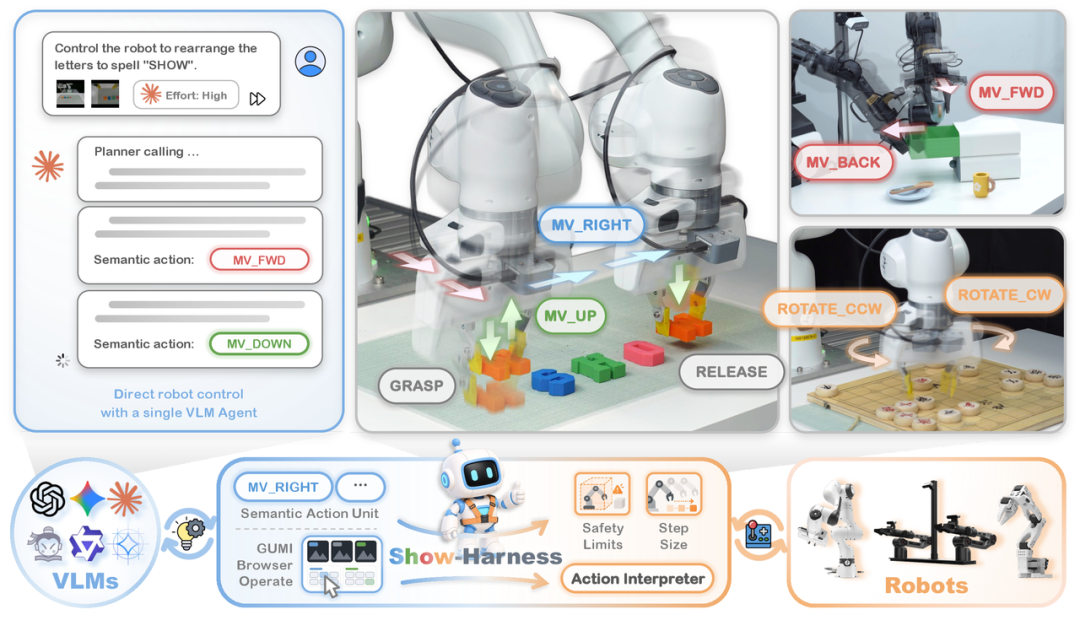
图 2:Show-Harness 概览。不同 VLM 通过同一语义接口与不同机器人形态连接
不让 VLM 去 “猜” 连续控制量,而是让它持续做细粒度决策
Show-Harness 的动作空间包含一组紧凑的语义动作单元。例如,模型可以选择相对于当前参考视角的前后、左右、上下移动,也可以做绕特定轴的旋转、抓取、释放或结束任务。
这种表示有两个关键点:
语义上可理解。 模型不必直接输出关节或末端位姿数值,而是围绕 “目标在什么方向”“下一步应靠近还是下移”“是否已经对齐” 来决策。这种更明确的语义表达更容易被模型所理解,并在其上进行推理。
物理上可落地。 每一个语义单元都对应一个小而有界的物理变化。不同机器人通过各自的动作解释器,把相同的动作意图映射为各自的运动控制目标。
因此,模型侧接口不随机器人形态改变;改变具身平台时,系统替换的是底层动作解释器,而不是要求 VLM 重新学习一套面向关节和坐标系的动作语言。对零样本 frontier agent 而言,论文中的跨具身本体的切换仅通过更换机器人底层控制解释器完成。
更重要的是,这不是一次性输出长计划再 “盲执行”。Harness 将多视角图像、机器人本体状态、短期动作历史和任务描述组织进循环:模型观察当前状态、分解或更新子任务、做出语义动作,执行后再根据新的视觉与状态反馈继续修正。
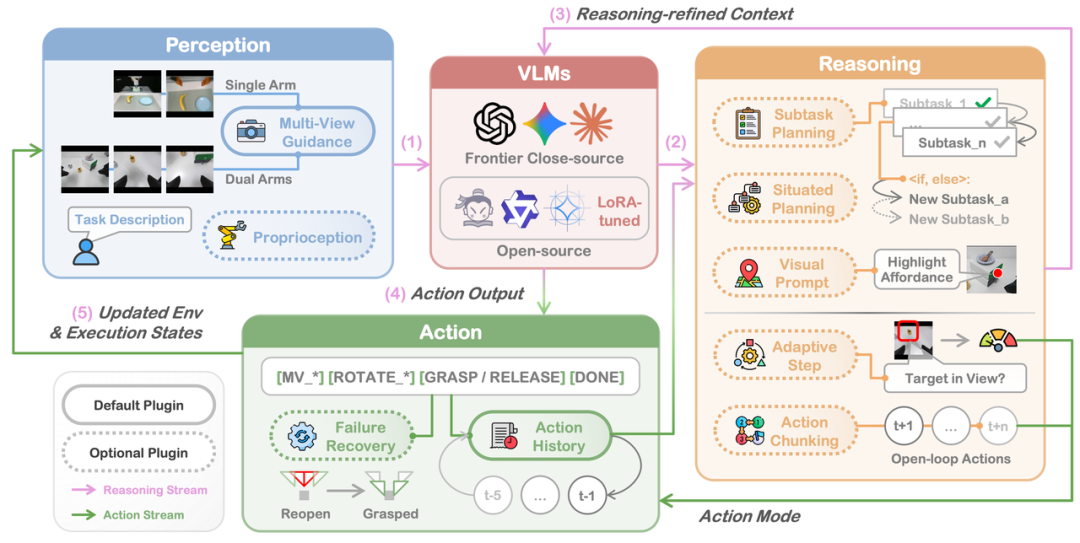
图 3:Show-Harness 的 perceive–reason–act 闭环。感知、推理与执行模块围绕共享语义接口组织。
GUMI:一套 GUI,同时服务人类和 Computer-Use Agent
如果语义动作本身可读、可理解、可操作,它就不应只属于模型。Show-Harness 团队进一步构建了 GUMI(GUI-based Manipulation Interface),把同一套机器人语义动作单元呈现为浏览器中的图形控件和键盘快捷键。
这形成一个很自然的统一:
人类操作者可以通过键盘远程 “玩” 机器人,不需要额外的专用遥操作硬件;
Computer-Use agent 可以像操作网页一样操作同一个 GUI 来控制机器人;
VLM robot agent 则可以直接预测同一套语义动作,而无需经过 GUI 点击。
每一步操作前的观察与被选择的语义动作会被记录成 (observation, action) 数据对。由于动作解释器同时保留相应的低层命令和轨迹,一份 demonstration data 既可用于训练基于 Show-Harness 的动作策略,也可转化为连续控制 policy 的数据;同样的流程还能覆盖单臂、双臂、仿真和真机,并允许人在 agent 执行过程中介入修正。
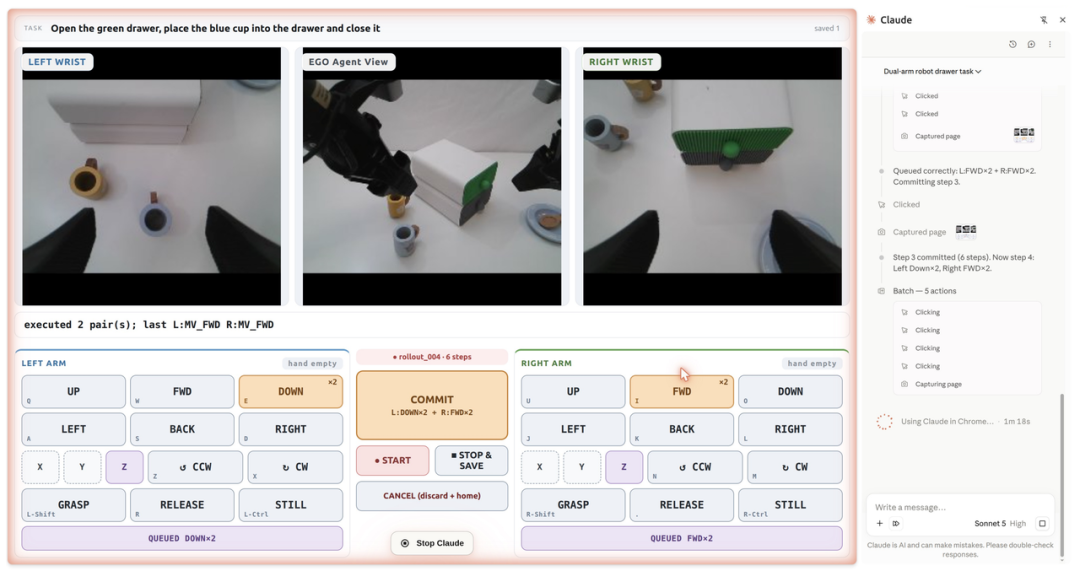
图 4:GUMI 将语义动作做成 GUI。左侧是双臂机器人控制界面,右侧展示 Computer-Use agent 通过浏览器操作同一界面。
论文中,团队通过 GUMI 在真实机器人上采集了 164 条遥操数据、约 7.8K 个决策步骤:其中 Franka 为 101 条(5.0K 步),AgileX 为 63 条(2.8K 步)。仿真部分则收集了 230 条遥操数据、13.5K 个决策步骤,覆盖 ManiSkill 与 RoboLab 两个环境。
从更高的视角来看,GUMI 不只是一个数据采集工具。它把人类控制、GUI agent 控制和 VLM 直接控制对齐到同一动作语义中,让 “人如何示范”“Agent 如何操作”“模型如何学习” 不再是彼此割裂的三条管线。
同一套动作接口,跨模型、跨本体、跨任务
这套语义动作接口的目标不是绑定某一个特定的模型,而是成为 foundation model 和物理系统之间的通用层。论文首先从模型、机器人本体和任务三个维度展示了同一接口的适用范围。
跨模型。 对闭源 frontier VLM,Show-Harness 无需微调即可进入真实机器人的闭环;对小型开源 VLM,可在同一动作空间上进行轻量适配。论文默认使用 Qwen3.5-2B,仅在语言模型线性层加入 rank-64 LoRA,冻结视觉编码器和多模态投影层,更新约 3% 参数。
跨机器人本体。 论文中的实验覆盖 7 自由度的 Franka 和 6 自由度的 AgileX(含双臂场景)。模型面对的是同一套语义动作接口,底层由各平台的动作解释器完成落地。需要强调的是:zero-shot 模式通过更换底层控制解释器切换具机器人本体;轻量后训练模式则使用两种平台收集的 demonstration 数据进行联合训练。
跨任务与环境。 真机任务演示从日常 pick-and-place,扩展到陌生物体、背景 / 光照 / 视角 / 干扰物变化、空间推理,以及双臂开抽屉等操作。首图中的擦除文字、双臂折衣服、将笔放入笔筒、切蛋糕等场景,也展示了这套动作抽象可以承载比标准抓放更丰富的任务过程。
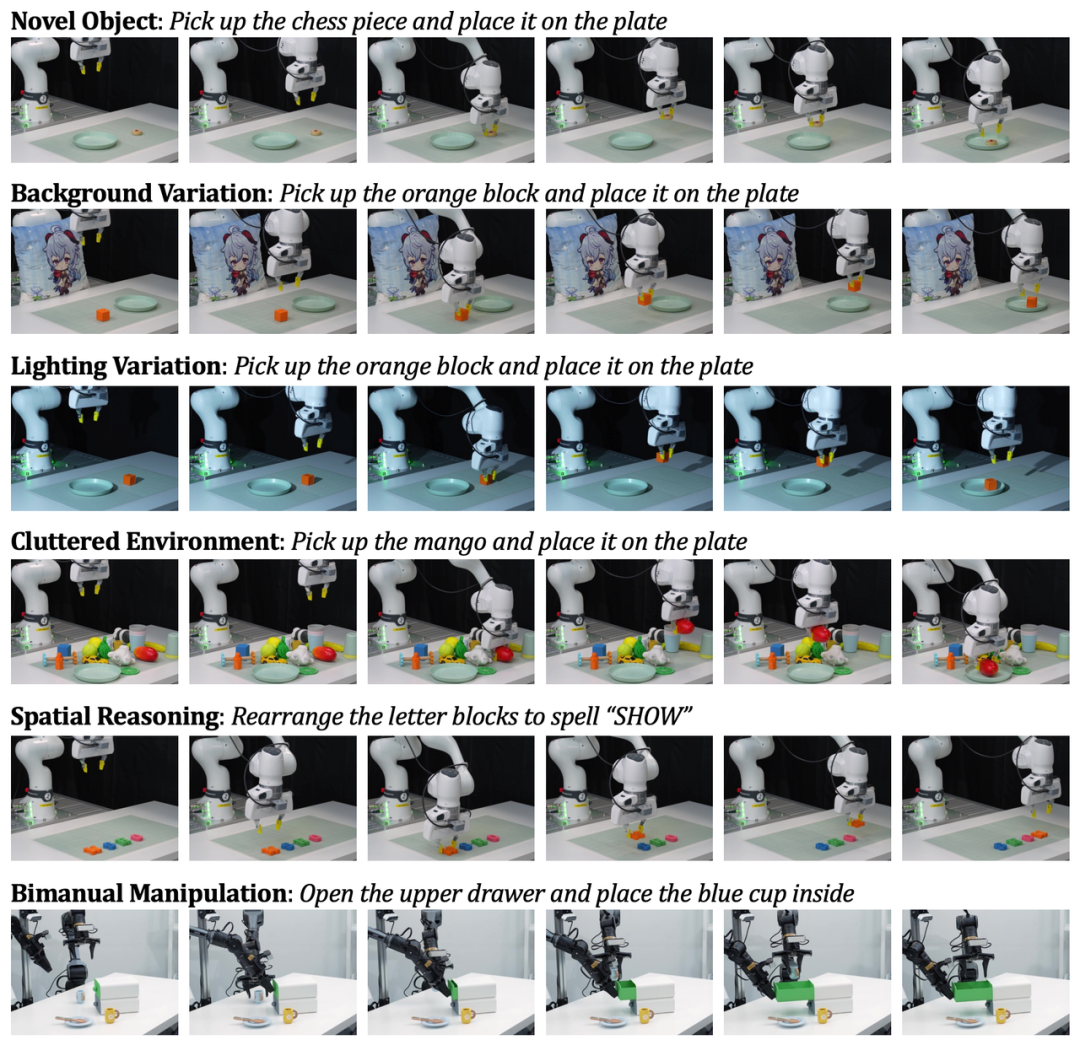
图 5:真实机器人上的泛化演示,包括新物体、环境变化、空间推理和双臂操作。
真机上的三层泛化
进一步地,Show-Harness 在真机实验上从跨任务、跨环境、跨本体三个维度来综合评测泛化能力。下表中的 ZS 为零样本 frontier VLM,FT 为轻量后训练的 Qwen3.5-2B;每项为对应设置下的平均成功率。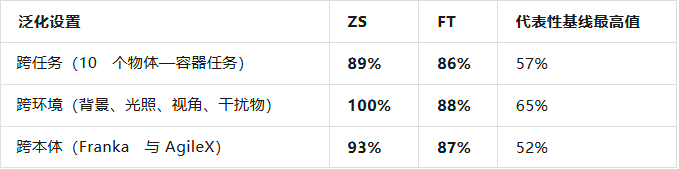
此外,在 sim-to-real 实验中,FT 模式仅使用通过同一界面收集的 230 条仿真示范训练,迁移到真实 Franka 后完成 13/20 次任务;论文中的可训练 VLA 对比方法在该设置下均为 0/20。
当然,这些任务成功率的数字并不意味着 “机器人控制已经解决”。更准确的解读是:在论文测试的操作任务与分布变化中,一个语义上足够清晰、物理上足够细粒度的接口,可以让 frontier model 的现有能力更好地转化为可执行的机器人控制,也可以让小模型以较低的成本获得更强的迁移性。
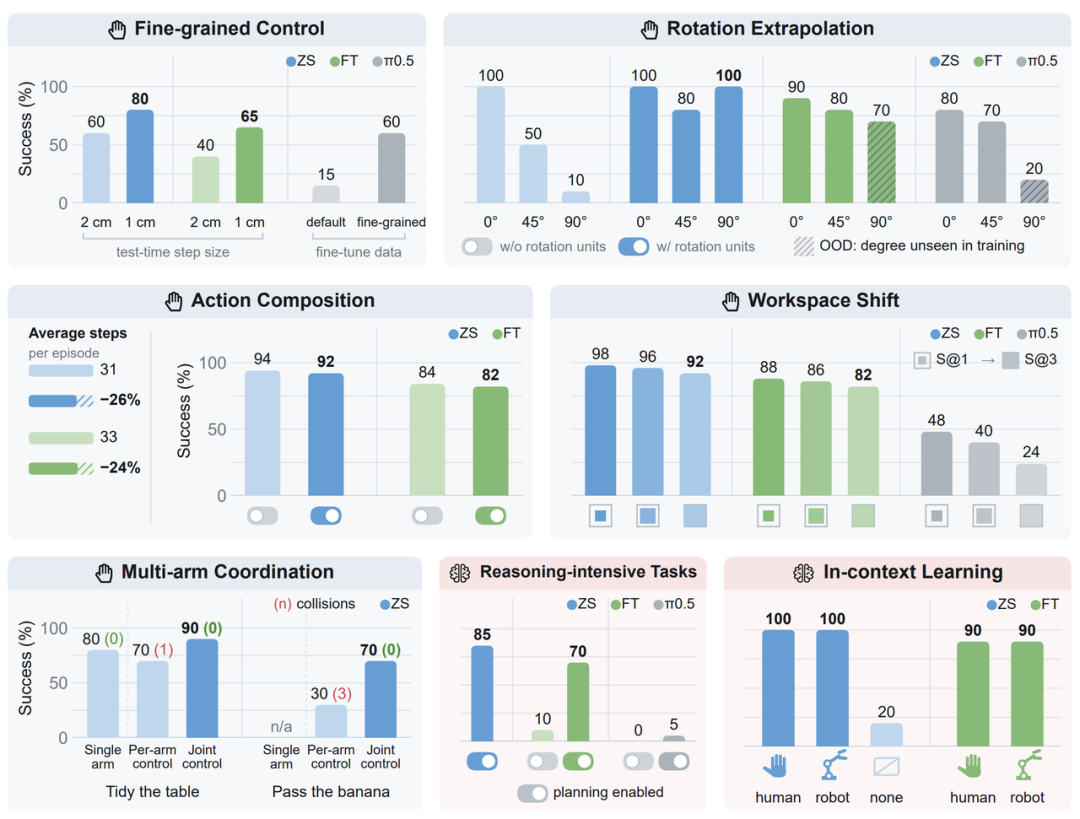
图 6:论文对精细控制、旋转外推、动作组合、工作空间变化、多臂协作、推理任务与 in-context learning 的进一步分析。
前面的实验展示 Show-Harness 在任务、环境和具身变化下的广泛泛化能力。一个更困难的问题是:Show-Harness 在多大程度上能让 foundation model 适应新的物理与语义需求?为此,如上图所示,团队通过一系列针对性场景考察了两种互补的适应能力:物理适应性,即无需重新训练策略,便能应对运动精度、动作组合、工作空间和具身形态的变化;以及语义适应性,即处理需要推理,或需要从新示范中进行 in-context learning 的任务。
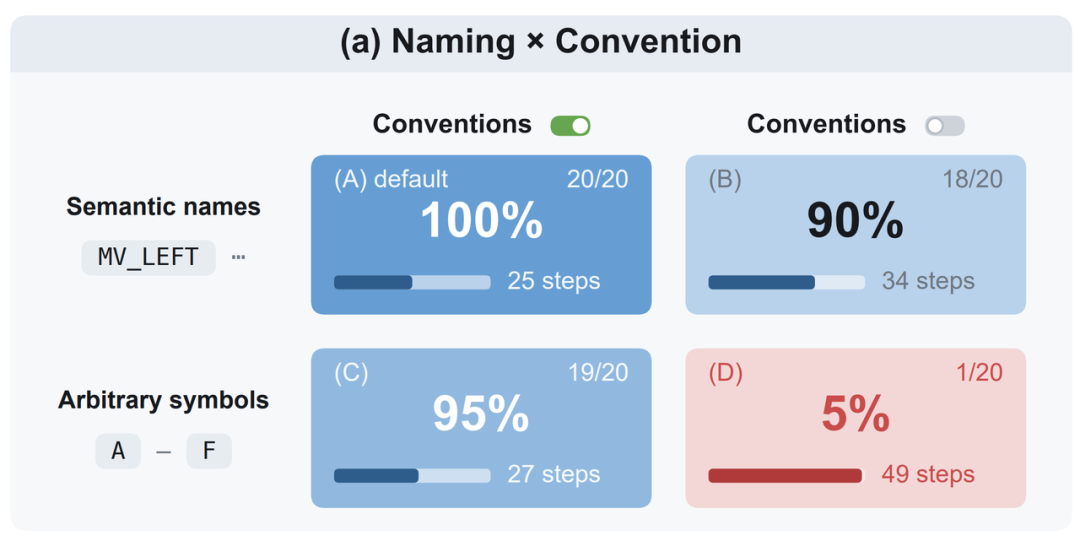
图 7:动作命名与物理约定的 2×2 控制变量实验。
另一组实验则进一步解释了接口的作用:把直观的动作名称换成 A–F,但保留明确的物理约定,成功率仍达到 95%;只保留语义名称、不解释约定,也能达到 90%;当名称和约定同时移除,成功率则降至 5%。也就是说,语义名称已经能够调用模型已有的空间先验,而明确、稳定的 “符号 — 物理效果” 约定,则是接口完成动作 grounding 的关键。
结语:Embodied Harness 是基座模型走向物理世界的接口
从 Computer-Use 到 Robot-Use,变化的其实不仅仅是环境:前者操作的是屏幕上的数字对象,后者面对的是存在不确定性、接触和安全约束的物理世界。但相同的是,它们都需要一个模型能够理解、又能把结果反馈回来的交互接口。
Show-Harness 提供了一种具体尝试:不是把 foundation model 的智能简单压缩进一组连续控制量,也不让它停在高层规划;而是在模型与机器人之间加入一个 Embodied Harness,把多视角观察、推理、语义决策、具身解释与执行反馈组织为持续闭环。
也许未来 Computer Agent 和 Robot Agent 并不是两套完全独立的系统,而是 foundation model 通过不同接口与数字世界、物理世界交互的两种形式。如何设计这些接口,可能会成为把通用智能真正带入具身系统的一项关键工作。
延伸阅读:从 Show-Harness 到 Multimodal Embodied Agent
在 Show-Harness 之后,Show Lab 团队进一步发布了综述 Survey on Multimodal Embodied Agents: From Computer-Use to Robot-Use,从单个系统进一步放大视野,讨论多模态 Agent 从数字环境走向物理世界时,能力结构与研究问题发生了哪些变化。
该综述以 Perceive → Anticipate → Plan → Act → Verify(PAPAV)为统一框架,梳理多模态 Agent、机器人系统及二者走向融合的研究版图;配套的 Awesome Repo 也将持续收录这一快速演进方向中的相关工作。
Awesome Repo:https://github.com/showlab/Awesome-Multimodal-Embodied-Agent
项目主页:https://showlab.github.io/Awesome-Multimodal-Embodied-Agent/
作者信息:
本研究由新加坡国立大学 ShowLab 团队主导完成。
共一作者 Yanzhe Chen 陈彦哲(博士生), Zechen Bai 白泽琛(博士生),Zhijun Cao 曹植竣(硕士生)和 Wenzheng Zeng 曾文正(博士生)均来自 ShowLab@NUS,长期聚焦于多模态理解和具身智能相关研究。
项目负责人为新加坡国立大学校长青年助理教授 Mike Zheng Shou 寿政。