
【科研速递/AI*中医药】当大语言模型走进针灸诊室:fNIRS+眼动揭示“脑补偿”机制
文章标题:《Brain compensation mechanisms of large language models in clinical decision-making in acupuncture: A fusion study using fNIRS and eye-tracking》发表期刊:Expert Systems with Applications (IF=9.4)Online时间:2025-12-18
摘要:研究提出 知识图谱增强的神经认知框架,将 fNIRS(功能性近红外光谱) 与 眼动追踪 结合,用于研究大语言模型(LLMs)在针灸临床决策中的“脑补偿机制”。研究构建了一个面向针灸穴位配伍的领域 LLMs,融合中医古籍、现代教材、临床病例与知识图谱,并采用知识增强生成(KAG)与混合推理提升准确性和可解释性。实验将 60 名参与者随机分为 AI 辅助组和非 AI 辅助组,执行穴位配伍任务。结果显示:模型在配伍任务中达到 72% 准确率;AI 组在认知负荷相关脑区激活更低,眼动注视时间更短、注意力调整更少,提示 AI 辅助可降低认知负担、提升认知效率。
研究背景:
针灸选穴与配伍是临床针灸疗效的关键,依赖医师长期经验、隐性知识和复杂认知判断。
传统 RAG 或序列式流程容易丢失领域语义关系,导致准确率下降、认知负荷升高、可解释性不足。
知识图谱(KG)与 KAG 可增强 LLMs 的领域知识感知和推理能力。
研究问题:LLMs 能否减轻医师信息过载、重复任务与认知偏差?能否让医师聚焦更高阶的症状解释与临床决策?
研究方法:
1. 总体框架:
知识图谱增强的神经认知框架,融合 fNIRS、眼动、经典文献与临床知识。
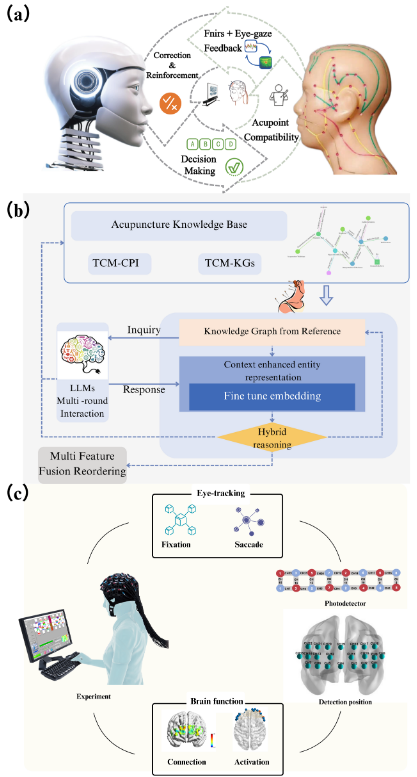
图1 研究工作流程概述。(a) 大脑和人工智能之间相互作用的概念图,突出了人工智能在认知任务相关大脑疲劳机制中的补偿作用。(b) 通过增强针灸语料库知识图谱来构建经络兼容性大语言模型。(c) 设计实验控制任务,利用fNIRS和眼球跟踪信号来讨论人工智能对大脑机制的影响。
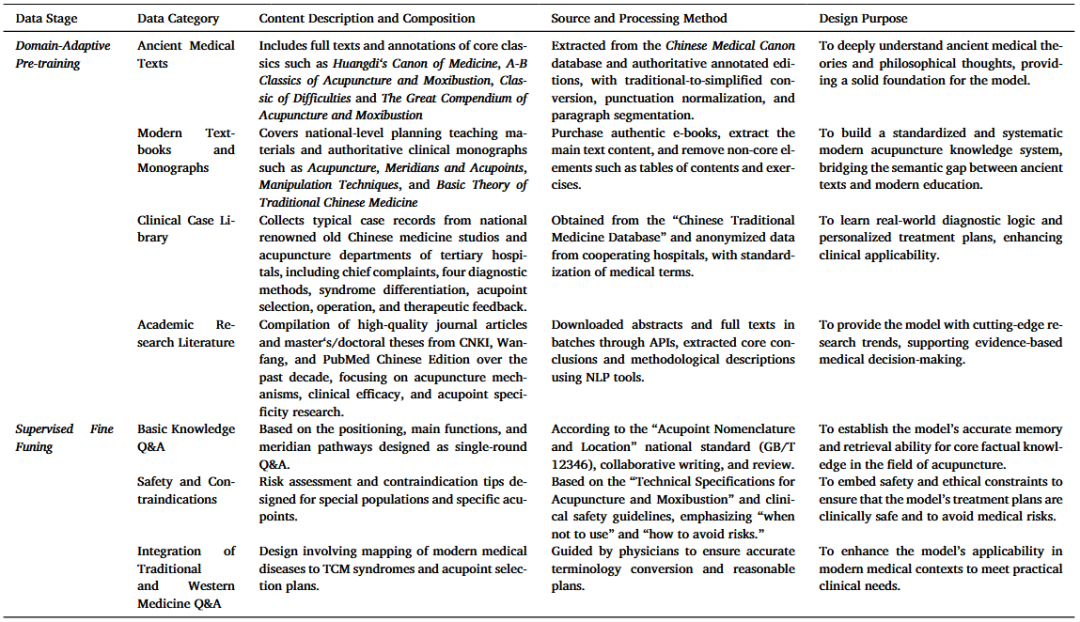
2. 数据与知识库:
古籍:《黄帝内经》《针灸甲乙经》《难经》《针灸大成》等。
现代教材与专著:《针灸学》《经络腧穴学》《刺法灸法学》《中医基础理论》等。
临床病例库:来自中医药数据库及合作医院匿名数据。
监督微调数据:基础知识问答、安全与禁忌、中西医结合问答。
表1 穴位配伍大模型中的数据源和设计目标概述。
3. 模型构建:
基于 DeepSeek-V3 进行领域自适应微调;DeepSeek-V3 为 MoE 架构,总参数 671B,预训练语料 14.8T tokens。
跨文档链接:基于实体向量余弦相似度,设置阈值 τ,计算 F1 选择最佳阈值。
上下文增强实体表示:联合损失包括结构损失、文本损失、跨模态对齐损失。
嵌入微调:掩码语言建模、邻居预测、领域微调、任务导向微调、对比学习与难负样本挖掘。
逻辑形式引导的混合推理:两阶段,先识别意图与操作,再构建逻辑形式,结合 KG 查询与 LLM。
多特征融合重排序:融合语义相似度与图路径分数,动态调整平衡参数。
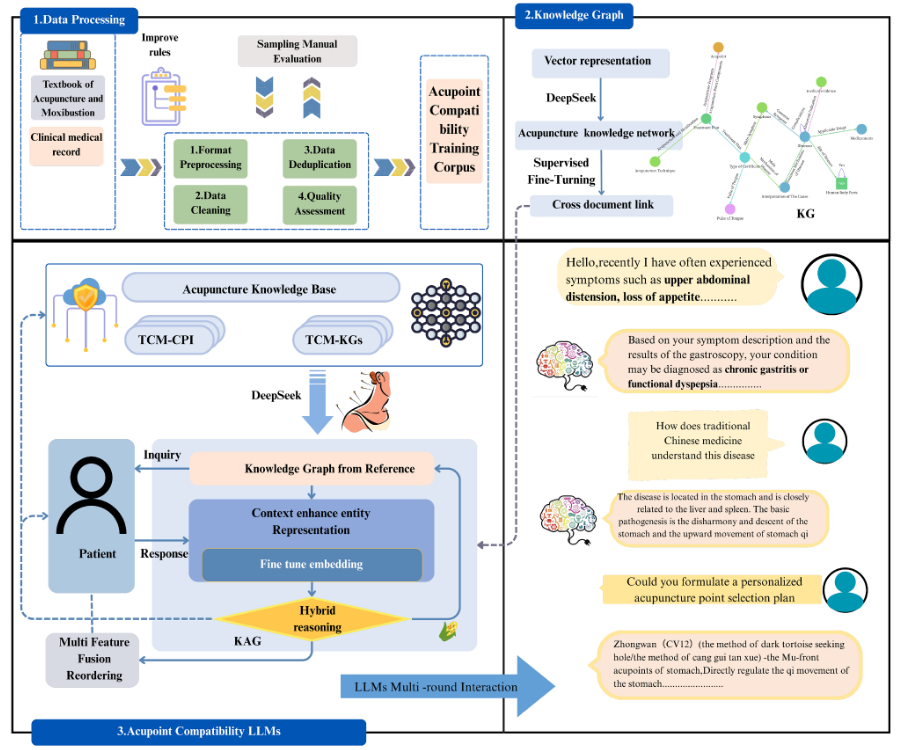
图2 构建穴位配伍大语言模型的方法。
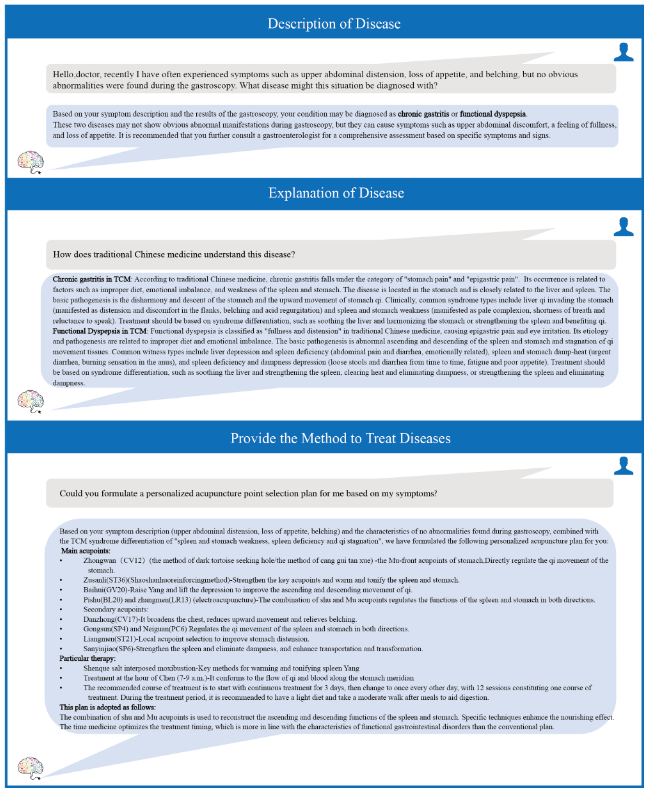
图3 基于中医的鉴别诊断和穴位选择的知识导向人工智能会诊系统。以功能性消化不良为例,根据症状描述和辨证分型,协同大语言模型,通过两阶段推理生成多回合交互穴位配伍方案。
4. 基线模型:ChatGPT、Chinese-LLaMA、DeepSeek-R1、ZhongJing、HuatuoGPT、GPT-4、GPT-3.5、DeepSeek-V3 等。5. 评价指标:- 分类:Accuracy、Precision、Recall、F1、AUC。
- 文本生成:Rouge-1/2/L、METEOR、BERTScore。
- 信息检索:nDCG、MRR、P@1、P@3、P@5。
实验设计:
参与者:60 人,18–25 岁,本科及以上,具备针灸理论知识与执业资格;排除抑郁/焦虑自评 ≥50 者。
分组:随机数字表分为 AI 组与非 AI 组。AI 组:使用所构建的 LLMs 根据病历辅助选择穴位配伍处方;非 AI 组:不借助 LLMs,自主完成选穴配伍。
任务流程:①静息 5 min 采集脑血氧信号;②AI 组使用 LLMs 辅助,非 AI 组手动选穴,任务约 20 min;③结束后再采集 3 min 静息信号。
同步采集:fNIRS + 眼动追踪 + 视频记录。
fNIRS 处理:修正 Beer-Lambert 定律转 OD,移动平均校正运动伪影,去除心跳、呼吸、Mayer 波,OD 转 HbO/HbR 浓度。
眼动指标:完整注视持续时间、眼开放度、瞳孔直径、首次完整注视持续时间、间隔持续时间、完整注视开始次数等。
结果与分析:
1. 模型性能(图4-6):
穴位配伍 LLMs 分类准确率 0.72,Recall 0.73,AUC 0.93,F1 表现最佳。
文本生成:Rouge-L 0.29、METEOR 0.36、BERTScore 0.91,优于多数基线。
信息检索:MRR 0.88、P@1 0.90、nDCG 0.85,排序与首条命中能力突出。
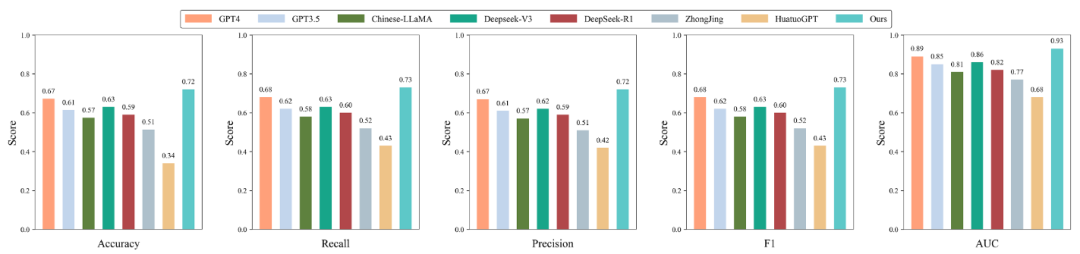 图4 分类评估指标主要用于评估分类任务的性能。
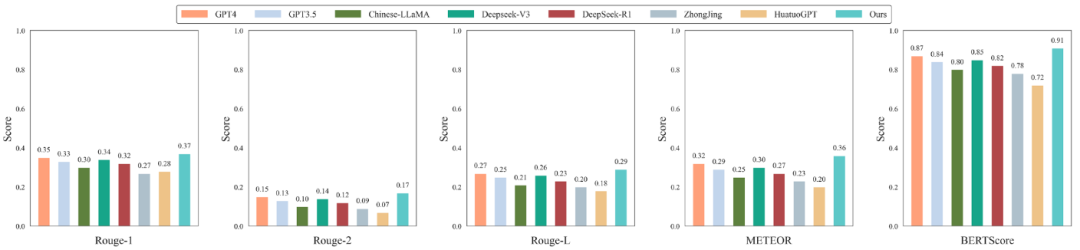 图5 文本生成评估指标的比较,主要用于评估生成文本和参考文本之间的表面相似性。图6 不同模型的信息检索评估指标比较,主要用于评估搜索和推荐系统的排名质量。
2. 消融实验(图7-9):
纯语言模型准确率 0.61;加入 KG 提升约 7%;加入 KAG 后达到 0.72。
Rouge-L 提升约 4%,METEOR 与 BERTScore 提升约 7%。
nDCG 提升 11%,MRR 提升 10%,P@1 提升 9%。
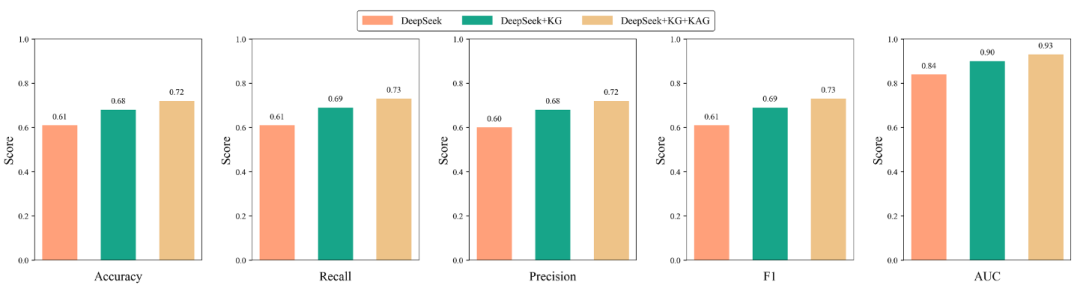 图7 消融模型分类评估指标的比较。
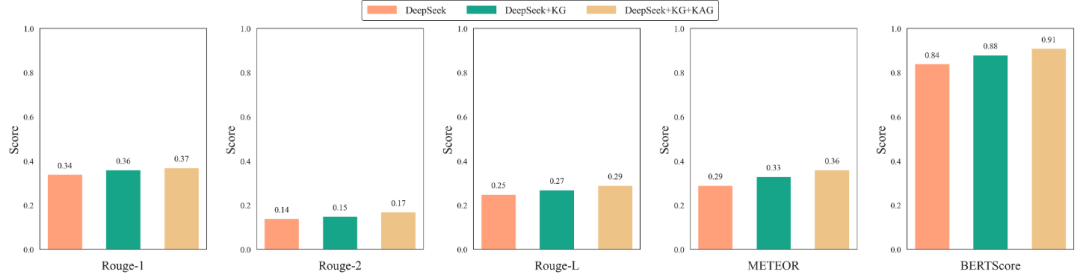 图8 消融模型的文本生成评估指标的比较。
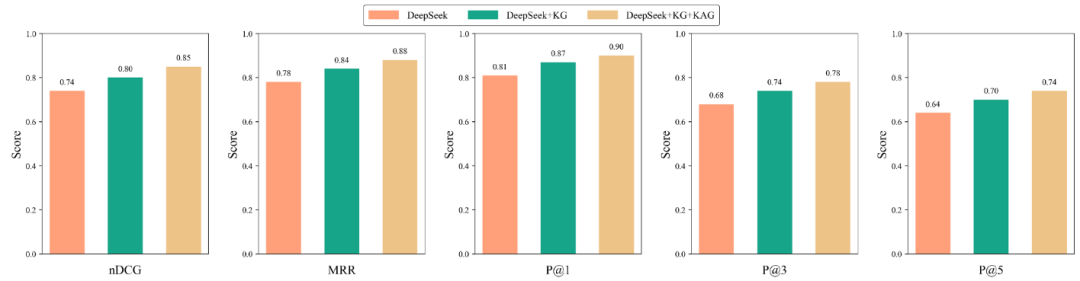 图9 信息检索中消融模型的评估指标。3. 计算负载(表2-4):
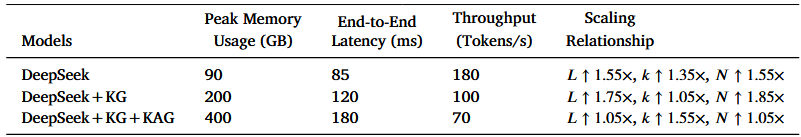
- 基础 DeepSeek 延迟 85 ms、吞吐 180 tokens/s。
- 加入 KG 后延迟 120 ms、吞吐 100 tokens/s。
- 进一步加入 KAG 后延迟 180 ms、吞吐 70 tokens/s,峰值内存 400 GB,但扩展性增强。
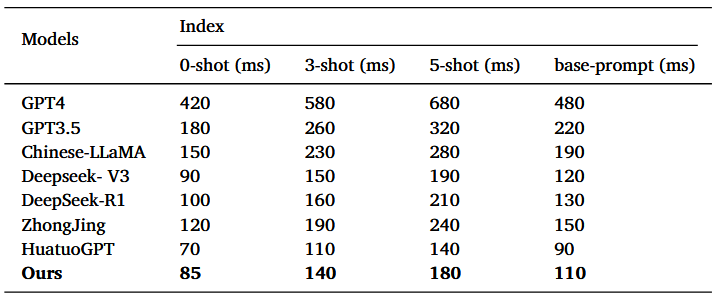 表3 不同模型的计算负荷。
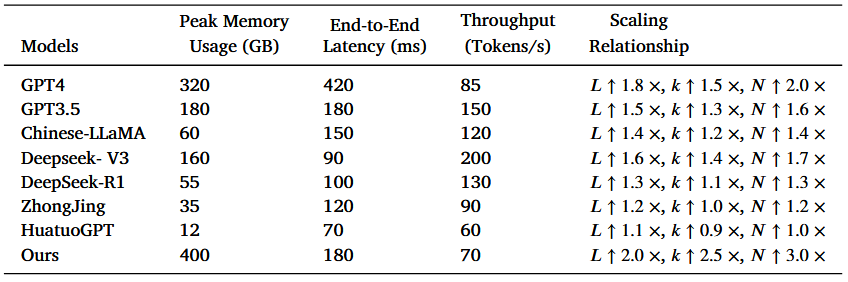
表4 消融模型的计算负荷。
4. 皮层激活:
AI 组:右额下回与双侧额中回正激活,提示工作记忆、规则应用等高级认知资源参与。
非 AI 组:右额下回与右额中回负激活,提示需要抑制部分额叶活动以维持注意,认知负荷更高。
组间差异集中在右额下回,AI 辅助降低该区域抑制需求。
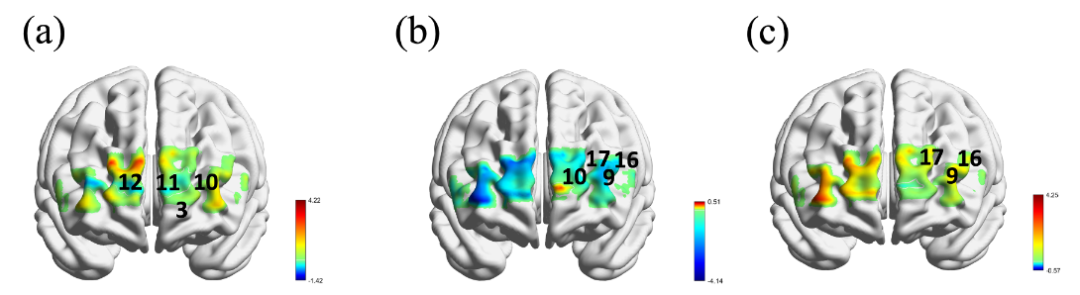
图11 皮层激活模式:(a)AI组;(b)非AI组;(c)人工智能和非人工智能参与者之间大脑激活模式的差异。
5. 功能连接(图12):- AI 组基于右额中回有 19 条显著增强连接,基于右额下回有 20 条。
- 非 AI 组分别为 17 条和 18 条。
- AI 组右额下回—右额中回连接增强,促进执行控制与工作记忆耦合,提升信息过滤与注意稳定性。
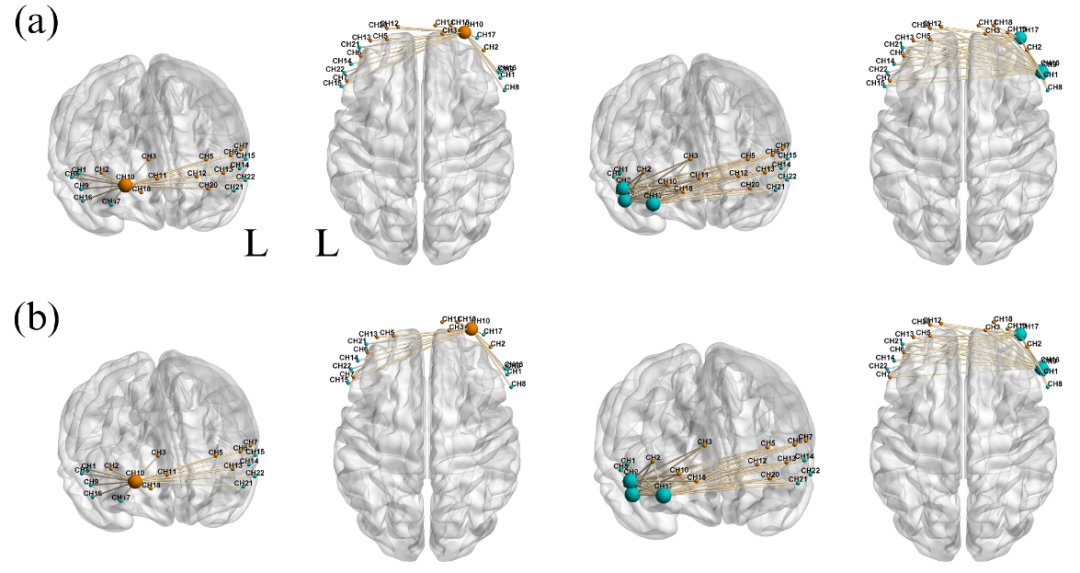 图12 使用公共和差异激活区域作为种子点的功能连通性分析。(a)AI组。(b)非AI组。6. 眼动结果(图13):
- AI 组平均完整注视持续时间显著更短,分布更集中,差异有统计学意义(Z = -3.093,p = 0.002)。
- AI 组首次完整注视时间更短、间隔持续时间更短、完整注视开始次数更少。
- 提示 AI 辅助可能降低决策不确定性、减少注意力漂移、优化工作记忆负荷与神经资源分配。
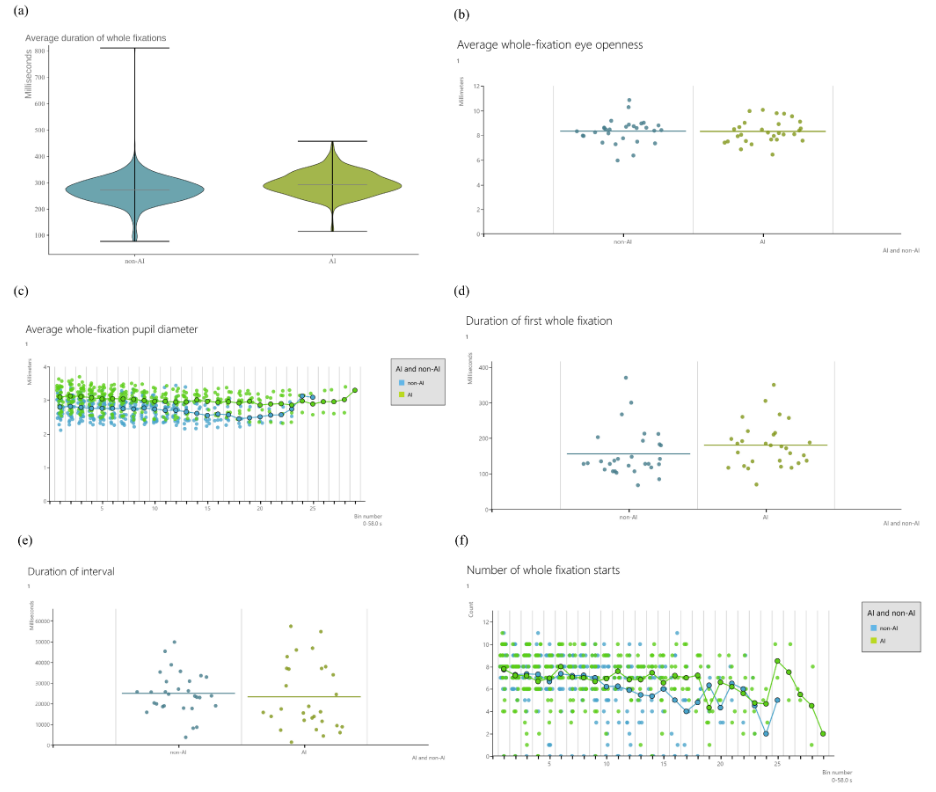 图13 两组的眼球追踪结果。(a)整个固定的平均持续时间。(b)平均全注视眼睛张开度。(c)平均全固定瞳孔直径。(d)第一次全固定的持续时间。(e)间隔持续时间。(f)全固定开始次数。
论文总结:
✅ 优点:1. 跨学科融合:AI 建模 + 神经影像 + 眼动 + 中医针灸;2. 模态证据链完整:模型性能、皮层激活、功能连接、眼动行为相互印证;3. 实验设计随机分组、同步采集 fNIRS 与眼动,生态效度与时间同步性较好;4. 为“人-AI 协作”提供神经认知层面的实证依据。 ⚠️ 局限:1. 实验室控制环境,未完全模拟真实临床复杂度和压力;2. 仅聚焦中医针灸穴位配伍任务,跨疾病、跨医学领域泛化性待验证;3. 计算成本较高,峰值内存 400 GB、吞吐下降至 70 tokens/s。🚀 未来方向:1. 高保真临床模拟或真实临床原位实验;2. 扩大参与者人群与疾病覆盖;3. 开展前瞻性临床研究,评估 GenAI 提升临床决策质量与效率的潜力。
注:本文内容均整理自原论文,点击“阅读原文”可跳转至论文页面。