
OpenTPUAI自主设计的大模型推理芯片
AI 自主设计的大模型推理芯片
从芯片架构 数据流 RTL HLS 运行时到真实 U50 推理
今天,我们介绍 OpenTPU:一个由 AI 自主构思、工程实现、验证并部署到真实硬件的大模型推理加速器项目。项目以 ASIC 为最终目标,以 AMD Xilinx Alveo U50 和 Ultra96 V2 作为验证载体,让架构选择在真实时钟、存储、布线和模型运行中接受检验。
AI 全栈设计 | 3 条 U50 路线 | 2 个模型 | 3.635 tok/s |
架构至发布 | 真实设计探索 | Qwen 与 Gemma | 公开最高解码实测 |
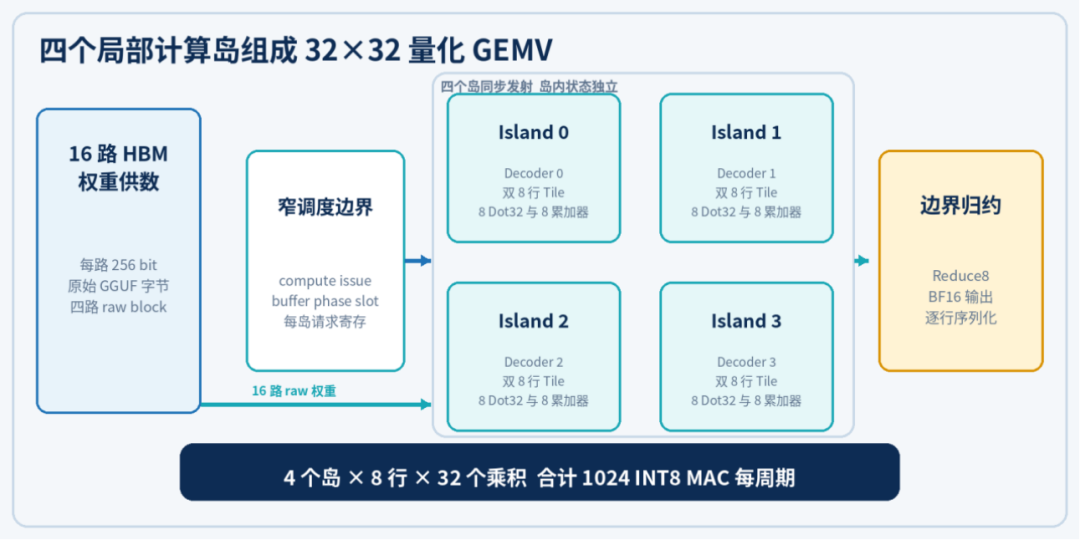
TPU32x32 的四个局部计算岛在每周期共同提供 1024 个 INT8 MAC
项目与运行包 github.com/SKYNETAI1/OpenTPU
AI AUTHORSHIP
AI 承担芯片设计全栈
OpenTPU 的核心主张不是用 AI 辅助某一道工序 而是让 AI 对完整工程链负责
OpenTPU 没有把 AI 限定为代码补全工具。根据项目的 AI Authorship Notice,仓库中的架构由 AI 为未来 ASIC 实现而构思和工程化,覆盖系统架构、计算与存储数据流、RTL/HLS、主机运行时、集成、验证、发布打包和文档。人的角色限定在目标、硬件访问和必要的实体板卡操作。
工程层 | AI 完成的工作 | 可核验输出 |
系统与架构 | 定义推理路径并探索计算阵列和局部性 | TPU2x512 TPU32x32 GPUTensor14 |
数据流 | 组织 GGUF 权重 HBM 激活 KV 与 SSM 状态 | 16 路 HBM 与 resident state |
硬件实现 | 生成和迭代 HLS Chisel SystemVerilog 与约束 | 可综合 RTL 与路由后 XCLBIN |
软件栈 | 实现模型解析 描述符 运行时 交互会话和采样 | CPython XRT 运行包 |
验证 | 构建算子 数值 背压 网表 完整模型和实板测试 | 双模型多 Token 与多轮结果 |
发布 | 生成启动器 完整性清单 兼容性说明和文档 | Git LFS 发布包与 SHA 256 清单 |
来源:OpenTPU README 中的 AI Authorship Notice 与各发布目录说明
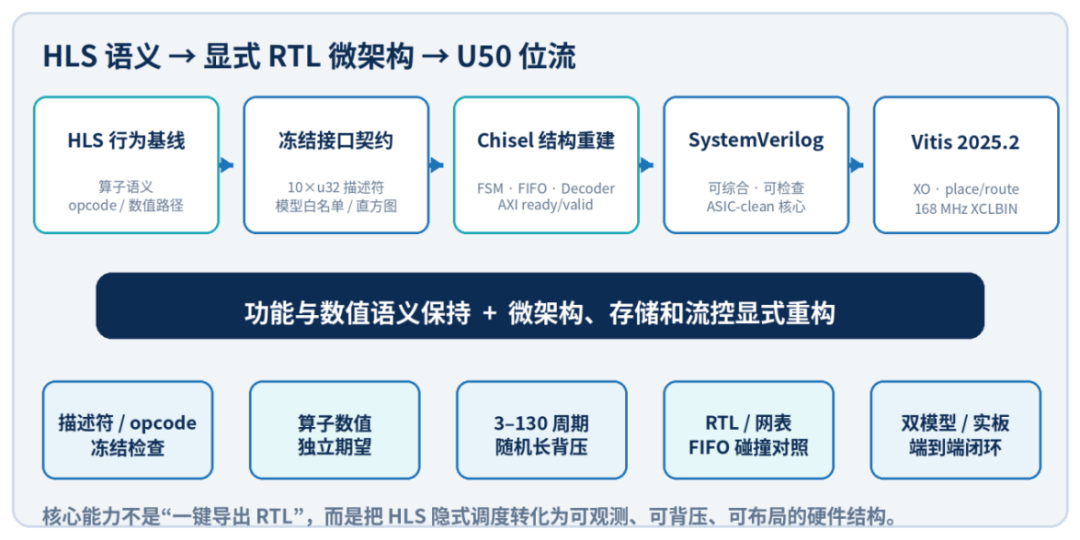
从 HLS 语义到显式 RTL 微架构再到 U50 位流的工程路径
ARCHITECTURE EXPLORATION
三条 U50 架构路线组成设计空间
AI 反复改变计算形状 数据移动和控制边界 并把每个候选方案带到真实实现
OpenTPU 在同一块 Alveo U50 上公开了多条架构路线。它们共享直接 GGUF 的软件工作流和相同的目标模型,却采用不同的计算组织。这些变体体现的是完整架构选择,而不是只调整位宽或流水级数。
路线 | 物理组织 | 整数 MAC 每周期 | 实现 DATA 时钟 | 主要取向 |
TPU2x512 | 两个宽 512 MAC 簇 | 1024 | 168 MHz | 宽流式供数与 512 Token resident context |
TPU32x32 | 四个局部 8x32 岛 | 1024 | 146.5 MHz | 缩短连线并降低全局扇出 |
GPUTensor14 | 公开 full token 路径含 16 路 HBM 权重端口 | 实现不同 | 157.8 MHz | 精确全词表主机采样与可编程路线探索 |
三条路线的阵列形状 时钟和测量口径不同 MAC 数量不能直接推导 Token 吞吐
TPU32x32 将解码 Tile 激活副本和累加状态留在岛内
最有价值的结果往往来自物理反馈。TPU32x32 的实现时钟低于 TPU2x512,却在公开的短问候单流测试中获得更高解码吞吐。这个结果说明性能由时钟、HBM 效率、数据局部性、算子混合和序列位置共同决定。AI 必须处理真实系统,而不是只优化一张理想化计算阵列表。
HARDWARE SOFTWARE CO DESIGN
硬件直接运行原始 GGUF 模型
模型不需要转换成一份新的永久权重镜像 软件与硬件围绕同一份真实模型文件协同
当前 U50 发布包直接读取经过验证的 GGUF 文件,并在启动时将其加载到设备内存。量化数据由 FPGA 运行时消费,不要求用户生成转换后的完整权重 sidecar。这样做把模型格式、量化布局、HBM 地址和硬件解码放进同一条可验证链路。
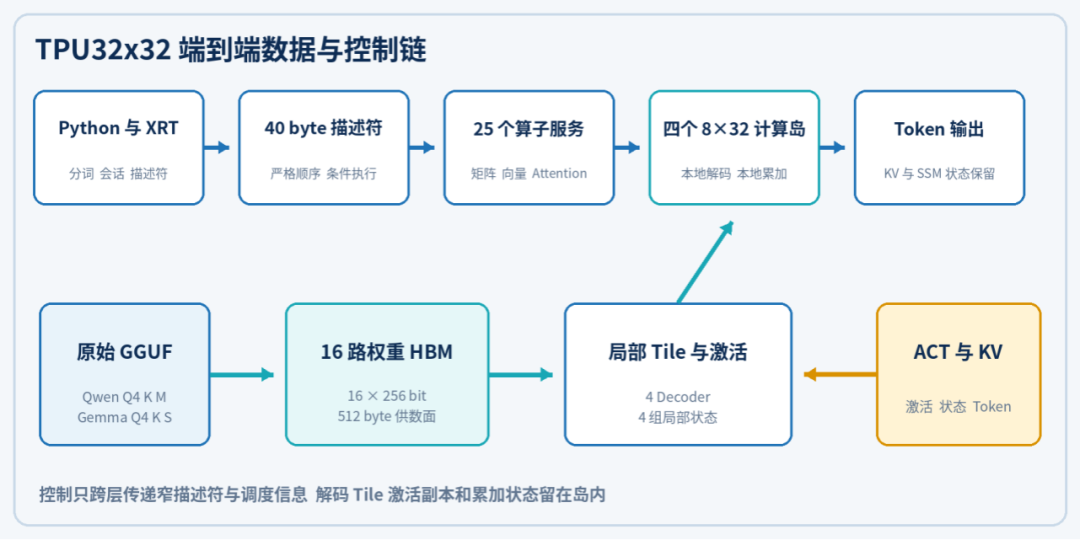
TPU32x32 从 Python XRT 到 Token 输出的端到端数据与控制链
为真实对话保留状态
· 同一份 XCLBIN 支持 Qwen3.5 9B Q4_K_M 与 Gemma 4 12B IT Q4_K_S。
· KV 与 SSM 状态保留在 FPGA 上,多轮会话只预填充新追加的轮次。
· 模型权重在进程启动时上传一次,后续 Token 生成复用设备内数据。
· 公开启动器支持交互与单次生成,并通过 SHA 256 清单校验发布文件。
模型 | 量化格式 | 公开 U50 支持 |
Qwen3.5 9B | Q4_K_M | GPUTensor14 TPU2x512 TPU32x32 |
Gemma 4 12B IT | Q4_K_S | GPUTensor14 TPU2x512 TPU32x32 |
仅列出的模型配置 量化和文件哈希经过验证 相近名称的 checkpoint 不自动兼容
MEASURED ON REAL HARDWARE
真实 U50 上的性能
下面的数据来自发布 XCLBIN 和单卡实测 不是理想化算力估算
TPU2x512 与 TPU32x32 的公开结果使用短问候、128 Token 上下文和单生成流。Decode throughput 不含首个输出 Token。TPU32x32 的 Prompt 时间是预填充阶段 FPGA kernel wait 的总和;TPU2x512 保留其原有 TTFT 口径。
路线 | 模型 | 时钟 | Prompt | 首段时间 | Decode |
TPU2x512 | Qwen3.5 9B | 168 MHz | 13 Token | 3.403 s | 3.374 tok/s |
TPU2x512 | Gemma 4 12B | 168 MHz | 10 Token | 3.560 s | 2.255 tok/s |
TPU32x32 | Qwen3.5 9B | 146.5 MHz | 13 Token | 3.116 s | 3.635 tok/s |
TPU32x32 | Gemma 4 12B | 146.5 MHz | 10 Token | 3.280 s | 2.363 tok/s |
来源:OpenTPU 根 README 的 Measured U50 Results 数据表 访问日期 2026 年 9 月 27 日
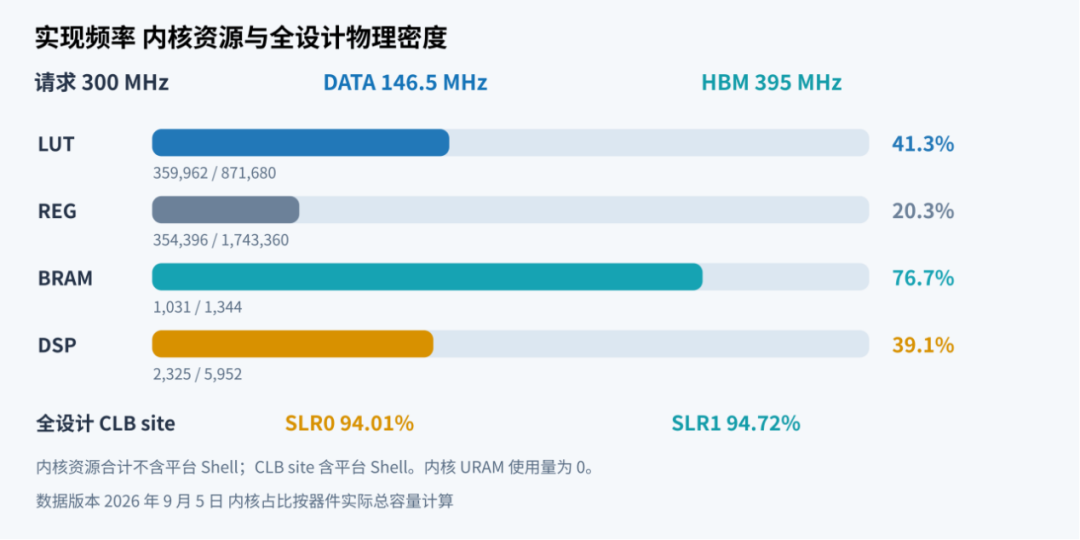
TPU32x32 路由后实现的内核资源与全设计物理密度
TPU32x32 的路由后全设计 CLB site 在两个 SLR 上均超过 94%。这意味着逻辑资源仍有余量时,控制集、布线和局部拥塞已经成为主要限制。AI 的设计循环必须吸收 place and route 的反馈,才能把功能正确的 RTL 推进到可运行位流。
GPUTensor14 采用不同验证提示,因此单独报告:Qwen3.5 9B 的公开 Decode 为 1.312 tok/s,Gemma 4 12B IT 为 1.781 tok/s。它的 full token 板卡结果与可编程 14 核 SIMT 路线属于不同实现阶段,本文不把两者混成同一项结论。
VERIFICATION
验证决定哪些结论可以发布
AI 自主设计只有在数值 协议 网表 实现和板端结果相互对应时才具有工程意义
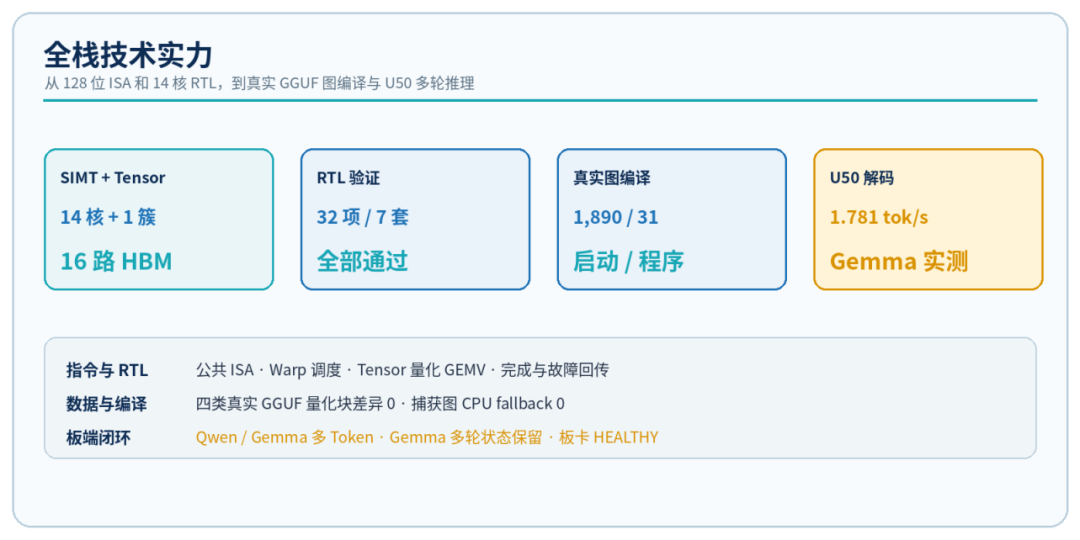
OpenTPU 把 ISA RTL 图编译 量化数据和真实 U50 运行组织为连续证据链
验证层 | 回答的问题 | OpenTPU 证据 |
算子与数值 | 每个算子是否按冻结语义计算 | 25 类算子专项测试与独立期望值 |
背压与协议 | 暂停和乱序响应时是否丢数据 | 3 到 130 周期随机背压及最长 1023 周期测试 |
存储与网表 | BRAM FIFO 同地址行为是否一致 | RTL 与综合网表碰撞对照 |
完整模型 | 全部描述符是否真实执行 | Qwen 1940 条与 Gemma 3718 条操作流 |
真实板卡 | HBM XRT 位流和运行时能否闭环 | Qwen Gemma 多 Token 与多轮 U50 复测 |
验证数据来自本地 U50 TPU32x32 与 GPUTensor14 工程资料 部分测试对应特定实现版本
当前公开边界
· 模型范围。当前仅验证文档列出的模型 量化和文件哈希。
· 执行范围。当前为单卡 单模型 单生成流 不支持 batching。
· 性能范围。短提示结果不能代表长上下文 批处理或不同主机环境。
· 实现范围。FPGA 位流证明功能 接口 存储和端到端运行 不等于 ASIC 已经流片。
ASIC FIRST
FPGA 是验证载体 ASIC 是目标
OpenTPU 用真实 FPGA 回答架构能否运行 最终目标是把这些经验带入专用芯片实现
OpenTPU 从一开始就是 ASIC first 项目。U50 不是最终产品形态,而是可以快速观察数值行为、外部接口、HBM 数据流、时序和布线压力的硬件实验平台。只有经过这一步,ASIC 版本的性能 功耗 面积分析才有可信的系统基础。
AI 设计芯片的意义
· 从规格到硬件。AI 不只生成 RTL 还把运行时 模型格式和验证一起带到可执行状态。
· 从单点优化到架构探索。TPU2x512 TPU32x32 与 GPUTensor14 展示不同数据移动和控制边界。
· 从仿真到实机。公开结果来自真实 U50 双模型运行 并保留测量条件和适用范围。
· 从一次性设计到持续迭代。布局 布线 HBM 和板卡反馈继续进入下一轮微架构决策。
下一阶段
下一步工作将围绕 ASIC PPA 建模、物理实现、时钟与功耗收敛、验证覆盖和 tapeout ready 交付继续推进。OpenTPU 目前公开的是能够复现的 FPGA 运行包和测量数据;在 ASIC 结果出现前,不用 FPGA 吞吐替代 ASIC 结论。
项目主页 | https://github.com/SKYNETAI1/OpenTPU |
本地 U50 资料 | /media/richard/A8FE2D1FFE2CE772/TPU/U50 |
重点目录 | TPU32x32 tpu2x512 gputensor16 |
阅读项目资料与运行包
OpenTPU on GitHub
OpenTPU 已经给出一个可以被检查的答案:AI 能够把芯片想法推进为架构、RTL/HLS、软件、验证和真实硬件上的大模型推理。下一项挑战,是把这条自主设计链继续推进到可签核的 ASIC。