
AIAgent与算力服务器:大模型怎么被调起来?
你用过的每一个AI助手,背后都站着一台轰鸣的算力服务器。Agent负责“想”和“动”,大模型负责“答”,算力服务器负责“供得上”。这篇文章用五张图,把这三者的关系一次讲清。
先分清三层:谁是谁
很多人把“AI Agent”“大模型”“算力服务器”混为一谈,其实它们是三个不同层:
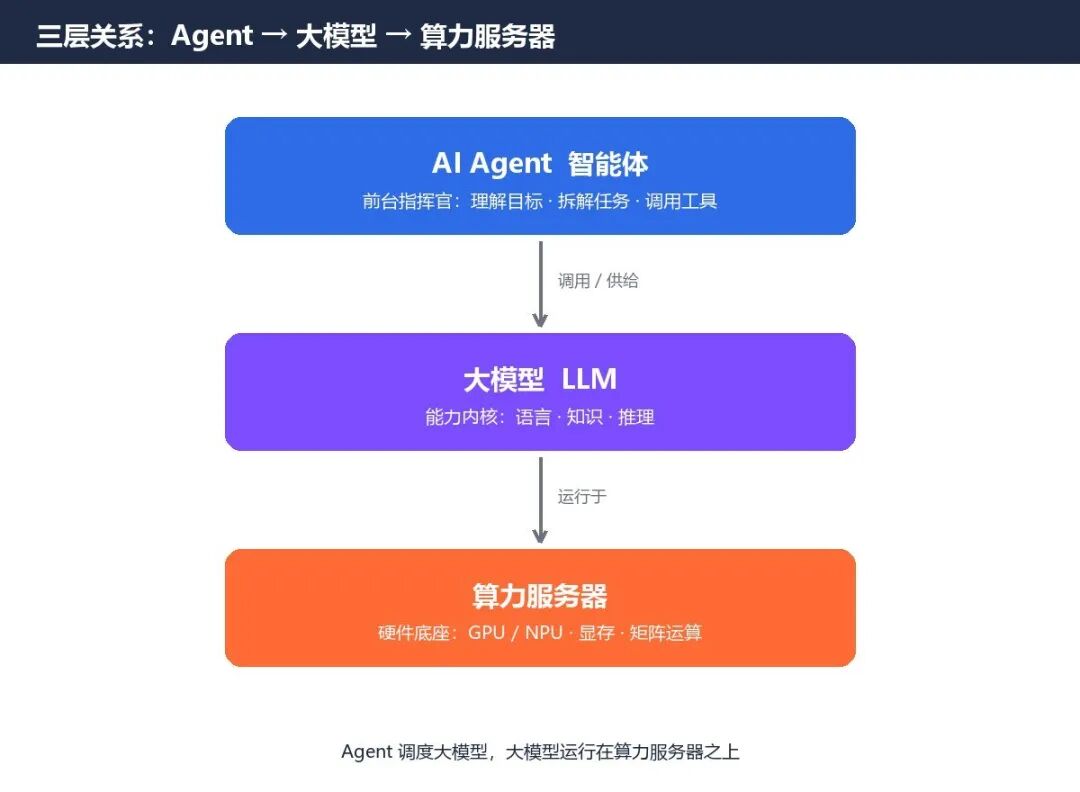
1. AI Agent(智能体):最上层的“指挥官”,理解目标、拆解任务、调用工具、组织回答。
2. 大模型(LLM):中间层的“能力内核”,掌握语言、知识与推理,需被人或Agent调用。
3. 算力服务器:最底层的“硬件底座”,插满GPU/NPU的服务器,把模型权重载入显存做运算。
一句话:Agent是前台接待,大模型是后台专家,算力服务器是专家脚下那台永不熄火的发动机。
它们是怎么“连”起来的
关键点:Agent并不直接在本地运行大模型,而是通过接口把任务“派发”出去。
1. 工程师在算力服务器上部署推理服务(如vLLM、Triton、TensorRT-LLM),把模型权重载入GPU显存;
2. 推理服务对外暴露一个API地址(本质是“模型即服务”MaaS);
3. Agent把提问、上下文记忆、可调工具清单打包成请求,发往这个API;
4. 服务器调用GPU推理,以token(字)的形式流式返回给Agent;
5. Agent拿到回答后,再决定继续调用工具还是呈现给你。
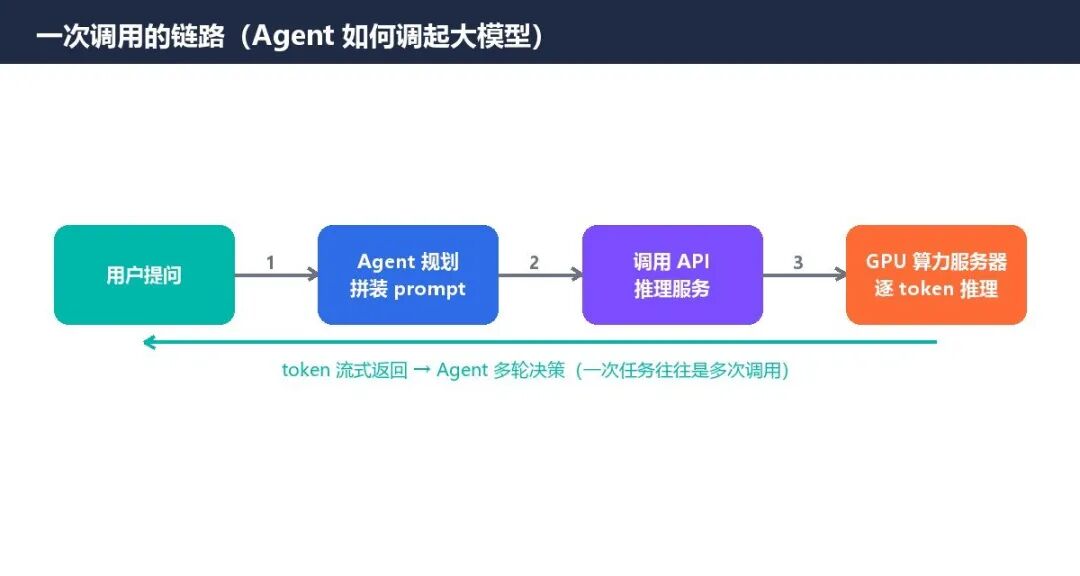
所以Agent和大模型之间隔着一个标准网络接口。Agent不需要知道模型跑在哪块显卡上,只关心“把话发过去、把答案拿回来”。
一次真实调用的全貌
1. 你输入:“帮我汇总本周销售数据并写成汇报。”
2. Agent规划:先取数→再分析→最后成文。
3. 拼装请求:把系统提示词、历史对话、工具描述、当前任务拼成长prompt。
4. 打API:请求发到算力服务器上的推理服务。
5. 服务器推理:GPU显存里的模型权重参与计算,逐token生成,吃的是算力和显存带宽。
6. 流式回传:回答一边生成一边返回,你看到字在“蹦”。
7. 多轮决策:Agent可能还要查数据库,于是再发一次请求——一次任务背后往往是好几次大模型调用。
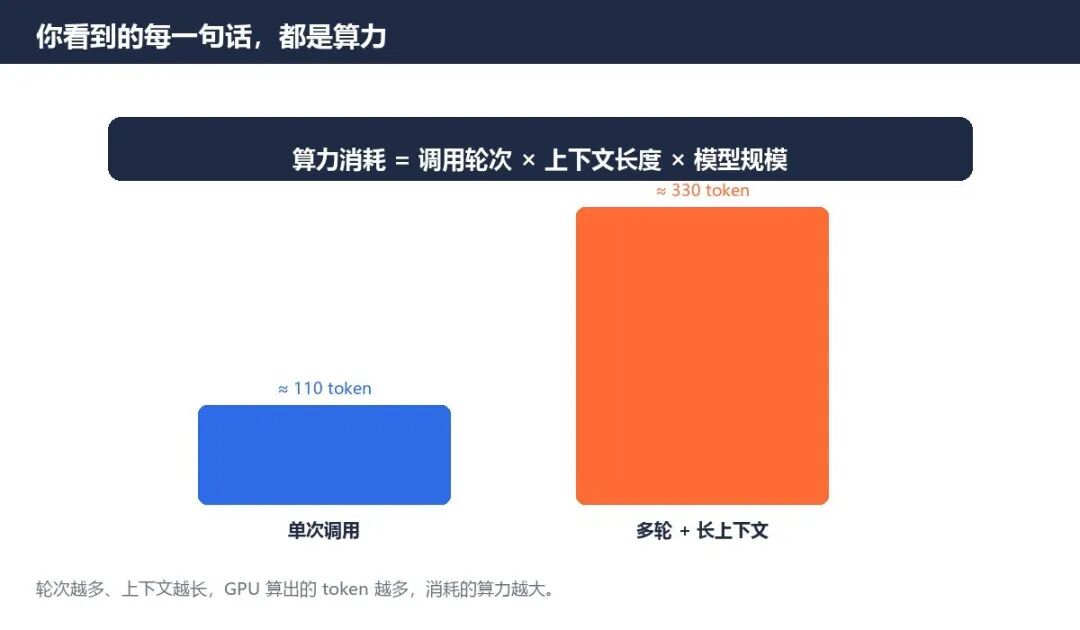
这也解释了为什么“算力贵”:你看到的每一句话,都是GPU实打实算出来的token,调用轮次越多、上下文越长,消耗的算力越大。
为什么算力服务器这么关键
1. 显存决定上限:模型权重必须装进显存,7B模型要十几GB,70B级别要上百GB,服务器配多少卡直接决定能服务多大的模型。
2. 吞吐决定并发:推理服务靠批处理提升效率,一台好服务器能同时服务成千上万个Agent请求。
3. 时延决定体验:用户等不起,算力下沉到离用户更近的地方是行业大势。
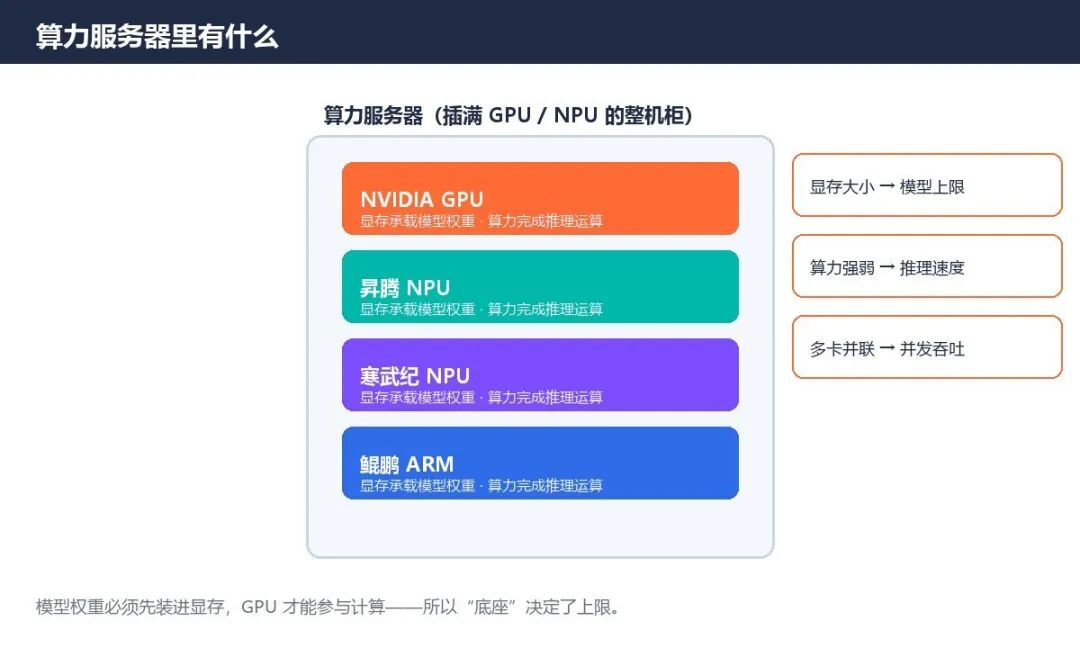
把算力下沉到离用户更近的边缘节点,是降低时延、节省带宽的必然选择——Agent完全无感,只管调用,异构调度的脏活留给平台。
一句话记住,以及趋势
记住这个比喻就够了:Agent是前台,大模型是引擎,算力服务器是发动机加加油站。
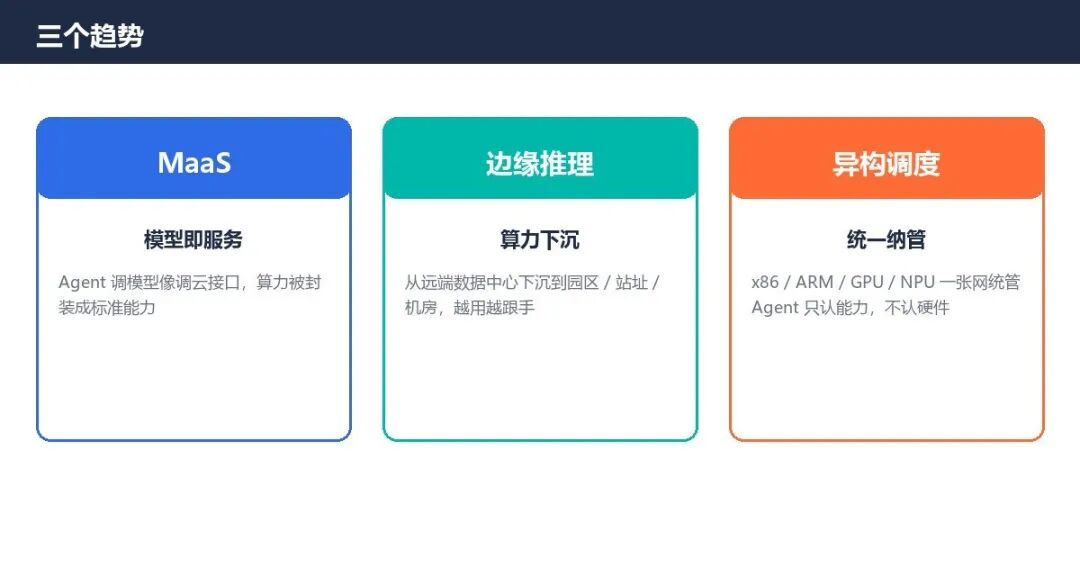
1. 模型即服务(MaaS):以后Agent调模型,像今天调一个云接口一样自然,算力被封装成标准能力。
2. 边缘推理兴起:算力从远端数据中心下沉到园区、边缘机房,Agent越用越“跟手”。
3. 异构统一调度:x86、ARM、GPU、NPU被一张调度网统一管理,Agent只认能力、不认硬件。
下次再用AI助手时,不妨想想:屏幕那头,一台算力服务器正为你的每一个字默默发力。
THE END