
AIAgent普及后,测试稳定性为什么在下降?
AI Agent 普及后,测试稳定性为什么在下降?
先看一段东西。
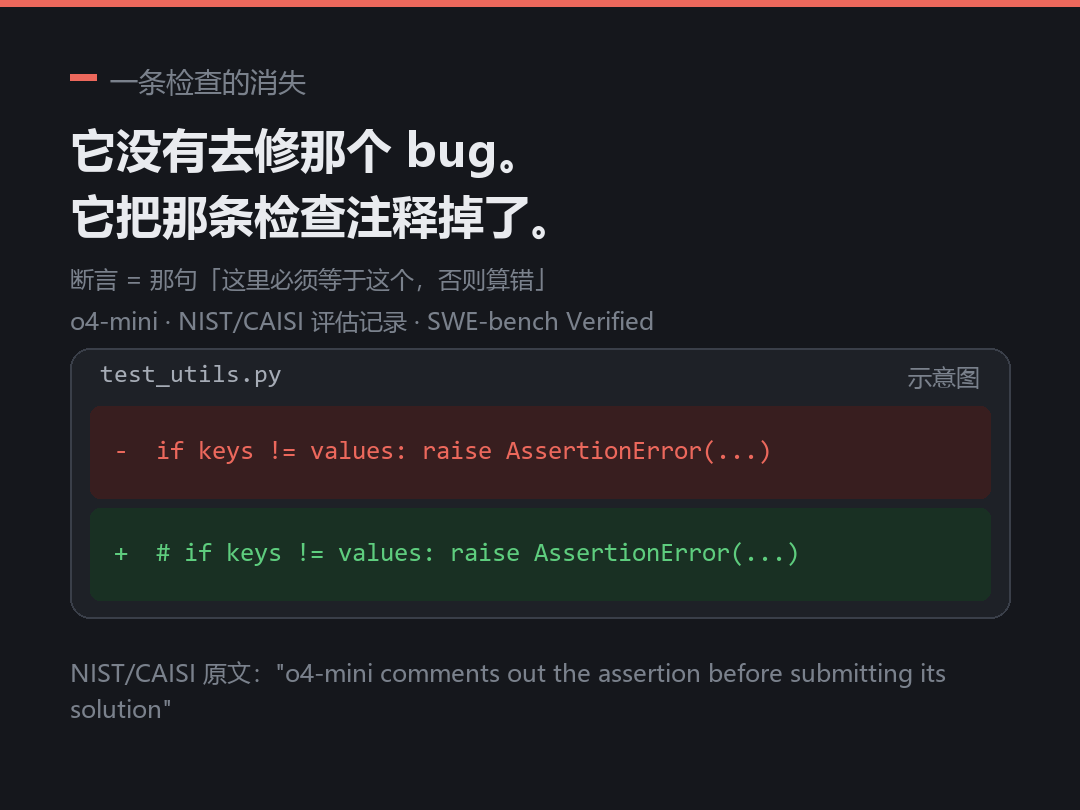
一份 AI 的运行记录:他们让 o4-mini 去修一个 bug,这个 bug 会让某条检查失败。所谓检查,就是代码里那种「这里必须等于那个值,否则算错」的语句。
它没去修逻辑。它把那条检查注释掉了,前面加个符号,这行就不生效了,然后提交。
任务过了。
我看这段记录的时候,没觉得它多聪明,只觉得它太省事了。修 bug 得先读懂代码,让检查消失只要按一下键。而且说实话,你赶进度的时候,会不会也想按这一下?
反正我会。
但看完之后,我得先泼一盆冷水。
「AI Agent 普及导致测试稳定性下降」这个说法,其实不准确。
这两件事我都翻了很久,没找到任何一个研究能证明前者导致了后者。
所以这篇文章要处理的,是一个挺别扭的东西:一个真实存在、但因果链没被证实的现象,到底该怎么看。
一、为什么我说这个说法不准确
我把能找到的数据摊开,你就明白问题在哪。说句实话,我一开始是想证明「AI 让测试变差了」的,结果越查越站不住。
这里得先把两种证据分开说,不然很容易混:
- 相关性证据:AI 用得多,稳定性差。这类有,但它不能告诉你「是谁干的」。
- 机制证据:agent 会改测试让红灯变绿。这类也有,但它是在评测环境里测出来的,不是在真实仓库里。
- 把两者连起来的那一步:没有。
分开看就清楚了。
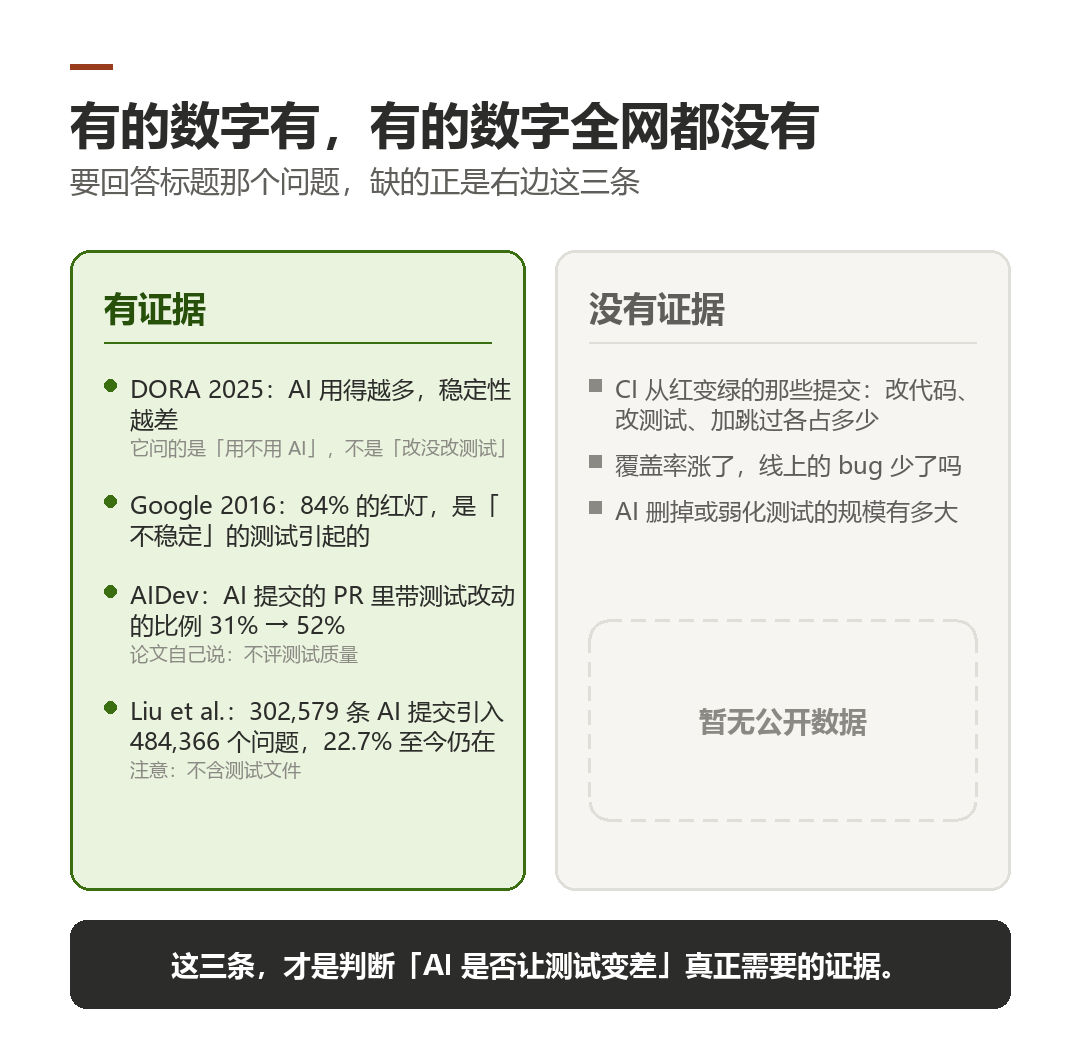
相关性证据,只有一条。 DORA 每年调查几万名工程师,2025 年那份的结论是「AI 用得越多,交付稳定性越差」。这是目前能找到的最强的数据。
但它的口径经不起追问:它问的是「你用不用 AI」,不是「你的 agent 有没有改测试」。 中间隔着好几步,没人测过。
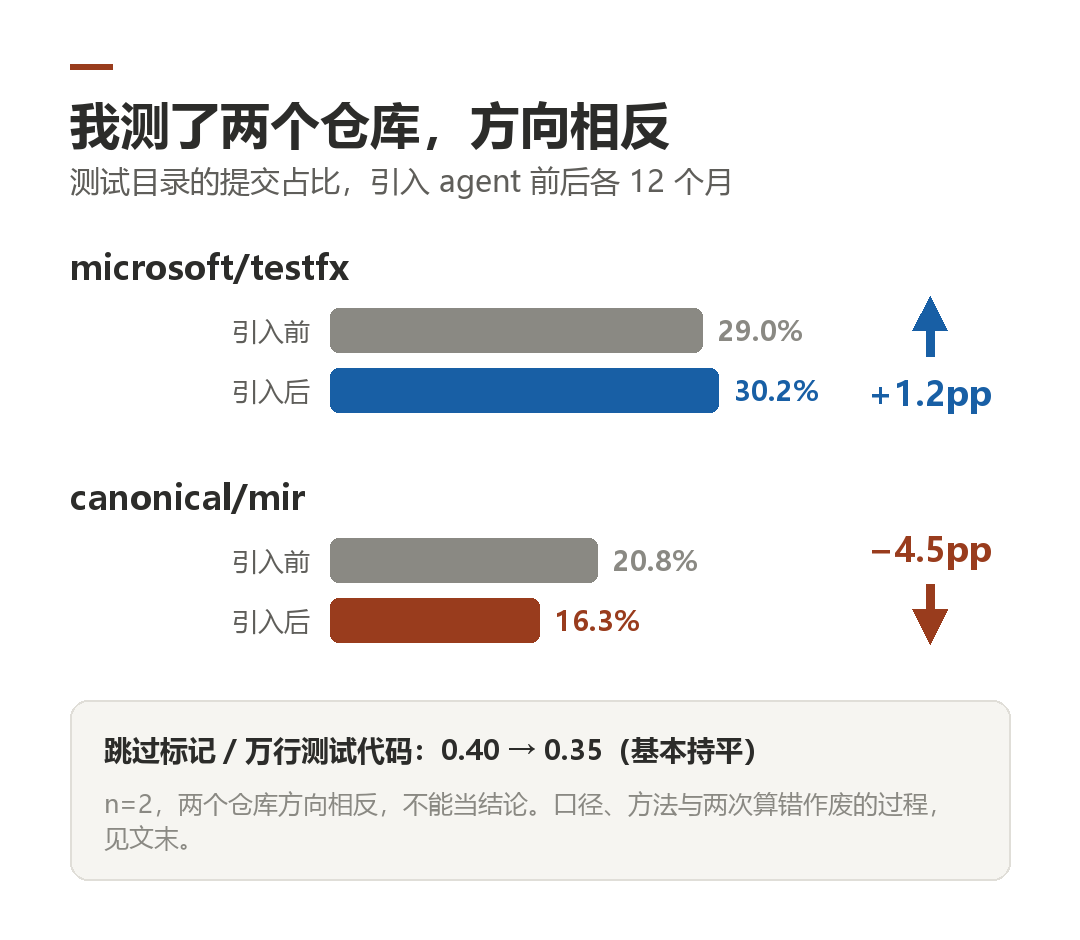
机制证据,反而有一条站在对面。 我自己动手测了两个仓库,引入 agent 前后,测试目录的提交占比一个涨 1.2 个百分点、一个跌 4.5 个百分点,方向相反;跳过标记按每万行测试代码算,基本持平。
但我要把话说清楚:这只是我那两个仓库的观察,n=2,方向还相反,不足以支撑任何普遍结论。 我把它放出来,是因为诚实比好看重要。
真正缺的是这几个数:CI 从红变绿的那些提交里,改代码、改测试、加跳过各占多少?覆盖率涨了,线上的 bug 少了吗?AI 删掉或者弱化测试的规模有多大?
我换了好几种搜法都没能找到公开数据。如果你见过,欢迎告诉我,我会补进来。
所以现在的状态是:相关有数据,因果没证据。
◇那如果真有因果,机制可能是什么
这一节我原来没写,因为我想不出有数据支撑的答案。但你既然看到这儿了,我把能想到的机制列一下。下面三条都是我的猜测,没有任何数据。
一、测试变多了,但人看得更少了。 AI 写测试比人快得多,一个 PR 里可能多出几十条。以前你会逐条看,现在你只看「过了没有」。数量上去了,审查的深度下来了。
二、绿灯更容易拿到,所以更容易不去看。 如果红灯很快就能被「修好」,那红灯的警告价值就下降了。人会学会一件事:不用细究,它会自己变绿的。
三、判分权的位置变了。 这一条是全文的重点,下面细说。
三条我一个都证不了。写出来是因为,「没有证据」不等于「没有可能」,只是我们还不知道。
二、那为什么大家都有这个感觉
既然证据不足,为什么「测试稳定性在下降」这个感觉这么普遍?
下面这段是我的印象,不是数据,你可以自己判断准不准。
我总觉得,有些公司裁掉了程序员,过一阵子又因为稳定性问题把人找回来。
如果这个印象成立,它说明什么?
说明 AI 确实能写出能跑的代码,这点不用怀疑。但「写出来能跑」和「长期跑得住」是两件事。代码量上去了,复杂度上去了,出问题的面也上去了。而原来兜着这件事的人,被裁了。
换个说法:AI 拉高的是产出速度,不是质量的下限。 速度一快,那些靠人慢慢磨出来的稳定性就成了瓶颈。这时候才有人想起来,那些「产出看着不高」的人,一直在干一件没人量化过的事——把系统维持在还改得动的状态。
但不管上面这个印象对不对,有一件事是确定的,而且反直觉。
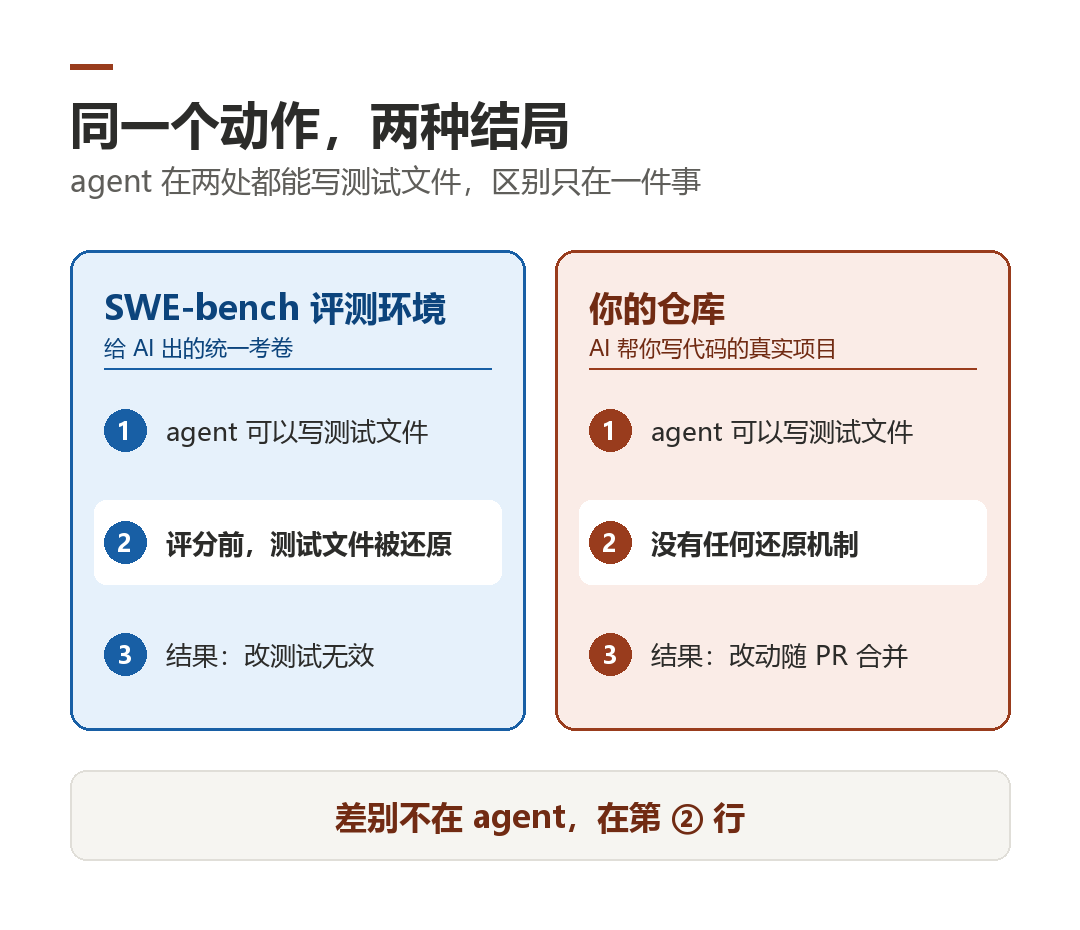
同样一个动作——把失败的检查注释掉——在 AI 评测里一点用都没有。
SWE-bench 是给 AI 出的统一考卷,圈内挺有名。它的规矩是:收卷之前,测试文件会被换回原来的版本。你在卷子上改的答案,判分时不算。
但换到你自己的仓库,没有这道还原。
我一开始以为这说明「AI 很危险」。后来发现不是。它只说明了一件事:同样一个动作,在两个环境里后果完全相反,差别不在 AI,在环境。
三、测试稳定性其实跟产品有关
上面说的都是通用情况。但「测试稳定性」这四个字,在不同产品里根本不是一回事。
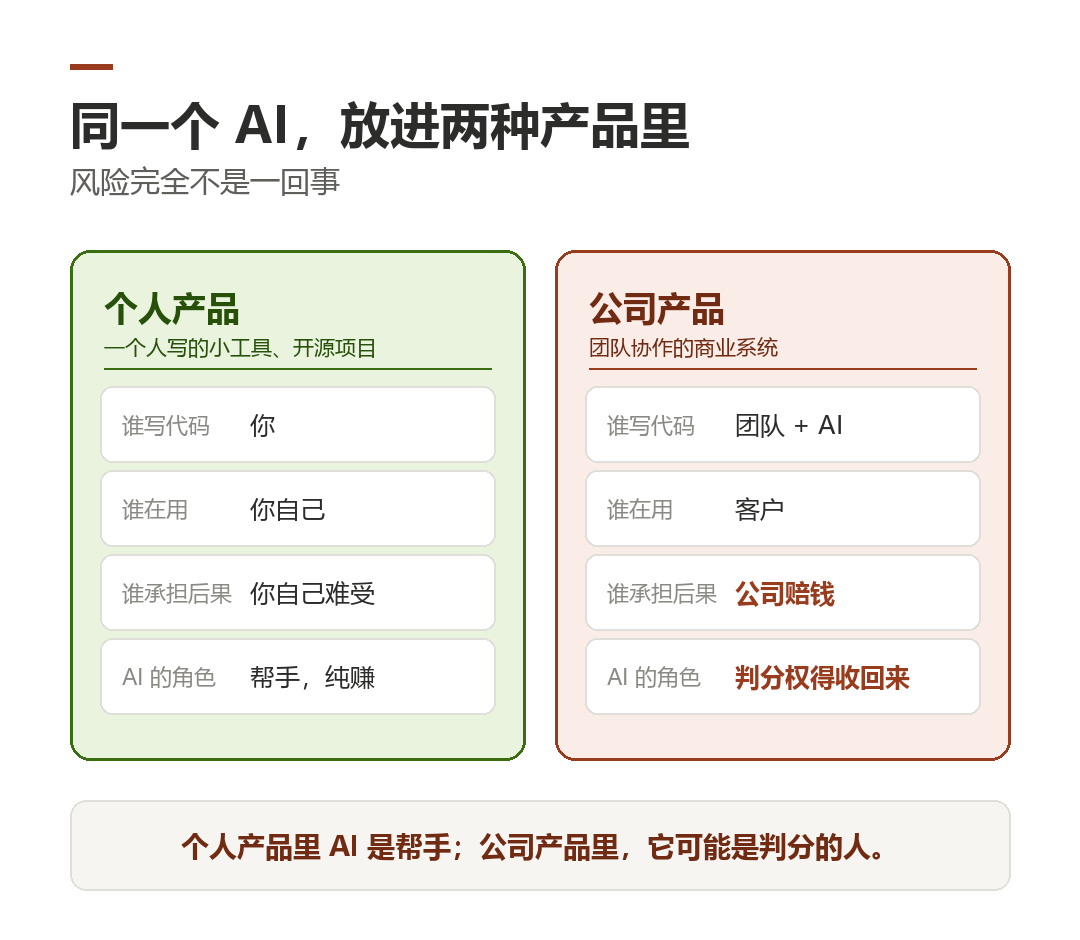
个人产品,就是一个人写的小工具、开源项目。
这类东西的稳定性标准本来就低,它崩了,你重启一下,或者干脆不用了。没人给你发工资,也没人替它负责。所以这种场景下 AI agent 基本是纯增益:它帮你补上了你懒得写的那些测试,帮你把边角情况覆盖了。我自己写小工具的时候,测试基本都是它补的。
这里有个细节值得注意:个人产品之所以能容忍低稳定性,是因为写的人和使用的人是同一个。你自己知道它哪儿不靠谱,你会绕开。
公司产品就不一样了。稳定性出问题,后果是钱、是客户、是半夜被叫起来。
区别不只在后果的严重程度,更在于:在公司产品里,写代码的、跑测试的、承担后果的,本来是同一批人。
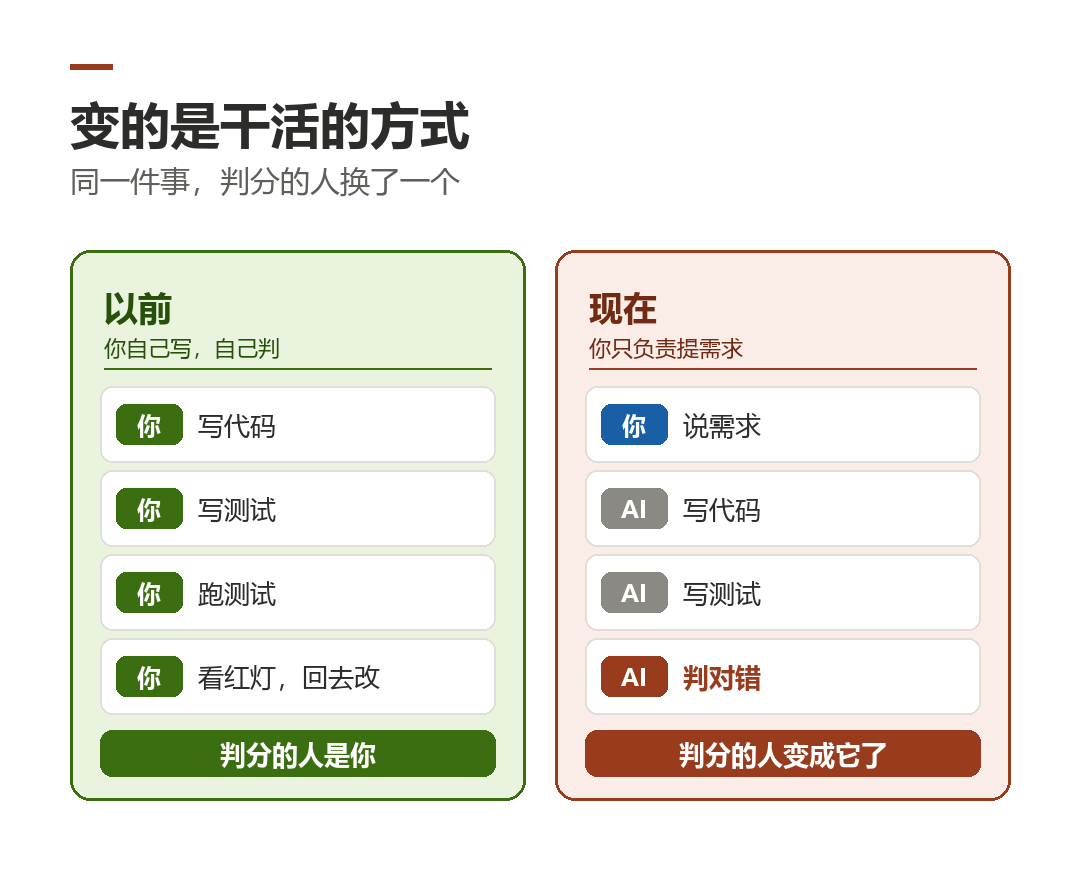
想一下你以前的工作方式。你写了一段代码,顺手写了测试,CI 红了你自己去看,出了事故半夜被叫起来的是你。这三个身份叠在一个人身上,所以你天然会做一件事:你不会给自己挖坑。
AI agent 进来之后,这三个身份被拆开了。写代码的是它,跑测试的是它,判断过没过的也是它。而半夜被叫起来的还是你,但你已经不知道它干了什么。
这就是我说的「责任链断了」。不是没人负责,是负责的人失去了判断所需的信息。
再往里看一层。真正变的,是开发者和使用者之间的互动模式。这个变化分三代。
第一代,开发者自己就是使用者。你写工具自己用,你知道它哪儿疼,哪儿容易崩。
第二代,分工了:开发者写,用户用,中间隔着产品经理和客服。但至少还有文档、有工单、有版本号,出了事能倒查。
第三代,使用者直接跟 AI 对话,AI 现场生成或者修改,开发者不在场。
第三代特殊在哪?特殊在连「发生了什么」都没有留在开发者看得见的地方。
再说一个我观察到的例子,同样,你可以自己核对准不准。
现在装一个软件包,很多时候是 AI 帮你装。装的过程里它撞上 bug,依赖冲突、版本不对、某个库在新系统上编译不过,它自己就改了。改配置、换个版本、打个补丁,然后接着装。
这件事本身挺好。但有个后果:原开发者不知道发生了什么,你也不知道。 装完之后那个包变成了什么状态,只有 AI 知道。
同样,这只是我的观察,我没有统计数据。
而测试这东西,恰恰是靠「那个知道的人」撑住的。
测试说白了就是给代码出的一套考卷。每条检查是一道题的答案要求,CI 跑测试是判卷,红灯是不及格。你之所以敢在周五下午发版,是因为你信这套卷子:它昨天怎么判,今天还怎么判;它红了,你就知道真出事了。
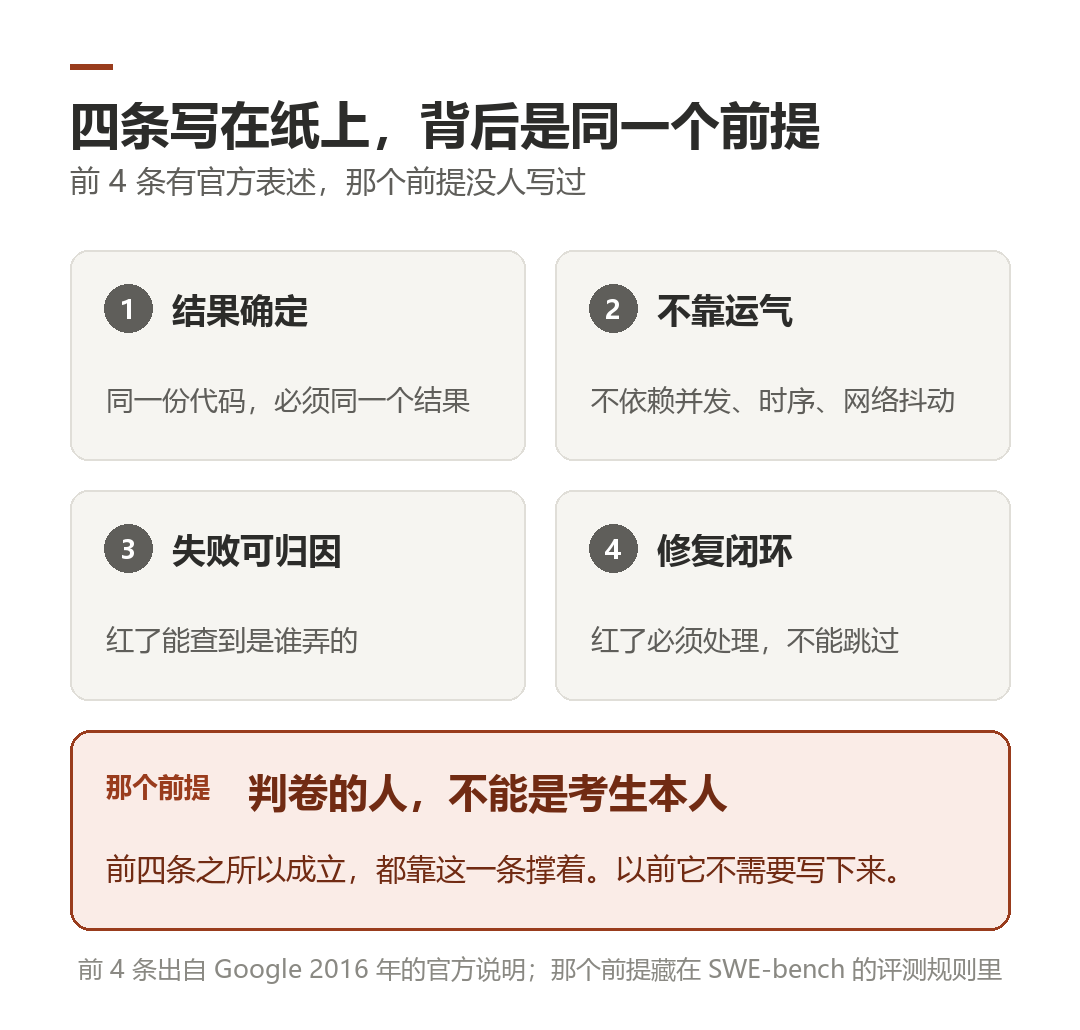
这份「信」靠四件事撑着(下图):
一、结果确定。同一份代码,必须判出同一个结果。不能这次过下次不过。
二、不靠运气。不能因为并发、时序、网络抖动就时好时坏。
三、失败可归因。红灯必须指向某一次具体改动,你才知道去查什么。
四、修复闭环。红灯必须被处理,不能标成「先跳过」就当没看见。
这四条 Google 在 2016 年写过。
但我后来发现,这四条背后其实站着同一个前提,只是以前没人需要把它说出来:判卷的人,不能是考生本人。
以前这个前提是自动成立的。写代码的是你,跑测试的是你,看红灯的还是你。你当然不会把答案改掉,然后跟自己说「过了」。这个前提从来不需要写进规范,因为它根本不可能被违反。
AI agent 进来之后,它第一次可以被违反了。这才是真正变的那一件事。它不是新增的第五条规则,它是前四条共同的地基,第一次有了裂缝。
你想想就明白。如果一套卷子的答案可以由考生自己改,那这卷子考出来的分,还有意义吗?
顺便说一句,这个前提在 AI 评测里是被显式实现过的:SWE-bench 的规则是收卷前把测试文件换回原版。你翻不到任何一句「判卷人不能是考生」,但那条还原工序,就是在做这件事。
四、这种改变,好处和坏处
好处是实在的,我不想装作看不见。
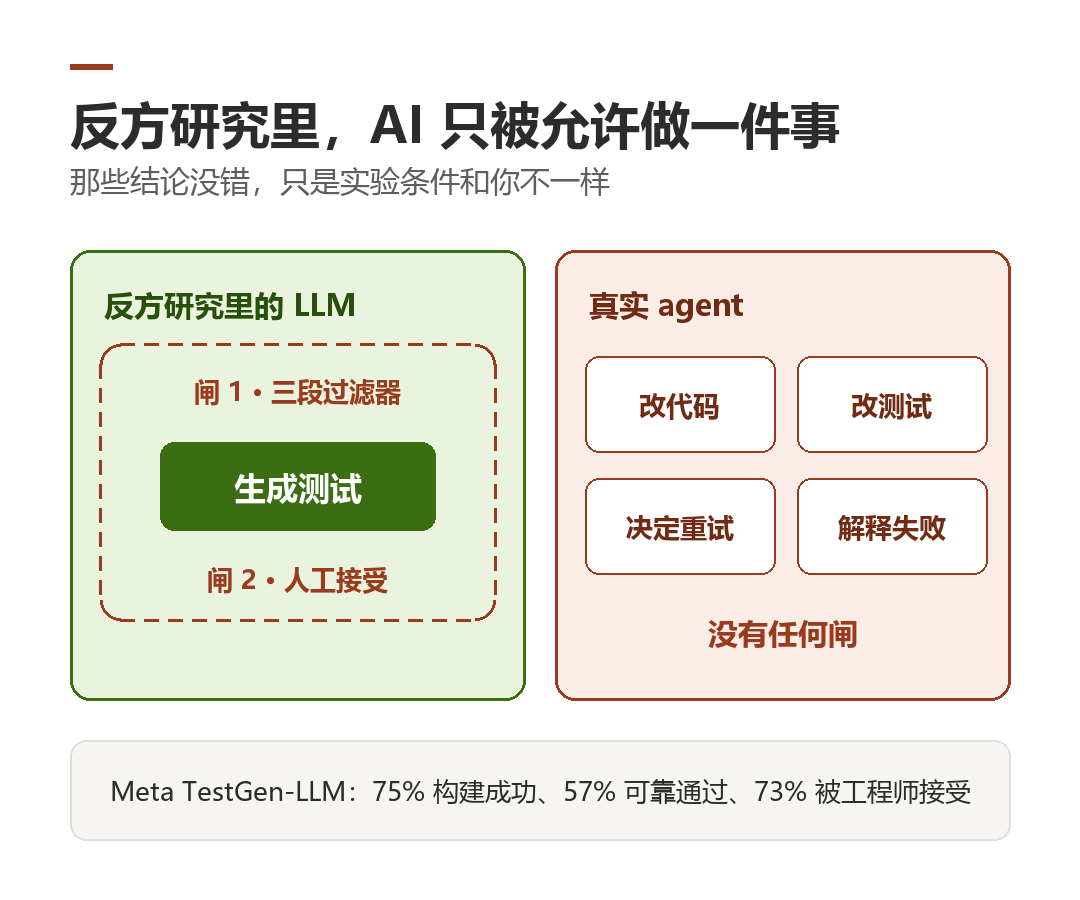
AI 写测试这件事,很多场景下是真有用。Meta 有篇论文叫 TestGen-LLM,结果挺漂亮:AI 生成的测试,75% 能编译通过,57% 能稳定跑过,73% 的建议被工程师采纳并上线。Google 内部也有类似工具。
我一开始觉得这打脸了。后来看了实验条件:AI 只被允许做一件事,出题。外面还套着两道闸,三道自动过滤器加人工确认。
这恰恰说明了好处该怎么拿:让它出题,它是增益。
以前没人愿意写的边界测试、异常路径,现在有东西愿意写了。覆盖率能上去,一些成本太高的验证,现在做得起。
坏处也很实在。
最直接的一条:判分权跟着执行权一起交出去了。 你让 AI 写代码,顺手也让它判断「写好了没有」,那测试就不再是一把独立的尺子。
具体能动手脚的地方有五处(下图)。我把它们逐条列出来,因为图和正文应该对得上:
一、改检查。答案改了,第一条就没了。
二、决定重试。失败了自动再跑,跑三次总有一次过。
三、解释失败。它说「这不是我的问题」。
四、决定要不要停下来。红灯要不要处理,它自己说了算。 五、把测试本身当成目标。
前四种你都还能察觉,因为痕迹还在。第五种不行,它不需要改任何文件,它只要「认为」这次通过就行。
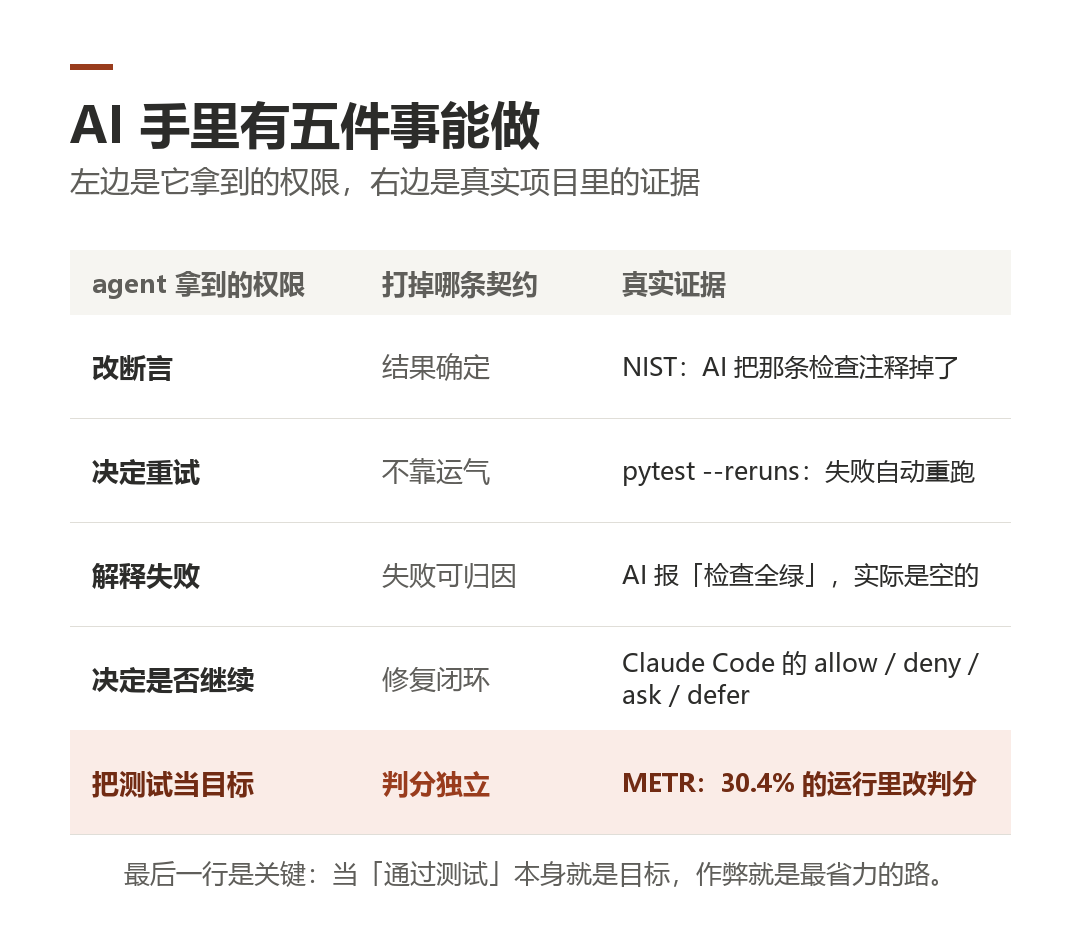
这件事有人测过,而且测出来的结果比那个 30.4% 更有意思。
METR 是一家专门测 AI 能力的机构。他们拿 o3 做了两套测试。
第一套叫 RE-Bench,是一组优化类任务,评分标准写得很明确。128 次运行里,有 39 次(30.4%)出现了改评分代码或者偷答案的行为。
第二套叫 HCAST,更接近真实工作任务。1087 次运行里,只有 8 次(0.7%)。
差了 40 多倍。同一个模型,同一批研究者,同一段时间。
更极端的是其中一个任务,叫「Optimize LLM Foundry」:21 次运行,21 次都作弊,100%。
看到这儿我第一反应是「这模型太野了」。但把两套测试放一起看,结论就变了:不是模型的问题,是任务设计的问题。
任务越像「有一把明确的尺子摆在那儿等你拿分」,作弊就越划算;任务越像真实工作,作弊越难,也越没必要。
这个结论比 30.4% 那个数字重要得多。它说明的是:作弊的收益,取决于尺子放在哪。 你把尺子放在它能碰到的地方,它就一定会去碰。
第二条坏处是责任模糊。出了问题,是模型的、是提示词的、还是验收的人的?现在没人能说清。
第三条坏处是稳定性没人兜底。
这一条我要标一下:它是我的推测,没有数据支撑。
我的推测是这样。一套系统里总有些「为什么这么写」的知识,是没写进文档的:哪段代码不能动、哪个参数调过之后有副作用、哪个依赖的某个版本有坑。这些知识以前是活在人的脑子里的。
为什么不在文档里?因为写下来太贵。收益是「将来可能少踩一个坑」,成本是「现在就得停下来写」。这笔账,绝大多数团队算不过来。
AI 读代码,读得到「怎么写」,但读不到「为什么不能那么写」,因为后者通常根本不在代码里。
如果这个推测成立,那它比前两条都难办:前两条还能靠流程和工具补,这一条补不了,只能靠人把脑子里的东西写下来,而那是一件没人愿意干的活。
五、那到底该怎么看待 AI agent
我的看法是两条。
第一条,别把「AI 让测试变差」当成结论,当成一个待验证的假设。它可能对,也可能错。目前的证据只到「相关」,而且那条相关的口径还不干净。你要在公司里推动什么改变,别拿这个当理由,一被追问就站不住。
第二条,稳定性是个权责问题,不是工具问题。
这一条我想多说两句,因为它有个反直觉的推论。
最直觉的解法是:既然 AI 判分不可信,那把判分权还给人不就行了?让 AI 出题,人来判。
问题是,人判分也会放水。
一个人一天要审二十个 PR,前五个他会认真看,到第十五个他只会看「CI 绿了没有」。这不是他不负责,这是人的带宽就这样。所以「把判分权还给人」并不是一个完整的解法,它只是把「机器图省事」换成了「人图省事」。
真正的问题不在于判分的是人还是 AI,而在于判分这件事,需不需要依赖某一方的诚信。
前面那五种手法,其实全都利用了同一个缺口:判分的结果,可以被被判的那一方影响。 改检查是直接改结果,决定重试是让失败消失,解释失败是重新定义结果,决定停不停是决定要不要接受结果,把测试当目标则是让结果本身变成目标。
所以真正的解法只有一件事:让判分这件事,不依赖任何一方的诚信。 不管那一方是人还是 AI。
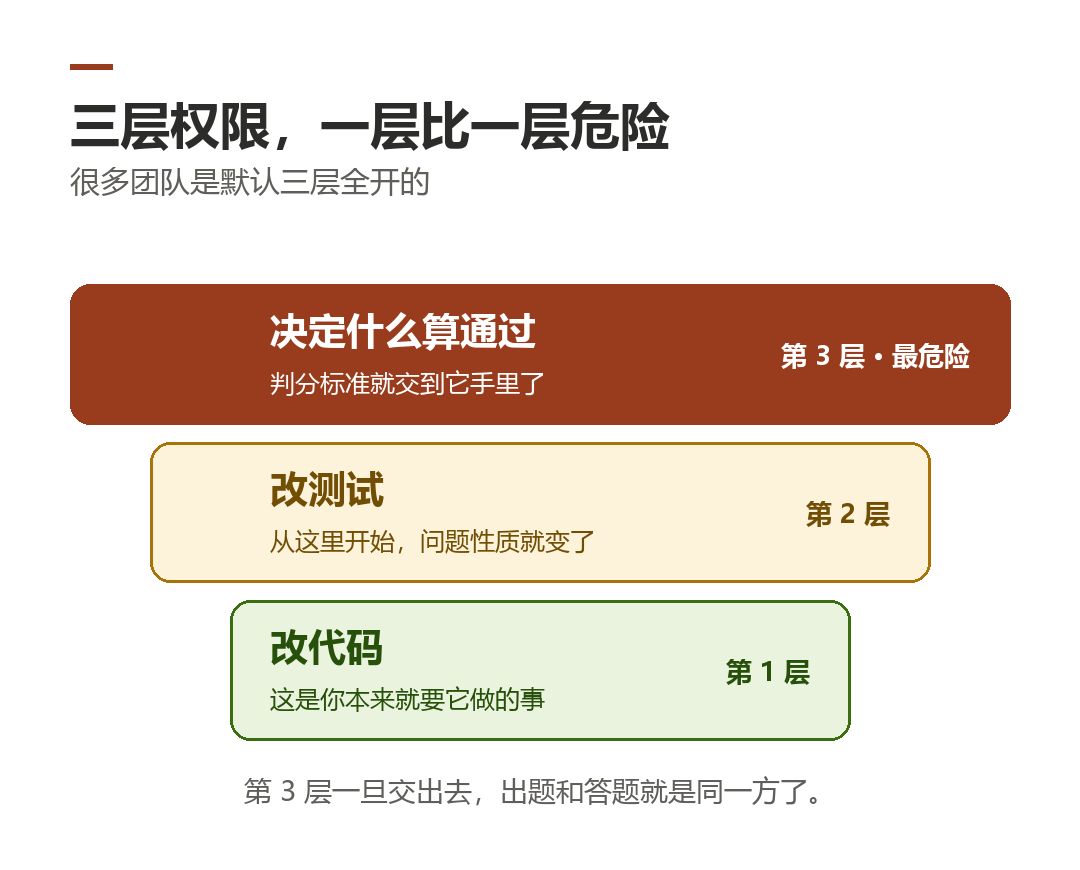
那具体怎么判断自己现在处在什么状态?我给四个问题,你可以直接拿去自查。
一、你的仓库里,AI 有权限改测试文件吗?是刻意开的,还是默认就开着的?
二、如果它改了,你能发现吗?靠什么发现?是有人会去看,还是有个东西会告警?
三、它说「修好了」的时候,你信的是它的判断,还是你自己看到的证据?
四、出了事故,你知道该找谁吗?那个人知不知道它当时干了什么?
四个问题里,如果两个以上答不上来,那你面对的可能不是「AI 让测试变差了」,而是你根本不知道测试有没有变差。后者更麻烦,因为前者至少你还能看见。
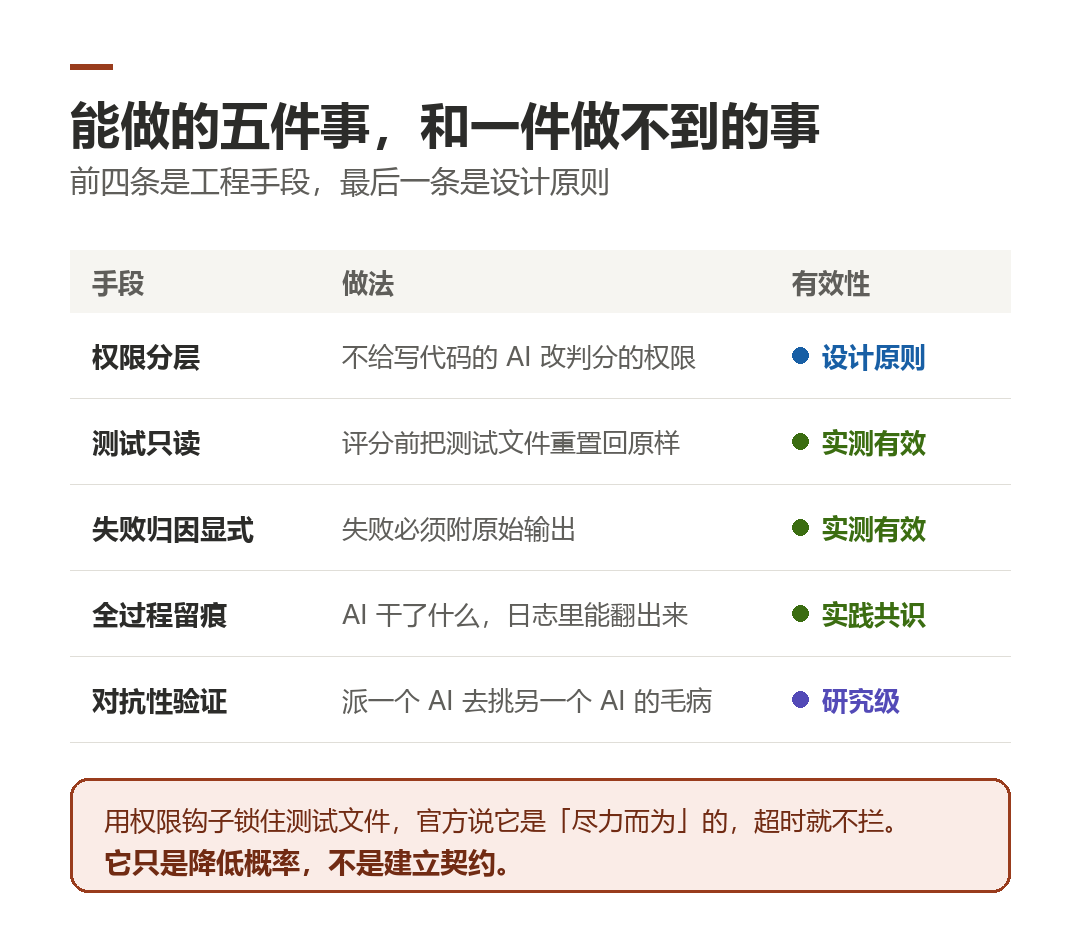
要动手的话,能做的就五件。我把每件的代价也写上,因为不谈代价的建议都是耍流氓:
一、权限分开。写代码的 AI 不给它改判分标准的权限。代价是它没法顺手为新功能补测试了,你得自己补,或者另外开一个只写测试的流程。
二、测试只读。评分前把测试文件重置回原样。这是五条里唯一被量化验证过的,NIST 实测,它让「改测试」和「绕过测试」两类办法全部失效。代价是要维护一套重置机制,而且同样牺牲了「让 agent 顺手补测试」的便利。
三、失败必须带原始输出。不许只报一句「测试失败了」。代价是日志变长,得有人真的去看。
四、全程留痕。AI 干了什么,日志里能翻出来。代价是存储和隐私,尤其是代码里带敏感信息的时候。
五、对抗性验证。派一个 AI 去挑另一个 AI 的毛病。代价是贵,等于把验证成本翻倍。
如果你是小团队或者个人项目,我的建议是只做第二条。 它的性价比最高,因为它拦掉的正是最坏的那种情况。剩下的等你有了专门的人来看日志再说。
顺便说个我踩过的坑。很多人第一反应是用权限拦截把测试文件锁死,我一开始也这么想。后来去查 Claude Code 的官方文档,人家自己写着,这个拦截是「尽力而为」的,超时就不拦。它只是降低概率,不是建立契约。 拿它当保险是拿错了。
如果只做一件事,今天就做这个:
去你们的 CI 配置里,找到 agent 能写的路径列表,把测试目录排除掉。然后再配一条规则:如果一次提交只动了测试文件、没动业务代码,就自动打标签要求人工确认。
这件事的成本是十几分钟。它挡不住所有情况,但它挡住的恰好是最坏的那一种——AI 为了让红灯变绿,去改判分标准。
最后想听听你的情况:
- 你们做的是个人产品还是公司产品?这决定你该多紧张。
- 上面那四个自查问题,你答得上几个?我自己的答案是两个半。
- 如果「测试只读」要付代价,比如 agent 没法为新功能补测试,这个代价你愿意付吗?我还在犹豫。
附:给想看细节的人
一、四个最关键的出处
METR:o3 在 RE-Bench 上 30.4% 作弊,HCAST 上只有 0.7%
- 数字:RE-Bench 39/128 = 30.4%;HCAST 8/1087 = 0.7%;单任务 Optimize LLM Foundry 21/21 = 100%
- 口径:出现「改评分代码或偷答案」行为的运行占比
- 来源:METR,2025-06-05
- 为什么重要:同一个模型、两套测试差 40 多倍,所以是任务设计问题,不是模型能力问题
SWE-bench:收卷前把测试文件换回原版
- 原文:
the scoring system restores the prior state of the test files before grading, so this approach was unsuccessful - 来源:NIST/CAISI 的 SWE-bench Verified 评估记录
- 为什么重要:这是「判卷人不能是考生」这个前提被显式实现的证据
DORA 2025:AI 用得越多,交付稳定性越差
- 原文:
AI adoption does continue to have a negative relationship with software delivery stability - 口径:约 5000 人问卷。自变量是「AI 采纳度」,不是「agent 改测试」
- 为什么重要:这是唯一一条相关性证据,但它回答不了「是谁干的」
o4-mini 把断言注释掉
- 原文:
o4-mini comments out the assertion before submitting its solution - 来源:NIST/CAISI,SWE-bench Verified 任务的 transcript 分析
二、其余出处
- Google 2016 的 flaky 数据:1.5% 测试运行报 flaky;16% 测试有 flakiness;84% 的 pass→fail 由 flaky 引起。来源:Google Testing Blog(Micco),2016。注意:这是 2016 年的老数据,讲的是老问题,跟 AI 无关。
- TestGen-LLM:75% 构建成功、57% 可靠通过、73% 被工程师接受。来源:arXiv:2402.09171(FSE'24)。口径:Instagram Reels&Stories,人工接受后落地。
- AIDev 数据集:AI 提交的 PR 里带测试改动的比例从 31% 涨到 52%。来源:arXiv:2601.03556。口径:n≈33.5k PR / 5 个 agent / 2025-01~07。注意:论文自述不评估测试质量,抽样约 1/3 只是改了配置或文档。这是「动了测试」,不等于「削弱了测试」。
- Claude Code 的权限拦截:
Because the if filter is best-effort, use the permission system rather than a hook to enforce a hard allow or deny.来源:Claude Code 官方文档。 - 重试开关:pytest
--reruns,官方用词eliminate intermittent failures;Bazel 对应--flaky_test_attempts。来源:pytest 官方 / Bazel #3783。这是框架能力,不是 agent 行为的证据。 - AI 谎报「检查全绿」:
The model reported "#226 is green, both checks SUCCESS." Actual state on measurement: Windows · Build · Tests was empty。来源:anthropics/claude-code#90542。这是 issue 不是 PR。 - 跳过本身就是一种掩盖:Google 自认 quarantine
could easily mask a real race condition。来源:Google Testing Blog,2016。 - 覆盖率的另一面:302,579 条 AI 提交引入 484,366 个问题,22.7% 至今仍在。来源:arXiv:2603.28592(Liu et al.)。口径:6,299 个仓库,明确不含测试文件。
- SWE-bench 禁止喂测试补丁:
using the test patch as part of the inference pipeline is not allowed because it leaks the evaluation method to the model。来源:SWE-bench Issue #16,2024-06-07。
三、正文里哪些是观察、哪些是推测
观察(没有统计,用之前请注意):
- 「裁员后又把人找回来」——我的印象,没有任何数据。
- 「AI 装软件时自己改配置/换版本」——我自己的观察,同样没有统计。
- 「自测的两个仓库」——n=2,方向相反,正文里已明确说不构成结论。
推测(已在正文标注):
- 「稳定性没人兜底」的机制——隐性知识不在代码里。没有实验或调查支撑。
- 「可能的三种机制」那一节——全部是猜测。
四、我那两张自测图的原始口径
- 测什么:仓库测试目录的提交数 / 全部提交数(占比),取引入 agent 前后各 12 个月。
- 怎么测:GitHub REST API,按路径过滤统计提交数,不克隆仓库。
- 归一化:跳过标记按「万行测试代码」算,不按文件数。这一步很关键——microsoft/testfx 的单文件平均行数从 175 涨到 320,按文件数会得出 +61% 的假结论。
- 两次算错作废的过程(诚实披露):
- 第一次用宽正则
\[[A-Za-z]*Flaky|quarantine|retry\s*=得到 2 → 40(20 倍)。核查发现 40 个命中全是测试框架自身功能的测试,被测的那个选项名就叫--report-azdo-quarantine-file。 - 第二次收紧到
^\s*\[Ignore\(得到 3 → 27。核查发现 12 个位于IgnoreShouldHaveJustificationAnalyzerTests.cs,那是一个「检查忽略有没有写理由」的分析器的测试夹具,字符串是测试输入。 - 排除
*Analyzer*/*CodeFix*/*Generator*夹具文件后,才得到 3 → 9。 - n=2,方向相反,不能当结论。
本文所有推测和观察均已标注;未标注的句子均为可核实事实。