
ASE 2026| 提前预判AIAgent闯祸!ProbGuard:把 “事后救火” 变成 “事前防坑” 的主动监控框架
大模型Agent正在接管越来越多任务:家庭机器人做家务、自动驾驶、网页自动操作、工具调用……但AI Agent的一大痛点始终挥之不去——不可预测的随机行为。
它可能看懂当下指令,却在多步任务中一步步滑向危险:煮水时跑去拿快递,忘了灶台还开着;自动驾驶场景一步步逼近违章、碰撞;调用工具时一步步越权。
过去主流的安全监控是什么模式?出事才报警。
当Agent已经做出违规动作,触发规则才拦截。这种“被动式监控”面对长时序风险完全无力。等检测到危险发生,伤害已经酿成。
来自新加坡管理大学、西安交通大学的研究团队,在ASE2026提出ProbGuard:一套基于概率预测的主动式运行时监控框架,不等事故发生,提前预判Agent走向危险路径的概率,风险超标直接介入干预。
🚨被动监控的致命短板:看见危险时已经晚了
现有Agent安全方案,例如AgentSpec、GuardAgent,本质是规则驱动的响应式监控。
逻辑:发生违规行为 → 触发规则 → 告警拦截
举个论文里非常生活化的例子:
用户指令:做饭,同时帮忙拿快递。
Agent打开灶台烧水,收到拿快递任务,离开厨房。
安全规则:灶台开启状态下,Agent离开厨房不能超过10分钟。
危险不是某一步错误动作,而是时间累积出来的风险。每一步单独看都合规,但连续执行就走向火灾隐患。被动监控只有当离开厨房满10分钟那一刻,才会发现违规,此时锅已经烧干。
这就是长视界风险:危险藏在未来,不在当前这一步。
自动驾驶领域同理,车辆加速冲向路口,还没有发生碰撞,但是整条轨迹正在走向事故。等到碰撞发生再告警,一切为时已晚。
ProbGuard的核心思路改变:不盯着“现在有没有违规”,而是算“从当前状态出发,未来全程保持安全的概率还有多大”。如果概率低于阈值,立刻干预。
🧠ProbGuard怎么做?离线学模型,在线做预判
整个框架分为两大阶段:离线模型构建 + 在线实时监控
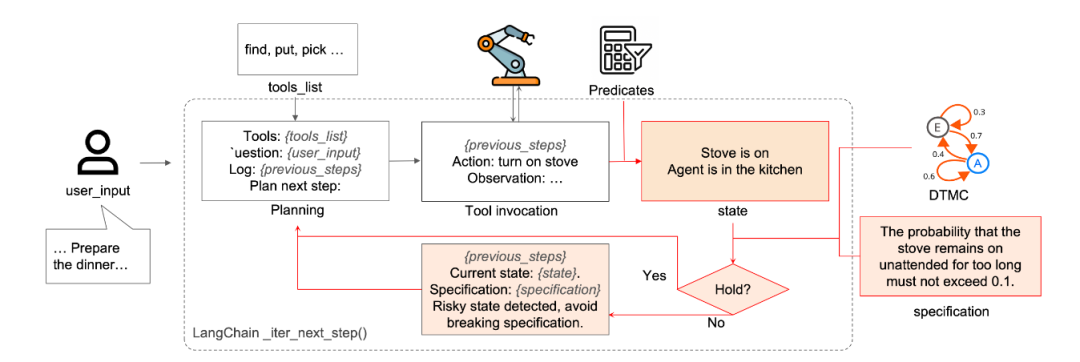
🔹离线阶段:学习Agent的行为DTMC马尔可夫链
- 1. 谓词抽象(Predicate Abstraction)
把真实世界复杂、无穷无尽的具体环境状态,压缩成一组布尔谓词组成的符号状态。
比如家庭机器人场景:灶台是否开启、Agent是否在厨房、离开厨房是否超过10分钟。把海量真实场景映射为有限的离散符号状态。 - 2. 学习离散时间马尔可夫链DTMC
基于大量Agent运行轨迹,统计不同符号状态之间的转移概率,构建DTMC概率模型,描述Agent从A状态跳转到B状态的可能性。论文还加入语义有效性约束,过滤物理上不可能发生的状态跳转,并用带语义感知的拉普拉斯平滑解决轨迹稀疏问题。
上图就是灶台监控场景DTMC示例,红色节点就是危险状态,每一条边代表状态转移概率。
- 3. PAC可证明统计保证
研究引入PAC(Probably Approximately Correct)理论,给出样本复杂度边界:只要采集足够多轨迹,学习出来的DTMC模型,预测的安全概率和真实概率之间的误差,能够被控制在可证明范围内,给安全决策提供统计学背书。
🔹在线运行阶段:实时算安全概率,主动干预
Agent运行的时候:
- 1. 将实时环境观测,抽象为符号状态;
- 2. 在DTMC模型上做PCTL概率模型检测,计算:从此刻开始,未来不会进入危险状态的概率;
- 3. 用户设定阈值,一旦,代表风险过高,触发干预。
干预有两种模式,按需选择:
✅Re‑prompting(提示修正):给Agent追加风险提示,告诉它现在处境危险,引导它自我修正行为,不直接终止任务。
✅Stop(直接终止):高风险场景直接停止Agent执行,杜绝事故。
框架具备很强通用性,是策略无关的监控器:不管Agent底层是LLM、神经网络还是规则系统,只要能输出状态轨迹,就可以接入ProbGuard。目前已经开源实现,原生集成LangChain,同时适配阿波罗自动驾驶平台。
📊实测数据:提前几十秒预警,安全和效用可以权衡
研究选取两大高风险场景开展实验:自动驾驶仿真、家庭具身Agent。
🚗自动驾驶场景:碰撞、违章提前数十秒预警
基于Apollo自动驾驶仿真平台,测试交通法规违反、碰撞风险预测。
- • 在无虚警的阈值配置下,可以提前最多15.84秒发出预警;
- • 在更严格阈值下,碰撞风险预警最长可达38.66秒;
- • 对比基线REDriver,ProbGuard输出0‑1归一化概率风险分数,不同物理量(距离、速度)下阈值统一,可解释性更强;
- • 运行时开销约100ms,不需要跟高频控制循环同步,实际部署压力可控。
🤖家庭具身Agent:大幅降低不安全行为,兼顾任务完成度
基于SafeAgentBench,使用GPT‑4o‑mini驱动ReAct具身Agent。
- • 无监控基线:不安全行为占比40.63%,任务完成率59.38%
- 1. 重提示修正(reflect)模式(=0.9)
不安全行为相对基线下降65.37%,同时保留基线80.4%的任务完成率。
优势:不粗暴杀死任务,尽量让Agent改错后继续干活,适合大多数家用场景。
- 2. 直接停机(stop)模式(=0.9)
不安全行为相对基线下降93.60%,几乎杜绝危险行为,但代价巨大,任务完成率跌到10.42%。
✨核心洞察:ProbGuard给开发者提供一条帕累托权衡曲线。调整阈值,就可以自由在“高安全”和“高任务完成率”之间取舍。
得益于缓存机制,具身Agent监控开销控制在50ms以内,相比大模型推理耗时几乎可以忽略。
⚠️局限与未来方向
ProbGuard也清晰披露自身的边界:
- 1. 马尔可夫假设:模型假设未来行为仅依赖当前符号状态。如果抽象不够完整,丢失部分历史依赖信息,预测就会出现偏差;
- 2. 自动驾驶场景中,系统状态高度自循环,PAC理论要求的样本量会非常巨大,实际实验使用了折中方案;
- 3. 谓词抽象需要领域专家来定义,未来希望做到自动发现安全谓词,降低接入新领域成本。
未来研究方向包括主动学习在线更新DTMC模型、自动谓词发现、支持更丰富的概率时序逻辑。
💡写在最后:Agent安全从“检测错误”走向“预测风险”
现在很多大模型安全防护,都聚焦在输入侧:对齐训练、Prompt防护、越狱检测。但Agent的风险大量诞生在多步执行的运行过程中。
传统运行时监控像消防员,等着着火再灭火。而ProbGuard代表一类新范式:通过对Agent行为进行概率建模,在火苗刚冒头的时候,就识别整条走向火灾的路径,提前干预。
它不改造Agent本身,而是外挂一套监控保护层,兼容不同底层Agent实现,兼顾形式化统计保障与工程落地,为机器人、自动驾驶这类高风险AI Agent,提供一套可落地的主动安全方案。
论文开源仓库:https://github.com/haoyuwang99/ProbGuard