
Hindsight 开源:让AIAgent拥有长期记忆,并具备持续学习能力
Hindsight 开源:让 AI Agent 拥有长期记忆,并具备持续学习能力
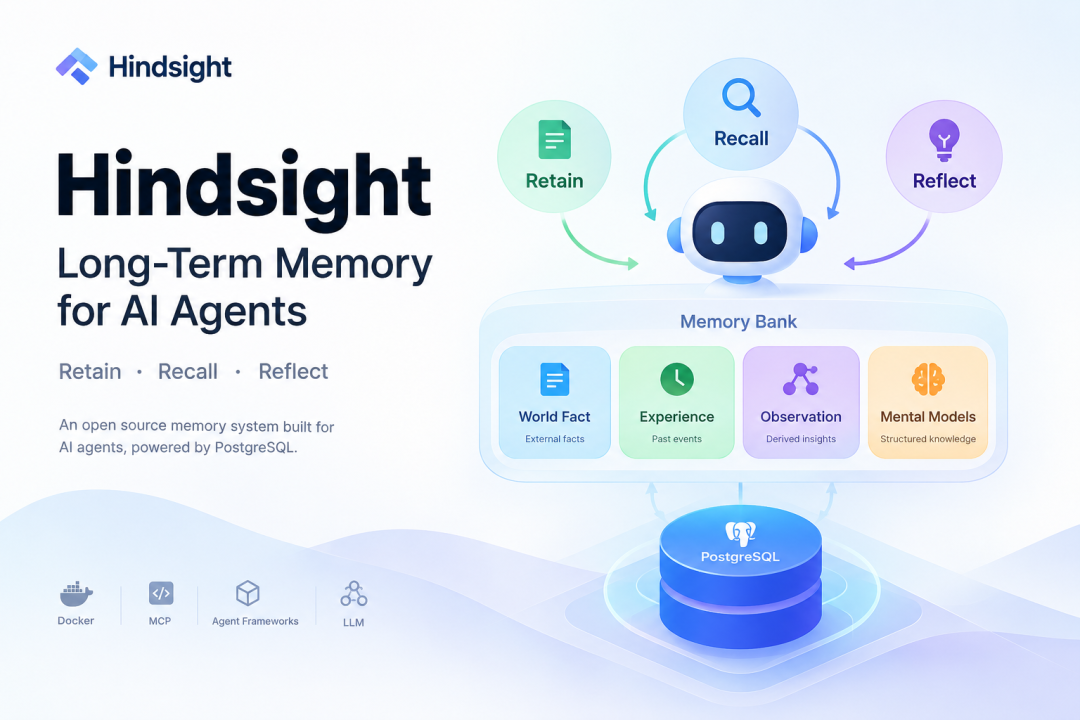
Vectorize 开源了 Hindsight,一个面向 AI Agent 的长期记忆系统。项目围绕 Retain、Recall、Reflect 三项核心能力构建,用于完成记忆写入、长期检索以及基于历史记忆的推理。
Hindsight 采用 PostgreSQL 作为核心存储,结合向量检索、全文检索、实体关系和时间信息组织记忆,并支持 MCP、Docker、本地模型以及多种 Agent Framework。
项目源码采用 MIT License。
核心能力
Hindsight 将 Agent Memory 划分为几个不同层次。
World Fact 用于保存外部世界中的事实,例如项目采用 PostgreSQL、某位用户负责某项业务。
Experience 用于保存 Agent 或用户实际经历,例如某次部署完成、一次技术方案讨论以及一次任务执行结果。
Observation 用于保存从多个历史事实中归纳出的信息,例如用户长期使用某种开发方式,或者某个项目长期采用某类技术方案。
在此基础上,Hindsight 还提供 Mental Models,用于围绕特定主题形成持续更新的知识模型,例如用户技术偏好、项目架构和历史决策。
因此,系统中的记忆具有“事实—观察—模型”的层次关系。
Retain:写入长期记忆
retain() 是 Hindsight 的记忆写入接口。
client.retain(
    bank_id="my-bank",
    content="Alice joined Google in March 2024 as a Senior ML Engineer"
)
系统会从输入内容中提取事实、实体、关系和时间信息,并建立检索所需的数据结构。
官方提供多种提取模式:
- •
concise:提取精简记忆 - •
verbose:提取更完整的信息 - •
custom:自定义提取方式 - •
verbatim:保留原始表达 - •
chunks:直接保存原始 Chunk
同时可以通过 retain_mission 为 Memory Bank 指定关注方向。例如软件项目可以重点记录架构决策、API 设计、技术选型和问题修复过程。
这种方式使不同 Agent 或项目能够拥有相互独立的 Memory Bank。
Recall:多路检索历史信息
recall() 用于从长期记忆中寻找相关内容。
Hindsight 的检索体系称为 TEMPR,综合语义、关键词、实体关系和时间等信息进行搜索。
例如查询:
Alice 去年春天负责过什么项目?
系统可以同时利用 Alice 这一实体、项目语义以及时间条件进行检索。
这一设计针对长期记忆中的典型问题:用户过去的信息往往分散在多个会话中,单纯依靠向量相似度很难完整表达实体关系和时间关系。
Recall 本身负责搜索记忆,不负责生成最终回答,也不会额外调用 LLM 进行回答生成。
Reflect:基于记忆进行推理
reflect() 在 Recall 基础上进一步处理复杂问题。
response = client.reflect(
    bank_id="my-bank",
    query="What are Alice's strengths for the team lead role?"
)
Reflect 会检索相关记忆,再综合事实、Observations 和 Mental Models,通过 LLM 形成回答。
Recall 更接近“找到过去的信息”,Reflect 则用于“根据过去的信息形成结论”。
对于用户长期偏好、项目历史决策、任务经历等问题,Reflect 可以将分散在多个时间点的记忆结合起来。
Observation:持续整理历史事实
Hindsight 的 Observation 机制用于从多个记忆中形成更高层次的信息。
例如一个用户先后表达过:
- • 喜欢使用 Python;
- • 新项目开始使用 TypeScript;
- • 后端项目逐步统一采用 TypeScript;
- • 后续项目优先考虑 TypeScript。
这些内容可以分别作为历史事实保存,同时进一步形成关于用户技术偏好的 Observation。
新的事实进入系统后,相关 Observation 可以继续更新。
这样形成的记忆结构包含原始证据和高层归纳信息,后续 Reflect 可以同时利用两类内容。
PostgreSQL 作为核心数据库
Hindsight 的一个工程特点是直接建立在 PostgreSQL 之上。
项目官方 API 文档列出了多种向量后端,包括:
- • pgvector
- • pgvectorscale
- • vchord
- • ScaNN
全文搜索则支持 PostgreSQL 原生全文搜索以及多个扩展方案。
Hindsight 因此可以在 PostgreSQL 中同时处理结构化数据、全文检索、向量检索以及 Agent Memory。
项目还提供读副本相关配置,可将 Recall 查询分配到独立连接池。
对于已经使用 PostgreSQL 的企业或个人开发者,这种架构能够减少额外数据库组件。
支持云端和本地模型
Hindsight 本身不提供基础大语言模型,记忆提取和 Reflect 推理需要连接 LLM。
官方支持:
- • OpenAI
- • Anthropic
- • Gemini
- • DeepSeek
- • MiniMax
- • Groq
- • Amazon Bedrock
- • Vertex AI
同时支持:
- • Ollama
- • LM Studio
- • llama.cpp
- • OpenAI-compatible API
- • LiteLLM
因此,Hindsight 可以与本地模型结合使用。
对于已经运行 Ollama、vLLM 或 LiteLLM 的本地 AI 环境,可以将 Hindsight 作为独立 Memory Server,通过兼容 API 调用现有模型。
MCP 接入 Agent
Hindsight 内置 MCP Server,可以将长期记忆能力提供给支持 MCP 的 Agent。
项目目前提供针对 Coding Agent 的集成,README 中列出的对象包括:
- • Claude Code
- • Codex CLI
- • Cursor CLI
- • GitHub Copilot CLI
- • Cline
- • Devin
- • Pi
- • Prime Agent
实际使用时,可以为不同代码仓库建立独立 Memory Bank。
Agent 在开发过程中可以记录架构决策、代码问题、解决过程以及项目约定,后续任务通过 Recall 获取历史信息。
Hindsight 同时提供 Microsoft Agent Framework、Google ADK 等集成方式。
Docker 部署
官方提供 Docker 镜像,基础部署方式如下:
docker run -it --pull always \
  --name hindsight \
  -p 8888:8888 \
  -p 9999:9999 \
  -e HINDSIGHT_API_LLM_API_KEY=$OPENAI_API_KEY \
  -v hindsight-data:/home/hindsight/.pg0 \
  ghcr.io/vectorize-io/hindsight:latest
默认 API 端口为 8888,控制界面端口为 9999。
项目同时提供 Python Package、Docker Compose 和 Helm 等部署方式。
论文评测
Hindsight 的技术方案发表在 arXiv 论文 《Hindsight is 20/20: Building Agent Memory that Retains, Recalls, and Reflects》。
论文使用 LongMemEval、LoCoMo 等长期记忆任务进行测试。
论文报告,在使用相同开源 20B 模型的实验中,加入 Hindsight 后整体准确率由完整上下文基线的 39% 提升至 83.6%;扩大模型规模后,LongMemEval 达到 91.4%,LoCoMo 最高达到 89.61%。
项目官方随后发布的 Agent Memory Benchmark 中,Hindsight v0.4.19 的测试结果包括:
| 数据集 | Hindsight 测试结果 |
|---|---|
| LoCoMo | 92.0% |
| LongMemEval | 94.6% |
| LifeBench | 71.5% |
| PersonaMem | 86.6% |
这些结果对应特定版本、模型和测试设置,适合用于理解项目当前研究与工程实现的表现。不同版本、模型和数据集之间不能直接横向比较。
项目技术结构
从整体架构看,Hindsight 可以概括为:
Agent → Retain → Memory Bank → Recall → Reflect → Agent
其中:
Retain 负责将对话、文档和任务经历转化为长期记忆。
Memory Bank 负责保存事实、经历、观察和实体关系。
Recall 负责通过语义、关键词、实体和时间等信息检索记忆。
Reflect 负责结合检索结果和高层记忆进行推理。
Mental Models 则负责维护针对特定主题的长期知识摘要。
在工程层面,PostgreSQL 提供核心存储,向量与全文检索提供搜索能力,外部 LLM 负责记忆提取与 Reflect,MCP 则负责连接现有 Agent。
适用场景
Hindsight 主要适用于需要长期状态保存的 Agent:
个人 AI 助手
保存用户长期偏好、历史任务和持续变化的信息。
Coding Agent
记录代码仓库结构、技术方案、历史 Bug 和开发约定。
企业 Agent
保存业务知识、操作历史和跨会话任务状态。
客服 Agent
建立持续更新的用户交互记忆。
研究 Agent
保存检索过程、历史结论及相关证据。
对于本地 AI 用户,Hindsight 还可以与 Ollama、vLLM、LiteLLM 和 MCP 组合使用,构建本地化的长期记忆服务。
相关地址
项目地址:
https://github.com/vectorize-io/hindsight
项目文档:
https://hindsight.vectorize.io/
论文:
https://arxiv.org/abs/2512.12818