
每天为你解读一个新知识-AI大模型蒸馏
✅ AI大模型蒸馏(知识蒸馏 Knowledge Distillation)
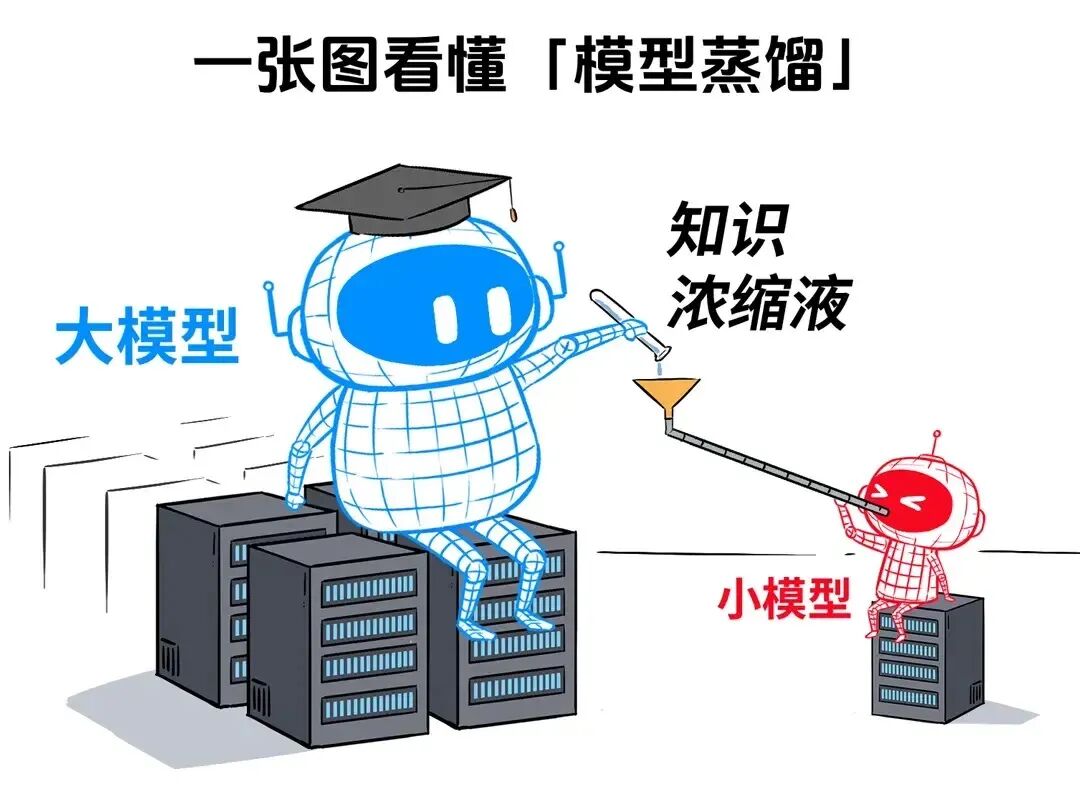
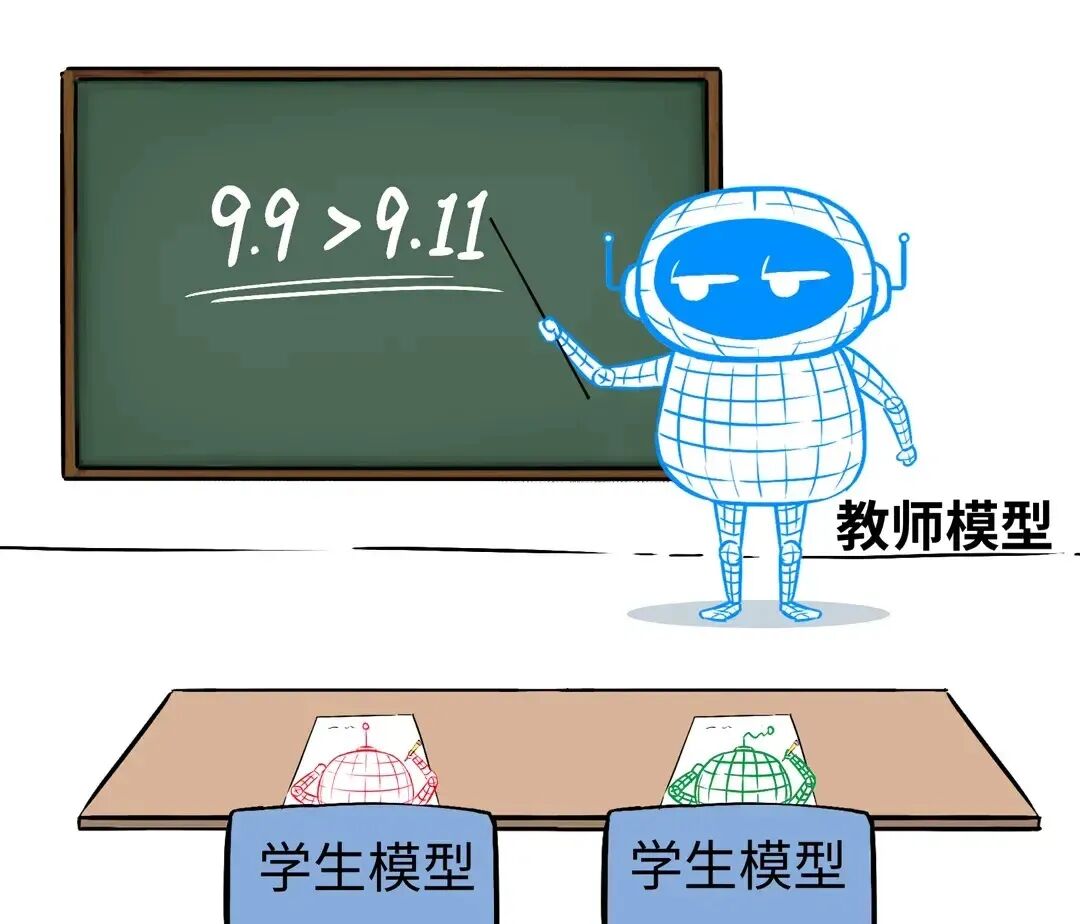
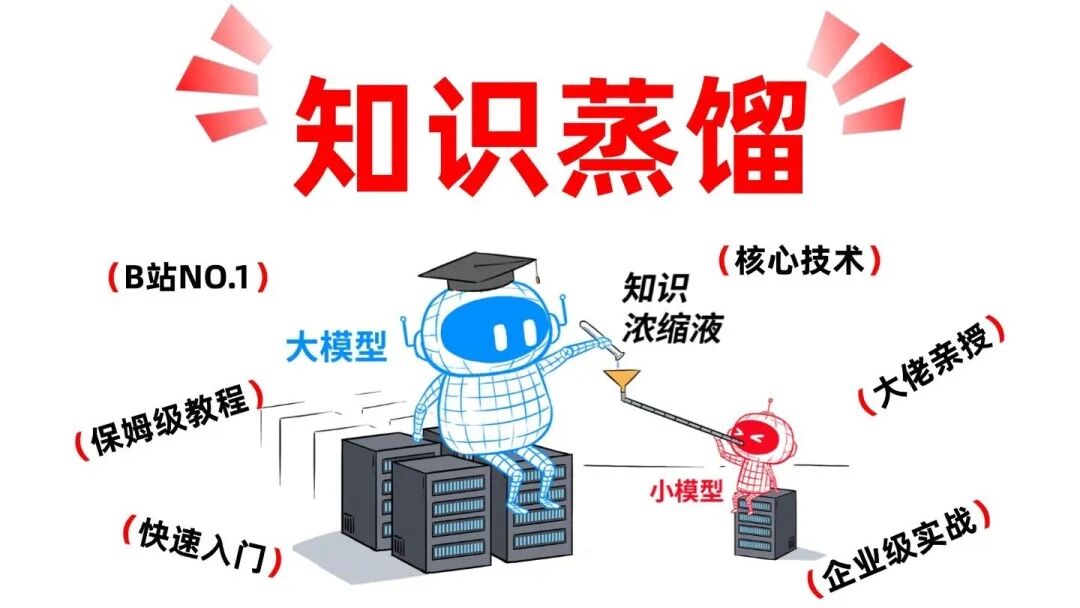
一句话定义:拿一个已经训练好、能力很强的巨型大模型当「教师模型」,训练一个参数量更小、推理更快的「学生模型」,不是拷贝权重,而是让小模型模仿大模型的回答风格、推理思路、判断偏好,把大模型的能力迁移到小模型身上,属于模型压缩技术。
通俗类比:大师(教师大模型)做题不只写下最终答案,还把自己完整的思考过程、各个备选答案的取舍思路全部写出来,学徒(学生小模型)照着这套思路学习,最后学徒体型更小、干活更快,解题水平却非常接近大师。
一、为什么要做大模型蒸馏?
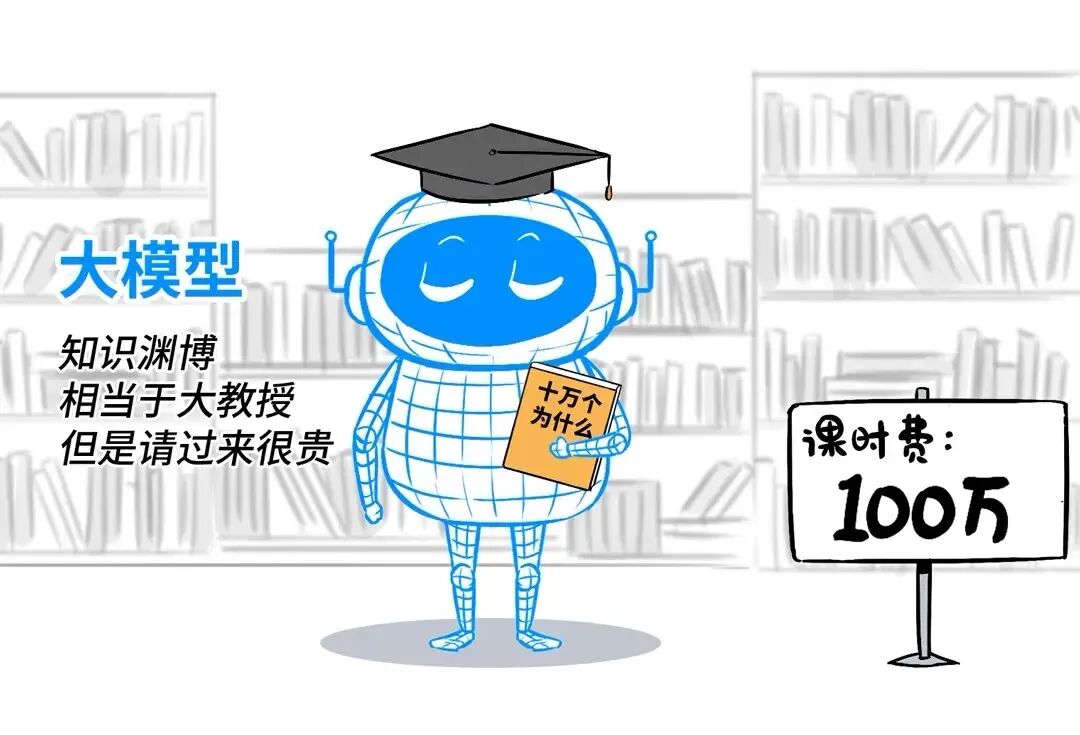
超大参数量大模型(比如几百B)有致命缺点:
1. 推理很贵:一次问答消耗大量GPU算力,调用成本高
2. 速度慢:token生成延迟高,不适合手机、边缘设备本地部署
3. 资源占用巨大:内存显存需求极高
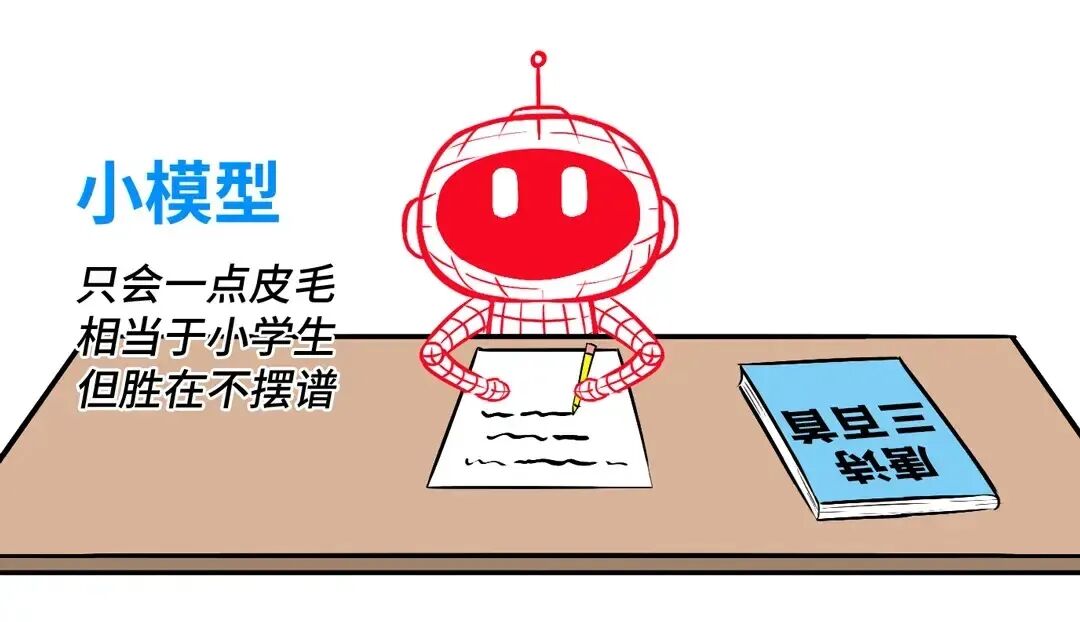
👉 蒸馏目标:用一个小很多的模型,尽量逼近大模型效果,推理速度快几倍、显存占用大幅下降,可以部署在普通服务器甚至手机本地。
典型例子:DistilBERT,参数量只有BERT的一半,速度快2.5倍,性能只小幅下降;很多开源大模型都有对应的蒸馏版(DeepSeek‑R1‑Distill等)。
二、核心原理:蒸馏到底在“蒸”什么?——暗知识(Dark Knowledge)
普通训练只用硬标签 Hard Label:只给唯一标准答案,例如问题的正确回答只有一行文字。
• 硬标签信息量很少:只知道“这个答案是对的,其余全部错”
教师大模型输出的是完整概率分布(软标签 Soft Label):不只给出最优答案,还输出所有备选答案各自的置信概率。
• 概率分布里面藏着暗知识:模型对于“各个答案之间相似程度、取舍倾向、不确定度”的理解,这是单纯标准答案给不出来的经验。
举个例子:
硬标签:正确答案:A
教师软标签:A概率80%,B概率18%,C概率2%
暗知识含义:模型认为B和A很接近,C几乎完全不相关,学生模型要学到这个判断倾向,而不只是死记“A是正确答案”
温度参数 T:蒸馏里的核心超参,用来把概率分布“摊平、软化”,放大次要选项之间微小的概率差异,方便学生捕捉暗知识。
三、LLM大模型蒸馏完整流程(两种主流方式)
方式1:白盒蒸馏(有教师模型权重,学术常用)
1. 教师大模型训练完成,权重冻结,不更新
2. 同一个输入prompt,同时送入教师、学生模型
3. 教师输出token概率分布(软标签)
4. 学生模型同时学习两件事:
◦ ① 和真实标准答案对齐(硬损失)
◦ ② 和教师模型的概率分布对齐(蒸馏损失,KL散度)
5. 反向传播只更新学生模型参数,反复迭代收敛
方式2:黑盒蒸馏(产业界最常用,只用大模型API)
很多商用大模型不给你底层权重,只能调用API拿回答,这时用黑盒蒸馏:
1. 准备大量prompt数据集
2. 调用教师大模型API,让老师对这批prompt输出完整回答,得到高质量蒸馏数据集
3. 拿着这批「老师写好的问答对」,直接对小基座大模型做SFT监督微调
4. 最终得到模仿教师回答风格、行文逻辑的学生模型
现在绝大多数企业做业务专属小模型,都是这种黑盒蒸馏路线。
四、蒸馏 VS 微调 VS 量化(极易混淆,一次性分清)
• 微调(Fine‑tune / SFT):基座大模型在自有业务数据上继续训练,目标是适配新任务,模型大小基本不变
• 蒸馏(Distill):大模型教另一个独立的小模型,核心目标:能力迁移、模型变小
• 量化(Quantization):同一个模型,把参数的数值精度降低(FP16→INT8/INT4),不改变模型结构,单纯压缩体积、加速推理,知识本身没有迁移
工程上经常组合使用:蒸馏出小模型之后,再做量化,进一步加速部署
五、优势与局限性
✅ 优点
1. 小模型推理成本大幅降低、响应更快,适合端侧部署
2. 不需要从零预训练,依靠教师的高质量输出,小模型训练数据门槛更低
3. 可以专门蒸馏垂直领域能力:只用业务相关问答,蒸馏一个领域专属小模型
❌ 局限(非常关键)
1. 学生模型存在上限:很难超过教师模型,最多接近老师水平
2. 蒸馏只能学到教师输出里体现出来的能力,藏在教师内部权重里、从来没有输出过的知识,学生学不到
3. 容易出现模仿偏误:只学老师回答的表面话术,底层推理能力并没有真正迁移(俗称“背答案”)
4. 版权与合规风险:未经授权,大量抓取商用大模型API输出用来蒸馏竞品模型,属于违反服务协议的行为
六、典型落地场景
1. 手机本地AI助手:把云端大模型蒸馏成7B/3B小模型,手机本地离线运行
2. 企业私有化部署:不用昂贵超大模型,蒸馏一个业务版小模型部署在内网服务器
3. 垂直行业Agent:客服、编程、法律、医疗领域,蒸馏行业专属轻量化大模型
4. 多模型方案:云端用巨型教师模型做复杂难题,常规请求交给蒸馏后的小模型处理,大幅降本
七、常见误区纠正
1. ❌ 蒸馏=复制大模型参数:完全不是,学生是独立模型,参数完全不一样,只是行为模仿老师
2. ❌ 蒸馏之后能力不变:一定会有性能损失,优秀蒸馏方案做到损失很小
3. ❌ 蒸馏只能做更小的模型:理论上大模型也可以蒸馏到大模型;工业界几乎都是大→小