
Nature Machine Intelligence|不只是「像大脑」,人脑信号还能直接引导语言模型进行鲁棒推理
语言模型和人脑,是否使用相似的方式推理?
从神经科学的视角来看,语言并不等同于思维。2024 年 Nature 的一篇观点文章综合了神经科学及相关领域的证据指出,支持语言加工的核心脑网络与支持推理等复杂思维的系统可以相互分离:语言能力受损时,部分复杂思维能力仍可保留;而在完成推理、规划等任务时,大脑主要依赖不同于核心语言网络的神经系统。由此而言,语言更接近一种服务于交流的信息传递系统,而非复杂思维发生的必要条件 [1]。
这一视角让大语言模型所表现出的认知能力更值得探究。语言模型主要通过语言数据与下一个词元预测目标进行训练,却已能够完成推理、规划和工具使用等超出传统语言加工范畴的任务。这究竟只是对训练语料统计规律的利用,还是模型以语言为载体学到了一部分类似人脑的潜在认知能力的内部表征?
既有 NeuroAI 研究发现,语言模型的内部表征与人脑语言网络活动之间存在一定对应关系 [2],多模态大模型也能够形成与人类物体概念表征部分相似的结构 [3]。然而,对于逻辑推理这类超越语言加工本身的高阶认知任务,语言模型与人脑表征的关系仍缺乏系统证据。更进一步,即使模型与人脑存在相关性的对齐,这种对应关系是否具有功能意义,即人脑信号能否反过来用于引导模型进行鲁棒推理,仍是一个开放问题。
最近,来自北京大学、清华大学和微软亚洲研究院的研究者在 Nature Machine Intelligence 发表研究,围绕演绎推理问题系统地探究了上述问题。研究发现,语言模型的内部表征与人脑推理相关脑区的任务态 fMRI 活动存在部分对齐关系;更重要的是,可以进一步利用脑信号所诱导的方向,在推断阶段干预模型表征或在训练阶段微调模型参数,从而将模型与人脑之间的 “表征对齐” 转化为能够改善推理鲁棒性的 “神经引导”。 这项研究由此将语言模型与大脑之间的关系从相关性的表征分析推进至功能性的神经引导,为脑启发人工智能提供了一条新的研究路径。
论文题目:Beyond representational alignment with brain-guided language models for robust reasoning
论文作者:肖命清,杜凯,林宙辰
论文链接:https://www.nature.com/articles/s42256-026-01278-w
预印本链接:https://arxiv.org/abs/2606.11893
代码链接:https://github.com/pkuxmq/Brain-guided_LLM
新闻观点链接:https://www.nature.com/articles/s42256-026-01302-z
背景:AI 与大脑的表征对齐
人工智能模型与人脑可以在行为层面完成相同任务,但相似的行为表现并不意味着二者具有相似的内部机制。表征对齐关注内部表征层面的对应关系:在相同刺激或任务条件下,分别提取模型隐藏状态与人脑神经活动,再比较两类表征所形成的结构是否一致。
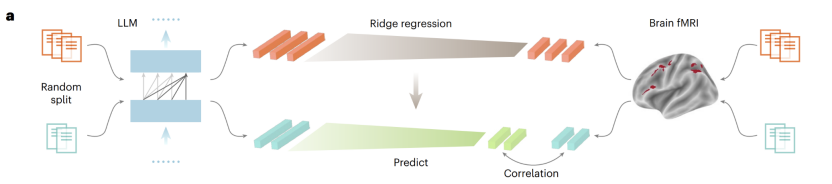
图 1:神经可预测性计算示意图
一类常见方法是使用模型表征预测脑活动,并以预测结果与真实神经响应之间的相关程度衡量二者的对应关系,这一指标通常被称为神经可预测性(neural predictivity)或 brain score [4]。该方法先在部分刺激上学习从模型表征到神经表征的线性映射,再预测未参与拟合的新刺激所诱发的脑活动。考虑到 fMRI 测量包含噪声,结果通常还会依据神经数据的可解释上限进行归一化。研究将这一范式扩展至演绎推理,以考察语言模型内部表征与人脑推理相关脑区之间的对应关系。
演绎推理中的部分表征对齐
研究使用公开的任务态 fMRI 数据,参与者完成三段论推理与传递关系推理两类任务,并判断结论能否由前提推出。为减少语义干扰,问题主要由伪词、虚构名称和受控属性关系构成。研究让来自 Qwen、Llama、Mistral、Phi 和 Gemma 等系列的 10 个开源模型处理相同刺激,模型参数规模覆盖 1.5B 至 72B,并提取模型内部的激活表征。
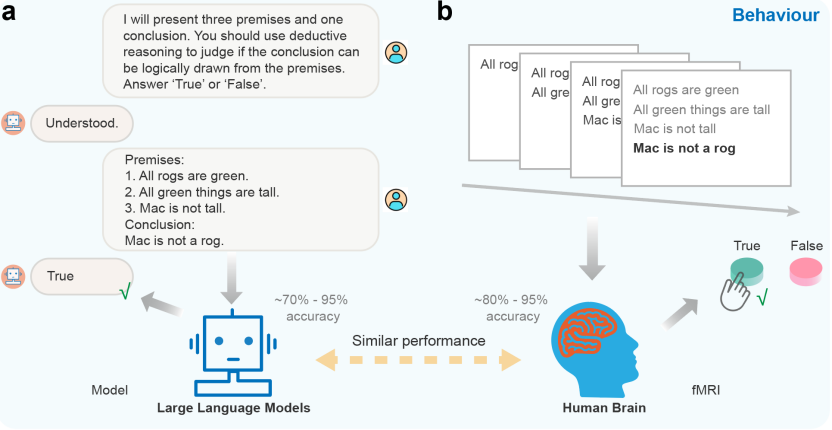
图 2:演绎推理任务示意图
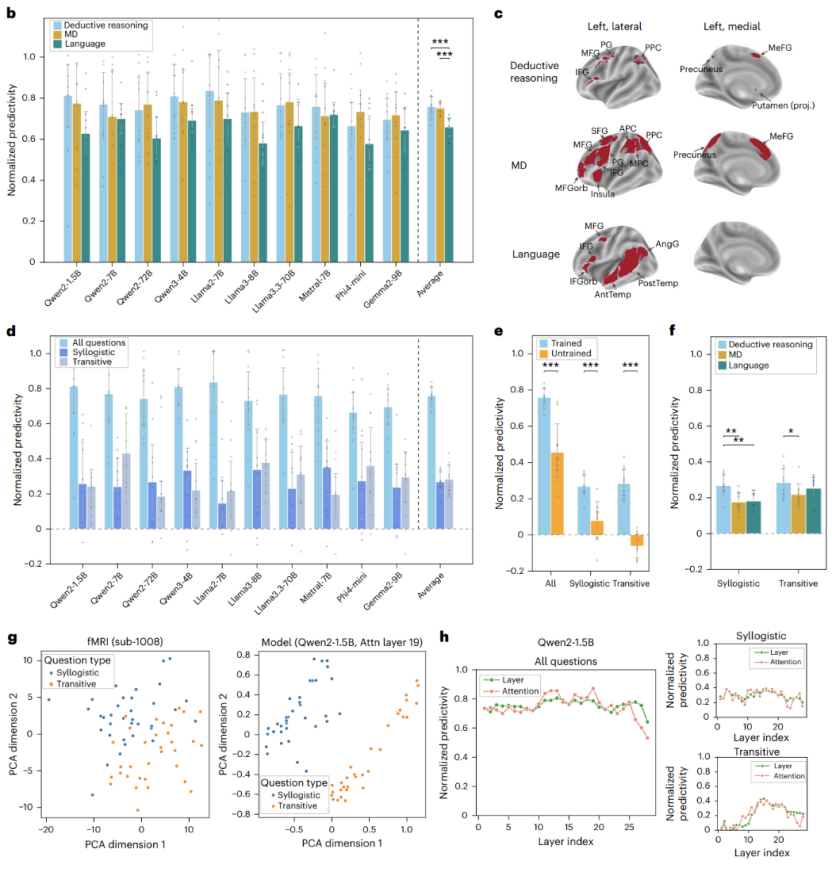
图 3:神经可预测性结果
研究分别计算了模型表征与大脑中的演绎推理脑区、多重需求网络和核心语言网络的神经可预测性。结果显示,当考虑整体推理任务时,模型表征平均可以解释推理相关脑区约 76% 的可解释方差,且存在区域特异性:演绎推理脑区和多重需求网络中的神经可预测性显著高于核心语言网络。同时这一趋势在不同的模型家族中保持一致。
另一方面,当对两类推理问题分别进行分析时,神经可预测性明显下降至约 27%,表明在更细粒度的层面上,模型与人脑表征的差异仍然存在。即便如此,模型的神经可预测性仍显著高于未训练的模型,并保持区域特异性。
总体而言,结果说明了模型与人脑表征的部分对齐:模型捕捉到了与人脑推理活动部分共享、具有脑区特异性的结构,但在具体推理类型内部仍存在明显差异。
从相关性到神经引导
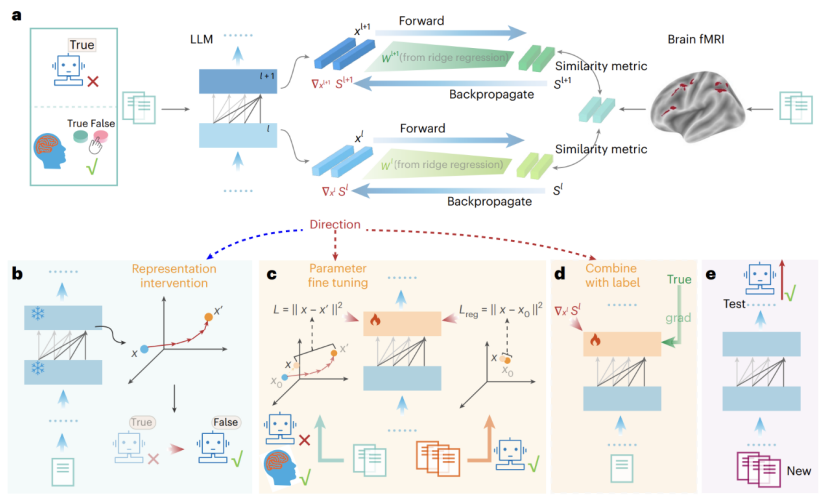
图 4:神经引导方法示意图
基于表征空间的部分对齐,研究进一步提出了基于脑信号的神经引导方法。具体而言,方法首先学习从模型隐藏状态到 fMRI 空间的线性映射,然后对于模型回答错误、而人类回答正确的问题,计算映射后的模型表征与真实脑活动之间的相似度指标、并将该指标对模型隐藏状态求梯度,由此得到模型隐空间中的神经引导方向。该方向由模型表征与大脑表征的联合结构所决定。
这一方向有两种用法:神经活动引导的表征干预(NARI)在模型推断过程中直接修改引导内部表征、不更新参数;神经活动引导的表征微调(NARF)则通过微调训练将表征方向的知识内化到模型参数中。
NARI:推断阶段的表征干预
NARI 面向模型原本回答错误、而相应人类参与者回答正确的问题,在模型中间层的注意力输出上施加受约束的神经引导。对于纳入分析的原始错误问题,NARI 最终实现了 100% 的纠错覆盖,显著优于仅保留模型表征结构的随机脑信号基线和随机方向基线。这说明脑信号的引导能够提供有效的模型激活引导方向。
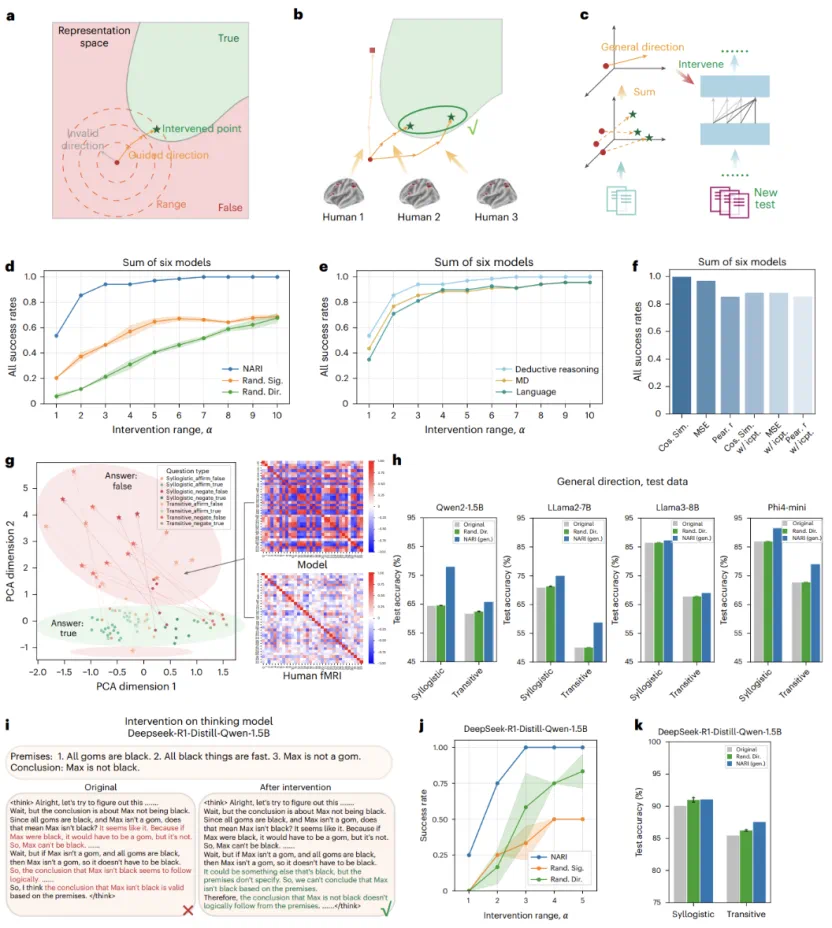
图 5:脑信号引导的推断时干预结果
进一步,方法聚合多个问题和参与者产生的成功干预方向,得到可迁移到新问题的通用方向。该方向在多个模型上提升了在新的推理问题上的测试表现,并且可一定程度扩展至具有思维链的模型推理过程。这说明脑引导的方向包含更一般的推理相关的信息,能够引导模型的内部表征。
NARF:将神经引导内化到模型参数
NARF 通过参数微调使模型中间表征接近脑信号引导的目标,从而将表征层面的知识内化到参数中以提升模型推理的鲁棒性。已有研究表明,语言模型对于即使相对简单的推理问题,仍存在鲁棒泛化的问题 [5,6],例如前提的呈现顺序也会显著影响模型表现 [6]。因此,研究在训练时使用 fMRI 实验中的三段论与传递关系问题,而在测试时引入新问题、不同前提顺序与数量、以及具有不同逻辑类型的推理问题,以测试模型推理的鲁棒性。
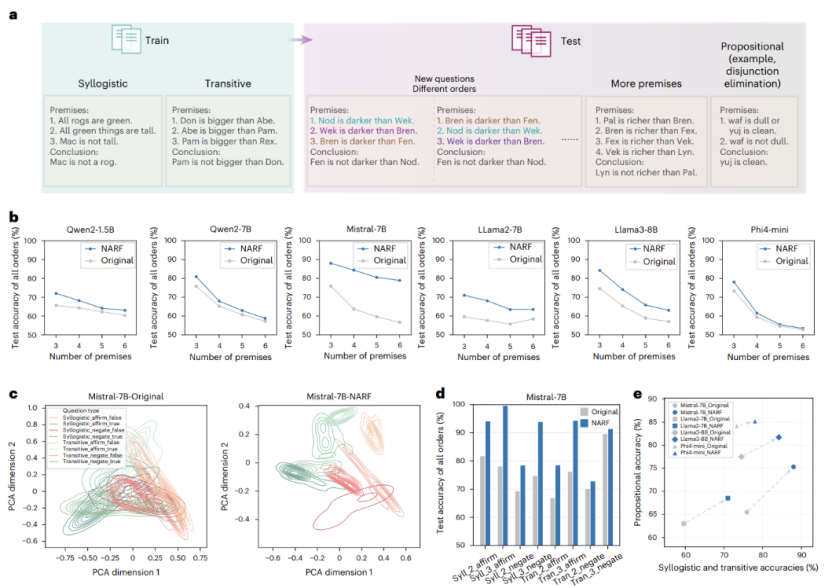
图 6:脑信号引导的参数微调结果
结果显示,微调后的模型在不同前提数量和排列顺序下均获得稳定提升,正确与错误逻辑问题在中间层中的分离也更加清晰。性能增益还能迁移至命题推理,说明模型学到的并非具体问题的表征,而是具有一定跨问题和跨推理类型泛化能力的表征知识。
神经引导与语言监督的互补性
更进一步,研究揭示:神经引导带来的增益,和常规的语言层面的监督是互补的。为此,研究将两种监督联合起来:语言监督通过最终输出词元的交叉熵损失,直接约束模型给出正确答案;NARF 则同时推动中间表征朝更接近人脑任务态神经活动的方向变化。两种目标分别作用于最终行为和内部表征,因此可以共同参与训练。
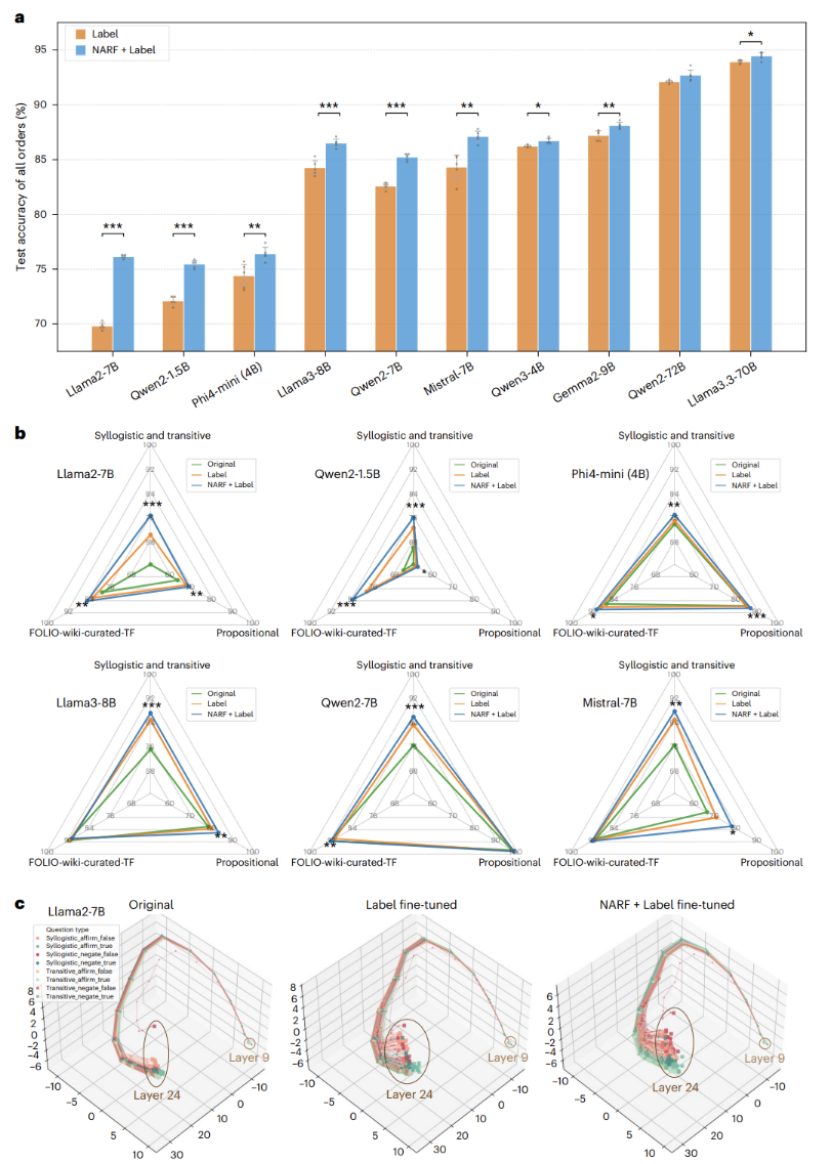
图 7:脑信号引导的参数微调与语言监督相结合的结果
结果显示,加入脑信号引导后,模型的准确率相较于仅使用语言监督具有一致的提升(平均约 2.2 个百分点),且提升可以泛化至具有不同逻辑结构的命题推理以及自然语言一阶逻辑推理,最高提升可达 13.2 个百分点。同时,研究也测试了采用合成的训练数据进行语言监督训练的设定,结果显示神经引导仍具有额外的增益。模型内部表征的层级轨迹分析显示,神经引导相比仅使用语言监督可以对正确与错误逻辑问题的中间表征形成更具区分性的推断轨迹。这些结果说明神经引导可以作为一种额外的学习信号来源。
研究还将这一框架扩展至 Human Connectome Project 的关系加工任务,结果显示,任务态脑活动也能诱导有效的表征干预方向、神经引导也能在语言监督的基础上带来一致的增益,表明了该框架并不局限于单一演绎推理数据集。
总结
这项研究不仅揭示了语言模型与人脑推理过程内部表征的部分对齐,还进一步将二者的关系从 “表征是否相似” 推进至 “脑信号能否用于改善模型”。结果表明,模型与人脑推理相关区域存在部分且具有脑区特异性的表征对应,这种部分的共享结构还可以转化为推理阶段的表征干预和训练阶段的参数监督,并为常规语言监督提供额外增益。这提供了一条内部表征层面的新的脑启发 AI 的路径。
当前实验主要聚焦于基础演绎推理,fMRI 的时间分辨率也难以追踪复杂思维过程中的快速变化。未来,更高时间分辨率的 EEG、MEG 等模态的数据,以及覆盖更复杂认知过程的神经数据,可能支持更细粒度的分析与引导。
参考文献
[1] Fedorenko, E., Piantadosi, S. T. & Gibson, E. A. F. Language is primarily a tool for communication rather than thought. Nature, 2024.
[2] Schrimpf, M. et al. The neural architecture of language: integrative modeling converges on predictive processing. PNAS, 2021.
[3] Du, C. et al. Human-like object concept representations emerge naturally in multimodal large language models. Nature Machine Intelligence, 2025.
[4] Schrimpf, M. et al. Brain-Score: which artificial neural network for object recognition is most brain-like? bioRxiv, 2018. https://doi.org/10.1101/407007.
[5] Malek, A. et al. Frontier LLMs still struggle with simple reasoning tasks. arXiv preprint arXiv:2507.07313.
[6] Chen, X. et al. Premise order matters in reasoning with large language models. ICML, 2024.