
让AIAgent先写 HLS 再改 RTL,性能直接翻 2.6 倍?
最近 UCLA Jason Cong 团队的一篇 ICCAD '26 邀请论文回答了一个我们这行人吵了很多年的问题:AI Agent 做芯片设计,到底该直接写 RTL,还是走 HLS(High-Level Synthesis,高层次综合)?他们的结论很明确——先在 HLS 层做设计,再对生成的 RTL 做细化,这条组合流水线(他们命名为 AHRR,Agent-based HLS with RTL Refinement)在 11 个任务的基准上,比 Agent 直接写 RTL 拿到了 2.62 倍的几何平均加速。
这篇文章我按论文的脉络完整梳理一遍,细节都在。
四条设计流程
论文把 Agent 与硬件设计的接口拆成四种流,做的是受控对比:
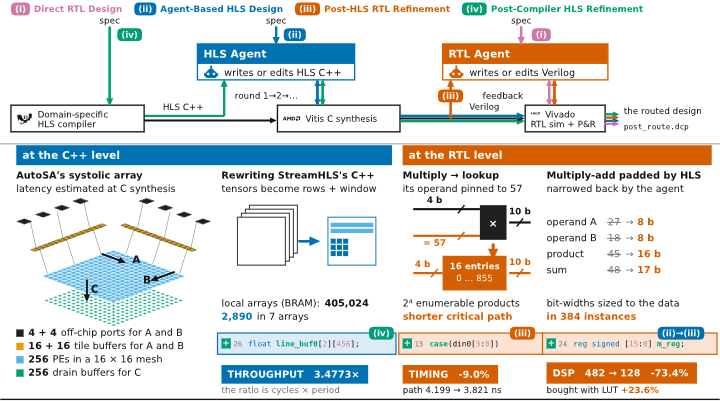
- Direct RTL Design:Agent 拿到任务规格后直接产出 RTL,拥有完全控制权。
- Agent-based HLS Design:Agent 优化 HLS C/C++ 代码,把调度、流水线和 RTL 生成交给编译器。
- Post-HLS RTL Refinement:Agent 在 HLS 工具(Vitis HLS)产出的 Verilog 上继续做底层优化。
- Post-Compiler HLS Refinement:领域专用编译器(论文用的是 AutoSA 和 StreamHLS)先生成一份 HLS 设计,Agent 再细化 C++,产出的 RTL 再作为流 (iii) 的输入。
流 (ii)+(iii) 组合起来就是 AHRR。作者的切入点很清晰:RTL 之所以成为人工设计的标准接口,是因为它提供周期精确的规格;但 HLS 把调度和流水线决策交给编译器,领域专用编译器再往上封装了参数化的架构模板。Agent 到底受益于哪个层面,此前没有系统的量化答案。
实验怎么做的
评估平台选 FPGA——部署方便、迭代快,但作者强调这些设计流层面的取舍基本与目标工艺无关。Agent 用的是开源编码 Agent pi,未做修改,跑标准的迭代循环:每轮最多一小时开发并提交候选设计,采用隐藏测试集(hidden testbench)评分。任务包里有一份正确的未优化 C++ 参考、一份测试激励和固定的接口契约。
两个细节做得比较扎实:一是隐藏测试集不断加严,直到 C++ 参考达到 100% 分支覆盖率,还在参考 RTL 上额外测了语句和分支覆盖;二是 prompt 刻意保持最小化,只写优化目标、资源预算、接口要求和提交协议,避免 prompt 工程掩盖方法本身的差异。模型用了 Gemini 3.1 Pro(高推理档)和 GPT-5.6-sol(超高推理档),同一套 harness、所有参数固定,每个实验跑一次。有效设计的判定是:通过隐藏测试集、布通、资源不超上限。执行时间按仿真周期数乘以布线后时钟周期与目标时钟的较大值计算。
核心结果:抽象层级确实帮 Agent
对比规格驱动两条流,Agent-based HLS Design 相对 Direct RTL Design 拿到 2.31 倍几何平均加速;加上 Post-HLS RTL Refinement 组成 AHRR 后,提升到 2.62 倍。
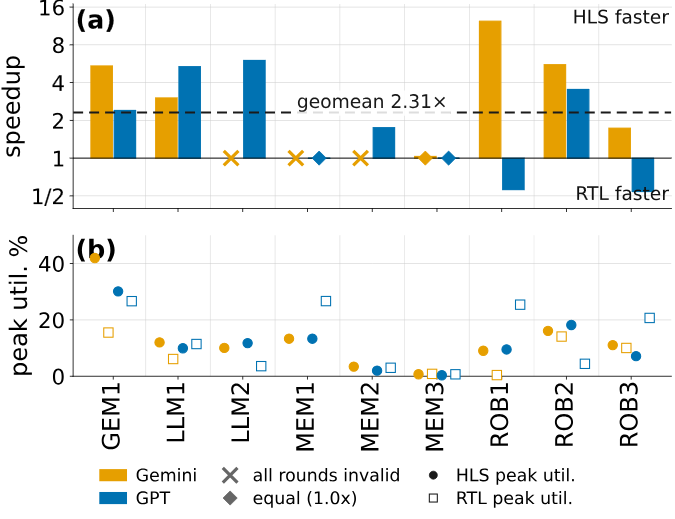
逐任务看有几个值得记住的数字。ROB1 上 Gemini 的 HLS 流比直接 RTL 快 12.35 倍,细化后达 13.82 倍;ROB2 上 GPT 从 9.22ms 优化到 2.20ms(4.19 倍)。RTL 直接设计并非全无胜算——它赢的两个场景(ROB1、ROB3 的 GPT 版本)都是小核,状态能塞进寄存器,RTL 流可以直接落位,HLS 只能靠 binding pragma 表达意图。
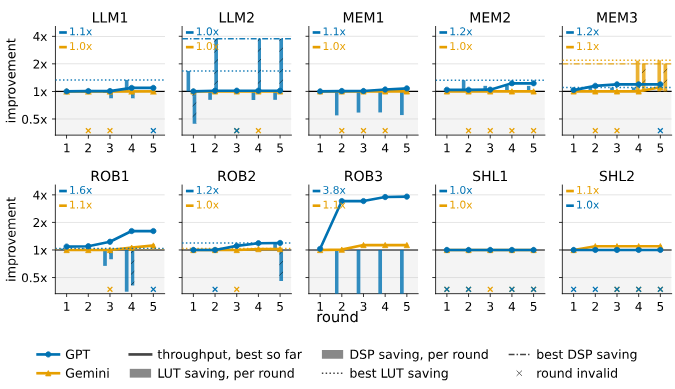
细化阶段的数据也说明问题:16 个有效案例中,Post-HLS RTL Refinement 相对其 HLS 起点 geometric mean 提升 1.17 倍。大部分成功轮次是局部修改,周期数改动通常小于 1.15 倍;而每一次大的延迟改进都来自彻底重写——Agent 直接扔掉 HLS 生成的 RTL 另起炉灶,ROB1 和 ROB3 上就是靠重写拿到 22 到 4 倍的加速。
Post-Compiler HLS Refinement 那条线更有意思:在 SHL2 上 Gemini 和 GPT 分别把 StreamHLS 的结果再提升 3.3 倍和 1.7 倍;在 GEM1 上两者把 AutoSA 提升 1.3 倍和 1.2 倍,周期数改动不到 2%,收益来自时序改善——Gemini 改了 storage binding(bind_storage type=ram_2p impl=lutram)和 FIFO 深度(2→4),GPT 重构了控制和 PE 数据通路。编译器优化之后仍有油水可榨,这件事本身就有说服力。SHL1 是唯一两个 Agent 都没改进的任务,但原因不在 Agent:编译器生成的初始设计仿真时间已接近超时上限,迭代空间被评估环境卡死了。
案例分析:抽象到底帮了什么
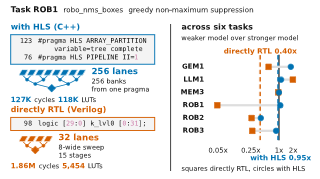
ROB1(greedy NMS)最能说明问题。 任务是对最多 8192 个候选框做非极大值抑制,保留至多 512 个,IoU 阈值 50%。主延迟瓶颈在每周期处理的框数。走 HLS 时,Agent 只需两条 pragma——ARRAY_PARTITION 切成 256 个 bank、PIPELINE 做到每周期一次迭代——Vitis HLS 自动生成 256 端口读取、对数深度比较树和层间流水寄存器,产出的 Verilog 有 43914 行。同一个 Agent 直接写 Verilog,只搭出 32 路 argmax 加 8 路抑制扫描,每周期从内存口读一个 512-bit 字,378 行代码 15 级流水。结果:直接 RTL 版跑 1.86M 周期,HLS 版 127K;LUT 倒是省了,5454 对 118K。
更有推广价值的是右半张图:在四个 (GPT/Gemini)×(HLS/RTL) 组合全部成功的六个任务上,弱模型直接写 RTL 只达到强模型 0.40 倍的加速,走 HLS 则达到 0.95 倍。HLS 把设计知识蒸馏进了抽象层,显著抹平了模型能力差距——这对工程团队的选型意义很大。
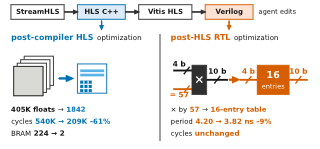
SHL2 则展示了编译器启发式的局限。 StreamHLS 生成了四个局部数组,总计 405K 个浮点值,还多插了一级填充拷贝。这是 source-to-source 编译器的通病:方向对了,代码生成靠固定启发式,跨设计泛化不了。Agent 在 HLS 层把存储收敛到两行 line buffer 加一个 3×3 窗口(共 1842 个浮点值),删掉填充级,周期数从 539726 降到 209297,Block RAM 从 224 块降到 2 块。到了 RTL 层,Agent 又发现两个乘法器的第二操作数在生成的 RTL 里已经是常数,替换成查找表,时钟周期从 4.20ns 降到 3.82ns,周期数不变。编译器走大步,Agent 补碎步,分工很清楚。
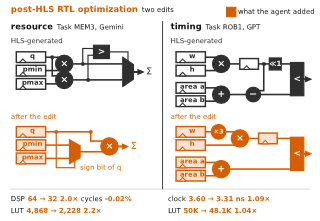
MEM3 和 ROB1 的 RTL 细化案例同样漂亮。 MEM3 要对 32 个向量元素算 max(q·min, q·max),Vitis HLS 每个元素放两个乘法器再选大值,共 64 个 DSP。Gemini 看出 q 的符号本身就决定了该选 min 还是 max,把选择移到乘法之前——DSP 从 64 降到 32,LUT 从 4868 降到 2228,周期数几乎不动,时钟周期还从 3.14ns 改善到 2.83ns。ROB1 上,生成的 RTL 把 50% IoU 比较实现为 union < 2·intersection(其中 union = a+b−intersection),关键路径上压着一个乘法器、33 位减法器和比较器。GPT 把等价条件改写成 a+b < 3·intersection,减法器出径,时钟周期从 3.60ns 到 3.31ns,达标 3.33ns 的目标,周期数不变,LUT 还省了 4%。这类资源映射、算术结构、时序上的机会,只有 RTL 生成之后才暴露出来。
推荐流程与产业信号
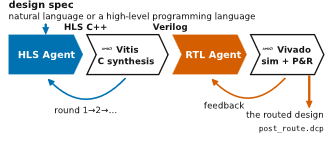
论文最终推荐的 AHRR 流:从自然语言或高级可执行语言的设计规格出发,Agent 生成优化的 HLS C/C++,经 HLS 工具生成 RTL 后,同一 Agent 再在 RTL 层检查并细化时序、存储和数据通路决策。两段互补——HLS 侧提供架构杠杆,RTL 侧提供周期精确的控制,2.31 倍到 2.62 倍的递进就是这个互补性的量化体现。
结论部分还有一个判断我认同:HLS 方法论多年来落地不顺,卡在两个障碍上——现有 RTL 流程的路径依赖,以及人很难读懂 HLS 生成的 RTL、做周期级修改。这两个障碍对 Agent 都不成立:Agent 没有方法学惰性,结果好就用;而读懂并细化编译器生成的 RTL,恰恰是它们已经展现出的能力。Agent 可能反过来成为 HLS 和其他高阶设计方法普及的推手。
论文收尾提到,研究完成之际,OpenAI 在 2026 年 8 月发布的 Jalapeño 芯片已经采用了 AI Agent + HLS 的设计方式(设计流程细节尚未公开)。学术界的系统验证和工业界的实际采纳指向了同一个方向。
总结评论
这篇论文把"抽象层级"从口味之争变成了可量化的工程决策:HLS 承担架构探索并抹平模型能力差距,RTL 细化回收编译器启发式漏掉的局部优化,两层缺一不可。做 EDA 和芯片研发的团队,应该开始认真评估"Agent + HLS + RTL 细化"这类混合流的工具链建设,而不是押注单一抽象层。隐忧也有——基准全部在 FPGA 上,ASIC 下的 PPA 权衡未必同构,且评估 harness 对仿真时间的依赖会直接限制 Agent 的发挥空间。
参考来源
- arXiv: Can Agents Design Better Chips with a Higher Level Abstraction?