
Jev火了:这个AI模型不聊天,只负责替你做判断
最近,一个不太像传统大模型的产品开始刷屏:Jev。
它不陪你聊天,不帮你写文章,也不负责把一件事解释成几千字。你给它一段状态信息,再提出几个边界清楚的问题,它返回的是选项、分数、概率和置信度。
实际情况是,它不负责说什么,只负责该怎么判断。
大模型最浪费的地方,可能是做完判断还要解释
一个Agent执行任务时,往往要经过很多判断:用户是在咨询还是投诉?这条请求该调用搜索还是数据库?一篇文章能不能直接发布?当前步骤应该继续,还是交给人工?
这些问题并不一定需要一篇完整答案。很多时候,系统真正需要的只是:
选择:转人工
置信度:90%
传统做法通常是调用一次大语言模型,让它阅读上下文、分析原因、组织语言,再输出一段JSON。程序还要解析这段文字,处理模型漏字段、格式错误,甚至临时创造不存在选项的情况。
Jev走的是另一条路:把判断本身变成模型的主要输出。它不再先生成一段人类读得懂的话,再让程序从中提取结论,而是直接返回软件可以消费的结构化结果。
这不是把普通大模型“调得更快”,而是从任务定义上砍掉了文本生成这一层。
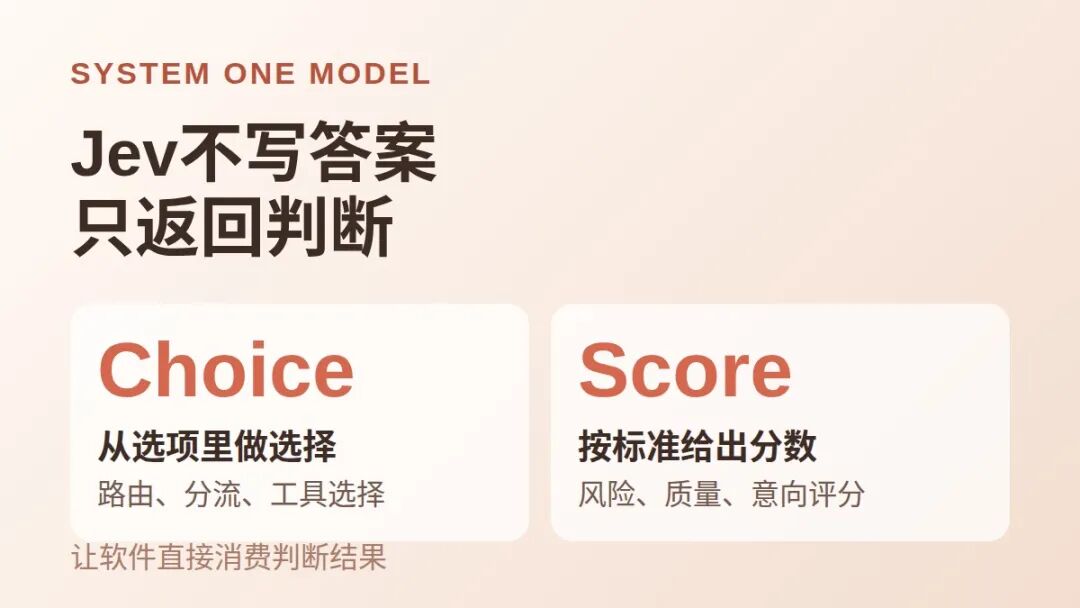
Jev的答案不是一段话,而是三种判断
TypeSafe AI把Jev归入System One Model,面向的是软件内部的决策。它目前的核心问题大致分成三类。
第一类是Choice,从一组固定选项中做选择。比如判断客服消息应该进入售前、售后、退款还是人工队列。
第二类是Score,按照一套标准打分。比如给文章的发布风险、销售线索的意向程度,或者一段代码的审核优先级评分。
第三类是Noul,可以理解为对某个判断给出概率结果,例如 这段内容是否包含敏感信息。
它的关键不只是返回一个结论,还会给出概率和置信度。程序因此可以设置阈值:高于90%自动执行,60%到90%增加复核,低于60%转人工。
这让人机协作从一句模糊的建议,变成可以写进业务代码的分支。
它为什么快,但又不是更强的通用模型
传统语言模型需要逐个生成Token。即使只想得到通过或不通过,模型仍然需要处理上下文、组织解释、生成格式。
Jev的设计目标更窄:同一份状态可以同时交给多个问题评估,问题之间相互独立,结果直接返回。官方文档把它描述为并行判断,而不是连续生成一串文本。
TypeSafe公开介绍中还提到,Jev使用新的模型架构、并行采样和RLCD,也就是面向校准决策的强化学习。官方页面展示过193.6倍速度和444.6倍成本差异,但这属于厂商基于特定System One工作流给出的对比,不应直接理解成所有任务都能获得同样结果。
官方模型文档显示,Jev 1.13的输入是文本或结构化文本,单次请求的状态和问题共享上下文预算;它不接受图片、音频和视频,也不负责开放式长文本生成。
所以,Jev不是更强的ChatGPT,而是一个被刻意限制了能力边界的判断层。
真正的难点,是把问题问得足够小
Jev最适合的不是 请判断这家公司有没有前途 这种大问题,而是拆开的原子问题:市场需求是否明确?技术路线是否可行?差异化是否存在?商业模式是否能产生收入?
每个问题都可以单独评分,再由程序自己设定权重。
这点很重要。Jev不会替开发者完成全部思考,它要求业务方先把判断标准说清楚。问题越宽泛,结果越容易变成看似精确、实际难以复核的分数。
它的置信度也不能直接等同于正确率。一个模型可以非常确定地判断错误。Jev解决的是软件如何利用不确定性,而不是保证每次判断都正确。
它应该放在Agent的哪个位置
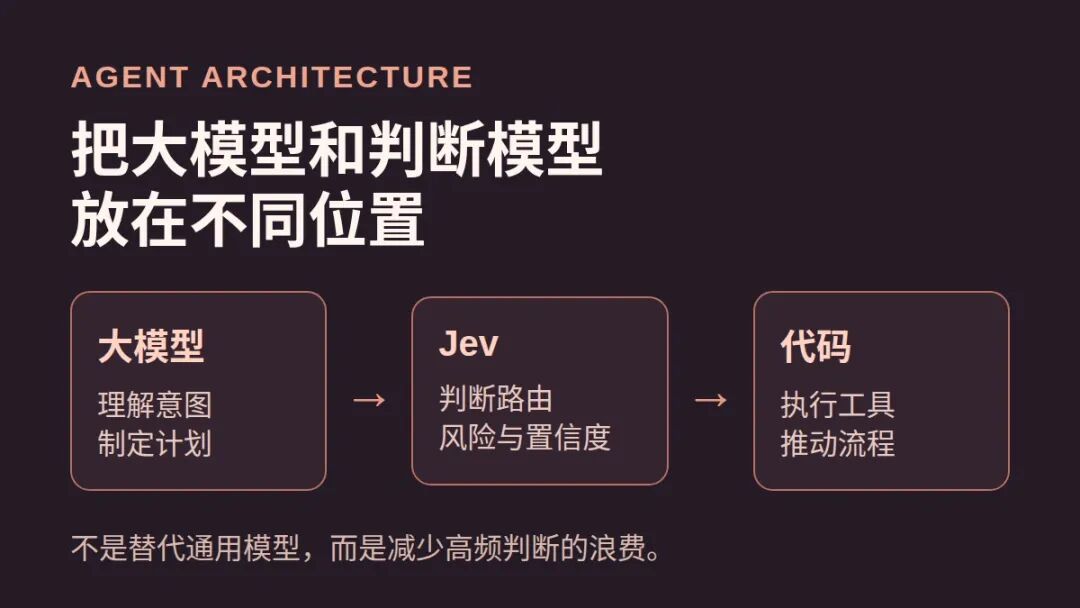
更合理的组合不是让Jev替代大模型,而是让不同模型各做擅长的事:
大模型:理解用户意图,制定任务计划
Jev:判断路由、风险、是否继续、是否转人工
代码:执行工具和业务流程
在客服系统里,它可以负责分流;在内容系统里,它可以负责发布前风险初筛;在Agent里,它可以判断下一步调用哪个工具;在自动化流程里,它可以决定哪些请求可以直接执行,哪些请求必须交给人。
如果任务需要写文章、解释概念、整理复杂背景,通用大模型仍然更合适。如果任务每天要做成千上万次明确判断,Jev这类模型才可能体现价值。
未来的AI系统可能不会只依赖一个万能模型,而是形成更清晰的分工:语言模型负责沟通,推理模型负责复杂分析,代码模型负责实现,判断模型负责分流与决策。
Jev现在的关键价值,不是它能不能取代大模型,而是它提出了一个很实际的问题:软件里的每一次判断,真的都需要一个会聊天的大模型吗?