
AgentHarness 完整指南:AIAgent的基础设施层如何工作
关于理解 Agent Harness,基本上这篇文章涵盖了你需要知道的一切!
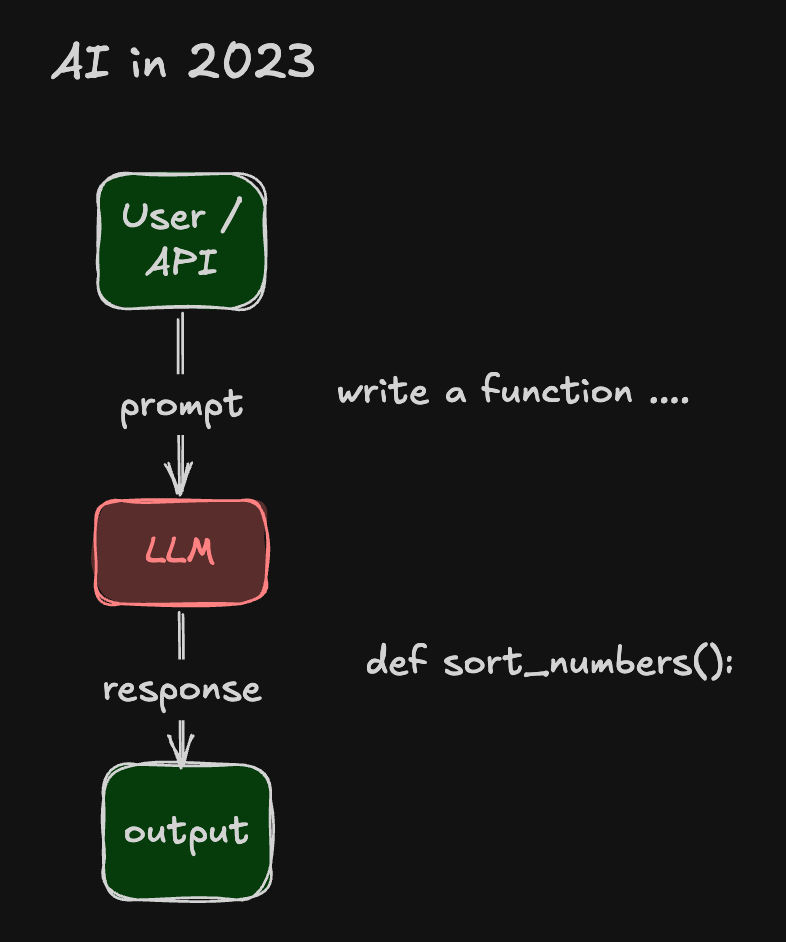
早在 2023 年我们开始与 LLM 交互时,一切都很简单。我们只需要提出问题,然后得到答案。像我这样的程序员通常会提出这样的问题:“用 Python 编写一个对数字数组进行排序的函数”。我们几乎可以实时得到答案,而模型也不会进入_思考_模式!因为当时的模型只是基础的 LLM,还没有如今 agentic 系统中的各种复杂能力。
我所说的各种复杂能力,指的是 tools、memory、skills 以及更多在 2026 年已经不可或缺的能力。正是这些附加组件,让一个简单的 LLM 变成了 AI agent。
一边是 Agentic 竞赛
在 2023 年和 2024 年,竞争的焦点是模型。OpenAI 拥有最优秀的通用模型之一,而 Anthropic 则拥有最优秀的 coding 模型之一。竞争者不断构建模型,以在 MMLU、SWE-bench 等标准 benchmark 中击败其他模型。
模型竞赛开始趋于饱和,reasoning 和 context 等能力开始出现。当我们提出问题时,聊天 UI 中开始出现类似“thinking...”的提示。人们开始好奇,当 UI 中出现“thinking...”时,底层究竟发生了什么。
Agent 竞赛开始了……
另一边是用户的野心
随着模型变得更加复杂,我们作为用户也变得更加有野心。我们不再只是提出问题,而是开始分配任务。为了回答用户的问题,这些任务需要 agent 设定目标、使用 browser 等外部工具、从 memory 中回忆过去的对话和事实,以及执行更多操作。
我至今仍清楚地记得,自己曾经截取 Amazon landing page 的屏幕截图,将其作为输入提供给一个 coding model,并要求它构建一个模仿该截图的网站(一次完成全部工作)!它确实生成了一个相似的 UI,但想象一下,一个用户实际上希望 UI、backend、infrastructure 以及周边的一切都能一次性完成配置。
这就是我们在 2026 年所处的位置!
所以如今,我会输入这样的 prompt:“解决 GitHub issue #122 中报告的 bug”。这样的 prompt 要求 LLM 执行更多操作。这个看似简单的 prompt 中其实包含了多个步骤。2023 年的 LLM 可能会回答:“抱歉,我无法访问你的 GitHub repo。”
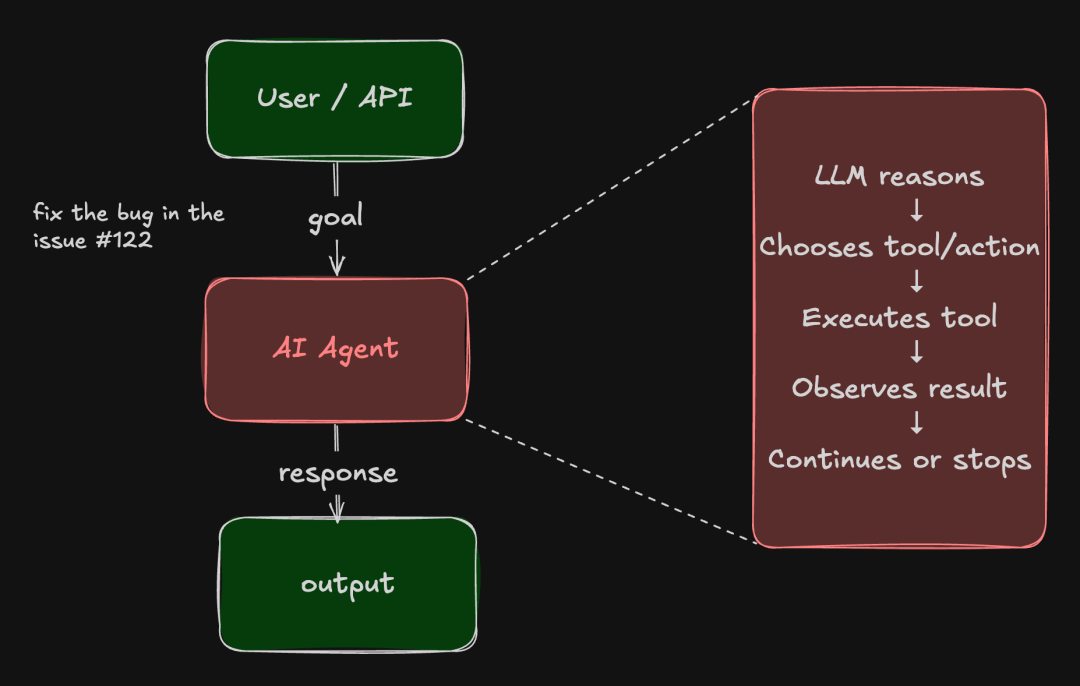
然而,一个拥有良好 Agent Harness 的 LLM 则会进入_思考_模式。它会经历 reasoning → planning → choose tool/action → execute tool → observe result → repeat or stop。
我明白了,但 Agent Harness 到底是什么?
如果我们在 LLM 外围封装了 context、tools、memory 等如此多的附加组件,那么就应该有一种高效的方式来_工程化_这些组件与 LLM 的交互。而 Agent Harness 就是对这种机制的称呼。正式定义如下:
Agent harness 是包裹、控制、测试、监控和评估 AI agent 的基础设施层。
简单来说,它就是围绕 LLM 构建的“操作系统”。
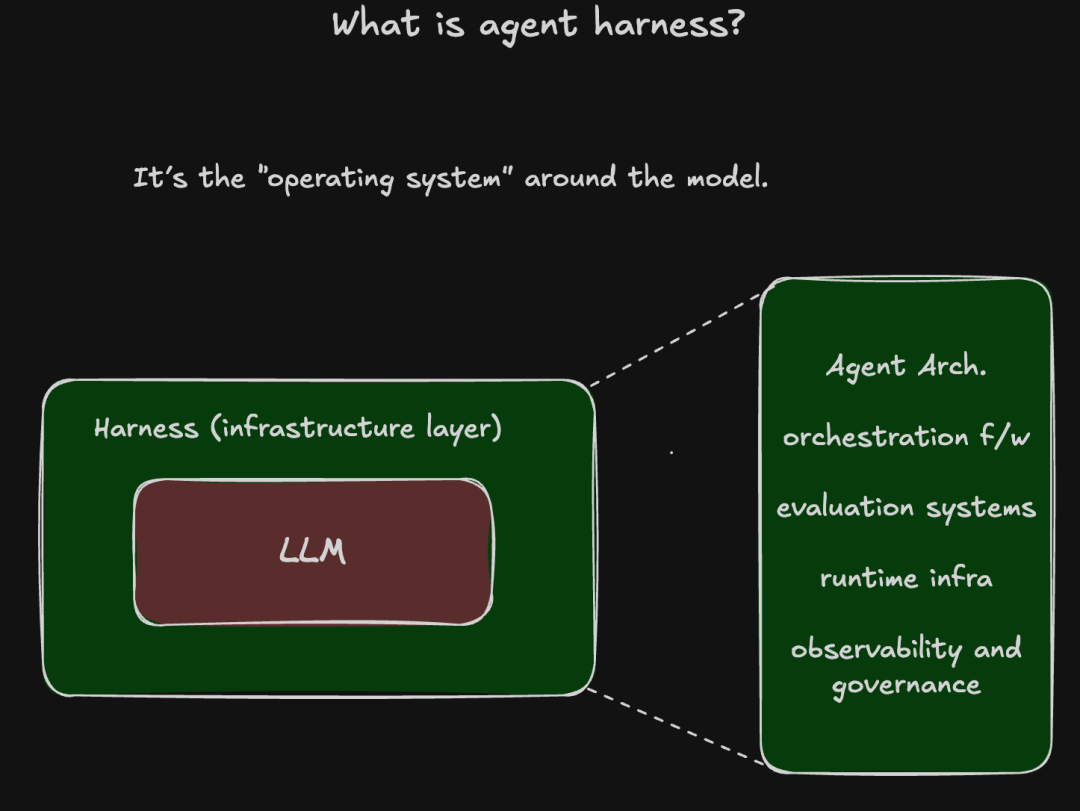
作为包裹在 LLM 外围的基础设施层,harness 由 agent architecture、用于编排 harness 内多个 sub-agent 的 orchestration framework、用于评估 agent 输出的 evaluation system、runtime infrastructure、security、governance,以及最后但同样重要的 observability 组成。
为什么需要 agent harness?
随着我们为 AI agent 设定越来越大的目标,AI agent 执行这些任务所需的时间也在不断增加。下面这张来自 Anthropic 的有趣图表清楚地说明了这一点。
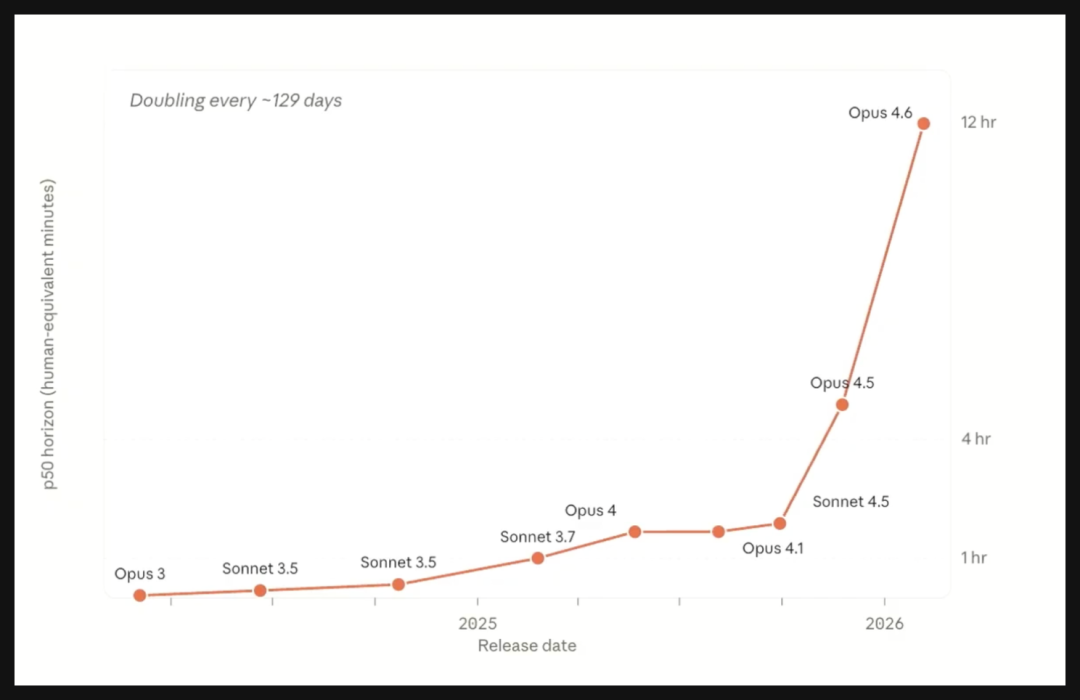
就在 2025 年,也就是一年前,agent 执行一项给定任务通常需要大约一小时。但如今,这个时间已经徘徊在 12 小时左右!这些 long-horizon 任务会带来一些问题。它们可能无限循环、幻觉式地调用工具、破坏 agent state、超出 token budget、丢失 context、重试错误操作、静默失败、滥用权限,甚至忘记目标。
这些都是代价高昂的问题。想象一下,一个 AI agent 进入了 12 小时的无限循环。这个循环消耗的 token 和 compute 将会非常庞大。我们可以在 harness 中为任意给定任务设置 budget,从而解决这个问题!这个 budget 可以是时间、token 或 compute budget。
更严重的是安全问题。想象一下,LLM 选择使用了一个具有破坏性的工具,例如删除文件系统中所有文件的工具。通过 harness,我们可以对 LLM 能够访问的内容进行细粒度控制!
简而言之,正是 harness 让你能够控制 agent,从而让你确信 agent 正在执行你希望它执行的操作!
Agent harness 的组件
无论我们如何称呼一个 harness,它都应该属于以下组件之一。
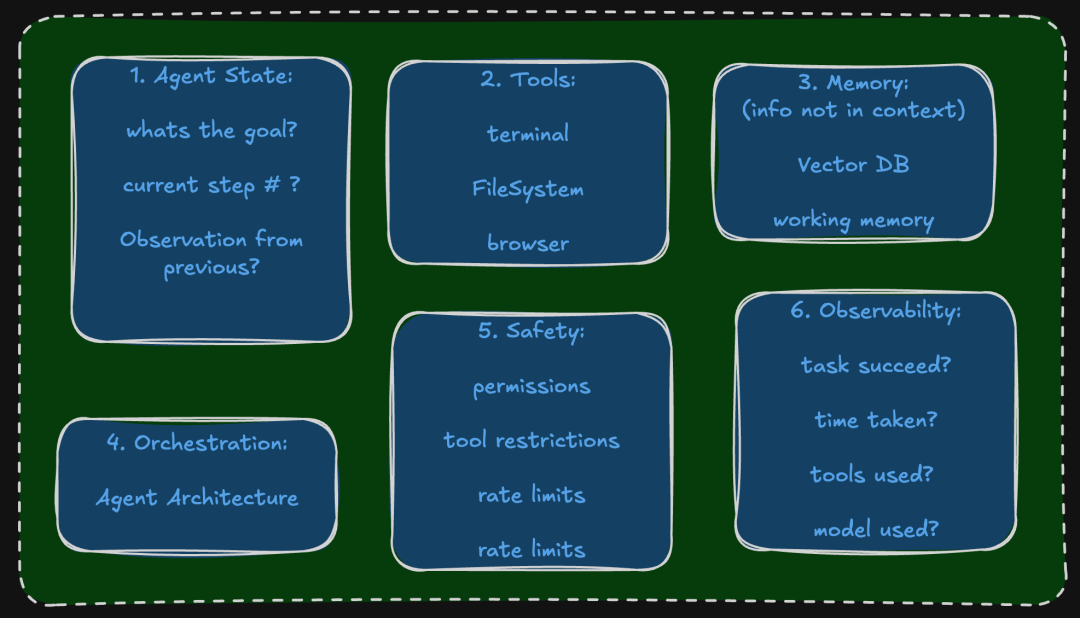
Agent state。 回答这样的问题:我现在在哪里? 它会跟踪当前任务、步骤、观察结果、决策等信息。例如,如果 agent 的计划中包含 4 个步骤来完成某个目标,那么 state 会跟踪哪些步骤已经完成、当前状态是什么,以及还有哪些工作需要完成。
Tools。 回答这样的问题:我能做什么? 它为 agent 提供 code execution、browser、APIs、databases、shell 等能力。在所有组件中,tools 是最直观的组件。例如,对于 coding agent 而言,read_file function 可以是最基本的工具之一。
Planning。 回答这样的问题:我应该做什么? 它决定_接下来应该发生什么_,并创建或修订计划。在 coding task 中,planning component 可以提出一个包含 4–5 个步骤的序列,这些步骤需要按顺序完成,才能结束任务。
Memory。 回答这样的问题:我知道或记得什么? 它会跨步骤或 session 存储和检索信息。每当我们从 Vector DB 中检索一些信息并放入 context 时,可能都值得对这些内容进行总结,以优化 context,进而优化 working memory。这些工作需要由 harness 的 memory component 负责管理。
Orchestration。 回答这样的问题:_我该如何执行这个过程?_它控制 execution loop、tool calls、retries、sub-agents、parallelism、handoffs 等。例如,假设 agent 正在处理一个购买任务。可以调用一个 payment sub-agent,同时由 inventory agent 并行执行更新库存等其余操作。或者,inventory agent 也可以在 payment agent 成功完成任务后,按照顺序执行。
Context Management。 回答这样的问题:LLM 现在应该看到什么? **** 它决定在每个步骤中将哪些信息放入 LLM 的 context window。
Safety & Governance。 回答这样的问题:我被允许做什么? Permissions、sandboxing、approval gates、policies、limits、authentication 等都属于这一组件。即使模型可以使用一个非常强大的工具,它究竟能够执行到什么程度?例如,即使允许模型在 coding task 中编辑文件,也应该确保它不能删除文件系统中的全部或部分文件。
Observability & Evaluation。 回答这样的问题:它真的成功了吗?它会追踪发生了什么,并衡量 agent 是成功、失败,还是违反了约束。模型完成给定任务所付出的各种代价都会在 observability 中被跟踪。例如,模型可能只需要使用 10 个工具中的 3 个就能完成任务。跟踪这些工具的使用方式是有价值的。如果它们失败了,原因是模型缺少其工具集合中的某些工具,还是因为 context 中缺少某些数据?
而 harness engineering 则是一门新兴学科,研究如何设计、实现和执行上述组件,使 agent 发挥最佳表现。
一个实际的 coding agent 示例
现在我们已经了解了不同的组件,接下来看看这些组件如何在一个简单的 coding task 中相互交互。
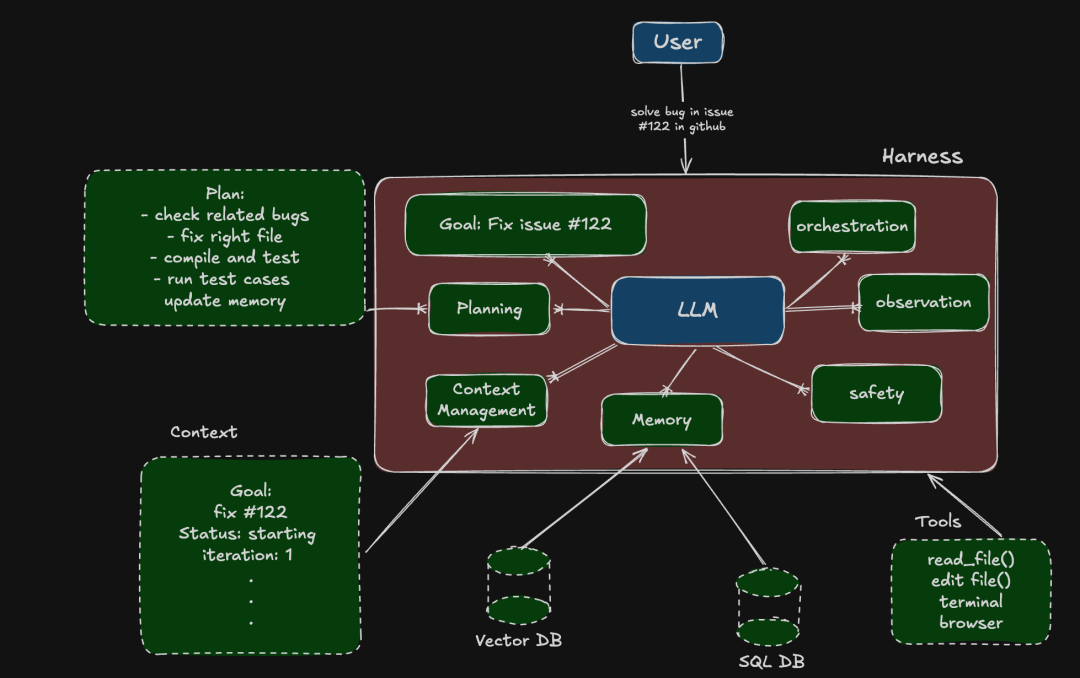
假设我们已经为一个 coding agent 实现了 harness。用户发送了以下 prompt:
解决 github issue #122 中的 bug
请注意,这并不是一个简单的“向我解释……”类型的 prompt,而是真正的任务。要完成这个任务,我们需要 planning、tool use、memory 以及更多 agentic 能力。
下面是实现该 harness 的一种合理方式:
首先,用户的输入会进入 context。模型开始进行 reasoning,并提出一个目标。在目标完成之前,它会一直保留在 context 中。
然后,它决定对任务的执行进行“plan”。它提出了如下计划:检查相关 bug、修复正确的文件、编译并测试、运行 test cases,以及更新 memory。
在执行的第一步中,harness 会从 Vector DB 中检索一些 memory,其中包含与当前任务相关的历史 bug 详情。它找到与 authentication 相关的信息,并将其作为最匹配的结果放入 context。
然后,模型利用 context 中的信息,决定退出 auth.py 文件以修复 authentication bug。不过,这需要使用 read_file 和 write_file tools。模型使用这些 tools 编辑文件并保存。
模型决定通过 terminal 测试代码变更。现在需要使用 terminal tool,而该工具位于模型可用的 tools 集合中。(harness 确保模型拥有访问 terminal 和文件的适当权限)
模型继续执行计划中的下一步,并运行 test cases。为此,它需要访问更多 tools。此外还要注意,整个过程中每一步都会更新 context,以确保模型能够跟踪当前所在位置以及剩余的工作。
在整个过程中,observability component 会确保所有内容都被记录下来。日志包括所使用的 tools、任务耗时、使用的 memory、中途发生的任何失败等。
请注意,我们还没有涉及 evaluation,而 evaluation 本身就是一个庞大的主题。它不只是衡量准确性,还可以根据 agent 的实际行为涵盖多个指标。
那么,我们将走向何方?
如今 agentic AI 面临的最大挑战之一是 long-horizon reliability。随着运行数小时、甚至数天的 agent 成为现实,我们需要确保运行过程绝对可靠。如果 agent 陷入无限循环或进入某种损坏的 state,我们最终可能会浪费资源并危及安全。
接下来,随着我们围绕模型构建更加复杂的 harness,evaluation 也会变得相当困难。每项任务都会留下包含大量数据的 traces,例如使用的 memory;我是否应该更换模型,还是改进 harness?我是否应该添加更多 tools,还是修复现有 tools?
随着社区积极构建复杂的 harness,这些问题正在不断出现。
让我们拭目以待,看看接下来会走向何方。下一篇文章再见……