
AI、机器学习、深度学习、大模型到底什么关系:用一段文本分类代码理清边界
最近自己准备系统学习大模型,这个算是自己的学习笔记吧,希望对大家有帮助。
如果你是刚接触 AI 的 Python 开发者,经常在文章里看到"人工智能""机器学习""深度学习""大模型"这几个词被随意混用,甚至有人把它们当成同义词替换使用——这篇文章用一个具体任务把它们的关系理清楚。
一句话结论:这四个词不是并列关系,而是一层套一层的包含关系——AI 是最外层的目标,机器学习是实现 AI 的一种主流方法,深度学习是机器学习里的一个分支(用神经网络做拟合),大模型则是深度学习发展到一定规模后出现的一类特殊产物。
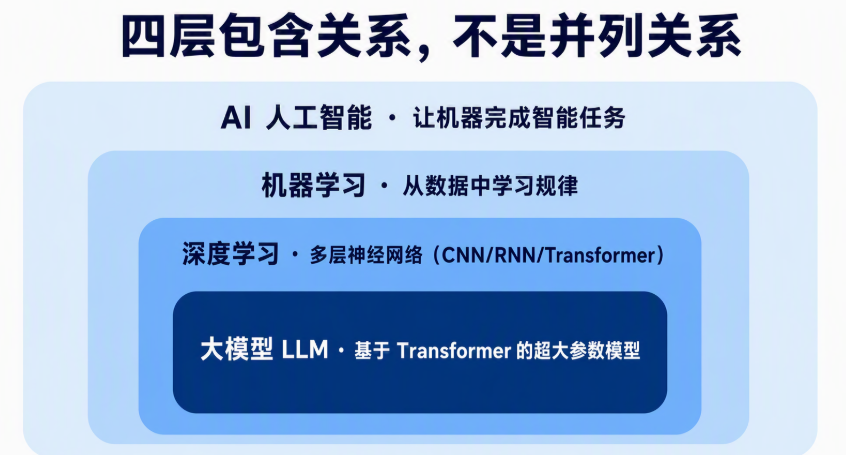
用同一个任务——"判断一句话是正面评价还是负面评价"——分别用规则、传统机器学习、深度学习、大模型这四种方式实现,你会直观看到它们之间的层级关系:
# 方式一:AI,但不是机器学习——纯规则判断
def rule_based_sentiment(text: str) -> str:
    negative_words = {"差", "糟糕", "失望", "垃圾"}
    return "负面" if any(w in text for w in negative_words) else "正面"

print(rule_based_sentiment("这个产品质量太差了"))  # 负面
这段代码是 AI(因为它在完成一个"看起来需要智能"的任务),但不是机器学习——因为规则是人写的,不是从数据里学出来的。这正是很多人对"AI"这个词最大的误解:AI 的范围远比机器学习大,写规则、写搜索算法、写专家系统都属于 AI,只是现在"AI"在日常语境里几乎被"机器学习/深度学习"垄断了。
那机器学习、深度学习、大模型之间的边界具体在哪里?往下看。
为什么会混用:四个词其实描述的是四个不同的问题
先把关系放在一张表里,再逐个解释每一层解决的具体问题:
| 概念 | 解决什么问题 | 典型方法 | 是否需要从数据里学习 |
| AI(人工智能) | 让机器完成"看起来需要智能"的任务 | 规则、搜索、机器学习等,方法不限 | 不一定 |
| 机器学习 | 让机器从数据中自动学出规律 | 线性回归、决策树、SVM、神经网络等 | 是 |
| 深度学习 | 用多层神经网络处理复杂、非结构化数据 | CNN、RNN、Transformer | 是,且依赖大量数据 |
| 大模型(LLM) | 用海量数据训练出通用的语言/多模态能力 | 基于 Transformer 架构,参数规模极大 | 是,且训练成本极高 |
AI 是目标,机器学习是手段之一,深度学习是机器学习里专门处理图像/文本/语音这类复杂数据的手段,大模型是深度学习在"规模"这个维度上走到某个阈值后的产物。 它们不是四个平行的技术,而是一层比一层具体、范围一层比一层小的子集。
用集合的写法表示这个关系会更直观:
常见的误用方式是把这个包含关系当成了并列关系,比如说"这个项目用了 AI 和机器学习两种技术"——这句话本身逻辑上就有问题,因为机器学习本来就是 AI 的一种实现方式,不存在"AI 和机器学习"并列使用的说法,只能说"这个项目用机器学习方法来实现 AI 任务"。
怎么用代码看清每一层的边界
延续开头的文本分类任务,把剩下三种实现方式补全,观察每一层相比上一层到底多做了什么。
第二层:传统机器学习——从数据里学出规则,而不是人写规则
规则方法最大的问题是:负面词表永远列不全,"这个产品一言难尽"这种句子,规则完全判断不出来。机器学习的思路是让计算机从大量标注好的样本里,自己找出"哪些词组合倾向于负面":
from sklearn.feature_extraction.text import TfidfVectorizer
from sklearn.linear_model import LogisticRegression

# 示例训练数据,真实项目需要成百上千条标注样本
texts = ["质量很好,很满意", "太差了,很失望", "物流很快,不错", "垃圾产品,别买"]
labels = ["正面", "负面", "正面", "负面"]

vectorizer = TfidfVectorizer()
X = vectorizer.fit_transform(texts)  # 把文本转成数值特征

clf = LogisticRegression()
clf.fit(X, labels)

new_text = vectorizer.transform(["一言难尽,不推荐"])
print(clf.predict(new_text)) # 模型自己判断,而非人写规则,输出不靠谱关键区别:TfidfVectorizer 把文本变成数值特征(词频统计),LogisticRegression 从这些数值特征和标签之间自动学出权重。规则方法里"负面词表"是人定义的,这里"哪些词权重高"是数据训出来的——这就是"机器学习"和"AI 但非机器学习"的分界线。
但这套方法有个明显短板:TfidfVectorizer 本质是词频统计,不理解词语顺序和上下文语义,"这产品不差"和"这产品很差"里都有"差"字,传统机器学习很难区分否定语义。这正是深度学习要解决的问题。
第三层:深度学习——用神经网络理解语义和上下文
深度学习(尤其是 Transformer 架构)不再靠词频统计,而是通过神经网络学习词语在上下文中的语义表示。这里直接调用一个基于 BERT 的预训练模型来演示,不涉及从零训练:
from transformers import pipeline

# 需要提前安装 transformers 和对应的模型权重
# pip install transformers torch
classifier = pipeline(
    "sentiment-analysis",
    model="uer/roberta-base-finetuned-jd-binary-chinese",
)

result = classifier("这个产品不差,用起来还挺顺手")
print(result) # 模型能理解"不差"是双重否定表达正面,这个靠谱多了运行环境:Python 3.11、transformers 4.x、torch 2.x。这段代码是示意代码,具体模型下载和推理速度依赖你的网络环境和硬件,请按实际情况调整。
深度学习相比传统机器学习多做的事情:不再依赖人工设计特征(比如词频、词表),而是让神经网络自动学出"语义表示",能处理否定、语序、上下文这些传统机器学习很难建模的现象。代价是需要更多数据、更强算力,模型本身也更难解释。
第四层:大模型——同一个任务,换一种解决思路
到了大模型这一层,任务的解决方式发生了本质变化:你不再需要专门训练一个分类模型,而是直接用一个已经在海量文本上训练好的通用模型,通过描述任务的方式(Prompt)让它完成分类:
# 示意代码,需要替换为你实际使用的大模型 API
from openai import OpenAI

client = OpenAI()

def llm_sentiment(text: str) -> str:
    response = client.chat.completions.create(
        model="gpt-4o-mini",
        messages=[
            {"role": "system", "content": "判断输入文本的情感,只回答正面或负面},
            {"role": "user", "content": text},
        ],
    )
    return response.choices[0].message.content

print(llm_sentiment("一言难尽,不推荐"))这里最容易被忽略的一点是:大模型解决同一个分类任务,并没有"专门训练一个分类头",而是复用了模型在预训练阶段学到的通用语言理解能力,你只是通过 Prompt 告诉它当前想要什么输出格式。这也是为什么大模型常被称为"通用能力"而不是"专用模型"——前三层的方法都需要针对具体任务单独训练,大模型可以靠同一套参数处理分类、翻译、摘要等完全不同的任务。
边界:什么时候该停在哪一层
不是任务越复杂就应该无脑往"更大的模型"走,四层方法各有适用边界:
| 方案 | 适合场景 | 不适合场景 |
| 规则(AI,非ML) | 规则明确、变化少,比如敏感词过滤 | 规则难穷举、语义复杂的场景 |
| 传统机器学习 | 结构化数据、样本量有限(几百到几千条)、需要可解释性 | 图像、语音、复杂语义文本 |
| 深度学习 | 数据量大(几万条以上)、需要理解语义/图像特征 | 数据量不足、需要极强可解释性的合规场景 |
| 大模型 API | 任务多变、样本极少甚至零样本、追求开发效率 | 对响应延迟、成本、数据隐私极度敏感的场景 |
一个容易被忽视的判断标准是数据量和成本。如果手上只有几百条标注数据,大模型直接调用往往比自己训练深度学习模型效果更好、开发成本更低;但如果是高频调用、对延迟和成本极度敏感的场景(比如每天调用几千万次的风控规则),自己训练一个轻量级机器学习模型可能比调用大模型 API 更经济。
另外,大模型不是"深度学习的替代品",而是深度学习的一种极端形态——它本质上还是神经网络(大多是 Transformer 架构),只是参数规模、训练数据量达到了之前方法没有触及的量级。理解这个包含关系,比记住某个模型叫什么名字更重要,因为具体模型会不断迭代,但这个技术层级关系相对稳定。
小结
回到最初的问题:AI、机器学习、深度学习、大模型不是四个可以互换的词,而是一层套一层的技术栈。
- • 判断一个方案属于哪一层,看它是不是"从数据里学规律"(是否是机器学习),再看它是否用神经网络处理非结构化数据(是否是深度学习),最后看它是否具备跨任务的通用能力(是否是大模型)。
- • 实际选型时,先看数据量和场景约束,再决定用哪一层的方法,而不是默认"越新越好"。
下次看到一篇文章把"AI"和"机器学习"并列使用时,你可以想想它实际指的是哪一层。你在自己的项目里,处理过的具体任务更适合停在哪一层——规则、传统机器学习,还是已经需要上大模型了?
完整示例代码已整理为可运行项目;觉得有用的话,欢迎微信打赏鼓励一下,让我有动力继续输出这类实战内容。