
IROS 2026最佳移动操作论文候选:ULTRA让人形机器人根据目标行动

把一个箱子从地上搬到指定位置,对人来说,是一件普通的小事。对人形机器人来说,却是一道全身协作题。
走近时要调整站位,下蹲时要保持平衡,双手接触箱子后要稳稳托住,起身和移动时还要协调双腿、躯干与手臂。任何一个环节出错,都可能让箱子滑落,甚至让机器人失去平衡。
一种办法是提前准备好完整的参考动作,让机器人逐帧跟踪。但如果只给出箱子的目标位置,中间的动作该如何产生?
能不能用同一个控制器,既在有参考动作时精确跟踪,也在没有参考动作时,根据感知和任务目标完成操作?
这正是 ULTRA 想解决的问题。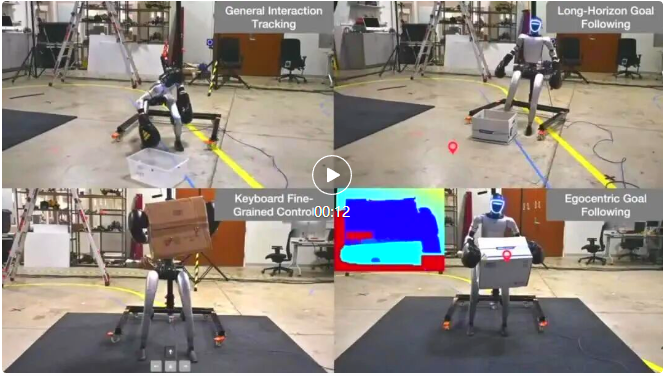
我们提出了 ULTRA(Unified Multimodal Control for Autonomous Humanoid Whole-Body Loco-Manipulation),并在 Unitree G1 人形机器人上进行了验证。该工作已被 IROS 2026 接收,并入选 IROS 2026 Mobile Manipulation Paper Award 候选论文。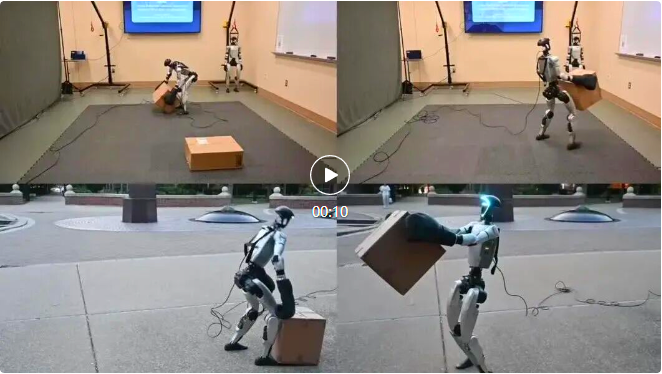
一个控制器,接受不同「详细程度」的指令
我们先区分两种控制需求。
动作跟踪提供一套逐帧参考:身体怎么动、物体如何移动,都有明确的轨迹。机器人要尽量准确地复现这些动作。
目标驱动控制则只规定希望达到的结果,例如物体的目标位置与朝向,把中间动作留给控制器生成。这就是「稀疏目标」:它没有逐帧规定机器人怎样迈步、弯腰和抬手。
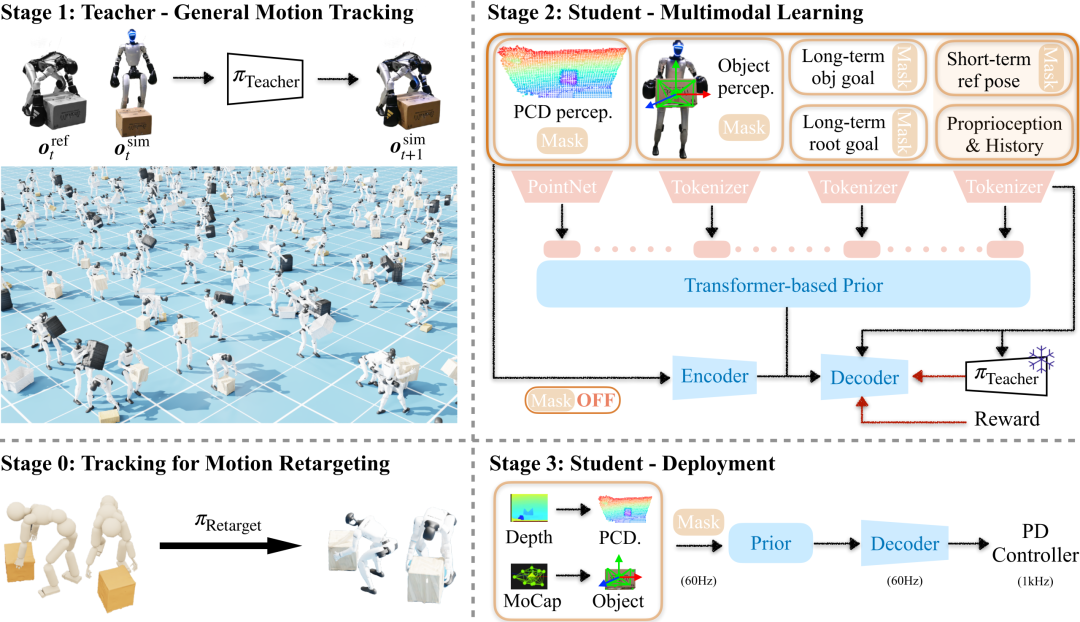
ULTRA 将这些需求放进同一个控制框架:这些能力由同一组策略参数实现。 控制器还可以使用不同的感知输入,包括外部动作捕捉系统提供的物体状态,以及机器人自身深度相机获得的信息。
这里的「自主」,具体指在给定目标和可用感知的条件下生成动作。目标仍需外部提供,而机器人不再需要别人提前规定每一帧应该怎么动。人的动作不能「复制粘贴」,先让训练数据符合物理
这些全身协作能力从哪里来?一个重要来源是人体运动捕捉数据。
但人和机器人的身体比例、关节结构不同。同样一个搬箱子的动作,直接映射到机器人身上,可能出现手够不到箱子、脚底打滑,或接触关系不合理的问题。姿态看起来相似,并不代表动作能稳定执行。
ULTRA 为此引入了物理驱动的神经动作重定向。
可以把它理解为:让机器人在物理仿真中学习如何「用自己的身体」完成示范中的动作。通过强化学习,重定向策略在尽量保留人体动作与操作意图的同时,考虑动力学和接触约束,生成在仿真中可执行的机器人轨迹。
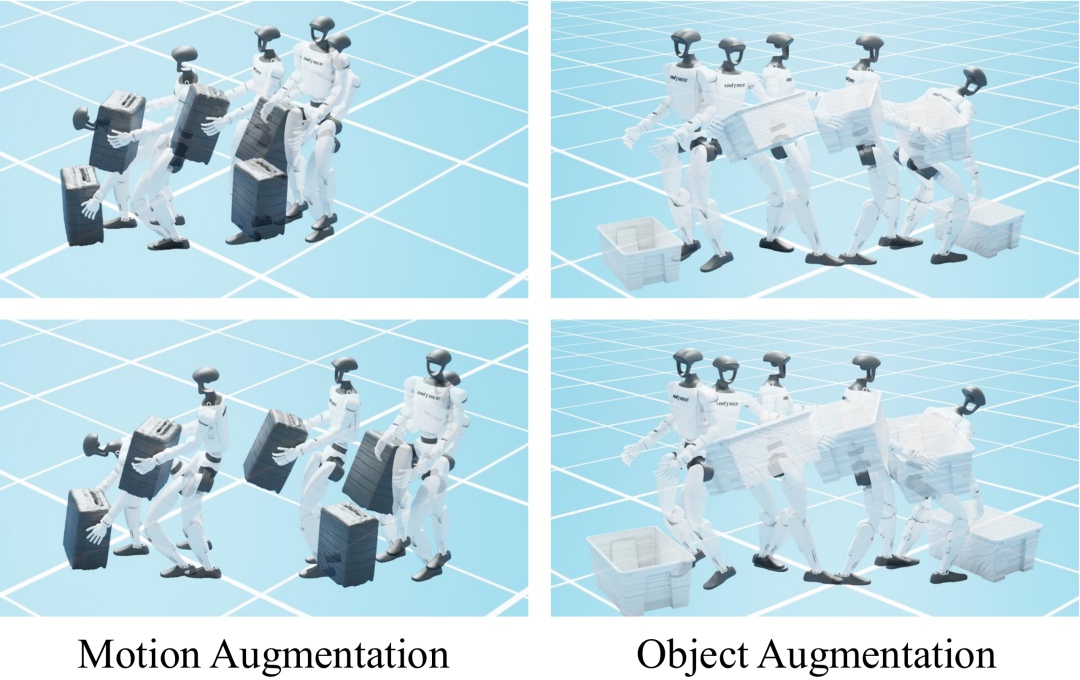
训练完成后,同一个重定向策略可以处理新的动作,并通过调整运动范围和物体尺寸扩充数据,无需为每条新轨迹重新训练一套策略。
这样,人体动作就转化为后续控制策略可以学习的训练材料。
下面的视频可以重点观察:同一个人体动作如何转化为机器人的全身运动,以及物体尺寸和运动范围变化后,手、脚与物体之间的配合如何调整。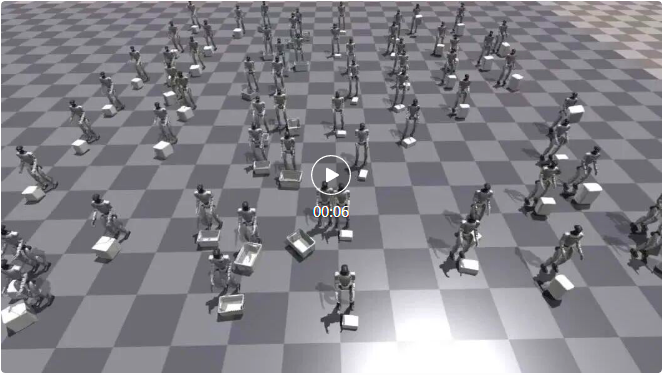
 从「会跟踪」到「会完成目标」,还需要两步学习
有了机器人动作轨迹,接下来要训练能在不同输入条件下工作的控制器。
第一步,通过教师策略传递控制能力。
训练时,我们先训练一个「教师策略」读取完整仿真状态和参考动作,学习如何协调身体、维持接触并完成操作。随后,通过策略蒸馏,将这些能力传递给面向实际部署的「学生策略」。
学生需要适应不同的信息组合:有时有完整参考,有时只有部分目标;有时能获得精确的物体状态,有时只能使用第一视角感知。
为此,ULTRA 使用输入可用性掩码。它像一张信息清单,告诉策略这一次哪些输入可用,让同一个模型根据现有信息生成动作。
第二步,通过强化学习微调,提高处理偏差的能力。
学会模仿之后,策略还需要面对示范之外的情况:初始位置有所变化,目标出现在新的位置,或执行过程产生偏差。
ULTRA 因此进一步在仿真中进行强化学习微调,让策略通过尝试和任务反馈,学习如何调整动作、接近目标。训练关注的范围也由复现参考动作,扩展到给定目标后的实际完成情况。
用机器人自己的视角,完成全身操作
控制之外,还有一个实际问题:机器人如何知道箱子在哪里?
在实验室里,外部动作捕捉系统可以提供精确的物体位置。但要走向更广泛的使用场景,机器人还需要利用自身传感器理解眼前环境。
ULTRA 支持第一视角深度感知:从深度图中提取物体点云,也就是用一组空间点描述物体的形状和位置,再将其提供给控制策略。机器人结合关节状态、身体姿态等本体感知,以及给定的任务目标,协调全身动作。
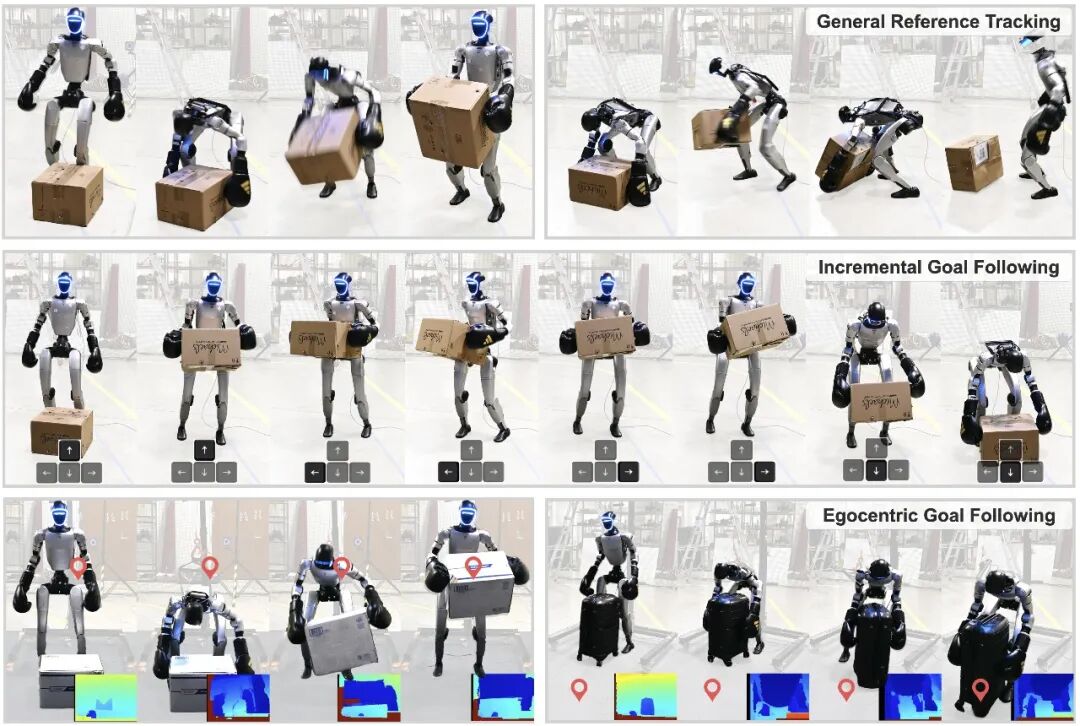
我们在 G1 上测试了完整动作跟踪、细粒度控制、较远期目标跟随,以及基于第一视角深度感知的目标驱动控制。使用第一视角点云输入时,我们发现强化学习微调将大幅提高成功次数。
把「中间怎么动」,交给控制器
人体运动数据提供了丰富的全身动作经验。ULTRA 尝试把这些经验转化为更灵活的控制能力,让一套策略能够接受不同详细程度的任务指令,并利用不同来源的感知信息行动。
从跟踪一条预先给定的轨迹,到在给定目标后生成动作,人形机器人需要跨过数据、控制与感知之间的多重障碍。ULTRA 展示了将这些环节连接起来的一条可行路径。
当人只需要指定希望达到的结果,机器人就必须学会补上「中间怎么动」。这正是 ULTRA 向前推进的一步。
论文
ULTRA: Unified Multimodal Control for Autonomous Humanoid Whole-Body
Loco-Manipulation
论文链接: https://arxiv.org/abs/2603.03279
项目主页: https://ultra-humanoid.github.io/
作者
何夏麟现为 UIUC 计算机科学博士生,本科毕业于上海交通大学 ACM 班。研究聚焦机器人学习与具身智能,主要关注人形机器人的全身控制、自主移动操作与 sim-to-real。相关工作发表于 RSS、CoRL、IROS 等会议,并入围最佳论文奖评选。
徐思睿现为 UIUC 计算机科学博士生,本科毕业于北京大学。研究聚焦具身智能与物理仿真,致力于让机器人理解、学习并掌握物理交互。以第一作者在 CVPR、NeurIPS、CoRL 等会议发表论文,多项工作入选 Oral、Spotlight 和 Highlight,并获研讨会奖项,入围最佳论文奖。