
Schematron V2:低成本实现前沿级 HTML 转 JSON 提取
今天,我们发布了 Schematron V2,这是专为 HTML 转 JSON 提取任务打造的新一代模型。如果你是新朋友:Schematron 是一组小型、专用模型,能把杂乱的 HTML 转化为干净的结构化 JSON,以远低于大型通用 LLM 的成本和延迟,提供前沿级的提取质量。
Schematron V1 已为众多在生产环境中处理 Web 级数据的企业提供大规模提取能力,我们很高兴推出性能更强的新变体。
Schematron V2 引入了两款新模型:Schematron V2 Small 和 Schematron V2 Turbo。Schematron V2 Small 在保持类似 3B 模型速度的同时,提取质量几乎比肩初代 8B 模型。Schematron V2 Turbo 专为极致吞吐量优化,在单块 H100 上每秒处理 4.14 个请求(较初代 Schematron 3B 提升 2.5 倍),且质量仍超越上一代 3B 模型。
我们使用 Inference 平台 训练 Schematron,这是我们专为训练高性能任务型 LLM 构建的 LLM 微调引擎。两款 Schematron 模型现均可通过 Inference.net 的 Serverless API 获取。
Schematron API
使用下方代码通过 Inference.net Serverless API 调用 Schematron V2。请确保设置好 INFERENCE_API_KEY 和 HTML 变量,后者填入你的 HTML 文档。
import os
from pydantic import BaseModel, Field
from openai import OpenAI

class Product(BaseModel):
    name: str
    price: float = Field(
        ..., description=(
            "Primary price of the product."
        )
    )
    specs: dict = Field(
        default_factory=dict,
        description="Specs of the product.",
    )
    tags: list[str] = Field(
        default_factory=list,
        description="Tags assigned of the product.",
    )

HTML = '<YOUR_HTML_DOC>'

client = OpenAI(
    base_url="https://api.inference.net/v1",
    api_key=os.environ.get("INFERENCE_API_KEY"),
)

resp = client.beta.chat.completions.parse(
    model="inference-net/schematron-v2-small",
    messages=[
        {"role": "user", "content": HTML},
    ],
    response_format=Product,
)

print(resp.choices[0].message.parsed.model_dump_json(indent=2))
import os
from pydantic import BaseModel, Field
from openai import OpenAI
class Product(BaseModel):
name: str
price: float = Field(
..., description=(
"Primary price of the product."
)
)
specs: dict = Field(
default_factory=dict,
description="Specs of the product.",
)
tags: list[str] = Field(
default_factory=list,
description="Tags assigned of the product.",
)
HTML = '<YOUR_HTML_DOC>'
client = OpenAI(
base_url="https://api.inference.net/v1",
api_key=os.environ.get("INFERENCE_API_KEY"),
)
resp = client.beta.chat.completions.parse(
model="inference-net/schematron-v2-small",
messages=[
{"role": "user", "content": HTML},
],
response_format=Product,
)
print(resp.choices[0].message.parsed.model_dump_json(indent=2))为什么这很重要
2025 年 9 月发布 Schematron V1 时,我们证明了小型专用模型在 HTML 抽取任务上可以媲美前沿 LLM,而成本只有后者的 1/40 到 1/80。社区的积极反馈印证了我们早已了解的事实:各家团队都在尝试大规模地从网页中抽取结构化数据,而成本一直是最大的瓶颈。
V2 进一步提升了质量与体积的比值。你能以 8B 模型的成本获得小模型的运行速度;而如果吞吐量是你的首要考量,Turbo 版本能让你以前所未有的速度处理页面。
质量:缩小与 8B 模型的差距
我们沿用了发布初版时采用的 LLM-as-a-judge 评估方法,由 GPT 5.4 对提取结果进行 1 至 5 分的评分。
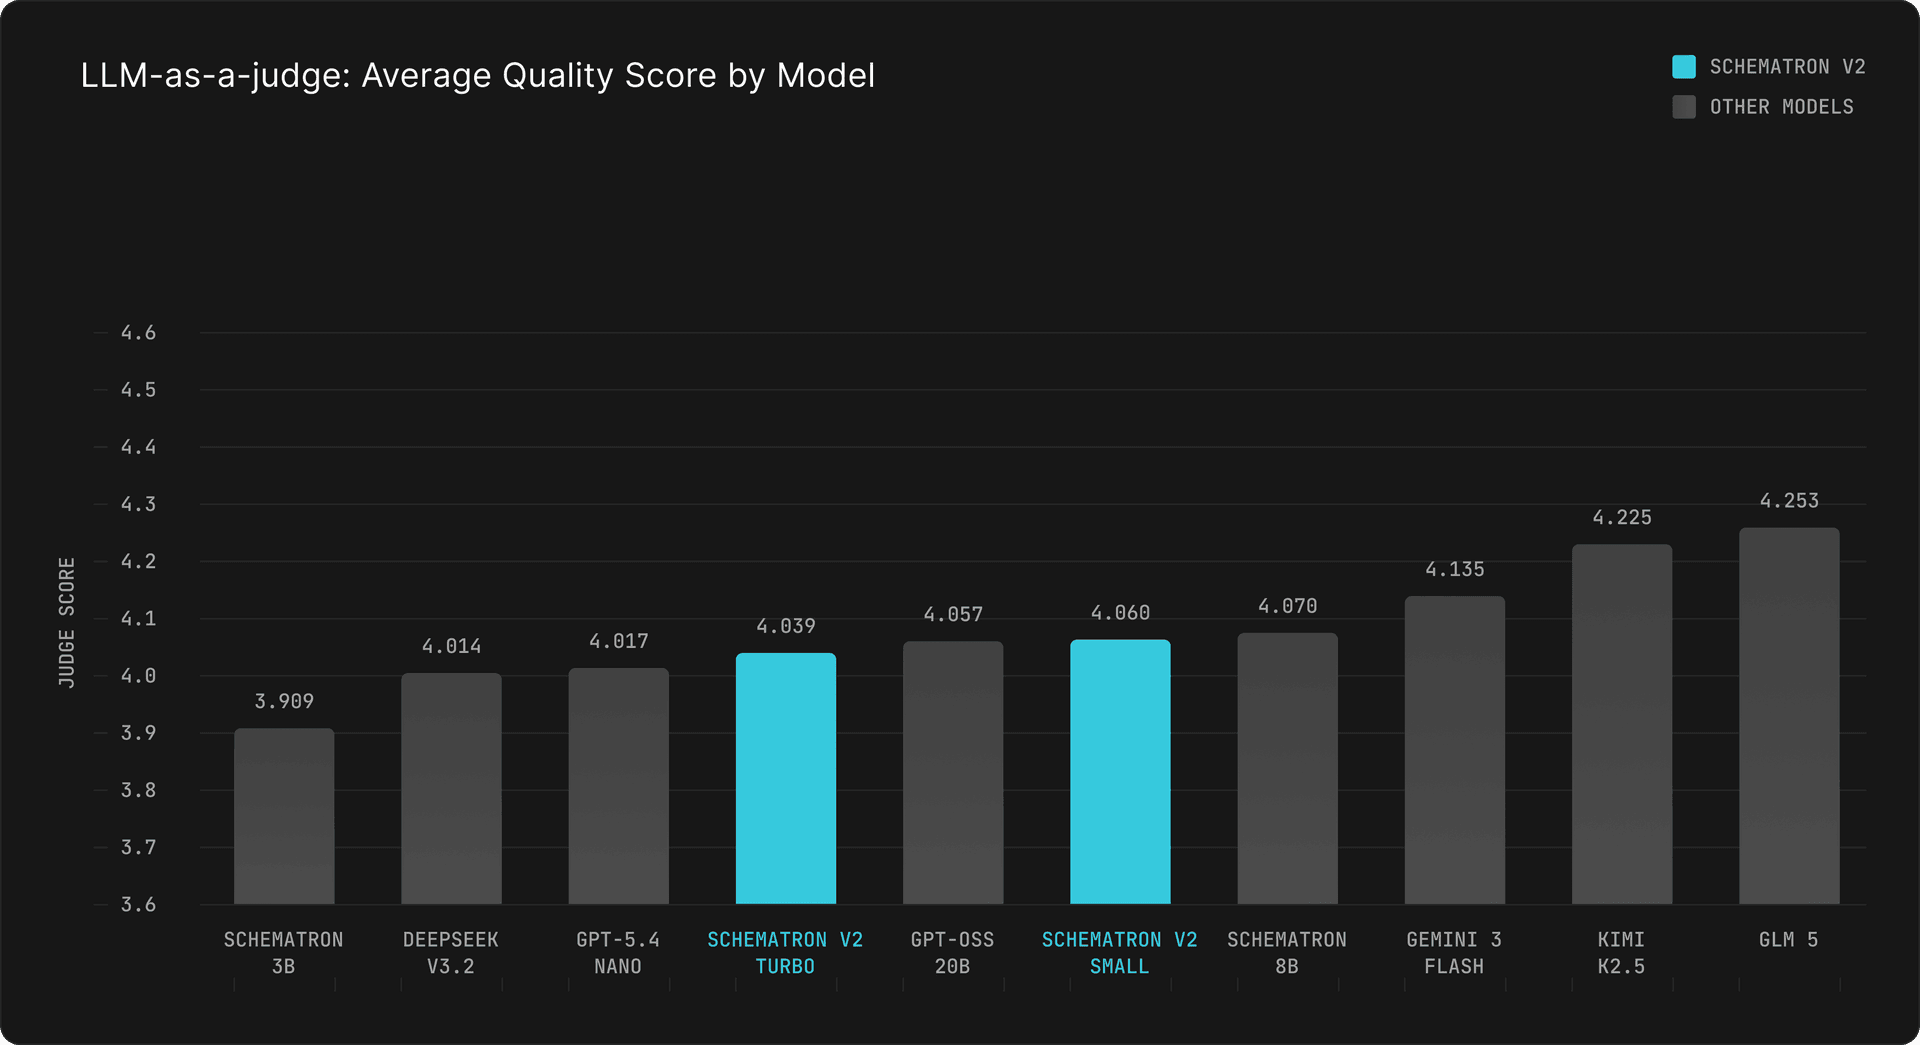
Schematron V2 Small 得分为 4.060,与初版 Schematron 8B(4.070)极为接近,并显著领先于第一代 Schematron 3B(3.909)。对于大多数生产环境工作负载而言,V2 Small 与 8B 之间的差距微乎其微。
Schematron V2 Turbo 得分为 4.039,相比初版 3B 有显著提升,且该模型是在侧重速度而非质量优化的前提下实现这一成绩的。
作为参照:在该基准测试中,两款 V2 模型均表现优于 DeepSeek V3.2 和 GPT-5.4 Nano,而后两者均为规模大得多的模型。
吞吐量:比 V1 快 2.5 倍
Schematron V2 Turbo 专为高吞吐量工作负载设计,这些场景对每毫秒和每美元的成本都极为敏感。
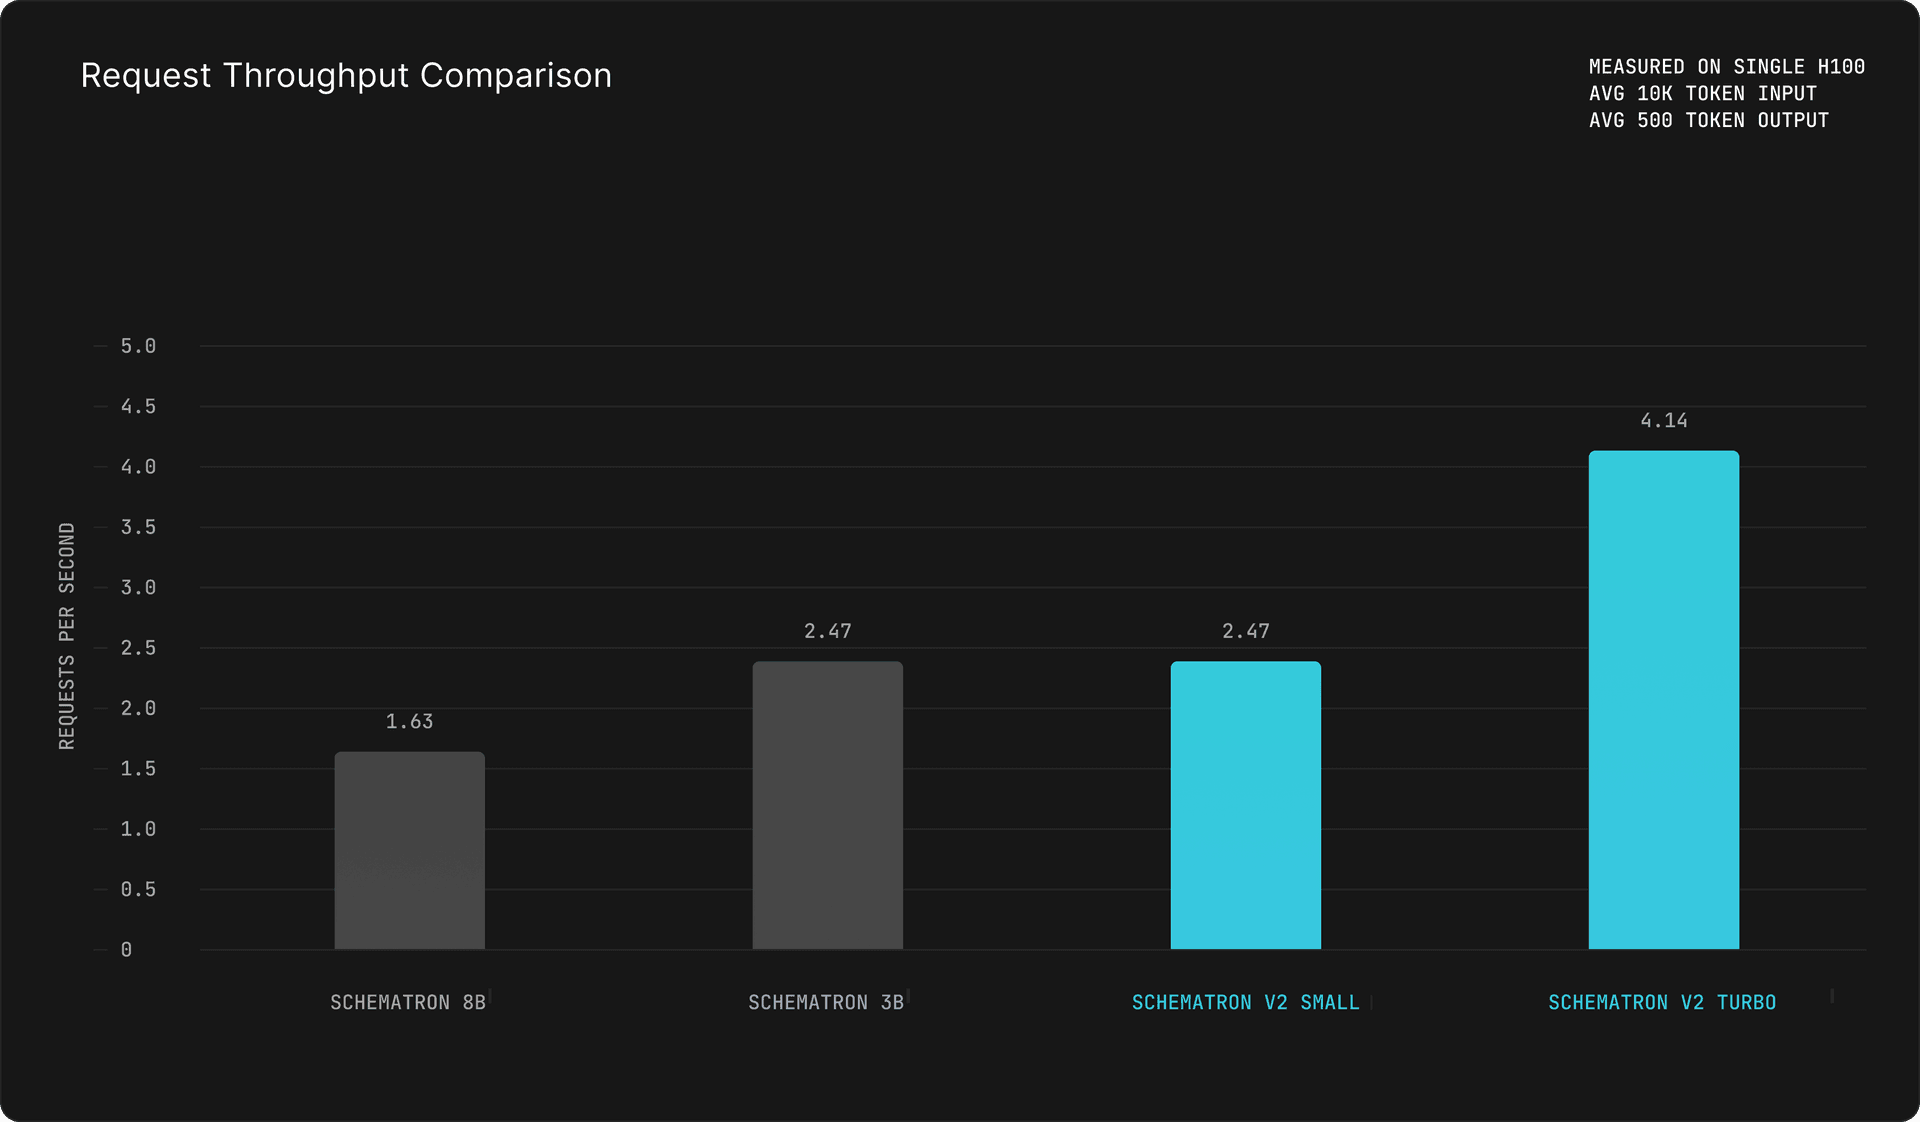
在单张 H100 显卡、10k 输入 token 和 500 输出 token 的测试条件下:
Schematron V2 Small:2.47 次请求/秒
Schematron V2 Turbo:4.14 次请求/秒
Schematron 8B (V1): 1.63 次请求/秒
Schematron 3B (V1):2.47 次请求/秒
Turbo 模型达到每秒 4.14 次请求,比初版 8B 提升 2.5 倍,比旧版 3B 提升近 1.7 倍。对于延迟敏感的爬取和抓取流水线(例如面向实时交易的金融文件解析,或实时价格监控),这种速度优势会迅速累积放大。
提升 LLM 事实准确性:SimpleQA 结果
我们还重新运行了 SimpleQA 基准测试,该测试衡量 Schematron 作为提取层在基于网络搜索增强的流水线(使用 GPT-5 Nano 作为基座模型,配合 Exa 搜索)中对事实准确性的提升效果。
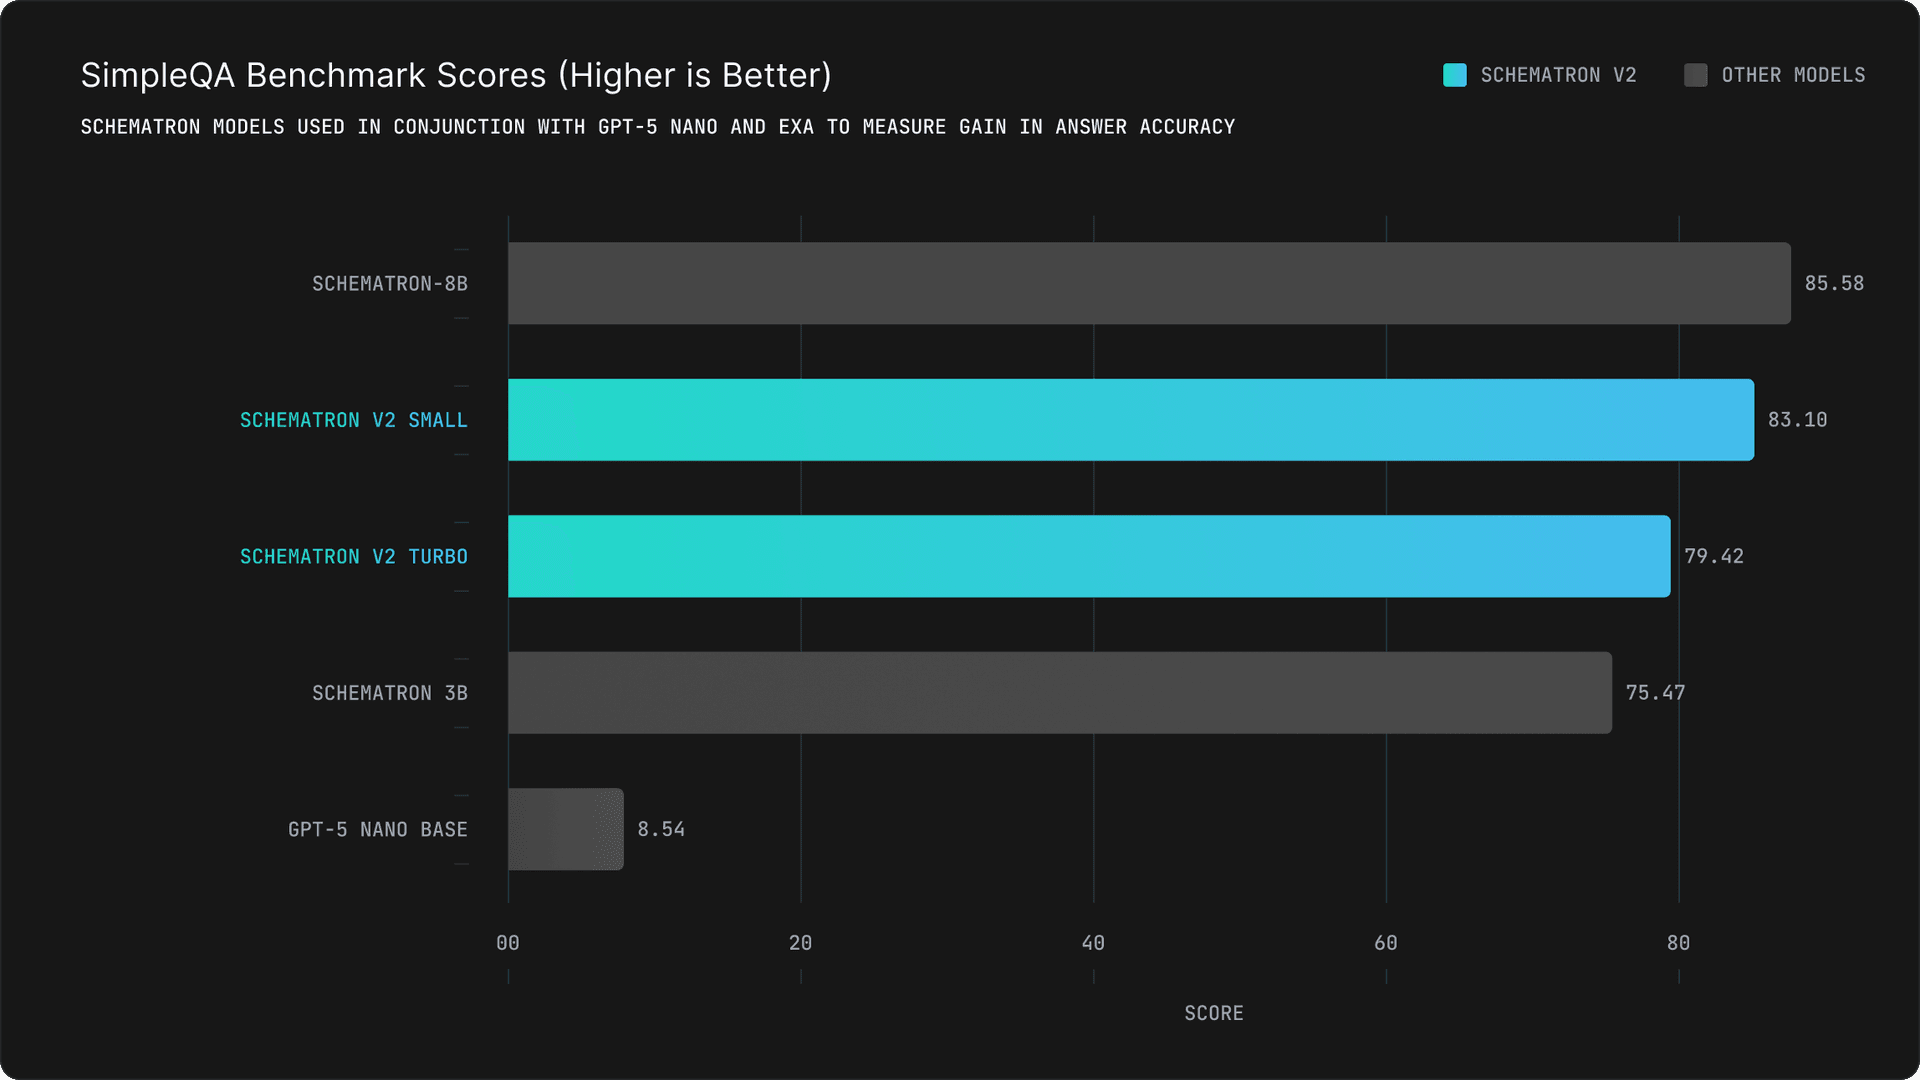
Schematron V2 Turbo: 79.42
Schematron V2 Small: 83.10
Schematron 8B (V1): 85.58
Schematron 3B (V1): 75.47
GPT-5 Nano(无搜索):8.54
Schematron V2 Small 达到 83.10 分,较第一代 3B 模型大幅提升了 7.6 分,仅落后 8B 模型 2.5 分。即使是 Turbo 变体也取得了 79.42 分,比原始 3B 模型提升了近 4 分,且页面处理速度显著更快。
这些结果进一步强化了我们的核心发现:结构化提取从根本上改变了 LLM 网页搜索的经济模型。Schematron 不再将整个原始 HTML 页面(每次查询消耗数万个 token)喂给大型模型,而是只提取关键的结构化数据,使大规模基于网页的事实增强成为可能。
定价
Schematron V2 的定价旨在让互联网规模的数据提取触手可及:
Schematron V2:输入 $0.10/百万 token – 输出 $0.25/百万 token
Schematron V2 Turbo:输入 $0.06/百万 token – 输出 $0.15/百万 token
按此价格,若每天处理 100 万页面(假设每页输入 1 万 + 输出 8k token),使用 V2 3B 的日成本约为 $700,使用 V2 3B Turbo 则约为 $440。对于高吞吐量的工作负载,通过专用实例还可获得额外折扣。联系我们了解关于专用容量的更多详情。
下一步:Schematron Pro
我们的脚步不会停在此处。Schematron Pro 正在开发中,它在保持类似请求吞吐量(throughput)的同时,追求比当前 8B 模型更高的精度。对于需要极致提取质量且愿意支付高于 3B 模型溢价的用户团队,Pro 将是最佳解决方案。敬请期待。
快速上手
V2 双版本模型与原始 Schematron 系列拥有相同的核心能力:128K token 上下文窗口,以及确保 100% 符合 Schema 输出的严格 JSON 模式。你可以使用 Pydantic、Zod 或 JSON Schema 定义结构,传入原始 HTML,即可获取经过验证且类型安全的数据。
关于更多使用详情,请参阅我们的文档。
Schematron V2 Small 和 V2 Turbo 的模型权重目前仍保持闭源,仅通过我们的 Serverless API 提供。原始的开源 Schematron 3B 和 8B 模型依然在 Hugging Face 上可用。
开始提取
我们很想了解你正在构建什么。欢迎通过以下资源开始使用:
创建账户:试用 Inference.net API,附赠 10 美元免费额度
文档:阅读 Schematron 文档,了解如何调用 API
预约会议:与我们的团队交流,了解专属实例和批量定价方案
期待看到你用更快速、更低价的抽取能力创造出精彩的作品。
返回全部文章联系我们与研究团队交流
预约与我们的研究团队通话,深入了解专用语言模型(Specialized Language Models)如何帮你降低成本、提升性能。
预约通话