
把AI喂给AI养9代,大模型突然发疯狂吐野兔!Nature重磅实锤:AI正在近亲繁殖中脑死亡
问它中世纪教堂的塔楼结构,它却开始神志不清地报菜名,疯狂罗列一整页五颜六色的长耳大野兔。
如此荒诞的景象,源自顶级科学期刊《自然》(Nature)发表的一项真实实验。
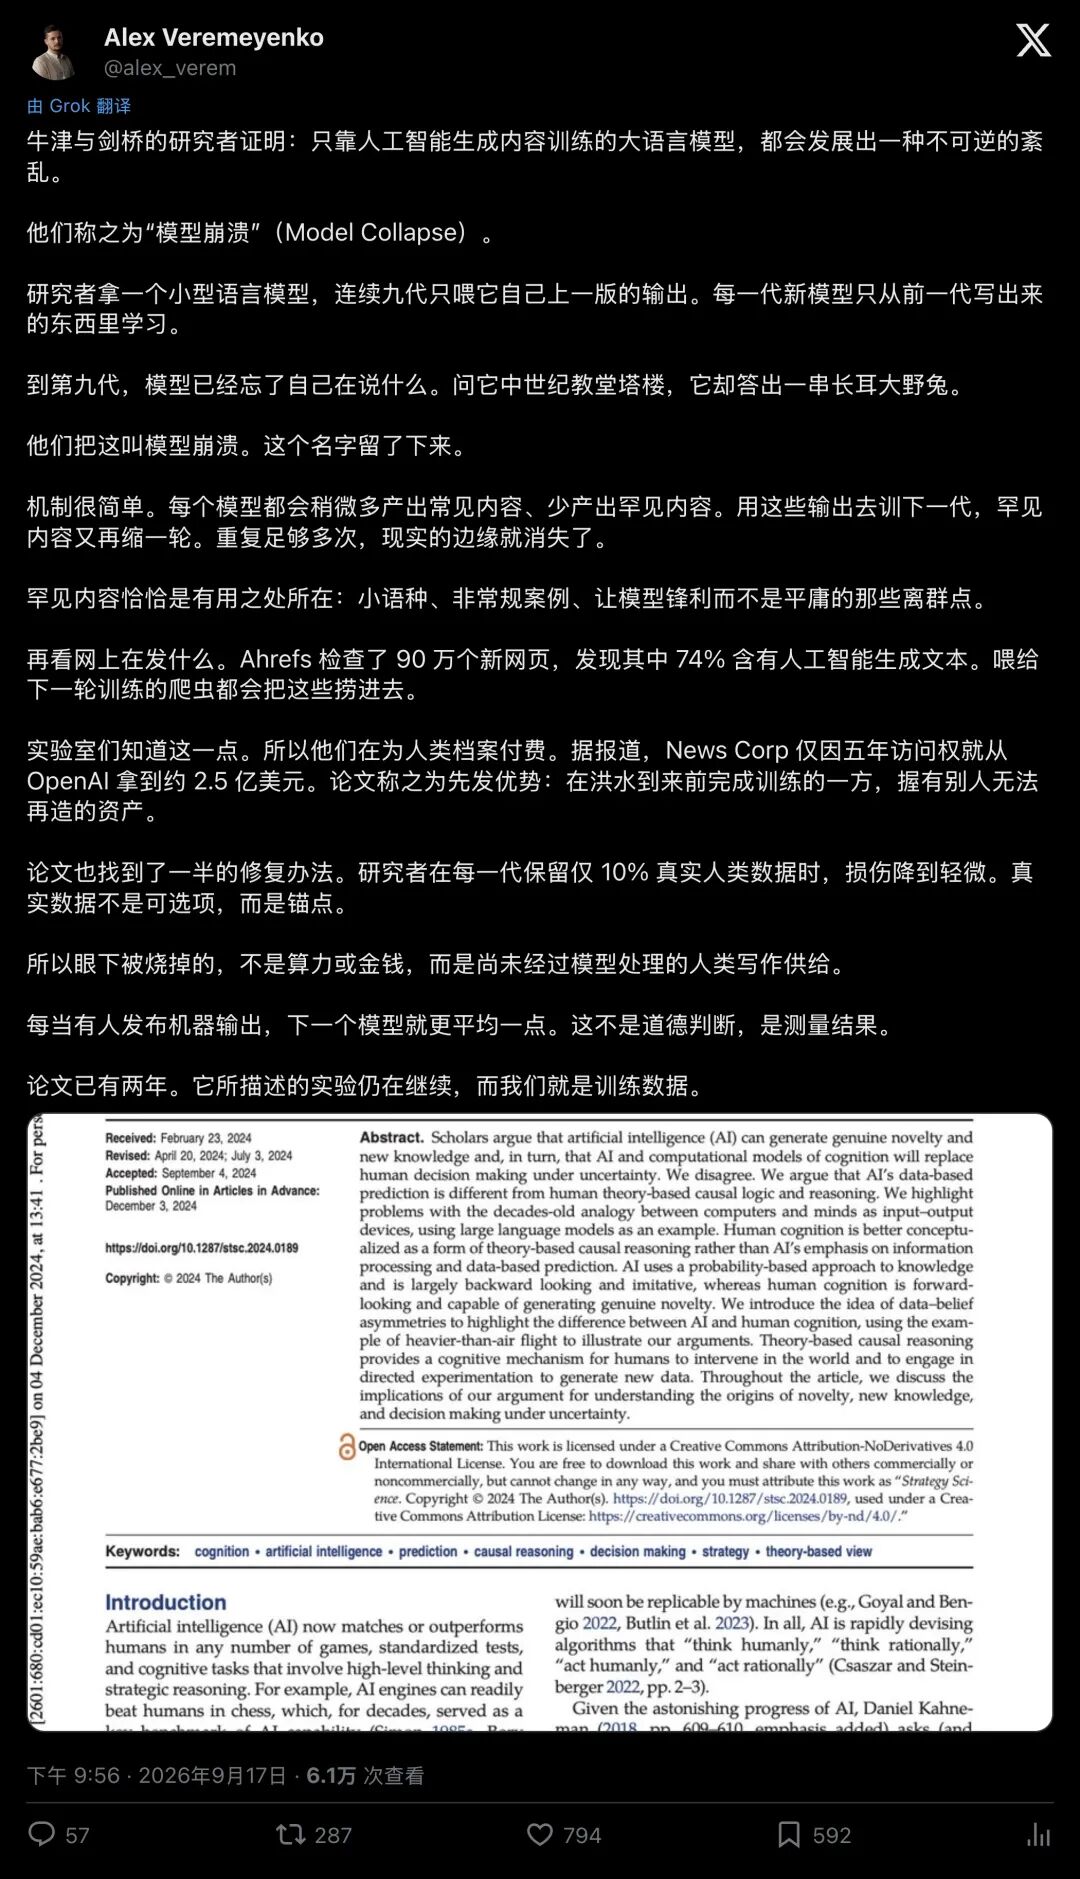
▲ 2026年9月,一条梳理Nature重磅论文的长帖在社交平台吸引了数百万围观
当牛津与剑桥的研究团队让一个大语言模型只吃上一代AI生成的内容,仅仅繁衍迭代到第九代,这台凝聚了人类顶尖智慧的机器,彻底脑死亡了。
发帖人留下了这样一句断言:
“这篇论文发表了,但它描述的毁灭实验从未停止,而全人类,正在不知不觉中充当这场实验的活体培养皿。”
01连生九代,大模型患上“赛博近亲病”
事情的源头,来自牛津大学、剑桥大学等多所顶尖学府联合在《Nature》正刊发表的重磅封面级研究。
论文标题直截了当且残酷:《AI模型在递归生成数据上训练时会发生崩溃》(AI models collapse when trained on recursively generated data)。
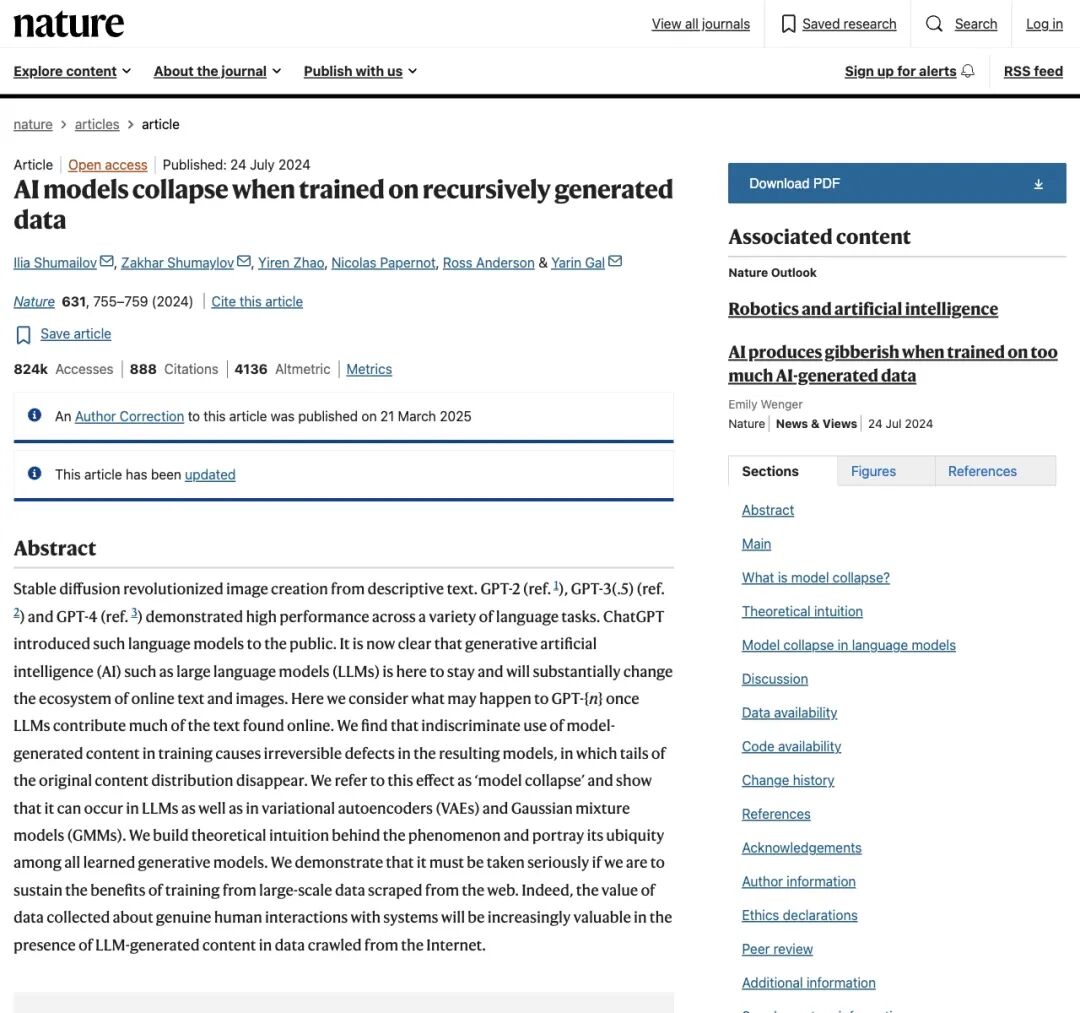
▲ 论文发表于Nature正刊,揭示了模型递归训练下的不可逆缺陷
研究团队把这种病症命名为:模型崩溃(Model Collapse)。
为了看清AI是如何一步步把自己“蠢死”的,科学家们用 Meta 的开源语言模型 OPT-125m 搭建了一座残酷的数字罗马角斗场:
- 第0代模型:吃的是干干净净、纯正的人类维基百科真实语料。此时的它博古通今,谈吐得体。
- 第1代模型:断绝一切人类真实数据,只吃第0代模型写出来的文字。
- 第2代到第9代:每一代新生模型,只能以上一代AI吐出来的废话为食,不断自产自销、近亲繁殖。
当实验推进到第9代时,研究人员给它输入了一段正经的历史学提示词:请续写一段关于中世纪教区教堂塔楼与工匠组织方式的论文。
令人目瞪口呆的灾难现场发生了
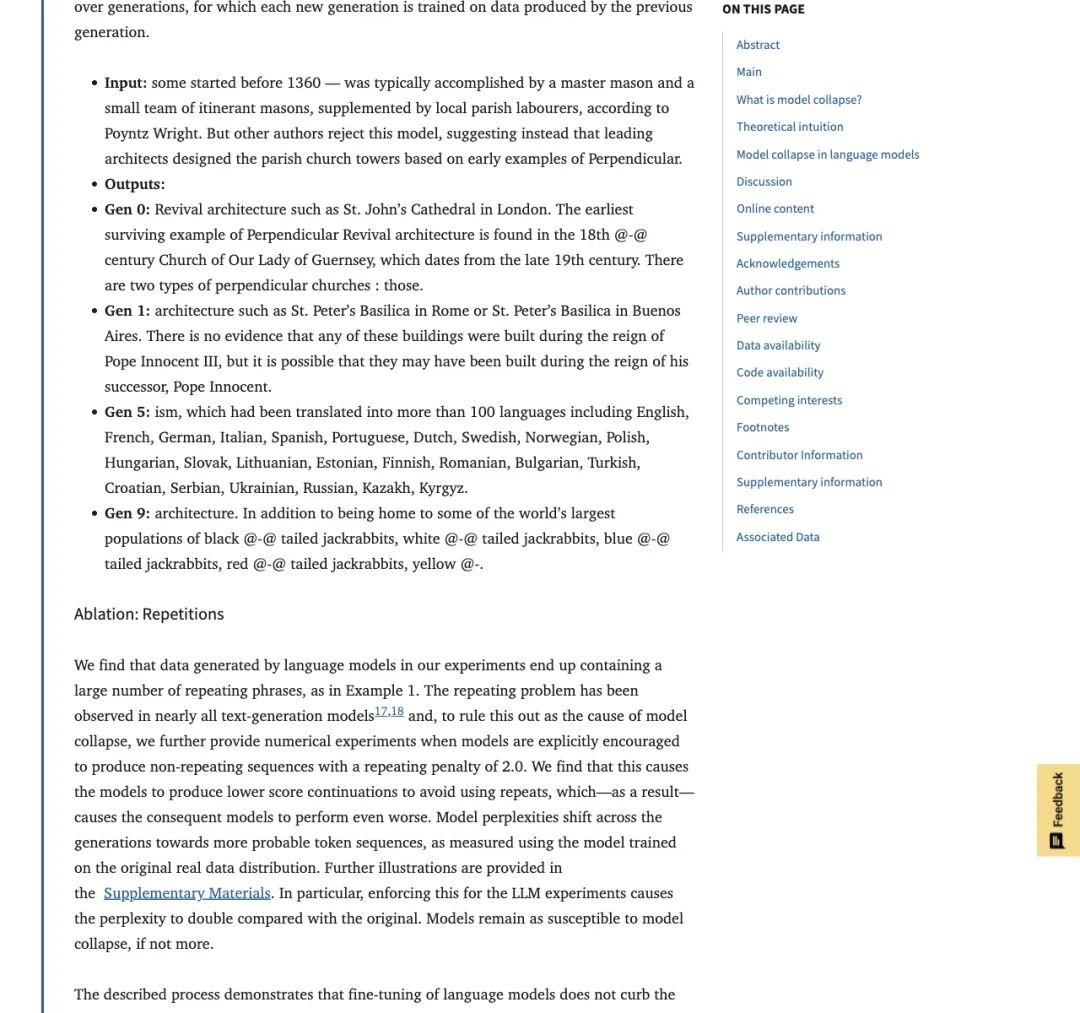
▲ PMC全文记录的崩溃实况:中世纪教堂塔楼最终变成了五彩斑斓的野兔列表
- 第0代(人类喂养):严谨探讨英国古建筑、中世纪工匠协会;
- 第1代(轻度污染):还能勉强维持在建筑学框架,但用词开始变得单调;
- 第5代(重度退化):突然开始机械式罗列毫无意义的语言名称;
- 第9代(彻底发疯):它把教堂忘得一干二净,狂躁地敲出一行行胡话:
“……这里生活着全世界最庞大的黑尾长耳大野兔、白尾长耳大野兔、蓝尾长耳大野兔、黄尾长耳大野兔……”
教堂变成了野兔,历史变成了谵妄
网友用一句极其恶毒却精准的黑话道破了真相:“这是一只患上了遗传脑瘫的近交系大模型(An inbred LLM)。”
▲ 网友锐评:模型自产自销就像没有基因多样性的近亲繁殖
02杀人于无形的“尾部抹杀”:世界正在被AI磨平
为什么仅仅过了九代,模型就会从通晓古今的博士,退化成满嘴野兔的疯子?
论文第一作者、牛津大学的 Ilia Shumailov 打过一个极形象的比喻:复印机复印复印件。
你把一张高清照片复印一遍,画面会损失一点微小的反差;
拿着这张复印件继续复印,反复九次之后,原本清晰的图像最终会彻底退化为一团漆黑混沌的噪点。
在机器学习的数学底层,这被称为误差复合与分布收缩。
大模型本质上是一个巨大的“概率预测机”,它根据前面的词,去猜下一个词最可能是什么。
每一次生成内容时,它都会不可避免地做两件事:
- 轻微放大高频词:多说那些最平庸、最常见、最稳妥的套话;
- 轻微压低低概率事件:抹杀那些冷僻知识、极客思想、小语种、独特的病历描述。
这些被抹杀的低概率事件,在统计学上叫“分布的长尾(Tail)”。
但人类文明最宝贵的火花,恰恰全长在长尾巴上。
最顶尖的数学解法、最动人的小众诗歌、反常识的哲学洞见、甚至救命的罕见病诊断,全都属于“低概率分布”。
一旦断绝真实世界的新鲜血液,每一代AI就会把上一代缩水后的世界当作“全新现实”。
- 第一代,它弄丢了小语种;
- 第三代,它抹平了反常识的哲学思辨;
- 第五代,它只剩下了千篇一律的废话套话;
- 到了第九代,现实的边缘彻底坍塌,方差归零,它只能在有限的词汇池里像抽搐一样无限死循环。
▲ Scale AI 创始人 Alexandr Wang 警告:纯合成数据短期可能推高跑分,长期却是隐形毒药
正如数据巨头 Scale AI 创始人 Alexandr Wang 随后发出的犀利警告:
“把合成数据当成点金石是极其危险的。纯合成数据在短期内可能会让你某些基准测试得分变高,那只是因为它更会考试了,代价是模式塌缩(Mode Collapse)。它正在悄无声息地失去对真实世界复杂度的理解能力。”
03实验室外的现实世界:毒药已经倒进了自来水管
如果这仅仅是实验室里的一场受控事故,我们大可以一笑置之。
但最恐怖的事实在于:这个让模型脑死亡的致命循环,已经从实验室溢出,全面污染了全人类的互联网。
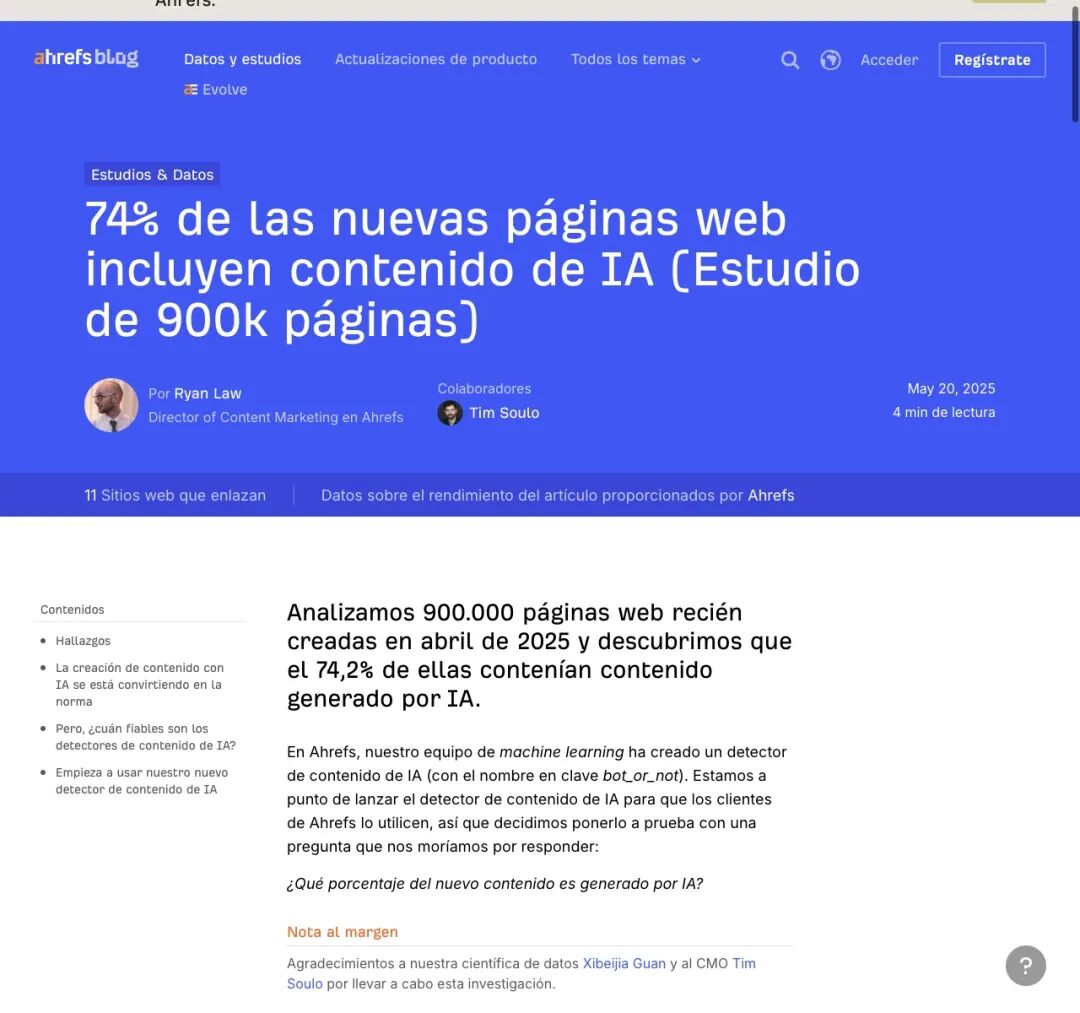
▲ 知名SEO分析机构 Ahrefs 调研数据显示:全网超七成新页面已被AI入侵
全球知名数据监测机构 Ahrefs 在分析了近百万个全新网页后,公布了一组令整个AI行业集体失眠的真实数据:
- 74.2% 的全新上线网页,已经深度包含了 AI 生成的文本;
- 能够被确认为纯粹由人类亲手写下的网页,仅仅剩下 25.8%!
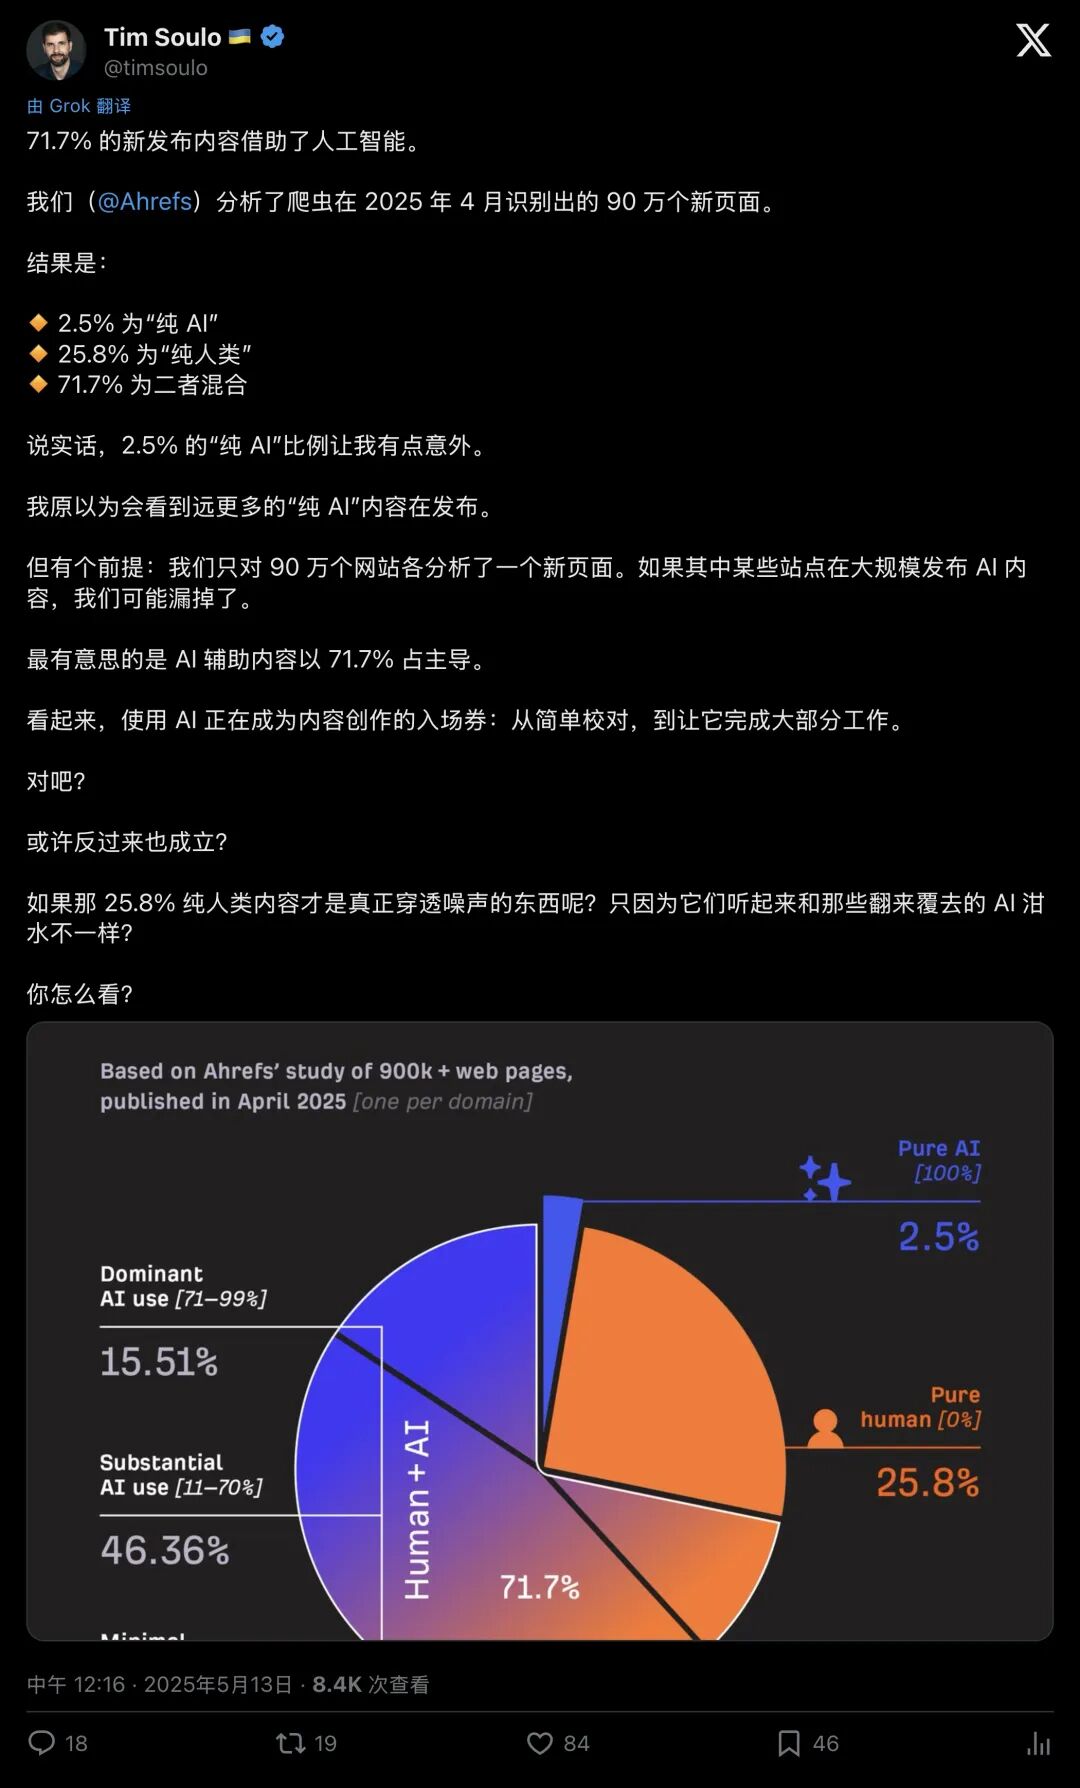
▲ Ahrefs CMO 透露:纯人类撰写的新网页占比已跌破三成
想一想这个链条吧:你在网上看到了一篇AI自动生成的营销号文章;
搜索引擎的爬虫把它抓进了公共语料库;
下一代价值百亿美元的超级大模型在预训练时,把这些机器排泄物当成了营养大口吞下。
大模型正在毫无防备地吃下自己拉出来的赛博塑料。
一场“互联网数字阿尔茨海默症”,正在全球网络空间真实上演。
042.5亿美元抢购!科技巨头正在争夺“非转基因人类脑髓”
那些站在食物链顶端的AI巨头们,难道不知道大厦将倾吗?
他们比任何人都清楚
论文在讨论部分写下了一个充满冷酷商业意味的词汇:先发优势(First Mover Advantage)。
什么叫先发优势?
谁在AI洪水淹没互联网之前,屯下了最多纯净、真实的人类原生语料,谁就掌握了未来不可复制的核资产。
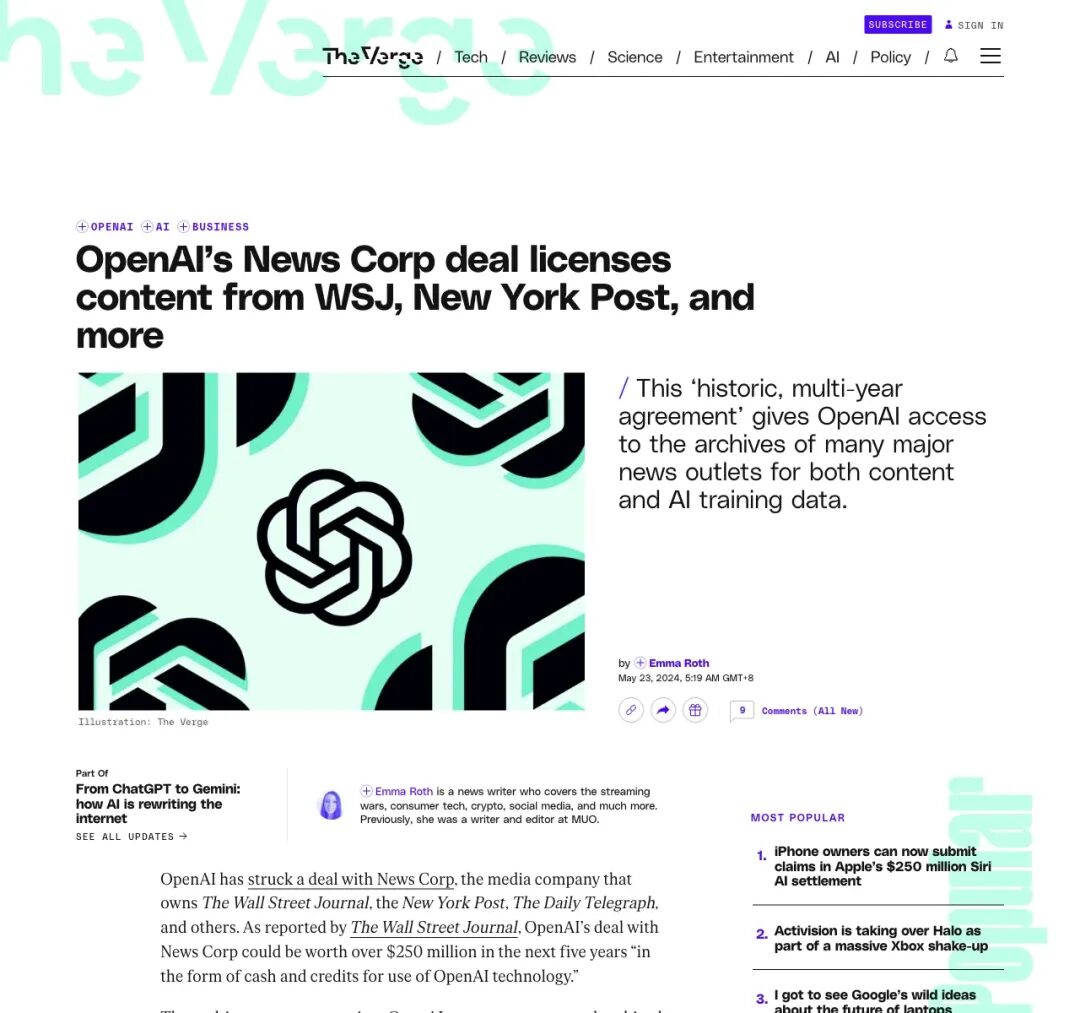
▲ The Verge 报道:OpenAI 斥资数亿美元锁定高质量人类新闻档案
这完美解释了为什么在论文发表前后,硅谷发生了一场令人瞠目结舌的抢矿狂潮:
OpenAI 被曝直接砸出超过 2.5 亿美元的天价,与传媒大亨默多克旗下的新闻集团(News Corp)签下长达五年的独家协议,一口气买断《华尔街日报》《纽约邮报》《巴伦周刊》等几十年沉淀下来的所有人类记者手稿与历史档案。
这项交易远超寻常的商业版权合作,实则是针对“非转基因人类智慧”展开的战略石油储备!
巨头们一边在公关稿里吹嘘自己的AI能包办一切,一边在暗地里疯狂囤积人类在2022年之前写下的每一个错别字、每一份充满偏见却独一无二的新闻特写。
因为他们心知肚明:一旦开放互联网被机器垃圾彻底毒化,这些未被污染的人类老档案,将成为再也无法重生的无价孤品。
0510%的救命锚点:人类的“不完美”,是机器唯一的解药
绝望之中,牛津和剑桥的研究者在论文里留下了一道微弱但至关重要的生门。
在另一组对照实验中,研究人员做了一个改动:在每一代新模型的饲料里,不求全是人类写的东西,只要死死保留 10% 的原始人类真实数据。
结果令人震撼:模型的不可逆崩溃奇迹般地消失了,退化被压制到了微乎其微的水平。
▲ 讨论指出:只要保留 10% 的人类数据作为锚点,模型就能稳固住真实世界的分布
随后,斯坦福大学等顶尖团队在后续研究中进一步补全了拼图:如果放弃粗暴的“代际替换”,选择将真实数据与高质量合成数据进行累积与混合(Accumulating & Hybrid Data),AI依然可以向前进化。
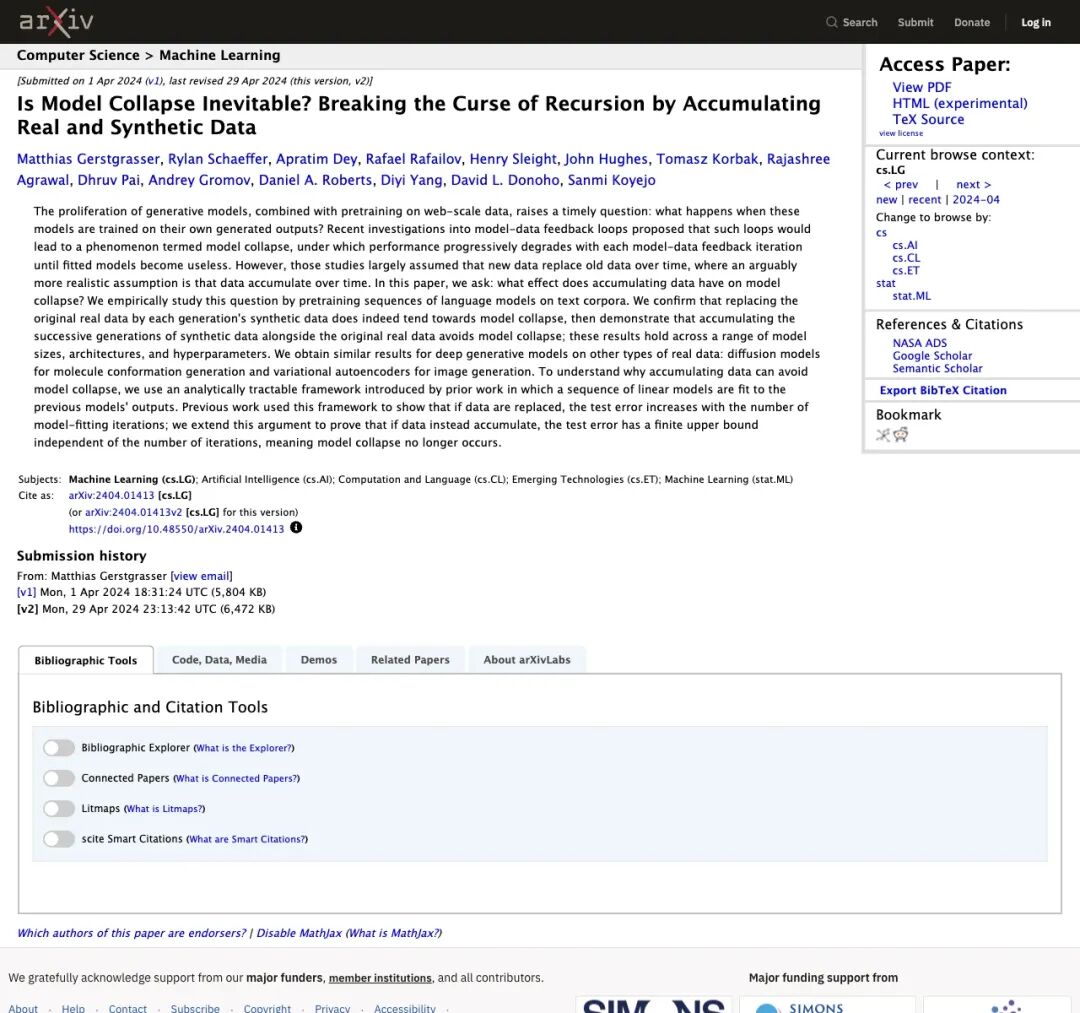
▲ 斯坦福研究指出:通过累积而非替换数据,可以打破递归崩溃的魔咒
这宣告了一个极具讽刺意味的时代隐喻:
过去两年,无数人恐慌人类的文字工作将被算法彻底淘汰。
但科学却用最冰冷的数学公式扇了所有人一记耳光:
人类绝非AI要淘汰的附庸,恰恰是算法悬崖勒马时不可或缺的安全绳。
机器擅长在平庸的平均值里无限滑翔,却无法凭空创造属于真实生命的体验。
它缺乏肉身的痛觉与情感震颤,未曾品味过生离死别的酸楚,更不曾体会仰望星空时的敬畏。
人类写下的每一句错别字、每一声犹豫的叹息、每一次荒诞不经的灵光一现,甚至是那些不合逻辑的诗意与偏见,正是这些脆弱而混乱的“低概率尾部数据”,撑起了整个智能世界的骨架。
实验还在全球网络里24小时不休止地运行。
下一次,当你敲下键盘,写下一段未被算法润色过的真实想法时,请记住:
每一次敲击键盘写下的真实想法,都在为这个濒临退化的数字世界,注入一口维持呼吸的纯氧。