
并行编程难不难?Paul McKenney 免费在线教材书评
以下是我对保罗·麦克纳尼(Paul E. McKenney,Linux 内核 RCU 同步机制的作者)所著免费在线教材 Is Parallel Programming Hard, And, If So, What Can You Do About It? 的一些看法。
我读了这本教材相当多的一部分,觉得已经吃饱了,短期内可能不会再继续读下去,因此趁着印象还新鲜时写下这篇书评。
背景与情境
在这部分,我想聊聊自己开始阅读这本教材时所处的心理状态、人生阶段以及物理环境。
这可能会像美食网站开头那种冗长的个人故事一样令人乏味,如果这部分对你没兴趣,可以直接跳过后面的内容。
过去十年,我的职业生活一直围绕 TLA+ 和分布式系统展开,我觉得是时候求变了。那是一段过渡期,情绪上颇为动荡!
2022 年,我曾尝试(并失败)转向 Lean,希望获得一份极其小众且几乎不存在的职位,成为帮助研究人员将其量子信息处理结果形式化的专家。那让我精疲力竭。考虑到自动定理证明近期的进展,我那暂时具有先见之明的神经系统可能是在帮我避开陷阱。这便是我参加 2026 年在密苏里州哥伦比亚市举办的 Software Should Work 会议时的背景与情境。
会议上有许多精彩的演讲,但我尤其喜欢 Filip Pizlo 关于 Fil-C 的报告:
我与 Fil 聊了很多,从解释器话题逐渐聊到并发。自从我用 TLA+ 和分布式系统知识武装自己后,我一直觉得自己对并发很有见解,但 Fil 向我展示了编写无锁并发垃圾收集器的难度,让我意识到自己对并发的了解其实非常肤浅(在会议上意识到自己知道得很少,正是好会议的标志)。
此外,Fil 还提到 TLA+ 在推理 真正 并发事件(多核 CPU 上实际存在的可能性)方面可能并不好用(或至少人体工程学不佳)。他也强调了分析并发算法的线性化属性(linearizability)的重要性,我对这个概念在分布式系统语境下大致有所了解。
这一切听起来颇具吸引力,因此我寻找了一本更侧重无锁(lock-free)特性,而非互斥锁(mutex)或消息传递模式的并发编程教材。 并行编程是否很难?如果是,你该怎么办?(Is Parallel Programming Hard, And, If So, What Can You Do About It?)似乎正符合需求,因为它聚焦于通用并发编程及 CPU 缓存效应,而非专门讲解如何编写无锁数据结构的教材。 这本书还曾在 Hacker News 上引发过数次(2023、2021、2020、2015、2014、2011)尚可一读的热议。 我认为纠结于寻找那本“完美”的教材毫无意义(这不过是拖延症的聪明借口),所以这本已经够好了。
我读这本书时的场景是一次为期 1.5 周的假期,我去加拿大一个安静的林区探望家人。 2026 年恰逢蚊灾肆虐的糟糕季节。 因此,我大部分时间都坐在凉爽的封闭露台上,在数百只蚊子的严密监视下专心阅读,确保它们不会离开岗位:
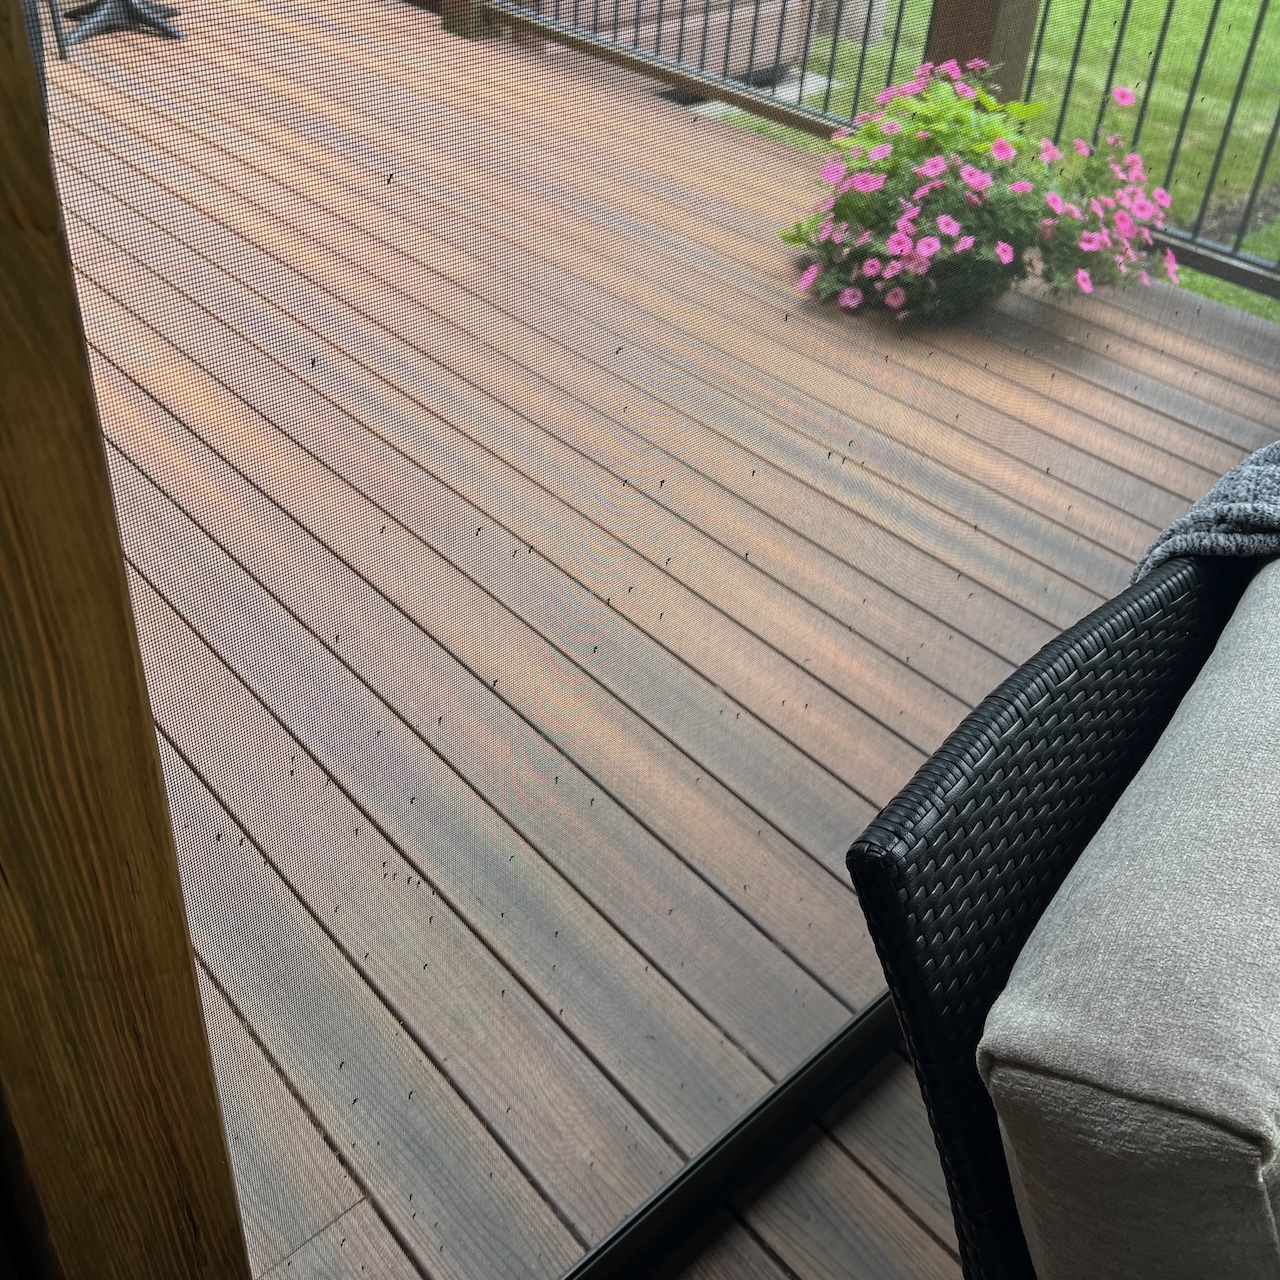
得益于卫星通信和基站覆盖,即使在这个偏远地区,网速也相当不错,令人有些恼火。不过除此之外,这里确实是阅读教材的绝佳地点。
教材的排版格式
关于这本教材的实际结构,有几点简评:它提供了不少于三种独立的 PDF 格式版本:
- 双栏布局,类似科学论文
- 单栏布局,页边距较大
- 单栏布局,无页边距
最后一种非常适合在我的 Pine64 PineNote 上阅读。
这本书内部链接极多。一部分链接用在快速知识测验的问答框里,点击就能跳到答案;每当提到某个图或章节,以及大量脚注和引用时,也都会用到链接。可惜后者非常烦人,至少应该砍掉八成。如果你的电子书阅读器没有实体翻页键,那你的阅读体验就是:本来想翻页,却总是误触链接,被随机跳转到不知何处。电子书本身导航起来就容易晕头转向,这样一来,靠连续翻页在两个章节之间快速来回切换基本不可能了。偶尔我确实想点链接时,又会遇到两个链接紧挨着的情况,触摸屏的精度根本没法保证点中想要的那个。最简单的办法是把链接全部禁用,但那样就会失去那些相当不错的知识测验题。所以我只能硬着头皮忍受。
教材内容——入门章节
就我的水平而言,这本教材的讲解方式近乎完美。开头几章是很轻松的介绍和动机铺垫,到第 3 章《Hardware and its Habits》才正式进入正题。这一章从较高的层面讲解现代 CPU 的工作原理——什么让它们快,什么让它们慢,还配了不少幽默的插图。3.2.1 节《Hardware System Architecture》是我觉得最有意思的地方:书中以简化的方式讲解了一个 CPU 核心写入一个不在自己缓存中的内存地址时会发生什么。
这里有个遗憾:我对 CPU 缓存如何协调并发读写几乎没有概念,本来很希望能有一段对 MESI 协议的基础讲解。我是在网上搜索以便更好地理解这一节时才知道 MESI 的,而本书只在附录里提了一句。了解 MESI 之后,我对全书其余内容的理解都大大加深了。
了解 MESI 协议还让我意识到,多个 CPU 核心并不能真正同时向同一数据位置写入!x86 CPU 实际上并非直接写入内存,而是先写入缓存(缓存值最终才会被刷回内存)。只有当 x86 CPU 核心独占有包含该地址的缓存行时,才能向特定地址写入。如果另一个核心试图同时写入该地址,它必须等待独有权转移到自身。因此,字面意义上的并发写入实际上不会发生。不过,如果被写入的数据跨越多个缓存行,写入仍可能出现撕裂。
第四章《专业工具》简直让人头皮发麻。书中指出,如果编写并行程序时稍有不慎,编译器会进行极其“富有创意”的优化,导致完全荒谬的行为!第 4.3.4.1 节《共享变量陷阱》列举了诸如加载撕裂、存储撕裂、加载融合、存储融合、代码重排、虚构加载、虚构存储(尤为恶劣)、存储转加载转换以及死代码消除等令人胆寒的事故。然后,假设你的代码幸免于编译器的“毒手”,本章又详细剖析了 CPU 在实际执行程序时可能做出的各种离谱操作。这双重难题让我在思考并行程序时,除了熟悉的互斥锁或消息传递机制外,其他方面都难以理清思路。
我对这一章的唯一不满是它过于聚焦于 Linux 内核环境。我原本希望能了解到 C++11 和 C11 如何通过 std::memory_order 等手段来规范化并行编程。但相关内容仅在 4.2.6 节《原子操作(C11)》和 4.2.7 节《原子操作(现代 GCC)》中占寥寥几段。读完这一章,我对 ACCESS_ONCE() 和 WRITE_ONCE() 宏的印象仅停留在它们将变量强制转换为 volatile* 以震慑编译器上。诸如关于“良性数据竞争是否属于错误”等引人入胜的历史性争论(参见 相关论文),则被完全略过。
教材内容 - 主要章节
第五章《计数》堪称全书的重头戏,也是我在全书中读得最仔细的一章。本章列举了大约十种用多线程递增计数器的编程方式。显而易见且正确的实现是每个线程使用原子递增指令,但书中很快通过性能测试指出这种方式性能堪忧。这里,我对 MESI 协议的课外知识发挥了关键作用。
本章的终点是一种称为"窃取信号限制计数器"的机制,老实说我没有完全搞懂。如果让我自己实现计数器,我可能不会把方案做得那么复杂。我非常喜欢基于数组的每线程统计计数器,它在概念上与分布式系统中的无冲突复制数据类型颇为相似。它们也是学习伪共享性能影响的绝佳载体——你不能把所有线程专属计数器塞进单个连续数组就万事大吉!
读完第五章后,我便略读其余内容,寻找感兴趣的议题。其中一些章节偏理论,讨论所有权、分区、延迟处理等,这些概念与分布式系统容易类比。《形式化验证》一章用了 Promela 和 Spin,作为一个 TLA⁺ 用户,我没有动力去学这些工具。《验证》一章中有一节(11.6.4)专门讲《寻找海森堡虫》,内容不错。无锁编程直到第十四章《高级同步》才真正开始涉及,此时我已准备转向一本专门聚焦无锁编程与数据结构的教科书。第十五章终于谈到内存模型,但我早已借助其他课外资源去理清对此概念的困惑。
总体评价
虽然我只深入读了前五章,但我认为这本教材非常出色。之所以这么说,是因为它真的让我对并行编程产生了强烈的求知欲!上班时的大多数午餐时间,我都得努力忍住,不把刚学到的那些冷知识一股脑倒给同事。比如你知道吗:release-consume ordering(释放-消费顺序)的形式化尝试失败了?或者 x86 上用 mov 做的基本对齐读写本身就是原子的?还有 out-of-thin-air values(凭空值)?还有 DEC Alpha 那个弱到离谱的内存模型?或者 release-acquire 语义是怎么回事?还有确定性仿真测试为什么至今还无法有效测试无锁算法?以及 ARM(v8 之前)上的原子操作为何可能被抢占?这里面全是反直觉到荒诞的宝藏知识。接下来我想学高性能垃圾回收,欢迎推荐资料!