
AI性能成本下降速度超越历史上任何技术
自 2023 年以来,在特定 AI 基准测试中达到固定性能水平的成本急剧下降。
追踪 AI 发展趋势的研究机构 Epoch AI 指出,相关成本平均每季度下降约 47%,即每年降低约 13 倍。该机构称,没有任何其他变革性技术的成本下降速度如此之快。不过,这一数字反映的是达到固定基准分数的市场价格,而非纯粹的算法或架构进步,也不等同于现实生产力成本,后者完全是另一回事。
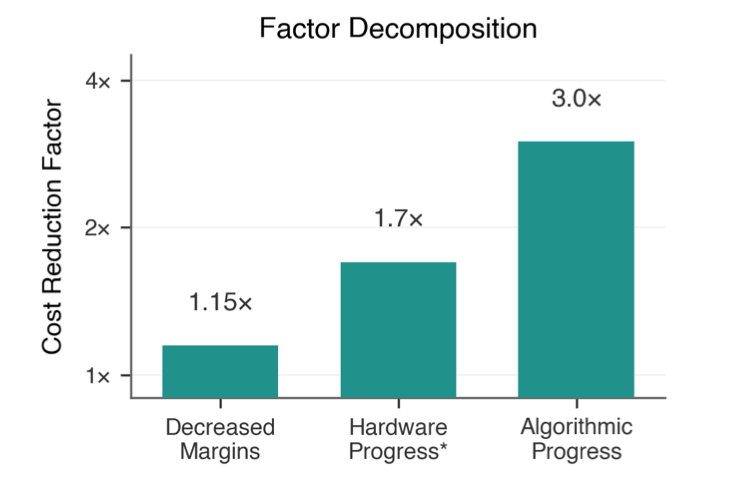
麻省理工学院的研究人员分析类似数据后发现,成本每年下降 5 到 10 倍。一旦剔除硬件成本降低和竞争定价压力的影响,他们估算算法效率带来的实际提升约为每年 3 倍。单次运行的峰值性能实际上可能变得更贵,因为新一代推理模型在每个任务上消耗的算力大幅增加。
尽管这两项研究关注的点有所不同:要达到去年顶级模型的能力水平,现在的成本大幅降低;但如果运行当前最先进的模型,单次查询的成本往往显著更高。
匹配 o3 准确率所需的成本如今仅为一小部分
Epoch AI 以 OpenAI 的 o3 为例。2025 年初,o3 在 GPQA Diamond(一项博士级科学测试)中得分为 75 分,估计每题成本为 30 美分。18 个月后,GPT-5.6 系列模型以 0.04 美分的价格达到了相同分数。Epoch AI 表示,这相当于原价格的 1/725。如果汽车成本下降得这么快,一辆 5 万欧元的车如今将不到 70 欧元。OpenAI 仅在几天前推出了更便宜的 GPT-6 Sol 和 Luna 模型,两者价格减半但性能提升有限,因此价差可能进一步扩大。
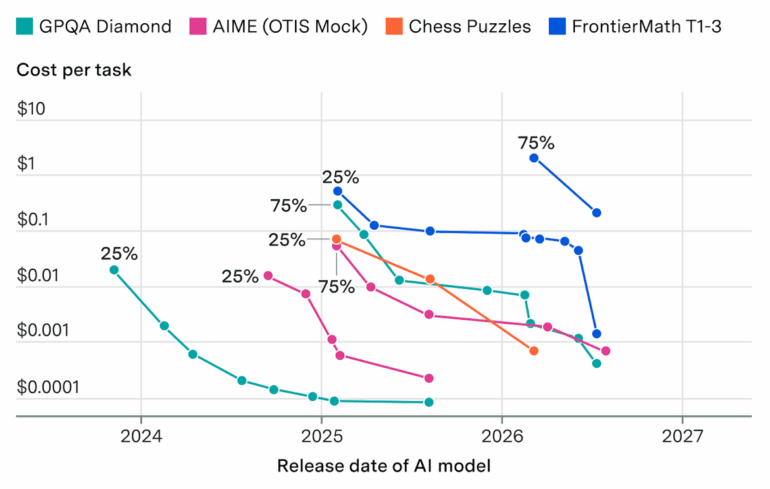
Epoch 的分析基于五个基准测试,涵盖数学、科学和逻辑谜题。由于样本较窄,该机构表示其结论是“基于现有最佳数据得出的合理但粗略的测量结果”。
算法进步只能解释价格下降的一部分
Hans Gundlach 和他在 MIT 的同事使用了对比平台 Artificial Analysis 的定价数据,时间跨度为 2024 年 4 月至 2025 年 11 月,每次测试评估的模型数量也远多于以往的研究。他们的数值低于 Epoch,部分原因在于新一代推理模型可以对难题投入额外的 测试时计算,即使 token 单价持续下降,每个正确答案的成本依然被推高。Token 是供应商计费的文本单位,只比较它并不能反映全貌。
MIT 在拆解降价推动因素后发现,更便宜的硬件占一部分,竞争占更多。研究者通过单独分析开源模型来排除竞争因素,剩下的就是纯粹的算法效率提升,约为每年 3 倍。Epoch 得出的 13 倍之所以更高,是因为它没有剔除硬件和竞争的影响。
基准测试得分更高不等于效率更高
MIT 的研究还发现,部分性能提升仅仅源于算力投入的增加。一款在 GPQA Diamond 基准测试中超越前代的新模型,看似是技术进步,但研究者估算,其性能提升的很大一部分其实来自每个问题消耗了更高的处理算力。结果分数更高,运行成本也更高。编程和数学基准测试也呈现出类似的趋势,只是幅度较小。
并非所有基准测试的进步都意味着效率的提升。新模型往往结合了更好的训练、更优的数据、更先进的架构以及更多的测试时算力。一个单一的分数将所有这些因素混杂在一起。
此外,还存在“刷分”问题:AI 公司可以针对知名测试进行优化,使分数虚高,但在实际应用场景中并无收益。Epoch 通过引入一项基于保密游戏的测试(“Mystery Game Puzzles”)来防范这种情况。在这项测试中,成本下降得最慢,这与刷分理论相符,但同样可能反映出任务格式或数据噪声的影响。
仅看价格无法决定该选哪个模型
在为特定任务挑选模型时,宽泛的平均成本参考意义不大。像 Artificial Analysis 这样的平台会从质量、价格、延迟、上下文窗口和输出速度等多个维度对模型进行排名,最便宜的选项很少能在所有维度上胜出。
对于实时聊天机器人而言,低成本但高延迟的模型毫无用处。强大的推理模型可能因速度太慢而不适合自动化流程。更昂贵的前沿模型如果准确率更高、减少了重试次数,反而可能更具成本效益。这些细节在简单的每 token 价格对比中并不体现。我们在 Frontier Radar #3 中深入探讨了这一 token 经济学问题。