
高通这一代骁龙:手机芯片,开始为Agent重新设计
智能体时代,AI 算力的玩法也在升级迭代。
北京时间 9 月 23 日,在 2026 骁龙峰会上,高通 CEO 克里斯蒂亚诺・安蒙(Cristiano Amon)正式介绍了高通面向 Agent 时代的战略转型。
与此同时,高通发布了两款新一代旗舰手机 SoC:第六代骁龙 8 超级至尊版(Snapdragon 8 Elite Extreme Gen 6)与第六代骁龙 8 至尊版(Snapdragon 8 Elite Gen 6)。
新一代芯片将 AI 算力作为核心升级方向,重点对端侧 AI 智能体推理、内存架构、个性化和多模态处理能力进行了升级。
芯片能力,全面倒向 AI
今年的手机芯片竞争极度激烈,骁龙成了最后一个发布的旗舰芯片,不过好在我们并没有白等。
本次发布的两款骁龙 8 Elite Gen 6 均采用台积电 2nm 制程工艺(N2P),搭载新一代高通自研的 Oryon CPU,采用 8 核配置。这是高通首次在同一代骁龙 8 Elite 系列中推出两个不同定位的旗舰产品。
在 CPU 配置上,两款芯片都采用 8 核 CPU 配置,包括两颗最高频率达到 5GHz 的 Prime 核心,以及 6 颗最高频率达到 4GHz 的 Performance 核心。这是业界首次将手机 CPU 主频提升到 5GHz。
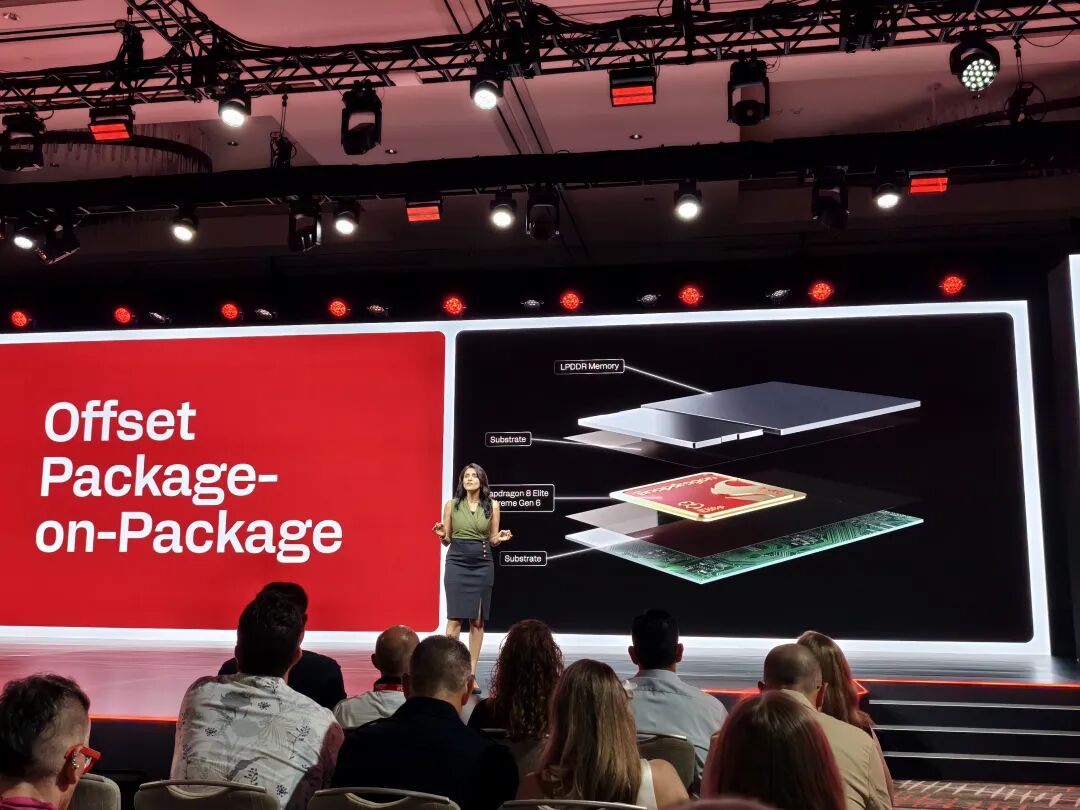
为了支持这样的峰值性能久一点,高通甚至还用到了新的封装技术。Offset Package-on-Package(Offset PoP,偏移式堆叠封装)改变了手机处理器与内存芯片原本上下堆叠的位置,将内存向一侧移动,为处理器留出了更直接的散热通道。高通表示,新封装能够使处理器在高负载下维持峰值性能的时间延长至原来的两倍以上。
缓存也要继续增加,高通引入了一项面向 Agent 工作流、视频编辑等负载的 CPU 缓存技术 Oryon FlexCache,为 CPU 配备了 16MB 共享 L2 缓存。与传统的固定缓存分配方式不同,FlexCache 允许不同类型的 CPU 核心动态访问同一个缓存资源池。当某个高性能核心需要处理大型任务时,可以使用更多缓存空间,降低访问外部内存的频率。
看起来,高通在 CPU 上的升级非常倾向于智能体的任务负载。与数据中心的 AI 算力类似,过去 CPU 主要用于通用计算,或作为 AI 计算中的辅助算力,但在智能体时代,CPU 需要负责整个任务的编排和调度,因而重要性大大提升。
GPU 方面,高通为其全新 Adreno GPU 加入了专门针对 AI 计算设计的 Adreno Matrix Cores(矩阵核心),并推出新的图形渲染技术 Adreno Neural Fusion。此外还有 18MB Adreno 独立高速显存(HPM),为 GPU 提供低延迟的片上存储资源。
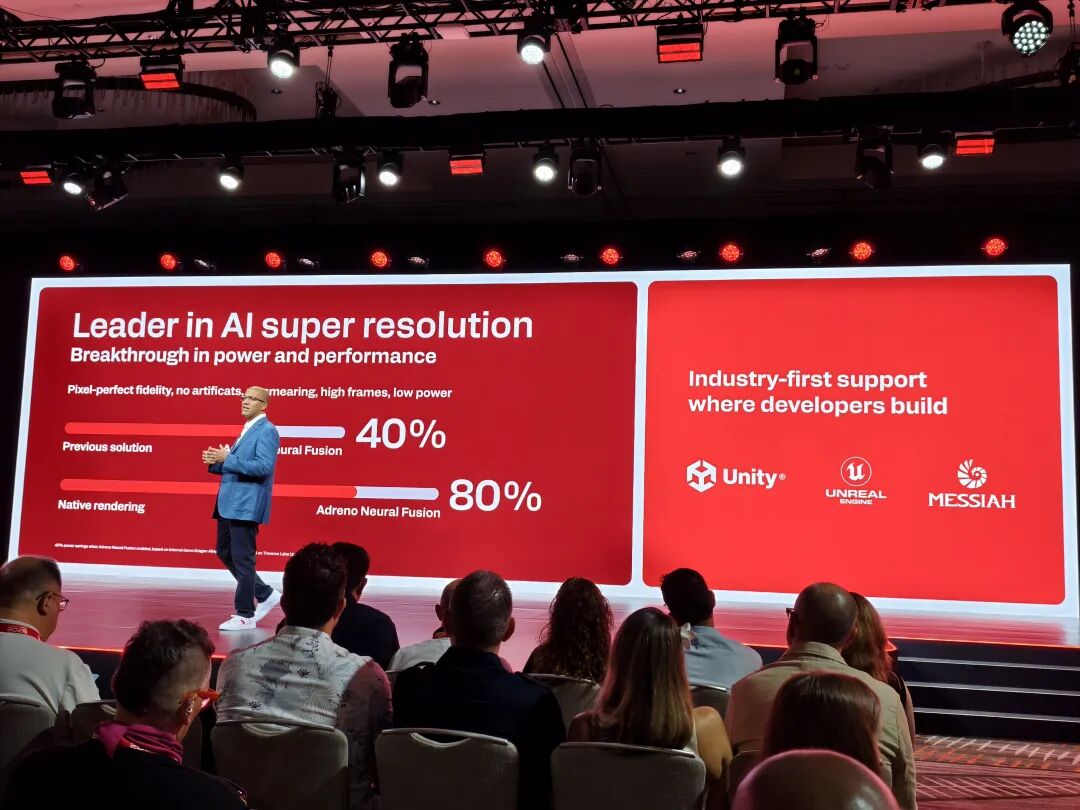
Adreno Neural Fusion 将神经网络计算、AI 超级分辨率和帧生成整合到同一条图形渲染管线中。现在,手机端游戏可以先使用较低分辨率渲染画面,再由 AI 模型重建出高分辨率图像。帧生成技术则可以根据已有画面和运动信息,生成额外的中间帧。
这使得开发者不必完全依赖传统 GPU 渲染增加画面细节,也能提升游戏的视觉表现与流畅度。类似的技术(如英伟达的 DLSS)已经出现在 PC 游戏领域有一段时间了。根据高通公布的数据,新方案在支持的游戏中最高可以实现 40% 的功耗节省。Adreno Neural Fusion 已获得 Unity 和虚幻引擎的支持,很快将在一大批手游上落地。
AI 算力方面,高通这次不仅提高了 Hexagon NPU 的计算性能,还专门针对 Transformer 架构、大规模 MoE 模型以及 AI Agent 的运行需求进行了架构调整和专门优化。
新增的 Element Accelerator 是专门针对 Transformer 相关计算进行优化的硬件加速单元,可以与原有的标量、向量及张量计算单元协同工作,提高大语言模型推理的效率。这项设计针对的不只是传统的单轮文本生成任务,还包括 AI Agent 需要处理的长上下文、多步骤推理以及多个任务之间的切换。高通表示,新平台对 INT4 模型的 Prefill(预填充)性能最高可提升 50%,并能够优化解码吞吐量。
再加上 NPU 的共享内存容量比前代增加了 50%,第六代骁龙 8 超级至尊版最多能够支持在手机端运行 30B 参数的 MoE 模型。这次落地的是 StepEdge-Omni 30B-MoE,由高通联合阶跃星辰、无量火和江波龙,基于第六代骁龙 8 超级至尊版实现。
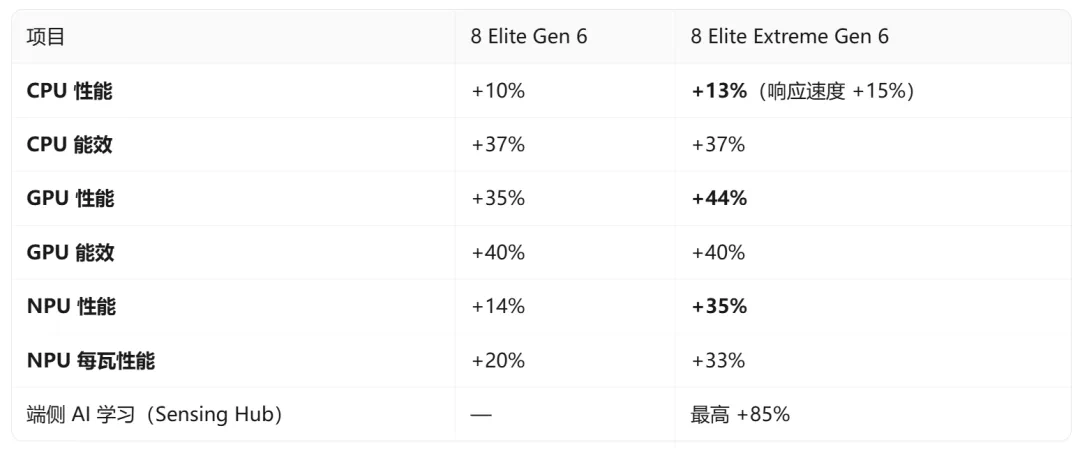
面向常规高频率的 AI 应用,高通升级了 Sensing Hub(传感器中枢),其采用双 Micro NPU 架构,支持在低功耗状态下持续处理来自传感器、麦克风等设备的信息。Sensing Hub 的性能提升幅度最高达到 85%,还支持 Qualcomm Personal Scribe(个人记录),可以帮助设备处理语音相关信息,并为个性化 AI 助手建立和维护用户情境信息。
此外在影像上,两款芯片均升级了 Spectra ISP,并引入 Intelligent Pixel Control(智能像素控制)与 Elite Color Engine 等技术。其中,Intelligent Pixel Control 进一步提高了 ISP 与 AI 计算单元之间交换信息的能力,使 ISP 能够针对图像中的不同像素和拍摄主体进行更加精细的识别和处理。超级至尊版提供更强的视频处理能力,还支持 VVC(H.266),通过提供专用硬件解码支持,手机可以减少视频播放过程中由软件解码产生的处理器负担,最高可节省 55% 的功耗。
通信方面,两款新平台均配备高通 X105 5G 调制解调器及射频系统,以及 FastConnect 8800 移动连接系统。其中 FastConnect 8800 引入 4×4 Wi-Fi 系统,支持即将确定规格的 Wi-Fi 8。
总体而言,两款芯片的 CPU、制程和基带相同,差异主要集中在 GPU、缓存、内存和 NPU 共享内存上。
与上代第五代骁龙 8 至尊版(8 Elite Gen 5)相比,性能提升如下:
这样的性能升级可以驱动更多新形态的 AI 应用。
比如未来用户在手机上收到会议邀请邮件后,Agent 可以自动理解邮件内容,提取活动时间、地点、航班和其他相关信息,开展一系列工作;Personal Scribe 能够在用户授权的情况下,处理日常对话中的信息,比如整理工作会议记录,并将相关信息组织到用户的个人知识图谱中。高通还描绘了 AI 在智能眼镜、智能手表、智能手机和汽车之间延续任务的体验。
未来的计算架构,要围绕 Agent 转了
最近,AI Agent 已经改变了人们的工作方式,它也在改变智能手机的定义。
昨天的峰会上,高通 CEO 安蒙发表了题为「Snapdragon for the Agentic Age」(面向智能体时代的骁龙)的主题演讲,介绍了高通正在推动个人计算从「手机为中心」到「以 AI Agent 为中心」的范式转变。
他回顾了高通此前对移动端 AI 发展的判断:最初,AI 主要用于增强手机拍照等已有功能,随着大模型技术的突破,高通在去年的骁龙峰会上提出了 Ecosystem of You(以用户为中心的生态)愿景。而到了今年,随着 MoE 模型、Agent、Harnes、Skills、MCP 等技术的发展,安蒙认为,端侧设备的未来形态已经开始变得清晰。
未来的设备是个什么形态?安蒙在此举的例子包括「二代豆包手机」努比亚 NaviX Ultra、荣耀 Robot Phone,还有千问还未发布的智能体电脑 Qwen Book。
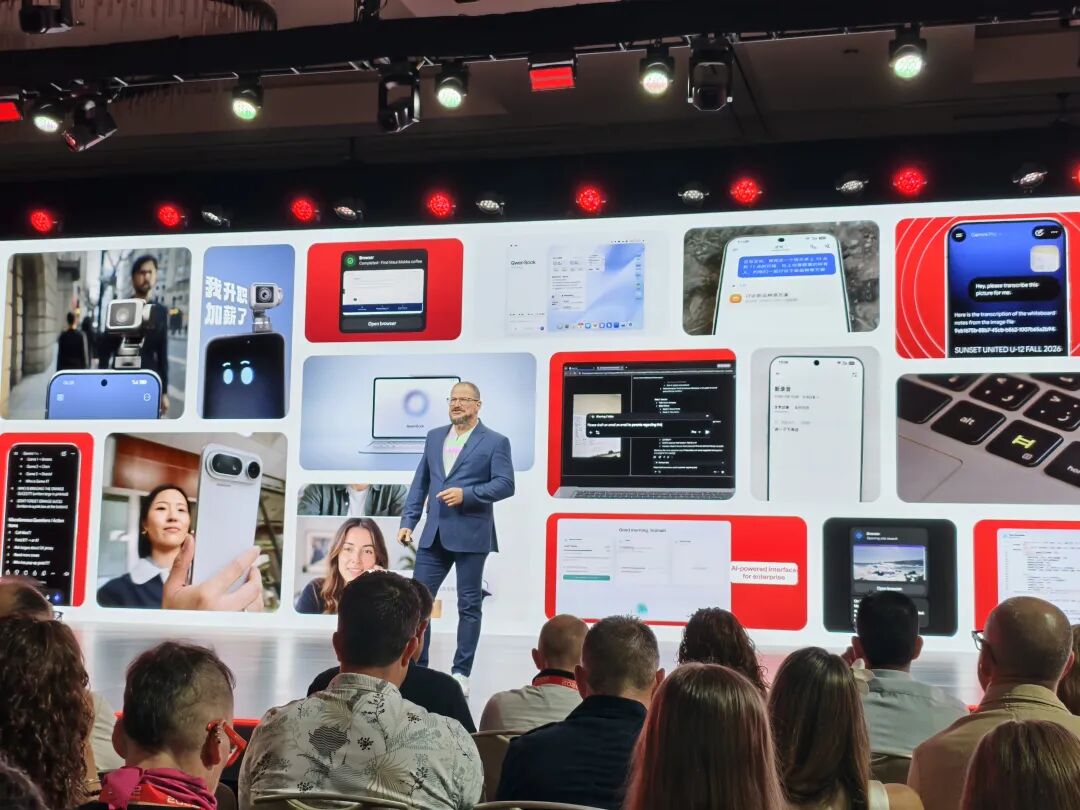
当然,它们突出的能力也会有大量落地到旗舰手机上。相较于回答问题的 AI,Agent 能够理解用户需求,并代替用户完成任务。未来评价 AI 手机的核心标准可能就是「它能帮你干多少活」。
这意味着 AI 手机并不是简单地塞进一个大模型,还需要具备长期上下文、任务规划、跨应用调用,以及在用户授权下执行操作的能力。
另一方面,未来手机承担的角色将会发生巨大的变化:既然是 Agent 驱动使用 App 等各种工具,那么手机就不再一定是用户直接操作的对象,它也可以是信息和计算的节点,由 Agent 再去驱动别的设备。
安蒙表示,Agent 时代的智能手机需要支持两个维度的使用体验:
第一个维度是直接使用。由人发起操作,手机根据指令作出响应,比如打开应用,使用手机拍摄照片、观看视频、玩游戏、处理工作等等;
第二个维度是 Agent 帮人使用手机。Agent需要持续感知环境、理解用户意图和上下文,并在必要的时候进行推理、规划、记忆和操作。
这样的前提下,移动端 Agent 就需要具备一系列能力,包括访问用户授权的个人知识,维护持续性的上下文和记忆;通过安全的权限机制,在获得授权后代表用户执行操作;理解语言、视觉、音频等不同模态的信息;协调不同模型、App、互联网服务和数据;以及在不同设备之间保持连续的用户体验。
这意味着未来即使用户没有主动操作,Agent 也可能在后台持续使用手机的计算资源。因此,未来的 AI 手机不能只依靠更大的 NPU 来解决 AI 问题,内存和能耗效率的重要性将会更加凸显出来。
有意思的是,安蒙还提出了 Agent 的普及标准:必须比用户自己操作更简单。
他以个人计算的发展史举例。过去电商交易主要在 PC 上完成,现在基本都是手机 App 了,原因之一就是手机让用户可以更加方便地完成相同任务。因此,Agent 能否成为新的任务入口,同样取决于它能否进一步降低操作门槛。
这意味着你不能再像 PC 端用智能体干活那样,向 AI 输入复杂的提示词,反复纠正它的理解,并在执行过程中多次确认执行结果。一个好用的端侧 Agent 要交互简单,能自如使用各类应用工具、云服务和 AI 模型。
当然,在后台所需要协调的能力和计算资源就会越复杂。
安蒙谈到了将原本面向数据中心的 High Bandwidth Compute(高带宽计算,HBC)迁移到骁龙平台赋能的终端设备,并为骁龙开发专门的协处理器。它将让内存与 AI 处理单元更加接近,从而提高计算速度和能效。新的计算架构有望降低 AI 模型推理时大量数据在不同计算单元之间吞吐的开销,相关技术会在下一届 MWC 上公布。
最后,未来个人 AI 的用户可以根据自己所处的环境,以及当前需要完成的任务,选择最方便的设备与 Agent 交互。它可以是手机、PC、智能眼镜、手表、其他可穿戴设备,也可以是汽车。与此同时,计算任务可以根据实际需要,在不同终端及云端资源之间分配。
在过去,高通的核心业务是为手机提供处理器、通信和多媒体计算能力。而在安蒙描绘的未来中,手机、PC、智能眼镜、可穿戴设备乃至汽车,都将成为统一个人 AI Agent 的不同交互终端。
这意味着端侧、云端和跨设备计算需要作为一个整体协同工作。
为了让开发者能够在异构 AI 算力上快速进行开发,高通致力于提供统一的开发平台。在今年 7 月完成收购 AI 领域跨硬件编译器与运行时公司 Modular 之后,昨天在演讲中安蒙直接宣布将模块化开源 Modular 的系统级编程语言 Mojo 与统一 AI 推理服务引擎 Max。
Modular 的 AI 原生软件平台与高通解决方案互补,覆盖数据中心、边缘基础设施、个人与工业 AI,其提供的技术栈作为中立的可移植编译层作用可以类比 CUDA。
结语
AI 手机已经问世几年,但如今说到各类新应用、Agent,以及跨设备、跨生态的统一体验,仍然有待更多的创新。
从此次骁龙峰会来看,围绕 AI 的计算体系正在发生变化:CPU、GPU 和 NPU 需要针对智能体的工作负载重新设计,内存、连接和能效将决定 Agent 能否持续运行,而软件与计算平台的统一,则关系到 AI 能否真正跨越不同设备、模型和应用。
进入 Agent 时代,计算平台需要解决的问题,正在从如何让一台设备运行得更快,转向如何让分布在不同设备上的计算资源,共同完成用户交代的任务。
这也是新一代骁龙芯片的演进方向,高通正在把技术布局延伸到新的计算架构、AI 软件平台,以及由手机、PC、智能眼镜和汽车组成的个人设备生态。
个人计算的竞争已经掀开了新的一页。