
GPT-6猛砍价,Opus 5.5忙“变好用”:模型价格战,已经不能只看API定价
北京时间 9 月 23 日,OpenAI 和 Anthropic 前后相隔大约一个小时发布了新一轮模型更新。
OpenAI 推出 GPT-6 Sol 和 GPT-6 Luna,将本月早些时候 GPT-6 Astra 上的部分能力继续下放:Sol 面向专业工作、Coding 和复杂 Agent 任务,Luna 则进一步压低成本,瞄准高频、大规模调用。
Anthropic 几乎同时推出的 Claude Opus 5.5,继续强化 Coding 和 Agent 能力之外,还把“Communication”单独列为重点升级方向,并进一步降低模型运行成本。
技术能力上,两家公司依然在比较模型能力、Coding、Agent 和计算机操作;但从开发者的早期反馈来看,大家对两者的关注焦点并不同。
对于 GPT-6 Sol 和 Luna,大家反复讨论的是“价格怎么还能继续降”;对于 Opus 5.5 则更受关注“上一代那些难用的问题到底修好了没有”。
模型价格战,脱离 API 价格表
GPT-6 这一轮最激进的变化首先发生在价格上。
GPT-6 Sol 的 API 输入价格从 GPT-5.6 Sol 促销价的每百万 Token 4 美元降至 2 美元,输出从 20 美元降至 10 美元;GPT-6 Luna 则从每百万 Token 0.20 美元和 1.20 美元进一步降至 0.10 美元和 0.50 美元。相比上一代,Sol 和 Luna 的价格大致又下降了一半。
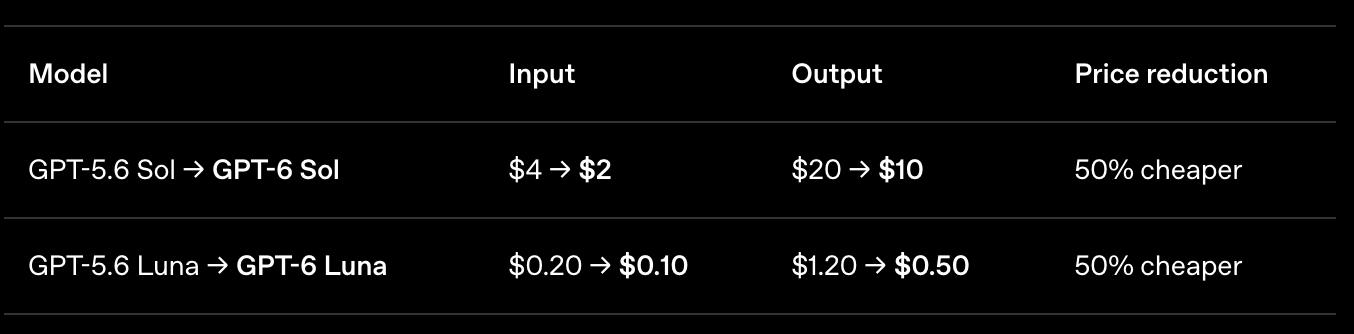
OpenAI 并没有只强调 Token 单价,而是反复用“完成一次任务多少钱”证明这一代产品的方向已经从刷新能力上限,转向整体压低 Agent 的使用成本。
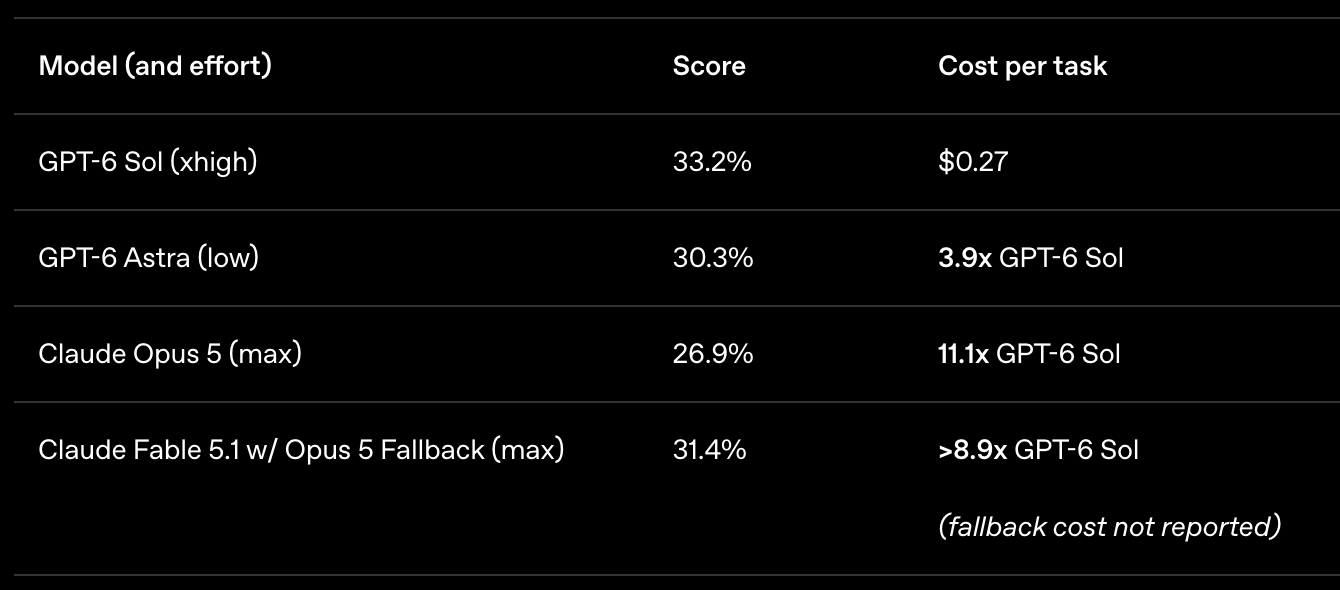
在 AutomationBench 中,Agent 需要调用 47 种工具完成销售、营销、运营、客服、财务和人力资源等业务流程。GPT-6 Sol 在 xhigh 推理强度下得分 33.2%,平均单任务成本 0.27 美元;Claude Opus 5 得分 26.9%,OpenAI 计算其任务成本约为 Sol 的 11.1 倍。Claude Fable 5.1 配合 Opus 5 回退时取得 31.4%,OpenAI 称其成本至少是 Sol 的 8.9 倍,而且这一数字还没有完整计入约 40%任务回退到 Opus 5 产生的额外费用。在覆盖 55 个细分行业的 Agents’ Last Exam 中,OpenAI 同样把重点放在“接近或超过高端模型能力,但显著降低任务成本”上。
Coding 场景更能体现这种策略。
在 DeepSWE 1.1 中,GPT-6 Sol 最高推理强度得到 68.8%,与 Claude Fable 5 xhigh 的 69.9%只差 1.1 个百分点,但 OpenAI 称其单任务成本低约 80%;GPT-6 Luna 则达到 66.6%,接近 Claude Opus 5 和 Fable 5 中等推理强度的水平,而按照 OpenAI 的测算,完成同类任务的成本分别比 Opus 5 低约 93%、比 Fable 5 低约 96%。
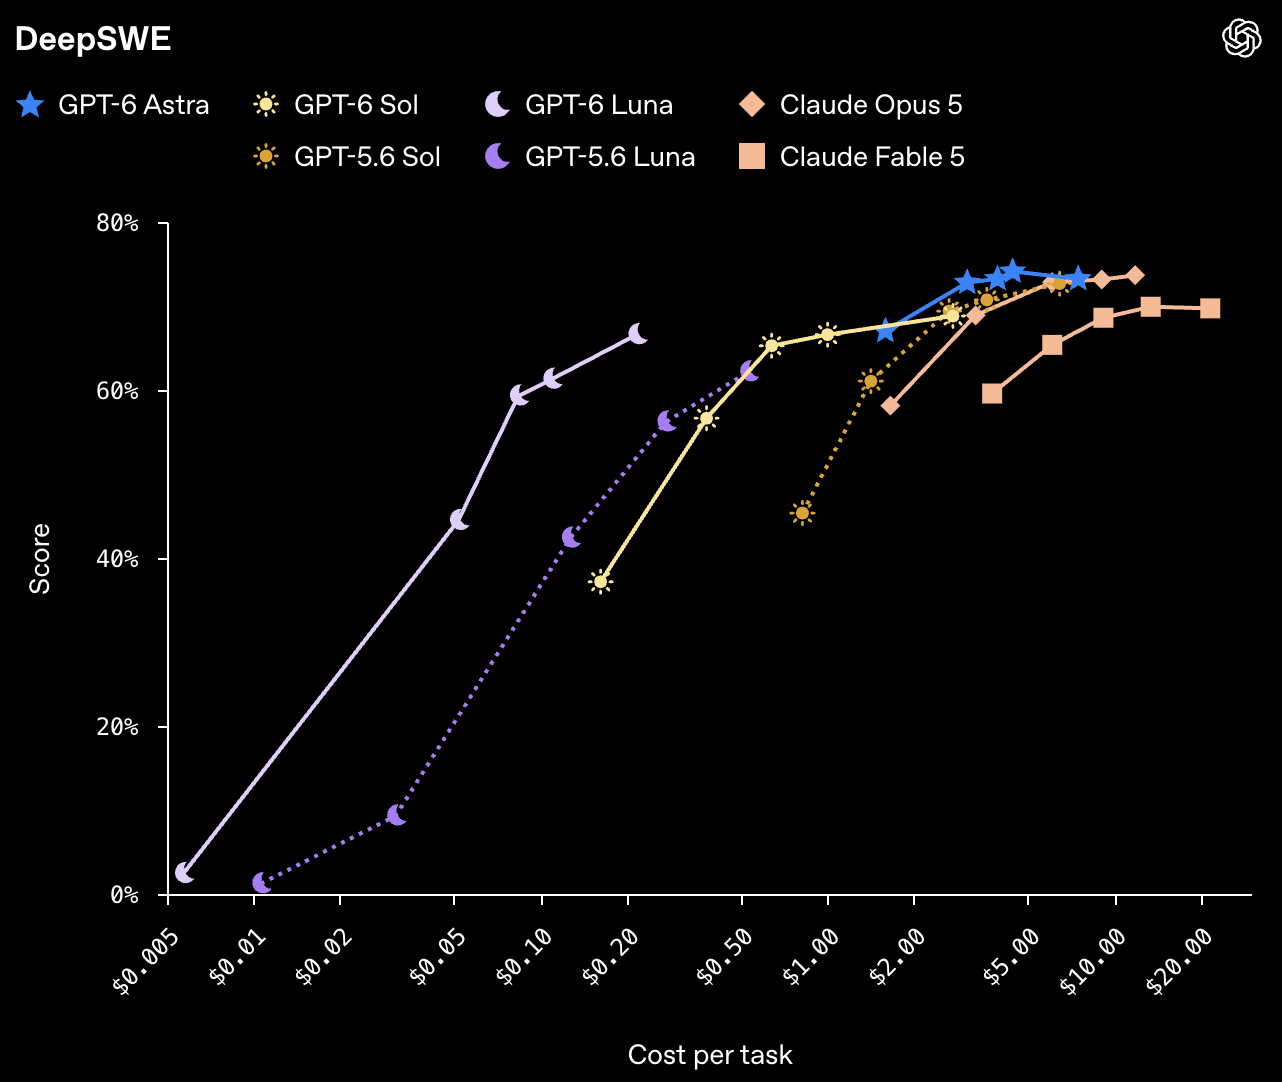
Luna 得到的正面评价尤其集中在性价比上,有用户惊讶于这样一个已经相当便宜的模型还能再次降价,也有人表示已经开始把部分生产分类任务迁移到 GPT-6 Luna。
不过,这种反馈同时暴露了 GPT-6 的另一面:一些开发者并没有感受到很强的“6 代跃迁”,原本期待 Sol 明显接近 Astra,实际体验却更像一个更成熟、更便宜的 GPT-5.6 Sol。有人干脆把这次发布概括为“主要是一次成本胜利”。
Anthropic 面对的问题则完全不同。上一代 Opus 5 并非能力不强,相反,它在不少 Benchmark 上已经处于很高位置,但真实使用口碑明显分化。
一些开发者认为它 Coding 正确性不错,却容易出现表达冗长、术语奇怪、注释过多、过度设计,以及擅自扩大任务范围等问题。甚至有用户指出,Opus 5 在不少 Benchmark 上已经与 Fable 接近,但自己在实际 Coding 中仍几乎全部使用 Fable。
因此,Opus 5.5 这次把 Communication 单独列出来并不奇怪。Anthropic 强调,新模型会减少不必要的术语和特殊措辞,把重要信息放在前面,并改善长时间协作中的可读性。
同时,Opus 5.5 典型工作负载成本相比 Opus 5 下降 40%,输出速度提升 30%以上,Cache Read 价格下降 60%。这次降价,Anthropic 也在试图解决“最强模型能不能重新变成开发者愿意连续使用几个小时的工具”的成本问题。
Coding 还是主战场,但开发者越来越不相信几分 Benchmark 差距
在 OpenAI 公布的部分 Coding 评测中,GPT-6 Sol 已经逼近 Claude 此前的高端模型。但过去几轮发布已经让很多人意识到,软件工程 Benchmark 里的几分差距,很难稳定映射到真实使用体验。
Opus 5 就是一个典型例子:它发布时拥有漂亮的成绩,但仍有不少开发者认为它在真实项目里难用;与此同时,也有另一批用户认为高推理强度下的 Opus 5 已经是非常强的程序员,甚至能够根据刚发表的论文完成算法实现。
“到底好不好用”,除了模型,也越来越依赖任务类型、代码库结构、工作流以及开发者自己的 Agent Harness,而不是一张统一榜单。这也是为什么 Opus 5.5 虽然获得了明显更积极的早期评价,社区态度仍然带有很强的“先用几周再说”。
一些长期在 Fable、Opus 和 OpenAI 模型之间切换的开发者已经考虑把 5.5 重新作为主力,也有人认为其表达风格确实改善,但“Benchmark 很好看”已经不足以直接建立信任。
Anthropic 自己也承认,当模型能力达到目前水平之后,评测之间几个百分点的差距越来越难直接映射成现实体验。
原因在于,真实软件工程从来不只是“写出一段能通过测试的代码”。历史代码、技术债、架构约束、模糊需求、团队规范、长期维护性,以及“哪些地方不能碰”,都很难被单一 Benchmark 完整覆盖。一个模型即使第一次写出的代码完全正确,如果它修改了大量无关文件、进行了不必要的重构,或者需要开发者花大量时间理解和返工,实际生产力仍可能低于一个跑分稍低、但行为更稳定的模型。
因此,Coding 模型的评价对象不再是“能不能生成正确代码”,而是 Agent 完成一次软件工程任务的全过程质量:它用了多少步骤、改了多少无关内容、有没有理解边界、是否容易复核,以及最终需要多少人工介入。
当 Agent 连续工作数小时,模型价格战开始拼“缓存阶段”
这次发布,OpenAI 开始明显把 Prompt Caching 当成 Agent 降本的核心能力,而不再只是把它当作底层推理优化。
OpenAI 披露,其内部研究人员过去一年对 Coding Agent 的使用量快速增加,如果按照 API 价格折算,一名研究人员每天使用 Coding Agent 产生的 Token 成本中位数已经超过 600 美元,前 10%的研究人员甚至超过 7000 美元。
当 Agent 开始持续运行,大量成本并不是来自新的问题,而是来自同一批代码、工具定义、历史对话和任务状态被反复重新处理。
GPT-6 因此进一步调整了 Prompt Caching 机制。已经命中的缓存输入 Token 可以获得 90%的价格折扣,同时减少重复 Prefill 带来的计算开销和延迟。
OpenAI 还新增 Prompt Caching Dashboard 和诊断工具,让开发者看到哪些 Prompt 成功命中缓存、哪些没有;过去调整 Reasoning Effort 或者动态启停工具容易让缓存失效,现在 GPT-6 可以在不破坏既有缓存的情况下调整推理强度,并通过保持工具定义稳定、动态控制工具可用性,提高缓存复用率,并允许开发者显式设置缓存前缀断点。
数据显示,过去几个月的这些改进,已经让 GitHub Copilot 在数十亿次 OpenAI 模型请求中需要重新处理的 Prompt Token 比例下降超过 50%。
这类变化也直接引起了开发者注意。一些生产 Agent 用户指出,自己的实际账单中,Cache Read 本身就可能占据相当大比例。因此,即使一个模型普通 Input Token 价格便宜一半,如果缓存利用率更低,最终任务成本也未必真能便宜一半。
Anthropic 其实也在向同一个方向调整。Opus 5.5 将 Cache Read 价格降低 60%,并不是一个孤立的价格变化,其也是在适应同一种长周期 Agent 工作负载。
对于长上下文 Coding Agent 来说,缓存利用率、上下文复用和工具调用策略正在成为与模型本身同样重要的经济变量。
都在改进使用体验
除了 Coding 和价格,两家公司这次也都在调整模型的交互体验。
OpenAI 同时把 Astra 上的部分回答风格调整带到了 Sol 和 Luna,包括减少术语堆砌、奇怪措辞和低价值细节,回答整体稍短,并在 Coding 任务中更清楚地区分“做了什么、验证了什么、哪些事情没有验证”。
这一点和 Anthropic 这次的方向其实非常接近,只不过 Anthropic 面临的是更明确的历史包袱:上一代 Opus 已经因为表达方式和工作习惯收到大量负面反馈,因此 5.5 更像一次有针对性的使用体验修复。
Opus 5.5 目前另一个争议则来自安全限制。
一些早期用户报告,普通 Bash 操作偶尔会被判断成“Third-Party Attack”,从而阻断正常工作流。Anthropic 此次进一步加入针对 Agent 每一步动作的分类器,并强化 Prompt Injection 防御。
对企业 Agent 而言,更严格的安全防护当然有现实价值,但对 Coding Agent 来说,现实的问题是:如果模型什么都会,却频繁因为安全系统不让做,那么能力本身就很难完全转化为生产力。
参考链接:
https://openai.com/index/introducing-gpt-6-sol-and-luna/