
Python 版 Lightpanda:仅需一次 pip 安装即可拥有的浏览器
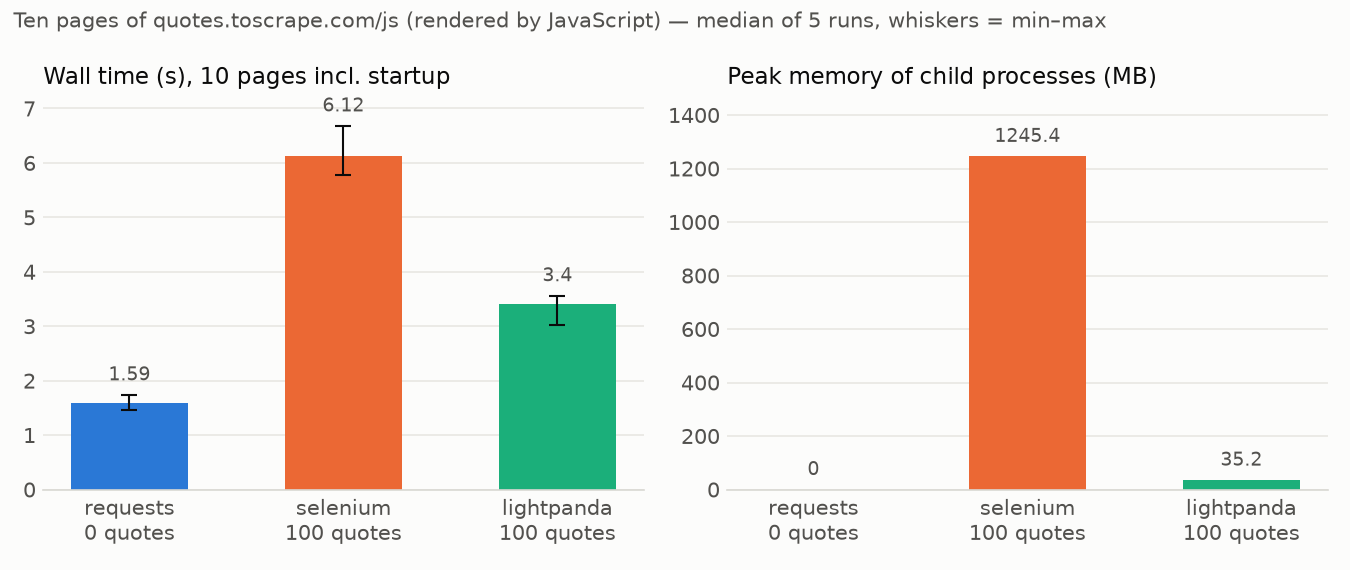
执行 pip install lightpanda 可同时安装浏览器二进制文件和 Python 绑定。一条命令,浏览器随装随用。你只需 import Browser,调用 page.goto,通过 page.extract 获取结构化数据,结果便可直接导入 pandas、numpy 或 scikit-learn。在抓取 100 条引文的测试中,Lightpanda 约 3 秒完成,内存占用 35 MB;而 Selenium 搭配无头 Chrome 约需 6 秒,内存占用 1.2 GB(5 次运行的中位数)。
网络流量正向机器化演进,而机器流量主要运行在 Python 上
如今,由代码浏览网页的比例屡创新高,其中相当一部分来自 AI agent。多数 agent 基于 Python 构建,因为模型、框架及数据工具链均沉淀于此。当你的 agent 或爬虫需要调用浏览器时,该浏览器理应与代码处于同一技术栈。
现状并非如此。常见配置是 Python 脚本通过 Node.js 进程与浏览器交互,该进程负责 Chrome DevTools Protocol(CDP)通信,并管理预先下载的 Chromium 构建版本。结果是,仅加载一个网页便需同时运行两种语言运行时环境。
Lightpanda 是一款专为机器场景从零构建的无头浏览器,不依赖图形渲染。通过 pip install lightpanda,它将浏览器直接嵌入 Python 技术栈,使开发者无需借助 Node.js 运行时即可从 Python 直接驱动页面操作。
一条命令,浏览器随行
完整安装流程仅一步:
pip install lightpanda
此命令将下载包含 Lightpanda 浏览器二进制的 wheel 包,绑定接口与浏览器引擎一站式齐备。
目前若从 Python 驱动浏览器,需分别安装客户端库、CDP 层的 Node.js 运行时,以及由库自行下载的 Chromium 构建版本。Lightpanda 的 wheel 包自带浏览器,使浏览器版本与包版本严格同步,免去维护两个独立组件的同步成本。
由于 Lightpanda 是原生 Python 模块,你现有的技术栈无需任何改动。抓取到的数据直接作为 Python 对象返回,可以无缝导入 pandas 或 numpy。
何时真正需要浏览器
并非所有抓取任务都需要浏览器。如果你要抓取的页面是服务端渲染的,直接用 HTTP 请求加 HTML 解析器会更快、更省钱,这时就该选它。但服务端渲染只覆盖了网络的一部分,远没有想象中那么普遍:Zyte《2026 年 Web 访问现状报告》发现,超过 40% 的热门落地页必须通过 JavaScript 渲染才能返回有意义的内容。在这些网站上,普通请求拿到的 HTML 要么是个空壳,要么是个验证页,只有页面脚本执行后数据才会出现。我们曾在这篇文章中讨论过这一趋势。
因此,对于 JavaScript 页面,你的选择其实只有一个:用 Selenium 或 Playwright 驱动完整浏览器。这确实能执行 JavaScript,但要配置 Node.js 客户端和下载 Chromium,对于很多轻量级任务来说实在太重了。
使用 Lightpanda 的 Python SDK,你可以在不离开 Python 环境的前提下,获得接近真实浏览器的 JavaScript 执行能力,且内存占用比 Node.js + Chrome 组合低一个数量级(参见基准测试)。
一个可运行的示例
试试 quotes.toscrape.com/js,这个页面的引言完全由客户端 JavaScript 绘制。普通 HTTP 请求拿不到任何引言,因为 DOM 要等脚本执行后才构建。
下面是用 Lightpanda 完成抓取的完整代码。Browser() 会启动内置的浏览器二进制文件,并在 with 代码块结束时自动停止。page.extract 接收一组 CSS 选择器作为 schema,并返回对应的记录:
from collections import Counter

from lightpanda import Browser

SCHEMA = {
    "quotes": [
        {
            "selector": ".quote",
            "fields": {"text": ".text", "author": ".author", "tags": [".tag"]},
        }
    ],
    "next": {"selector": "li.next a", "attr": "href"},
}

with Browser() as browser, browser.new_session() as page:
    quotes = []
    url = "https://quotes.toscrape.com/js/"
    while url:
        page.goto(url=url)
        data = page.extract(schema=SCHEMA)
        quotes.extend(data["quotes"])
        url = data["next"]

    print(f"{len(quotes)} quotes")
    tags = Counter(tag for q in quotes for tag in q["tags"])
    print("Top tags:", tags.most_common(5))
运行后就能拿到全部十页的引言:
$ python scrape.py
100 quotes
Top tags: [('love', 14), ('inspirational', 13), ('life', 13), ('humor', 12), ('books', 11)]
tags 字段声明为列表,所以 extract 会把每条引言内的所有 .tag 解析成一个 Python 列表。返回的数据结构已经可以直接交给 Counter,再进一步交给 pandas 处理。
同时抓取多个页面
如果想并行抓取多个页面而不是逐个进行,可以用 AsyncBrowser。它的所有方法都可以 await,每次调用都在浏览器自己的线程池上运行,不会阻塞事件循环。browser.session() 会打开一个限定在单个任务范围内的会话,任务结束时自动关闭:
import asyncio
from collections import Counter

from lightpanda import AsyncBrowser

SCHEMA = {
    "quotes": [
        {
            "selector": ".quote",
            "fields": {"text": ".text", "author": ".author", "tags": [".tag"]},
        }
    ],
}

URLS = [f"https://quotes.toscrape.com/js/page/{n}/" for n in range(1, 11)]

async def scrape_one(browser, url):
    async with browser.session() as page:
        await page.goto(url=url)
        data = await page.extract(schema=SCHEMA)
        return data["quotes"]

async def main():
    async with AsyncBrowser() as browser:
        results = await asyncio.gather(*(scrape_one(browser, url) for url in URLS))
    quotes = [q for page_quotes in results for q in page_quotes]
    print(f"{len(quotes)} quotes")

asyncio.run(main())
这个模式可以轻松扩展:一个浏览器、多个会话,用 asyncio.gather 一次性并发发起。
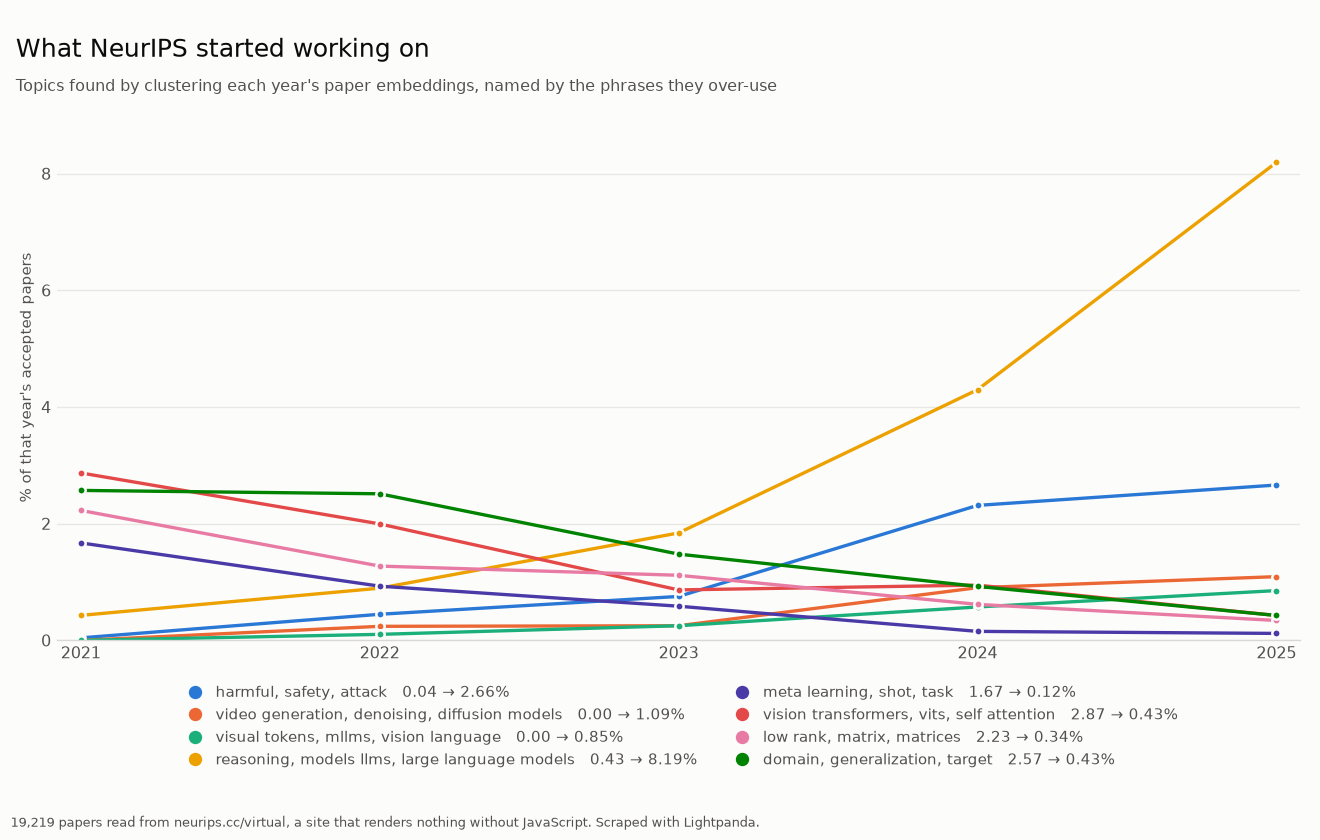
回报:普通爬虫读不到的 19,219 篇论文
我们在真实站点上验证了这一点。将 Lightpanda 指向 NeurIPS 论文集,抓取了 2021 年至 2025 年的所有论文(共 19,219 篇)。
每年的页面约有 800 KB 脚本包裹着一个空列表,并提示需启用 JavaScript 才能查看论文。使用 requests 搭配 BeautifulSoup 只能抓到零篇论文,因为在 JavaScript 执行前,HTML 中根本不存在论文内容。
仅渲染页面还不够。单一年份的页面会加载 27 MB 的索引,并将全部 5,858 篇论文保留在内存中,但屏幕上只显示 400 篇。其余论文仅存在于运行时文档中。Lightpanda 直接读取了活动 DOM 中的完整列表。
运行规模很小:每一年对应一个浏览器进程,五年并发处理。整个流程耗时约一分钟。后续处理使用标准 Python 技术栈,包括 pandas、numpy、scikit-learn 和 matplotlib,无需替换其他组件。
以下是运行结果,重现该过程的代码见 此处。
在你的爬虫中试试
Python SDK 指南 包含完整示例,运行时间约十分钟。安装该包后,将其指向当前爬虫难以处理的页面,看看返回什么。
pip install lightpanda
常见问题
pip install lightpanda 与通过 Playwright 驱动 Lightpanda 有什么区别?
lightpanda 包内置了浏览器二进制文件,并提供原生 Python API,无需配置客户端或单独下载浏览器。你仍然可以通过 Puppeteer、Playwright 或 Selenium 驱动 Lightpanda,它们通过 CDP 协议连接,但这意味着你需要运行这些客户端及其依赖项。若希望完全在 Python 内部完成所有操作,请选用 Python SDK。
Python SDK 能执行 JavaScript 吗?
可以。它运行一个基于 V8 的真实浏览器引擎,因此客户端 JavaScript 会正常执行,DOM 也会在你读取前完全构建。这正是它优于 requests 的原因,后者仅返回初始 HTML,不会运行页面的脚本。如果你已有 PandaScript 文件,可以直接从 Python 运行并获取输出结果。
与 Chrome 相比,内存占用多少?
在爬取 100 条引用的基准测试中,SDK 中位运行 5 次的结果为耗时约 3 秒、内存 35 MB;而使用 Selenium 配合无头 Chrome 则耗时约 6 秒、内存 1.2 GB。Lightpanda 没有渲染管线,而 Chrome 的大部分内存正是消耗在这里。
需要安装 Node.js 吗?
不需要。Python SDK 直接与内置浏览器通信,唯一的要求是 Python 3.10 或更高版本。
可以并发爬取多个页面吗?
可以。使用 AsyncBrowser,为每个任务通过 browser.session() 打开独立会话,然后用 asyncio.gather 并发运行。每次调用都在浏览器自身的线程池中执行,不会阻塞你的事件循环,因此在异步 Web 服务器中也是安全的。
如何获取结构化数据而非原始 HTML?
调用 page.extract 并传入 CSS 选择器构成的 schema。每个条目将字段名映射到一个选择器,若将字段声明为列表,则会解析元素内的所有匹配项。最终你会得到 Python 字典和列表,可直接用于 pandas。
如何遵守 robots.txt?
浏览器可以代你执行 robots.txt 规则。默认处于关闭状态,这与 lightpanda 二进制文件的默认行为一致,所有封装器都支持通过 args= 传递浏览器参数:
Browser(args=["--obey-robots"])                    # 也有 AsyncBrowser 版本
CDPServer(args=["--obey-robots"])                  # 也有 BiDiServer 及对应的异步版本
run_script("saved.js", args=["--obey-robots"])
网站不允许的请求会直接失败而不是被发送出去:工具调用会抛出 ToolError: navigation failed: RobotsBlocked,run_script 则会抛出 ScriptError。
开启这个功能之前有一件事需要了解,因为它很容易被误以为是 bug:这条规则会作用于