
数据、模型、算力越来越难分开,Data+AI 基础设施怎么进化?
一个具身智能的数据版本,从采集完成到真正进入下一轮模型训练,可能需要两周,甚至一个月。
在今年的云栖大会上,穹彻智能首席科学家吕峻用这样一个时间尺度,描述了具身智能数据链路的复杂程度。视频、点云持续产生,数据从采集开始,还要经历预处理、质检、标注等多个环节,一条链路中可能发生十几次甚至数十次数据调用。存储、计算与模型资源能否被高效调度,最终都会体现在模型迭代的速度上。
这让今天的 AI 基础设施面对了一个和大模型早期很不一样的问题。
过去几年,行业大量讨论 GPU 数量、集群规模、训练速度和推理成本,基础设施的中心几乎始终是模型。数据更像模型训练之前已经准备好的原料:清洗、入库、训练,整个过程相对清楚。
AI 开始进入真实世界以后,这个前提正在消失。
机器人每执行一次任务,都可能产生新的视频、点云、动作轨迹和失败样本;科学智能在探索过程中持续制造新的计算结果和实验数据;Agent 每执行一项企业任务,也会留下新的查询、调用轨迹、上下文和反馈。
数据不再只出现在训练开始之前,它开始贯穿智能产生、智能应用和下一轮优化的全过程。
阿里云智能集团研发副总裁、计算平台事业部负责人汪军华在此次云栖大会上把这条链路概括为三个阶段:从数据到智能、从智能到应用、从应用到进化。 第一个阶段里,海量数据经过处理和训练形成知识与能力;第二个阶段中,企业知识、业务数据和任务上下文帮助智能体理解业务;进入第三个阶段,应用产生的轨迹、结果和反馈重新经过筛选、评估,参与下一轮模型与智能体优化。
数据因此从模型的“输入”,变成了整个智能系统持续流动的血液。
生产训练数据,本身已经是一项复杂计算
具身智能是观察这种变化很直观的场景。
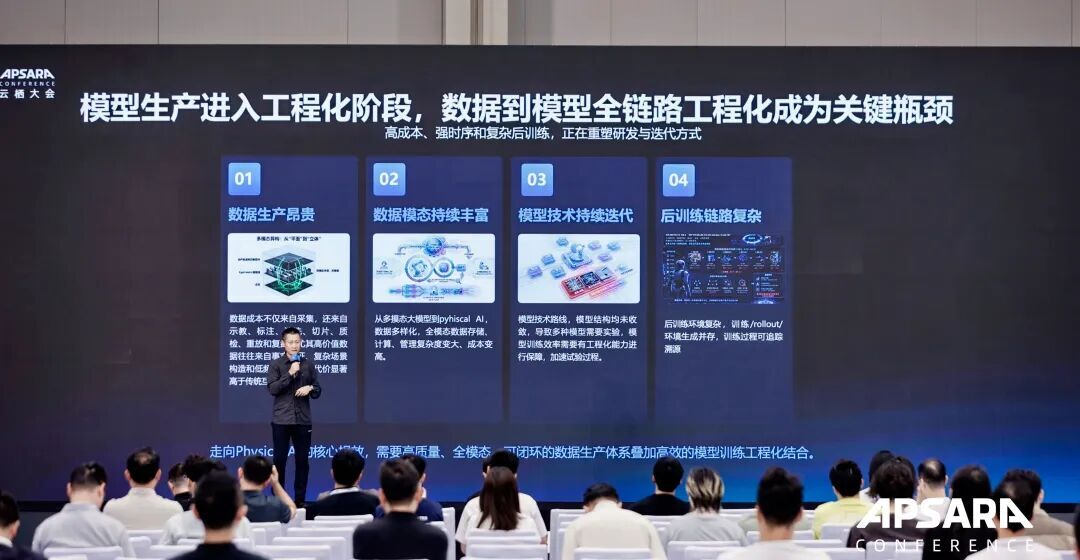
传统企业数据处理面对的主要是表、字段和日志。到了 Physical AI,原始数据开始变成视频、点云、关节轨迹、力控信号、多视角画面。它们很难通过一条固定的 ETL 流程直接变成训练集。
一段机器人操作视频,要经过画面处理、时间对齐、轨迹计算、质量检测,再进入标注;鱼眼镜头可能要先去畸变,视觉定位需要 GPU,图像处理和动作计算又大量消耗 CPU,部分数据理解和标注还会直接调用大模型。
于是,一个此前并不明显的问题浮出水面:生产训练数据,本身也开始同时消耗 CPU、GPU、模型 Token、存储与网络。
这也是阿里云此次首先升级 MaxCompute AI 计算引擎的原因。
传统大数据计算主要建立在 CPU 之上,而多模态数据的理解、筛选和标注越来越多地嵌入 AI 推理。MaxCompute 因此开始把 CPU、GPU 与大模型 Token 调用放入统一的资源调度和管理体系,同时通过 MaxFrame 和 SQL AI Function,让 Python 与 SQL 数据处理能够直接调用 AI 能力;在此基础上,再把 Coding、自动驾驶、具身智能等领域的数据处理经验封装成 Skill。
这些能力已经开始进入具体的业务场景。
在义乌小商品城的商品理解场景中,MaxCompute AI 计算引擎每天处理百万级图片,并伴随数十亿级 Token 调用;在穹彻智能的数据生产管线中,阿里云现场披露的数据吞吐提升超过 10 倍,同时利用十万级弹性算力单元支撑任务波峰。
这些数字背后,反映出的重点并非某一个算子的性能提升,而是数据处理正在从单一计算变成一种 异构资源协同问题。
穹彻智能首席科学家吕峻在接受媒体采访时谈到,具身智能目前还处于快速探索期,算法侧经常会产生新的处理算子和新的标注方法,很难提前固定一套长期不变的数据流水线。对这类公司而言,资源能否随任务临时拉起、任务结束后迅速释放,直接决定了资源会不会长期闲置,也决定一个实验能否及时开始。
更进一步,具身数据正在进入精细化管理阶段。
穹彻目前在标注环节已经基本放弃传统人工数据标注,并希望数据处理、质检也越来越多地交由模型完成。一方面,模型标注可以随需求快速扩容;另一方面,当标注规则从 A 版变成 B 版时,模型侧可能只需要调整 Prompt,而让上百人的人工团队重新理解一套细粒度规则,会产生很高的组织和管理成本。
这也重新定义了所谓的“数据墙”。
行业早期讨论数据墙,关注点更多是有没有足够多的数据。进入规模化研发以后,问题开始转向另一侧:已经拥有的大量数据,能否以足够低的成本、足够快的速度,被筛选、理解、质检、标注,并稳定转化成模型真正可以使用的数据。
从当前阶段看,数据总量已经不再是唯一短板,数据质量、精细化标注和精细化质检正在成为更现实的问题。数据质量管理本身也依赖算法,一旦发现问题,还要尽快把结果反馈回采集端,重新调整下一轮数据生产。
数据由此形成了自己的闭环。
数据墙、算法墙、算力墙,已经很难分开解决
具身智能真正走向规模化训练和应用,数据、算法和算力几乎构成了现阶段绕不开的三堵墙。数据类型越来越复杂,训练链路也在不断拉长,而大规模训练、推理和数据处理又持续抬高对算力效率的要求。
这次 PAI 的能力延伸,也基本沿着这三条线展开。PAI-EgoX 面向具身数据处理,覆盖单目、双目、多视角、鱼眼等数据,并将前后质检、数据转换等环节串联成数据管线;PAI-RoboX 进入模型训练环节,支持 VLA、世界模型、微调、强化学习和评测,并将真机数据、仿真数据与第一视角数据纳入同一套训练体系;PAI-TurboX 则继续向底层延伸,处理训练、推理与数据处理中的性能问题。
表面上看,这是三层基础设施。实际进入研发现场,三层之间的边界越来越模糊。
数据处理慢,GPU 会等待数据;模型架构发生变化,底层计算和通信策略需要一起调整;算力规模继续扩大以后,存储吞吐和数据加载速度又会反过来决定集群利用率。
汪军华在分享中提到一个很典型的问题:模型训练慢很容易被观察到,判断“为什么慢”却远没有这么简单。瓶颈可能来自基础设施,也可能来自训练框架或模型任务本身。DLC 3.0 中的 Xfuse 因此把这几层信息放在一起诊断,再由 Agent 辅助关联问题、寻找根因。
这种变化也解释了阿里云今年为什么反复强调“芯云模一体”。
模型架构持续演进,模型与硬件之间的适配问题也变得更加突出。以推理为例,一旦模型结构与硬件缓存等能力不匹配,推理效率就可能明显打折。因此,模型、云和芯片之间需要更紧密的 co-design,让硬件更好地适配模型,也让模型能够更充分地发挥硬件性能。
对客户而言,“一体”最终很少体现为一个新的产品入口,更实际的收益发生在整条链路里:数据少搬一次,计算少等待一次,框架少做一轮适配,模型和芯片之间少留一个需要工程师手动填平的缝。
在 Physical AI 之外,AI for Science 也在暴露类似问题。
无尽前延 CTO 张林峰提到,AI for Science 一端连接基础模型,另一端又大量依赖既有科学软件。相比已经被充分工程优化的 AI 软件栈,不少科学计算软件仍然效率较低、接口分散,甚至很难直接被智能体接管。对计算平台而言,工作已经不只是提供一批 GPU,还需要处理科学软件、开发环境、模型训练以及不同计算任务之间的协同。
越接近实验世界,这种复杂度越高。材料、化学、生物等领域往往同时包含计算任务和实验过程,模型输出之后还有后续验证,验证结果又会形成下一轮数据。
因此,从数据到智能正在变成一条持续运转的生产线。一次模型训练只是其中的一个环节。
从智能到应用,Agent 需要一套新的数据底座
当智能从训练阶段进一步进入企业应用,数据又发生了第二次角色变化。
过去的数据平台,本质上主要为人设计。
数据工程师开发任务,分析师编写 SQL,业务人员查看报表。人可以阅读数据字典,也可以在发现结果异常之后停下来确认口径。
Agent 开始直接访问数据后,平台第一次需要面对一种完全不同的“用户”。
阿里云资深产品解决方案总监,大数据和人工智能平台解决方案负责人魏博文把这个变化描述得很具体:人发起的 workload 通常相对确定,一次查询结束之后,人可能隔十几分钟再决定下一步;Agent 拿到结果后可以立即继续尝试第二种、第三种路径,甚至并发调用多个引擎。原本隐藏在后台的计算压力和管控压力,很可能被放大十倍、百倍。
更敏感的问题来自数据安全。对于底层数据平台,“查”与“增、删、改”的风险并不在同一级别,而智能体在不断尝试路径时,天然需要更明确的行为边界。阿里云因此提出数据沙箱,让 Agent 在受约束的环境中执行数据操作。
这让数据平台的目标从“让数据可访问”,继续向前走了一步:数据需要 Agent Ready。
此次 OpenLake 向 Agentic Lake 演进,核心逻辑也在这里。
OpenLake 原先解决的是同一份数据如何被不同计算引擎共享;Agentic Lake 开始进一步提供面向 Agent 的 Skill、接口和能力,让智能体能够发现资产、理解数据语义、调用不同计算引擎。过去 OpenLake 的主要用户集中在大数据人员,Agentic Lake 希望进一步把使用者扩展到业务人员,交互方式也逐渐从产品界面、开发工具进入自然语言和智能体工作流。
在底层,DLF 统一承载结构化、半结构化、非结构化、向量与流式数据;同一份数据可以继续进入批处理、流处理、分析、搜索和 AI 训练。融合检索把结构化条件与向量语义结合起来,选出的样本还可以直接进入后续训练链路。
数据湖仓因此多了一层新的要求:它需要向机器解释企业自己的世界。
一家公司的“收入”采用什么统计口径,某个指标对应哪张表,哪批数据拥有更高优先级,某个 Agent 对哪些数据只有读取权限——这些过去大量存在于文档、经验和组织流程里的知识,都需要被转成机器可以消费的上下文。
ADA 的定位正好位于这一层。
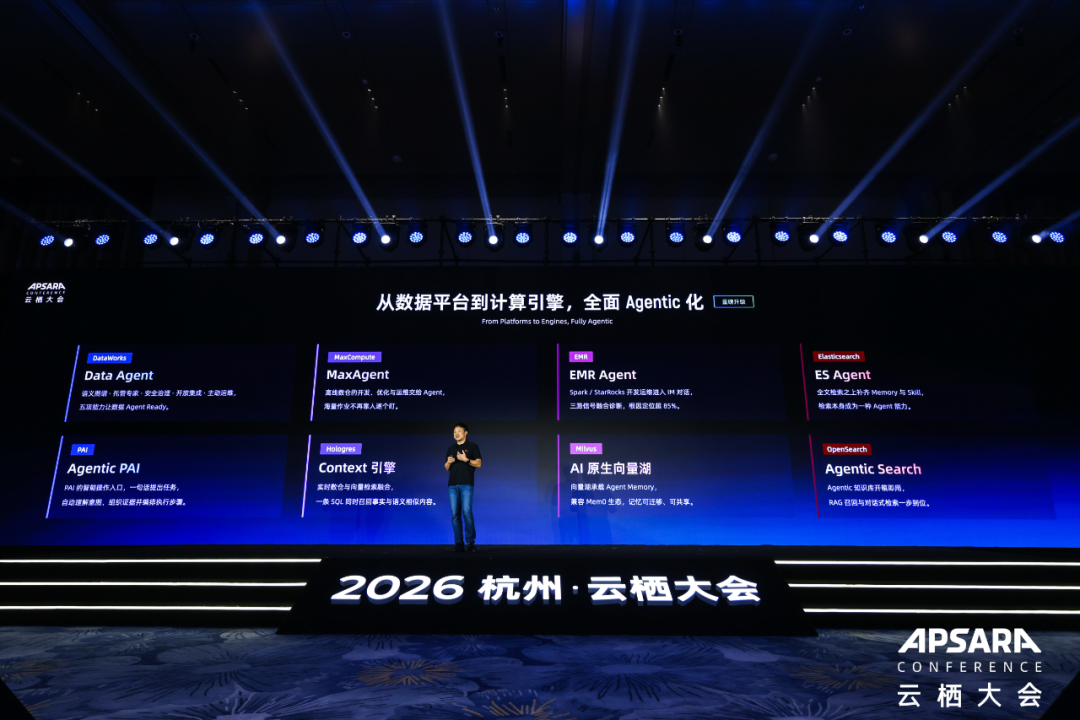
从发布架构看,ADA 通过主智能体组织 DataWorks Agent、MaxAgent、EMR Agent、Flink Agent、Hologres Agent、Agentic PAI 等专业智能体,再向下连接企业语义图谱、本体建模、语义模型、知识检索与数据资产。它要解决的并非简单地“用自然语言写 SQL”,而是让分析、工程、运维和 AI 任务在一致的业务上下文中完成,并且能够跨引擎执行和交付。
实时数据又把这个要求继续向前推了一步。
上下文并不会一直静止。订单在变化,设备状态在变化,比赛画面和事件也在变化。Flink Streaming Agent 因此把视频、音频、文件与业务流持续接入流式 AI 处理,再让 Agent 根据新的信息调整后续动作。
从这个角度看,Agent 时代的数据平台已经同时承担了三件事:存储企业事实、解释企业语义,并持续告诉智能体此刻发生了什么。
进化的起点,是把每一次应用重新变成数据
数据真正贯穿完整链路,还差最后一步:应用产生的东西能不能重新回来。
Agent 执行一次任务,会留下工具调用、运行轨迹、结果和反馈;模型训练会暴露新的性能瓶颈;数据引擎每天又会面对不断变化的查询模式。
这些都属于新数据。
阿里云把这一阶段称为“从应用到进化”。新数据与新负载持续涌入以后,依赖少数专家反复调参的方式越来越难跟上系统变化,基础设施需要把观察、诊断、尝试和验证变成可持续的工程过程。
PAI-CrystalLLM 是这种思路在训练侧的体现。
它给大模型训练造了一座“风洞”:真正启动大规模集群之前,先利用少量 GPU 高保真模拟大规模训练行为,提前观察迭代时间、显存占用、通信和 MoE 均衡等问题。阿里云现场披露的内部测试数据显示,32 卡即可仿真 8192 卡训练,资源节省超过 99%,迭代时间预测误差为 0.58%,峰值显存误差低于 0.01%。
这里更重要的一点,是大规模训练的试错成本开始下降。
过去一个工程师提出新的并行策略,需要在真实集群里验证;一次判断错误,就可能消耗大量计算资源。风洞把一部分试错提前到了更便宜的环境里,也为后续系统自动寻找更优方案提供了空间。
Hologres 则把同样的思路放到了数据引擎自身。
它让 AI 分析真实 workload,发现瓶颈,生成候选方案,再经过最小实现、正确性门禁与性能验证决定是否沉淀。失败方案同样会成为下一轮优化的反馈。在 TPC 优化实践中,这一循环带来了 3.2 倍性能提升;随后公布的 TPC-H 3000GB 结果中,Hologres 以 8,443,627 QphH 的性能成绩和 390.47 CNY/kQphH 的性价比成绩位列对应榜单第一。
值得注意的是,它和传统自动化之间也出现了一条重要分界。
传统自动化通常执行工程师事先写好的规则;这类自进化系统开始根据真实负载寻找问题,再提出、测试和筛选新的优化策略。在 AI 训练链路里,Agent 已经可以自动插入 Profiling,分析性能瓶颈,再调用平台提供的 Skill 重构训练任务,并把优化前后的性能变化形成报告交给用户。
人依然掌握最终决策,但大量过去依赖专家手工完成的分析和试错,开始进入机器可执行的闭环。
一次智能迭代,到底有多长
“数据、智能、进化”最终指向的是一条持续循环的链路:数据产生智能,智能进入真实业务,新的数据和反馈再回到系统。
这也在改变 AI 基础设施的评价尺度。训练用了多少张卡、GPU 利用率有多高、推理延迟还能压低多少,仍然重要。随着 AI 进入真实生产,另一项能力正在变得更关键:从新数据产生,到完成处理、训练和优化,再形成下一版模型能力,整个周期能被压缩到多短。
未来基础设施的效率,很大程度上就体现在这里。AI 基础设施的竞争单位,正在从“一次计算”逐渐变成“一次智能迭代”。
阿里云此次把数据基础设施、AI 计算、Agentic Lake、模型训推与系统自进化放进同一条链路,核心也在于缩短这一周期。数据流动、计算调度和反馈闭环的效率,正在直接影响智能演进的速度。
在当天的演讲最后,汪军华用 “Own Your Data. Own Your Intelligence.” 作结。企业需要掌控自己的数据,也需要掌控自己的智能,不只是调用外面的大模型,而是让智能真正服务于自己的业务。