
使用 NodeWright 管理 Kubernetes 节点集群
Kubernetes 管理的是节点上运行的工作负载,但节点本身的管理才是难题所在:内核参数、系统软件包、存储布局、安全代理以及 GPU 工作负载所依赖的宿主机调优。许多团队使用 Ansible 剧本、自定义脚本和手动运维手册来管理这些。这种方法在最初是可行的,但当一个新集群在不同区域建立、内核升级导致 RDMA 故障,或者本周需要在全集群范围内紧急修复某个 CVE 时,就会变得难以为继。
GPU 基础设施让挑战更加严峻。你不能简单地丢弃一个 GPU 节点并重新创建一个新的,因为硬件资源稀缺,更换可能耗时数小时,且长期运行的训练任务无法简单重调度。因此,运维问题的核心不是如何改变一个节点,而是如何在不中断训练任务的情况下改变所有节点。目前,答案通常是电子表格、维护窗口,以及一名工程师在凌晨三点盯着终端。
NVIDIA DSX 平台帮助你设计和运营 AI 工厂,将整个设施视为单一系统而非机器的集合。宿主机配置遵循同样的逻辑:变更的单位是集群(fleet)而非单个节点。NVIDIA 的 DSX OS 是开源软件层,其中的 NodeWright 项目负责配置和更新底层的宿主机操作系统。
从脚本到声明式节点管理
DSX OS 通过一套涵盖 AI 就绪基础、资源与工作负载编排及生产级 AI 服务的模块化开源项目组合来解决这一挑战。AI 就绪基础定义、配置、验证并保障加速型 Kubernetes 基础设施。NVIDIA GPU Operator、NVIDIA Network Operator、Topograph、NVIDIA GPU DRA 驱动、NodeWright、NVIDIA 集群就绪引擎 (NVCRE) 以及 NVSentinel 共同提供了支撑性的基础设施能力。
NodeWright 能够以声明式方式配置和更新 Kubernetes 节点操作系统,且不会干扰工作负载。它是一款开源的、原生支持 Kubernetes 的软件包管理器,旨在大规模修改和维护主机基础设施。可以将其视为整个集群版本的 apt 或 yum:它不仅感知工作负载状态和中断预算,还能在节点集群中逐步推送变更。
NodeWright 已在 NVIDIA 生产环境中作为 Skyhook 投入使用,现已开源。本文正式启用 NodeWright 这一名称。
为什么 Kubernetes 需要自己的包管理器
配置机器已经有不少优秀的工具了。Ansible 和 Puppet 在这个领域已深耕多年。但它们的设计初衷是单独管理机器,而非像集群那样管理正在运行敏感工作负载的节点组。
当你需要在 200 个 GPU 节点上更新内核参数时,难点不在于运行脚本,而在于如何做到不干扰这些节点上的训练任务。传统的配置管理工具并不理解 Kubernetes,它们不会在变更前隔离(cordon)节点,不会等待关键 Pod 结束,也不会在重启前驱逐工作负载。它们无法在集群内部追踪成功或失败,而你的其他可观测性数据正集中在集群里。
NodeWright 弥补了这一空白。它管理主机层面变更的全生命周期,涵盖安装、配置、升级和卸载。在此过程中,它严格遵循工作负载所依赖的 Kubernetes 原语,如 PodDisruptionBudgets、节点选择器、污点(taints)和容忍(tolerations)。NodeWright 的软件包定义为自定义资源(Custom Resources),因此它们的部署方式与集群中的其他资源一致:通过 kubectl、Helm、Argo CD、Flux 或你正在使用的任何 GitOps 工具。
NodeWright 的工作原理
NodeWright 由三个主要组件构成:Operator(控制器)、自定义资源和软件包。
Operator 是一个 Kubernetes 控制器,负责监听 NodeWright 自定义资源,并管理节点间变更的生命周期。软件包是承载实际修改内容的容器镜像,包括脚本、配置文件和二进制文件。软件包还包含验证脚本,当修改出现错误时,这些脚本会暴露故障并停止推送流程。
apiVersion: nodewright.nvidia.com/v1alpha1
kind: NodeWright
metadata:
  name: gpu-node-tuning
spec:
  nodeSelectors:
    matchLabels:
      nodepool: gpu
  interruptionBudget:
    percent: 33
  podNonInterruptLabels:
    matchLabels:
      workload: long-running-training
  packages:
    nvidia-tuned:
      version: 0.9.0
      image: ghcr.io/nvidia/nodewright-packages/nvidia-tuned
应用 NodeWright 自定义资源后,operator 会在每个目标节点上按精心设计的流程依次执行操作。图 1 展示了完整流程,以及受保护的工作负载如何暂停该流程。
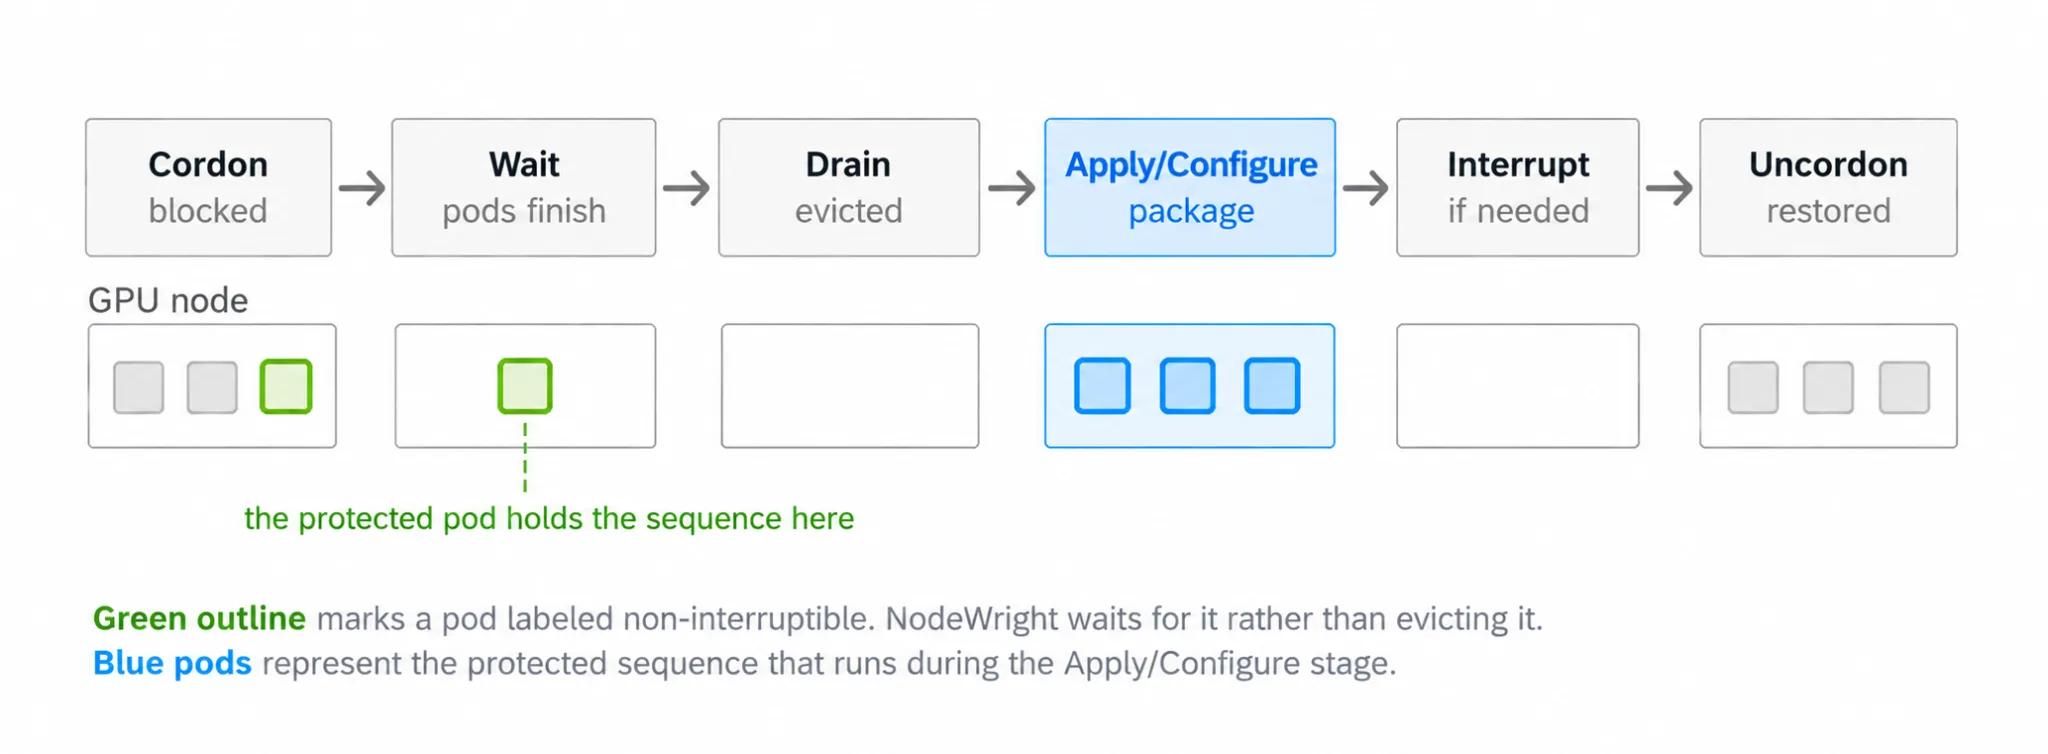
- Cordon(封锁)。将节点标记为不可调度,避免新的工作负载调度到该节点上。
- Wait(等待)。让关键工作负载平稳结束。你可以通过标签声明哪些 Pod 绝不能被中断。
- Drain(驱逐)。驱逐剩余的 Pod,默认遵循 PodDisruptionBudget,默认行为不够用时还可自定义 drain 行为。
- Apply and configure(应用与配置)。运行软件包:设置内核参数、安装 agent、配置系统服务。
- Interrupt(中断)。如果变更需要,则重启服务或重启节点。
- Uncordon(解除封锁)。将节点重新加入集群,恢复调度工作负载。
这套流程的意义在于:既可能因为一次内核更新损失半程训练,也可能在整个节点集群上无损完成同样的更新——区别就在这里。
NodeWright 包能够执行多种通常需要 root 权限的宿主级操作,且无需重置节点。它支持配置 sysctl 和 GRUB 参数、设置崩溃转储收集、创建逻辑卷、安装安全代理、修复 CVE 以及其他系统级配置任务。NodeWright 会追踪每个节点上所有包的状态和语义化版本,从而区分全新安装、升级和降级操作。此外,包还可以声明依赖关系,NodeWright 将据此确定正确的执行顺序。
验证功能已内置于包生命周期中。应用、配置、升级、卸载及中断后恢复等操作,均可配合检查机制来验证预期的节点状态,并通过 Kubernetes 暴露故障。例如,CVE 修复包可以检测易受攻击的内核模块是否仍处于加载状态,若检测到则标记该包为失败。这样运维人员能即时感知受影响的节点,而无需等待工作负载失败后才发现问题。
当集群扩展时,同样的模型也适用于节点就绪管理。新置备的节点可能在完成必需的配置和调优之前就可被调度。NodeWright 可要求新节点加入集群时携带 Kubernetes 污点(taint),在完成必需的包操作和验证检查并确认节点通过后才移除该污点。这构建了一条从已置备到已配置、再到已验证、最后可调度的可控路径,确保新容量在真正就绪前不会承接生产工作负载。
大规模下的安全发布
将变更推送到单个节点很简单,但推送到一千个正在运行生产训练任务的 GPU 节点则是另一回事。
NodeWright 的 DeploymentPolicy 资源提供了渐进式发布策略,用于控制变更在机群中的传播方式。你可以定义隔间(compartment),即通过标签选定的具名节点组,每个隔间拥有独立的中断预算和发布策略。图 2 展示了可用的三种策略。
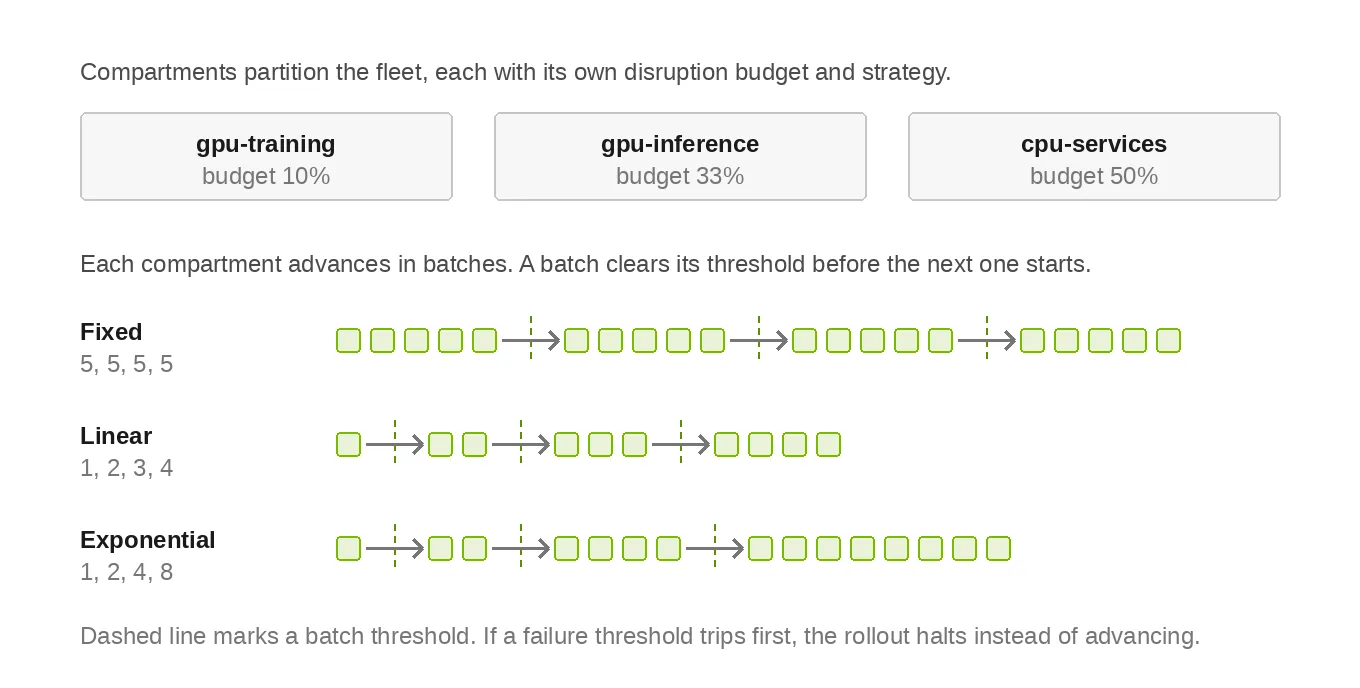
图 2。Compartments(分区)将集群划分,每个分区拥有独立的策略与预算。批次阈值设定了推进更新所需的最低成功率,失败阈值则会在连续批次失败次数过多时停止该分区
- 固定(Fixed)。 批次大小保持不变。每次固定更新五个节点。
- 线性(Linear)。 按固定增量增加批次。从 1 开始,然后 2,再 3,随着过程逐步建立信心。
- 指数(Exponential)。 按增长因子倍数增加批次。从 1 开始,然后 2,4,8。一旦信任建立,加速很快。
每种策略都包含批次阈值,即进入下一批次前所需的最低成功率。可选的失败阈值会在连续批次失败次数过多时停止该分区。风险容忍度由你设定,NodeWright 负责强制执行。
这意味着你可以用单个金丝雀节点启动全集群内核更新,验证其健康状况后,让更新自动加速。
如果出现问题,更新会停止而非级联失败。NodeWright 会在状态中报告错误,标记失败的 Jobs,并为每个受影响的节点添加标签和条件。你可以快速通过 Kubernetes API 识别和排查原因。
NodeWright 软件包与 NVIDIA AI 集群运行时
NodeWright 是一个多功能的软件包管理平台。由于软件包执行的操作需要 root 权限,宿主修改直接依赖于原生 Kubernetes 原语:细粒度 RBAC 控制用户权限,准入控制器校验规格,集成验证检查确保每一步的状态一致性。公共软件包仓库提供了运行 shell 命令、管理 bind mounts 以及建立内核崩溃转储收集器等模块化基础组件。
NVIDIA 还基于其团队大规模运营 GPU 集群积累的实践经验,发布了一系列调优包。
这些调优包采用意图驱动的设计。你不需要指定某个配置档案,只需声明所用加速器及其用途,例如 NVIDIA Blackwell GPU 加上多节点训练,调优包就会自动组装出合适的配置:内核参数、电源管理和系统设置。其覆盖范围包括 NVIDIA Hopper 和 Blackwell GPU,为任意 NVIDIA GPU 提供通用基线配置,并针对不同云环境提供变体。还有一个专门的包,用于运行 Container-Optimized OS 的 Google Kubernetes Engine(GKE)节点——这类环境无法使用常规的调优工具栈。
节点初始化包则针对特定的云与加速器组合自动完成引导步骤,比如为搭载 NVIDIA Hopper 或 Blackwell GPU 的 Amazon Elastic Kubernetes Service(Amazon EKS)集群处理内核版本管理和 Elastic Fabric Adapter(EFA)驱动安装。
这些包只是一个更大体系的一部分。NodeWright 与 NVIDIA AI Cluster Runtime(AICR)集成。AICR 会记录经过验证的驱动、Operator、内核和系统配置组合,并以版本锁定的"配方"形式发布。其组件目录会同时锁定 NodeWright Operator 和承载环境特定调优的 NodeWright 定制项,然后将它们渲染成可直接部署的 bundle,支持 Helm、Argo CD、Flux 或 Helmfile。NodeWright 负责将这些配方中主机层面的部分应用到运行中的节点上。
NVIDIA 的两个配套开源项目——NVCRE 和 NVSentinel——补全了这个生态。NVCRE 负责工作负载运行前的验证,确保加速基础设施达到生产可用状态;NVSentinel 则监控运行时故障,并支持 cordon、drain 和修复操作。与 NodeWright 一起,这些工具为 GPU 加速的 Kubernetes 集群提供了配置、维护和自愈能力。
需要说明的是,NodeWright 并不取代 NVIDIA GPU Operator 或 NVIDIA Network Operator,它管理的是这两者之下的主机操作系统层。
开始使用
NodeWright 可通过 Helm 安装到任意 Kubernetes 集群。Chart 以 OCI artifact 形式分发,无需添加任何仓库:
helm install nodewright oci://ghcr.io/nvidia/nodewright/charts/nodewright \
  --version <chart-version> \
  --namespace nodewright \
  --create-namespace
接下来,定义一个 NodeWright 自定义资源,指定要应用的软件包,通过标签筛选目标节点,剩下的工作交给 Operator 处理。
- NodeWright 仓库: 源码、问题反馈及讨论区
- 软件包仓库: NVIDIA 及社区提供的软件包
- NodeWright 文档: 架构设计、CLI 参考及部署策略
- NVIDIA AI 集群运行时: 更广泛的经过验证的配置系统
参与社区
NodeWright 采用 Apache 2.0 许可证,是 DSX OS 的一部分。DSX OS 是一个开源项目组合,涵盖 AI 就绪基础架构、资源与工作负载编排以及生产级 AI 服务。你可以单独采用某个项目,集成多个项目,或将它们组合成一个平台。其价值在于开放的接口、独立的采用方式以及一致的生命周期管理,而非单一大而全的栈。
在客户级规模下运行该技术栈能尽早暴露故障模式,NVIDIA 团队会与社区分享这些观察结果。软件包仓库正是 NodeWright 实现这一目标的地方。NodeWright 团队特别关注目录尚未覆盖的硬件与云组合的软件包,以及来自运维人员的调优配置,特别是那些团队尚未充分理解的配置场景。
Kubernetes 改变了团队管理负载的方式。但底层节点——尤其是运行高负载 AI 任务的 GPU 节点——仍依赖脚本和人工手册。NodeWright 将同样的声明式、自动化且安全的方法延伸到了主机层。采用你需要的部分,帮助塑造未来的方向。
项目参考: NodeWright 仓库 和 NodeWright 软件包仓库。