
Token 成本过低,已难以作为计量单位
机器学习智能的使用价格每年下降好几个数量级,丝毫没有放缓的迹象。 未来一两年内,LLM 很可能作为基础设施融入计算的方方面面,而不仅仅是一款产品。 未来 3-6 年内,LLM 很可能以当前旗舰级的质量在普通消费级硬件上本地运行。 很快,AI 1 使用的瓶颈很可能是质量和获取渠道,而不再是 token 数量的多少。
这真的在发生吗?
惊人的论断需要惊人的证据,所以我收集了一大堆证据。
AI 可以是闭源的(如 GPT-6 Astra),也可以是开放权重的(如 GLM-5.3-flash)。 开放权重模型可以托管在云端(例如由 Z.ai 提供),也可以本地运行。 一般而言,面向本地运行的模型要小得多,比如 Muse Glimmer 或 Qwen3 Coder。
其中一方面的进步并不总能带动其他方面。
影响所有 AI 的进步
GPU
每一代 GPU 的能效都在指数级提升。
在下图中(来源),X 轴是时间,Y 轴是 GPU 本身的能效,数值越高越高效。
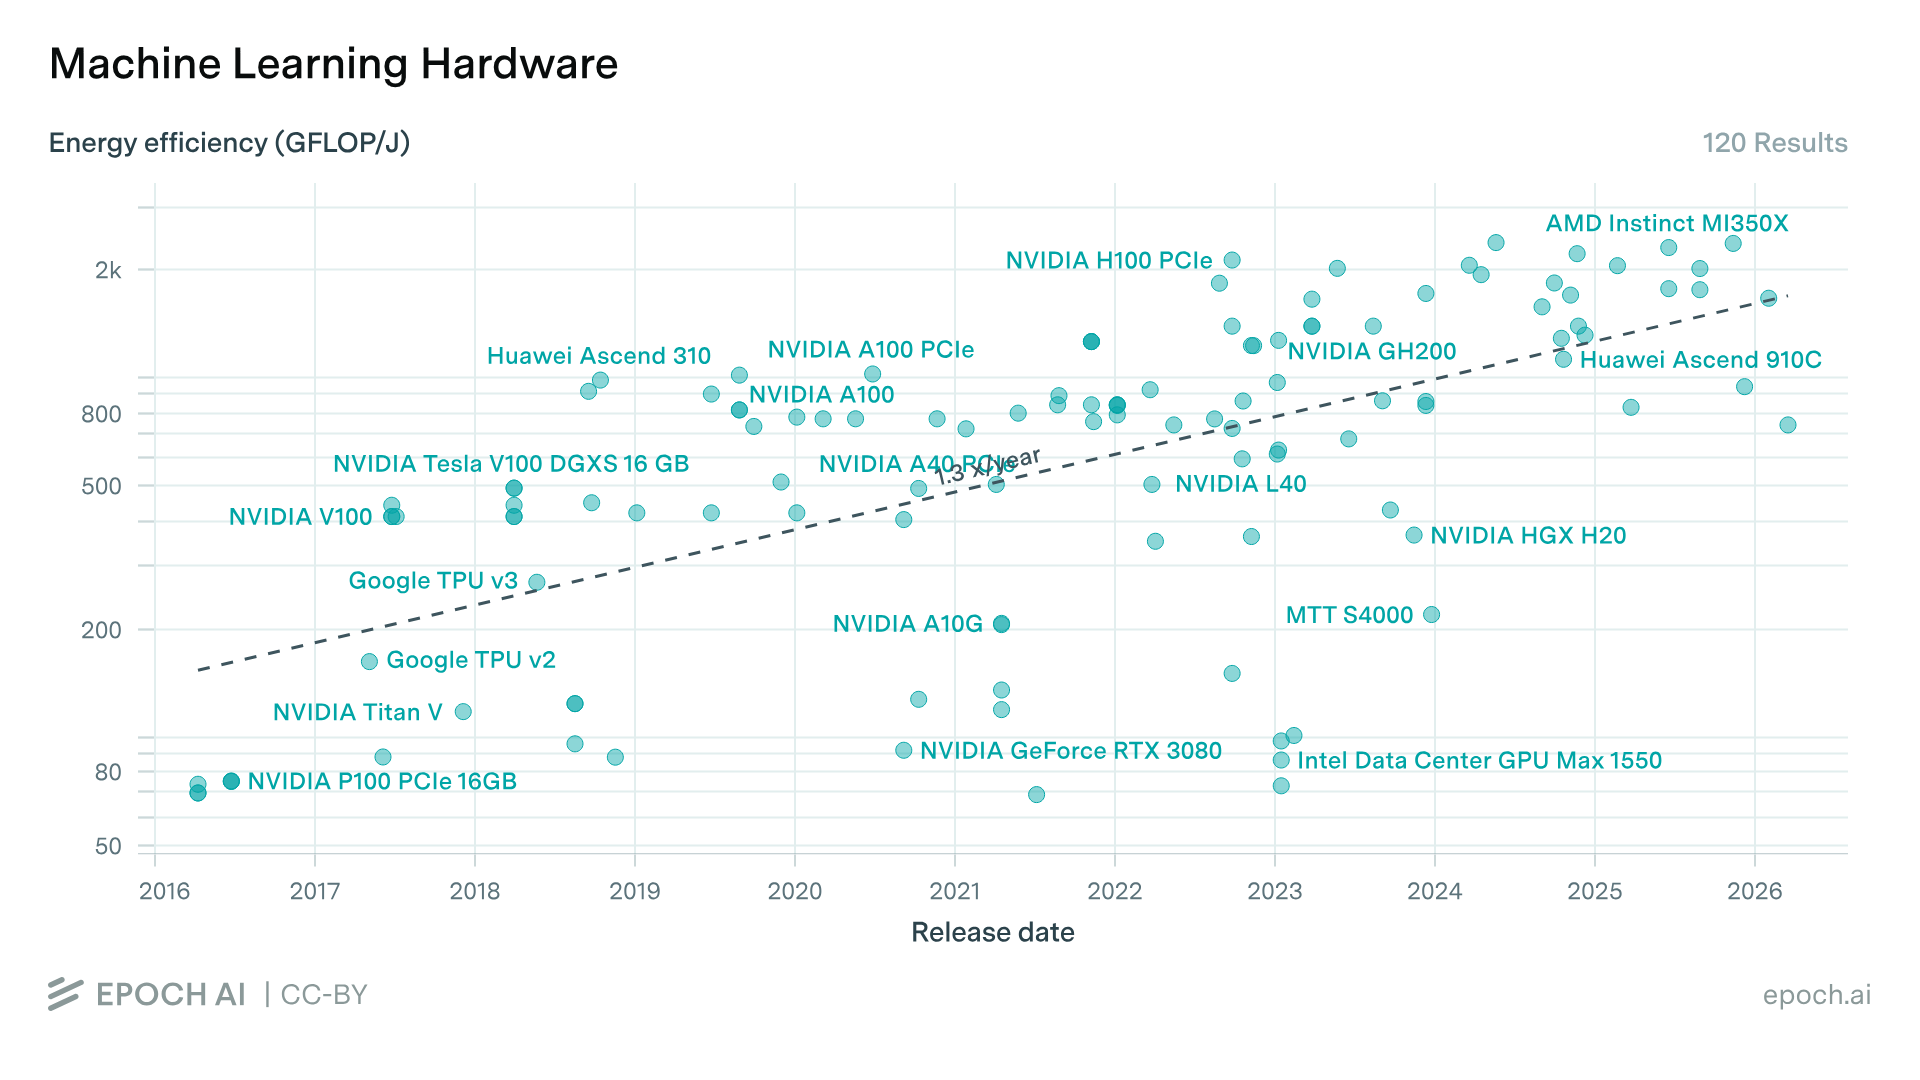
这是一张对数坐标图,也就是说,图上的直线代表能效呈指数增长。在这个具体案例中,对数的底是 1.3,意味着大约每两年能效翻一倍。
这种效率提升速度,自 20 世纪 60 年代的摩尔定律以来前所未见。
模型
用模型完成给定任务的成本正在快速下降。
模型通常按 token 计价。token 是词的碎片,表示一个单词大约需要 1.5 个 token。模型每读取一个 token、每输出一个 token,「模型提供方」(如 Anthropic 或 OpenAI)都会向你收取固定的费用。
各模型的单 token 成本并没有持续下降,至少在“前沿”级最强大模型上并非如此。 但完成单个 任务 的成本确实在降。 虽然小模型的单 token 成本更低,但为了完成同样的任务,它们通常需要消耗更多 token,因为需要更深入的思考或反复修正初稿。 本部分关注的是从头到尾完成任务的综合成本。
下图(数据来源)展示了当前“任务成本/智能比”的 帕累托前沿。 帕累托前沿展示的是你能获得的最佳 权衡 组合,而不仅仅是某单一指标的最优值。 在这里,我们需要权衡的是:
- 纵轴:模型的“智能”水平(通过基准测试套件衡量)
- 横轴:完成这些基准测试所需的成本
成本采用对数刻度。 纵轴数值越大、横轴数值越小,代表表现越好。
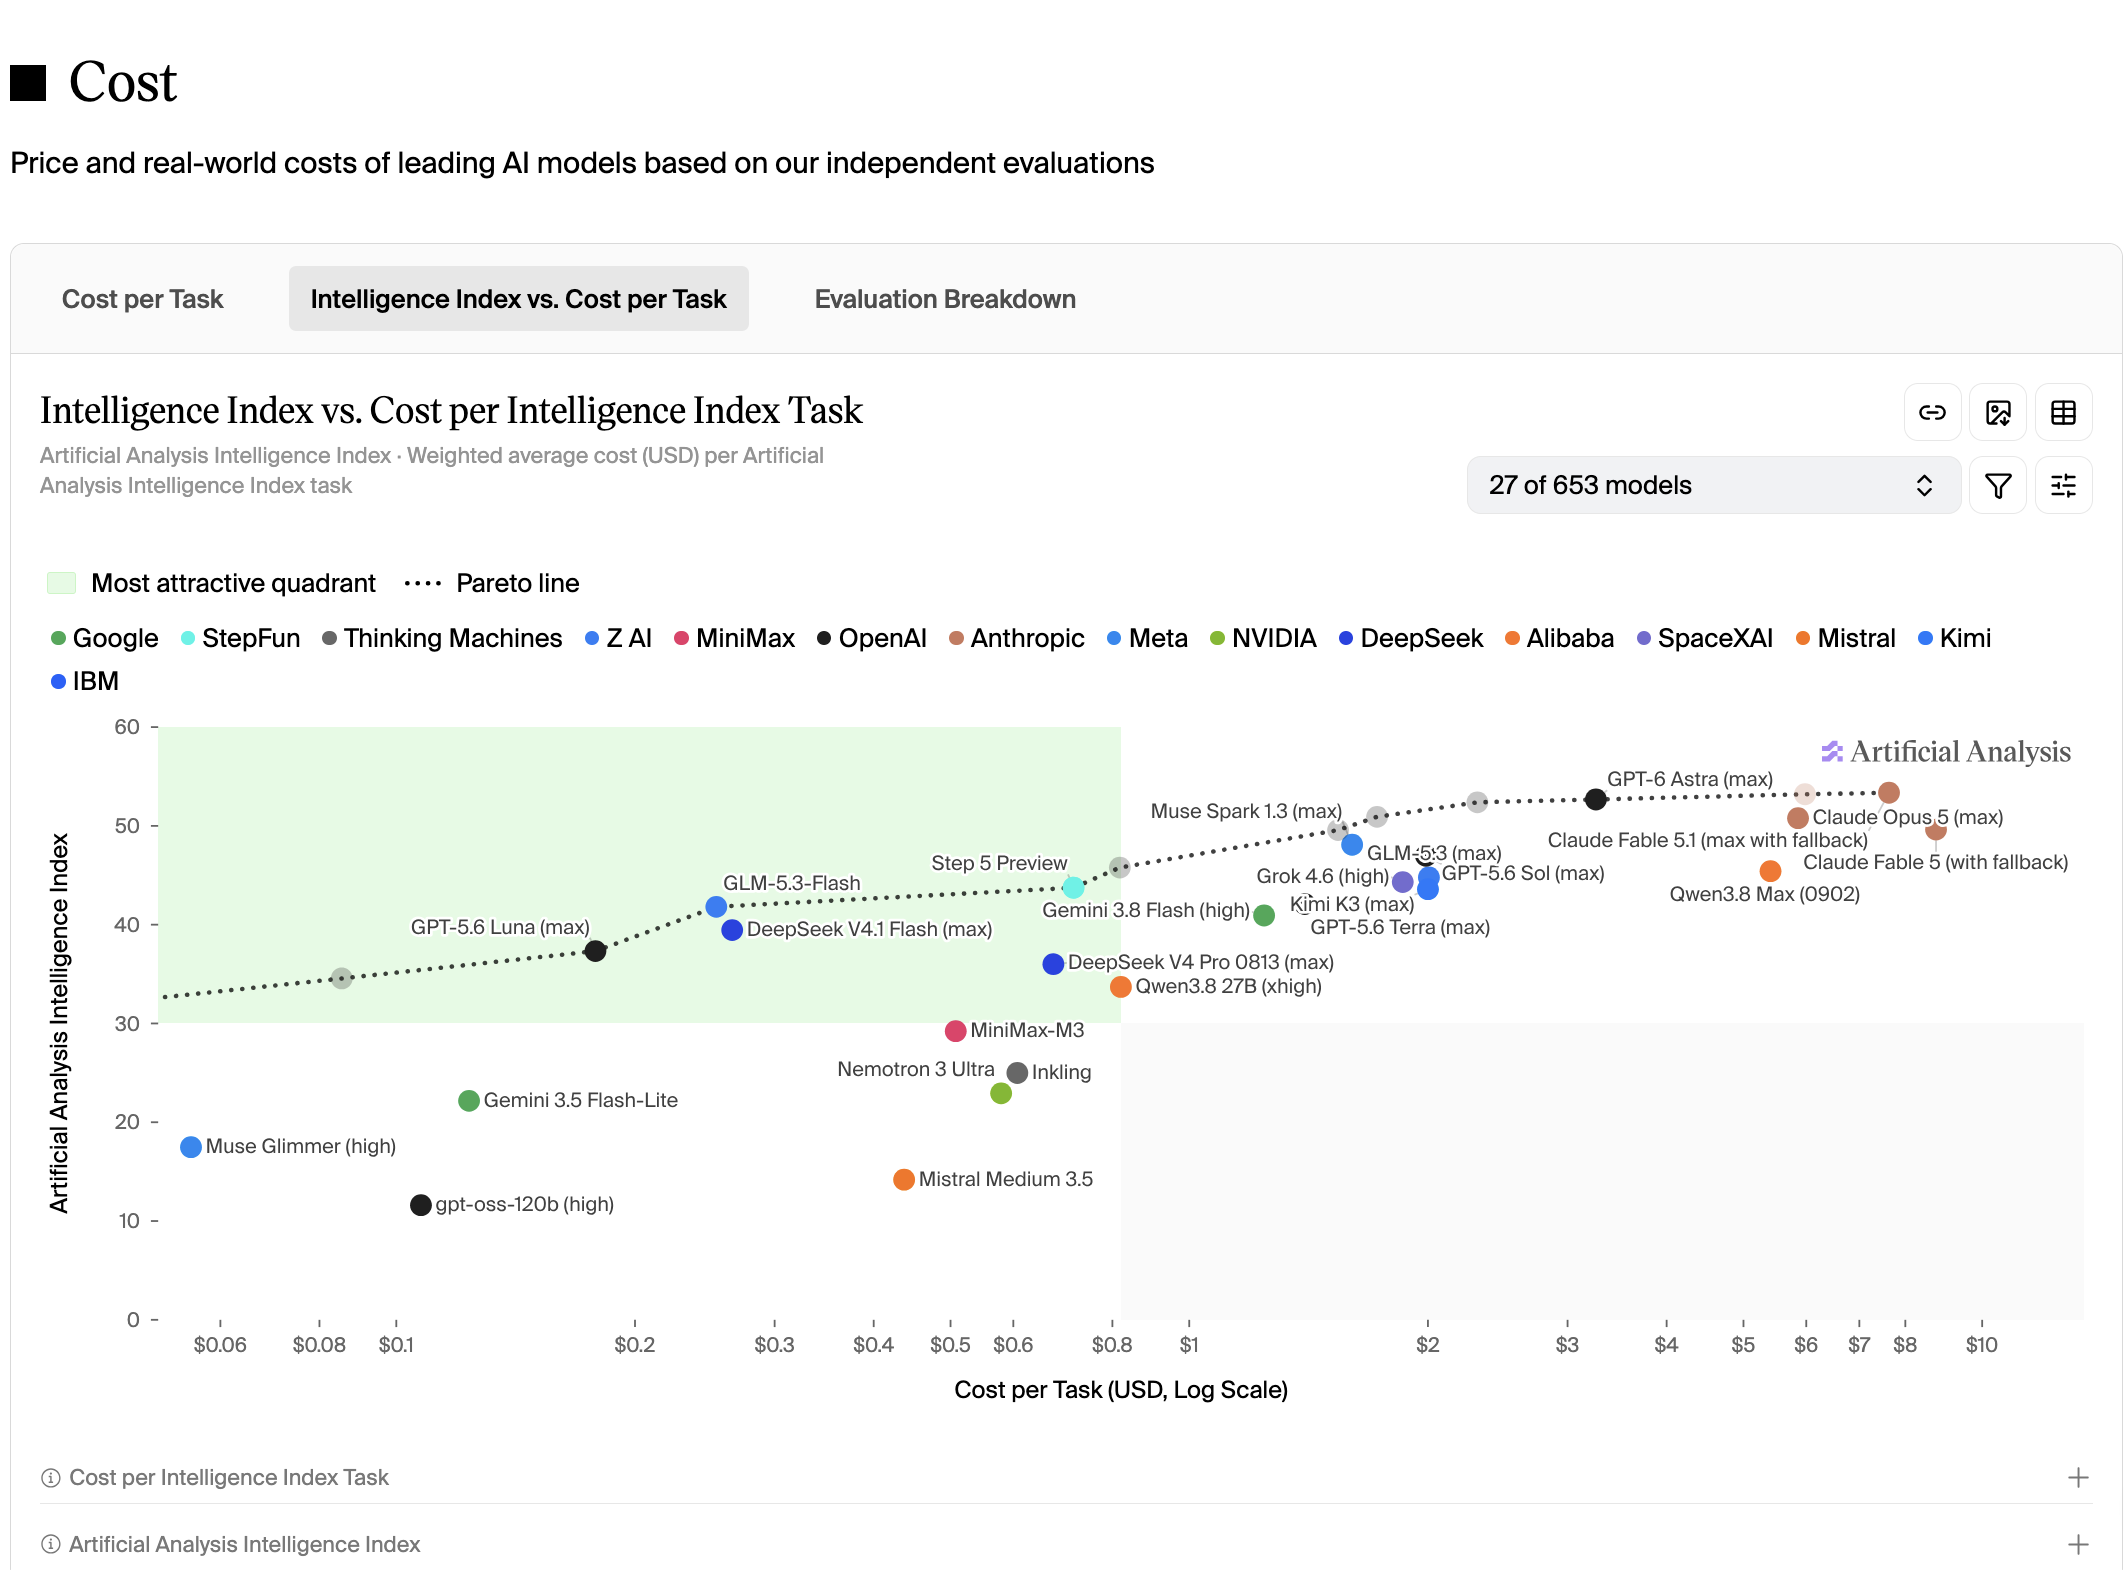
这张图展示了截至 2026 年处于帕累托前沿的一系列模型。 图表右上角是 Claude Fable-5.1(昂贵且聪明),中左侧是 GPT-5.6 Luna(便宜但稍显平庸)。 位于虚线下方(劣势区)的模型基本上没有参考价值。2
接下来,看看这张展示 2025 年年初、年中及年末前沿情况的图表(2025 年年终报告):
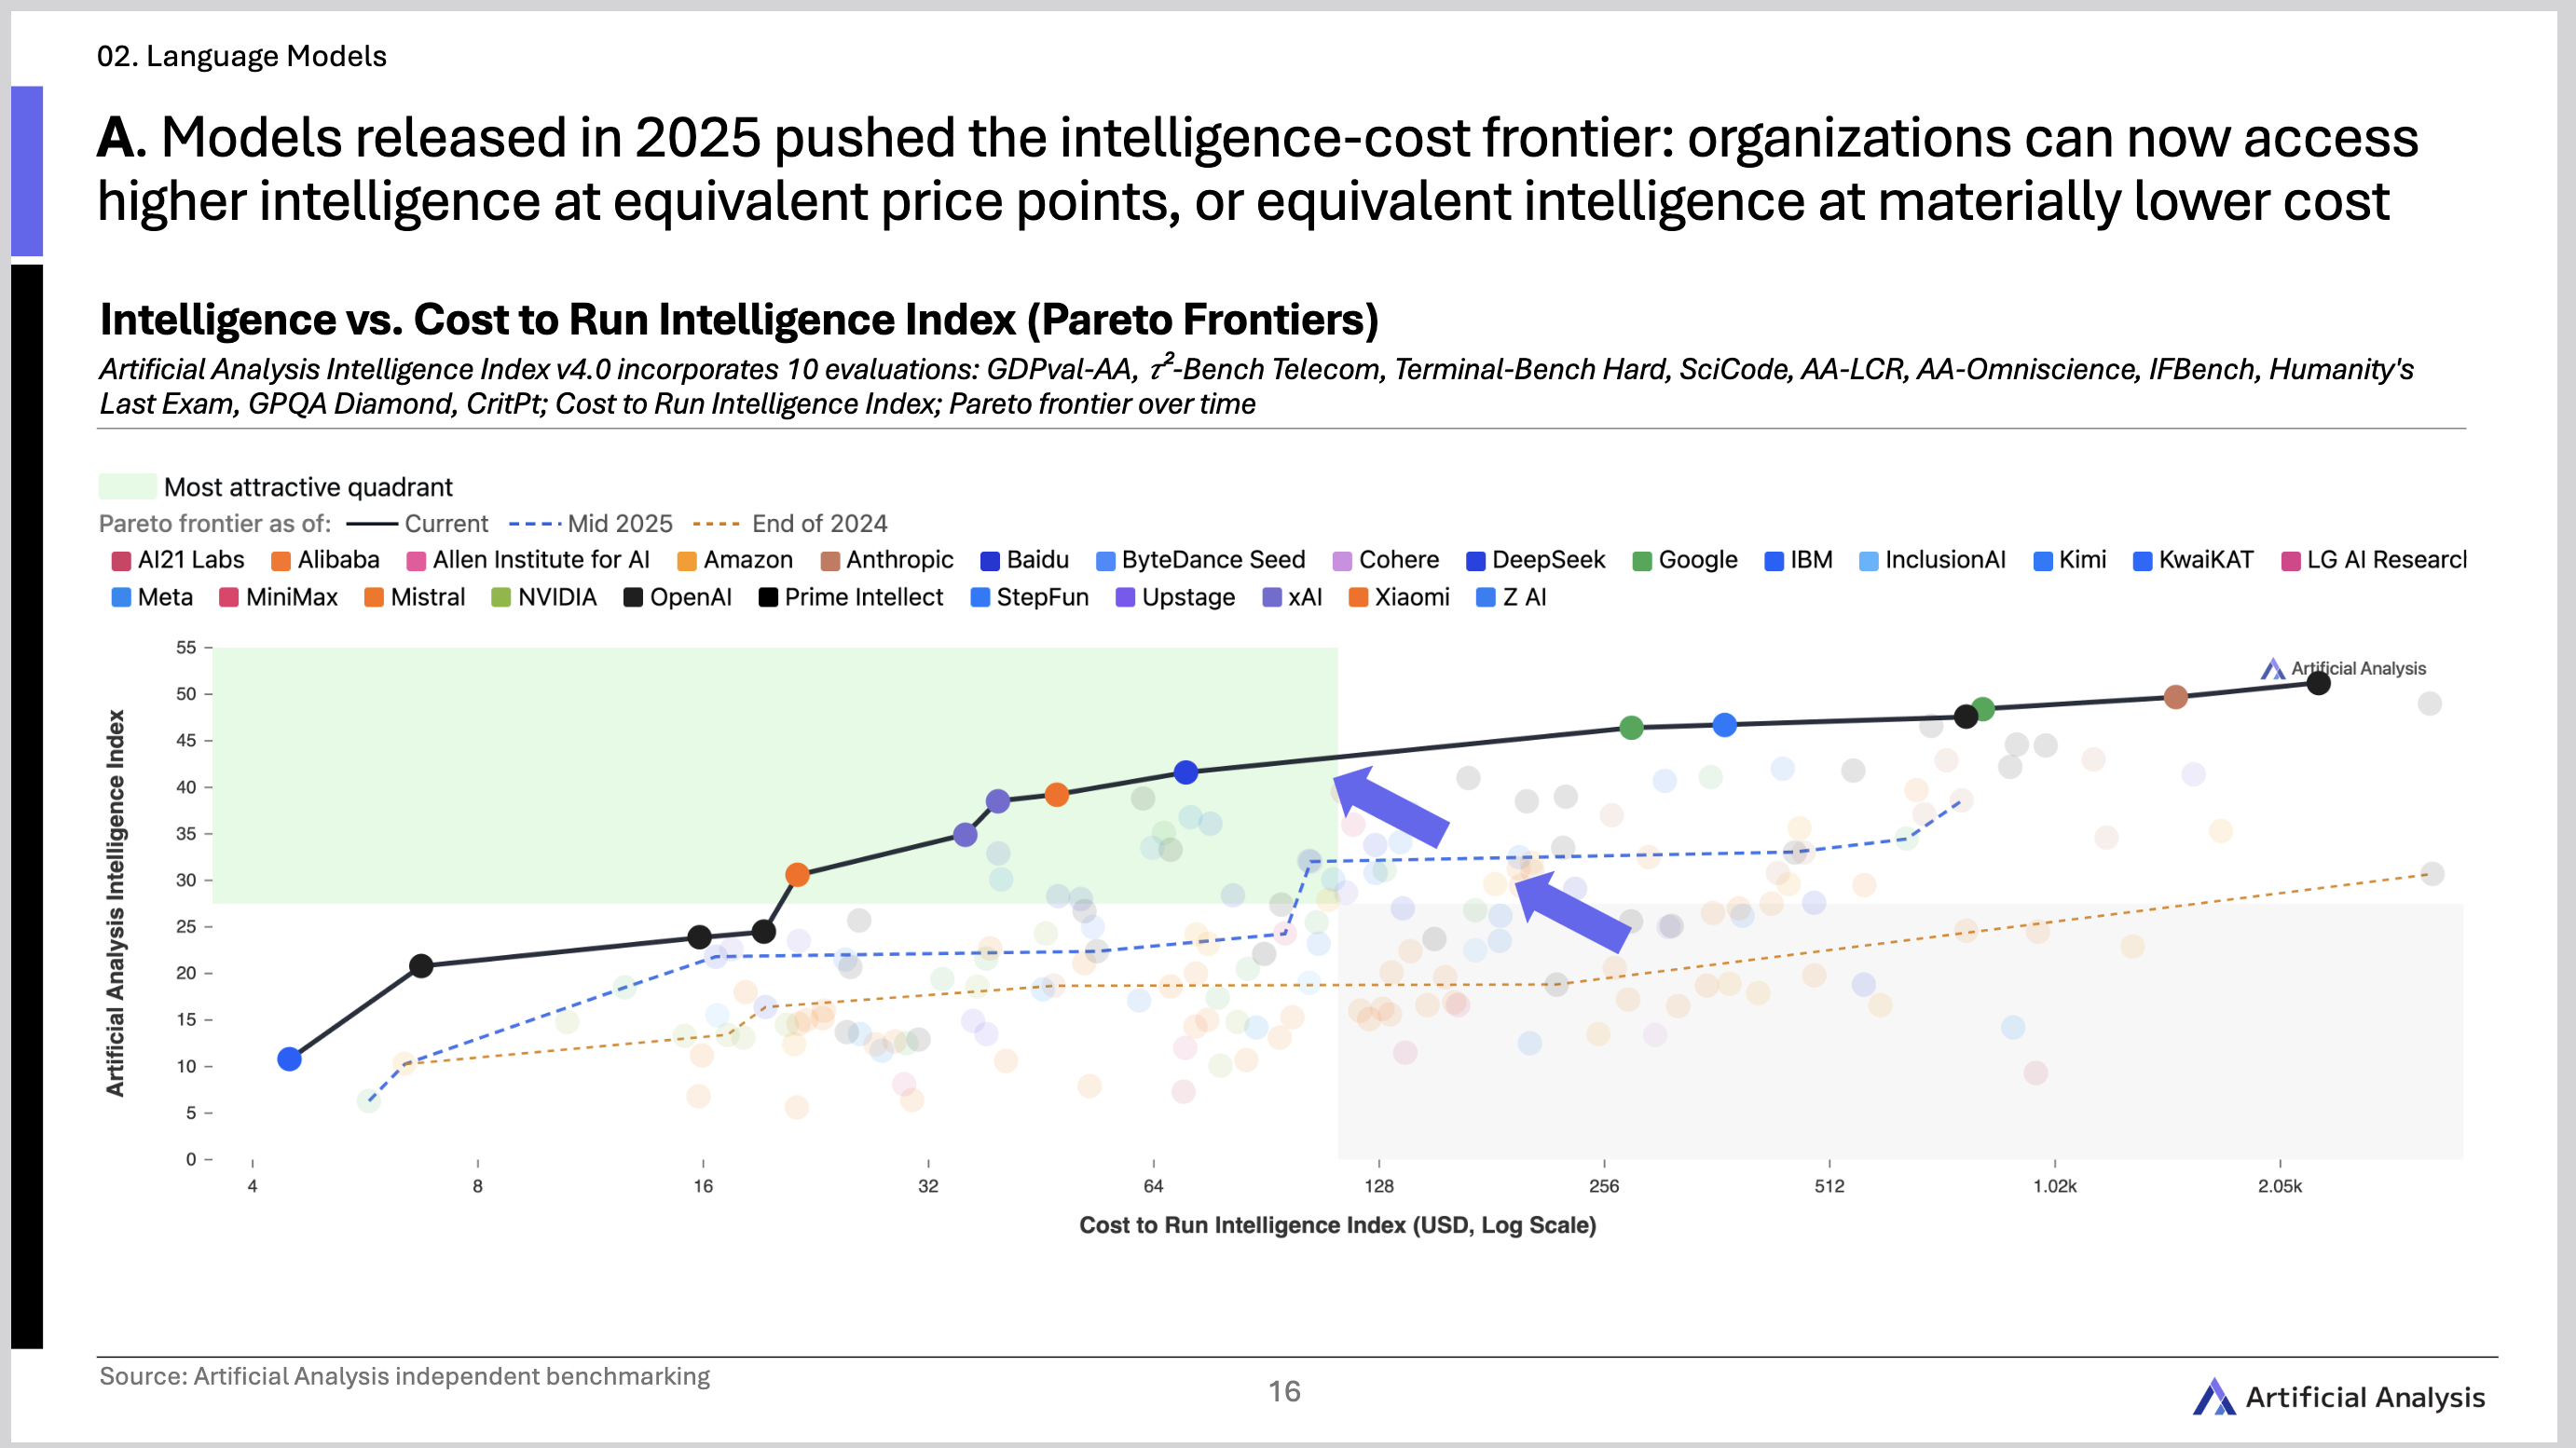
图表显示,在 2025 年间,模型不仅变得更聪明,按任务算的成本也更便宜了。 如果在纵轴几乎任何任务水平画一条水平线,会发现年末完成该任务的成本比年初更低; 如果在横轴几乎任何成本点画一条垂直线,会发现同等成本下模型能做更多事情。
将 2025 年的图表与 2026 年的对比一下。 纵轴(智能水平)大致持平,且低端模型的能力跌幅有所收窄。 横轴(成本)则便宜了 两个数量级。
推理引擎
“推理引擎”是指接收已训练好的模型和输入文本,并在 GPU 上实际执行运算的软件包。
当前的推理引擎还不够成熟,但迭代速度非常快。不同引擎的年同比性能提升幅度在 10% 到 50% 之间。
评估推理引擎通常看两类基准测试:“离线”(一次性批量处理大量 token)和“在线服务”(处理用户随机时间点的输入请求,并尽可能快地返回响应)。目前,在线服务的效率提升速度远快于离线推理。
下文列出的所有数据均针对在线服务场景,而非离线场景。
vLLM
vLLM 是一款开源推理引擎,其能效一直在持续优化。
在下图(来源)中,Y 轴代表每 token 的能耗(焦耳/Token),X 轴代表批处理大小(大致对应“并行处理多少输入”),蓝红两线代表不同的软件版本。Y 轴数值越小,表示能效越高。
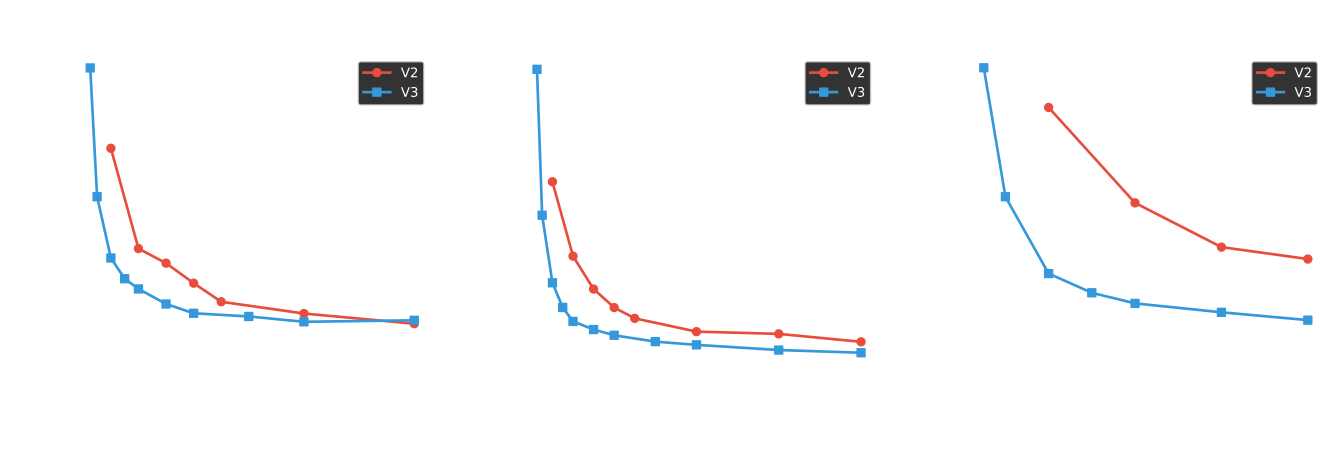
vLLM 0.11.1 于 2025 年 12 月发布,距离 2024 年 9 月发布的 vLLM 0.5.4 仅过去一年多。换言之,在短短 15 个月内,其能效提升了约 40%。
虽然缺乏针对连续多个版本能效的严格对比数据,但单看 vLLM,其性能也在飞速提升。且 v2 到 v3 的性能增益,与我们有确切数据支持的能效改进幅度大致成正比。
NVIDIA
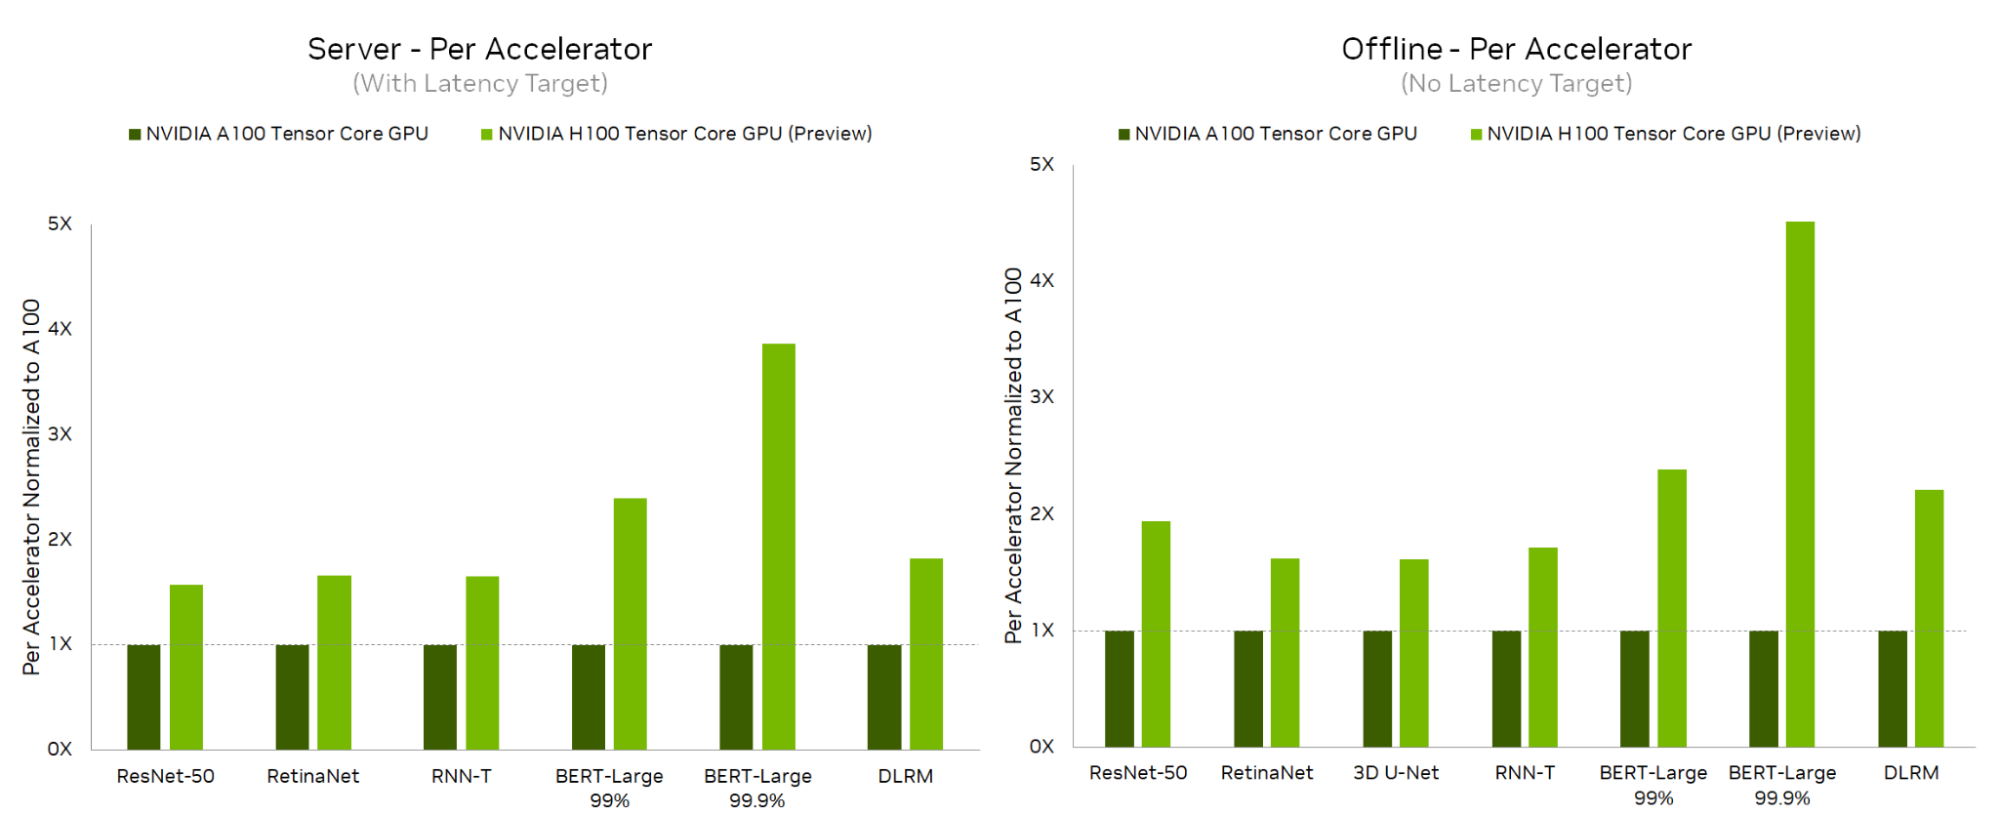
能效的提升并非局限于某单一软件包。NVIDIA 在其MLPerf 技术栈上,从 2.0 到 2.1 版本实现了高达 50% 的能效改进:
Intel
这也不是旧基准测试的特例。Intel 最近展示的结果表明,仅通过优化 MLPerf 从 6.0 到 6.1 版本,吞吐量就提升了 2.4 倍。
这张图展示的是吞吐量而非效率,所以对比不算严谨。不过硬件固定不变、变化的只是软件,因此其中相当一部分提升应该确实来自效率的改善。
影响托管 AI 的改进
Mixture-of-Experts
如今模型采用的架构,从根本上就比早期已知的 LLM 构建方式更高效。
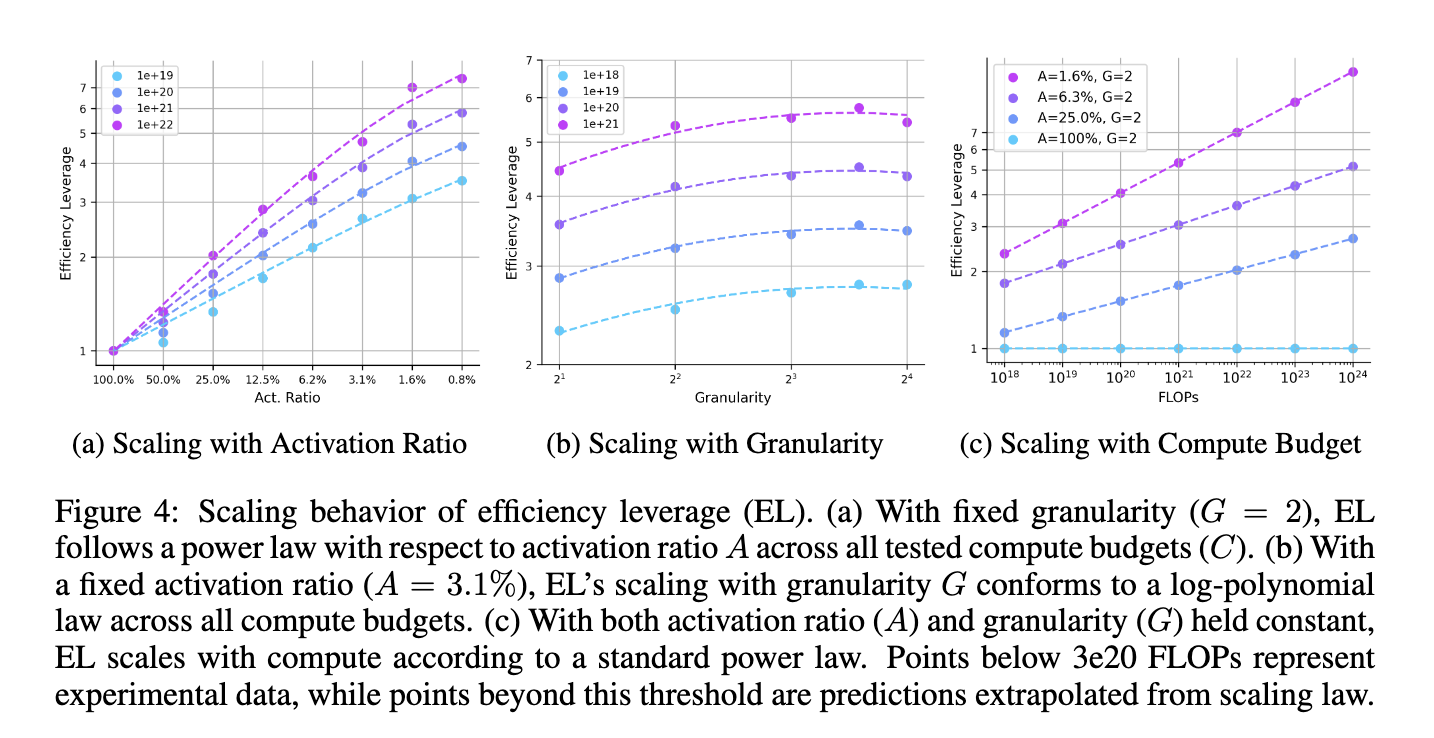
早期的 LLM 基于"稠密"(dense)模型,也就是说,模型的每一部分都要对每个输入进行"激活"(执行矩阵乘法)。而近期的架构采用"Mixture-of-Experts"(MoE,专家混合)架构,在"专家"层派不上用场时将其停用。这直接降低了达到同等输出质量所需的算力。在下图中,一个模型可以小 7 倍(参数量从 6B 减到 0.8B),同时在基准测试上达到相同的表现(来源):
这意味着,相对于模型质量而言,模型的成本和内存占用会随时间不断下降。
当然,人们的应对并不是用更少的算力维持同样的输出质量,而是用同样多的算力换取更好的输出——所以每焦耳产出的 token 数量基本没变,但每焦耳产出的质量在快速提升。
需要注意的是,MoE 在本地机器上帮助不大,因为专家层还是得全部驻留在内存中才能使用。虽然有一些项目(如 mlx-flash)可以按需把层换入内存,但它们只是让这些模型能跑起来,并不会跑得快。
影响本地 AI 的改进
Mamba
在本地运行 LLM 的一个现状是:需要的内存量大得离谱,而且你还买不到,因为内存早就被各家 AI 公司抢购一空了。而新近的模型正把内存需求降低 5 倍甚至更多。
传统模型基于 Transformer 架构。这种机制要求模型记住每一个输入,在某些场景下,单个输入就可能达到数百 KB,而这些数据还要在每一层中重复存储。相比之下,较新的模型采用了 Mamba 架构,模型只需保留输入的一个有损摘要。如果你熟悉编码智能体中的「压缩」概念,可以把 Mamba 理解为直接内置于模型本身的一种流式压缩机制,因此效率更高。
单靠 Mamba 并不够(如果 LLM 连一个 URL 都记不住,那就没法抓取内容了!)但 Mamba 与 Transformer 的混合架构已大幅降低了处理相同数量 token 所需的 RAM 占用。经过 3 4-bit 量化后,Nemotron-H-47B 只需约 32 GB VRAM(即显存)即可容纳超过百万个 token。而同等质量的 Llama-3.1 60B 模型,处理相同数量的 token 则需近 120 GB,若不使用量化,这一数字还会进一步恶化。
针对特定场景的优化
Jev 与 Laya
将 AI 仅用于特定的是/否类判断,可使成本降低两个数量级。
TypeSafe AI 本周推出了其旗舰产品「Jev」。 Jev 不同于生成式 LLM,它无法自由生成文本,只能在预设选项中做出选择。例如,你可以问它:「这条 shell 命令是否违反了系统提示或会导致破坏性变更?」它会返回一个 0 到 100% 之间的概率值。
关于 Jev 有很多值得关注的亮点,但最让我印象深刻的是其定价页上的这段对比:
现有 LLM:
输入 token:每 MTok $0.20 至 $10。 输出 token:约为输入价格的 5 倍。
System One + Jev
输入 token:每 MTok $0.042(即每 10 亿 token $42)。 输出 token:免费(便宜到无法计费)。
如果你匆匆略过了上文,那么价格相当于每 十亿个 token 42 美元4。 一个 token 大约相当于三分之二个词。 一本书平均有 8 万词。 所以,花 3 美分就能读 5 本书,花 42 美元能读 人类有史以来所写全部书籍 的万分之一。
价格低廉到几乎不值得费心。 比你的电费还便宜。
事实上,它便宜到有人正在开发直接调用 Jev 的开发工具。 例如 jgrep,它允许你运行这样的查询:
$ jgrep -o "announces or releases a new AI model" titles.txt | sort -rn | head -3
0.980	PrismML Launches Bonsai 2 27B, Its Most Capable Model Yet
0.970	Alibaba Releases Qwen3.8-Omni-Flash
0.940	Google announces new experimental "CC" AI agent for families
jgrep 的自我描述如下:
它在 200 毫秒左右返回一个概率值,成本约为千分之一美分,速度快、成本低,足以嵌入管道。 jgrep 随着行的到达读取数据,并发判断,并按输入顺序打印匹配结果,因此既可用于 tail -f,也可用于文件。 在 994 条 Hacker News 标题上的实测:处理一个描述耗时 4.6 秒、花费 0.012 美元,同时处理三个描述耗时相同。
还有一些更奇特的用法。 Jev triage 是一个用于查看开放 pull request 的 TUI 工具,按优先级排序。 它通过查看每一条评论来确定优先级,而不是依据标签。 这不能取代专门的 triage 团队,但绝对是位得力的助手。
Jev 是专有模型,但 Laya 是开放权重的,且小到可以本地运行。 经过微调后,它可能比 Jev 更快、更准确。 缺点是它只是一套代码库,而非成品产品:
- 没有托管服务,需要你自行完成大量配置。
- 除非微调,否则表现不佳,因此你需要具备相当多的 ML 知识才能充分利用它。
- 仅支持最多 512 字节的上下文,因此在处理大型输入时扩展性较差。
研究 Jev 和 Laya 让我确信,架构层面仍有巨大的改进空间, ML 在可预见的未来不会触及规模扩展的极限。
整合起来
综合以上因素,过去一年里 token 成本大约下降了 2.5 个数量级:
- 模型在单任务上的成本效率提升了约 100 倍。
- 硬件的单 token 能耗效率提升了约 1.3 倍。
- 推理引擎的单 token 能耗效率提升了约 1.4 倍。
如果抛开原始 token 价格,看其他基准指标,还能看到另外一些进步:
- 新架构让同样的内存能装下 5 倍甚至更多的 token,使本地运行更聪明的模型成为可能。
- 诸如 Jev 和 Laya 这类专用模型,还能把成本再降低 1-2 个数量级。
这些技术目前都还不成熟,未来只会更好——离收益递减的天花板还远得很。
接下来会怎样?
Token 比工具调用还便宜
真正有意思的是,把 token 价格和计算的其他成本放在一起比较。比如,算算工具调用有多贵。以下只是粗略估算;我们讨论的是数量级差异,用 Fermi 估算就足够了。
GPT-5.6 Luna 的价格约为每百万 token 30 美分(来源)。假设 Luna 每次决定调用工具要消耗 1 万 token,也就是每轮约三分之一美分。纽约市的电价约为每千瓦时 25 美分,我所在的荷兰也差不多。我的 MacBook Air 空闲时功耗约 10 W,高负载下约 30 W。5 于是得到这样一张表:
| 工具 | 功耗 (W) | 时长 (s) | 价格 (美分) | 比 Luna 一轮便宜的数量级 |
|---|---|---|---|---|
grep | 10 | 0.1 | 0.000007 | 4.5 |
| 解析 HTML | 10 | 1 | 0.00007 | 3.5 |
cargo build | 30 | 30 | 0.00625 | 1.5 |
照这个趋势,用 token 替代工具调用……在未来几年内还真不是不可想象的事!
当模型的成本低于工具本身时,把模型嵌入工具就变得非常有吸引力。
前文提到的 jgrep 已经展示了这种趋势;未来,我们可能会在更广泛的计算基础设施中看到类似的应用。
例如,可能会出现使用机器学习的自适应构建调度器。
这类技术如今已经可行,但部署起来需要相当多的专业知识;一旦通用模型让它们变得容易实现,嵌入这些功能将变得更加简单。
供给侧的杰文斯悖论
随着模型运行成本的降低,企业的反应是建设更多的算力基础设施。 为什么?因为每投入一美元,它们能赚得更多。 这就被称为杰文斯悖论:某样东西的效率越高,其总使用量反而越大。 具体来说,随着成本下降,人们更倾向于使用它。 这被称为诱导需求,在讨论交通网络时经常提到这一现象。
投资者如何收回成本?
如果 Token 便宜到无需计费,LLM 提供商如何盈利? 这意味着泡沫即将破裂吗?
不,我不这么认为。 首先,就像我在上文部分所谈到的,单个 Token 便宜并不意味着推理业务对提供商来说无利可图。 其次,OpenAI 和 Anthropic 仍然遥遥领先于大多数其他 AI 实验室。 数量的廉价并不意味着质量同样廉价。 我认为我们将看到一个这样的世界:最艰难的任务会向前沿实验室购买算力,而“常规”任务则会使用开放权重模型或那些必须与开放权重模型竞争的大折扣计划。
开放权重模型是否能赶上 OpenAI 和 Anthropic 仍是一个未解之题! 如果能,那将会损害投资者利益,并可能在美国经济中产生连锁反应。 不过,我认为这不会改变根本的技术格局:NVIDIA 依然会繁荣,企业依然会使用 AI(而且这比之前的预期会更便宜)。
需求侧的杰文斯悖论
但还有一个更有趣的问题: 一旦算力足够便宜,人们会用它来做什么? 拿到一百万个 Token 怎么办?十亿个呢?
以下是我认为可能发生的一些事情,尽管并非所有事情都很可能发生。
- 网络安全状况会急剧恶化。为了不被入侵,企业将集中使用 Cloudflare Access 等托管服务,以及仅限内部访问的 AWS/Azure 服务。
- 裸算力(Raw compute)的优势将更加显著。Oxide Computer、AWS、Cloudflare 及所有超大规模云服务商都将受益。我们将看到更多公司出租专为推理优化的专用 GPU,而不仅仅是通用型 EC2 实例。这种趋势在服务如 runpod 中已经显现。
- 软件开发的难点将转向产品需求、测试和用户界面设计,而非算法。就业市场会变得相当怪异。理想情况下,我们会看到 QA(质量保证)和 UI/UX(用户界面/用户体验)岗位的复兴。
- “租用软件”的模式将变得稀缺。代码库不再构成护城河,运营和安全才是价值驱动的核心。我们将看到更多像 Amazon Managed Streaming for Apache Kafka 这样的服务,而像 JetBrains IDE 或 Blackboard 这样的产品会越来越少。
- 可能还有很多其他变化!未来正变得越来越不可思议!!
选择权
我认为非常有意思的一点是,过去人们在面对一个软件产品时,只有三个基本选项:
- 使用它。
- 不使用它。
- 使用另一个类似的产品。
现在多出了第四个选项:让 LLM(大语言模型)去构建它。LLM 输出的质量可能有好有坏,但这个选项是以前从未存在过的。企业必须在质量上竞争,而不仅仅是比拼那些过去无法做到的原始能力。在受监管的行业,现有巨头相比自由市场中的新进入者,将拥有巨大的优势 6。
这真正酷炫的地方在于,它使得创造为特定用户量身定制的可塑性软件变得容易得多。对于非程序员来说,这在五年前是难以想象的 7。
总结
我不知道下一步会怎样。但我认为,我们应该为这样一个世界做好规划:在这个世界里,我们不仅会看到廉价的算力,还会看到廉价的智能。
-
我特意使用「AI」而非「LLM」:像 Jev 这样的新型机器学习分类器并非 LLM,但能力相当。↩
-
除非你有其他基准测试,比如「会告诉我台湾的首都」或「会写竞选演讲」,这些分别被中国和美国模型禁用。↩
-
「量化」大致指「模型内部细节的保留程度」。默认使用 16 位浮点数。 模型通常会被量化为 8 位或 4 位,在质量仅轻微损失的情况下,体积更小、速度更快。↩
-
TypeSafe 表示:「我们无法证明这不是补贴,需要时间来证明定价的可持续性(我们预计价格会降而非涨)。」↩
-
对于硬件而言,这种效率异常高。服务器软件通常针对吞吐量调优,而非效率,因此执行相同工具所需功耗可能高出几个数量级。↩
-
让电子病历等软件对医生如此难用的原因之一,是医生不能简单地拒绝使用它们。法律要求医生保存的记录量大得无法手工管理。加上转换成本,这导致了「寡头垄断」,少数在位者无论产品多差都能占据市场。↩
-
除了 Apple Shortcuts、Salesforce 和 Excel 表格等极窄的利基市场除外。↩