
The Decoder 6小时前 · 2026-09-24 00:13:31 · 3 阅读
Anthropic 工程师解析:模型推理能力增强为何导致 Claude 写作质量下降
AI 模型在数学、代码和推理上的能力突飞猛进,但写作质量却停滞不前,甚至有所退步。
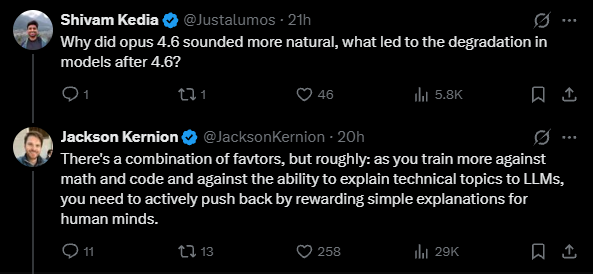
Anthropic 负责 Claude 微调的员工 Jackson Kernion 最近解释了为什么 Opus 4.6 是 Anthropic 最后一个写作能力出色的模型。答案一部分在意料之中:更新的模型都为数学和代码做了优化。
但另一个原因是,这些模型还接受过训练,专门生成面向其他 AI 模型的技术性说明,这正是 Claude 表达怪异("Claudeish")的真正原因。Kernion 说,模型已经“适应了 LLM 心理学”,学会的是写给 AI 看,而不是写给人看。
Kernion 把这比作只和同类自闭症人士交流的人:他们形成了圈内顺畅的风格,但在外人看来却难以理解。LLM 的工作记忆远超人类,能捕捉到细粒度得多的细节,因此在训练过程中会形成一种 AI 模型用起来很高效、但人类读者读起来却是“信息密度过高的堆砌”的写作风格。
为代码优化的代价是自然语言
在 Kernion 看来,问题根源在于强化学习的奖励结构:有些奖励优化的是 AI 模型的理解效果,有些优化的是人类的理解效果。数学和代码训练越多,就越需要主动反向调整,奖励那些人类读者能看懂的简洁表达。
Kernion 表示,凭借 Opus 5.5,Anthropic 找到了更好的平衡,并补充道,自 Opus 4.6 以来,他还没对某个模型的写作水平如此满意。不过这并不意味着 Opus 5.5 超越了旧版本。Kernion 写道:“这是一个难以解决的问题,我们会持续改进。”
原始来源: The Decoder