Claude Opus 5.5 成为 AINews 默认模型,各厂商集体降价 40-50%
OpenAI 也拼了一回:GPT-6 Sol 和 Luna 以比 GPT-5.6 低 50% 的价格发布。但凭借1700万浏览量还在持续上涨,今天注定属于 Claude Opus 5.5——"Claude 5.5 系列的首个模型",大多数任务上达到"Claude Fable 5.1 的水平",运行成本还比 Opus 5 便宜 40%。
Claude@claudeai推出 Claude Opus 5.5,Claude 5.5 系列的首个模型。 它的大多数任务表现达到 Claude Fable 5.1 的水平,且运行成本比 Opus 5 低 40%。 2026年9月22日 下午4:31 · 1720万 次浏览
2740 回复 · 8010 转发 · 8.52万 赞
Opus 5.5 在大多数基准测试上超越 Fable、挑战 Astra,两家实验室都把 API 降价归功于效率优化——但从 prefill、decode 到整体算力,各项指标都有两位数的巨大提升……
Theo - t3.gg@theoOpus 5.5 比 Opus 5 更小??Anthropic 的后训练是不是大幅进步了?太猛了。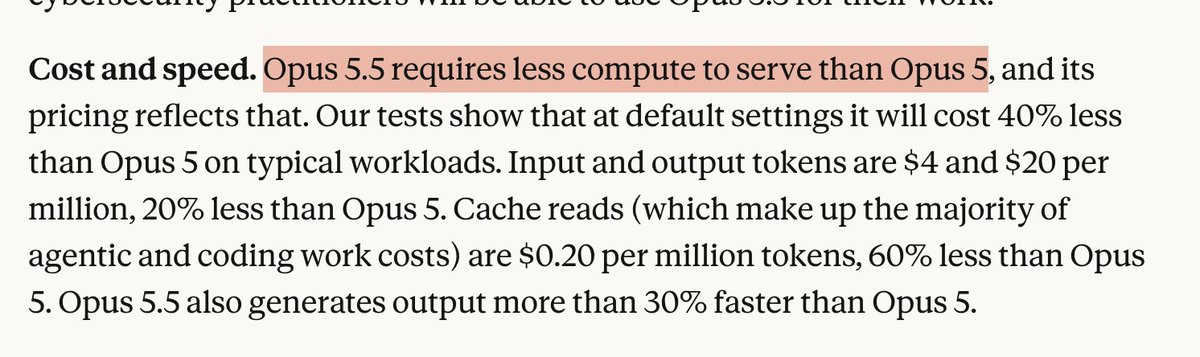 2026年9月22日 下午6:53 · 11万 次浏览
127 回复 · 74 转发 · 3880 赞
……不过在部分前沿任务上,token 消耗的增加抵消了一部分效率收益。
Artificial Analysis@ArtificialAnlysClaude Opus 5.5 (max) 每个 Intelligence Index 任务成本为 $5.98,与 Opus 5 (max) 的 $5.86 相近,但这其中包含了 token 用量的显著增长与 Anthropic 的降价 相比 Opus 5,Opus 5.5 增加的 token 用量会带来约 80% 的……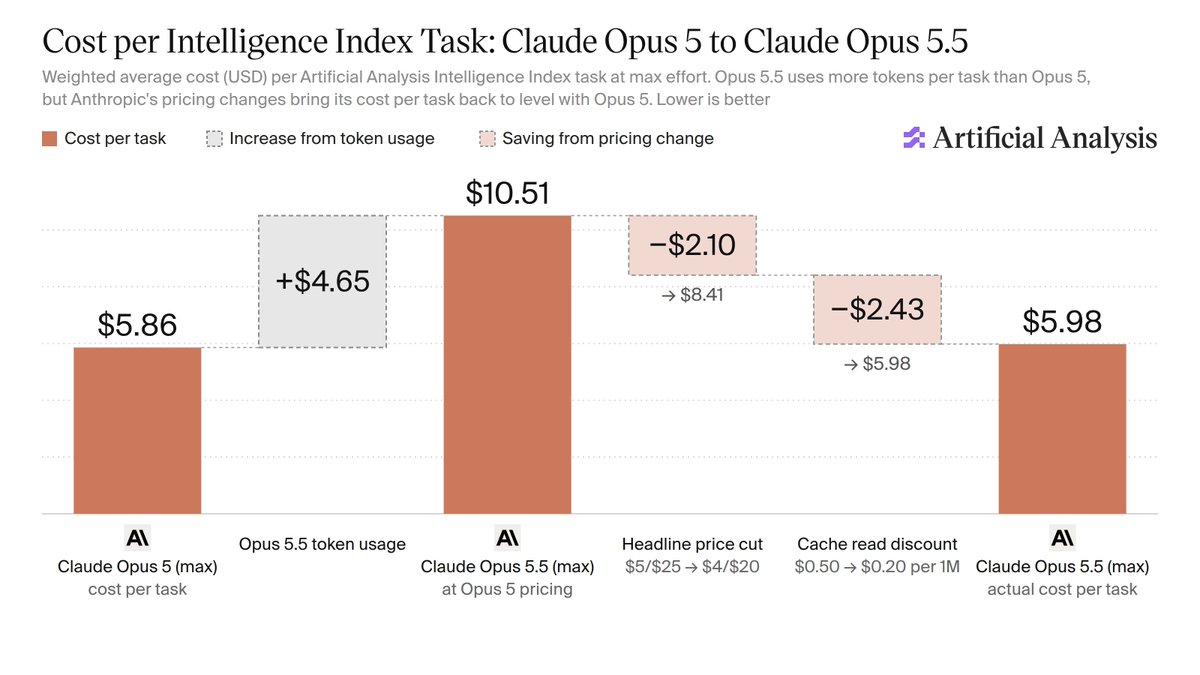 2026年9月22日 晚上11:34 · 3.61万 次浏览
39 Replies · 25 Reposts · 603 Likes
不过,Claude 发布中少见的重点强调了写作能力的提升:“它会优先呈现最关键的信息,并严格遵循你给出的写作规则,这让长时间会话的体验更连贯易读。”
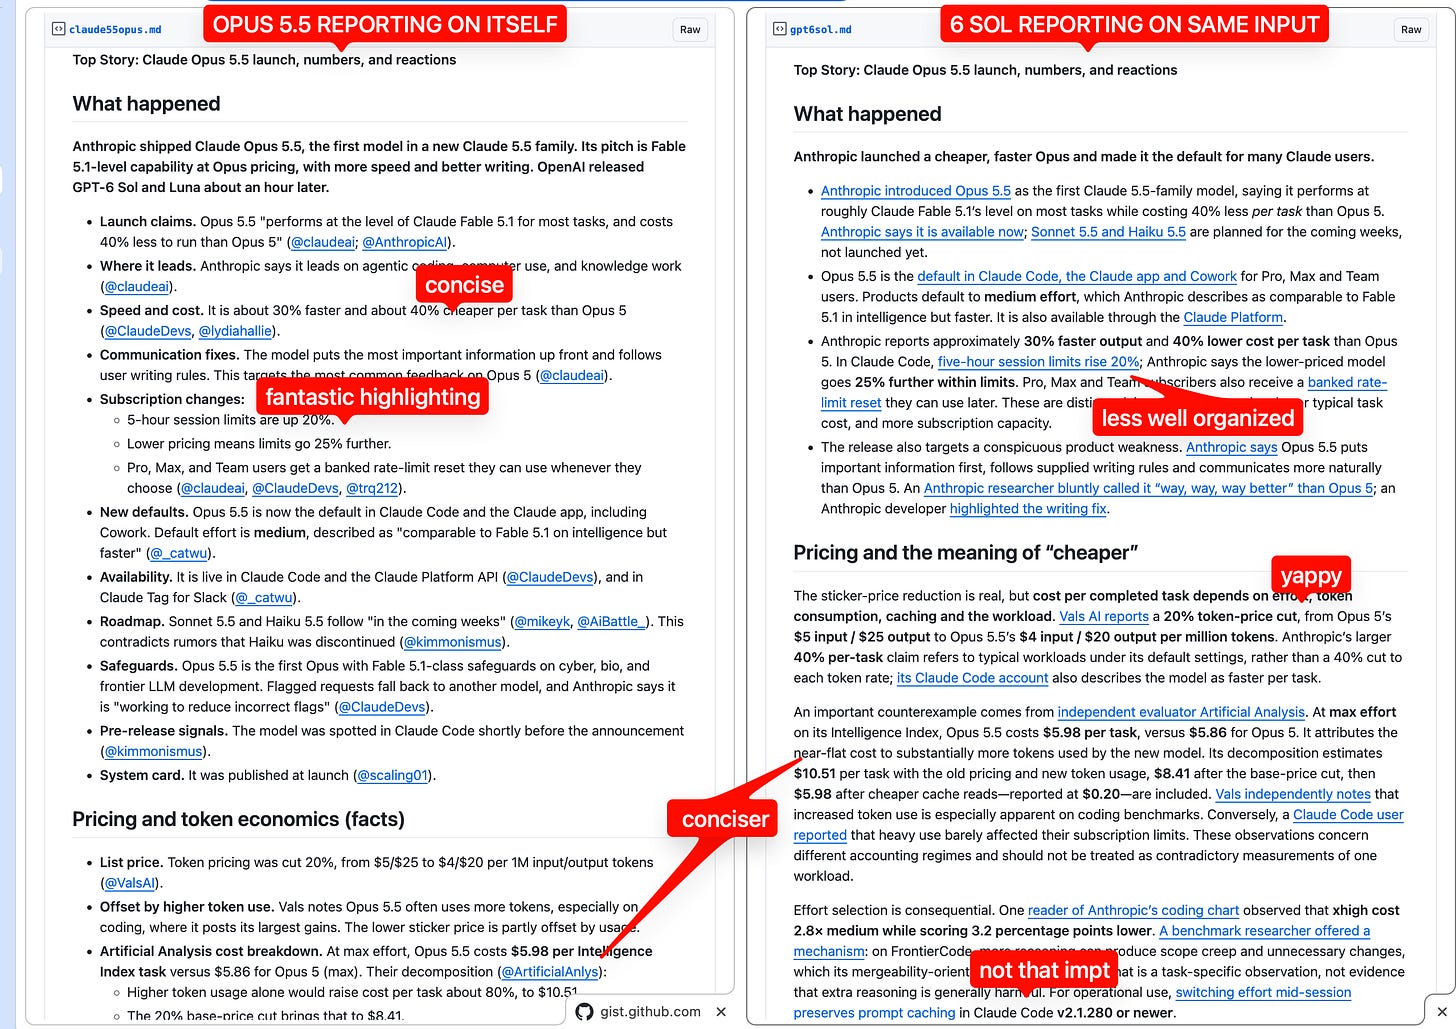
我们亲自验证了这一点。以下是今日的 AINews 板块在 Opus 5.5 和 Sol 6 上运行的结果。两者差异巨大——我们将立即在 AINews 中全面切换到 Opus 5.5,直至上线下一个模型或 AINews 版本。

Anthropic 还发布了关于大规模多智能体集群的初步工作(以及效率方面):
Lisan al Gaib@scaling01 很自豪 Anthropic 成为首个在系统卡中报告将多智能体系统扩展至 100 个并行智能体的实验室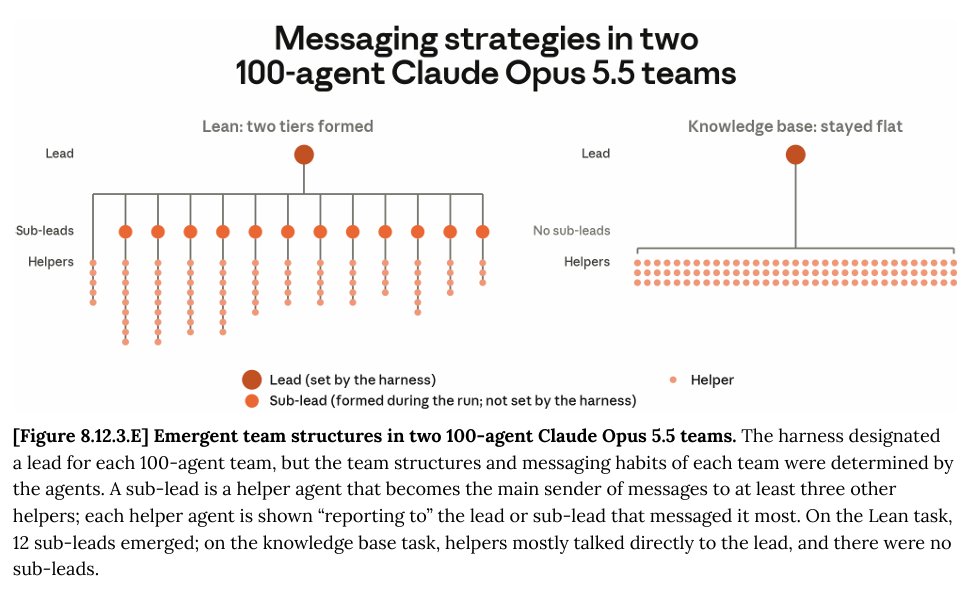 Lisan al Gaib @scaling01 Opus 5.5 系统卡
https://t.co/D1PDkVqChC5:01 PM · Sep 22, 2026 · 82.2K Views
30 Replies · 60 Reposts · 1.19K Likes
2026 年 9 月 21 日至 9 月 22 日的 AI 新闻。我们检查了 12 个 subreddit、544 个 Twitter 账号,没有额外的 Discord 渠道。你可以在 AINews 网站搜索所有往期内容。提醒一下,AINews 现已成为 Latent Space 的一个板块。你可以选择订阅或退订特定频率的邮件通知!
AI Twitter 摘要
头条新闻:Claude Opus 5.5 发布、数据表现及各方反应
事件经过
Anthropic 发布了 Claude Opus 5.5,这是全新 Claude 5.5 家族的首款模型。其卖点是以 Opus 的定价提供 Fable 5.1 级别的能力,同时速度更快、写作质量更高。OpenAI 在约一小时前发布了 GPT‑6 Sol 和 Luna。
发布时的宣称。 Opus 5.5 “在大多数任务上的表现与 Claude Fable 5.1 相当,运行成本比 Opus 5 低 40%”(@claudeai;@AnthropicAI)。
领先领域。 Anthropic 称其在 agentic coding、计算机使用和知识工作方面处于领先地位(@claudeai)。
速度与成本。 相比 Opus 5,其速度提升约 30%,单任务成本降低约 40%(@ClaudeDevs,@lydiahallie)。
沟通优化。 该模型将最关键的信息前置,并严格遵循用户的写作规范。这主要针对 Opus 5 收到的最普遍的用户反馈(@claudeai)。
订阅服务变更:
5 小时会话的额度限制提升了 20%。
因价格降低,同等限制下的使用量可多出 25%。
Pro、Max 和 Team 用户将获得可灵活使用的时间累积重置额度(@claudeai,@ClaudeDevs,@trq212)。
新的默认设置。 Opus 5.5 现为 Claude Code 和 Claude 应用(包括 Cowork)的默认模型。默认努力程度为中等,被描述为“智能水平堪比 Fable 5.1 但速度更快”(@_catwu)。
可用渠道。 该模型已在 Claude Code 和 Claude Platform API(@ClaudeDevs)上线,并集成到 Slack 的 Claude Tag 中(@_catwu)。
路线图。Sonnet 5.5 和 Haiku 5.5 将“在未来几周内”发布(@mikeyk、@AiBattle_)。这也澄清了 Haiku 已被砍掉的传闻(@kimmonismus)。
安全防护。Opus 5.5 是首个配备与 Fable 5.1 同级安全防护的 Opus,覆盖网络、生物和前沿 LLM 开发领域。被标记的请求会回退到另一个模型处理,Anthropic 表示正在“努力减少误标”(@ClaudeDevs)。
发布前信号。官宣前不久,有人已在 Claude Code 里发现了这个模型(@kimmonismus)。
系统卡。随发布同步公开(@scaling01)。
定价与 token 经济学(事实)
标价。Token 价格下调 20%,从每百万输入/输出 token 的 $5/$25 降到 $4/$20(@ValsAI)。
但被更高的 token 消耗抵消。Vals 指出,Opus 5.5 往往消耗更多 token,尤其是在它提升最大的编码任务上。较低的标价有一部分会被用量吃掉。
Artificial Analysis 成本拆解。在最大推理力度下,Opus 5.5 每个 Intelligence Index 任务的成本为 $5.98,而 Opus 5(max)是 $5.86。他们的拆解如下(@ArtificialAnlys):
仅 token 用量增加这一项,就会把单任务成本推高约 80%,达到 $10.51。
基准价格下调 20% 后降到 $8.41。
更便宜的缓存读取($0.20)再降到 $5.98。
这意味着什么。在最大推理力度下,相比 Opus 5 的单任务成本优势不复存在。“便宜 40%”的说法只在默认(中等)设置下成立。
对比 Fable 5.1。Cline 报告称,Opus 5.5 在 Artificial Analysis Intelligence Index 上以约 2.5 倍更低的成本击败了 Fable 5.1(@cline)。
Prompt 缓存。在 Claude Code v2.1.280+ 中,会话中途切换 effort 模式不会破坏 prompt 缓存(@lydiahallie)。
模型规模(推测)。@theo 声称 Opus 5.5 比 Opus 5 更小,并将此归因于 post-training。官方并未确认这一点。
基准测试与独立评测
Anthropic 官方表格。在 Anthropic 发布的重点对比表中,Opus 5.5 在所有行上都优于 Fable 5.1,并在大多数项目上超越 GPT‑6 Astra(@kimmonismus,@synthwavedd,@scaling01)。
@ShayneRedford(Anthropic)总结了声称的改进:
在 CursorBench、KWBench 和 OSWorld 上表现优于 Astra。
风格和指令遵循能力大幅提升。
科学和健康领域能力更强。
对网络与生物滥用更具鲁棒性。
第三方及合作伙伴评测:
EvalResultSourceVals 指数排名第1,较 Opus 5 上升2个名次/2分;Anthropic 占据前三席位(GPT‑6 Sol 待发布)@ValsAIVals RSI 指数排名第1;该模型在 LM Training 任务上首次超越其协议下的公开参考基准;性能超过 Fable 5.1@ValsAI、@ValsAIFrontierSWE (Proximal) 得分 62.3%,位列第2,落后于 GPT‑6 Astra(65.5%);领先于 Fable 5.1(56.3%)和 Opus 5(52.0%)@ProximalHQFrontierCode 1.1 (Cognition) 在扩展模式(Extended)下得分 65.3%,“以极低的成本”从 Fable 5 手中夺回榜首@cognitionCursorBench 得分 57.8%(Max 模式),成为新的最强模型;单任务成本比 Opus 5 低 40%@cursor_aiPerplexity WANDR 得分 0.610,成本为 $4.13/任务;性能略高于 Fable 5.1,且成本低 67.6%@perplexity_aiParseBench(表格)得分 93.9%,比 Opus 5 高 7 分;超越 Fable、Gemini 和 Astra@jerryjliu0Roboflow 视觉/检测“Anthropic 迄今视觉能力最强的模型”;目前已在 Playground 排行榜上超越 Google 模型@skalskip92、@skalskip92
评测详情与注意事项:
Vals 运行配置。 RSI 在原生 Claude Code 环境中以最大力度(max effort)运行,配置为 1M 上下文、128K 最大输出 tokens,temperature 设为 1(@ValsAI)。
ParseBench 注意事项。 模型在处理图表、格式和布局时仍有困难。LlamaIndex 指出其每页 5.8¢ 的成本对于生产环境下的 OCR 而言过于昂贵。但请注意,该评价出自拥有竞品产品的厂商。
AI 研发与编码对比。 @eliebakouch 解读系统卡时称,该模型在 AI 研发方面“表现大致相当”,但在智能体编码(agentic coding)上“实力强劲”。
已饱和。@scaling01 问 CoBench 是不是“完蛋了”。@synthwavedd 调侃这个新基准一出就饱和了。
Arena。Opus 5.5 已上线 Agent Arena,并在 WebDev、文本、视觉和文档类目的 Battle Mode 中可用。目前还没有分数(@arena)。
Effort 扩展的异常现象。在一张 agentic coding 图表上,xhigh effort 的成本约为 medium 的 2.8 倍,分数却低了 3.2 分(@LearnOpenCV)。@Yuchenj_UW 称之为“最离奇的基准测试结果”,建议直接用 medium。
@nrehiew_ 给出了一种解释:
Opus 5 在 FrontierCode 上也有同样的表现。
FrontierCode 会惩罚不必要的改动,而更高的 effort 会带来范围蔓延。
因此模型“在更高的推理 effort 下表现反而持续变差”。
System card 细节
多智能体扩展。system card 在 8.12 节报告了最多扩展到 100 个并行 agent 的测试。@scaling01 称这是首家实验室发布此类报告。@maksym_andr 将其视为多智能体 scaling law 的实证依据。
ProgramBench 的争议。ProgramBench 作者 @OfirPress 指出,Anthropic 接近 100% 的解决率来自 166/200 的子集,而这个子集很可能剔除了最难的程序,比如 FFmpeg 和 PHP 编译器。他还指出了指标口径不一致的问题(@OfirPress、@OfirPress):
Anthropic 报告的是平均测试通过率。
ProgramBench 报告的是完整任务完成率。
部分完成的任务通常能通过 60–70% 的测试,这会推高通过率指标。
与 Mythos 5.1 的对比。Opus 5.5 在 Anthropic 的 ECI 基准测试中得分高于 Mythos 5.1,并在所有测试过的网络安全评估中胜出(@scaling01,@scaling01)。
奇怪的价值对齐发现。@teortaxesTex 引用了一段文字:“恶意输出几乎完全出现在 Claude 在产生恶意输出之前做了一个不大可能且无害错误的案例中”。他质疑 Anthropic 是否“给自己植入了潜伏代理”。
“源自 RSI 的训练”。他另外引用了一行关于“第一个源自 RSI 训练的模型”的描述,并认为这令人担忧(@teortaxesTex)。
生物医学影像。@iScienceLuvr 欢迎了据报道具备的生物医学图像分析能力。
更多需求。@scaling01 希望提供不带思维链的时间跨度选项。
安全立场与保障措施争议
官方立场:
Sam Bowman:Opus 5.5 比前代模型“安全得多,发布它更有可能降低与价值对齐相关的风险”,尤其是针对最极端的对齐风险(@sleepinyourhat,@sleepinyourhat)。
他也承认对跟上不断升级的风险节奏感到担忧,但同时表示在当前能力水平下现有工具仍然可信(@sleepinyourhat)。
Mike Krieger 提到了广泛的价值对齐测试和外部评估,包括来自 METR 的评估(@mikeyk)。
摩擦点:
备用模型触发过度。@iScienceLuvr 在要求 Opus 5.5 治愈癌症后,被降级至备用模型。
针对中国的定位(单项测试)。 @xlr8harder 称快速测试显示,前沿 LLM 开发的分类器针对的是中国硬件。他呼吁进行更多深入探究。
对涉华动向的反应。 @teortaxesTex 认为此举意在打压中国 AI 发展。而 @jakehalloran1 则解读为保护 Trainium 的专有技术。
“把控前沿节奏”的叙事框架:
@theo 指出,今日发布的模型均不属于 Astra 或 Fable 级别,这是有意放缓节奏的表现。
@goodside 表示,实验室呼吁把控前沿节奏的做法,削弱了他之前“暂停研发”的立场。
@dejavucoder 讽刺了这种说法,因为 Opus 5.5 的性能实际上优于 Fable 5.1。
写作、提示词与行为表现
团队成员的写作优化。 如 @_sholtodouglas 所言“我们修复了写作问题”,以及 @NotTomBrown 提到的“我们修正了口音”。
@_sholtodouglas 和 @NotTomBrown。罕见的坦率。 Anthropic 的 @nmca 发帖称:“比 Opus 5 好得多,好太多。抱歉之前那个模型表现不佳。”
@theo 称这条推文惊人,释放出沟通风格更宽松的信号。破折号。 @theo 指出输出中已不再出现破折号。这是互动率最高的回应帖。
Anthropic 的提示词攻略 (@ClaudeDevs):
整体交付任务,并明确“完成”标准及检查点。
无需再说“仔细思考”,因为模型总会先进行思考。
长时间运行后,询问模型还需要什么才能继续推进。
老套路为何失灵。 @dbreunig 指出,旧的 prompt 技巧如今与模型训练相冲突,这说明了可重新编译的 prompt 优化的必要性。
长时间运行的引导。 @omarsar0 关注到 Anthropic 针对长时任务给出的 prompt,模型有时会停下来汇报而不是继续执行。
Bug 反馈。 线上模型有时会生成 user 角色的对话(@BlackHC)。
实战写作质量。 Hamel Husain 直播了「Is Slop Dead?」来测试模型的写作能力(@HamelHusain)。@nptacek 也分享了个人写作评测中一次生成的结果。
视觉、3D 和代码即艺术的演示
感知能力提升。 Sholto Douglas 表示 5.5 系列在 3D 理解和建模上有「质的飞跃」,模型「现在能看见了,以前有点瞎」(@_sholtodouglas,@_sholtodouglas)。
用代码作画。 @jkeatn 让模型用纯 Python 逐像素生成绘画:
约 7500 行代码,仅用标准库模拟笔刷风格。
不依赖图像模型,也没有参考图。
Sholto 将这种「手工笔刷」式的创作与 diffusion 模型做了对比(@_sholtodouglas)。
Blender 场景。 Alex Albert 展示了在 claude.ai 上用一个 prompt 生成的 Blender 粘土动画(@alexalbert__)。他还基于史料还原了 1906 年的旧金山 Market Street:
素材来自 Sanborn 地图、当年的影片和档案照片。
纯程序化生成,不依赖下载的网格或纹理(@alexalbert__,提示词)。
@karpathy 对这个概念进行了发挥:将历史图片或视频转化为可漫游的定制 GTA 风格世界。
更多演示:
代码绘制的 JS 动画(@kevin_t_ngo)以及官方探索帖(@claudeai)。
代码生成的金门大桥,在 3D 场景方面被评为“媲美 Astra”(@petergyang)。
“我测试过的所有模型中视觉效果最好”(@other__reality)。
珊瑚礁壁纸;构建者表示其速度快了约 3 倍且成本更低(@chaseleantj)。
开放性问题。 @teortaxesTex 询问为何这一代模型在将函数映射到像素方面表现如此出色,并建议关注其泛化能力。
反响:支持、质疑与对比
支持声音:
流水线漏洞。 @rishdotblog 指出其发现了 Fable 和 Astra 错过的流水线问题。它还发现了 7 处 SEC 文件错误,包括 Comfort Systems 将 Q1 营收在 XBRL 中误标记为全年营收(@rishdotblog)。
回流用户。 “Claude 回来了”:@Yuchenj_UW 表示,离开一个月后,他正重新回到 Claude Code。
使用限额。 全天候高强度使用对限额的消耗“微乎其微”(@theo)。
怀旧情绪。 人们将其与备受好评的 Opus 4.5 和 4.6 进行比较(@arohan、@kimmonismus)。
竞争视角。 @scaling01 表示 Anthropic “又在前沿模型上耍大牌了”。@kimmonismus 称 “他们选择与 OpenAI 开战”。
持怀疑或中立态度:
信任赤字。 @kylebrussell 称他不再相信 Opus 的新版本会令人感到惊艳。Sholto 回复询问这次发布是否能让信任重获新生(@_sholtodouglas)。
限制并非人人受限。 @stablequan 表示反正自己从来不触及使用限制。
价格成为头条。 @dbreunig 提问,如果两家公司主打的卖点都是 token 降价,这意味着什么?
与 GPT‑6 Sol 正面交锋:
偏向 Opus。 @andrew_n_carr 称 Opus 5.5 “让 Sol 望尘莫及”。@synthwavedd 认为 Sol 表现未达预期,Anthropic “赢得了这一局”。
反对 Opus。 @teortaxesTex 指出,鉴于 Sol 的价格仅为 Opus 5.5 的一半,其成本和多智能体优势会被 “Astra+Sol+Luna 的频繁调用所抵消”(@scaling01)。
中立。 @kimmonismus 的总结认为胜负难分:Anthropic 在能力惊喜上领先,OpenAI 则在价格上占优。@simonw 发布了一篇评测文章,在不同 effort 级别下用鹈鹕网格(pelican grids)对比了这三款模型。
OpenAI 发布 GPT-6 Sol 与 Luna:基于 Astra 的更便宜模型,覆盖 Codex、Work 和 API
OpenAI 数小时内便作出回应,推出 GPT-6 Sol 和 GPT-6 Luna,主打更快、更便宜,并继承了 GPT-6 Astra 在编程、计算机操作、事实性和对齐方面的大部分进展 @OpenAI @OpenAIDevs。定价相当激进:Sol 为每百万输入/输出 token $2 / $10,Luna 为 $0.10 / $0.50,均比对应的 GPT-5.6 前代便宜约 50% @OpenAI。两款模型已上线 ChatGPT Work 和 Codex 以及 API,桌面端应用中的 Free 和 Go 用户也可以使用 Luna,但值得注意的是暂不支持 Chat 模式 @OpenAI。
OpenAI 的宣传重点放在单位任务成本的 Pareto 优化上,而非旗舰级的绝对性能领先。官方示例称,在 AutomationBench 上,Sol 以 xhigh effort 运行可超过 Claude Opus 5 max,而成本仅为每任务约 9%;在 OSWorld 2.0 离线测试中,Luna max 优于 GPT-5.6 Sol medium,成本只有十分之一 @reach_vb。第三方集成也迅速跟进:Perplexity 将 Sol 设为默认的 “Light” effort 编排模型 @perplexity_ai;Devin 称 Sol 在每任务成本低 61% 的情况下与 GPT-5.6 Sol 表现相当,Luna 则以约四分之一的成本胜过前代 @cognition;Arena 也已加入两款模型用于 agent 和代码方向的测试 @arena。
深层基础设施的故事可能比产品命名更重要。OpenAI 称其提升了缓存与推理效率,支持针对缓存输入令牌读取高达 90% 的折扣,并推出了新的 Prompt Caching Dashboard 及诊断 API,以帮助理解缓存复用故障 @OpenAIDevs @OpenAIDevs。这对长期运行的 Agent 尤为关键,因为工具切换或推理变更引发的缓存失效一直成本高昂。市场反应不一:许多人称赞其经济性,尤其是 Luna 的价格底线;另一些人则认为 Anthropic 在顶级模型质量上胜出,而 OpenAI 在亲民定价与部署易用性上占优 @kimmonismus @synthwavedd。
Agent 基础设施、评测工具及基于真实场景的后续训练
多篇帖子指向一个日益熟悉的趋势:价值重心正从单纯的模型访问转向<強> Harness、评测、路由及基于专有轨迹的后续训练。DigitalOcean Managed Agents 进入公测,支持 Claude Code、Codex 及 LangGraph 风格的 Agent,具备闲置暂停运行时、受治理的工具端点及 75+ 模型选择 @digitalocean。在开发工作流方面,VS Code Agent Merge 引入了实验模式,可自动在 PR 中解决评审意见、失败检查及合并冲突 @code。
Perplexity 分享了目前较为具体的训练后(post-training)报告之一:其 Computer agent 混合使用了拒绝采样微调(rejection-sampling fine-tuning)和提示引导的自蒸馏(hint-guided self-distillation),基于真实用户会话数据,从成功轨迹和明确的工具调用错误中学习。据称在在线 A/B 测试中,工具调用失败率降低了 21.2% @perplexity_ai @AravSrinivas。这是一个很好的例子,展示了实验室如何通过生产环境追踪数据(production traces)而非纯合成强化学习环境,将仿真到真实的跨越(sim-to-real bridging)落地应用。
评估(Eval)和可观测性(observability)工具也备受关注。Lenny’s newsletter 列举了 Ramp、Shopify、Harvey 和 Cursor 等公司投资评估体系带来的具体投资回报率,并推荐了 Hamel Husain 和 Shreya Shankar 关于高级评估系统的后续文章 @lennysan。Hamel 还发布了一个评估技能/插件,旨在自动化评估审计和错误分析的部分环节 @lennysan。在可观测性方面,LangSmith 增强了对 决策模型(如 Jev/SemIf)的支持,使 agent 追踪中的状态、问题、选项和输出更易检查 @hwchase17 @LangChain。来自多位从业者的核心观点:即使模型和提示词相同,执行框架(harness)也可能显著改变基准测试结果 @omarsar0。
开放模型、压缩以及在更小硬件上运行更大模型的工程实践
Tim Dettmers开启了“开源周”,发布了集成到 bitsandbytes2 的运行时动态压缩框架,目标是高质量实现 1.5–2.0 bit 压缩,并承诺提供“惰性压缩”——在部署时自动找到更优的内存/质量/速度权衡方案 @Tim_Dettmers @Tim_Dettmers。这套方案明确面向内存受限、想要运行大型开源权重模型(包括不断增长的 KV cache)的小团队和个人。
硬件与本地部署也是本周的主题之一。一篇关于 NVIDIA DGX Spark 的上手文章介绍了这款 15×15×5.05 厘米、重 1.2 kg 的设备:搭载 GB10 Grace Blackwell 芯片、128 GB 统一内存,理论算力最高可达 1 PFLOP FP4 稀疏计算。NVIDIA 声称经量化后可本地推理高达 200B 参数的模型,并可通过 QLoRA 等方法微调最高 70B 的模型 @kimmonismus。另外,Reka EdgeQ 展示了一款针对 Qualcomm Hexagon NPU 直接优化的端侧 VLM,TTFT 仅 0.73 秒、每次推理耗电 6.9 mWh,且让 GPU 保持空闲以维持持续散热表现 @RekaAILabs。
在开源模型方面,除了常规的讨论,还涌现了几项有实质意义的发布。Step Code v0.1.0 基于 MIT 协议推出,这是一个编码代理 CLI,据称在 Terminal-Bench 2.1 上得分 80.9%,在 Multi-Frame(一项包含 150 个长程任务的基准测试)上得分 73.3% @StepFun_ai。Ming-Image-0.1-Design 是一个 6B 参数量的开源权重图像设计模型家族,发布时同步推出了 UI 设计和“图像转可编辑 PPT”等代理技能,并声称在 Artificial Analysis 的 UI/UX 设计排行榜上位列 开源权重模型第一 @AntLingAGI。此外,Rigel 带来了一项规模较小但在技术上颇具亮点的预训练成果,这是一款 2.3B 总参/360B 激活参数的 Hybrid Mamba-2 MoE 模型,据称是在 H100/A100/V100 及 TPU v5p/v6e 等异构混合硬件上、基于同一套代码库训练而成的,仅用 Llama-3.2-3B 预训练 FLOPs 的 <1% 便达到了与其差距无几的性能 @MayankMish98。
多模态模型:图像、视频、语音与世界模型
在图像生成与编辑领域,Qwen-Image-2.1 在社区排行榜上表现强劲,同时在 Image Edit Arena 和 Text-to-Image Arena 中拿下 开源模型第一,整体表现已逼近前沿闭源系统 @arena。生态配套工作方面,包括支持 Unsloth Desktop 的 INT8/FP8 及 GGUF 格式,配合内存卸载可在 6–8 GB VRAM 下运行 @danielhanchen,以及 Gradio 致力于将 Qwen 默认的 9B 提示词改写器 精简至 0.8B 以便在笔记本电脑上运行 @Gradio。
在视频和实时媒体领域,PixVerse R2 被宣布为一款实时世界模型,强调可编辑、持久化的“活体世界” @PixVerse;而 fal 则发布了 H3 Max 的技术栈拆解,声称通过涵盖后训练、GPU 执行、权重加载、扩展及服务等环节的优化,实现了3 秒内生成 5 秒视频 @fal。其世界模型加速器接口值得关注,该接口将请求/响应语义替换为针对交互式模型的持久化 WebRTC 会话 @fal。
语音领域同样活跃。AssemblyAI Universal-3.5 Pro 在 OpenRouter 上线,支持19 种语言的同步 STT,并通过关键词和提示词实现领域导向,目前还有临时折扣 @OpenRouter。StepAudio 3 ASR 在 Artificial Analysis 的AA-WER 指数上达到了1.7% 的词错率,在非流式语音转文本领域基本与榜首持平,尽管价格略高 @ArtificialAnlys。Moondream 还发布了支持25 种语言的本地 STT 模型 Parakeet Redux 和 Parakeet Ultra,分别针对 CPU 和 GPU 进行优化 @moondreamai。
热门推文(按互动量排序)
Claude Opus 5.5 发布:Anthropic 的主要发布帖互动量最高,定义了当天最大的模型事件 @claudeai。
GPT-6 Sol 和 Luna 发布:OpenAI 推出更便宜的 Astra 衍生模型,是当天的另一大头条 @OpenAI。
Managed Agents 预览版:DigitalOcean 为 Claude Code/Codex/自定义智能体推出的托管运行时公开预览,引发了异常高的基础设施关注度 @digitalocean。
OpenAI 标准提案:Sam Altman 关于 AI 标准与治理的发帖引发了大量讨论,热度超出一般产品新闻 @sama。
Epoch 谈 AI 成本曲线:Epoch 估算自 2023 年以来,同等性能下的 AI 成本每季度下降约 47%,这是当天颇有价值的宏观数据 @EpochAIResearch。
AI Reddit 摘要
/r/LocalLlama + /r/localLLM 摘要
1. Qwen、DeepSeek 与 AliceAI 大模型路线图
Qwen4-27B 已获确认(热度:2353):一张会议幻灯片 截图似乎确认了即将推出的 Qwen4 系列,明确列出了 Qwen4-27B,与 Qwen4-Max、Qwen4-Flash 和 Qwen4-Plus 并列。帖子指出,社区关心阿里巴巴是否也会发布更小的 MoE 变体如
35B-A3B,有评论者推测 N-gram 之类的架构改动可能降低显存需求。评论者主要在讨论 Qwen4-27B 能否超越 Qwen 3.8 Flash Next,以及最佳本地推理方案会偏向独立显卡还是大容量统一内存设备。大家还期待在 Qwen4 Flash、Qwen3.8 Flash Next 和 Qwen4-27B 都以开放权重发布后进行对比。有评论者推测,如果 Qwen4-27B 采用 N-gram 风格架构,显存需求可能更低,但帖子里没有给出具体实现细节或显存数据。
有人提出在假设三者都以开放权重发布的前提下,对比 Qwen4 Flash、Qwen3.8 Flash Next 和 Qwen4-27B。核心问题是:稠密/标准
27B模型能否足够明显地超越更小的 Flash 变体,从而决定用户该优先选择独立显卡还是大统一内存系统。有用户希望Qwen4 Flash能保持类似Flash Next的内存占用,目标部署在
128 GB显存以内,反映出大家关注大型开源权重 Qwen 模型在本地进行推理的可行性。
阿里巴巴计划推出参数量达 5 万亿至 10 万亿的 AI 模型,并发布新芯片(互动量:648):据报道,阿里巴巴正计划开发参数量在
5T–10T区间的 AI 模型,并展示了新款 AI 芯片,暗示其前沿规模训练/推理目标远超当前消费级或本地部署的实用性。评论者将此举与此前对 DeepSeek R1671B/691B级别规模的激动情绪相联系,并预计任何实际下游应用都将通过蒸馏到更小的 Qwen 家族模型来实现,例如假设中的Qwen 4 27B。 主要争论在于对本地推理可行性的怀疑——“每个 token 需数分钟”——与乐观观点之间的对立,后者认为阿里巴巴可能会将内部更大的模型(可能是“Astra”)蒸馏为一个真正具有竞争力的中国前沿模型。评论者指出,5T–10T 参数的阿里巴巴模型对绝大多数用户而言将仅支持 API 调用,在家庭实验室硬件上进行本地部署不切实际,且在没有重大稀疏化、量化或专用服务硬件的情况下,生成速度可能慢至“每个 token 需数分钟”。
多篇评论将可能的实用价值框架为蒸馏,并将其与DeepSeek R1
671B/691B级别参数量引发的兴奋之情相比,建议用户不妨等待一个更小的衍生模型(如假设的Qwen 4 27B),以便能在本地运行。一位评论者推测,如果阿里巴巴已成功蒸馏或融入了Astra的能力,这可能意味着其对中国前沿模型的推进更为认真,但该线程并未提供基准测试证据或实现细节来验证这一说法。