
GitHub 2026 年 8 月可用性报告
虽然我们仍在持续取得进展,但八月的可用性表现颇具挑战。关于这些事故的更多细节,可以阅读我们上个月发布的一篇博客文章。我们正在大力投资架构改进并迁移到 Azure,这将为我们带来更多容量。与此同时,平台的流量仍在快速增长。我们优先做影响最大的工作,同时尽量控制风险,但正如八月这几起事故所示,风险无法完全消除。
归根结底,所有工作都得做,而事故也让我们有机会调整优先级。基于这些事故的修复项,我们对容量监控与管理、曾导致更大影响的 retry 策略以及核心服务的弹性都做了显著改进。此外,多项长期工作也在稳步推进。
8 月 11 日,GitHub 首次在 Azure 上运行了生产环境的 MySQL primary。客户端观察到的写入影响微乎其微,切换过程中没有对客户造成任何影响。8 月 27 日,我们又以同样的方式迁移了两个 primary。未来几周还会安排更多 primary 的迁移,随着每次 failover 积累经验,复杂度也会逐步提升。
读取流量也创下新高:已迁移服务的读取占比峰值达 60.4%,GitHub 单体应用在 Azure 上的读取占比峰值达 64.3%,Git 读取达到 54%。
在区域迁移之外,包含 24 张表的 authentication-core 集群已从 GitHub 最古老的共享数据库 mysql1 上迁走,为其 replica 减掉了约每秒一百万次查询。另一些查询治理方面的改动又减少了每秒 12 万次查询,并消除了每小时约 59,000 秒的无效数据库开销。
GitHub Actions 获得了额外容量,同时更长期的隔离工作仍在推进。通过调整任务路由,我们把 33% 的任务从紧张的生产集群挪到了空闲容量上,把 cache CPU 峰值利用率从 98% 降到 80%,相当于争取到了约三个月的缓冲空间。这只是近期的缓解措施,而非终点;八月的事故再次表明,我们需要更持久的容量与隔离方案,相关工作仍在继续。
拉取请求(Pull Request)隔离工作持续推进。除了已支持的匿名流量外,首批生产环境用户的认证读取流量占比也达到了 100%。
在 Git 过载保护方面的投入带来了显著收益:承载流量增加 6.4%,第 95 百分位延迟降低 24%,最大延迟减少 78%。边缘层更广泛的负载卸载保护也取得进展,为 GitHub 在应对突发高负载时提供了更多调节手段。实际上,这些保护措施在缓解八月份上述事件时发挥了关键作用。
我们同时改进了监控和遥测能力。拉取请求监控现在能够独立衡量合并、审查和评论的失败率,避免因高读取量掩盖写入路径的故障。8 月 21 日起,自动化的高影响事件检测开始结合客户支持信号与服务遥测数据。API 监控也在 30 天内完成了重新校准与验证,降低了噪声并提升了信号质量。这些变更有效提升了故障检测与响应效率。
下月工作计划包括:迁移下一批数据库主节点;继续将相关服务及其流量迁移至 Azure;重点改善共享数据库的健康状况;增强容量管理和自动伸缩的自动化能力;并在拉取请求体验的更多环节扩展依赖故障处理能力。
这一原则将继续指导我们的工作:可用性,然后是容量,最后才是功能。
8 月 6 日 15:22 UTC(持续 10 小时 42 分钟)
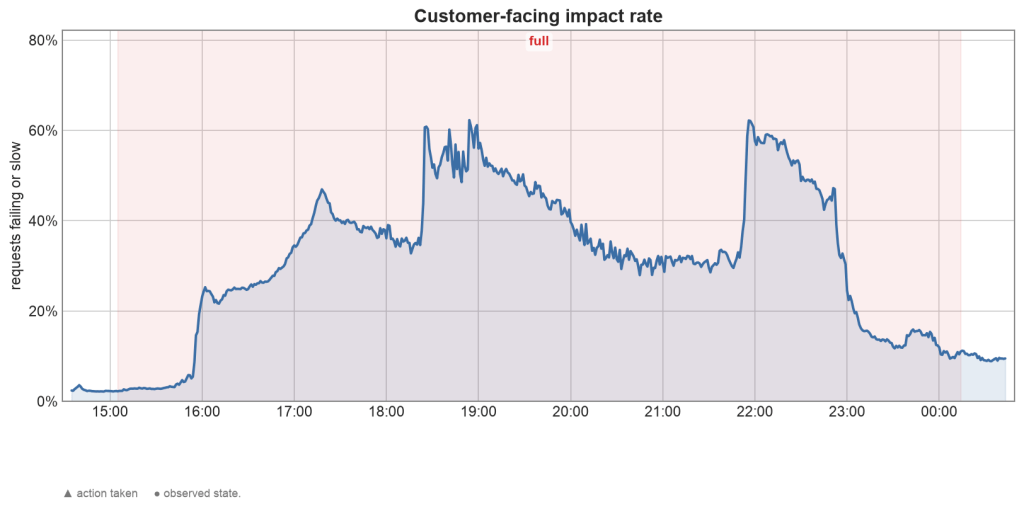
发生了什么?
此次事件源于一项针对内部 GitHub Actions 服务的例行部署。该服务负责处理传入事件并将其转化为 Actions 作业。部署内容本身并非故障原因(我们已回滚以证实这一点);问题在于,滚动更新过程中替换 Pod 时,短暂降低了其中一个站点的容量,导致流量向其他站点转移时超出了它们的承载极限。事件中段的受影响程度最为严重,当时大量 Actions 工作流运行失败,无法启动或完成。
哪里出了问题,原因是什么?
受影响的 Actions 服务当时已接近其容量和并发上限。一次常规部署短暂减少了运行中的 Pod 数量,迅速耗尽了剩余余量。这导致服务网格代理(sidecar)出现 CPU 限流和内存溢出重启,并进而引发多个集群中缓存、DNS 和 API 错误的级联故障。这些服务的入口服务网格余量有限,无法在部署期间吸收临时的容量损失。
随着核心服务恢复,任务分配路径中一个潜在 Bug 拖慢了恢复进程:Runner 被分配了已被撤销的任务,随后因不断重试这些无效任务而陷入卡死,无法处理有效工作,形成了自我放大的积压。
我们如何响应?
- 对内部 Actions 服务的一次常规部署短暂降低了某个数据中心的运行容量,几分钟内服务网格和剩余 Pod 即达到饱和。
- 缓存、DNS 和 API 错误在集群间扩散,Actions 基础设施故障率攀升,级联效应随之展开。我们宣布公开事故,识别出触发部署并回滚,以确认其内容并非根本原因。
- 随后约两小时内,我们扩展了饱和服务的容量,并限流入站的 Webhook 触发任务,以便系统稳定。
- 核心服务恢复时,大量排队任务仍然积压。一个潜在 Bug 导致 Runner 被分配不再有效的任务,随后卡在重试环节,阻碍了实际工作的处理。
- 我们部署修复,使 Runner 停止获取无效任务,清空积累的队列,并提高了拖慢恢复的内部速率限制。工作流成功率逐步回升至正常水平。
- 系统级队列被清空,Actions 恢复正常操作。少数自托管 Runner 保持卡死状态,需手动恢复;事故期间产生的部分事件无法自动重放,不得不重新触发。
我们如何降低此类事故发生的可能性或影响程度?
- 为服务网格入口和受影响的 Actions 服务增加余量并启用自动扩缩容,确保常规部署不会使其进入饱和状态。
- 在这些服务的部署过程中避免减少容量,以提升部署安全性。
- 加强监控,以便更早发现此类事故发生前的负载饱和与数据库代理异常状况。
- 改进大规模事故期间系统的甩负载和积压任务清理机制,避免 runner 卡在重试无效任务上。
- 在即将发布的 runner 和 ARC 版本中,为受此故障模式影响的自托管 Actions Runner Controller runner 提供自动恢复能力。
8 月 17 日 13:40 UTC(持续 7 小时 35 分钟)
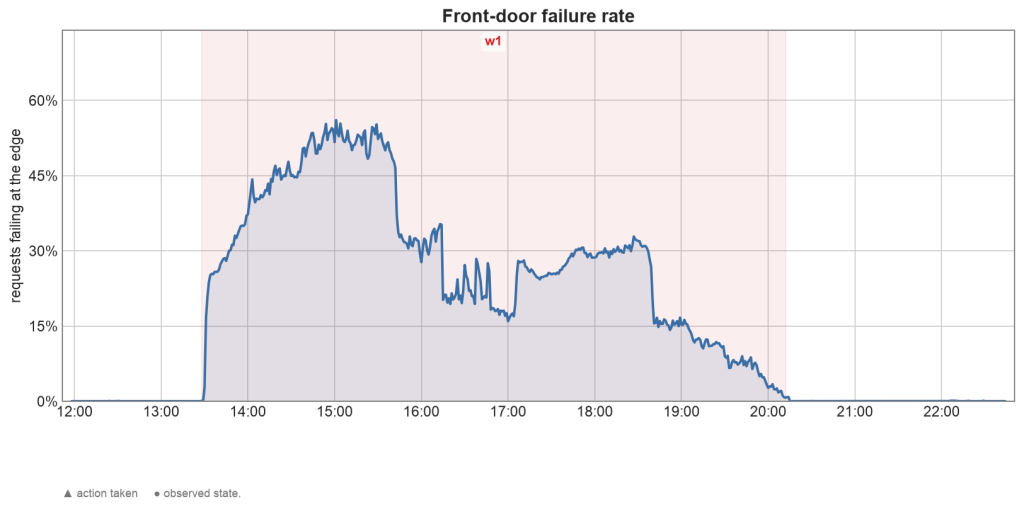
发生了什么?
问题原因是什么?
一波新的流量高峰使某个数据中心的负载均衡器超出了承载上限,同时一个 service-mesh sidecar 达到并发上限后未能扩容。
随着请求不断积压,该数据中心多个负载均衡节点的网络流上限被耗尽,共享的网关认证链路因此降级,导致经由该数据中心路由的大量服务普遍出现认证延迟和失败。
一个潜藏的客户端重试 bug 大幅放大了发往某个内部认证端点的流量,拖慢了 Copilot Token Service 的恢复速度。核心问题在于:service-mesh sidecar 未能扩容,加上重试行为失控,客户端缺乏足够的约束,导致局部降级被放大成更大范围的过载。
我们如何应对?
- 流量高峰使某数据中心的负载均衡器逼近承载上限;一个 service-mesh sidecar 达到并发上限且未能扩容。
- 过载开始级联:多个负载均衡节点的网络流上限耗尽,共享认证链路降级;issues、pull requests、API、Actions、Copilot 等服务开始返回错误、响应变慢。
- 自动监控检测到错误率升高并触发事故流程;公开状态页将受影响产品标记为降级,相关服务团队的工程师陆续加入处理。
- 工程师将故障定位到单个数据中心负载均衡器的网络饱和问题,开始把部分流量切换到其他数据中心,并减少网关重试以缓解压力。
- 团队在过载节点上停止了负载均衡进程,并屏蔽了触发重试的请求,这些请求正流向受影响最严重的内部端点,此举带来了广泛且即时的恢复。
- 由客户端重试放大导致的剩余认证错误,通过逐渐恢复流量流量得到了稳定,在持续的健康遥测数据后,事故得以解决。
我们如何降低类似事故的概率或影响?
- 修正自动扩缩容策略,使其不仅考虑主机服务,还兼顾服务网格边车的并发量和容量。
- 审计受影响服务中服务网格的请求、并发和扩缩容限制。
- 审查网关和客户端的重试及退避限制,防止局部退化被放大为更广泛的过载。
- 修复在事故期间放大了认证流量的客户端重试行为。
- 改进负载均衡器容量监控,并加强区域故障转移保障。
8月20日 14:43 UTC(持续9小时54分钟)
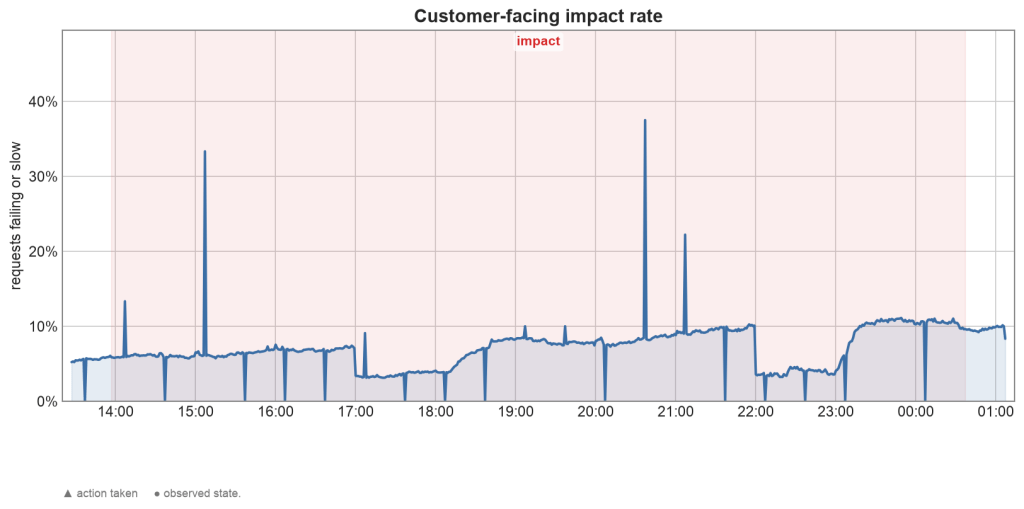
发生了什么?
在事故期间,Copilot 云代理任务受到影响。任务本身仍然运行至完成,因此没有工作丢失。一旦处理进度追赶上来,正确的状态和结果就会显示出来。稍等片刻或稍后再次查看,即可看到最新状态。
在整个事故期间,至少 54 个组织经历了 Copilot Cloud Agent 任务状态和结果滞后,远高于其正常水平。每分钟的客户影响峰值达到了任务状态活动测量值的 37.5%。
哪里出了问题,原因是什么?
Copilot 云代理使用托管云数据库存储每个代理任务的状态和结果。该数据库的一个区域遭遇了提供商层面的中断,导致受影响区域内读写任务状态的调用开始失败并运行缓慢。
负责将任务状态更新写入该数据库的流式处理器,随着数据库延迟升高开始处理不过来。这些处理器的吞吐量受限于固定数量的处理分区,其容量仅能应对正常延迟并预留少量余量。本次事件中的延迟远超这一余量,导致任务状态更新积压而非被清除。数据库的一项存储配置还拖慢了受影响区域的服务切换过程,导致首次切换未生效,恢复时间也因此长于预期。
我们如何应对?
- 存储 Copilot 云端代理任务状态的管理型云数据库的一个区域,在服务商侧区域故障后开始出现故障并运行缓慢。
- 值班工程师收到告警,开启事故响应流程,并将错误追溯至受影响的数据库区域。
- 工程师尝试对该区域执行故障转移,但并未生效——数据库的存储配置导致该区域响应迟缓——任务状态更新因此持续积压。
- 团队强制将受影响区域下线,并将任务状态处理切换至健康区域;写延迟仍维持在较高水平,积压导致状态视图延迟。
- 增加流式处理能力,并随着服务商区域逐步恢复,处理器开始消化积压,任务状态及结果随之更新。
- 延迟恢复正常,积压清除,事故得到缓解并解决。
我们如何降低此类事故的再次发生概率或影响?
- 移除导致受影响区域故障转移缓慢的数据库存储配置,以便在单区域出现问题时能快速撤离。
- 完善该数据库区域故障转移的操作手册,包括一份经过验证、有序的备用区域列表,以确保服务保持健康。
- 重新评估故障转移优先级,确保故障转移时选择的下一个区域是最佳的健康选项。
- 增强任务状态流式处理对数据库高延迟的容错能力,避免延迟尖峰立即导致吞吐量受限并形成积压。
- 改进管理型数据库的监控与升级机制。
8月26日 15:11 UTC(持续2小时50分钟)
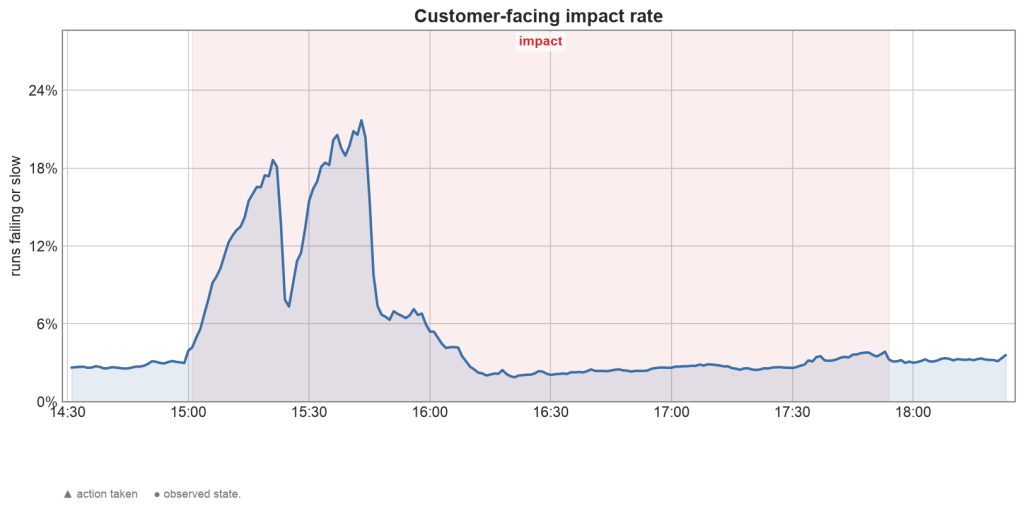
发生了什么?
一些依赖 Actions 运行的服务也受到了影响,包括 Copilot code review 和部分 GitHub Pages 部署。
大多数情况下,积压的任务排空后,延迟的运行就会自动开始;事故期间未能启动的运行,在事故后重新执行也都成功了。只有事故最初阶段创建的少数运行无法通过重新执行恢复,只能全新启动。
问题出在哪里?
简单来说,我们的共享基础设施服务没有跟上 Actions 逐月增长的速度和峰值负载。
一波涌入的事件叠加在原本已经很高的负载之上,把数据库推过了临界点。查询耗时攀升,数据库主节点达到饱和。
数据库过载后,负责把传入事件转换成 runner 分配的内部服务也跟不上了,导致 Actions 运行无法启动,排队时间远超正常水平。
对数据库主节点做故障转移只是部分缓解了问题。用于削减入站负载的限流阈值最初设置得偏高,没能充分保护数据库,因此恢复只能缓慢、手动地逐步推进。
当时没有自动熔断机制在数据库出现早期压力信号时对入站 Actions 负载进行限流,所以保护性限流只能在事故过程中手动实施和调整。这也是本次事故的一个教训。
我们如何应对?
- 在日常流量高峰期间,一波涌入的事件到达,而 Actions 依赖的一个共享数据库当时已接近运行极限。数据库主节点的写入和查询压力急剧上升,开始饱和。
- 负责把传入事件转换成 runner 分配的内部服务已无法跟上处理节奏。Actions 运行开始失败,我们随即启动了事故调查。
- 我们将数据库主节点故障转移到副本。情况一度有所改善,但未能完全缓解,运行依然失败或延迟启动。 * 我们限制了入站事件处理以减轻数据库压力,使其得以恢复。一旦限流和服务重启生效,核心服务的健康状态即恢复正常,但入站工作的处理速度此时已被有意放缓。 * 我们逐步提高限流阈值,并在每个步骤监控遥测数据,以确保不会再次压垮数据库,直到完整的事件处理恢复,积压的延迟工作清空。随后,我们将此次事故标记为已缓解。 * 一批运行在大型及自托管 runner 上的任务仍卡在等待 runner 的状态。我们部署了一项更改以释放这些任务,并继续后续工作以清除那些仍显示为已排队状态的运行。
- Kimi K3 的上游服务商出现性能降级,导致路由至该模型的 Copilot 请求失败率升高。
- 数分钟内,监控系统标记出错误率异常,我们随即开始调查。
- 我们宣布进入事故状态,定位到问题源于上游服务商专门影响 Kimi K3 的降级,并发布了指向该服务商的公开状态更新。
- 在此期间,使用其他模型或 Auto 设置的请求保持正常,因此重试或切换模型均能成功。
- 我们向服务商提交工单,并监测恢复情况,仪表板上的成功率逐步回升至正常水平。
- 事故一直保持开放状态,直至服务商确认 Kimi K3 完全恢复,随后我们将事故标记为已解决。
- 与上游服务商协作,提升 Kimi K3 模型的可靠性,减少此类事故中观察到的错误。
- 调研 Kimi K3 的备用服务容量,确保单一服务商降级时有后备方案。
我们正在如何降低类似事故发生的概率或减轻其影响?
* 通过优化客户端代码中的特定代码路径,提高数据库查询效率。 * 增加自动熔断器,当数据库出现压力迹象时,自动限制入站操作负载,而非依赖事故期间的人工限流。 * 增加保护措施,限制服务在副本滞后时回退到数据库主节点频率,以防回退加剧数据库压力。 * 提升事故后快速取消或清除处于排队或等待 runner 状态任务的能力,使受影响的作业能更快恢复。 * 继续推进针对 Actions 此部分的扩展和弹性工作,包括在事故发生时已完成并正在滚出的变更。8 月 27 日 10:04 UTC(持续 2 小时 8 分钟)
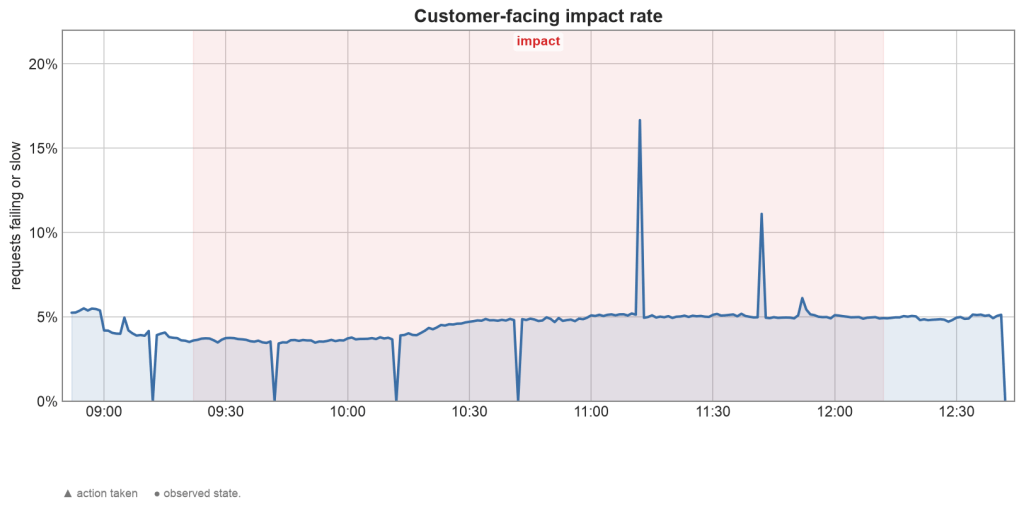
发生了什么?
配置为使用 Kimi K3 模型的客户受到了此次事故的影响。使用其他模型或切换至其他模型的客户未受到影响。
哪里出了错,原因是什么?
Copilot 提供多种 AI 模型选择。其中之一 Kimi K3 由上游模型提供商服务。
该提供商的服务性能下降,导致大量 Kimi K3 请求失败并返回错误。由于问题出在上游提供商,使用其他模型的请求——以及使用 Auto 设置(该设置会路由至不同模型)的请求——均未受影响。
在服务商的缓解措施生效前,Kimi K3 的请求持续有一定比例的失败率。峰值时,使用 Kimi K3 的失败请求占比超过一半。
我们如何应对?
我们如何降低此类事故发生的概率或减轻其影响?
请关注我们的状态页面,获取状态变更的实时更新及事故后的复盘。了解我们最新的工作内容,请访问GitHub Blog的工程板块。