
多台AI服务器,如何共享大模型的“记忆”?
从一台机器里的缓存层级,走向多台服务器之间的缓存协作。
大模型推理不仅需要算力,也需要把已经算过的数据放好、搬好。如果一份长文档已经被一台服务器处理过,另一台接到具有相同输入前缀的请求时,能不能少算一遍?
PART 01服务器变多,重复计算未必变少
企业知识问答、代码助手和多轮对话,经常反复使用相同的系统提示词、文档开头和历史内容。请求分散到不同服务器之后,同一段输入也可能被反复处理。
KV Cache,是注意力计算产生的Key和Value状态缓存。可以简单理解为:大模型读过内容后留下的“临时记忆”。它不是模型权重,也不是原始文档。
如果这份缓存只留在本机,其他机器就难以直接利用。扩容服务器增加了计算资源,却没有自动解决“算过的东西如何共享”。
PART 02读懂输入和持续输出,是两种工作
一次推理通常分为prefill和decode。Prefill叫预填充,就是处理输入、形成KV状态;decode叫解码,就是接着逐个生成token。Token可理解为模型处理文字的基本单位。
长输入的预填充需要较多计算;解码则要持续读取权重和缓存。两者挤在同一组GPU上,可能相互干扰:一个长文档开始处理,正在输出的对话也跟着停顿。
用户关心的不只是总共生成多少字,还包括多久开始回答,以及输出是否流畅。论文分别用TTFT(首个token等待时间)和TBT(相邻输出token的时间间隔)描述它们。其中,论文对每个请求取耗时较长的10%相邻token间隔的平均值,作为TBT指标。
PART 03Mooncake把缓存变成集群资源
Mooncake将预填充与解码交给不同的实例池,同时通过Mooncake Store汇集节点上的缓存资源。这里的“池”,可以理解为由多台服务器共同提供、由系统协调使用的一组资源。
架构纳入CPU、DRAM主内存、SSD固态硬盘和网络资源。缓存不再只能由保存它的那台机器使用,而是可以按需迁移、复用。
全局调度器Conductor负责协调:请求去哪里,缓存从哪里来,哪台解码实例接着输出。它看的不只是“哪台服务器空闲”,还包括“哪里已经保存了可复用的前缀”。
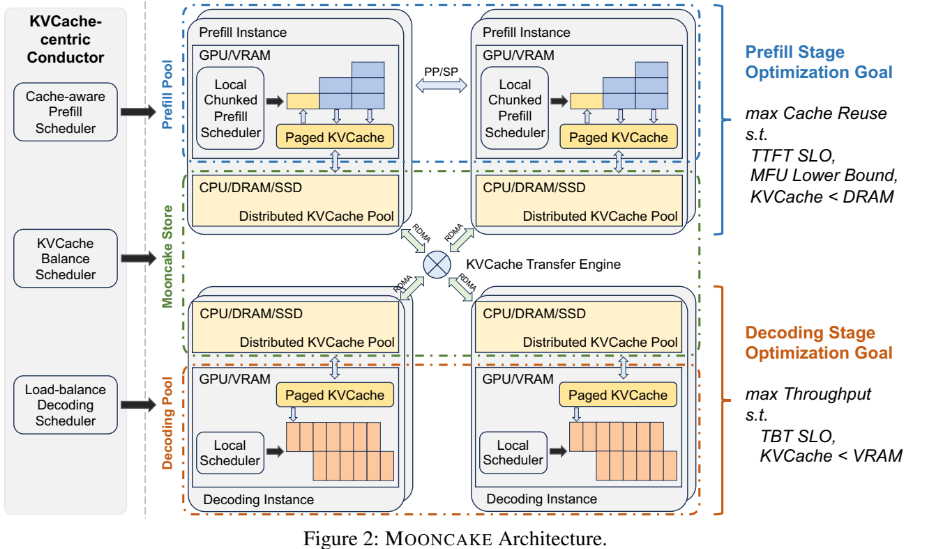
图1|Mooncake整体架构:预填充池、解码池与分布式KV缓存池,由全局调度器协调。来源:Mooncake,FAST ’25,Fig.2。
PART 04一次请求,怎样穿过这套系统?
先找缓存。系统把输入切成块,并结合前缀生成标识,寻找可以复用的KV。这里要求匹配共同前缀,不是把任意位置出现的同一段文字缓存直接拼起来。
再算增量。选中的预填充实例加载已有前缀,只继续计算尚未缓存的输入;新产生的KV逐层写回主内存。
随后边算边传。缓存传输与增量预填充交叠,把KV送到选定解码节点的主内存。解码端收齐所需缓存后,采用持续组批方式处理请求:每轮计算加入新请求、移出已完成请求,继续生成答案。
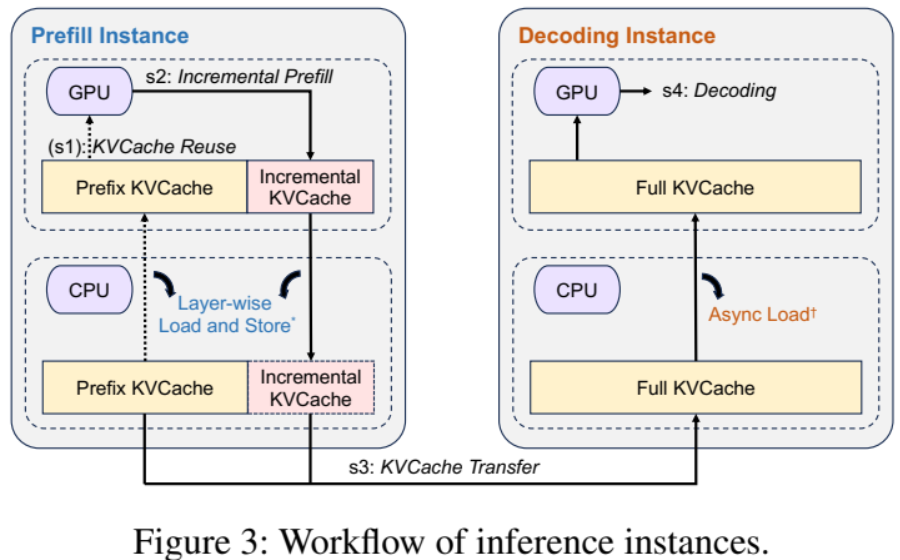
图2|缓存复用、增量预填充、跨节点传输与解码的数据流。缓存传输可与前面的计算重叠。来源:Mooncake,FAST ’25,Fig.3。
PART 05不是“有缓存就搬”,而是先算这笔账
远端有缓存,不代表远端就值得访问。搬运需要时间,持有缓存的节点也可能正在排队或承受网络压力。
Conductor会估算传输、排队和预填充时间,再选择实例。热点缓存还可以形成多个副本,分散访问压力;缓存空间不足时,系统采用LRU(最近最少使用)策略,也就是优先淘汰最久未使用的缓存块,但会保护正在被请求访问的块。
传输引擎使用RDMA,即远程直接内存访问。大白话说,就是让网卡承担更多跨机器内存搬运,减少CPU参与。引擎还会考虑网卡与内存的连接位置,避免流量都挤过同一条受限通路。
共享缓存的价值,要同时扣除搬运和排队的成本。这也是为什么Mooncake不只是一个更大的缓存仓库。
PART 06实验看什么,而不只看一个大数字?
先交代环境。论文实验使用架构参照LLaMA3-70B的测试模型(dummy model),不能将其视为对Kimi实际生产模型的公开测试。每节点配置8张A800-SXM4-80GB GPU和4张200Gbps RDMA网卡,缓存块大小为256 tokens;端到端对照使用vLLM 0.5.1,前缀缓存与分块预填充功能分别测试。(§5.1)
14%平均TTFT减少约16节点 · 会话轨迹回放全局 vs 本地缓存感知调度 · Fig.5
一组实验关注调度。在16个上述节点、回放Kimi会话轨迹的条件下,相比本地缓存感知调度,全局缓存感知调度的平均TTFT从3.58秒降至3.07秒,论文报告减少约14%。(§4.2,Fig.5)
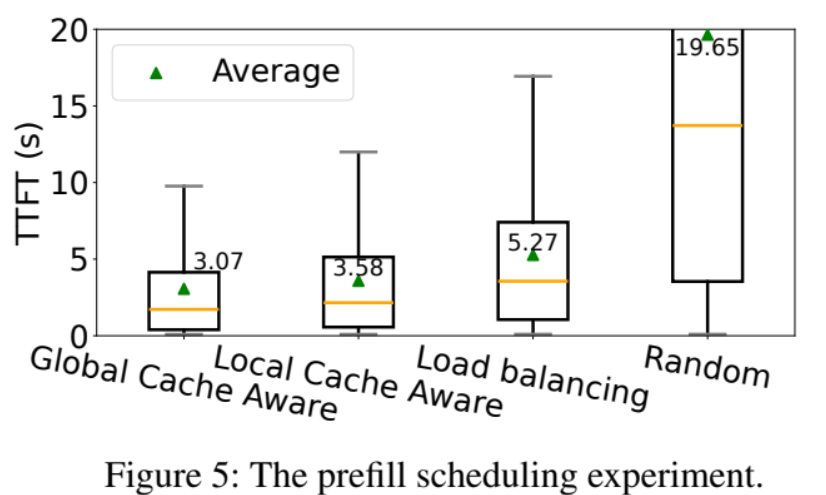
图3|不同调度策略下的TTFT分布,绿色三角标出平均值。本文14%的比较对象是Local Cache Aware,不是随机调度。来源:Mooncake,FAST ’25,Fig.5。
另一组实验关注共享本身。研究人员使用10个预填充节点,每节点缓存容量均为300万tokens,并把每次请求输出限制为1个token,以隔离解码影响。
48%prefill GPU时间减少10个预填充节点 · 输出1 tokenSynthetic · 全局 vs 本地缓存 · Fig.10
在合成负载下,相比只能访问本地缓存的配置,全局共享配置的缓存命中率为其2.36倍;平均prefill GPU时间降至其52%,即减少48%。合成负载由ShareGPT、Leval和LooGLE构造;在该负载下获得的实验收益,不能直接推广到其他线上业务。(§5.3.2,Fig.10)
图4|本地与全局缓存的命中率、平均prefill GPU时间对比。2.36倍与减少48%对应Synthetic组。来源:Mooncake,FAST ’25,Fig.10。
这些结果不能拼成一个总加速比:14%衡量首字等待,48%衡量特定配置的预填充GPU时间,2.36倍衡量缓存命中率。
PART 07它不是给集群接上SSD就能生效
收益依赖前缀复用程度、网络带宽和调度能力。若请求很少共享前缀,或跨节点传输拥塞,保存更多缓存不一定换来更快响应。
论文在指定合成负载的带宽实验中发现,带宽低于100Gbps时,TTFT明显恶化。这不是所有部署的统一门槛,但说明网络成本不能省略。(§5.4.2)
架构虽然包含SSD,本文引用的共享缓存实验却不能证明“增加SSD带来48%加速”。论文也没有给出可将这些收益单独归因于SSD的对照。
此外,系统用SLO,即服务延迟目标,约束调度;预测无法满足目标的请求可能被拒绝。论文的“有效请求容量”按同时满足TTFT与TBT条件的请求比例定义,不是GPU算力,也不是无条件接收全部请求的能力。
PART 08锋行致远视角:优化对象是一条数据路径
从行业角度看,Mooncake提示我们:当推理走向多机协作,缓存不仅要考虑容量,还要考虑放置、复用、复制与传输。
Storage → Memory → GPU之外,Network也成为跨节点数据路径的重要环节。存储保存计算成果,内存承接复用与搬运,GPU继续完成必要计算;它们需要与网络和调度一起评估。
这不意味着所有缓存都应下沉到SSD,更不意味着缓存越多越好。企业评估AI基础设施时,还需要追问:前缀重复度如何?实际链路能搬多快?节省的计算是否足以覆盖数据搬运?
锋行致远持续关注AI推理过程中的数据搬运效率,并持续探索AI Storage与存算协同方向。本文性能数据均来自Mooncake论文,不代表锋行产品测试结果。
值得保存的,不只是数据本身,还有已经为它付出的计算。
参考论文
Ruoyu Qin, Zheming Li, Weiran He, Jialei Cui, Feng Ren, Mingxing Zhang, Yongwei Wu, Weimin Zheng, Xinran Xu.
Mooncake: Trading More Storage for Less Computation — A KVCache-centric Architecture for Serving LLM Chatbot. USENIX FAST ’25,pp.155–170。