
多模态大模型进台站:让AI看懂设备照片与现场画面
广播台站的运维现场,大量信息是“只有人能看”的——设备外观有没有变形,仪表盘指针在什么位置,指示灯是红还是绿,机房里有没有异常烟雾。这些视觉信息,传统监控系统拍到了,存下来了,但看不懂。
AI 大模型的出现让人看到了破局的可能。但这里有个容易被忽视的分水岭:当前台站里跑的大模型,绝大多数是纯文本模型——喂进去的是日志、告警、规程文本,吐出来的也是文字。它能问答,能检索,能写报告,但它“看不了”现场照片。
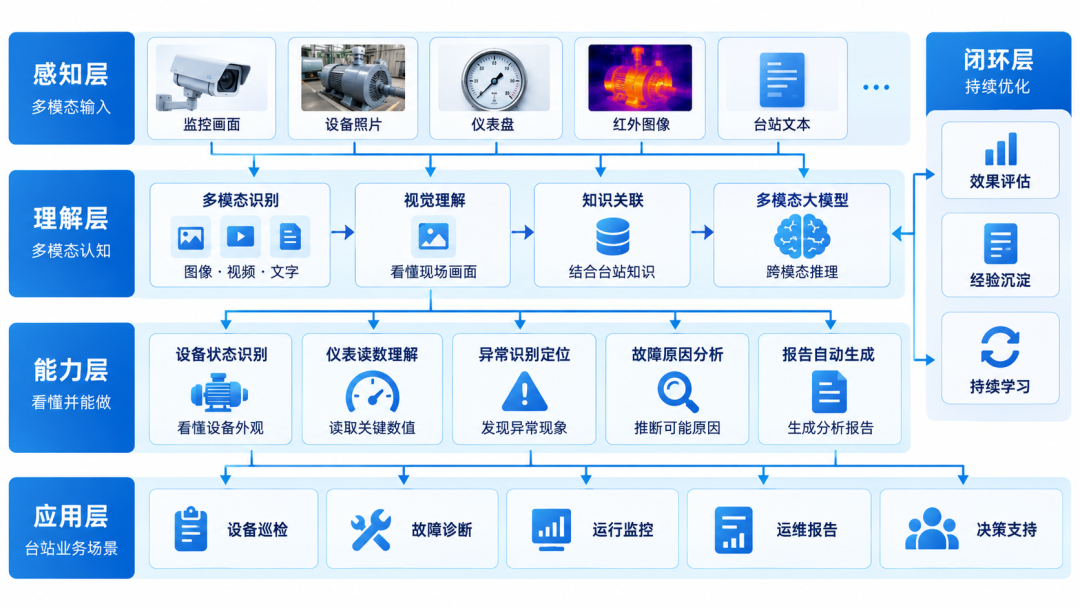
这恰恰是多模态大模型要解决的问题。它不只读文字,还能直接“看”图片——设备照片、监控截图、仪表盘画面,都能变成它理解和推理的输入。那么问题来了:多模态大模型进台站,到底能看懂什么?看到之后又能做什么?
先定位:单模态的天花板在哪里
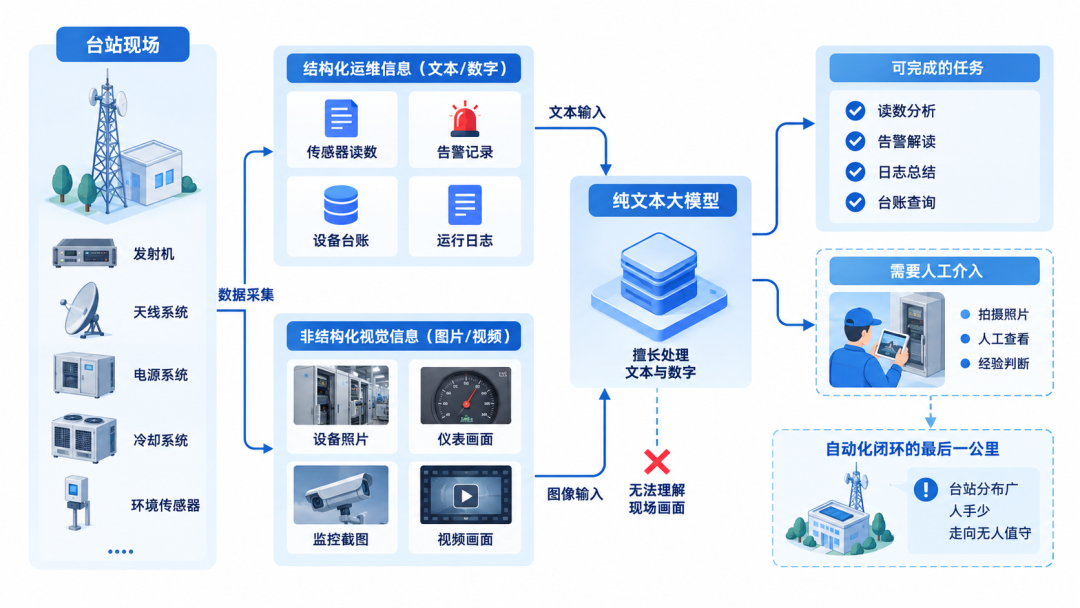
要理解多模态大模型的价值,先得看清纯文本大模型在台站场景里卡在哪里。
台站的运维信息大致分两类:一类是结构化的——传感器读数、告警记录、设备台账、运行日志,这些天然是文本或数字,大模型处理起来得心应手。另一类是非结构化的视觉信息——设备外观照片、仪表盘画面、监控视频截图、现场环境照片,这些只能靠人去看、去判断。
问题在于,台站现场的大量关键状态恰恰藏在这第二类信息里。一台发射机的冷却系统有没有漏水,一个电源模块的接线端子有没有变色,一块仪表盘的指针有没有卡在异常区间——这些判断决定了要不要停机检修,但纯文本模型一个都做不了。
结果是:AI 能帮你查规程、写报告、分析日志趋势,但每次需要“看一眼现场确认”的时候,还得人去拍照片、人去看、人来判断。AI 的能力边界,卡在了“眼睛”这一步。
这不是小问题。
拆架构:多模态大模型的四层能力
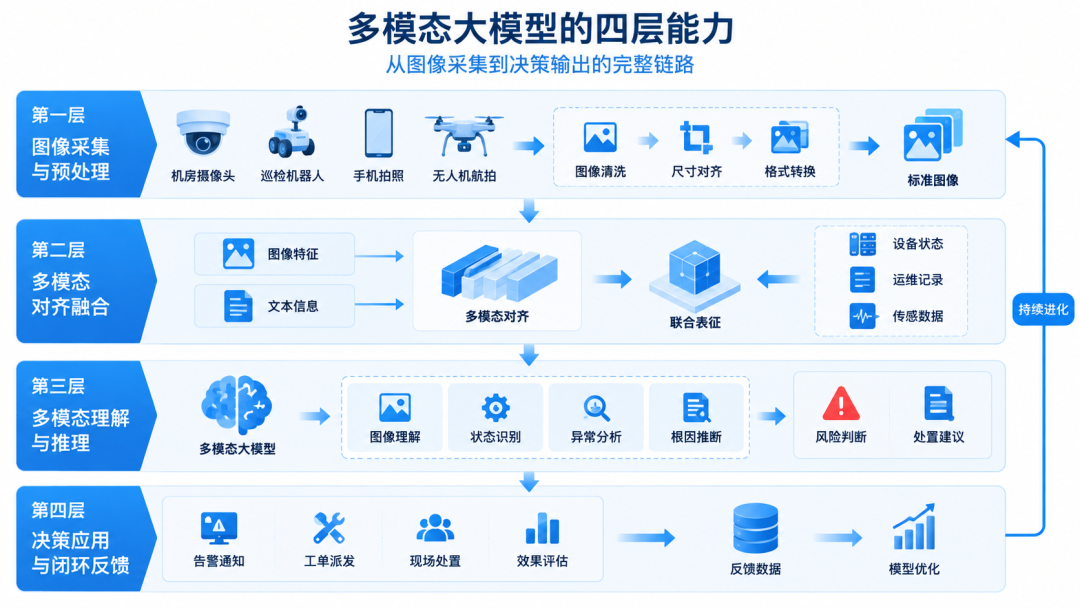
多模态大模型不是简单地在文本模型上“加个眼睛”。它涉及从图像采集到决策输出的完整链路,可以拆成四层来看。
■ 第一层:图像采集与预处理
这一层的任务是“把现场画面变成 AI 能处理的数字”。来源包括机房固定摄像头、巡检机器人搭载的相机、运维人员手机拍摄的照片,甚至无人机航拍画面。预处理环节要做的是图像裁剪、去噪、对焦校正、尺寸归一化——确保送进模型的图片质量稳定。
这一层最容易踩的坑是图像质量。台站机房光线复杂,有些设备藏在机柜深处,拍出来的照片模糊、过曝、偏色是常态。如果预处理不到位,模型看到的就是一团雾,后面的推理全白搭。
■ 第二层:视觉理解与特征提取
这是多模态大模型的核心能力层。模型接收一张图片后,要做三件事:识别图片里有什么(设备、仪表、指示灯、线缆),判断各个元素的状态(正常/异常/模糊不清),提取关键数值信息(仪表盘读数、指示灯颜色、设备型号标签上的文字)。
技术上说,这一层依赖大模型的视觉编码器(Vision Encoder)将图像转化为特征向量,再与文本特征空间对齐。业内管这个过程叫视觉-语言对齐(Vision-Language Alignment)。
■ 第三层:推理与决策
看到不等于看懂。第三层做的是“基于看到的内容做推理”。比如模型看到仪表盘指针在红色区域,结合设备运行参数(文本输入),推断出“功率超出额定值,可能存在过载风险”;再比如看到设备外观有变色痕迹,结合历史运维记录,推断出“疑似过热,建议检查接线端子”。
这一层是多模态真正拉开差距的地方。但多模态模型能自己“看到”证据,形成“图像证据 + 文本上下文 → 推理结论”的闭环。
■ 第四层:闭环执行与反馈
决策之后是执行。第四层把推理结果接入运维流程:自动生成巡检工单、触发告警通知、记录异常证据图片、关联到设备台账。更重要的是,执行结果会回流——运维人员确认了“确实是过热问题”,这条反馈进入模型训练数据,让下一次判断更准。
四层咬合,缺一层转不起来。没有第一层的图像质量保障,第二层就是空中楼阁;没有第三层的推理能力,看到也只是“看到了”但不“理解”;没有第四层的闭环反馈,模型永远停在“一次性判断”,无法持续进化。
分级看:从 L1 到 L4 的能力阶梯
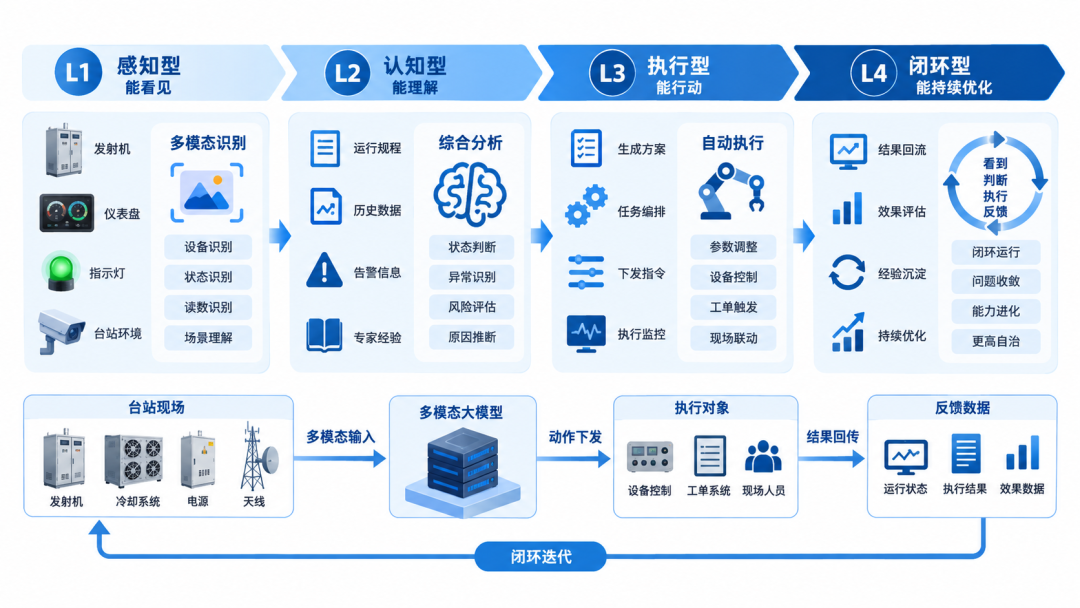
和多模态大模型在其他领域的演进一样,它在台站场景的能力也可以分成四级。搞清楚自己在哪一级,才知道下一步往哪里走。
■ L1 感知型:能看见
模型能识别图片里的基本元素——“这是一台发射机”“这是仪表盘”“指示灯是绿色”。相当于一个刚入职的新人,能看到东西但还不会判断。
■ L2 分析型:会诊断
模型不只识别“是什么”,还能判断“状态对不对”——“仪表盘指针在正常区间”“指示灯绿色=运行正常”“设备外观无明显异常”。这一级已经能替代部分人工巡检的判断工作,但遇到复杂场景(比如“这个变色要不要紧”)仍然需要人来拍板。
■ L3 决策型:出方案
模型能基于视觉证据给出行动建议——“发现 3 号冷却风扇轴承区域有油渍痕迹,结合温度偏高,建议安排检修”。它输出的不再只是状态描述,而是带有优先级和操作指引的方案。人确认后执行,但分析环节 AI 已经跑完了。
■ L4 系统级:自主闭环
模型能自主完成“发现问题→定位根因→生成工单→跟踪执行→验证结果”的全链路。多张图片、多设备状态、历史趋势交叉验证,不需要人逐张看图。行业现状离这一级还有距离——核心瓶颈不在模型能力本身,而在闭环执行链路的数据打通和流程嵌入。
然后呢?L4 真正的门槛不是模型多聪明,而是“看到→判断→执行→反馈”这条链路能不能真的跑通。模型再强,如果工单系统接不上、执行结果不回流,闭环就是断的。
看转变:三个关键跃迁
从单模态到多模态,不只是“多了一种输入方式”,而是几个底层逻辑的根本转变。
■ 从“人看图”到“AI 看图”
传统模式下,所有现场照片的判断都依赖人。巡检人员拍了照片,回来对着照片写记录、做判断。多模态大模型让 AI 直接参与“看图”环节——拍完照片,模型即时给出识别结果和状态判断,人只需要确认异常项。
这个转变的意义在于:台站走向少人值守时,“看现场”这件事不再完全绑定人工。
■ 从“单模态孤岛”到“多模态融合”
纯文本大模型处理的是“文字描述的台站”——日志里的功率值、告警里的温度阈值、规程里的操作步骤。多模态大模型处理的是“真实的台站”——不光有文字,还有照片、有画面、有视觉证据。
文本信息提供上下文和规则约束,图像信息提供实时状态和视觉证据,模型把两类信息交叉验证,判断的准确率和覆盖面都上了一个台阶。
■ 从“一次性判断”到“持续学习”
传统图像识别是“训练好就固定了”——识别 5 种设备就只认这 5 种,新设备来了得重新训练。多模态大模型具备上下文学习能力,运维人员用自然语言描述“这是新型号 XX 的面板”,模型能理解并应用到后续识别中。
更重要的是闭环反馈。每一次人工确认的判断结果,都成为模型的训练素材——对了几次,模型更自信;错了几次,模型自动校正。这是一个越用越准的飞轮。
过落地:三步走路线图
理想很清晰,但落地从来不是一步到位的。实践表明,多模态大模型在台站的落地可以分三步走。
■ 第一步:打地基——先把图像数据跑通
先选一个高频场景试水,比如仪表盘读数识别。把现有监控摄像头的画面接入模型,让模型学会“看仪表盘→读数值→对比阈值→输出状态”。这一步验证的是技术可行性:模型能不能看准、读对、判断正确。
地基不能反。如果连单场景的图像识别准确率都上不去,后面谈融合、谈闭环都是空中楼阁。
■ 第二步:连成线——多模态融合推理
单场景跑通后,把图像识别结果和文本信息(运行日志、告警记录、设备台账)接入同一个大模型。让模型能同时“看图”和“读数据”,做交叉推理——“图片显示冷却风扇转速表读数偏低,日志显示温度持续上升,推断散热系统效率下降”。
这一步的挑战在数据打通。图像系统和文本系统往往是两套独立架构,要融合到同一个推理链路里,接口、数据格式、时序对齐都需要解决。
■ 第三步:织成网——全场景闭环
从单设备扩展到全台站,从单场景扩展到多场景联动。设备外观巡检、仪表盘监控、环境画面分析、指示灯状态判断——所有视觉信息汇入同一个模型,和运行数据、运维知识库联动,形成“感知→诊断→决策→执行→反馈”的完整闭环。
画路线:回到开头的那个问题
回到开头的问题:多模态大模型进台站,到底能看懂什么?看到之后又能做什么?
能看懂的,是设备外观、仪表读数、指示灯状态、现场环境——那些过去“只有人能看”的信息。能做的,是把这些视觉信息变成 AI 可理解、可推理、可决策的输入,让运维闭环不再卡在“看现场”这一步。
表面上是给大模型“加了一双眼睛”,实质上是从“文本描述的台站”走向“真实可见的台站”。这中间的跨越,不只是多了一种输入模态,而是让 AI 的能力边界从“处理文字”扩展到“理解现场”——这一步打通了自动化运维的最后一公里。
关键命题已不再是“大模型能不能看图”,而是“看完图之后,诊断、决策、执行的闭环能不能跑通”。地基、连线、织网,三步走,每一步都需要扎实落地。
思行合一 顺势而为
智慧广电解决方案提供商
思|为|交|互
商务合作:waynezheng@idmakers.cn