
AI语言模型检测AD:解锁语言标志物
停顿(pauses)比不流利和不可懂词贡献更大
AD早期就影响语言——找词困难、不流利、长停顿、不可懂词都比同龄正常人多。过去用语音做AD检测多靠手工特征或小模型,Transformer类的BERT本来是文本模型,能不能直接吃语音转写文本、把"语音生物标志物"作为额外输入提升AD检测,新加坡国立大学WisDM数字医学研究所想做系统比较。该团队Zara Khanna、Dean Ho(biedh@nus.edu.sg)等,在Frontiers in Artificial Intelligence(JCR Q2,IF约4)2026年发表Utilising speech-derived biomarkers to detect Alzheimer's disease with BERT-based language models: a machine learning study(利用语音衍生生物标志物用BERT类语言模型检测AD:一项机器学习研究),单位为新加坡国立大学杨潞龄医学院数字医学研究所,DOI 10.3389/frai.2026.1875702。研究用Pitt语音转写语料库,比较BERT、ALBERT、DistilBERT三种轻量语言模型,在"无生物标志物/不流利/停顿/不可懂词/全部生物标志物"五种条件下做5折交叉验证,核心结论是加入停顿信息把macro-F1从0.796推到0.845,单靠停顿这一种语音特征收益最大。
三种语音生物标志物贡献不同
222例很可能AD+21例可能AD+243例对照,平均年龄AD组72岁、对照64.9岁。把语音转写里三类CHAT标注代码拆出来:不流利(&-um、&+su这类填充词和片段)、延长停顿(…及以上,对应>1.5秒静音)、不可懂词(xxx/yyy/www)。在5折CV、seed=4314下,BERT基线(无生物标志物)macro-F1 0.796,加不流利降到0.797几乎没动,加停顿跳到0.845,加不可懂词0.830,把三类全加回去反而降到0.824(图1)。ALBERT和DistilBERT趋势一致,停顿条件下ALBERT 0.840、DistilBERT 0.812。 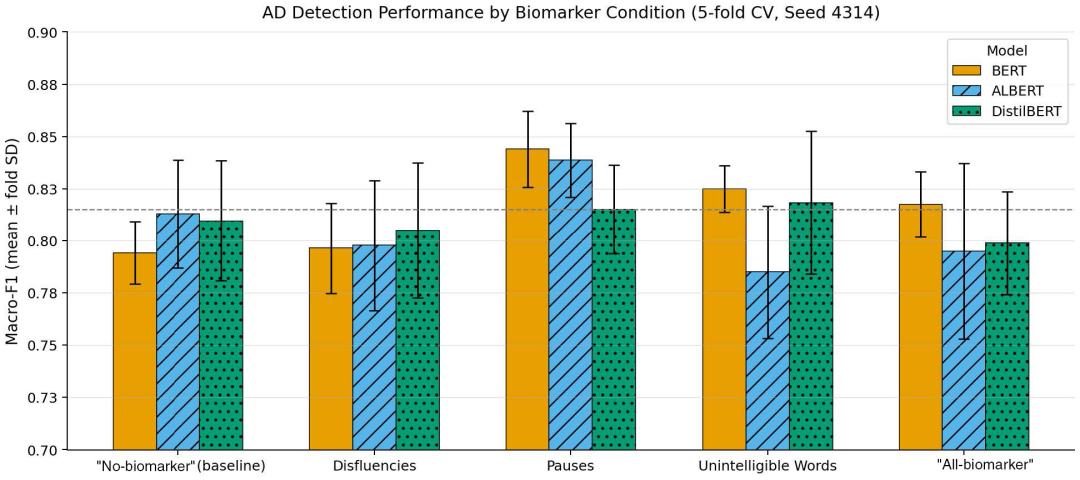 图1 三种BERT模型在五种语音生物标志物条件下的macro-F1(5折CV均值±SD)。停顿条件下BERT达0.845最高,全生物标志物组合反而下降
混淆矩阵显示漏诊减少
聚合混淆矩阵里,BERT基线真AD判对81%、假阴性19%;加停顿后真AD判对81%、假阴性仍19%,但真对照判对从78%升到88%(图2)——也就是说停顿主要让模型在"正常人说长停顿"这件事上学得更稳,减少把对照误判成AD。ALBERT停顿条件下真AD判对83%、真对照85%,DistilBERT停顿条件下真AD 80%、真对照84%。整体看停顿这一种轻量语音特征比堆全部特征更有效,作者把这解读为"语义停顿"比词级不流利更能反映海马—语言网络退行。 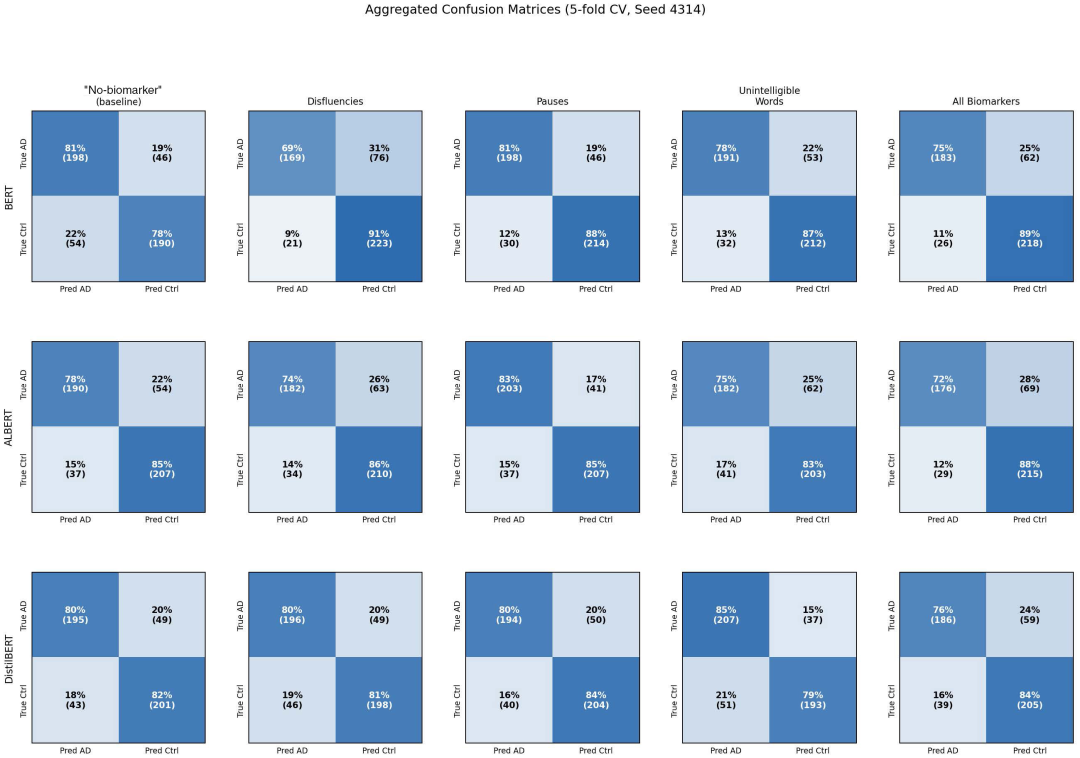 图2 三种模型在五种条件下的聚合混淆矩阵(5折CV)。对角线为正确分类比例,括号内为样本数 这项工作给"语音筛查AD"提供了一个不依赖昂贵ASR和声学特征工程的落地路径——只要把临床访谈录音转成带CHAT标注的文本,再训一个BERT,停顿这一项就能把模型F1提5个点。它也提示未来临床语音筛查应优先采集长停顿信息,而不是堆全部不流利和不可懂词。局限是Pitt语料库是英语单语、AD组教育程度较高、对照组年龄偏低,跨语言跨文化验证没做;MMSE和认知评分在转写层元数据里缺失,无法按严重度分层;5折CV的seed敏感性没系统报告,0.845这个峰值换seed可能回落。
Khanna Z, Ho D, Remus A, Raczkowska M, Montalan R, Saha P. Utilising speech-derived biomarkers to detect Alzheimer's disease with BERT-based language models: a machine learning study. Front Artif Intell. 2026;9:1875702. https://doi.org/10.3389/frai.2026.1875702
AD,speech biomarker(语音生物标志物),BERT,natural language processing(自然语言处理),pause detection(停顿检测),dementia detection(痴呆检测),machine learning(机器学习)
本文内容来自公开信息及研究文献,不代表临床建议。
如需投稿、转载、商务合作后台留言,回复有一定延迟敬请谅解。
辅助编辑:腾讯元宝or(GPT、Gemini、Claude等)